你不用买的那台交换机
一个跑 Ceph 的三节点 Proxmox 集群,节点之间需要快速网络。 常见的答案是一台 100 Gbit 交换机,常见的反对理由是它的价格。
对三个节点还有另一个答案:把它们直接互连成三角形,在上面做路由。 存储路径上根本没有交换机。
任何设计里最便宜的部件,就是你没买的那个,也只有它永远不会坏。
这换来了四样东西。
交换机的成本没了。 你需要的是网卡和三根线,而不是一台端口数相配的 100 或 200 Gbit 交换机。
数据路径没有单点故障。 一台交换机坏了或者重启,整个集群的东西向流量就跟着没了。 直接互连的节点不在乎楼里别处的交换机出了什么事。
重流量走自己的线。 实时迁移和 Ceph 复制留在网格上,不和办公、管理流量抢。
扩容是接线的活,不是端口预算的活。 没有一个中心设备充当带宽或端口数的天花板,所以只要每台服务器还有空闲 PCIe 插槽,这个网络就能长。OpenFabric 会自己在新链路上做路由。
还有一个老实话里的限制,因为它比那四个好处更重要。 全网格需要每两个节点之间都有一根线。 三个节点三根线。四个节点六根。五个节点十根。 接线增长得比节点数快,这个设计撑不过小集群,再往上就得换成有交换机的方案,比如 leaf-spine。
三个节点正是全网格合理的地方。再往上,每个节点只有两个网格端口,你还能搭的是一个环,而它需要一样这次搭建本来避开的东西,下面会讲。
搭出来的是什么
三台 Proxmox VE 主机,每台有两个专用的 100 Gbit 接口,接成三角形,这样每个节点都有两个直接邻居。
Proxmox SDN 负责路由。 协议是 OpenFabric:它算出网格上的最佳路径,拔掉一根线或者一条链路掉了,它就通过剩下的路径重新路由。不需要任何人登录。
这个网络在 10.10.10.0/24 里,专门留给网格,别的什么都不用:不做管理,不给客户机,不做存储寻址,也不对外。
| 节点 | 网格地址 | 网格接口 |
|---|---|---|
| mesh1 | 10.10.10.1/32 | nic1, nic2 |
| mesh2 | 10.10.10.2/32 | nic1, nic2 |
| mesh3 | 10.10.10.3/32 | nic1, nic2 |
每个节点得到一个 /32,而不是子网的一段。
这正是路由网格而非桥接网格的意义所在。地址标识节点,OpenFabric 通告它,两条物理链路只是到达它的路径。
Proxmox 会创建一个 dummy 环回接口来承载它。
接线
有源光纤 DAC 线缆,接成三角形,每个节点的两个网格接口都开启巨型帧。
| 线缆 | 从 | 到 |
|---|---|---|
| DAC-01 | mesh1 nic1 | mesh2 nic1 |
| DAC-02 | mesh2 nic2 | mesh3 nic1 |
| DAC-03 | mesh3 nic2 | mesh1 nic2 |
选有源光纤而不是铜缆 DAC,有两个理由,都关乎机柜而不是网络:
- 理线。 有源光纤 DAC 比铜缆细得多,也软得多,走线整齐,不会在服务器背后堆成一团。
- 风道。 机箱背后的线少了,对前进后出风道的干扰就少,几条高速链路落在同几个 U 里时,这一点很要紧。
两张网,不是一张
网格不是唯一的网络,也绝不能变成唯一的网络。
每个节点的 nic0 接在一台 2.5 Gbit 交换机上,在 Proxmox 里呈现为 vmbr0 网桥。
它承载 Web 界面、管理访问和客户流量。它也是你搭建网格时用的路径,所以它必须独立于网格。
nic0 被刻意排除在网格之外。 创建网格节点时只选 nic1 和 nic2。
网格承载三样东西:
- Ceph。 超融合存储的节点间复制、恢复和回填。
- 客户虚拟网络。 基于 VXLAN 的 VNet 把客户机网络延伸到三个节点上,用路由网格做底层。
- Corosync,作为第二条路径。 集群成员流量同时走管理网络和网格,这样仲裁不依赖其中任何一条单独存活。
值得写进变更单的规则:不管 100 Gbit 接口处于什么状态,管理和客户访问都始终通过 2.5 Gbit 交换机保持可用。
全部通过 Web 界面
这次搭建完全在 Proxmox Web 界面里完成。 这是有意的选择,不是工具的限制。
刻意不用的:
- 手工编辑
/etc/network/interfaces。 - 手工编辑 FRR 配置文件。
- 用
vtysh作为搭建方法。
Proxmox 根据你定义的 SDN 对象生成底层网络和路由配置。 如果某样东西确实没法在界面里设置,那应该把它作为前提条件明确指出来,而不是在命令行上悄悄修好。下一个打开 Web 界面的人不会知道你做过什么。
下面出现的命令行输出只作为证据,绝不是搭建步骤。
搭建过程
1. 打开 Proxmox Web 界面,进入 Datacentre → SDN → Fabrics。
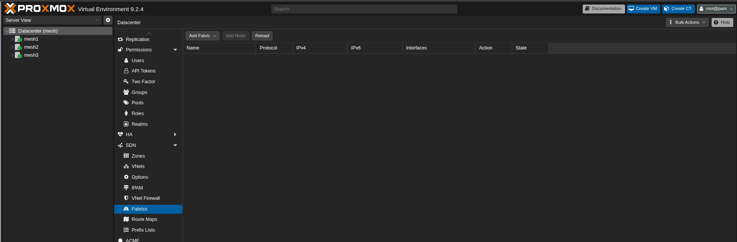
2. 添加网格。给它起名,填上网格前缀,设置计时器。
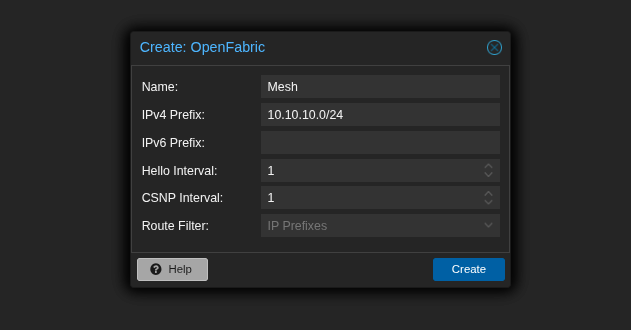
Hello 和 CSNP 间隔设为 1,在有变化时尽快更新状态,这正是这么小的网络想要的。
代价是控制面的消息更多。在三个节点、每个两条链路的规模上无关紧要,如果网络哪天长大了,值得再想一想。
3. 用 Add node 添加每个节点。从网格范围里给它一个地址,勾上参与的接口。
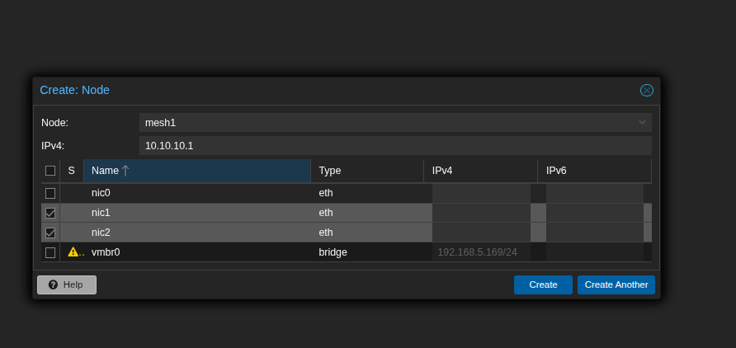
注意没勾的是什么:nic0 留在外面,vmbr0 保留管理地址。
前两个节点用 Create another,最后一个用 Create。
4. 应用之前先检查结果。
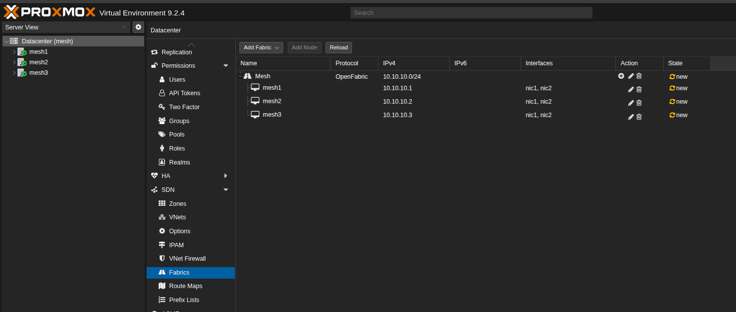
三个节点,三个地址,每个都是 nic1, nic2,全部标着 new,还什么都没写入。
5. 应用 SDN 配置。
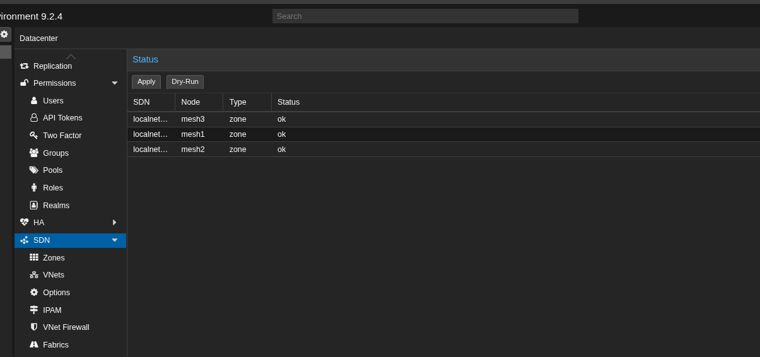
Apply 旁边有一个 Dry-Run,如果你想先看看它打算做什么的话。
怎么知道它成了
状态视图里,三个节点的 zone 和 fabric 条目都应该是 ok,也没有剩下待应用的改动。
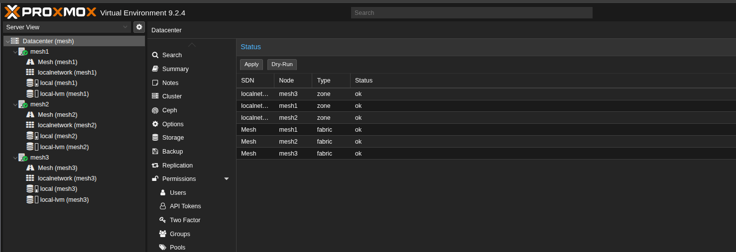
然后从某个节点自己的角度检查网格。
先看路由:每个节点都应该有到其他每个节点的 /32,Via 列告诉你它用的是哪个邻居。
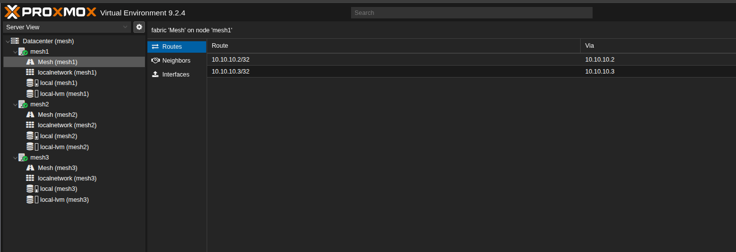
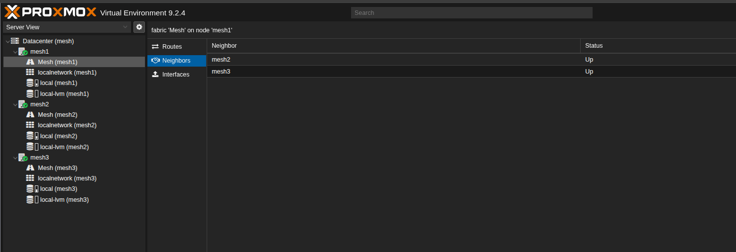
再看邻居。三节点三角形上有两个,都是 Up。
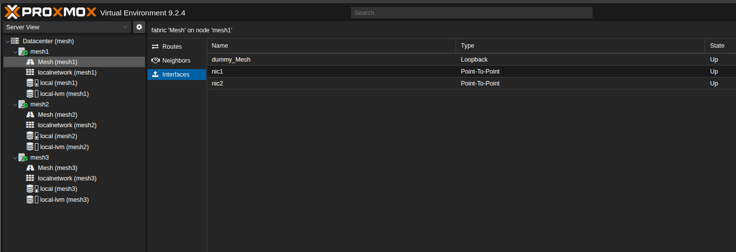
然后是接口,这里能看出整个东西的形状:dummy_Mesh 作为承载路由器地址的环回接口,nic1 和 nic2 是 Point-To-Point 而不是广播网段。
最后,端到端证明它。
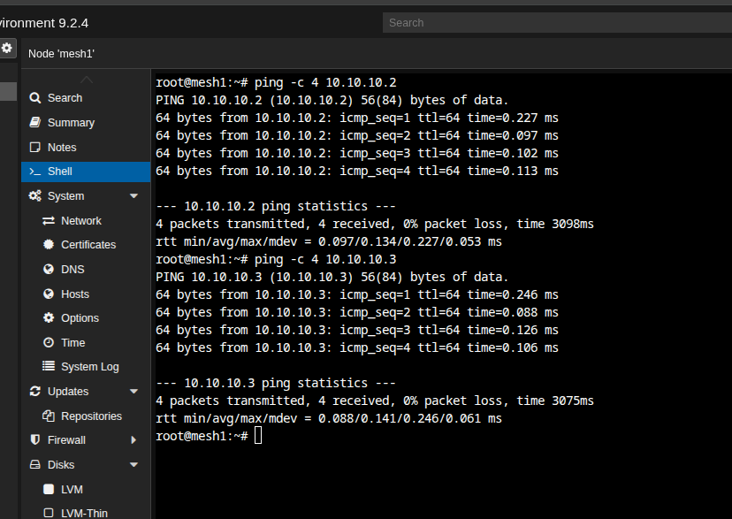
没有丢包,平均 0.134 ms 和 0.141 ms。 两个邻居都只隔一个直连跳,这正是三角形给你的。
值得做、却没有截图能显示的检查:拔掉一根线,确认一切仍然可达。 这正是选择路由网格而不是一对点对点链路的全部理由。因此,这是唯一要紧的测试。
超过三个节点:环
三角形就是全网格。每个节点到其他每个节点都有直连线,每一跳都只有一跳,没有哪个节点会承载不属于自己的流量。
这个特性是每节点两个网格端口在三个节点时换来的,到了四个节点就正好失去。不是失去一部分,是全部。四节点全网格每台需要三个端口。只有两个的话,你最多能接成一个环。
环改变了流量模型。相邻节点仍然有直连线,但环上相对的两个节点没有,它们的流量必须穿过一个中间节点。而那个节点必须愿意在它的两个网格接口之间转发数据包,Linux 默认不会这么做。内核文档把 ip_forward 描述为“Forward Packets between interfaces”,并且“Default: 0 (disabled)”。
只为网格接口打开它,别的不开:
# /etc/sysctl.d/99-mesh-forwarding.conf
net.ipv4.conf.nic1.forwarding = 1
net.ipv4.conf.nic2.forwarding = 1
sysctl --system
读回来确认,而不是想当然:
sysctl net.ipv4.conf.nic1.forwarding net.ipv4.conf.nic2.forwarding
按接口设置在这里是正确的范围,而且它单独就能生效。全局的 net.ipv4.ip_forward 不是前提条件。内核的转发判断读的是接收接口自己的值:
#define IN_DEV_FORWARD(in_dev) IN_DEV_CONF_GET((in_dev), FORWARDING)
IN_DEV_CONF_GET 返回的是该设备自己的设置,而不是和全局设置做与运算。所以 nic1 和 nic2 为网格转发过境流量,而 nic0 和 vmbr0 保持它们应有的样子:不做路由的主机接口。打开全局开关会让这台机器上的每个接口都变成路由器,包括面向你办公网络的那个。这个设计压根不需要这个。
关于全局 IPv4 开关,即使你不设置它,也有一件事要知道:net.ipv4.ip_forward 是一个批量设置项,所以内核文档警告说改变它会“resets all configuration parameters to their default state”。如果主机上有任何别的东西写了它,就会覆盖这些按接口的值。在你花一下午琢磨为什么过境流量不通之前,值得知道这一点。
IPv6 是例外,也是唯一需要全局开关的地方。 内核文档在 conf/all/forwarding 下直接这么说:
Enable global IPv6 forwarding between all interfaces. IPv4 and IPv6 work differently here; the
force_forwardingflag must be used to control which interfaces may forward packets.
所以 IPv6 没有上面那种整洁的按接口做法。如果网格承载 IPv6,你就全局开启转发,然后用 force_forwarding 限定范围,文档里写的是“Enable forwarding on this interface only — regardless of the setting on conf/all/forwarding”。注意同样的覆盖行为反过来也成立:把 conf.all.forwarding 设为 0,会重置每个接口上的 force_forwarding。
上面的搭建把网格的 IPv6 前缀留空了,所以这些在这里都不适用,只有你加上一个时才要紧。
注意转发没有改变什么:OpenFabric 本来就在通告每个节点的 /32,本来就在算出穿过环的路径。转发是缺失的许可,不是缺失的脑子。路由表一直都是对的,只是内核不肯当路由器而已。
和三角形相比,环的代价:
- 过境流量。 在四节点环上,两对对角节点要穿过一个中间节点,所以它们的流量除了占用自己的链路带宽,还占用那个节点的。Ceph 最先察觉,因为复制是全对全,而不是只在邻居之间。
- 多一跳的延迟,在这些路径上,叠加在无交换机设计通常的亚毫秒数字之上。
- 故障余量更小。 断一条链路,环就变成链:仍然全连通,但路径更长,过境更多。再断一条,集群就被分割。三角形断一条也完全没有过境流量。
而且它变糟的方式画出来比说出来容易。加上第五个节点,集群里每两个节点里就有一半要靠别人转发:
这才是这个设计真正的天花板,而且不是路由协议。OpenFabric 应付得很好。问题在于每节点的端口数是固定的,所以超过三个节点后,每多一台机器,就把你更多的流量变成别人的过境流量。
还有一句老实话,因为对一个到这里为止都只用 Web 界面的搭建来说它很重要:sysctl 不是 Web 界面里的操作。 按照前面立下的规则,这让它成为一个要明确指出的前提条件,而不是在命令行上悄悄修好的东西。把它写进运维手册,因为下一个打开 SDN 面板的人会看到一个健康的网格,却看不到任何提示说明这个环依赖 /etc/sysctl.d 里的一个文件。
撤销它
拆除就是把搭建倒过来,在同一个界面里:删除为网格创建的 SDN 对象,应用配置,确认管理访问没受影响。
最后这一步正是 nic0 和 2.5 Gbit 交换机存在的原因。 如果回滚网格可能让你失去 Web 界面,那这个设计在你动手之前就已经错了。
动手之前
- 管理访问确实独立于网格。去检查,不要想当然。
- 任何 SDN 改动之前,三个节点都是健康的。
- 节点名、接口名和接线都写下来,因为一台主机上的
nic1在另一台上是nic2,那会是个糟糕的下午。 - 两个网格接口都设置了巨型帧,并且 MTU 考虑了 VXLAN 在底层上的开销。
- 网格地址范围已经保留,别处没有在用。
参考资料
- Proxmox VE — Software-Defined Network — SDN Fabrics 文档。Fabrics “provide automated routing between nodes in a cluster”,OpenFabric “based on IS-IS and optimized for the spine-leaf topology common in data centers”,每个节点需要唯一的 Router-ID,并且 “a dummy ’loopback’ interface with the router-id is automatically created”
- Proxmox VE — Cluster Manager — Corosync 网络和冗余链路,双路径成员设计的依据
- Proxmox VE — Deploy Hyper-Converged Ceph Cluster — 超融合集群对网络的要求
- Linux kernel — IP sysctl documentation —
ip_forward及其默认值 0、按接口的forwarding控制,以及改变全局开关会重置按接口配置的警告