发布当天的 Rust OSD
croit 在2026年11月9日把 FlashStore OSD 放进公开预览1。
它是一个用 Rust 从零写起的 Ceph OSD,用自己的对象存储取代 BlueStore,说的是 Ceph 的线路协议。
宣称的是:它可以直接塞进你已经在跑的集群。你的监视器、管理器、ceph 命令行和客户端都原样不动,你一次换一块盘1。
这个说法对 Proxmox 用户比对大多数人更要紧。
在超融合的 Proxmox VE 节点上,Ceph 不是你单独装的东西。
它从 Proxmox 的 GUI 里来,出自 Proxmox 自己的软件源,由 Proxmox 构建和打补丁,整套东西由 pveceph 驱动。
如果别人家的 OSD 能坐进这套体系而不把它弄坏,你就能换上新的存储引擎,又不用放弃这些工具。
如果不能,你会以最难受的方式发现,而且是在一个同时跑着你虚拟机的节点上。
所以我试了。
我在 croit 工作,FlashStore 就是 croit 做的。 这就是我在它发布两天之内就去试的原因,也是下文什么都不打折扣的原因。 它是预览版,README 写着它 “not yet recommended for production data”1,而这篇是在真实硬件上跑起来到底要做些什么的记录,不是宣传册。
简短的回答:能用。 我写这些字的时候,八个 FlashStore OSD 正在一个原装 Proxmox VE 9.2 节点上给一台虚拟机提供 RBD 存储池,HEALTH_OK。 更长的回答是:要做两处文档里没提的修复,一处是因为 Proxmox 存放 Ceph 配置的方式,一处是因为 Proxmox 的内核,本文剩下的部分就是这两处修复以及它们是怎么被找出来的。 如果你只想让它跑起来,文末附近有个脚本把这一切都做了,而且已经在这个节点上跑过。
这台机器
实验环境是单个节点 pve2,在我家的局域网里,是一台 2021 年的破烂 Minisforum B550 迷你主机。
生产环境不会用单节点 Ceph,后面那条 CRUSH 规则就是为此付的代价,但这里的每一步,在有邻居的节点上都一样。
| Proxmox VE | pve-manager 9.2.26,内核 7.0.14-28-pve,Debian 13.7 |
| 机器 | Minisforum B550 迷你主机,2021 年;主板报告为 BESSTAR TECH B550,BIOS 5.17 |
| CPU | AMD Ryzen 7 5700G,8 核 16 线程,1 个 NUMA 节点 |
| 内存 | 58 GiB |
| OSD 盘 | 8 × Intel Optane P4800X 375 GB(6 块 Dell 品牌,2 块 Intel 零售) |
| 到 Optane 的 PCIe | 八块全在一个 Broadcom PEX880xx 交换芯片后面,经一条来自 APU 的 PCIe 3.0 x16 链路 |
| 启动盘 | WD SN750 512 GB,VG pve,完全不参与这一切 |
| 网络 | 一个 2.5 GbE 端口,vmbr0 |
| FlashStore | snapshot-2026-11-10,上游提交 c5792750020e2 |
用 Optane 是因为 FlashStore 有两条硬性要求,很多盘过不了。
盘必须有掉电保护,命名空间必须用 4096 字节的块,而且整个命名空间直接用,上面不能有分区或文件系统1。
FlashStore 在写入落盘持久之后才确认,所以一块用易失缓存在持久性上撒谎的盘,会在 mkfs 时被拒绝3。
每块 P4800X 在 Identify 数据里都报告没有易失写缓存(vwc 0),这是盘自己在说:缓存不会丢掉一个已经确认的写入。
因此,这次深入测试的瓶颈是这台迷你主机,不是 FlashStore,也不是盘。 八个核意味着每个 OSD 一个核,一个都不富余;58 GiB 要同时喂 Ceph 和虚拟机;八块 Optane 共享一条 PCIe 3.0 链路,因为 APU 就只给得出这么多。 下面每个数字,都要当成这台机器所允许的上限来读。
要么 Umbrella,要么没戏
FlashStore 一次只针对一个 Ceph 版本构建。
由分支决定:main 对应 Ceph 21.2.0 Umbrella,v20.2.4 分支对应 20.2.4 Tentacle4。
守护进程启动时检查集群的版本,不在自己窗口内的一律拒绝4。
发布页上的软件包是从 main 构建的,二进制文件自己也这么说:croit-flashstore-osd 21.2.0 umbrella。
Proxmox VE 9 提供三个 Ceph 软件源,只有一个对得上。
Tentacle 是 Proxmox 的默认选项,那它是稳妥的选择吗?
它恰恰是用不了的那个。
Proxmox 软件源里的 Tentacle 已经到了 20.2.5-pve1,而 FlashStore 的 Tentacle 分支只认 20.2.4。
Proxmox 软件源里的 Umbrella 是 21.2.0-pve1,正是 main 针对的那个版本。
Proxmox 并没有隐瞒 Umbrella 是什么。
PVE/Ceph/Releases.pm 把它列为 unsupported => 15,你一选它,GUI 向导就用大白话告诉你。
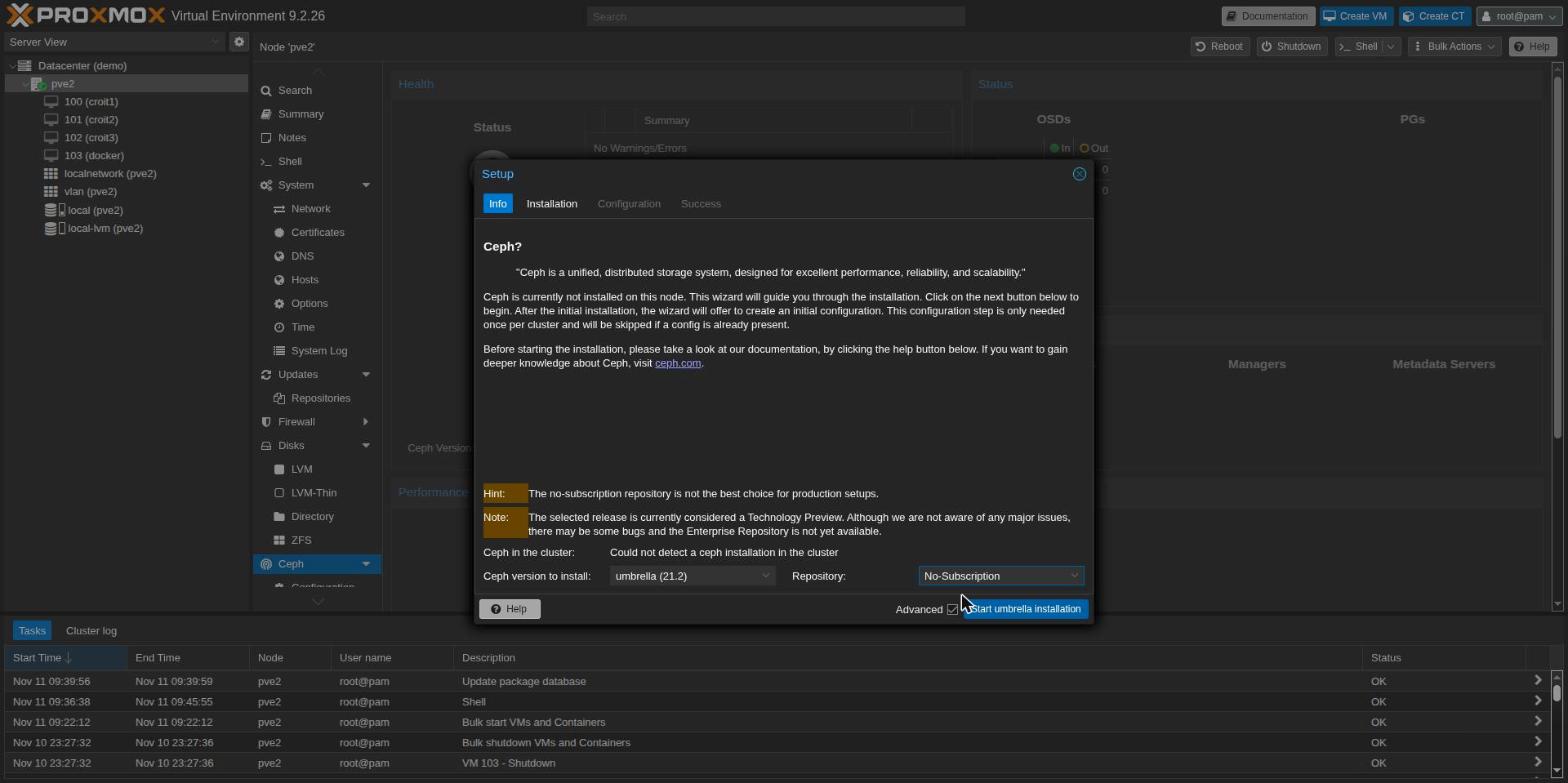
“Technology Preview”,没有企业软件源,安装程序在动 apt 之前还在终端里再问一遍 continue (y/N)?。
警告给得恰到好处,而且值得把它当成对整个技术栈的表态来读:预览版的 OSD,跑在预览版的 Ceph 上。
安装就是原装 Proxmox 的流程。 Datacenter → Ceph → Install,版本选 Umbrella,软件源选 No-Subscription,然后是公共网络和第一个监视器。
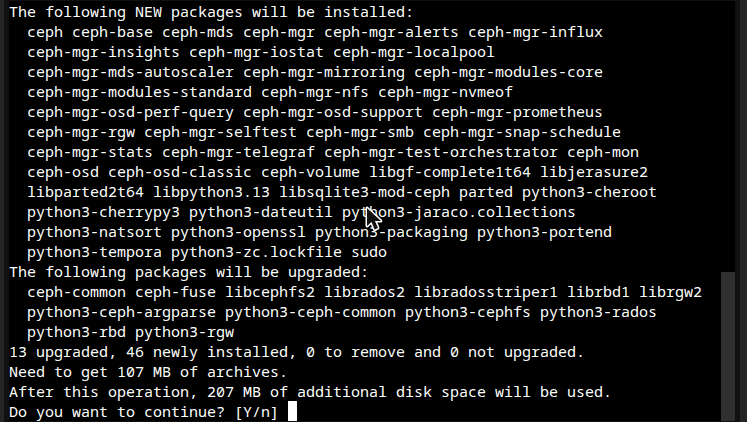
升级 13 个包,新装 46 个,下载 107 MB。
清单里有一样东西是 Umbrella 新有的:ceph-osd 旁边多了个 ceph-osd-classic。
两者在这里都用不上,因为从头到尾没建过一个经典 OSD。
大约一分钟后,mon.pve2 和 mgr.pve2 跑起来了,ceph versions 报告 21.2.0 … umbrella,健康状态 OK,只是还没东西可存。
四块盘还是 512 字节
八块 Optane 里有四块之前直通给过一台实验虚拟机,还是 512 字节格式,上面留着旧的 ZFS 标签。 另有两块格式是对的,但带着同样的标签。 两种情况的修法都很简单:从虚拟机上撤下来,格式化成 4 KiB,擦掉标签。
P4800X 把 4096 字节、无元数据的格式作为 LBA 格式 3 提供,nvme id-ns 报告为 lbaf 3 : ms:0 lbads:12。
nvme format /dev/nvme0n1 --lbaf=3 --force --timeout=900000
wipefs -a /dev/nvme0n1
sgdisk --zap-all /dev/nvme0n1
第一次尝试失败了,后来又有一次也失败了。
两次 nvme format 都返回 Interrupted system call,盘仍然是 512 字节。
内核日志里写着原因:
nvme nvme0: I/O tag 0 (0000) opcode 0x2 (Admin Cmd) QID 0 timeout, reset controller
nvme nvme1: I/O tag 9 (0009) opcode 0x6 (Admin Cmd) QID 0 timeout, reset controller
操作码 0x2 是 Get Log Page,0x6 是 Identify。
两个都不是格式化。
P4800X 会格式化整个介质,在这里每块盘花了 345 到 351 秒。
格式化进行时,控制器不响应其他管理命令,所以任何向盘提问的东西都得等着。
等过了内核 60 秒的管理命令超时,内核就放弃并复位控制器,而这一复位就把格式化杀掉了。
| 尝试 | 什么东西到了盘上 | 结果 |
|---|---|---|
| nvme0,第一次 | 09:53:04 的一个 Get Log Page,正值 Ceph 安装中途 | 中止,仍是 512 B |
| nvme0,放进服务单元 | 什么都没有 | 345 s 完成 4 KiB |
| nvme1 | 我自己查看进度的 nvme list | 中止,仍是 512 B |
| nvme2、nvme3 | 什么都没有 | 351 s 和 350 s 完成 4 KiB |
| nvme1,单独 | 什么都没有 | 346 s 完成 4 KiB |
修法是把每次格式化放进一个带长超时的临时服务单元里,一次一块盘,在完成之前别去碰这些盘:
systemd-run --unit=fmt4k /root/fmt4k.sh
journalctl -u fmt4k -f       # read progress from the journal, not from the drive
这样唯一的进度检查就是日志,没有任何东西会碰到控制器。
之后八块盘在 nvme list 里全都显示 4 KiB。
软件包
发布页提供 .deb 和 .rpm 软件包,其中有 Debian 13 trixie 的,Proxmox VE 9 就是基于它构建的2。
一个构建通吃所有发行版,要求 glibc 2.34 或更新6。
B=https://github.com/croit/ceph-rust/releases/download/snapshot-2026-11-10-0b6783237291
curl -LO "$B/flashstore_21.2.0+git.20261110063351.c5792750020e_debian-trixie_amd64.deb"
curl -LO "$B/sha256sums.txt"
sha256sum flashstore_*_debian-trixie_amd64.deb
grep debian-trixie/flashstore_ sha256sums.txt
手工校验一下。
sha256sum -c 校验不了这个下载,因为校验和文件里写的名字是 debian-trixie/flashstore_…_amd64.deb,而实际文件叫 flashstore_…_debian-trixie_amd64.deb。
哈希是一致的,两边都是 ce1fb352…26c8,所以文件没问题,只是清单和实际文件对不上。
apt install ./flashstore_*_debian-trixie_amd64.deb
croit-flashstore-osd --version
croit-flashstore-osd 21.2.0 umbrella (build 0.0.0) git c5792750020e
net tiers: kernel (+rdma upgrade)
它干净地装在了 Proxmox 自己的 ceph-osd 和 ceph-osd-classic 旁边。
软件包只在没有 ceph-osd.target 的主机上安装一个最小版本6,而 Proxmox 已经有一个了,所以 FlashStore 的服务单元挂在经典 OSD 本会挂的同一个 target 上。
在你针对这个软件包写脚本之前,有三件事值得知道:
| 文档怎么说 | 软件包实际是什么 | |
|---|---|---|
| 软件包名 | apt remove flashstore …6 | croit-flashstore-osd,文件名是 flashstore_… |
| 存储后端 | main 的生产特性集是 knet,spdk,rdma,mimalloc1 | 没有 SPDK:--check 报告 “SPDK NVMe driver: compiled out” |
flashstore_dev 的取值 | spdk:<pci>,开发构建里还有 file:7 | 内核层 kernel:/dev/… 是这个构建里唯一真正可用的存储路径 |
中间那行很要紧。
SPDK 层,也就是需要把盘绑定到 vfio-pci 的用户态 NVMe 驱动,不在发布的 Debian 软件包里。
里面有的是内核层:盘留在内核自己的 nvme 驱动上,FlashStore 通过 io_uring 跟它打交道。
源码显示它是编译进去了的,因为 knet 特性会拉进 kernel-nvme8,可主机检查的汇总行却说它 “compiled out of this build”。
那一行是错的。
信了它的读者会就此止步。
主机检查怎么说
croit-flashstore-osd --check 是只读的,在写入任何东西之前运行。
它检查构建、CPU、内存、IOMMU、每个 NVMe 控制器、网卡、内核和配置,并为每一项发现打印出确切的修法9。
在这个节点上它跑了 115 项检查,而且做得很好:每项发现都附带修复它的命令,省了我一大堆翻找。
| 发现 | 结果 | 我怎么处理 |
|---|---|---|
| 大页:一个都没预留 | FAIL | 按它要求预留 16 GiB,写进 /etc/sysctl.d 持久化 |
| SN750 启动盘:易失写缓存 | FAIL | 不管,它不是 OSD 候选盘 |
没加载 vfio-pci | WARN | 不管,这个构建没有 SPDK 可用 |
| memlock 限制 8 MiB | WARN | 不管,它测的是 shell;服务单元设置了 LimitMEMLOCK=infinity |
没有 isolcpus / nohz_full | WARN | 记下,属于延迟调优 |
IOMMU 是 translated,不是 iommu=pt | WARN | 记下 |
init_on_alloc=1 | WARN | 记下,据它说大块读时要多花 15 到 20 % 的 CPU |
| 2.5 GbE 端口、默认网卡环、中断分布在五个 CPU 上 | WARN | 记下 |
| 8 × P4800X:无 VWC、当前 4096+0、x4 @ 8 GT/s、空闲 | OK | |
| io_uring 支持 SEND_ZC 和固定缓冲区,内核 7.0 | OK |
第二个 FAIL 要提前打算好。
检查会把机器里每个控制器都算进去,启动 SSD 有写缓存,所以过不了掉电测试,尽管同一个检查正确地把它标为 “in use, not a candidate”。
教程说退出码 0 表示没有 FAIL9。
在任何从消费级 SSD 启动的主机上(很多 Proxmox 主机都是这样),无论你修了什么,--check 都不可能以 0 退出。
脚本要按每项检查的输出行来判断,不要看退出码。
调优类的 WARN 我都留着没动。 每一项都要改内核命令行并重启,而这是一次部署,不是跑分。 在任何人引用这台机器的数字之前,这份清单就是该逐项处理的东西。
八个 OSD 的核与大页
FlashStore 是每核一线程的模型,检查把这意味着什么说得很明白:“one core = one shard/PG owner”,每个 OSD 最多 8 个核,而且每个 OSD 核都要独占一个物理核,不和 SMT 兄弟线程共用。
八个物理核、八个 OSD,就是每个一核,flashstore_lcores = 0 到 7,SMT 兄弟线程留给 Proxmox 和虚拟机。
把这个写进配置再跑一遍,检查把每个核规划都标为 OK。
再看一眼大页。
检查要求每个 OSD 2048 MiB,这是守护进程默认的 --mem,所以八个 OSD 需要预留 16 GiB。
运行起来以后,每个 OSD 只用了 2048 里的 512 MiB。
这和 croit 自己关于内核后端的设计说明吻合,那里给负载分配器的预算就是 --mem 的四分之一10。
所以在这台机器上,八个全跑起来时,有 12 GiB 内存作为大页被预留着,没有任何东西去碰,而这台主机还有虚拟机要喂。
存储节点无所谓。
在 Proxmox 节点上,那块内存本可以是一台虚拟机,后文会把它削减到 OSD 实际用的量。
我能问一句,它为什么读不了 ceph.conf 吗?
盘格式化好了,软件包装上了,主机检查也过了,第一个 OSD 却起不来。
croit-flashstore-tool: refused: /etc/ceph/ceph.conf: Permission denied (os error 13)
在 Proxmox 上,/etc/ceph/ceph.conf 是指向 /etc/pve/ceph.conf 的符号链接,而 /etc/pve 是 pmxcfs,那个让每个节点的配置保持同步的集群文件系统。
那里的文件是 root:www-data 0640,pmxcfs 不允许你按文件去改11。
Proxmox 自己的 Ceph 守护进程之所以没事,是因为它们以 root 启动,读完配置,再降到 ceph 用户,每个 ceph-osd@ 服务单元上的 --setuser ceph --setgroup ceph 干的就是这个。
FlashStore 的服务单元不以 root 启动。
它从第一条指令起就是 User=ceph,ExecStartPre 也一样12,所以它根本没机会读到那个文件。
我能问一句吗:一个为 Debian 构建、号称即插即用的产品,为什么没在最常见的基于 Debian 的 Ceph 平台上试过? 我问的不是谁。 pveceph 把配置放在 pmxcfs 上,每个由 pveceph 管理的节点上的每个 FlashStore OSD,第一次启动都会撞上这个问题。
答案其实已经内置在守护进程里了。
它的源码描述了经典的 --setuser/--setgroup 降权:“started as root by a classic unit (--setuser ceph --setgroup ceph), the daemon becomes that user before it opens the store, a socket or a file”13。
所以一个按 Proxmox 启动自家 OSD 的方式来启动这个服务单元的 drop-in,应该就够了。
还差一点。 以纯 root 启动后,下一个拒绝来自盘。
activate: device kernel:/dev/ng0n1 not ready: /dev/nvme0n1: Permission denied (os error 13)
服务单元的 CapabilityBoundingSet 里没有 CAP_DAC_OVERRIDE12,所以 root 也要守普通的文件权限,而命名空间节点属于 ceph:ceph。
以 root 启动、组设为 ceph,两头都顾到了:root 拥有配置文件,ceph 组打开盘,守护进程在做任何别的事之前降到 ceph。
# /etc/systemd/system/croit-flashstore-osd@.service.d/pve-ceph-conf.conf
[Service]
User=root
Group=ceph
ExecStart=
ExecStart=/usr/bin/croit-flashstore-osd run --id %i --cluster ${CLUSTER} -f --setuser ceph --setgroup ceph
守护进程在自己的日志里确认了降权:set uid:gid to 64045:64045 (ceph)。
还有个更短的修法,SupplementaryGroups=www-data,我没用。
它会让 OSD 能读 /etc/pve 下每一个组可读的文件,而不只是 Ceph 配置。
OSD 没有理由去读集群其余的配置,而上面那个 drop-in 给它的,一点都不比 Proxmox 给自家 OSD 的多。
然后是设备节点。
FlashStore 的文档说命名空间节点必须可被 ceph 写入,“(udev rule)”14,而软件包一条都没带。
下面这条按型号匹配盘,所以无论编号怎么变,它都不可能误中启动盘:
# /etc/udev/rules.d/70-croit-flashstore-optane.rules
SUBSYSTEM=="nvme-generic", KERNEL=="ng*n*", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
SUBSYSTEM=="block", KERNEL=="nvme*n*", ENV{DEVTYPE}=="disk", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
执行 udevadm trigger 之后,十六个 Optane 节点都成了 ceph:ceph 0660,SN750 仍是 root。
这个内核不肯做的直通
内核层有两种模式,你指定哪个节点就决定了用哪种。
kernel:/dev/ngXnY 通过 io_uring 把 NVMe 命令直接发给盘,croit 管这叫 kernel-cmd。
kernel:/dev/nvmeXnY 在块设备上做 O_DIRECT 读写,叫 kernel 或 direct10。
croit 测过的每一格里 kernel-cmd 都领先10,README 自己的快速入门也用它1,所以我配的就是它。
权限理顺之后,守护进程降到 ceph,读了配置,然后在第一次读盘时停了:
croit-flashstore-osd: --dev kernel:/dev/ng0n1: /dev/ng0n1: kernel-cmd fixed-buffer probe read: Errno(13)
同样的探测一分钟前在 activate 里还通过了,那时它还带着 root 的能力。
所以问题是:这个内核是否允许一个非特权进程经 /dev/ngXnY 发送 I/O 命令。
不用 FlashStore 就能回答,以 ceph 身份用 nvme-cli 做同样的读:
| 身份 | 在 /dev/ng0n1 上的命令 | 结果 |
|---|---|---|
ceph | Identify Namespace | 允许 |
ceph | Read,LBA 0,4 KiB | Permission denied |
root | Read,LBA 0,4 KiB | 允许 |
八块 Optane 给出的答案一样,包括两块我从没格式化或复位过、跑的是 Intel 固件而不是 Dell 固件的盘。 所以不是盘的问题,也不是早上那几次格式化的问题。
上游说这应该行得通。
在 Linux 7.0 里,nvme_cmd_allowed() 允许非特权进程发送 I/O 命令,只要盘的 Commands Supported and Effects 日志把它标为支持且没有异常影响;只有写入或改变数据的命令才要求以可写方式打开15。
P4800X 的 effects 日志把 Read 标为支持,00000001,别的什么都没有。
读是允许的。
Proxmox 的内核不是上游的内核。
它这个构建的变更日志里,恰好在这条路径上有一个回移植的修复,CVE-2026-90227: nvme/ioctl: check SUBMIT_IO with nvme_cmd_allowed(),从字面看涉及的是另一个 ioctl,不是我测的那个。
我还没查清 7.0.14-28-pve 内核里到底是哪处改动造成了差别,我也不会去猜。
确定的是行为:在这个内核上,非特权的 NVMe 直通 I/O 会被拒绝。
FlashStore 对被拒绝的直通有个回退机制,但它没触发。
croit 的设计说明说,当 Identify 被拒绝时,kernel-cmd 设备会退回到在其块设备节点上做直接 I/O,并在启动时说明10。
这里 Identify 允许而 Read 不允许,所以回退从未触发,OSD 直接停了。
直接 I/O 不在乎这个。 每个 OSD 一行:
flashstore_store_backend = kernel
这样一来,osd.0 起来了。
croit-flashstore-osd: store mounted (1 shards, replayed 4 txns in 16 ms)
croit-flashstore-osd: set uid:gid to 64045:64045 (ceph)
[    1.398] crush location set (create-or-move updating item name 'osd.0' weight 0.3359 at location {host=pve2,root=default} to crush map)
[    2.406] osd.0 is now active (up_from 10, map 10)
2.4 秒进入 active。
准备并启动 OSD
每个 OSD 在 Ceph 配置里有自己的一节,在 Proxmox 上就是编辑 /etc/pve/ceph.conf,手工改没问题。
[osd.0]
	flashstore_dev = spdk:0000:05:00.0
	flashstore_store_backend = kernel
	flashstore_lcores = 0
设备按 PCI 地址指定,而不是 /dev/nvme0n1,这里的 spdk: 前缀也不代表 SPDK。
设了内核后端之后,守护进程每次启动都会在 sysfs 里查这个地址,找到控制器当前的节点10。
这一点在这里很要紧。
SN750 启动盘十月份是 nvme7,现在是 nvme8,通用节点的次设备号也不按盘的顺序来,ng1n1 是次设备号 0,ng0n1 是 2。
写着 /dev/nvme4n1 的配置,重启之后可能指向另一块盘。
写着 0000:0b:00.0 的配置不会。
然后每块盘一条命令,写入存储并向监视器注册 OSD:
croit-flashstore-tool prepare --dev spdk:0000:05:00.0 --id 0
kernel-cmd /dev/ng0n1: fixed-buffer NVMe passthrough probe ok (IORING_URING_CMD_FIXED on)
mkfs: device lba 4096 B x 91573146 (375083606016 B), awupf 1 lba, vwc false, max_xfer 32 lba
mkfs: 1 store shards, WAL ring 4096 MiB each
osd.0 prepared in /var/lib/ceph/osd/ceph-0
以 root 身份,两秒。
prepare 从 /var/lib/ceph/bootstrap-osd/ceph.keyring 读取 bootstrap 密钥16,而 pveceph 只在第一次创建它自家的 OSD 时才写这个文件,所以在没有经典 OSD 的情况下得先把它取出来:
ceph auth get client.bootstrap-osd -o /var/lib/ceph/bootstrap-osd/ceph.keyring
六块盘第一次就 prepare 成功。 两块被拒绝了:
croit-flashstore-tool: refused: device is not empty (non-zero data in the first 8192 bytes); --wipe destroys it
croit-flashstore-tool: refused: device is not empty (non-zero data at 65536 bytes); --wipe destroys it
lsblk 和 blkid 都报告这两块盘是空的。
上面其实是一个早先实验留下的 LVM 卷组的文本元数据区,那个卷组早就删了,开头的标签也已经清零。
FlashStore 的探测会读开头 8 KiB 以及 64 KiB 和 256 KiB 处的区域17,比常用工具看得更远,而它是对的。
除非被告知 --wipe,否则拒绝一块上面有任何东西的盘,这正是 OSD 工具该做的。
要不要擦,是盘的主人该做的决定,不是工具该做的。
决定之后,--wipe 大约两秒就 prepare 好了这两块,它们是在后面安装完成之后才加入的,所以面板截图和安装数据里都是六个。
然后启动它们:
systemctl enable --now croit-flashstore-osd@0
ID  CLASS  WEIGHT   TYPE NAME      STATUS  REWEIGHT  PRI-AFF
-1         2.01535  root default
-3         2.01535      host pve2
 0   nvme  0.33589          osd.0      up   1.00000  1.00000
 1   nvme  0.33589          osd.1      up   1.00000  1.00000
 2   nvme  0.33589          osd.2      up   1.00000  1.00000
 3   nvme  0.33589          osd.3      up   1.00000  1.00000
 4   nvme  0.33589          osd.4      up   1.00000  1.00000
 5   nvme  0.33589          osd.5      up   1.00000  1.00000
每个 OSD 都把自己放到 host=pve2 下,设备类别 nvme。
它们向集群报告的关于自己的信息,值得读一遍:
| 字段 | 监视器和管理器 | FlashStore OSD |
|---|---|---|
ceph versions | 21.2.0 (087cd25db8f1) umbrella (dev - None) | 21.2.0 (b060042deb05) umbrella (dev - croit-flashstore-osd) |
| 构建者 | Proxmox,-pve1 软件包 | croit,基于 README 指名的上游 v21.2.0 提交1 |
osd_objectstore | bluestore,每个 bluestore_bdev_* 字段都填好了 | |
| 它实际是什么 | FlashStore,没有 BlueFS,没有 RocksDB |
报告 BlueStore 是有意为之。
flashstore_report_objectstore 默认是 bluestore,因为经典监视器只有在每个 OSD 都这么报告时才启用某些特性,所以这个默认值让混合集群能继续工作7。
它不是真的,在你读集群元数据并信以为真之前,值得知道这一点。
Proxmox 怎么看待它们
Proxmox 的 OSD 面板列出全部六个,up 且 in,类别 nvme,版本 21.2.0,每个 344 GiB。
它还把它们叫作 FileStore。
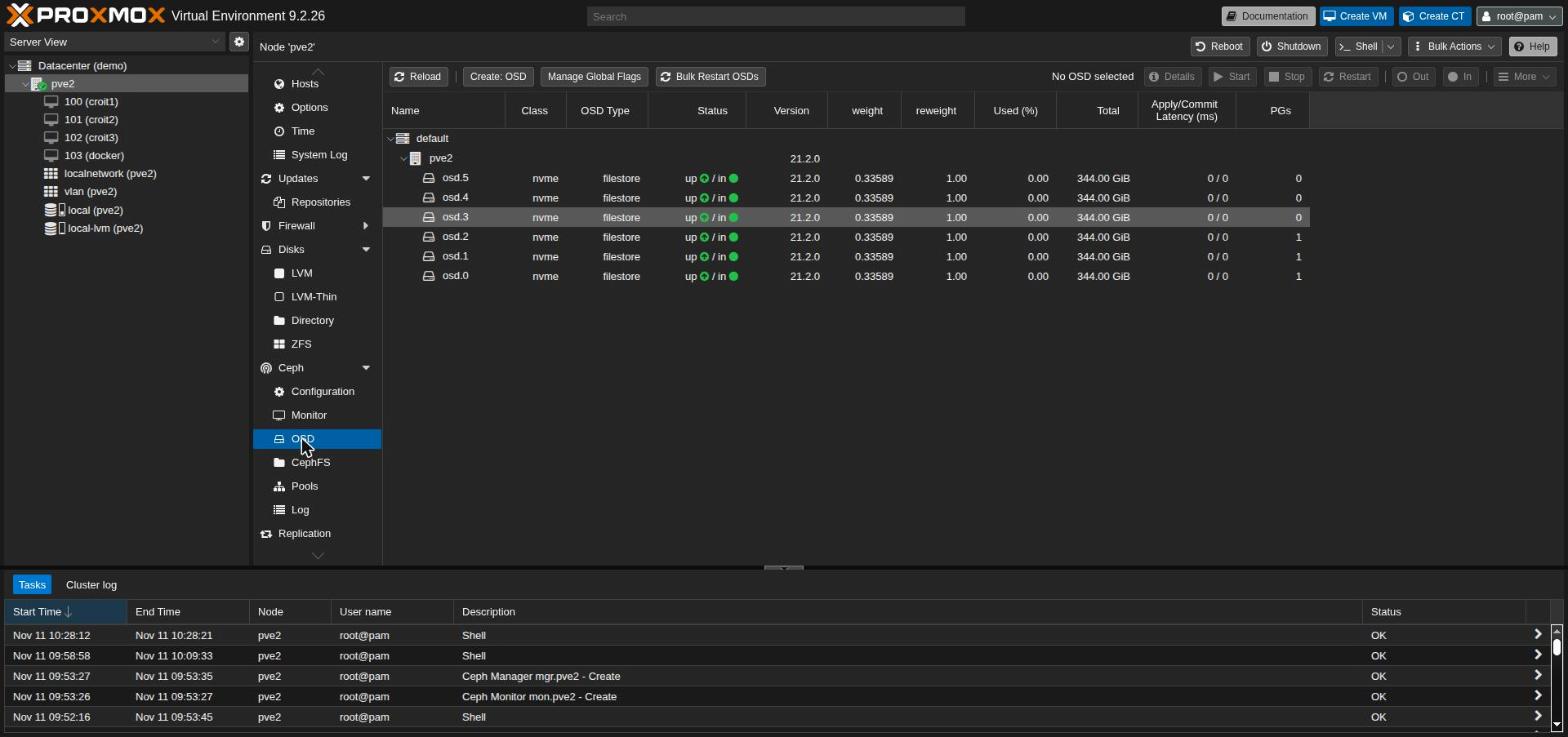
FileStore 是被 BlueStore 取代的那个对象存储。
Proxmox 在 PVE/API2/Ceph/OSD.pm 里推断这个标签:OSD 元数据里有 bluefs 键就是 BlueStore,其他一律是 FileStore18。
FlashStore 没有 BlueFS,因为它底下没有 RocksDB,所以它在一个字段里报告 BlueStore,又因另一个字段被标成 FileStore。
两个都不对。
而面板恰恰是大多数 Proxmox 管理员首先看的地方。
空闲时延迟列显示 0 / 0。
在下面的安装过程中,ceph osd perf 报告六个 OSD 的提交延迟在 0 到 3 ms 之间。
面板里的 Start、Stop 和 Restart 操作的是经典服务单元 ceph-osd@N,而那不是正在运行的东西19。
因此,面板只是这些 OSD 的一个视图,而不是它们的控制台。
凡是碰守护进程的事,用 systemctl … croit-flashstore-osd@N 和命令行,Create: OSD 和 Destroy 对它们千万别碰。
一个存储池、一个存储和一台 Fisher-Price OS (Windows) 虚拟机
集群里的第一个 PG,也就是管理器的 .mgr 池,OSD 一起来就处于 undersized+degraded。
怪单节点。
默认的 replicated_rule 把每份副本放在不同主机上,而这里只有一台主机。
ceph osd crush rule create-replicated replicated_osd default osd nvme
ceph osd pool set .mgr crush_rule replicated_osd
一条故障域为 osd、设备类别为 nvme 的规则20把每份副本放在不同的 OSD 上,PG 几秒内就变成了 active+clean。
在有三台或更多主机的真实集群上,保留按主机的规则,跳过这一步。
之后的一切都是照常的 Proxmox GUI。
Ceph → Pools → Create:名称 flashstore,size 3,min size 2,规则 replicated_osd,勾选 Add as Storage。
后来为了下面的负载测试,改成了 size 2,min size 1。
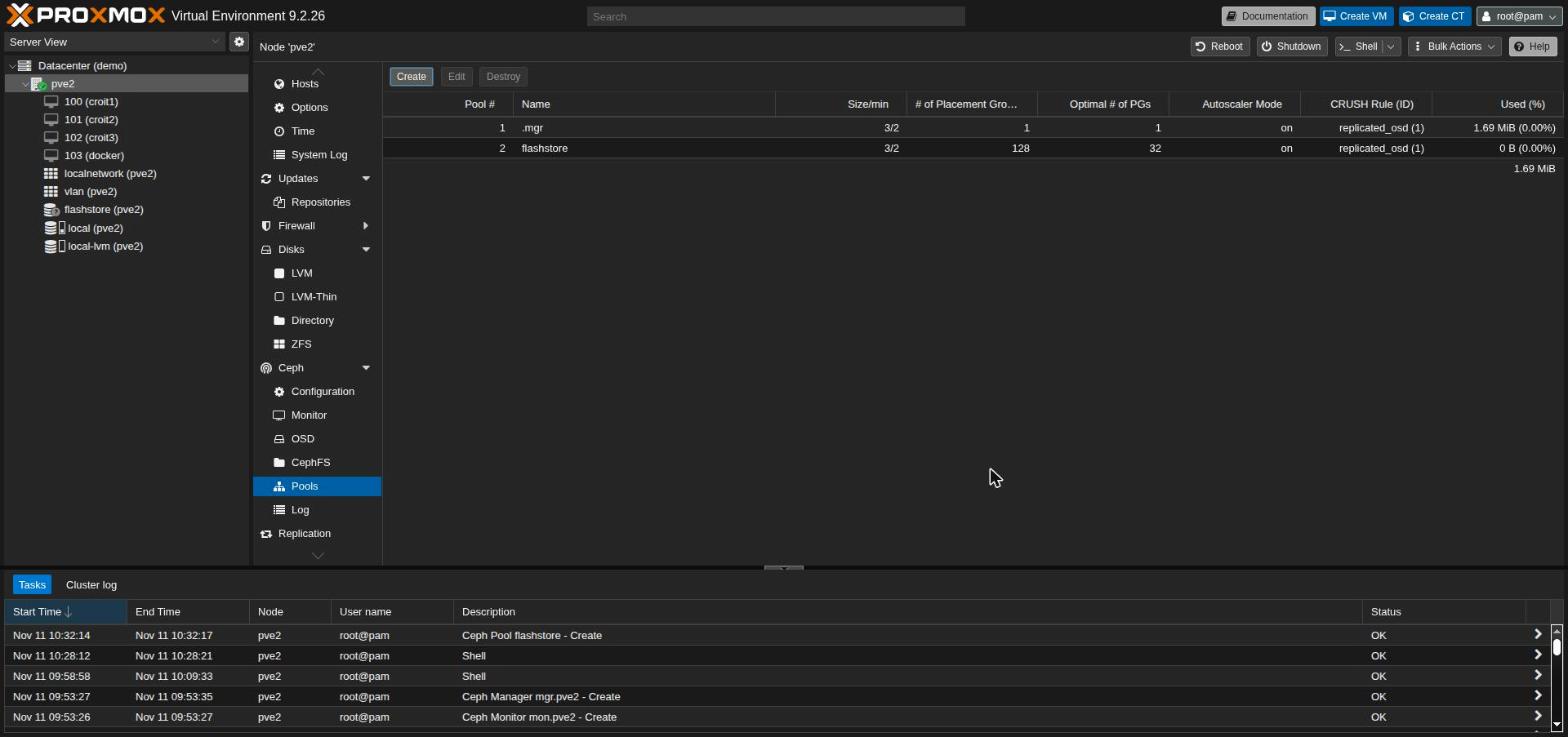
Proxmox 一次就建好了存储池和 RBD 存储定义,flashstore 出现在树里,可用 654 GiB,也就是 2 TiB 裸容量除以三份副本再减去开销。
129 个 PG 变成 active+clean,不久之后自动伸缩器把新池从 128 个 PG 降到 32 个。
测试用的客户机是一台 Fisher-Price OS (Windows) 虚拟机。
这不是我的偏好,而是很大一部分客户在他们的 Proxmox 存储池上实际跑的东西,所以它才是算数的负载:16 GiB 内存,4 核,一块放在 flashstore 上的 60 GiB 磁盘,开了 discard 和 iothread。
它对磁盘又话多又低效,这正是重点:存储测试要的就是最压磁盘的客户机。
在安装的头十五分钟里,每十秒对存储池采样一次:
| 存储池写入 | 活跃时中位数 9.3 MB/s,峰值 302 MB/s |
| 写操作 | 峰值每秒 2,486 次 |
| 存储池读取 | 峰值 60 MB/s |
| 已用裸空间 | 六个 OSD 共 35 GiB |
| 健康状态 | 全部 90 个样本都是 HEALTH_OK |
| OSD 重启 | 0 |
| OSD 常驻内存 | 之后每个 565 到 871 MiB |
这些是一个安装程序的数字,虚拟机和 OSD 在同一台主机上,调优类 WARN 一个没动,它们完全不说明 FlashStore 的速度。 它们说明的是:一个经典的 Proxmox 客户端把一整个操作系统装到了 Rust OSD 上,35 GiB 裸容量,没出一个故障,而这正是本文要检验的说法。
负载下它表现如何
装得上,证明它能用。 它不告诉你这台虚拟机用起来怎么样。
于是虚拟机跑了 CrystalDiskMark 9.0.321,跑了三次:Real World Performance [+Mix] 配置、Read&Write [+Mix]、C: 上一个 16 GiB 文件、70/30 读写混合,一次三遍,两次九遍。 这个配置一切都在单线程上一次一个请求地跑,这才是桌面或小型数据库实际的样子,而不是规格书的样子。
那时配置已经和安装时不同了。 虚拟机有六个核,存储池在 GUI 里改成了 size 2、min size 1、256 个 PG。 在单台机器上,size 2 加 min size 1 是实验室设置:只剩一份副本时,存储池仍继续接受写入,而这些写入一次故障就可能丢掉。 别的地方,保持 3 和 2。
磁盘用的是 Proxmox 的默认设置,no cache,这从 Proxmox 2 起就是默认值22。
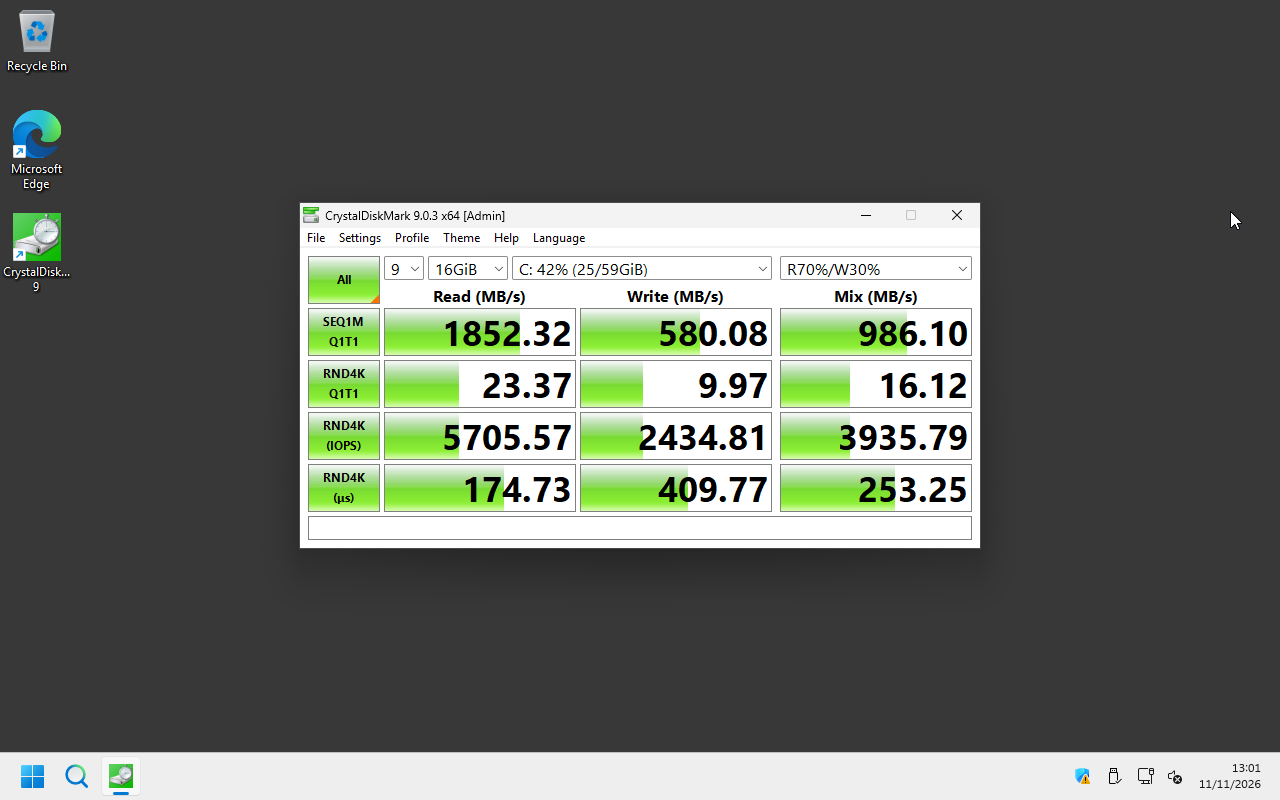
| Real World Performance [+Mix],16 GiB | 3 遍 | 9 遍 | 再 9 遍 |
|---|---|---|---|
| SEQ1M Q1T1 读 | 1,279.71 MB/s | 1,675.33 MB/s | 1,852.32 MB/s |
| SEQ1M Q1T1 写 | 563.67 MB/s | 576.65 MB/s | 580.08 MB/s |
| SEQ1M Q1T1 混合 | 1,043.75 MB/s | 1,043.28 MB/s | 986.10 MB/s |
| RND4K Q1T1 读 | 5,342 IOPS,186.57 µs | 5,659 IOPS,176.17 µs | 5,706 IOPS,174.73 µs |
| RND4K Q1T1 写 | 2,419 IOPS,412.51 µs | 2,405 IOPS,414.79 µs | 2,435 IOPS,409.77 µs |
| RND4K Q1T1 混合 | 3,938 IOPS,253.13 µs | 3,826 IOPS,260.49 µs | 3,936 IOPS,253.25 µs |
写入和小块延迟每次之间相差都在 1% 左右以内。 顺序读三次下来涨了 45%。 这是第一个迹象:读那一列测的并不是它看上去在测的东西。
三次运行全程每五秒对主机采样一次,八块 Optane 用 /proc/diskstats,存储池用 ceph status,每个进程和线程用 /proc,而两个视角讲的不是同一个故事。
写入:盘只占小头
| 一次一个 4 KiB 随机写,最后一次运行 | |
|---|---|
| 虚拟机看到的每次写入耗时 | 409.77 µs |
| 每块 Optane 上的每次写入耗时 | 17 µs |
| 虚拟机每写一次,到达 Optane 的写入次数 | 4.05:两份副本,每份大约两次写入 |
| 大块顺序写 | 虚拟机侧 580 MB/s,Optane 侧 1.14 GB/s,第二份副本让它翻倍 |
一次小写入里,盘只占不到 5%。 另外那 393 µs 是路上花掉的:QEMU、librbd、进入 OSD 的 messenger、OSD 本身,以及等第二份副本。 这里没有把这些拆开测,所以我不会给每一段报个数。 能说的是:在这台机器上,一次一个的 I/O 瓶颈不在 Optane,换一块更快的盘也动不了那 410 多少。 瓶颈已经转移到客户端,也就是 Proxmox 自带的 librbd;等 croit 自己的 librustyrbd 在这里部署之后,这方面还有后续。
读取:是缓存,不是 Optane
在最后一次运行里,4 KiB 随机读那一遍在整个 16 GiB 文件上每秒做了 5,700 次读,而八块 Optane 一个字节都没读。
顺序读那一遍在存储池层面达到 2.2 GB/s,与此同时盘自己的读取从 755 MB/s 掉到了零。
CrystalDiskMark 绕过客户机的缓存,磁盘在 QEMU 里也没有缓存,所以干活的内存在 OSD 里。
这个构建里 flashstore_obj_cache 默认开启,size 2 下每个 OSD 分到的文件份额大约 2 GiB,而每个 OSD 都长到了大约 2.6 GiB。
FlashStore 不报告命中情况,所以只能说几乎可以肯定,而不是已经证明。
这也是为什么顺序读每次运行都在涨:文件已经有更多部分在里面了。
把读那一列当成缓存数字,而不是存储数字。
CPU:核都去哪儿了
| 最后一次运行,单位为核 | 主机繁忙 | OSD | 客户机 vCPU | librbd 和 Ceph 客户端 | QEMU |
|---|---|---|---|---|---|
| 两遍之间空闲 | 20 到 24% | 3.3 | 0.1 | 0.03 | 0.03 |
| 4 KiB 随机写 | 30% | 3.9 | 0.38 | 0.20 | 0.08 |
| 4 KiB 随机读 | 30% | 3.6 | 0.47 | 0.39 | 0.15 |
| 顺序混合 | 41 到 53% | 3.8 | 1.5 到 2.3 | 0.5 | 0.12 |
虚拟机那三列来自它的线程:QEMU 给客户机的 vCPU 命了名,而 librbd 的 messenger 和工作线程跑在同一个进程里。
OSD 那一列几乎不动。 八个轮询的 OSD 什么都不干要花 3.3 个核,满负荷 3.9 个,所以在一台 16 线程的机器上,虚拟机还没开口要东西,五分之一的 CPU 就没了。 别的东西都没接近上限。 最忙的单个线程是一个客户机 vCPU,47%,librbd 最忙的线程一直不到 15%。 一次一个请求时,瓶颈是等待,不是干活,而 CPU 数字显示不出等待。
内存:按峰值来规划
| 三次运行全程 | |
|---|---|
| 健康状态 | 每个样本都是 HEALTH_OK,每个 PG 都是 active+clean,没有 OSD 重启 |
| 使用中的大页 | 从头到尾 4 GiB |
| 主机还能分出去的内存,跑着一台 16 GiB 虚拟机 | 3.1 到 4.0 GiB |
大页那一行就是前面预算那一节,只不过这次是在负载下:每个 OSD 512 MiB,另外 12 GiB 从没碰过。
普通内存才是要盯的数字,因为上面那个缓存就是用它做的。 一次读把文件拉进来之后,每个 OSD 都停在大约 2.5 GiB,下面是 Ceph 在一台 58.7 GiB 主机上占着的东西:
| 峰值时 Ceph 的内存,默认 4 GiB 目标 | |
|---|---|
| OSD 进程,八个合计 | 19.9 GiB,每个 2.4 到 2.6 GiB |
| 为 OSD 预留的大页 | 16 GiB,其中用了 4 GiB |
| 监视器和管理器 | 0.3 GiB |
| 合计 | 36.2 GiB,占主机的 62% |
| 主机还能分出去的,跑着一台 16 GiB 虚拟机 | 3.6 GiB |
它确实会还回来,但没有任何我能看出来的时间规律。
它在 19.9 GiB 停了 25 分钟,空闲间隙也算在内,然后在最后一次运行结束时降到 13.9 GiB,主机又有 10.2 GiB 可以分出去了。
这期间 osd_memory_target 一直是默认的每个 OSD 4 GiB,所以还没算一个大页,八个 OSD 就有权占 32 GiB。
在一个同时要跑虚拟机的节点上,峰值才是在盘之前就要算清楚的预算,也是那 12 GiB 闲置大页最伤人的地方。
同时跑三台虚拟机,预算更紧
一台虚拟机还宽裕得很。三台,预算就得算对了。 所以先改了两项设置。
ceph config set osd osd_memory_target 1073741824   # 1 GiB per OSD, was 4
sysctl -w vm.nr_hugepages=2048                     # what eight OSDs use, was 8192
目标值不需要别的操作:每个 OSD 几秒内就报告了新值,但还是一个一个地重启了,每次都等全部 257 个 PG 回到 active+clean 再重启下一个。
大页有个坑。
每个 OSD 启动之前,croit-flashstore-prep 都要有一整份 --mem,也就是 2048 MiB 空闲,不够就把池扩大,但它从不再缩回去。
削减之后重启 osd.7,池立刻又涨回去了:
croit-flashstore-prep[7]: hugepages 2048kB: free 256 < need 1024, nr_hugepages 2048 -> 2816
所以能扛过重启的下限,是 OSD 实际用的量加上一次启动的余量:2,816 页,5.5 GiB,而检查要求的是 16 GiB。 后面的安装脚本现在预留的正是这么多。 八个全部起来之后再削回 2,048,在下次重启之前还能再省出 1.5 GiB。
然后用这台虚拟机克隆出三台,每台 10 GiB,同时跑 CrystalDiskMark:Real World Performance [+Mix],三遍,但每台用 1 GiB 的文件而不是 16 GiB。 这让读那一列比以往更像缓存数字,所以看写。
| CrystalDiskMark,三台虚拟机同时 | VM 104 | VM 105 | VM 106 | 三台合计 | 单台虚拟机 |
|---|---|---|---|---|---|
| SEQ1M Q1T1 写 | 346.99 MB/s | 318.99 MB/s | 446.98 MB/s | 1,113 MB/s | 580.08 MB/s |
| SEQ1M Q1T1 读 | 796.05 MB/s | 905.03 MB/s | 1,160.93 MB/s | 2,862 MB/s | 1,852.32 MB/s |
| RND4K Q1T1 写 | 1,901 IOPS | 1,928 IOPS | 1,862 IOPS | 5,691 IOPS | 2,435 IOPS |
| RND4K Q1T1 写延迟 | 524.56 µs | 517.00 µs | 535.42 µs | 409.77 µs | |
| RND4K Q1T1 读 | 3,773 IOPS | 3,916 IOPS | 3,909 IOPS | 11,598 IOPS | 5,706 IOPS |
| RND4K Q1T1 混合 | 2,978 IOPS | 3,027 IOPS | 3,411 IOPS | 9,416 IOPS | 3,936 IOPS |
三台虚拟机拿到的小写入是一台的 2.3 倍,每台为此在延迟上付出了大约 27%。 原因仍然不在 Optane。 它们峰值每秒 20,900 次写入,每次 17 µs,和一台虚拟机时一样是 17 µs,八块里最忙的那块也只有 14% 繁忙。
| 主机,运行全程每五秒 | 默认 4 GiB 目标,一台虚拟机 | 1 GiB 目标,三台虚拟机 |
|---|---|---|
| 最大的 OSD 进程 | 2.7 GiB | 峰值 1.15 GiB,之后 0.8 |
| 八个 OSD 进程合计 | 19.9 GiB | 峰值 8.0 GiB,之后 5.8 |
| 预留的大页 | 16 GiB,用了 4 | 4 GiB,全部用上 |
| 分给虚拟机的内存 | 16 GiB | 30 GiB |
| 主机还能分出去的内存,最低时 | 3.1 GiB | 14.8 GiB |
| swap 增长 | 无 | 无 |
所以 FlashStore 确实守着 osd_memory_target。
它在一遍读的峰值时超出 15%,然后又回到目标之下,缓存是在预算之内干活,而不是在预算之外。
靠目标值加上削减大页,同一台机器上有 26 GiB 回到了虚拟机手里。
| 三台虚拟机时的 CPU,单位为核 | 主机繁忙 | OSD | 客户机 | librbd 和 Ceph 客户端 | QEMU |
|---|---|---|---|---|---|
| 三台 Fisher-Price OS (Windows) 启动 | 81 到 89% | 3.4 到 3.6 | 6.3 到 7.9 | 0.4 到 0.7 | 0.3 |
| 跑分 | 42 到 73% | 3.7 到 4.5 | 1.2 到 4.0 | 0.4 到 1.6 | 0.2 到 0.4 |
| 之后空闲 | 20 到 24% | 3.3 | 0.3 | 0 | 0 |
启动三台客户机比给它们跑分更费 CPU。 底下的存储从没接近过上限,这就是迷你主机在设限,本来也注定如此。
全部内容,一个脚本
上面的一切都在一个脚本里。 给它你想做成 OSD 的盘的 PCI 地址,剩下的它按本文的顺序做完,两处 Proxmox 修复也内置了。
flashstore-pve-setup.sh:在 Proxmox VE 节点上部署 FlashStore OSDlspci -D -d ::0108 # find the drives
bash flashstore-pve-setup.sh --dry-run 0000:05:00.0 # show the plan, change nothing
bash flashstore-pve-setup.sh 0000:05:00.0 0000:06:00.0
| 它检查 | 它写入 | 它运行 |
|---|---|---|
| Proxmox VE 9 和 Ceph 21.2.0 Umbrella | bootstrap-osd 密钥环 | 以 ceph 身份做一次直通读,以选择 kernel-cmd 或 kernel |
| 每块盘:NVMe、无写缓存、未挂载、未分区、未被占用 | 先 root 后 --setuser 的 drop-in | 每块盘执行 prepare 和 systemctl enable --now |
| FlashStore 自己的探测会读的区域里没有数据 | 每块盘一条 udev 规则,按序列号匹配 | 主机检查,只在 OSD 需要的项目上停下 |
| 4 KiB 块 | 每块盘一节 [osd.N],每个一个物理核 | 下载软件包,并对照发布的 SHA-256 校验 |
除非你要求,否则什么都不会被销毁。
--format-4k 会重新格式化不是 4 KiB 的盘,一次一块,各自放在自己的服务单元里,什么都打断不了它;--wipe 允许它覆盖有数据的盘。
--single-node 会加上 replicated_osd 规则,再跑一次会跳过已经是 OSD 的盘。
它在这里测过,不只是写出来而已。
它因为写缓存拒绝了 SN750,在 osd.7 的盘上还有存储时拒绝了它;然后在 osd.7 被清除、节点交还给 root 之后,用 10.5 秒从零重建了它,自己选了 kernel 后端。
它不做的事是安装 Ceph。
那一步要你接受一个 Technology Preview,这是你的决定,不是脚本的。
该修的地方
这些都拦不住一个铁了心的管理员,但每一样都能拦住一个忙碌的管理员。 每一项都是 croit 对任何下载这个软件包的人做出的说明,而每一项我第一次尝试就撞上了。
| 位置 | 发生了什么 | 怎么修 |
|---|---|---|
| systemd 服务单元 | User=ceph 读不了 pmxcfs,所以在 pveceph 节点上 OSD 永远起不来 | 发布先 root 后 --setuser 的启动方式,或者一个 Proxmox 用的 drop-in |
| kernel-cmd 回退 | 只在 Identify 被拒时回退;在 PVE 的内核上被拒的是 Read,OSD 直接停下 | 任何直通 I/O 被拒都回退到直接 I/O |
| udev | 文档要求一条把命名空间节点交给 ceph 的规则;但没有随包提供 | 提供一条,按配置的设备来写 |
--check 汇总 | 说内核 NVMe 是 “compiled out”,而它恰是唯一编译进去的存储路径 | 改正这个标签 |
--check 退出码 | 启动 SSD 过不了 PLP 测试,所以退出码 0 根本达不到 | 只给已配置或候选的设备打分 |
| 大页 | 按每个 OSD 2048 MiB 计算,且 prep 每次启动都要这么多空闲;内核后端只用 512 | 内核后端按实际用量计算,prep 也只要求同样多 |
sha256sums.txt | 文件名和发布的文件对不上 | 按发布时的名字写 |
| 软件包名 | 文档说 apt remove flashstore;软件包叫 croit-flashstore-osd | 统一一个名字,或者在文档里写对 |
flashstore_dev 参考 | 只列了 spdk: 和 file: | 写明 kernel:,以及带内核后端的 spdk: |
这些都不是新工作。 守护进程已经有了降权、直接后端和回退逻辑。 只是还没在大多数人会首先拿来试的那个平台上把它们串起来。
预览版就是让你发现这些的地方
上面每一项发现,放在预览版里都是对的地方,但留在那里就是错的。 预览版就是干这个的:有人把它带回家,装在自己实际有的硬件上,把它在哪儿摔倒记下来。 要紧的部分都扛住了。 存储几毫秒就起来了,OSD 加入了一个用别人的工具搭起来的集群,一整个操作系统装到它们上面,一个故障都没出。
绊倒它的是守护进程周围的一切。 一个放在服务单元读不了的文件系统上的配置文件,一个对上游允许的调用说不的内核,一块检查死活不肯不算的启动盘。 这些都不难。 可这一切正是 “能用的软件” 和 “在你机器上能用的软件” 之间的差别,而唯一能填平它的办法,是在人们手里实际有的机器上测,而不是在你专门为它搭的机器上测。
话虽如此,这是个有希望的开端。 在一台破烂迷你主机上,客户端还是经典的 librbd,八块盘全挤在一条 PCIe 3.0 链路上,Optane 在这里被压榨得比在 BlueStore 下还狠。 随着它的发展,我会回来更深入地挖,随着更多技术栈被替换,还会看看 CephFS2。
“即插即用” 是对一个没时间读源码的管理员许下的承诺。 Proxmox 的监视器、Proxmox 的 GUI、Proxmox 的内核,再加上别人家的软件包,正是这个承诺所针对的情形。 它现在差一点就兑现了。 九处小修复,它就能兑现;我宁可做那个周三早上把它们找出来的人,也不愿做那个周五晚上才撞上它们的客户。
croit/ceph-rust README — 自2026年11月9日起公开预览,“not yet recommended for production data”,硬件要求、快速入门、生产特性集、测试过的 Ceph 提交。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
croit/ceph-rust release snapshot-2026-11-10 — 本文用到的软件包,包括
flashstore_…_debian-trixie_amd64.deb和sha256sums.txt。 ↩︎ ↩︎croit/ceph-rust — hardware requirements — 易失写缓存检查、大页、内核版本说明。 ↩︎
croit/ceph-rust — branches and versions —
main针对 v21.2.0,v20.2.4针对 v20.2.4;“The daemon refuses a cluster release outside its supported window.” ↩︎ ↩︎Proxmox pve-manager, PVE/Ceph/Releases.pm —
umbrella以release => '21.2'和unsupported => 1列出。 ↩︎croit/ceph-rust — build and install packages — 支持的发行版、glibc 2.34、
ceph-osd.target的处理、apt remove那一行。 ↩︎ ↩︎ ↩︎croit/ceph-rust — configuration reference —
flashstore_dev、flashstore_lcores、flashstore_report_objectstore,以及它为什么默认为bluestore。 ↩︎ ↩︎croit-flashstore-osd Cargo.toml — 第 29 行,
knet = [… "kernel-nvme"]。 ↩︎croit/ceph-rust — first OSD tutorial — 只读的主机检查;“Exit 0 means no FAIL.” ↩︎ ↩︎
croit/ceph-rust — ADR 0169, kernel NVMe backend — 两种内核模式、实测对比、负载分配器预算、
spdk:地址解析,以及仅针对 Identify 的回退(修订 6)。在发布当晚加入仓库。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎Proxmox VE — Proxmox Cluster File System (pmxcfs) —
/etc/pve下的集群文件系统,及其固定的属主和权限。 ↩︎croit-flashstore-osd@.service —
User=ceph、ExecStartPre=… activate,以及不含CAP_DAC_OVERRIDE的CapabilityBoundingSet。 ↩︎ ↩︎croit-flashstore-osd privdrop.rs — 经典的
--setuser/--setgroup降权。 ↩︎croit/ceph-rust — prepare the host — “the namespace node must be readable and writable by user
ceph(udev rule)”。 ↩︎Linux v7.0, drivers/nvme/host/ioctl.c —
nvme_cmd_allowed(),非特权 NVMe 直通的规则。 ↩︎croit/ceph-rust — security — “
preparedefaults--keyringto/var/lib/ceph/bootstrap-osd/<cluster>.keyring”。 ↩︎croit/ceph-rust — prepare, activate and list — 非空设备探测和
--wipe。 ↩︎Proxmox pve-manager, PVE/API2/Ceph/OSD.pm — 只有元数据带
bluefs时osdtype才是bluestore,否则是filestore。 ↩︎Proxmox pve-manager, PVE/Ceph/Services.pm —
ceph_service_cmd()把osd.N映射到 systemd 服务单元ceph-osd@N。 ↩︎Ceph documentation — CRUSH maps — 副本规则、故障域和设备类别。 ↩︎
CrystalDiskMark — Crystal Dew World 的磁盘基准测试工具;“Various measure mode (Peak/Real World/Demo)”。 ↩︎
Proxmox VE wiki — Performance Tweaks — 磁盘缓存模式:“cache=none seems to be the best performance and is the default since Proxmox 2.X”。 ↩︎