这篇文章里的所有内容,都是在我自己桌上的一套 NetBox 4.7.2 上跑出来的,里面装着一整套真实资产:一个站点、一个机柜、十四台设备,接好了线、通好了电、分好了地址,分属三个客户。每张截图都来自这套实例,每条错误信息都是我真遇到过的。
内容按你实际碰到它的顺序展开。这东西是什么,你为什么想要一套,你搜索不出一个星期就会听说的那次分叉,怎样搭起一套,必须按什么顺序录入,然后你能从里面拿回什么。定制和扩展的部分放在最后,因为在你看清要扩展的东西长什么样之前,那些内容都说不通。
NetBox 是什么
NetBox 是一个数据库,它对网络由什么构成有一套非常明确的看法,上面再加一个 Web 应用。它是跑在 PostgreSQL 上的 Django 应用,自 2016年6月 DigitalOcean 发布以来一直以 Apache 2.0 许可开源,如今由 NetBox Labs 和一支志愿维护者团队共同管理。12
往下看,它是分布在十个应用里的 149 个模型,通过 146 个 REST 端点和一个 GraphQL 端点访问。这些数字是从我为这篇文章搭建的实例里数出来的,不是从功能介绍页上抄的:
| 应用 | 模型数 | 应用 | 模型数 |
|---|---|---|---|
| dcim | 56 | virtualization | 7 |
| extras | 23 | tenancy | 6 |
| ipam | 18 | wireless | 3 |
| circuits | 11 | users | 7 |
| vpn | 10 | core | 8 |
其中五十六个属于 DCIM,也就是物理层:站点、位置、机柜、设备类型、设备,以及设备可能拥有的每一种端口、槽位和线缆端接。十八个属于 IPAM。其余的覆盖线路、隧道和 IKE 策略、虚拟机和集群、无线链路、租户,以及让整个系统可扩展的那套机制。
数量不是重点。重点是它们之间的关联,而看清这一点最快的办法,就是 NetBox 最出名的那个页面。
从机柜开始,因为这个页面最能把它卖出去。
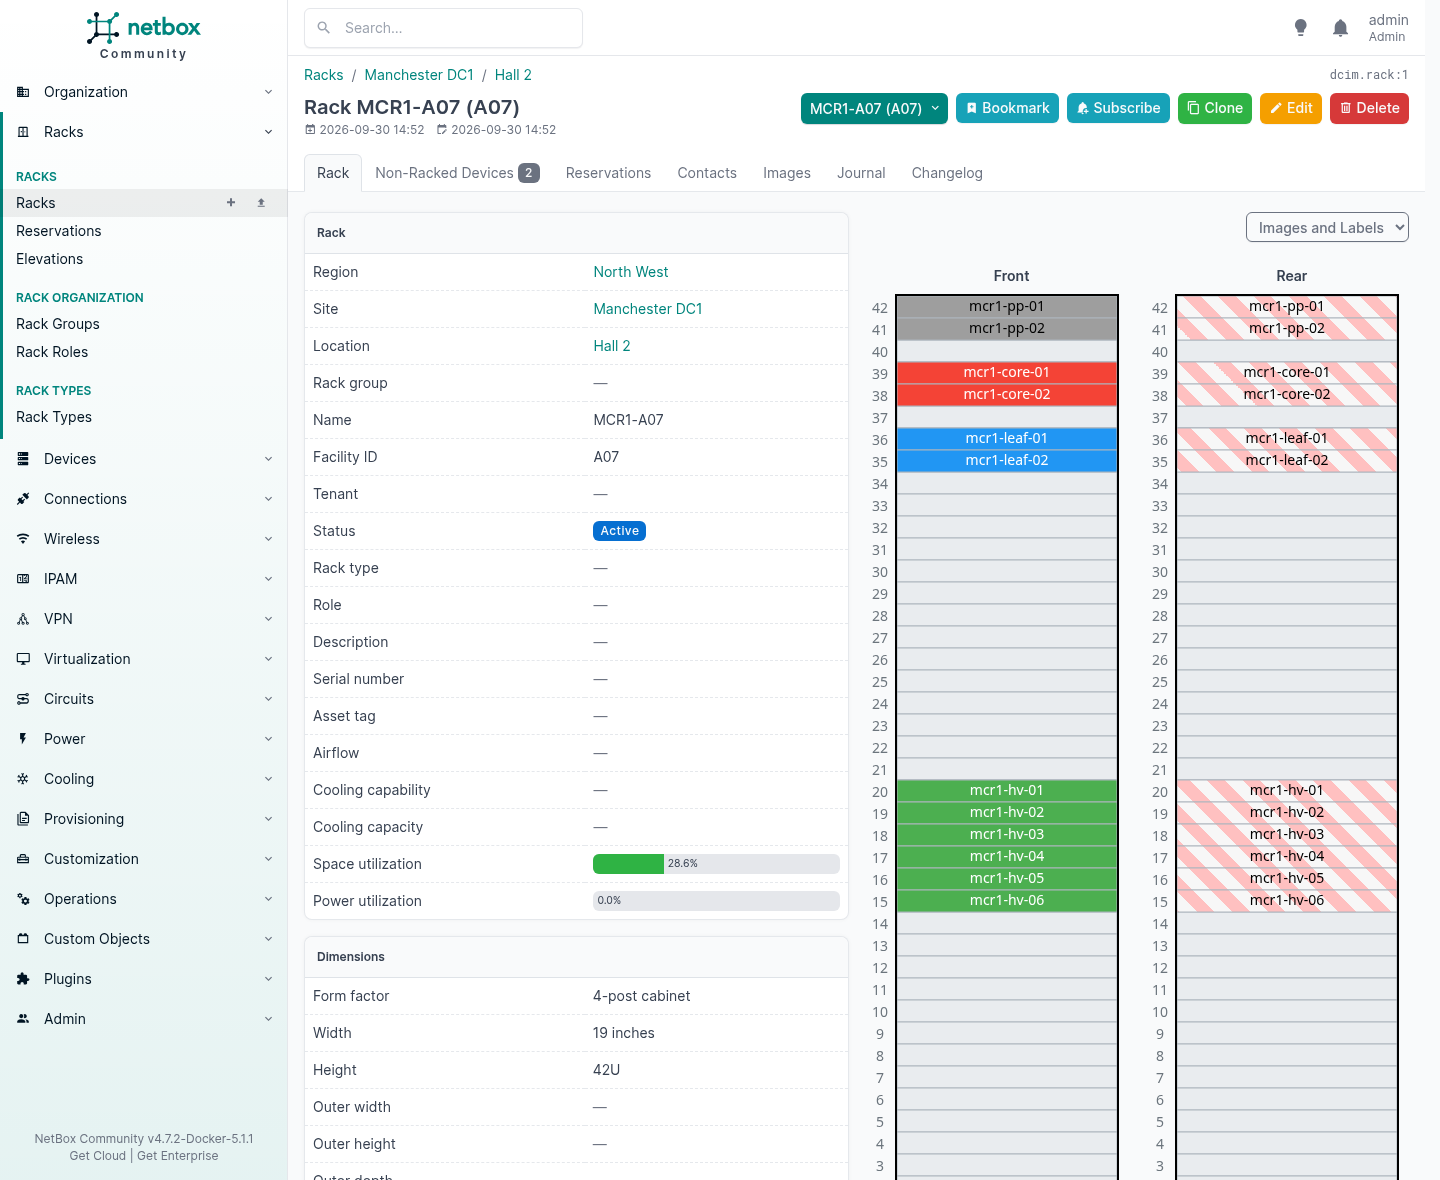
这张立面图是从数据画出来的,不是上传的图片。每台设备之所以出现在那里,是因为有记录说它占用了那几个 U、朝那个方向,颜色来自你给它分配的角色。空间利用率显示 28.6%,是因为 NetBox 算出来的。没有人去维护这个数字。
由此引出的两件事,比这张图本身更值钱。
你可以问哪些 U 是空的,并得到一个能直接拿来用的答案。你还可以在任何东西装进去之前预留这些 U,这就是“卖你真有的空间”和“卖你以为有的空间”之间的区别。
它刻意不做的事
一个清楚自己不是什么的产品,比一个什么都做却什么都做不好的产品要少见得多,而 NetBox 自己的文档在这一点上说得很直白。它不提供网络监控、DNS 服务、RADIUS、配置管理或设施管理。1
更重要的是,它保存的是你网络的期望状态,而不是运行状态,文档还说自动导入实时网络状态是“strongly discouraged”(强烈不建议的),因为每一条记录都应该先经过人工审核。1
其他一切都建立在这个决定之上,也正是这个决定招来最多争论。争论是这样的:真相来源难道不该就是真相吗?那就去发现网络,把结果导进来。回答是:发现出来的网络告诉你那里有什么,而那里有的东西包括任何人犯过的每一个错误。2021 年留在错误 VLAN 里的一个交换机端口是一个事实。它不是一个意图。
NetBox 保存意图。你的监控系统保存现实。真正有意思的数字是两者之间的差,而你没法只用一个输入算出差值。
另一条原则同样说得很直白:在一个相对简单、能解决百分之八十问题的方案和一个复杂得多的完整方案之间,选简单的那个。1 你第一次想建模某个它不支持的东西时就会体会到这一点,文章快结尾的地方有一整串章节讲碰到这种情况时该怎么办。
| NetBox 做的 | NetBox 不做的 |
|---|---|
| 记录应该在那里的东西 | 轮询实际在那里的东西 |
| 保存某个端口应有的 VLAN | 告诉你这个端口挂了 |
| 说明某个前缀属于哪个客户 | 向客户收费 |
| 用模板渲染设备配置 | 把配置推到设备上 |
| 跟踪线路、运营商和承诺带宽 | 监控线路 |
| 说明设备在哪个机柜、哪个 U | 打开机柜门 |
把右边那一栏当成你仍然需要的工具清单来读。读错了,你就会想把 NetBox 变成所有这些工具,而真相来源就是这样变成又一个没人信任的系统的。
你为什么需要一套
问一家托管服务商(MSP),某个客户网络的权威记录放在哪里,你会得到一个答案。分别去问他们的两个工程师,你会得到两个答案。
一个会指着一张电子表格。一个会指着一张网络图,最后一次保存它的人 2023 年就离职了。还有人会说防火墙配置就是文档,这话至少诚实,因为配置确实描述了一台设备在干什么。只是它没说为什么,没说是谁要求的,也没说那台设备后面的四个客户里,到底是哪一个在为这条规则付钱。
出问题从来不是在你发现记录错了的那天。而是在有人需要它的那天。
| 时刻 | 你必须拿出来的东西 | 拿不出来的代价 |
|---|---|---|
| 续约谈判 | 一份逐项列明月费到底买了什么的清单 | 竞争对手的报价是逐项列明的,因为他们真的去数过 |
| 有工程师递了辞呈 | 他知道的一切,写下来 | 六个月的摸索,一张工单一张工单地发现 |
| 有客户要走 | 一份对他们自己资产的描述 | 三周时间去拼凑,外加一个他们会如实给出的评价 |
| 审计员问范围问题 | 哪些系统存有个人数据,它们物理上在哪 | 告诉了监管机构一些后来被证明不属实的话 |
| 一次迁移需要报价 | 实际在那里的东西的数量 | 你按估算报价,差额自己吞 |
这些都不稀奇。它们就是平常的某个星期二。
你从中得到的不是文档。文档是你写完之后就不再维护的东西。你得到的是一个拒绝容纳矛盾的数据库,它能回答没人事先想到要问的问题。这篇文章后面有一个机柜,结果发现设备只装了 28.6%,电力却用了 90.7%。没有人专门去找这件事。它只是因为有人在一个设备类型上填过一次功率,就自己冒了出来。
老实的提醒也一并奉上,最后一节讲的就是这个。一份记录的价值,只等于你为保持它正确所付出的成本。但另一种选择是一个连自己都描述不清的企业,而第一个发现这一点的,通常是客户。
另一个:Nautobot
你搜索不出一个星期就会碰到它,所以值得知道当时发生了什么。
2021 年,Network to Code 分叉了 NetBox,把结果叫做 Nautobot。不是软分叉,也不是一个发行版:是一个已经分道扬镳五年的硬分叉。它自己的 v1.0 发布说明把它描述为“a divergent fork of NetBox 2.10”(NetBox 2.10 的一个分歧分叉),代码仓库创建于 2021年2月19日,v1.0.0 于 2021年4月26日发布。3
他们陈述的理由就在他们自己的博客上,值得读他们的原话,而不是我的转述。推动这件事的有三点。他们想卖企业级支持:“We need to offer high-touch support models with Service Level Agreements (SLAs) we can guarantee. We need flexibility to offer Long-term Support (LTS) for customers who can’t upgrade at the pace of a fast moving open source project.”他们想让真相来源处在一个自动化平台的中心,而不是只为文档服务。还有,“there became a growing divergence in our vision about what a Source of Truth for networking should look like and how to get there”。4
第一条理由需要标上日期,因为它已经不成立了。2021年2月,NetBox 背后没有任何公司能卖给你东西。NetBox Labs 直到 2023 年才成立,是在 IBM 收购 NS1 之后从 NS1 分拆出来的,联合创始人之一就是 NetBox 自己的首席维护者。5
而且它不是一个靠别人的项目做起生意的第三方。NetBox Labs 是 NetBox 的管理方:项目自己的文档写着“the open source project is stewarded by NetBox Labs and a team of volunteer maintainers”。1 他们为自行管理的部署销售 NetBox Enterprise,以 NetBox Cloud 的形式替你托管,并提供 7×24 支持。6
所以,“你买不到 NetBox 的支持”这句话,在 Network to Code 分叉的时候说是公道的,现在再说就不公道了。两个项目背后都有一家愿意签合同的商业公司,而在 NetBox 这边,那家公司就是项目的管理方。
大多数人漏掉的是下一句,而正是这一句让这件事不是一个龌龊的故事:“the NetBox project team suggested that we should consider forking.”(是 NetBox 项目团队建议我们考虑分叉。)
一次分叉能做到的文明程度,也就到这儿了。两拨人想要不同的东西,在很长一段时间里把话说开了,然后分开,而不是在同一套代码上打架。两边都还是 Apache 2.0。没有人拿走任何他们无权拿走的东西。
这次分叉到底是为了什么
Nautobot 1.0 的发布说明列出了它相对 NetBox 2.10 增加了什么,这份清单比任何博客文章都更能说明这场争论:3
| Nautobot 在 2021 年增加的 | NetBox 现在的情况 |
|---|---|
| GraphQL 支持 | NetBox 已经有了 |
| 以 Git 集成作为数据源 | NetBox 已经有了,叫同步数据源 |
| 单点登录 | NetBox 已经有了 |
| 密钥管理(Secrets) | NetBox 通过插件提供 |
| 脚本和报表合并为 Jobs | NetBox 在 4.7 中正把脚本移到一个插件里 |
| 所有模型都支持自定义字段 | NetBox 有广泛的自定义字段支持 |
| 数据校验插件 API | NetBox 有自定义校验规则 |
| 可定制的状态,作为数据库对象 | NetBox 的状态仍然是 Python 选项集 |
| 用户自定义的模型间关系 | NetBox 没有对应功能 |
| UUID 主键 | NetBox 用整数主键 |
| 插件 API 增强 | NetBox 的插件框架此后已经成长了很多 |
上半部分大多已经趋同。Nautobot 在 2021 年推出的好几样东西,后来都出现在了 NetBox 里,两个项目在公开场合解决同样的问题时,通常就是这样。
下面三项没有趋同,而且它们是架构层面的,不是表面功夫。我今天亲自查了两边的代码,而不是相信 2021 年的发布说明。
Nautobot 的 Status 是一个数据库模型,它自己的源码里描述为“Model for database-backend enum choice objects”,所以一个状态就是一行数据,任何人都能在界面里添加。NetBox 的状态来自 Python 选项集,所以下面 FIELD_CHOICES 那一节加一个状态,要靠编辑 configuration.py 再重启。Nautobot 有 Relationship 和 RelationshipAssociation 模型,所以你可以不写代码就在两个现有对象类型之间定义关系。NetBox 对这个问题的回答是插件,下面还有一串专门讲它的章节。另外,Nautobot 的主键是 UUID,而 NetBox 的是整数。
他们也确实做到了分叉时想做的事。到今天为止,Nautobot 在同一天发布 3.2.x 和 2.4.x,这是一条货真价实、与当前版本并行的长期维护线,而这正是当初陈述的三个理由之一。
选哪个
先看老实的数字。NetBox 有 21,625 个 star 和 3,133 个 fork;Nautobot 有 1,617 和 422。7 两者都在最近两天内有过推送,都是 Apache 2.0,现在背后也都有一家商业公司在卖支持和托管。
这个差距不是对质量的裁决。它反映的是五年的先发优势,以及大多数需要真相来源的人先找到的是 NetBox。但它确实决定了那件通常比功能更要紧的事:你选的那个,能找到多少插件、集成、Ansible 模块、论坛答案和同行。
所以:如果你要的是一份清单,一个供其他系统读取的真相来源,还想要最大的生态和最容易招到人,答案是 NetBox,这篇文章剩下的部分讲的也就是它。如果你想要真相来源的理由,明确就是要用它来驱动自动化,或者你希望状态和关系由你的团队来定义,而不是靠一个配置文件加一次重启,那就在做决定之前好好看看 Nautobot。
别让任何人光凭支持就把其中哪一个卖给你。现在两边都有支持了,而五年后依然存在的差别,就是上面那张表里的那些。
你不该做的,是因为有人告诉你另一个已经死了就选这一个。两个都没死,这个星期两边都还在发布新版本。
把它跑起来
两条路,为了写这篇文章我两条都走了一遍。想二十分钟内跑起来就用容器;如果它要承担关键业务,就在主机上用软件包装。
容器栈
社区维护着 netbox-docker,这是最快的答案:8
git clone -b release https://github.com/netbox-community/netbox-docker.git
cd netbox-docker
tee docker-compose.override.yml <<'EOF'
services:
  netbox:
    ports:
      - 8000:8080
EOF
docker compose pull
docker compose up
这样你就得到应用、PostgreSQL、Redis 和一个后台工作进程,全都连好了。我在 podman 下手工搭了一套一样的,好看清楚各个部件,而这些部件值得了解,因为其中两个会坑人:
| 容器 | 做什么 | 如果你漏掉它 |
|---|---|---|
netbox | 跑在 gunicorn 后面的 Django 应用 | 什么都不工作 |
postgres | 数据库,15 或更高版本 | 什么都不工作 |
redis / valkey | 两个数据库:一个放任务,一个做缓存 | 什么都不工作 |
netbox-worker | rqworker,负责消费任务队列 | webhook 永远不触发,后台任务永远不运行,而且没有任何警告 |
netbox-housekeeping | 定期清理 | 变更日志记录永不过期 |
关键就是第四行。没有工作进程,一切看起来都很健康。事件规则排进队列,然后就停在那儿。
第一次运行时有两件事咬了我,而且两件都不会出现在你会去搜索的错误信息里。
第一次迁移要花很长时间。 不是一分钟。在这台机器上是好几分钟,因为 NetBox 4.7 用 PostgreSQL 的 ltree 替换了 django-mptt,迁移过程中会重建每一张层级表。容器就那么待着应用迁移。别去动它。
没有 API_TOKEN_PEPPERS 就没法创建 v2 API 令牌,唯一的迹象是日志里的一条警告:
UserWarning: API_TOKEN_PEPPERS is not defined. v2 API tokens cannot be used.
至少设一个,长度至少五十个字符,然后再去查 API 为什么拒绝你。
在主机上,用软件包装
官方文档的路线是在 Ubuntu 24.04 上测试过的。我在一台干净的 24.04 上从头跑到尾,最后得到的是这些:
| 组件 | 24.04 给我的版本 | NetBox 4.7 需要的版本 |
|---|---|---|
| PostgreSQL | 16.15 | 15 或更高 |
| Redis | 7.0.15 | 6.0 或更高 |
| Python | 3.12.3 | 3.12、3.13 或 3.14 |
| Django | 6.1.1 | 随 NetBox 一起提供 |
| NetBox | v4.7.2 |
这些最低要求是 NetBox 自己定的,4.7 同时提高了 PostgreSQL 和 Redis 的下限。9
整个过程就五步。
# 1. the services
sudo apt install -y postgresql redis-server
sudo -u postgres psql -c "CREATE DATABASE netbox;"
sudo -u postgres psql -c "CREATE USER netbox WITH PASSWORD 'something-you-generated';"
sudo -u postgres psql -c "ALTER DATABASE netbox OWNER TO netbox;"
sudo -u postgres psql -d netbox -c "GRANT CREATE ON SCHEMA public TO netbox;"

# 2. the build dependencies
sudo apt install -y python3 python3-pip python3-venv python3-dev build-essential   libxml2-dev libxslt1-dev libffi-dev libpq-dev libssl-dev zlib1g-dev git

# 3. the application, at a release tag rather than at main
sudo mkdir -p /opt/netbox && cd /opt/netbox
sudo git clone https://github.com/netbox-community/netbox.git .
sudo git checkout v4.7.2
sudo adduser --system --group netbox
sudo chown -R netbox /opt/netbox/netbox/media/ /opt/netbox/netbox/scripts/ /opt/netbox/netbox/reports/

# 4. the configuration: five values, no more
cd /opt/netbox/netbox/netbox/
sudo cp configuration_example.py configuration.py
python3 /opt/netbox/netbox/generate_secret_key.py   # run it twice
sudo $EDITOR configuration.py

# 5. let the upgrade script do the rest
sudo /opt/netbox/upgrade.sh
那五个值是 ALLOWED_HOSTS、DATABASES、REDIS、SECRET_KEY 和 API_TOKEN_PEPPERS。最后两个要分别生成,不要一个当两个用。也就是说,密钥生成器跑两次,把结果粘到不同的行里。
upgrade.sh 会建好虚拟环境,装好所有 Python 依赖,跑迁移,构建离线文档,收集静态文件。在一台新机器上跑完时,它会打印一条看着吓人、其实没事的警告:
WARNING: No existing virtual environment was detected. A new one has
been created. Update your systemd service files to reflect the new
Python and gunicorn executables. (If this is a new installation,
this warning can be ignored.)
然后建一个超级用户,它就跑起来了:
source /opt/netbox/venv/bin/activate
cd /opt/netbox/netbox && python3 manage.py createsuperuser
凡是正经用途,都应该在前面放 gunicorn,而不是用 runserver。配置文件和 unit 文件已经在仓库里了,这个细节值得知道,因为很多人会自己去写:
sudo cp /opt/netbox/contrib/gunicorn.py /opt/netbox/gunicorn.py
sudo cp -v /opt/netbox/contrib/*.service /etc/systemd/system/
sudo systemctl daemon-reload
sudo systemctl enable --now netbox netbox-rq
netbox.service 在 127.0.0.1:8001 上跑 gunicorn,netbox-rq.service 跑工作进程,前面再放 nginx 或 Apache 来终结 TLS 并提供 /static。两个服务,第二个就是容器栈里需要的那个工作进程。
必须按什么顺序录入
一套全新的 NetBox 是一个带着主见的空数据库,用它的头一个小时,通常都花在弄清这些主见是什么上。你去添加一台设备,它不让你加。
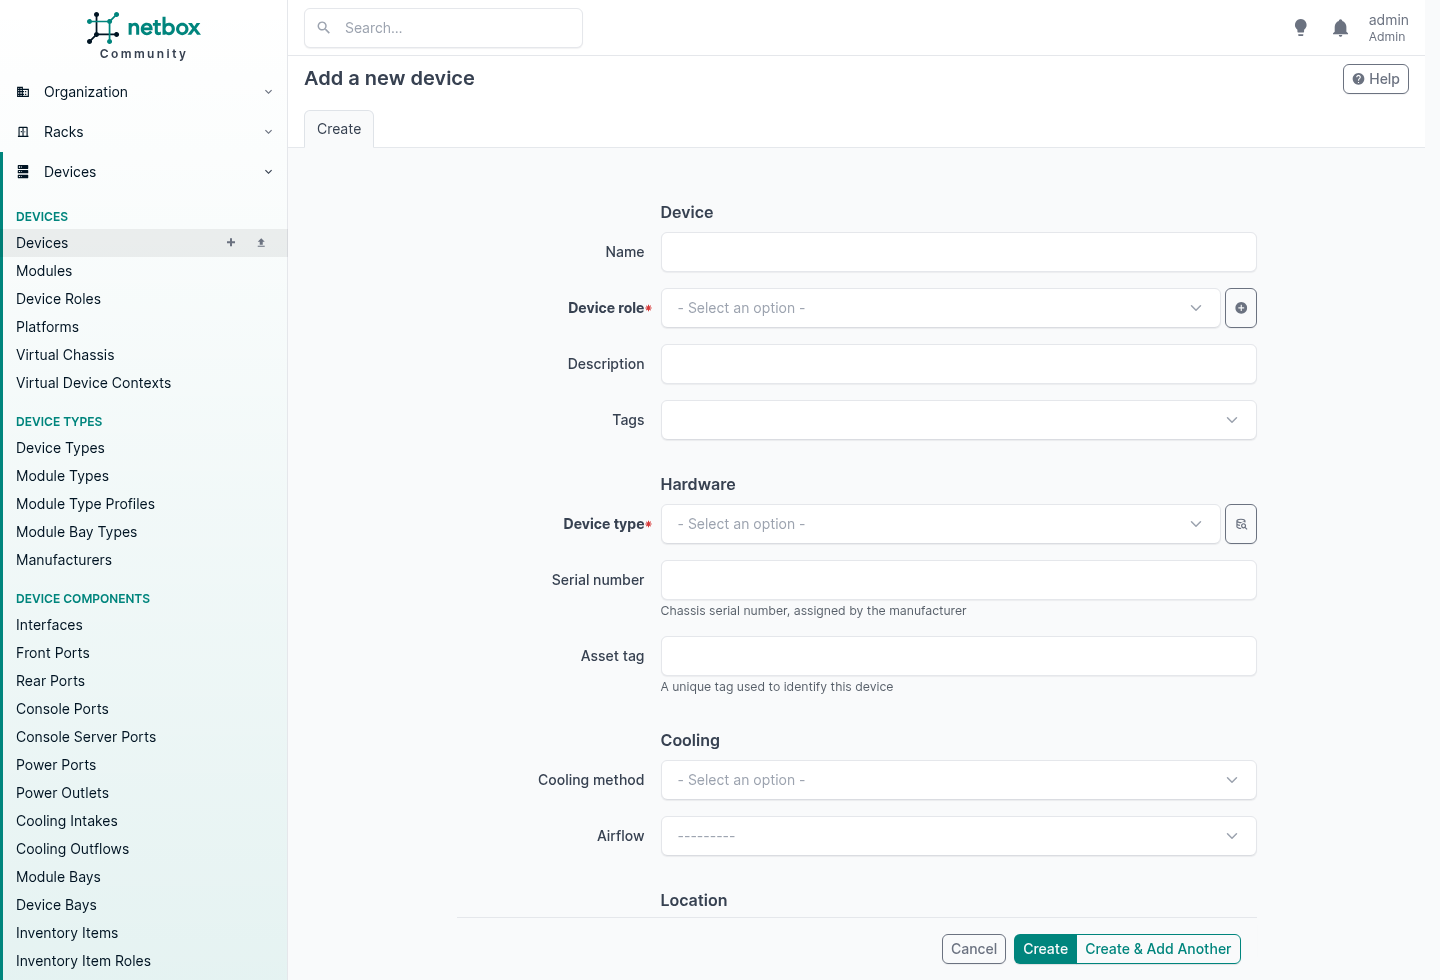
那些红色星号就是全部的教训。NetBox 不会在一样东西所依附的东西存在之前记录它,这不是故意刁难:一台没有类型的设备,是一行回答不了任何设备该回答的问题的数据。
所以我没有去猜,而是问了模型哪些外键真正是必填的,然后通过 API 逐条去破坏这些规则,看看会返回什么。
POST /api/dcim/device-types/   no manufacturer
  {"manufacturer": ["This field is required."]}
POST /api/dcim/devices/        no device type
  {"device_type": ["This field is required."]}
POST /api/dcim/interfaces/     no device
  {"device": ["This field is required."]}
POST /api/ipam/aggregates/     no RIR
  {"rir": ["This field is required."]}
POST /api/circuits/circuits/   no provider, no type
  {"provider": ["This field is required."], "type": ["This field is required."]}
POST /api/virtualization/virtual-machines/   nothing at all
  {"__all__": ["A virtual machine must be assigned to a site, cluster, or device."]}
每一次都被拒绝了,而且准确地说出了缺的是什么。下面是把同样的信息整理成一份前置条件清单:
| 要创建 | 必须先有 | 可选,但你最好先建 |
|---|---|---|
| Tenant(租户) | 无 | 一个 Tenant group |
| Region、Site group | 无 | 同类的上级,它们可以嵌套 |
| Site(站点) | 无 | 一个 Region、一个 Site group、一个 Tenant |
| Location(位置) | 一个 Site | 一个上级 Location、一个 Tenant |
| Rack type | 一个 Manufacturer | |
| Rack(机柜) | 一个 Site | 一个 Location、Rack group、Rack role、Rack type、Tenant |
| Device type | 一个 Manufacturer | |
| Device role | 无 | 一个上级 Device role,它们可以嵌套 |
| Device(设备) | 一个 Device role、一个 Device type、一个 Site | 一个机柜及位置、一个 Platform、一个 Tenant |
| Interface,以及所有其他组件 | 一台 Device | |
| Cable(线缆) | 两个可端接的东西 | 一个 Tenant |
| Aggregate | 一个 RIR | 一个 Tenant |
| VLAN | 无 | 一个 VLAN group、一个 Role、一个 Tenant |
| Prefix(前缀) | 无 | 一个 Site、一个 VLAN、一个 Role、一个 VRF、一个 Tenant |
| IP address | 无 | 一个可分配的 Interface、一个 Tenant |
| Circuit(线路) | 一个 Provider 和一个 Circuit type | 一个 Tenant |
| Circuit termination | 一条 Circuit | 一个落地的 Site |
| Cluster(集群) | 一个 Cluster type | 一个 Cluster group、一个 Site、一个 Tenant |
| Virtual machine | 一个 Site、一个 Cluster 或一台 Device | 一个 Platform、一个 Tenant |
| VM interface | 一台 Virtual machine |
让你付出代价的是第二栏。前缀、IP 地址、VLAN 和租户什么都不需要,所以第一天就可以按任意顺序创建它们,没有任何东西拦着你。它们有没有用是另一个问题,因为一个后面没有接口的地址只是列表里的一行,而一台没有租户的设备,是你以后还得回头再改的设备。
实际干活的顺序
由此得出一个顺序。照着往下做,就永远不会被拒绝。
首先,是其他一切所依附的东西。 这些都不激动人心,而且都很容易弄错,弄错的代价却很低。
- 先租户组,再租户。 在其他一切之前做这个。有二十八个模型带租户字段,包括 Site、Location 和 Rack,所以如果客户还不存在,你就没法边建边打上标记,以后只能批量编辑。
- 区域和站点组。 两者都可选,都能自我嵌套,而且彼此独立。区域按地理划分,站点组按功能划分,你可以用其中一个、两个都用,或者都不用。
- 站点。 几乎一切的根。站点什么都不需要,所以它是你真正能创建的第一样东西。
- 位置。 位置需要站点,而且可以嵌套,所以一个机房里有若干排、每排里有若干 pod,就是一个模型套三层。
- 机柜角色和机柜组。 两者都可选。机柜组是扁平的,作为第二条轴和位置并列,用来表示排和 pod 很方便。
- 先厂商,再机柜类型。 机柜类型需要厂商。如果你不对机柜本身建模,就跳过机柜类型。
- 机柜。 机柜需要站点。如果你还给它指定了位置,那个位置必须属于那个站点,NetBox 会检查。
然后是硬件目录,而不是硬件本身。 在你能添加哪怕一台设备之前,你需要厂商、设备类型、设备角色,以及实际上还需要平台。
- 厂商。 你可能在第 6 步已经建了一些,因为机柜类型也需要它们。模块类型同样需要。
- 设备类型,每个都需要一个厂商。
- 设备角色(可嵌套),以及平台。
这是大家会跳过的一步,而正是这一步决定了后面的活要敲多少字。设备类型以模板的形式带着自己的接口、端口和槽位,所以你用它创建的每台设备,一到位就已经带好了正确的组件。类型弄对一次,上架四十台就只是敲四十个名字。
平台是这份清单里的异类,因为设备严格来说并不需要它。还是现在就做。以后承载配置模板和 NAPALM 驱动的就是它,回头再给整套资产补上平台,花掉的会是你本来要花在租户上的同一个晚上。
然后是设备本身。
- 设备。 角色、类型和站点都是必填的。机柜和位置可选,如果填了,就必须和站点一致。
- 组件,如果设备类型没有自带的话。
- 线缆,连接在组件之间。
然后是地址分配,因为地址需要一个接口来落脚,而接口要到第 12 步之后才存在。
- RIR,然后是聚合(aggregate)。
- 前缀和 VLAN 角色、VRF、VLAN 组,然后是 VLAN。
- 前缀,然后是单个的 IP 地址。
然后是商务层。
- 运营商、运营商账户和线路类型。
- 线路,然后把它们端接到站点上。
还有虚拟资产,它和物理资产是镜像关系。
- 集群类型和集群组,然后是集群。
- 虚拟机,需要一个站点、一个集群或一台设备,然后是它们的接口。
第 1 到第 10 步是一个下午的活,感觉像行政杂务。里面一点光鲜的东西都没有。但正是这个下午,决定了第 11 步要花一个上午还是两个星期。
以后才会咬人的规则
必填字段是容易的那一半,因为它们立刻失败,并告诉你原因。真正把人绊倒的是一致性规则,只有当你的数据多到足以自相矛盾时,它们才会触发:
device at Leeds, put in a Manchester rack
  {"rack": ["Rack MCR1-A07 (A07) does not belong to site Leeds Edge."]}
device at Leeds, in a Manchester location
  {"location": ["Location Hall 2 does not belong to site Leeds Edge."]}
rack at Leeds, in a Manchester location
  {"__all__": ["Assigned location must belong to parent site (Leeds Edge)."]}
a second device in a unit that is already taken
  {"position": ["U39.0 is already occupied or does not have sufficient
                 space to accommodate this device type: MX204 (1.0U)"]}
如果有人问我何必费这些劲,我会指着最后那一条。NetBox 知道这台设备是 1U,知道机柜里有什么,不会让你在同一个空间里记录两样东西。你的电子表格会让你这么干一整个下午,一声不吭,等你发现的时候,已经有人抱着箱子站在机房里了。
这些规则都不可配置,也都不应该可配置。它们就是“记录”和“愿望”之间的区别。
用起来:每个页面给你什么
资产录进去之后,下面是你实际能从里面拿回的东西。下面所有内容都来自同一套实例:一个机柜、十四台设备,分属三个客户,接好了线、分好了地址。
设备就是它的组件
点进其中一台虚拟化主机,有意思的标签页不是概要,而是接口。
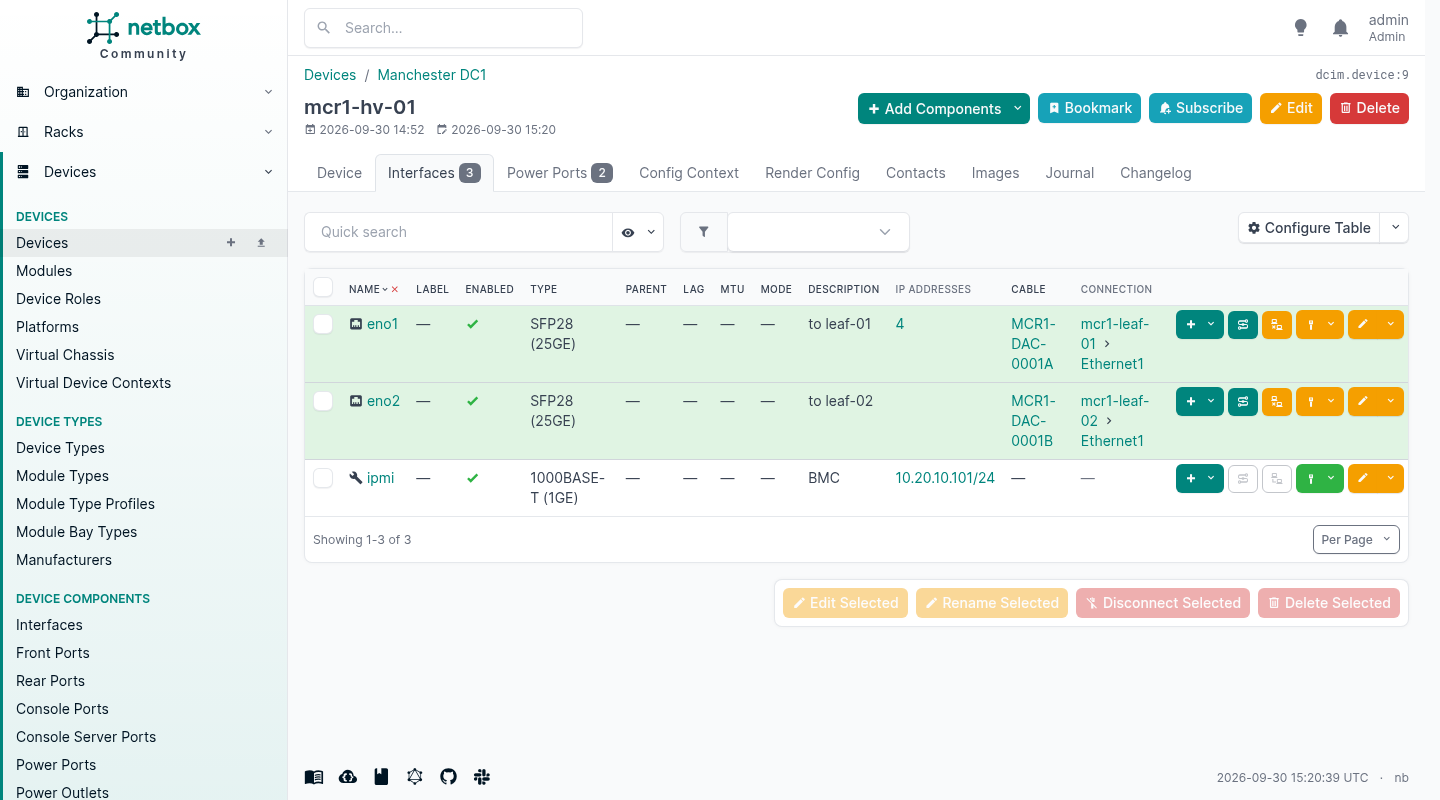
横着读一行。接口、速率、你写给它的描述、上面的地址、线缆上的标签,以及对端的端口。这是一次查询,回答的正是每个人实际会问的那个问题:“这个插在哪儿”。
注意地址挂在哪里。它在 eno1 上,而不是在服务器上。这听起来像抠字眼,直到你碰到一台设备,有一个管理接口、两个数据接口和一个环回接口,然后有人问哪个地址代表它。一个把地址挂在设备上的模型回答不了。这个模型能,而且它还能容纳一个接口上有四个地址这种再平常不过的情况。
顺着线缆走
线缆端接在组件上,而不是设备上。一端是一个接口,另一端是一个接口,或者是前端口、后端口、电源插座、线路端接。整个功能就建立在这个细节上,这也是为什么上面的接口列表不用别人告诉,就能在自己的一栏里打印出对端。
如果你把线缆建模成设备连设备,你只是画了一张图。把它端接在端口上,NetBox 就能顺着走。
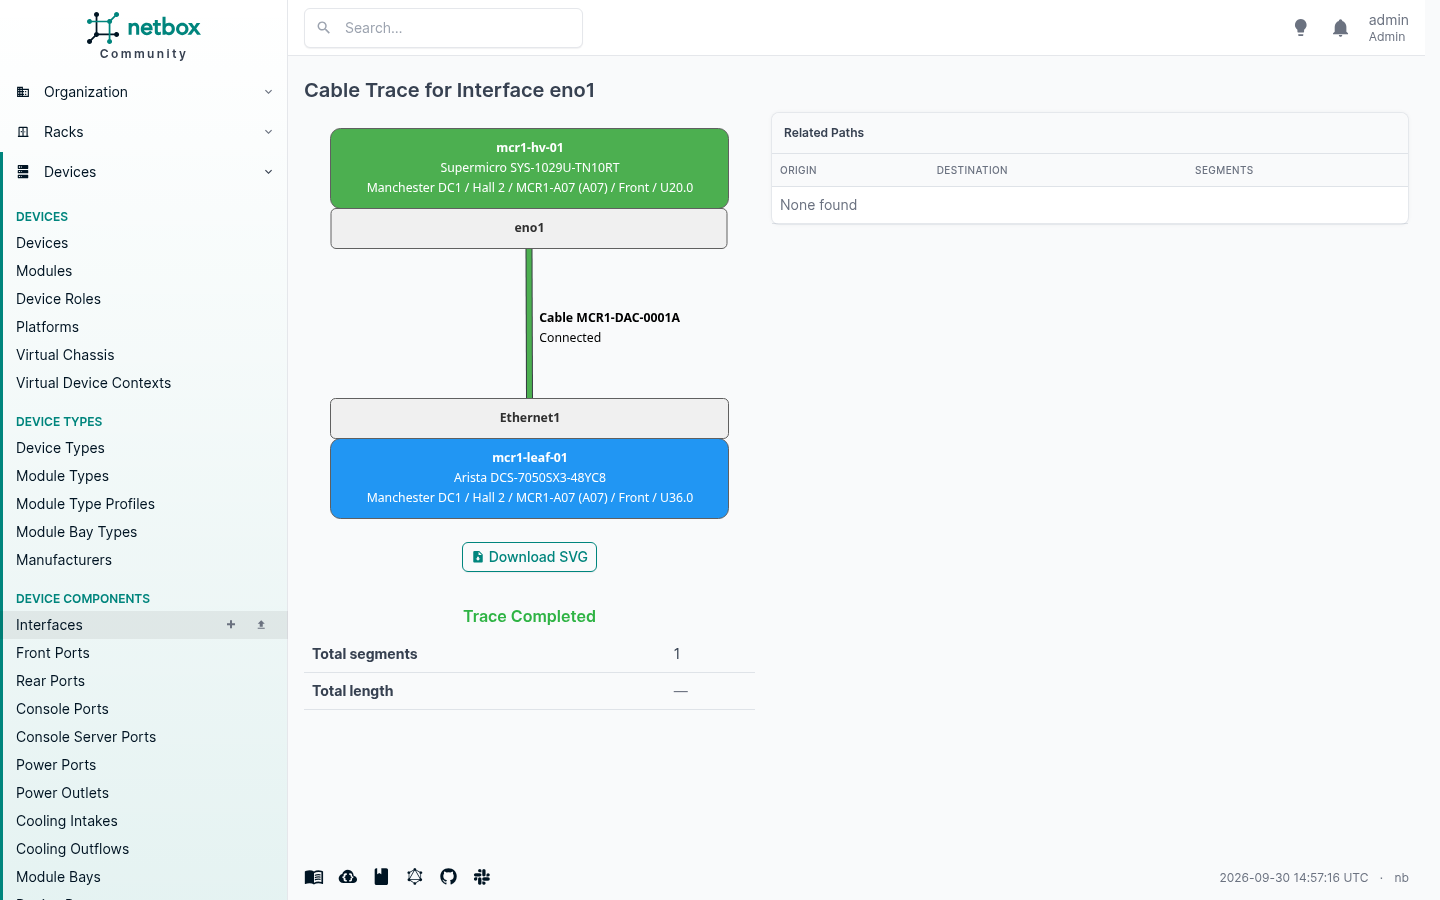
这里只有一跳,因为这是一根直连线缆。中间加上配线架,它就一块配线架一块配线架地走过去,告诉你一条穿过三个机柜的线路另一端是什么。否则这活就得有人打着手电,再有人在另一头拿着寻线器。
追踪还会打印出每一端的完整位置。站点、机房、机柜、朝向、U 位。如果你曾经在电话里试图告诉远程现场工程师该去看哪台设备,这一行就是全部价值所在。
地址,是一棵树而不是一个标签页
IPAM 是大家冲着来的那一半。
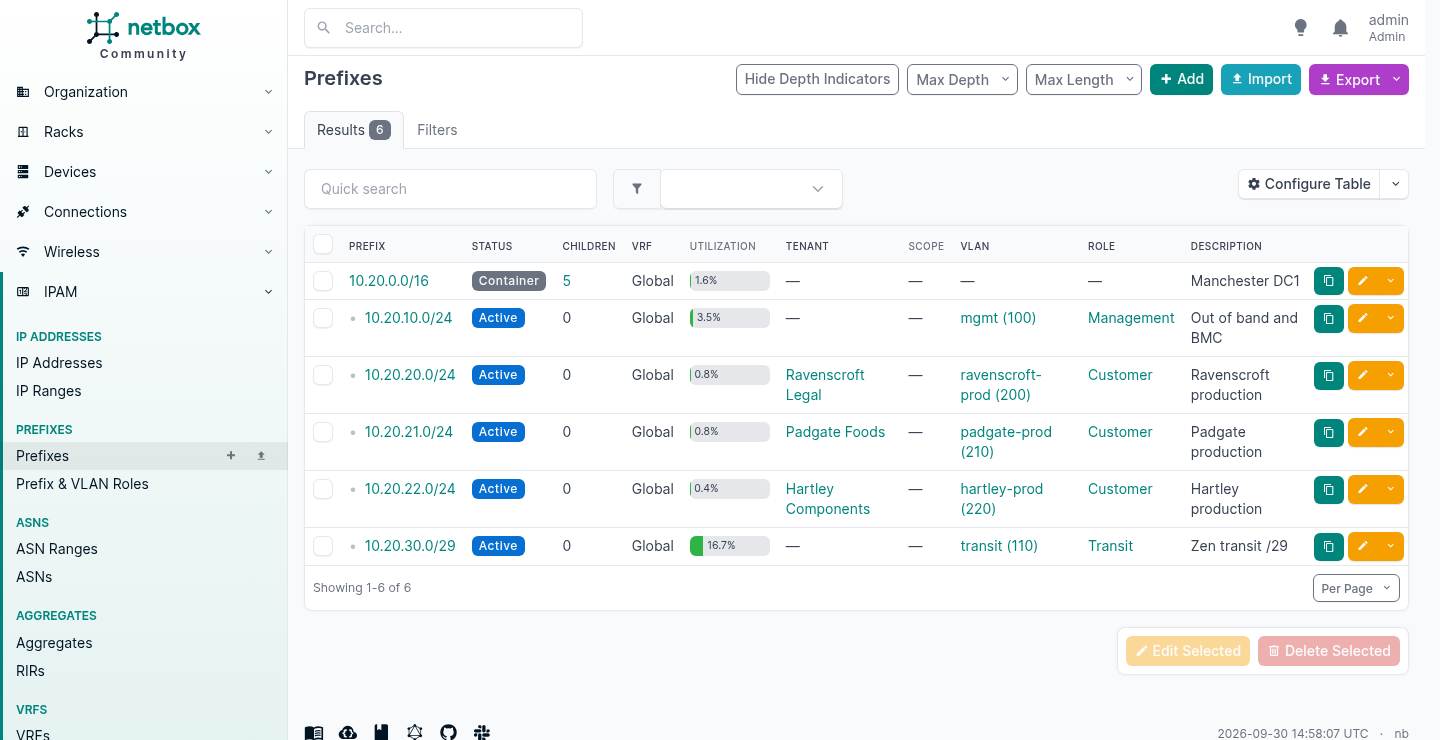
缩进是根据地址本身计算出来的。你不用告诉 NetBox 10.20.20.0/24 位于 10.20.0.0/16 之内,它自己会算出来,明年有人在中间加一个 /26,它也会继续算对。
每一行都带着你实际会拿来筛选的东西:它映射到的 VLAN、角色,以及它所属的客户。利用率也是算出来的。
打开其中一个,你就能看到里面的地址,以及空隙。
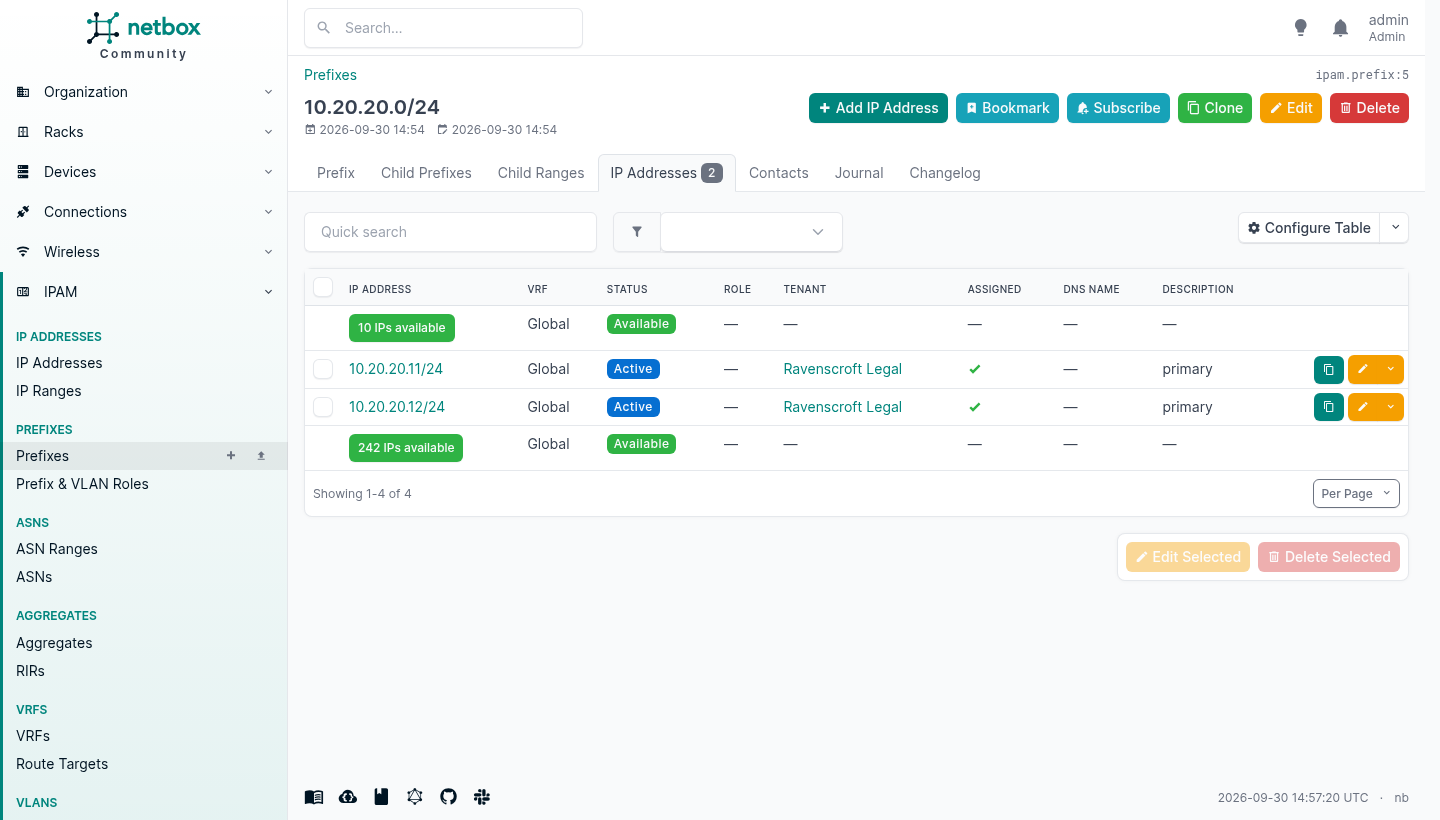
那些绿色的行就是空闲空间,和已用空间排在一起显示。有一个 API 调用能从一个前缀里给你下一个空闲地址,这是 IPAM 自动化里唯一一项立刻就能回本的功能,因为否则大家就是眯着眼盯着电子表格碰运气。
一个接口想挂多少地址就挂多少,两个地址族都行,你再各指定一个作为设备的主地址。
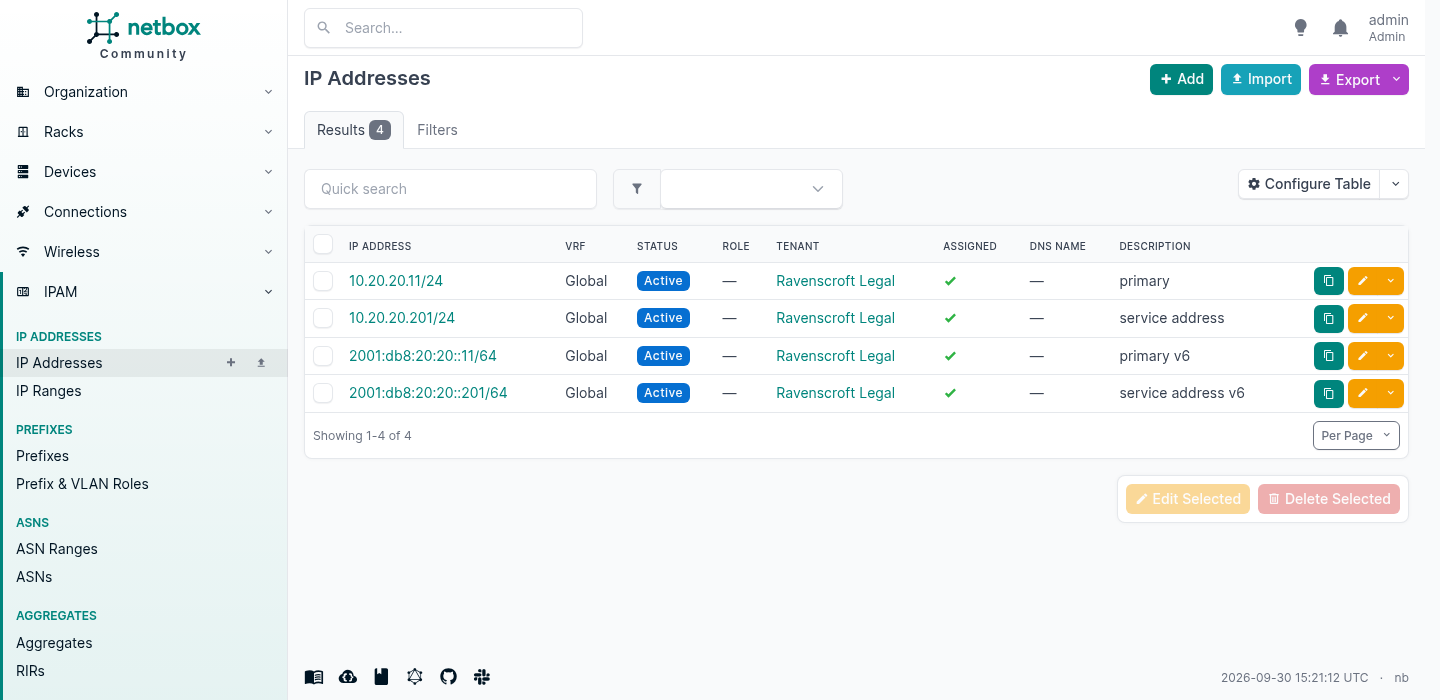
一个端口上两个 IPv4、两个 IPv6,这再平常不过,而以设备为中心的模型根本表达不了。
录入地址时,用它所在网络的掩码,而不是 /32。 NetBox 会接受 10.20.20.11/32,并把它归到正确的前缀下,因为包含关系是从主机地址算出来的。它不会做的,是事后替你揣摩:掩码按你输入的原样存储,并原样交给读取它的任何东西,所以一个局域网地址上的 /32,会被渲染成设备配置里的 /32。咬你的地方是三个月后的某个配置模板,而不是今天的表单。
一套安装,三个客户
NetBox 里的大多数对象都可以分配给一个租户。企业用它来区分业务部门。如果你卖托管服务,就每个客户建一个。
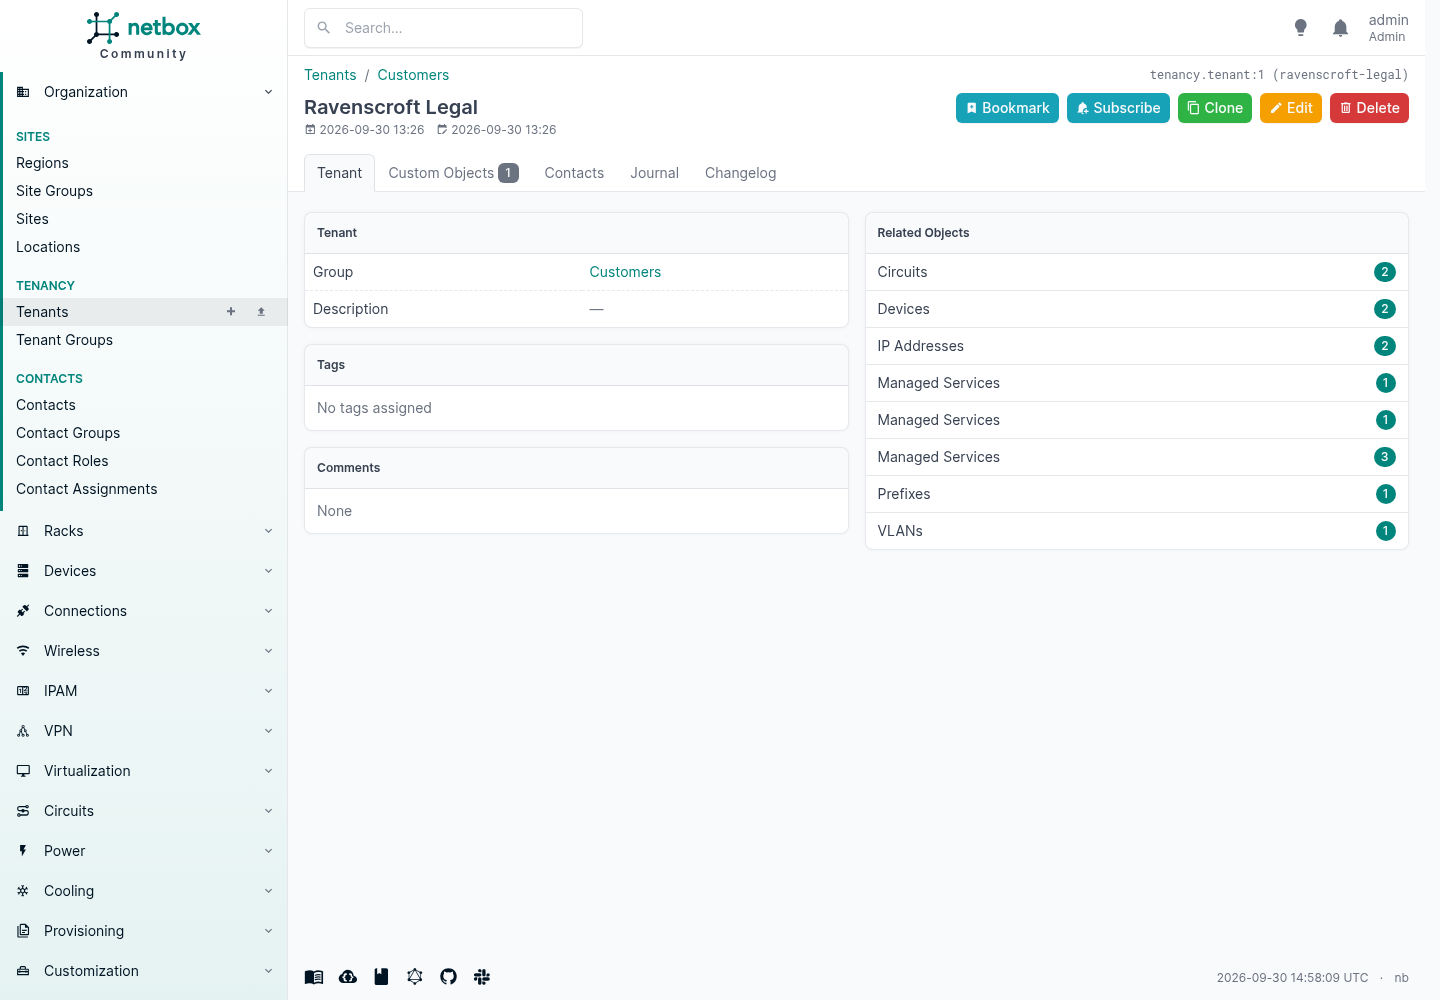
右边那个面板,就是“这个客户有什么”的答案,而且它是自己组装出来的。不用报表,不用电子表格,不用去问当初搭建它的工程师。
值得仔细想想租户到底意味着什么,因为第一天弄错,以后就是一年的拆解。租户意味着这个对象是专属于那个客户的。只为他们服务的路由器,就挂他们的租户。为四个客户服务的防火墙不属于其中任何一个,所以它不挂租户,这层关系要放到别的地方去。后面会细说,因为大多数人正是在这里发现自己需要添加一些自己的东西。
把数字写在设备类型上
这一步把一份清单和一个能回答问题的东西区分开来,而它每个设备类型大约只花十分钟。
设备类型可以带上它的重量,并通过电源端口模板带上它的功耗。在类型上填一次,你以后用它创建的每台设备都会继承。不填,NetBox 就只会乐呵呵地告诉你某个机柜满了 28.6%,别的什么都不说。
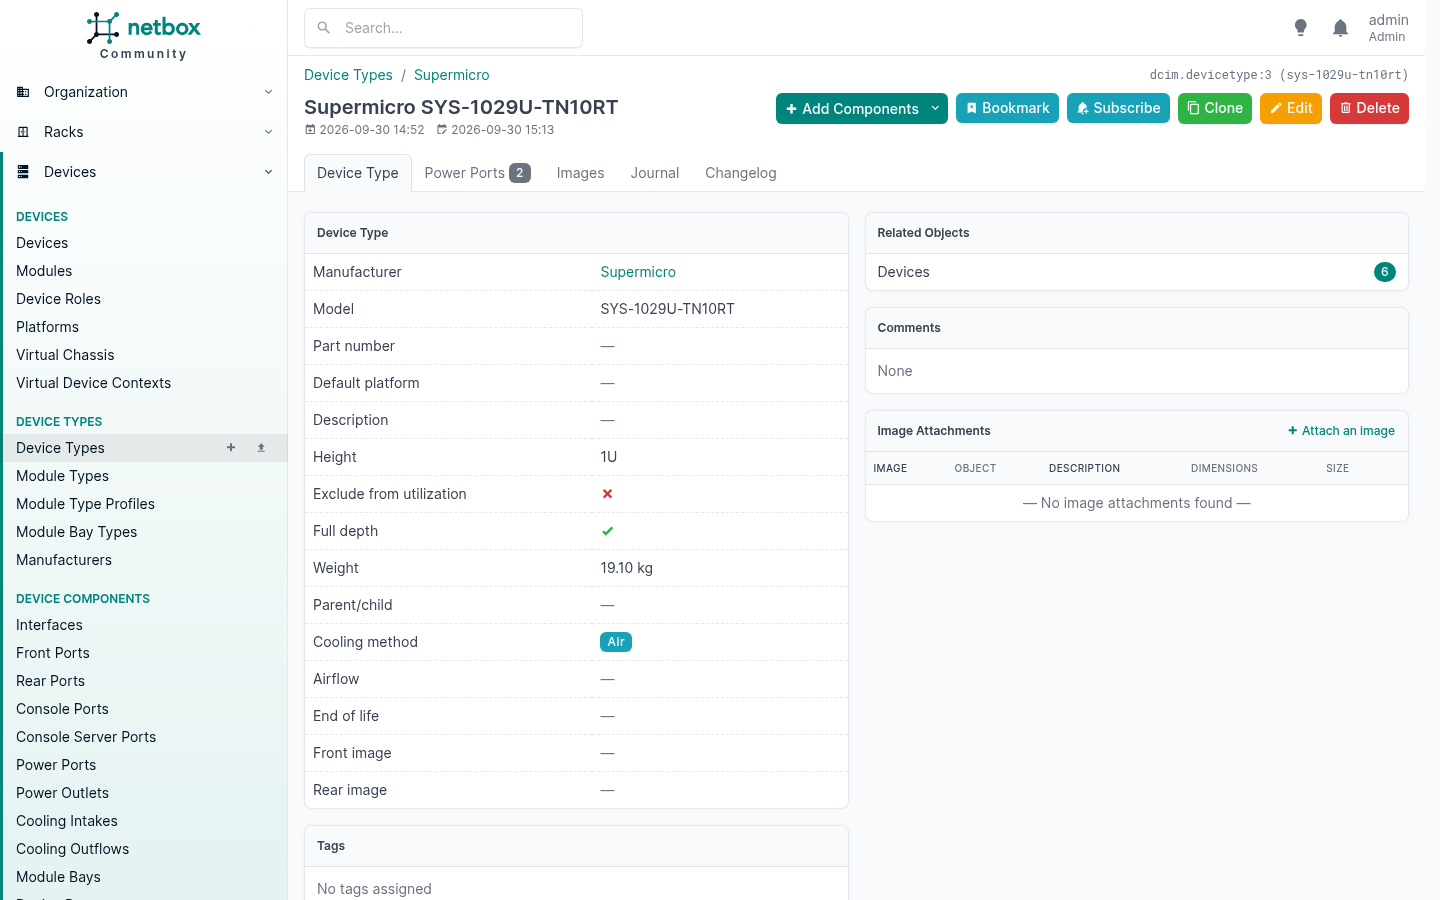
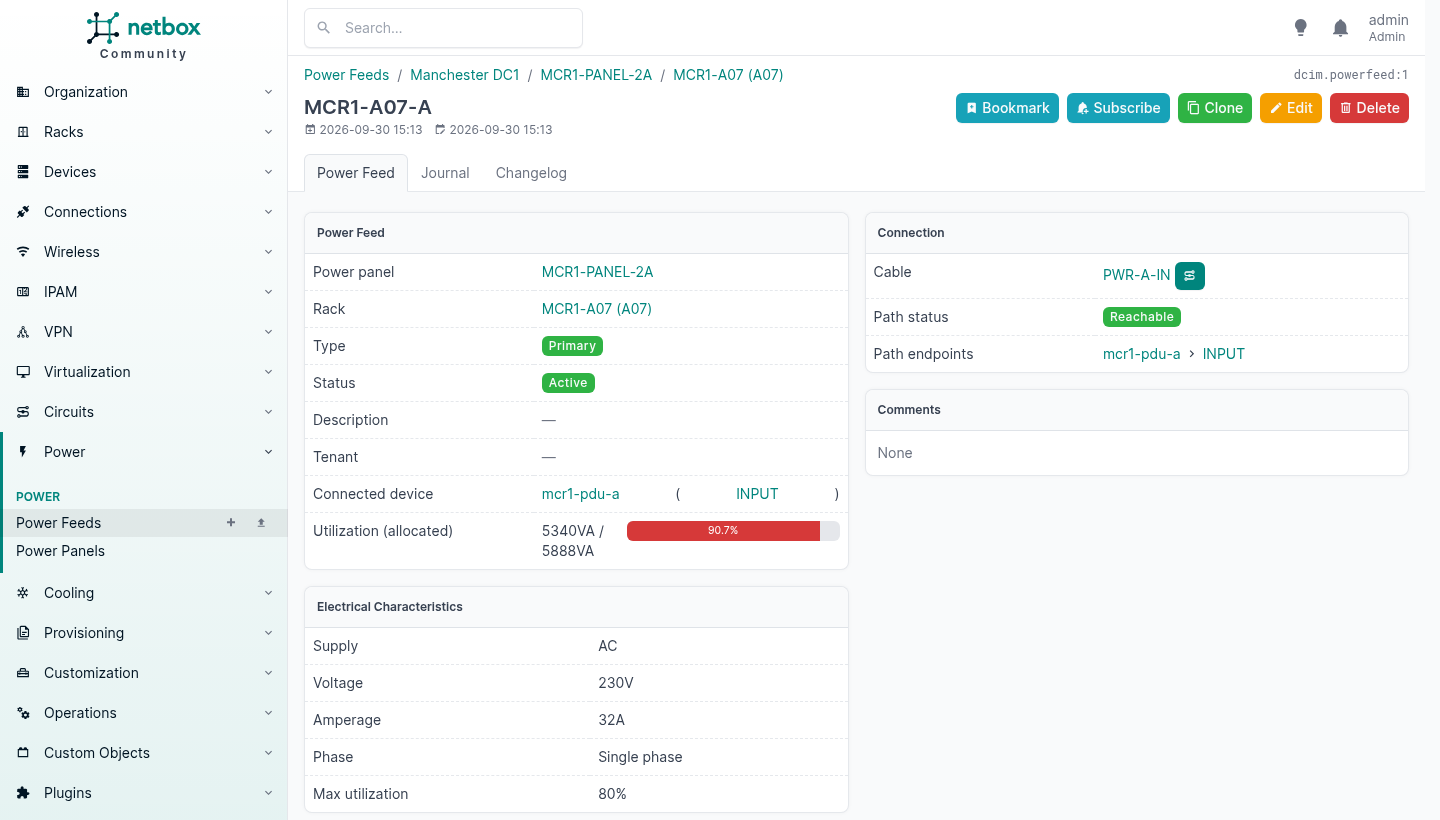
我给这里的五个类型都填了重量,给每个类型配了两个电源端口模板,带最大功耗和分配功耗,给 PDU 类型配了一个输入口和十二个输出口,然后建了一个配电盘和两路进入机柜的馈电,再把所有东西接上线:每台设备的 PSU1 接 PDU A,每个 PSU2 接 PDU B,每个 PDU 的输入口接到它的馈电。
然后,机柜页面就完全变了样。
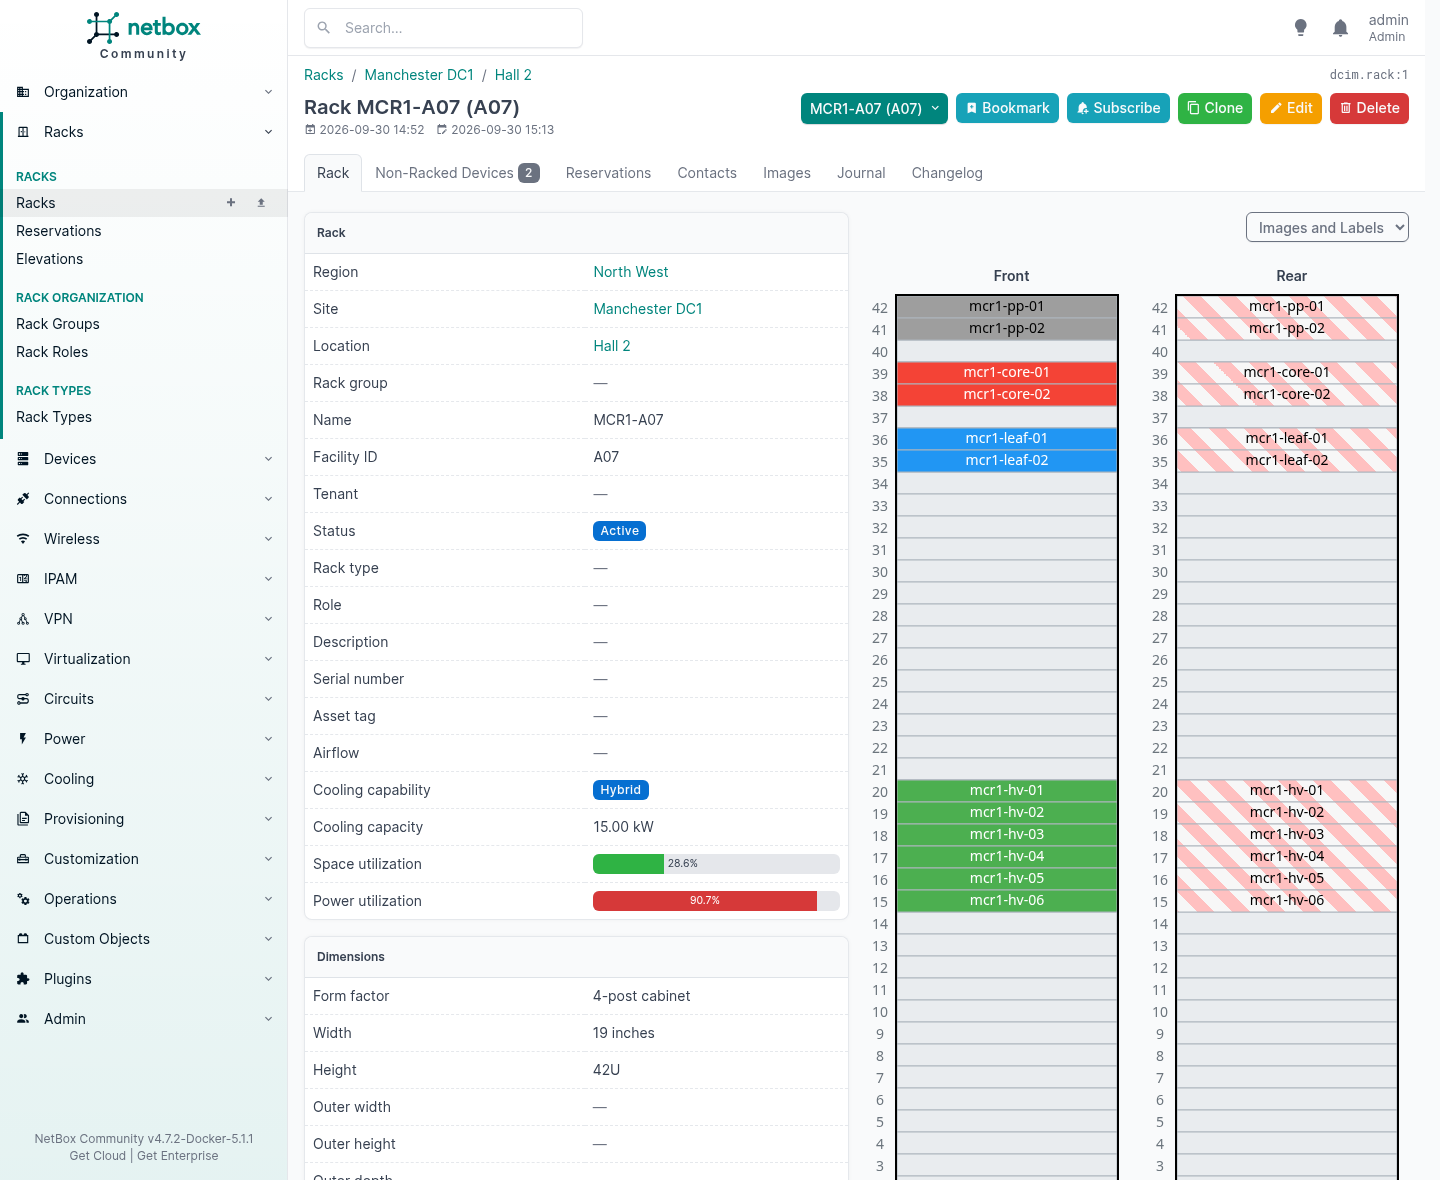
空间利用率 28.6%。电力利用率 90.7%。
那个机柜里的设备只占了三分之一,电力却快用光了,这是关于你资产的一个事实,任何电子表格都不会主动告诉你。下一批订单是装进这个机柜还是别处,也正是由这个事实决定的,而它来自你只在类型上录入过一次的数据。
让它一直显示为零的两件事
一开始我得到的是 0.0%,还得到了两次,两个原因都值得知道,因为哪个都不会报错。
插座必须引用输入口。 PDU 上的电源插座有一个 power_port 字段,指向同一台设备上的上游端口。留空,链条就断了:NetBox 没办法知道那十二个插座是由那个输入口供电的,于是什么都汇总不起来。
把输入口的功耗字段留空。 这条是反直觉的。NetBox 只有在一个电源端口自己的两个功耗字段都为空时,才会根据插在它上面的东西来计算它的功耗:
if self.allocated_draw is None and self.maximum_draw is None:
    ...aggregate the downstream power ports...
# otherwise
return {'allocated': self.allocated_draw or 0, ...}
我很热心地在 PDU 输入口上设了 maximum_draw: 7400,因为 PDU 的额定值就是这么多。于是 NetBox 信了我,把 allocated_draw 当作未设置,报告为零。把两个都清空,它就自己算出来了:
mcr1-pdu-a INPUT -> allocated 5340 VA, maximum 8480 VA, across 12 outlets
mcr1-pdu-b INPUT -> allocated 5340 VA, maximum 8480 VA, across 12 outlets
feed MCR1-A07-A: available 5888 VA   (230 V x 32 A x 80% max utilisation)
RACK power utilisation: 90.7 %
RACK weight: 166.6 kg of 900 kg
所以规则是:在叶子节点上填真实数字,中间的端口留空,让 NetBox 去加总。人为定义的值永远压过计算出来的值,这是正确的行为,而放在 PDU 上恰恰是错误的做法。
散热,这是新加的
4.7 版给 DCIM 加上了散热,而且加的正是越来越贵的那一半。机柜带有散热能力,可以是风冷、混合或液冷,还有以千瓦计的容量;设备类型带有散热方式。再往上是代表冷水机组和精密空调的冷源、代表通往机柜的冷却回路的冷却馈送,以及设备本身上用于冷板和分液歧管的进液和出液组件。
上面那个机柜显示 Hybrid、15.00 kW,因为我是这么告诉机柜的。如果你今年要接收液冷设备,这就是给你目前还记在电子表格里的那个东西准备的模型。
一套安装,多个客户
租户机制是服务商能只跑一套 NetBox、而不是每个客户一套的原因,值得弄明白它做什么,更重要的是,它不做什么。
NetBox 有二十八个模型带租户字段。站点、位置、机柜和机柜预留。设备、线缆和虚拟设备上下文。前缀、IP 地址、地址范围、聚合、VLAN、VLAN 组、VRF、路由目标、ASN。线路和线路组。集群和虚拟机。隧道、L2VPN、无线局域网和无线链路。电源馈电和冷却馈送。
这就是所有能计费的名词。一致地设好它,“这个客户有什么”就不再需要调查。
但租户是一个标签,不是一把锁。它说明这个对象专属于那个客户。它挡不住任何能登录的人把所有东西读个遍,在一家公司内部这没问题,一旦某个客户有了账号,它就毫无用处。
由此引出两件事,第二件是大家会弄错的。
租户意味着专属。只为一个客户服务的路由器,挂他们的租户。为四个客户服务的防火墙不属于其中任何一个,所以什么都不挂,你转而在你实际卖出的那个东西上记录这层关系。把租户硬塞给共享设备,会让每一份基于租户的报表都悄悄出错。
而访问控制完全是另一套机制。
隔离靠的是权限
NetBox 的对象权限接受一个 JSON 约束,这个约束就是一个 Django ORM 过滤器。它在构建任何东西之前先收窄查询集,所以每个视图、导出、API 调用和搜索都会跟着被收窄。
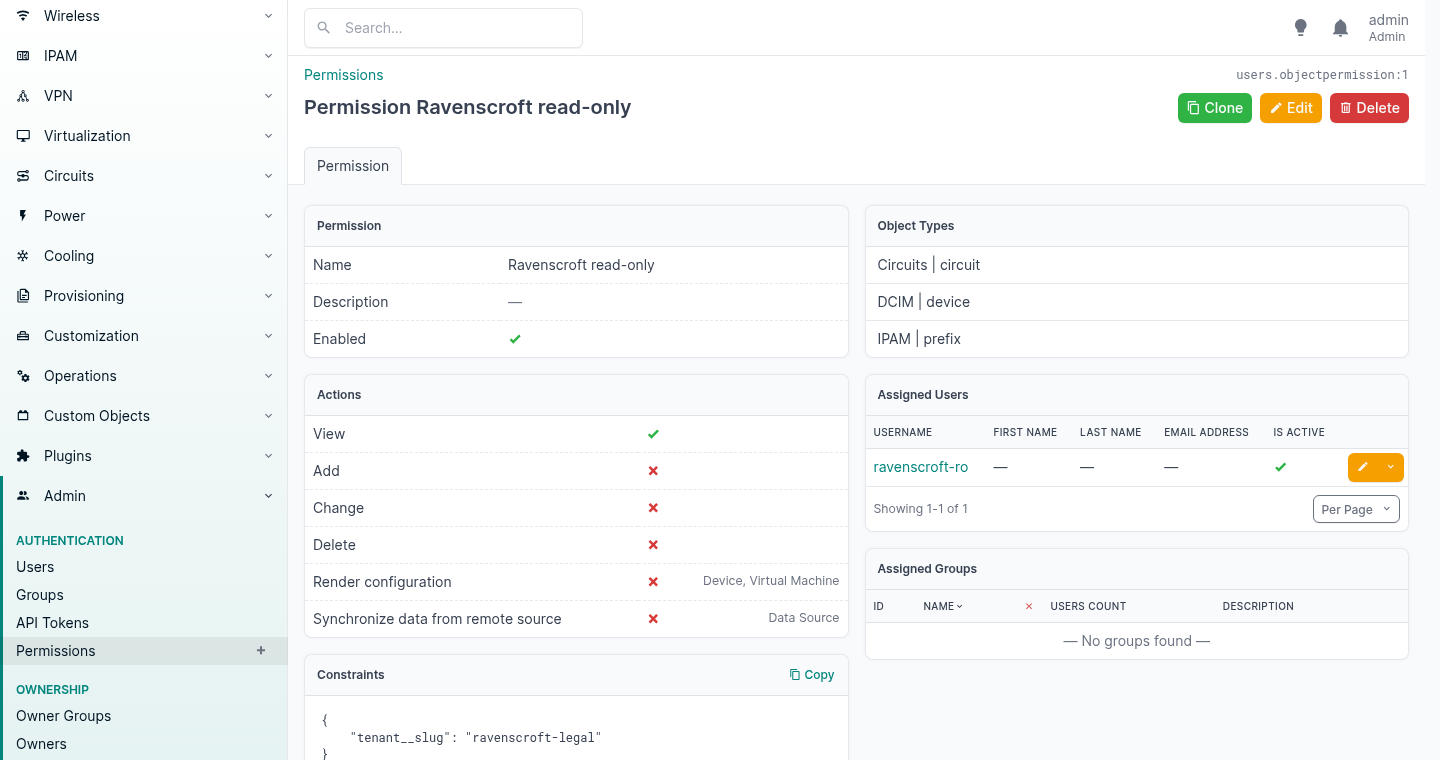
干活的是三个字段。它适用的对象类型、它授予的操作,以及底部那条约束。其他的都是记账。
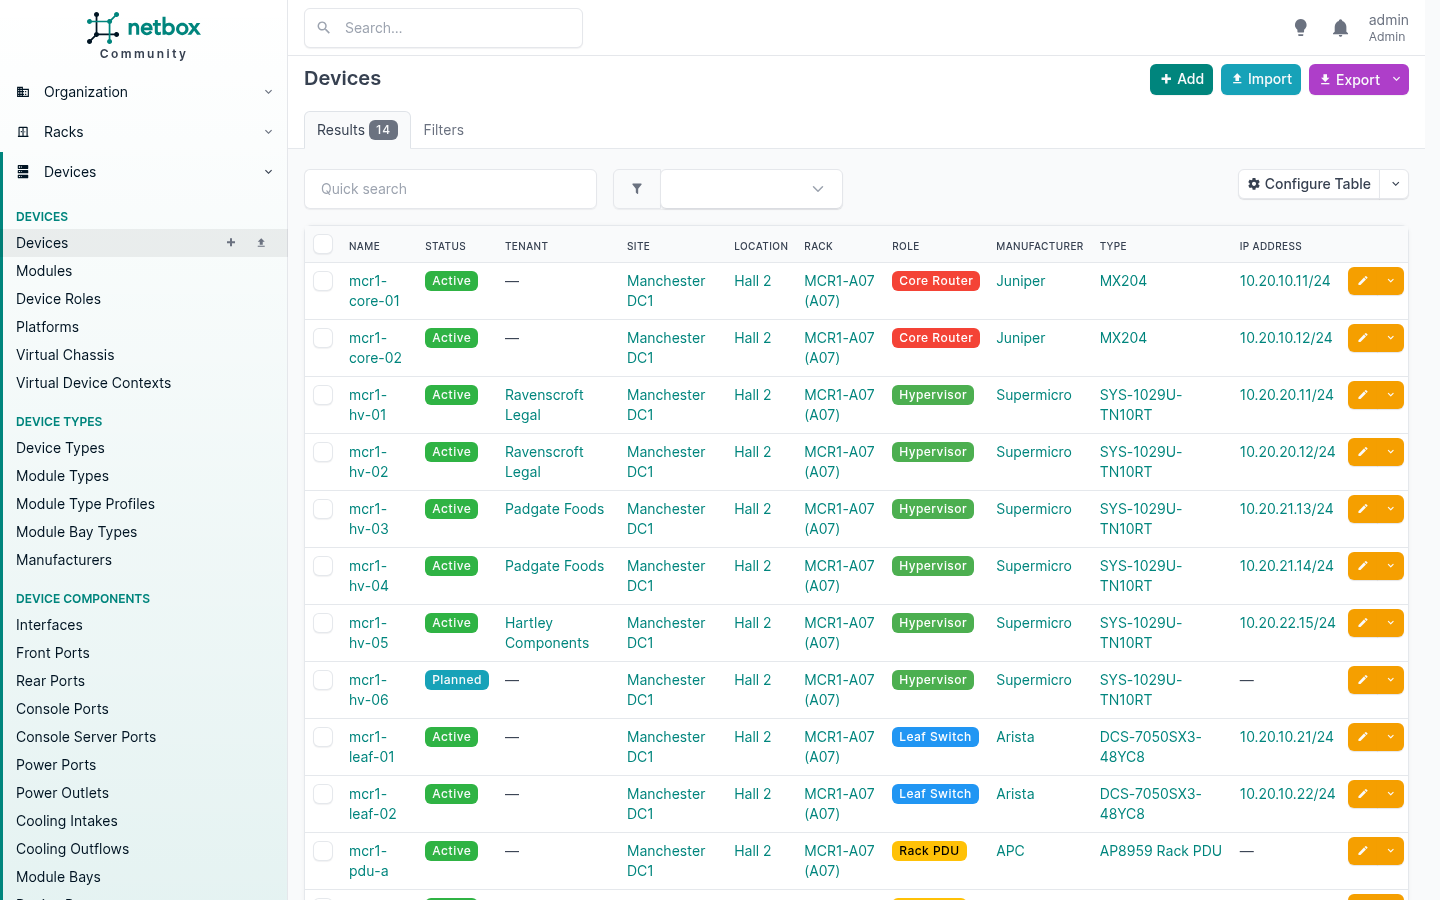
这是管理员看到的设备列表。
这是同一个 URL、同一套安装,以客户身份登录后看到的。
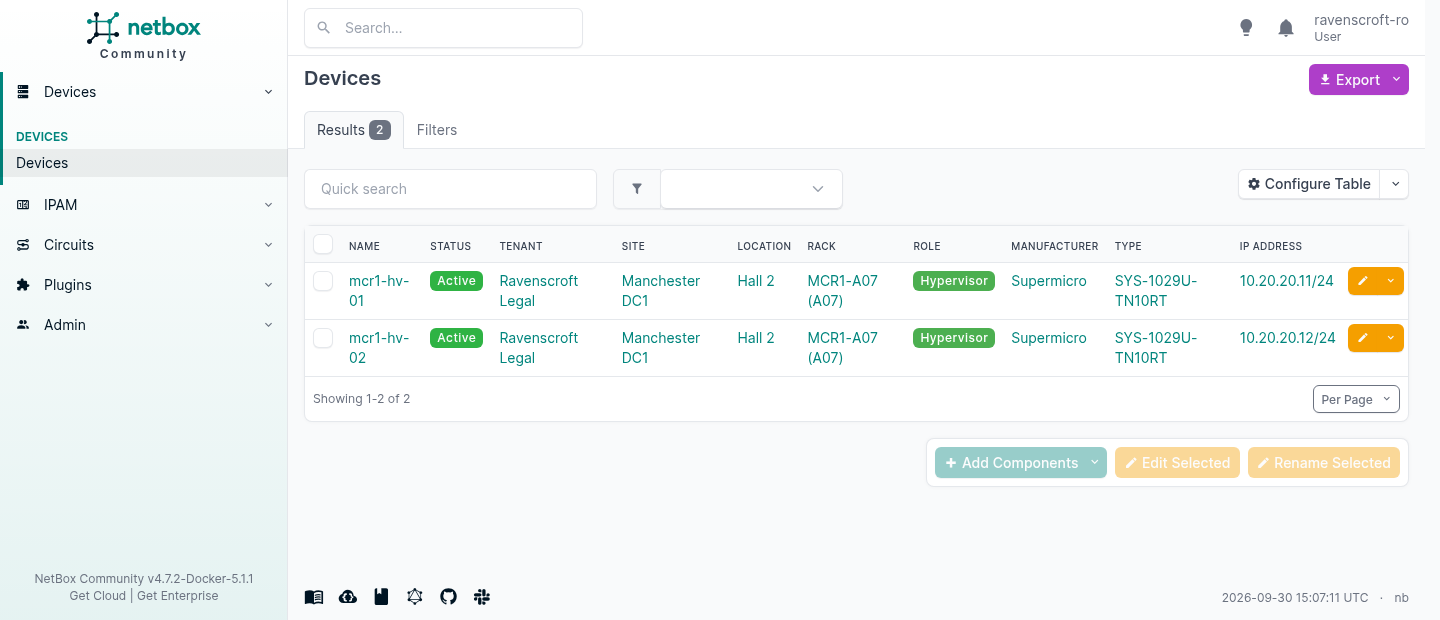
两行而不是十四行,再看看左侧菜单。它缩减到了这个账号被允许碰的四样东西。没有人配置过这个。导航是由同一套权限构建的,所以客户永远不会看到一个点进去会被拒绝的链接。
它说“不”的两种方式
这个细节值得知道,因为两种拒绝含义不同,而且都是有意为之。
| 客户的令牌请求 | 得到 |
|---|---|
/api/dcim/devices/ | 200,两行里的一行 |
/api/dcim/devices/1/,他们自己的 | 200 |
/api/dcim/devices/2/,别人的 | 404 |
/api/tenancy/tenants/ | 403 |
/api/dcim/sites/,从未授权 | 403 |
| 完全没有令牌 | 403 |
404 的意思是:这个类型是你的,但那一行不是。 约束把它从查询集里去掉了,所以就这个请求而言,它不存在。在那里返回 403 等于确认它存在,好奇的客户就能通过遍历 ID 把你的资产数一遍。
403 的意思是:这个类型从来就不是你的。 租户和站点从未授权,所以直接拒绝,客户也就没法枚举平台上还有谁。
然后让他们写
只读是容易的情况。真正的问题是,一个有编辑权限的客户能不能被信任,所以我在同一条约束下授予了 change,然后去找出口。
| 尝试 | 结果 |
|---|---|
| 编辑自己的设备 | 200,已保存 |
| 编辑另一个客户的设备 | 404 |
| 编辑自己的设备,把它移到另一个客户的租户下 | 403 |
| 删除自己的设备 | 403,从未授予删除权限 |
关键是第三行。把自己的设备重新分配给别人的租户,是最明显的逃逸路线,因为请求到达时这个对象在你的约束之内,之后就在约束之外了。NetBox 是按照对象将被留下的那个状态来评估约束的,所以它拒绝了。我没有相信状态码,而是把设备读了回来,租户确实没动。
这正是大多数自制多租户方案留着的那个洞,而它通常是被客户发现的,而不是被测试发现的。
需要继承的变量
这是大家会弄错的一个区别,弄对了能省下大量编辑工作。
自定义字段是挂在单个对象上的一个值。你逐个对象地设,它就待在那里。适合描述这个东西本身的事实:资产标签、支持合同编号、投运日期。
配置上下文是挂在某个特征上的值,所有符合这个特征的东西都会继承。适合应该层层传递的变量:你的 NTP 服务器、syslog 目标、SNMP community、DNS 域、管理 VLAN、备份窗口。
如果你发现自己在四十台设备上把同一个自定义字段设成同一个值,你要的其实是配置上下文。
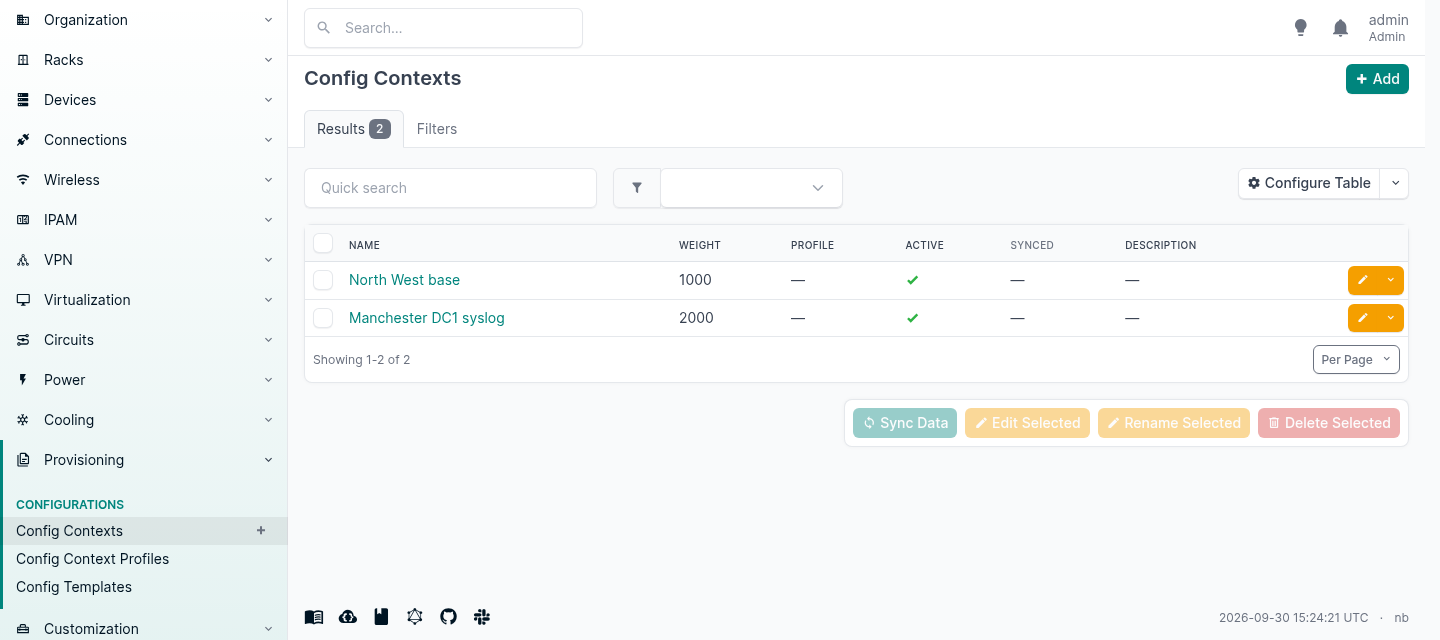
一个上下文就是任意 JSON,可以挂在区域、站点组、站点、位置、设备类型、角色、平台、集群、集群类型、集群组、租户组、租户或标签上。租户也在这份清单里,对服务商来说,这意味着一个对某个客户处处成立的事实,会跟着他们落到你以后为他们添加的每一台设备上。
合并是按键进行的,每个键由权重决定谁胜出。
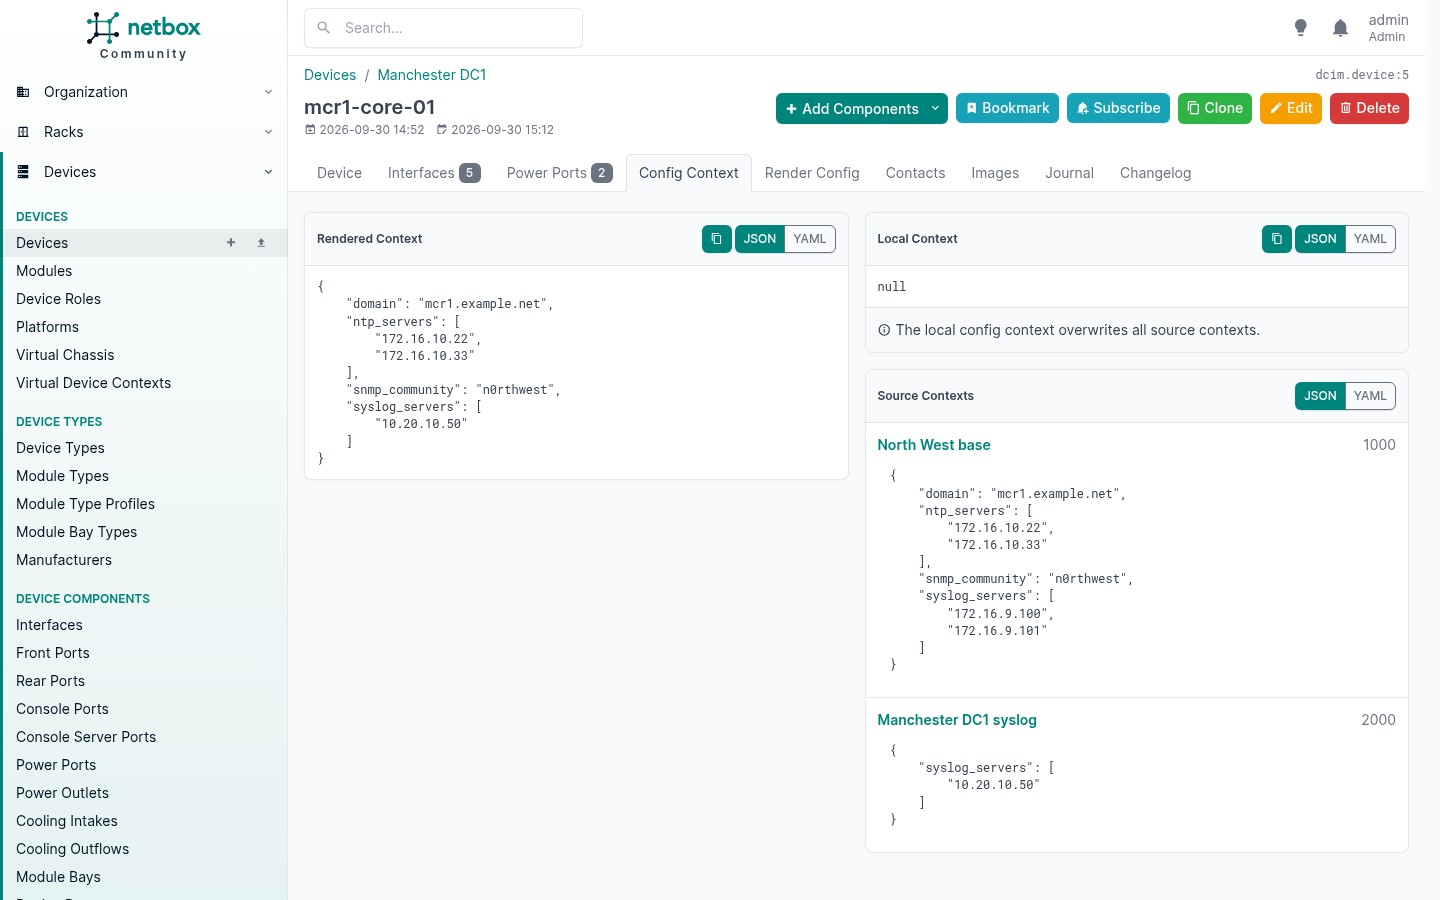
把右边的面板和左边对照着读。区域在权重 1000 上提供了四个键。站点在权重 2000 上提供了一个键。渲染后的上下文原封不动地保留了区域的域名、NTP 服务器和 community,只采用了站点的 syslog 服务器,因为那是唯一有争议的键。
你写的是例外,而不是把所有东西连同例外重新抄一份。这就是全部价值,也是它能扩展、而按设备存放的变量文件不能扩展的原因。
本地上下文压过上面的一切
继承栈有顶层,顶层就是对象本身。设备上的本地上下文数据,压过所有适用于它的源上下文,不管它们的权重是多少。
我在 mcr1-core-01 上设了这个:
{"syslog_servers": ["10.20.10.99"], "note": "this box logs somewhere else"}
它渲染后的上下文变成了:
{
  "note": "this box logs somewhere else",
  "domain": "mcr1.example.net",
  "ntp_servers": ["172.16.10.22", "172.16.10.33"],
  "snmp_community": "n0rthwest",
  "syslog_servers": ["10.20.10.99"]
}
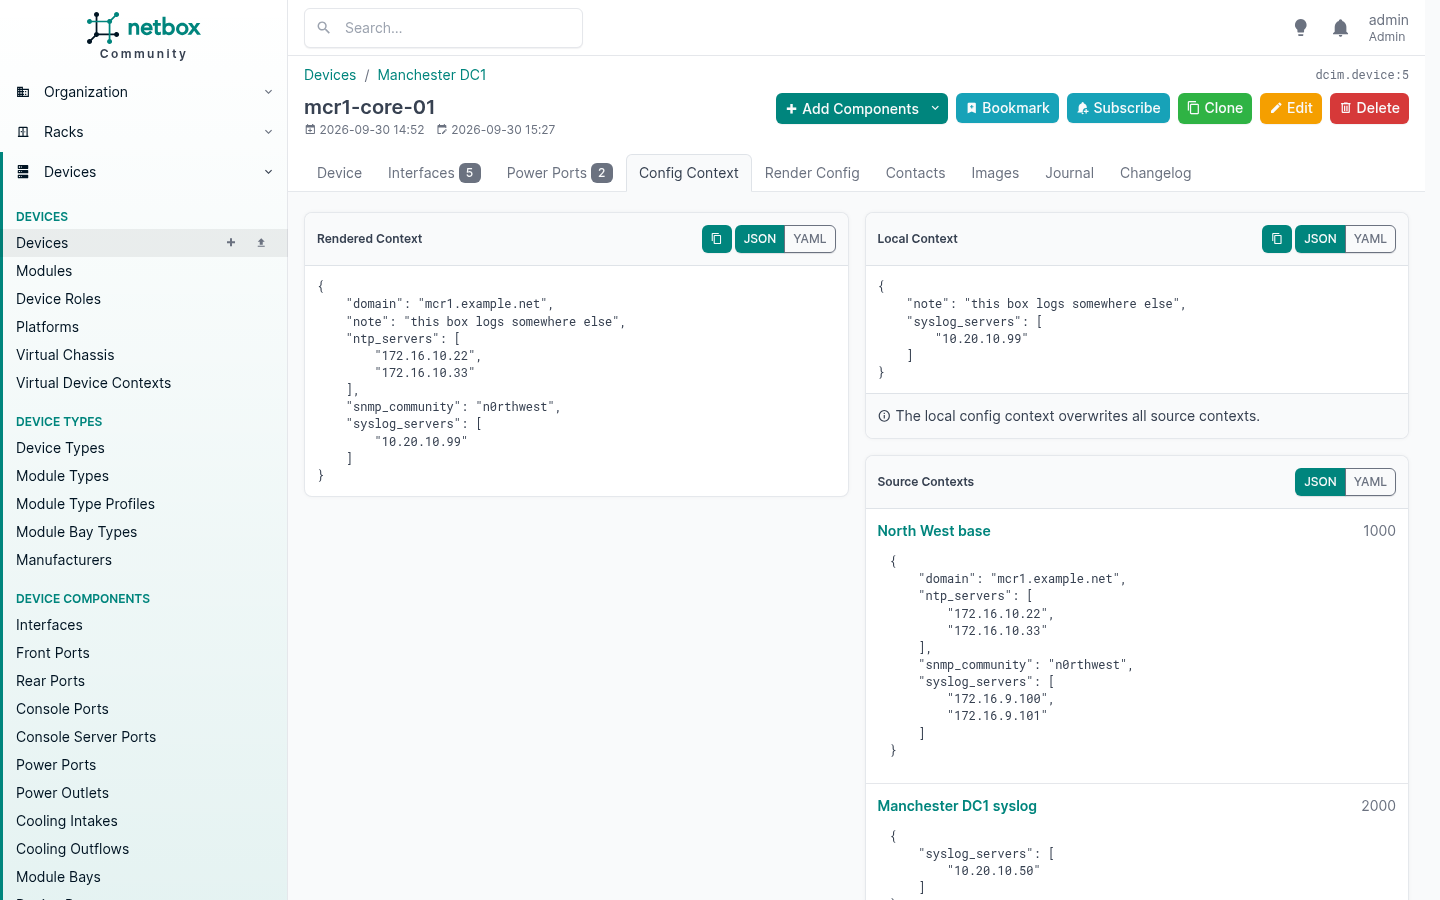
本地的 syslog 服务器同时压过了权重 2000 的站点覆盖和权重 1000 的区域。它没提到的东西照样继承,所以域名、NTP 服务器和 community 原封不动地传了下来,新键则直接加了进去。
这是给那一台确实与众不同的设备留的逃生口,面板也明明白白地告诉你它会覆盖所有源上下文。如果你发现自己在很多台设备上用它,而不是一台,那你就是找到了这些设备共有的一个特征,你要的是一个限定到这个特征的上下文。
三个陷阱
没有限定范围的上下文是全局的。 建一个上下文却忘了分配给任何东西,它就会作用于你所有的设备和虚拟机。这是文档里写明的行为,偶尔也正是你想要的。它同样是悄无声息的。
如果你想简单地引用键,键名里就不能有连字符。 上下文数据是 JSON,所以 ntp-servers 完全合法,但 Jinja 的变量名不是 JSON 键。{{ ntp-servers }} 会被解析成一个减法,抛出 UndefinedError: 'ntp' is undefined。对着带连字符的数据写 {{ ntp_servers }},你会得到一个空字符串、HTTP 200,哪儿都没有警告。键名用下划线,最直观的模板就能用。
profile 能拦住拼写错误。 配置上下文 profile 把相关的上下文归成一组,并在保存时对它们的数据强制执行 JSON schema。我给一个 profile 配了一个 schema,要求 syslog_servers 是 IPv4 字符串数组,然后犯了大家真正会犯的那两个错:
{"syslog-server": ["10.1.1.1"]}          singular, by accident
  400  Data does not conform to profile schema:
       'syslog-servers' is a required property

{"syslog_servers": [...], "syslog_port": 99999}
  400  Data does not conform to profile schema:
       99999 is greater than the maximum of 65535
在有人犯错的地方就被拒绝了,而不是四百台设备之后。
渲染配置
上下文数据加上一个 Jinja 模板,就得到一个配置文件。设备以 device 的名义在作用域内,它合并后的上下文以普通变量的形式在作用域内,你还可以遍历它的组件。
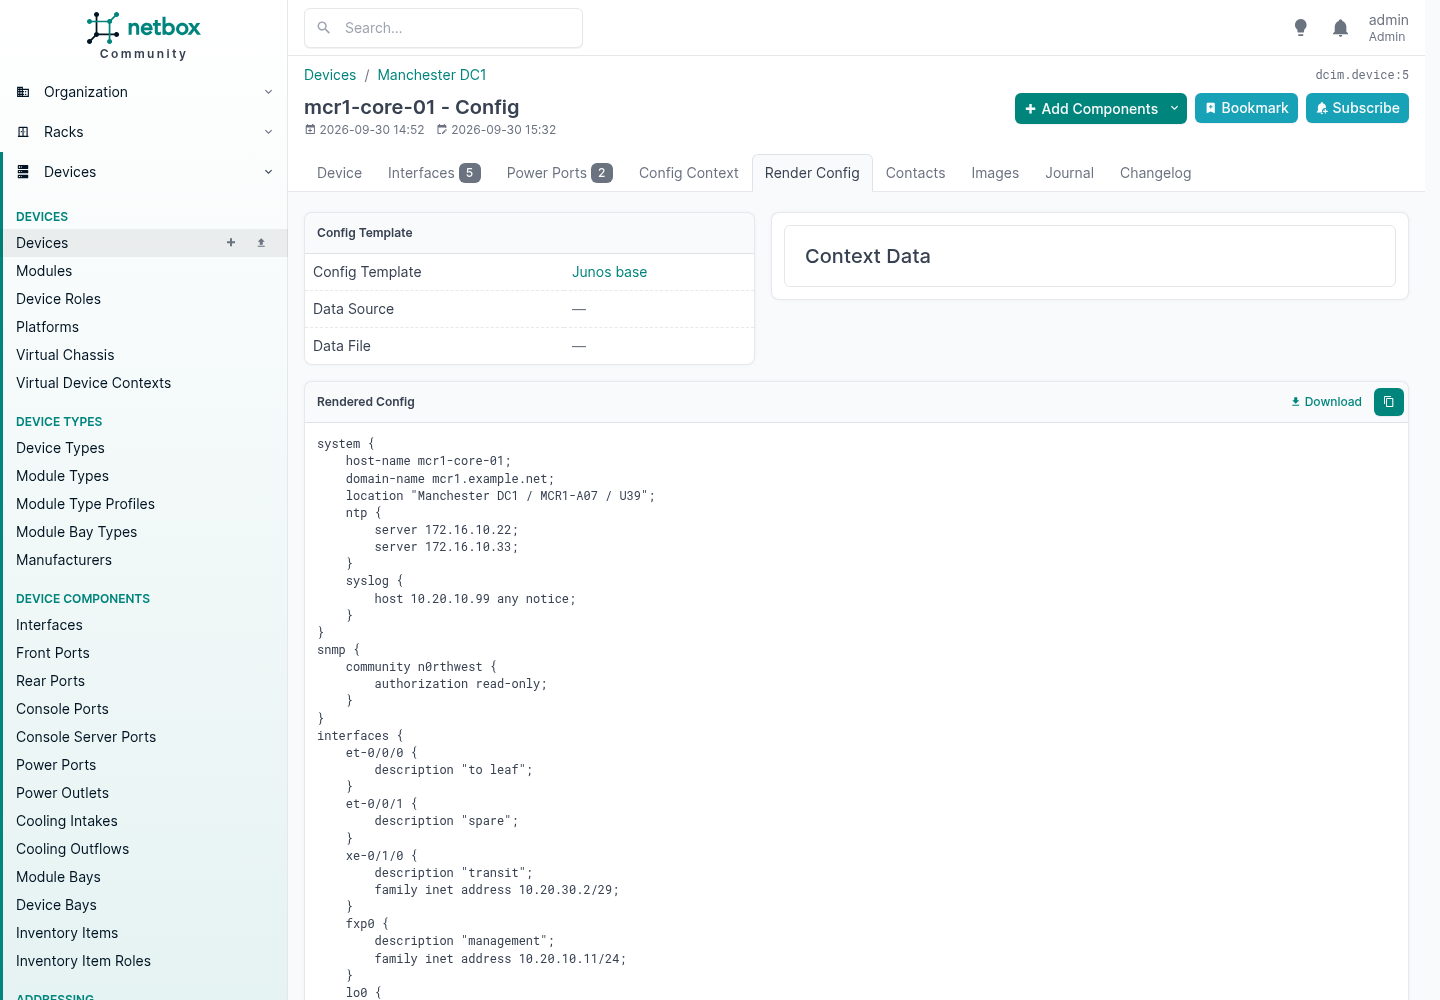
那个页面上的每样东西都来自不同的地方,这正是重点:
| 行 | 来自哪里 |
|---|---|
host-name mcr1-core-01 | 设备 |
domain-name mcr1.example.net | 区域级配置上下文 |
location "Manchester DC1 / MCR1-A07 / U39" | 站点、机柜以及在机柜中的位置 |
server 172.16.10.22 | 区域上下文,权重 1000 |
host 10.20.10.99 any notice | 设备自己的本地上下文,同时压过站点和区域 |
family inet address 10.20.10.11/24 | 那个接口上的地址,掩码按输入原样保留 |
模板的解析顺序是设备,然后角色,然后平台,三者都没有的话请求就会失败。所以你在平台上分配一次模板,运行那套软件的每台设备都会用它来渲染,除非它的角色或设备本身另有指定。这就是平台的用途:操作系统或厂商软件家族,而不是硬件。
NetBox 负责渲染。它不推送。把输出送上设备,是你的自动化系统的活,等哪天某个模板 bug 本来会把四百台设备重新配置一遍时,你会庆幸这是两个不同的系统。
插件
插件是一个和 NetBox 装在一起的 Django 应用。它可以添加模型、添加页面、扩展两套 API、往现有模板里注入内容、添加导航、添加后台任务队列,以及加载更多 Django 应用。它几乎没有做不到的事,因为底下就是 Django。
安装一个插件只要四条命令加一次重启:
source /opt/netbox/venv/bin/activate
pip install netbox-topology-views netbox-qrcode
# add the package names to PLUGINS in configuration.py, then
python3 manage.py migrate
python3 manage.py collectstatic --no-input
sudo systemctl restart netbox netbox-rq
在容器栈上,同样的软件包写进 plugin_requirements.txt,然后重建镜像。不管哪种方式,都要锁定版本,并先查兼容性矩阵,因为一个还没跟上 NetBox 新版本的插件,会让整个应用拒绝启动,而不是把自己禁用掉。
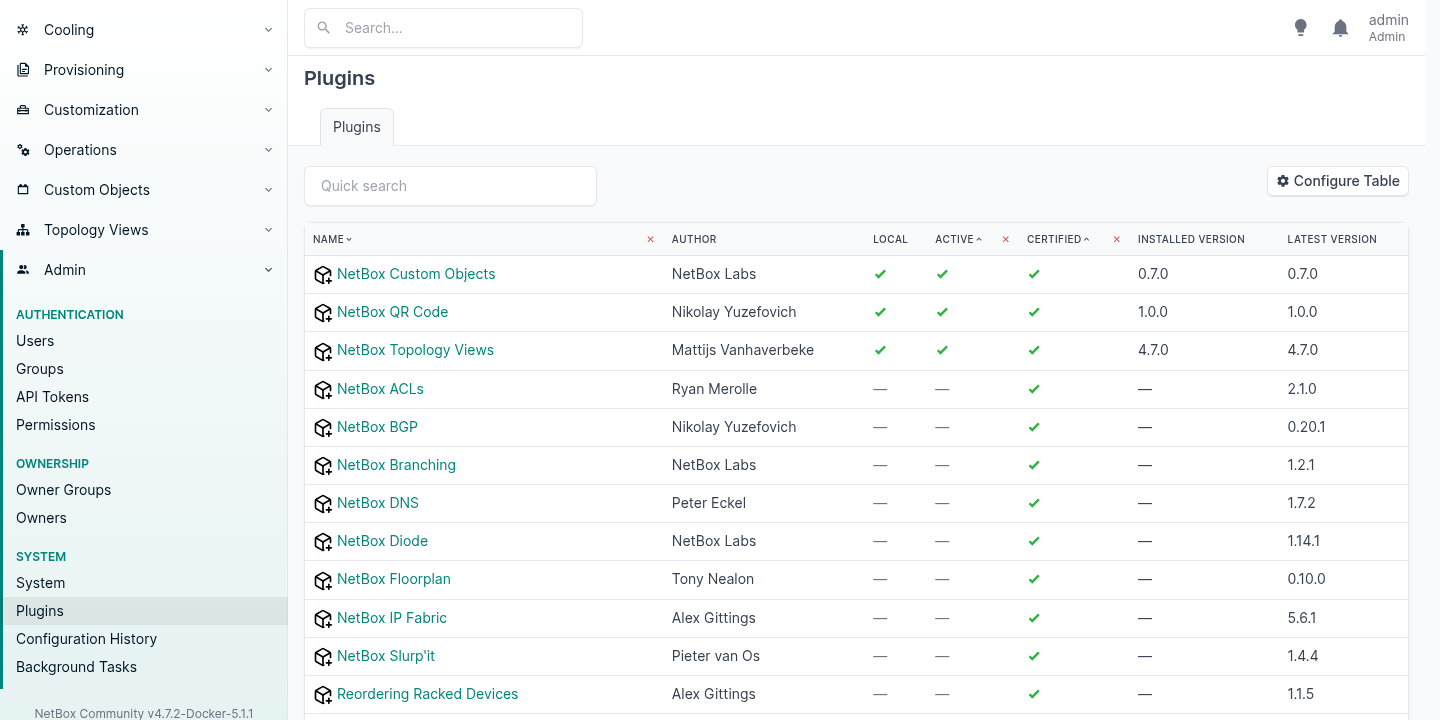
公开的目录里列了 31 个。下面这些值得了解,附上每个插件实际采用的许可证:
| 插件 | 做什么 | 许可证 |
|---|---|---|
| DNS | 把区域、记录和域名服务器作为真相来源 | MIT |
| BGP | 会话、community 和路由策略 | Apache 2.0 |
| Topology Views | 根据你的线缆生成图形化拓扑图 | Apache 2.0 |
| Floorplan | 图形化的站点和位置平面图 | LGPL 3.0 |
| QR Code | 为机柜、设备和线缆生成二维码,用作资产标签 | Apache 2.0 |
| ACLs | 访问控制列表和规则 | Apache 2.0 |
| Prometheus SD | 直接从 NetBox 给 Prometheus 提供主机列表 | MIT |
| Documents | 挂在线路和设备上的文档 | Apache 2.0 |
| Lifecycle | 硬件生命周期终止、许可证和合同 | Apache 2.0 |
| Contract | 合同和发票 | MIT |
| Reorder Rack | 拖放调整机柜 U 位 | Apache 2.0 |
| Branching | 隔离的、可合并的数据分支 | NetBox Limited Use |
| Custom Objects | 在界面里定义新的对象类型 | NetBox Limited Use |
Prometheus SD 是整个思路最老实的样子。NetBox 知道有什么,那就让 NetBox 去告诉监控系统,别再维护第二份会慢慢跑偏的主机列表。
在最后两行上搭东西之前,有件事要知道。NetBox 本身是 Apache 2.0,自 2016 年 DigitalOcean 发布以来一直如此,如今这个项目由 NetBox Labs 和一支志愿维护者团队共同管理。21 NetBox Branching 和 NetBox Custom Objects 不是:它们采用 NetBox Limited Use License 1.0,只授权“only as part of a NetBox installation obtained from NetBox Labs or a NetBox distributor authorized by NetBox Labs, and only for your own internal use”的使用,并且不授予使用该软件“to provide a managed service or software products that includes, integrates with, or extends NetBox in a way that competes with any product or service of NetBox Labs”的权利。如果你装的是从 GitHub 拿来的 NetBox Community,又是代表客户在运行它,那么在把一套 schema 建在它们上面之前,自己去读一读条款。10 NetBox 自己的安装指南推荐了这两个插件,却只字未提这一点。11
自定义字段
自定义字段给现有模型加一个属性。值以 JSON 形式和每个对象存放在一起,所以不需要迁移,也不需要重启,一共有十三种类型,包括指向其他 NetBox 记录的单对象和多对象引用。
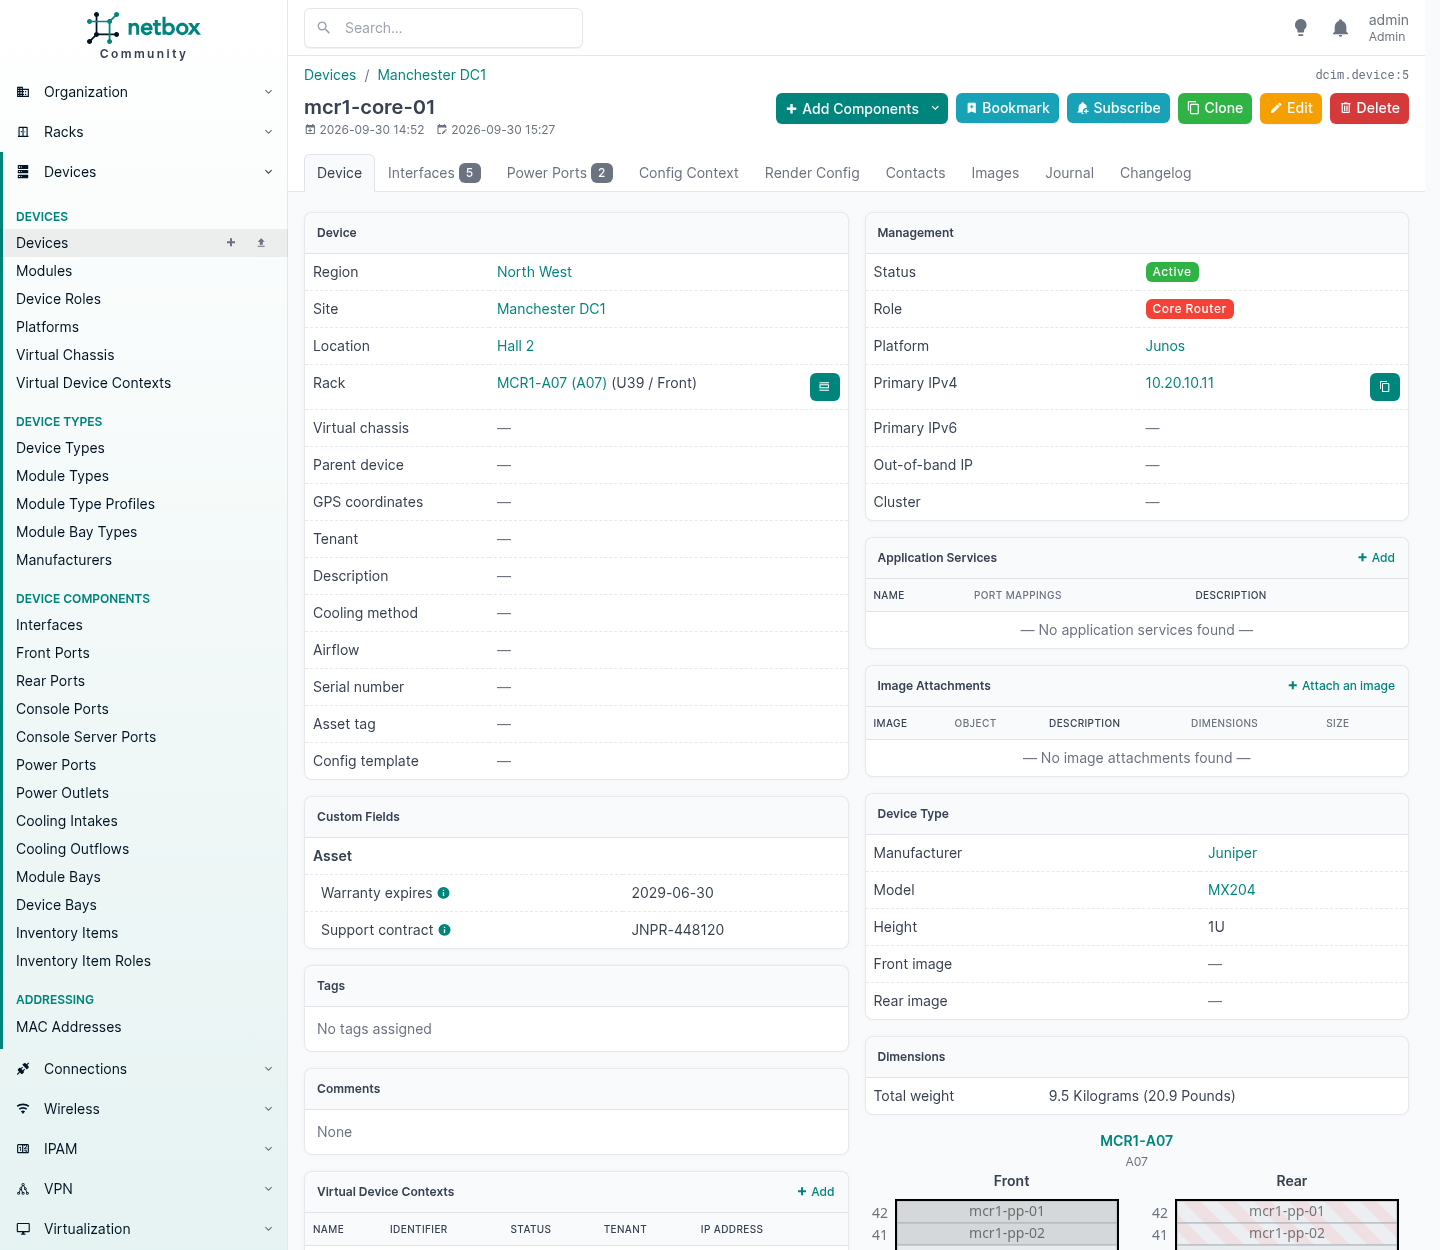
那里有两个字段,归在我选定的“Asset”标题下。注意它们右边的 Dimensions 面板:9.5 kg,没有人在这台设备上输入过。它来自设备类型。
自定义字段是有校验的,值得知道这一点,因为这和下面那条路线确实不同。我给合同字段配了一个正则表达式,API 就强制执行了它:
PATCH {"custom_fields": {"support_contract": "nonsense"}}
  {"__all__": ["Invalid value for custom field 'support_contract':
                Value must match regex '^[A-Z]{2,4}-[0-9]{6}$'"]}
4.7 里有两处变化,在规模大时很要紧。创建一个带默认值的字段,或者删除一个字段,都必须重写它所适用的每个对象的存储数据,所以在大表上,这项工作会交给一个后台任务,运行期间字段会显示“provisioning”或“deleting”。字段只有处于活动状态时才生效:在这两种操作进行期间,它不会出现在对象上、表单里、筛选器里,也不会出现在任何一套 API 里。这需要工作进程在跑,否则它会无限期地停在那个状态。
要添加的是关于这个东西本身的事实,就用自定义字段。值应该层层传递,就用配置上下文。你需要的东西根本不存在,就看下一节。
自定义下拉菜单,以及覆盖自带的选项
这个标题下面有两种不同的机制,它们解决的是不同的问题。一种用于你自己的字段。另一种改写 NetBox 的字段。
选项集,用于你自己的下拉字段
类型为“selection”的自定义字段从一个选项集里取选项,选项集是一个和其他东西一样在界面里管理的对象。这样“支持级别”就成了一个真正的下拉框,而不是一个会被人拼出三种写法的自由文本。
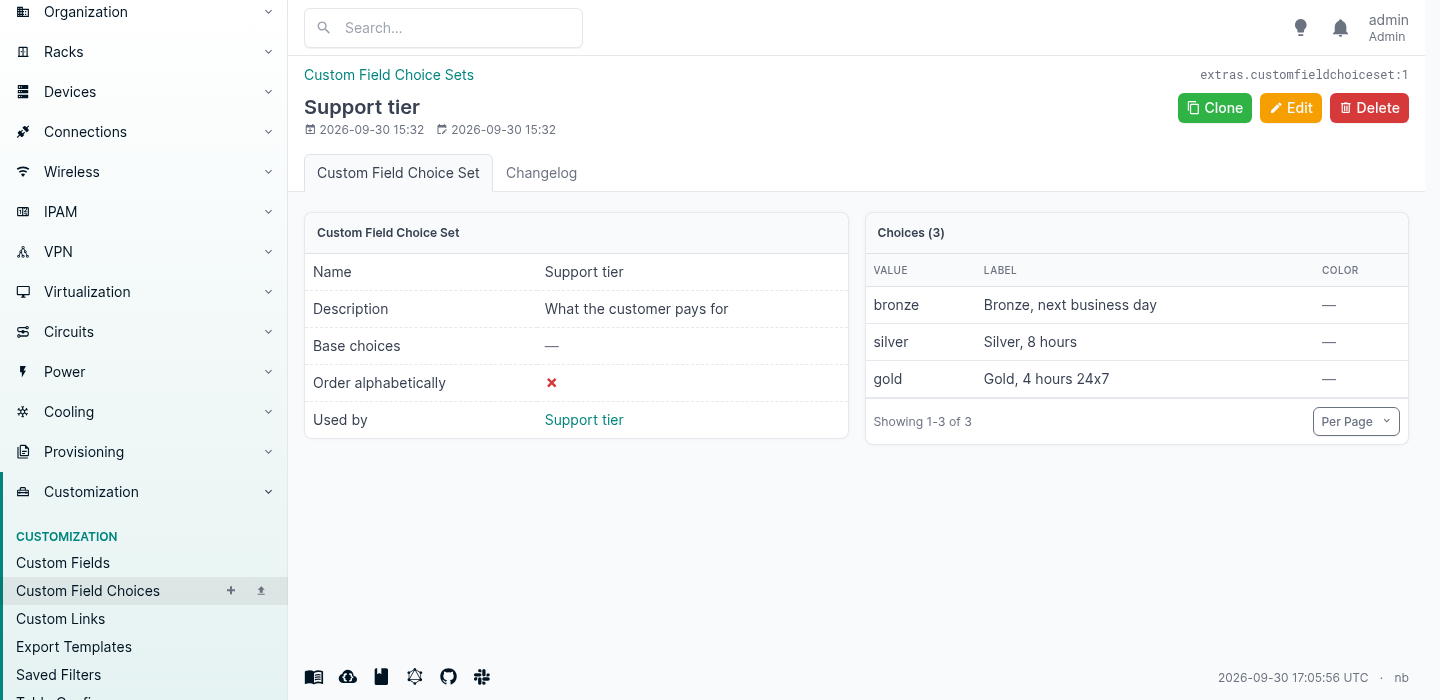
它是强制执行的,通过 API 也一样:
PATCH {"custom_fields": {"support_tier": "platinum"}}
  {"__all__": ["Invalid value for custom field 'support_tier':
                Invalid choice (platinum) for choice set Support tier."]}
选项集是共享的,所以一个选项集可以支撑几个模型上的同一个字段,在一个地方改列表,处处都跟着改。
FIELD_CHOICES,用于 NetBox 自己的字段
这个是大家不知道存在的那个。NetBox 有好几个内置的选项字段可以从 configuration.py 里扩展或替换,包括设备状态、站点状态、机柜状态、线路状态,以及很多别的。12
在名字后面加一个加号,就是在自带的列表上追加。不加,就是整个替换掉。
FIELD_CHOICES = {
    # add to what NetBox ships with
    'dcim.Device.status+': (
        ('burn-in', 'Burn-in', 'cyan'),
        {'value': 'awaiting-rma', 'label': 'Awaiting RMA', 'color': 'orange',
         'description': 'Faulty, with the vendor'},
    ),
    # replace the stock list outright
    'dcim.Site.status': (
        ('surveyed', 'Surveyed', 'purple'),
        ('building', 'Building out', 'orange'),
        ('active', 'Active', 'green'),
        ('closing', 'Closing', 'red'),
    ),
}
我在这套实例上就是这么配的。设备状态返回了七个自带值加上我的两个:
offline, active, planned, staged, failed, inventory, decommissioning,
burn-in, awaiting-rma
而站点状态只返回了我的值,自带列表没了:
surveyed, building, active, closing
一个选项可以是由值、标签和颜色组成的普通元组,也可以是一个字典,字典还能带一段描述,在表单里显示为副标题。它们在哪里都表现得和原生值一样,因为在 NetBox 其余部分看来,它们就是原生值:
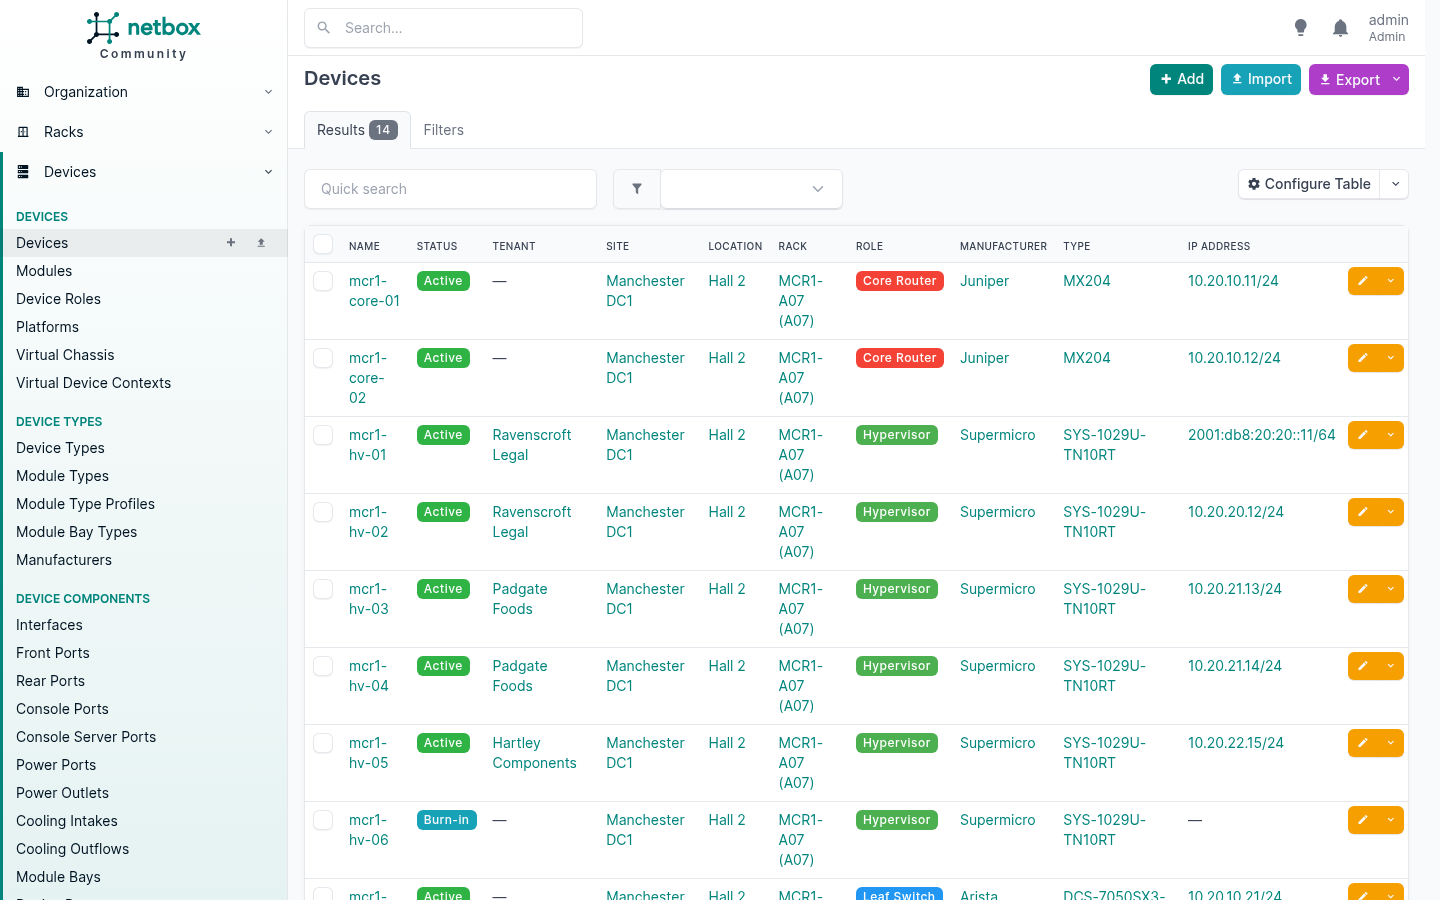
那个徽标就是我的状态,用的是我的颜色,排序和筛选都和其他状态一样。
用它之前,有三件事值得知道。
替换会把自带值从菜单里删掉,而不是从数据库里删掉。 已经持有其中某个值的对象会保留它,但这个值不再出现在选项里,下次有人编辑这个对象时,它也不再是合法的选择。如果你替换了一个列表,检查一下有没有东西还挂在你刚删掉的值上。
它在配置文件里,所以需要重启,也不是界面用户能改的东西。对服务商来说这样才是对的:你的业务认可哪些状态,是一个治理层面的决定,而不是某个星期二下午随手做的决定。
先扩展,再考虑替换。 自带值是每个插件、脚本和集成都预期会看到的。追加不花任何代价。替换是一个你要永远背着的决定。
自定义对象
这里有一个真正的空白。NetBox 能建模集群、虚拟机和虚拟磁盘。它不建模这些磁盘实际所在的数据存储(datastore),而对任何在跑 Proxmox 或 VMware 的人来说,正是这个对象把你买来的存储和使用它的工作负载连起来。
Custom Objects 插件让你在界面里或通过 API 定义一种新的对象类型,不用写任何代码。于是:
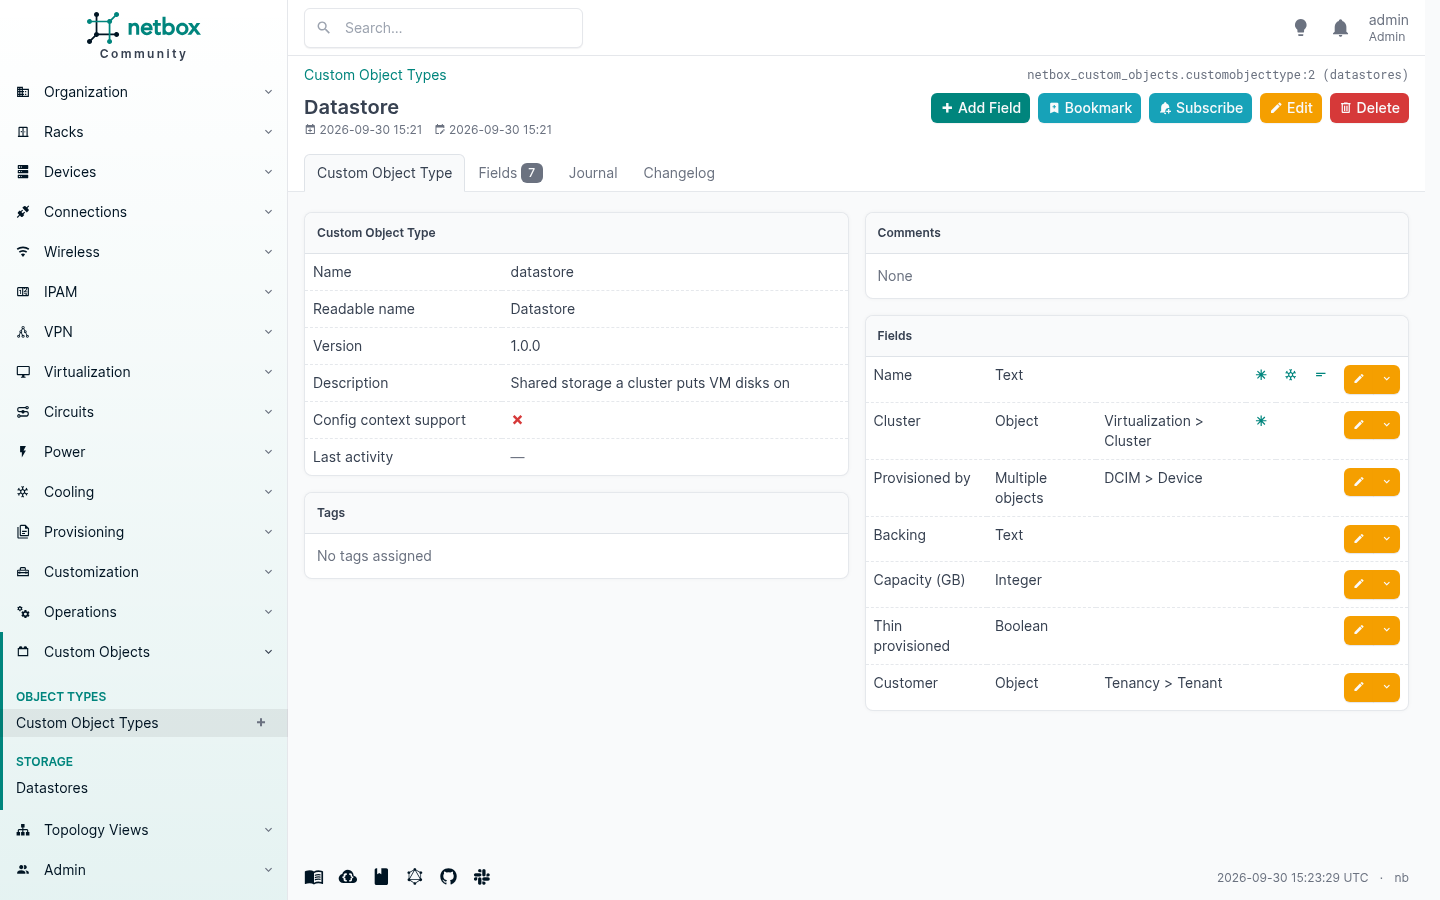
七个字段,其中两个是全部意义所在。cluster 是对一个真实 NetBox 集群的单对象引用,设为 protect,这样就没人能把集群从它的存储底下删掉。provisioned_by 是对实际提供这份存储的那些设备的多对象引用。
这样你就得到一个一等对象,有自己的导航入口、列表视图、筛选器、导入和导出:
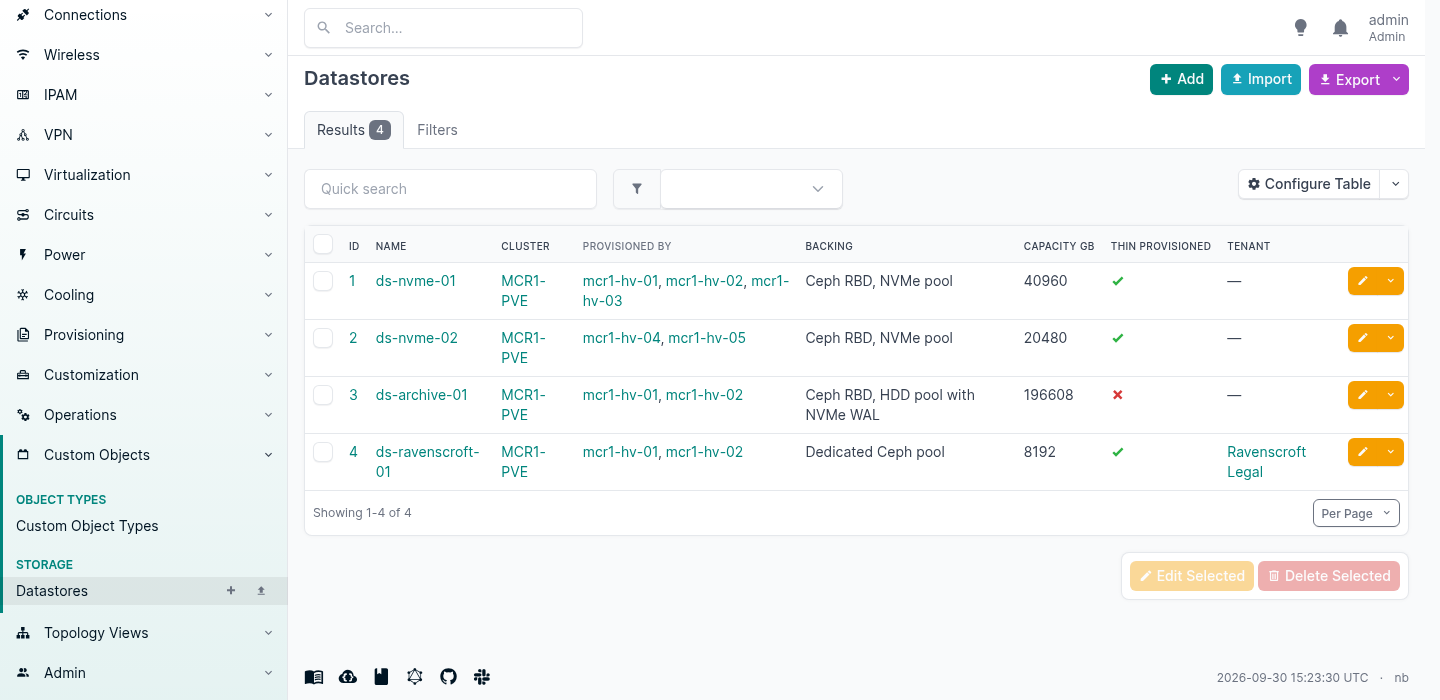
而且因为引用是真实的,这层关系从另一端也看得到。打开集群,数据存储就列在它下面。
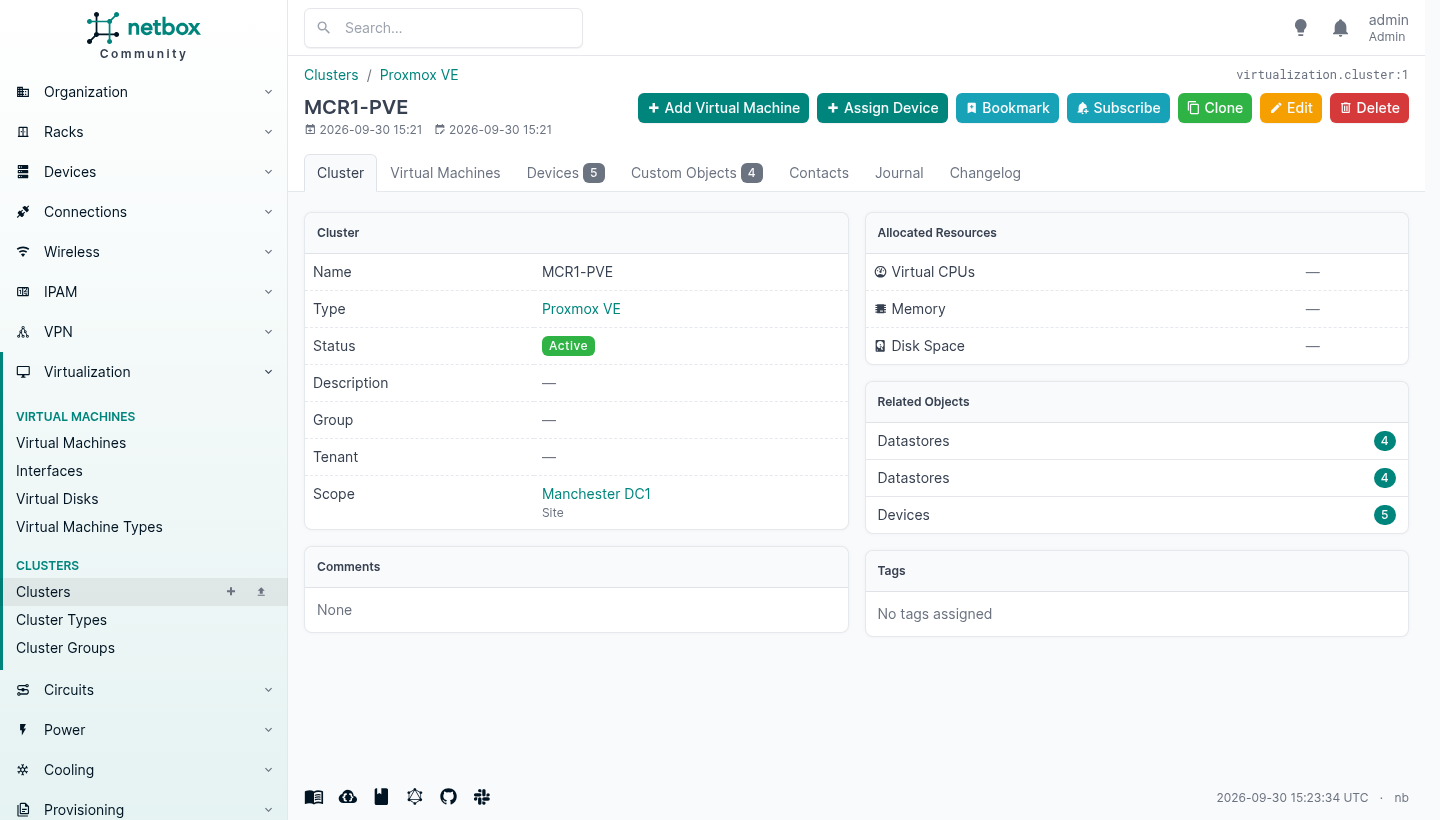
自定义对象类型继承了让一个 NetBox 对象成为 NetBox 对象的大部分东西:列表和详情视图、导航入口、REST 端点、全文搜索、变更日志、日志记录(journal)、标签、书签、导入导出、事件规则和通知。这些一行都不用写。
它也不是一个假装成表的 JSON 块。插件会执行真正的 DDL,出现在 PostgreSQL 里的是一张真正的表,带着真正的约束:
                    Table "public.custom_objects_2"
     Column      |   Type   | Nullable |     Default
-----------------+----------+----------+------------------
 id              | bigint   | not null | identity
 name            | varchar  |          |
 cluster_id      | bigint   |          |
 backing         | varchar  |          |
 capacity_gb     | bigint   |          |
 thin_provisioned| boolean  |          |
Indexes:
    "custom_objects_2_name_key" UNIQUE CONSTRAINT, btree (name)
Foreign-key constraints:
    ... FOREIGN KEY (cluster_id) REFERENCES virtualization_cluster(id) ON DELETE RESTRICT
我要求的 protect 变成了 ON DELETE RESTRICT,而且确实管用:删除那个集群会返回 409,并说出依赖它的是什么。
依赖它之前要知道的两件事
校验在表单上,不在 API 上。 这条会坑到自动化。我在一个自定义对象类型的字段上声明了 required、一个正则表达式和数值范围,然后通过 REST API 往里写:
| 我声明的 | 我发送的 | 结果 |
|---|---|---|
validation_regex | 一个什么都匹配不上的值 | 201 Created |
required: true | 完全省略这个字段 | 201 Created |
validation_minimum: 1 | 一个负数 | 201 Created |
unique: true | 一个重复值 | 400,被拒绝 |
on_delete_behavior: protect | 删除被引用的对象 | 409,被拒绝 |
守住的那两条,正是变成了数据库约束的那两条。其余的只存在于网页表单上,所以手工输入的人受约束,而每晚的同步任务不受。对比一下前面的核心自定义字段,同样的正则表达式通过 API 也被强制执行了。在这一点改变之前,凡是发票要依赖的东西,都要放在真正的约束后面。
删除一个类型就是删掉一张表。 删除一个字段就是删掉一列。这是从网页表单发出的 DDL,由任何有权限的人执行,文档也是这么说的。13 限制谁能删除这些东西。
什么时候该写一个真正的插件
如果这个对象很重要,如果有自动化往里写,如果你发现里面有垃圾数据会恼火,那就自己写模型。一个最小的 NetBox 插件包括一个 PluginConfig、一个模型、一个序列化器、一个视图集、一个表格、一个表单、几个视图和一张 URL 映射,总共不到两百行,大部分是声明。继承 PrimaryModel 就能免费得到标签、自定义字段、变更日志、日志记录、导出模板和所有权,而你加在模型上的每一条约束处处都会被强制执行,因为跑它的是 NetBox 自己的序列化器机制。
社区维护着一个 cookiecutter 模板和一份完整的插件教程。从它们开始,而不是从一个空目录开始。
而且它的许可证由你自己选,以后谁也改不了。
自定义校验,以及校验器类
上面讲的都是记录那里有什么。这一节讲的是拒绝记录不该有的东西。
NetBox 在写入每个对象之前都会校验它,你还可以在上面加自己的规则。一共有三种机制,都放在 configuration.py 里,合起来几乎能覆盖内部标准需要的一切。
其一:普通规则,不用写代码
校验器可以是一个从字段名到条件的普通映射。不用 Python,而且因为它只是数据,可以在不同安装之间移植。
CUSTOM_VALIDATORS = {
    'dcim.site': (
        {'description': {'required': True}},
    ),
    'dcim.device': (
        {'name': {'regex': r'^[a-z0-9]+-[a-z]+-([0-9]{2}|[a-z])$'}},
    ),
}
可用的条件有 min、max、min_length、max_length、regex、required、prohibited、eq 和 neq。你可以用点分路径伸进关联对象,所以站点上的 region.name 也可以拿来用,还可以按 request.user.username 匹配,不过文档非常正确地告诉你,这种事应该用权限来做。
上面两条规则都立刻生效:
POST a site with no description
  {"__all__": ["Custom validation failed for description:
                ['This field must not be empty.']"]}

POST a device named "Server1"
  {"__all__": ["Custom validation failed for name: ['Enter a valid value.']"]}
第二条就是一个被强制执行的命名规范。不是写在 wiki 页面上,不是存在某人脑子里,也不是新来的人三周后在评审里挨一顿说的那种东西。数据库不收。
其二:校验器类,当规则是一句话时
普通规则是拿一个字段去比一个常量。真正的内部规则通常是有条件的:只有当那个成立时,这个才要紧。对这类规则,你继承 CustomValidator,重写 validate(),然后调用 fail()。
我在 /opt/netbox/netbox/house_rules.py 的一个模块里放了三个:
from extras.validators import CustomValidator


class BillableKitNamesItsCustomer(CustomValidator):
    """Anything in a role we sell has to say whose it is."""
    BILLABLE_ROLES = {'hypervisor'}

    def validate(self, instance, request):
        role = getattr(instance, 'role', None)
        if role and role.slug in self.BILLABLE_ROLES and not instance.tenant:
            self.fail(
                f"A {role} is billable kit, so it must name the customer it belongs to.",
                field='tenant',
            )


class RackedDeviceNeedsAPosition(CustomValidator):
    """A device in a rack with no rack unit is a device nobody can find."""
    def validate(self, instance, request):
        if instance.rack and instance.position is None:
            if instance.device_type and instance.device_type.u_height:
                self.fail(
                    "A device in a rack needs a rack unit. Somebody has to find it.",
                    field='position',
                )


class CustomerPrefixNeedsATenant(CustomValidator):
    """A customer prefix that names no customer cannot be billed."""
    def validate(self, instance, request):
        role = getattr(instance, 'role', None)
        if role and role.slug == 'customer' and not instance.tenant:
            self.fail(
                "A customer prefix must be assigned to a tenant.",
                field='tenant',
            )
然后按点分路径把它们接上:
CUSTOM_VALIDATORS = {
    'dcim.device': (
        {'name': {'regex': r'^[a-z0-9]+-[a-z]+-([0-9]{2}|[a-z])$'}},
        'house_rules.BillableKitNamesItsCustomer',
        'house_rules.RackedDeviceNeedsAPosition',
    ),
    'ipam.prefix': (
        'house_rules.CustomerPrefixNeedsATenant',
    ),
}
注意,一个模型接受的是校验器的元组,普通规则和类可以随意混用,而且全部都会运行。哪怕只有一个校验器,也必须作为可迭代对象传进去,这是很容易白丢五分钟的地方。
然后规则就照它们说的那样执行:
POST a hypervisor with no tenant
  {"tenant": ["A Hypervisor is billable kit, so it must name
              the customer it belongs to."]}

POST a device into a rack with no position
  {"position": ["A device in a rack needs a rack unit.
                Somebody has to find it."]}

POST a prefix with role "customer" and no tenant
  {"tenant": ["A customer prefix must be assigned to a tenant."]}

POST a leaf switch with no tenant
  accepted, because a leaf switch is not in BILLABLE_ROLES
因为 fail() 接受一个 field 参数,错误信息会落在表单里正确的那个输入框上,而不是页面顶部,这就是一条大家学会的规则和一条大家怨恨的规则之间的区别。
这也是对自定义对象那一节里那个空白的回答。那里的校验只存在于网页表单上。CustomValidator 在模型层运行,所以它适用于界面、REST API、GraphQL 变更、批量导入,以及脚本做的任何事。写规则的地方只有一个,而且绕不过去。
其三:保护规则,针对删除
CUSTOM_VALIDATORS 守护写入。PROTECTION_RULES 守护删除,它接受的也正好是同样的两种形式。
PROTECTION_RULES = {
    'dcim.device': (
        {'status': {'eq': 'offline'}},
    ),
}
这表示一台设备只有在 offline 状态时才能被删除。效果是这样的:
DELETE an active device
  {"detail": "Deletion is prevented by a protection rule:
              [\"Custom validation failed for status:
                ['Ensure this value is equal to offline.']\"]"}

set it to offline, then DELETE
  204 No Content
在一个人和一台在线设备之间多加两下按键的阻力,这是整个应用里最便宜的保险。让下线流程成为解锁删除按钮的那个东西。
会坑到你的那一条
已有数据要到你下次碰它时才会被检查。 添加一条规则,并不会回头去校验已经存在的东西。它安静地待着,直到有人保存了一个违反它的对象,然后那个人就会收到一条错误,而错误针对的决定跟他毫无关系。
我亲眼看着它发生。mcr1-hv-06 是在我写下这些规则之前创建的,是一台没有租户的虚拟化主机。它在那儿待得好好的。然后我改了它的描述:
PATCH {"description": "touching it to trigger revalidation"}
  {"tenant": ["A Hypervisor is billable kit, so it must name
              the customer it belongs to."]}
这次编辑跟租户毫无关系。规则照样触发了,因为校验是针对整个对象运行的。
这是正确的行为,也正是一条新规则变成一张支持工单的过程。在启用一条规则之前,先查询会违反它的对象,把它们修好。API 让这件事很容易:规则本身就是一个过滤条件,所以查询带那个角色又没有租户的设备,你就拿到了清单。
然后再启用规则。这样它就只会抓新犯的错,这才是它的用途。
用 Ansible 驱动它
一个没人读取的真相来源会烂掉。netbox.netbox 集合是大多数人防止这件事发生的办法,而且它是双向的:NetBox 告诉 Ansible 有什么,Ansible 告诉 NetBox 它建了什么。
它的版本是 3.23.0,许可证是 GPL-3.0,在 Galaxy 上被拉取了超过 1340 万次。它带有 91 个模块和一个库存插件。14 下面所有内容都是对着同一套实例跑的,用的是一个只装了 ansible-core 2.21.4、pynetbox 7.8.0 和这个集合的容器。
库存清单是一次查询,而不是一个文件
这是第一个下午就能回本的那一半。nb_inventory 直接从 NetBox 构建你的 Ansible 库存清单:
plugin: netbox.netbox.nb_inventory
api_endpoint: http://netbox:8080
token: "{{ lookup('env', 'NETBOX_TOKEN') }}"
config_context: false
group_by:
  - sites
  - device_roles
  - tenants
  - racks
device_query_filters:
  - has_primary_ip: true
它产出的是这个,没有任何人在维护主机列表:
@sites_manchester-dc1:      @device_roles_hypervisor:
  |--mcr1-core-01             |--mcr1-hv-01
  |--mcr1-core-02             |--mcr1-hv-02
  |--mcr1-hv-01               |--mcr1-hv-03
  |--mcr1-hv-02               |--mcr1-hv-04
  ...                         |--mcr1-hv-05
@racks_MCR1-A07:            @tenants_ravenscroft-legal:
  |--mcr1-core-01             |--mcr1-hv-01
  |--mcr1-core-02             |--mcr1-hv-02
  ...                       @tenants_padgate-foods:
@device_roles_core-router:    |--mcr1-hv-03
  |--mcr1-core-01             |--mcr1-hv-04
  |--mcr1-core-02           @tenants_hartley-components:
                              |--mcr1-hv-05
看右边那一栏。因为设备上设了租户,你免费得到了每个客户一个组,所以 --limit tenants_ravenscroft-legal 会让一个 play 恰好只对一个客户的设备运行。在 NetBox 里加一台设备,下次运行时它就在组里了。下线一台,它就没了。没有人需要编辑任何东西。
每台主机到来时都带着 NetBox 对它的了解:
ansible_host     "2001:db8:20:20::11"
primary_ip4      "10.20.20.11"
primary_ip6      "2001:db8:20:20::11"
device_roles     ["hypervisor"]
sites            ["manchester-dc1"]
racks            ["MCR1-A07"]
tenants          ["ravenscroft-legal"]
device_types     ["sys-1029u-tn10rt"]
manufacturers    ["supermicro"]
status           {"label": "Active", "value": "active"}
总共二十二个键,其中一个值得在它让你吃惊之前注意到。ansible_host 是 IPv6 地址,因为那台设备设了 v6 主地址。我拿另外两台只有 v4 的设备核对过,它们返回的是 v4,所以规则是:有 v6 主地址的地方,插件优先用 v6。这是对的,但这种事你也宁可现在发现,而不是在纳闷某个 play 为什么走了一条你压根没想到的路径去连接时才发现。
写回去
模块是另一个方向,其中值得拥有的是 IP 分配,因为 NetBox 知道哪些是空闲的,而你的 playbook 不知道。
- name: Rack the device
  netbox.netbox.netbox_device:
    netbox_url: "{{ nb_url }}"
    netbox_token: "{{ nb_token }}"
    data:
      name: mcr1-hv-07
      device_type: SYS-1029U-TN10RT
      device_role: Hypervisor
      site: Manchester DC1
      rack: MCR1-A07
      position: 14
      face: Front
      tenant: Hartley Components
    state: present

- name: Let NetBox pick the next free address out of the customer prefix
  netbox.netbox.netbox_ip_address:
    netbox_url: "{{ nb_url }}"
    netbox_token: "{{ nb_token }}"
    data:
      prefix: 10.20.22.0/24
      tenant: Hartley Components
      assigned_object:
        device: mcr1-hv-07
        name: eno1
    state: new
注意里面没有什么。没有 IP 地址。你给出前缀,NetBox 就交回下一个空闲地址:
TASK [Let NetBox pick the next free address out of the customer prefix] ****
changed: [localhost]

"device   : mcr1-hv-07  (created)"
"interface: eno1  (created)"
"address  : 10.20.22.1/24  (allocated)"
一秒钟之后它就出现在界面里了,还没接任何线,但已经上架、有了租户、分好了地址:
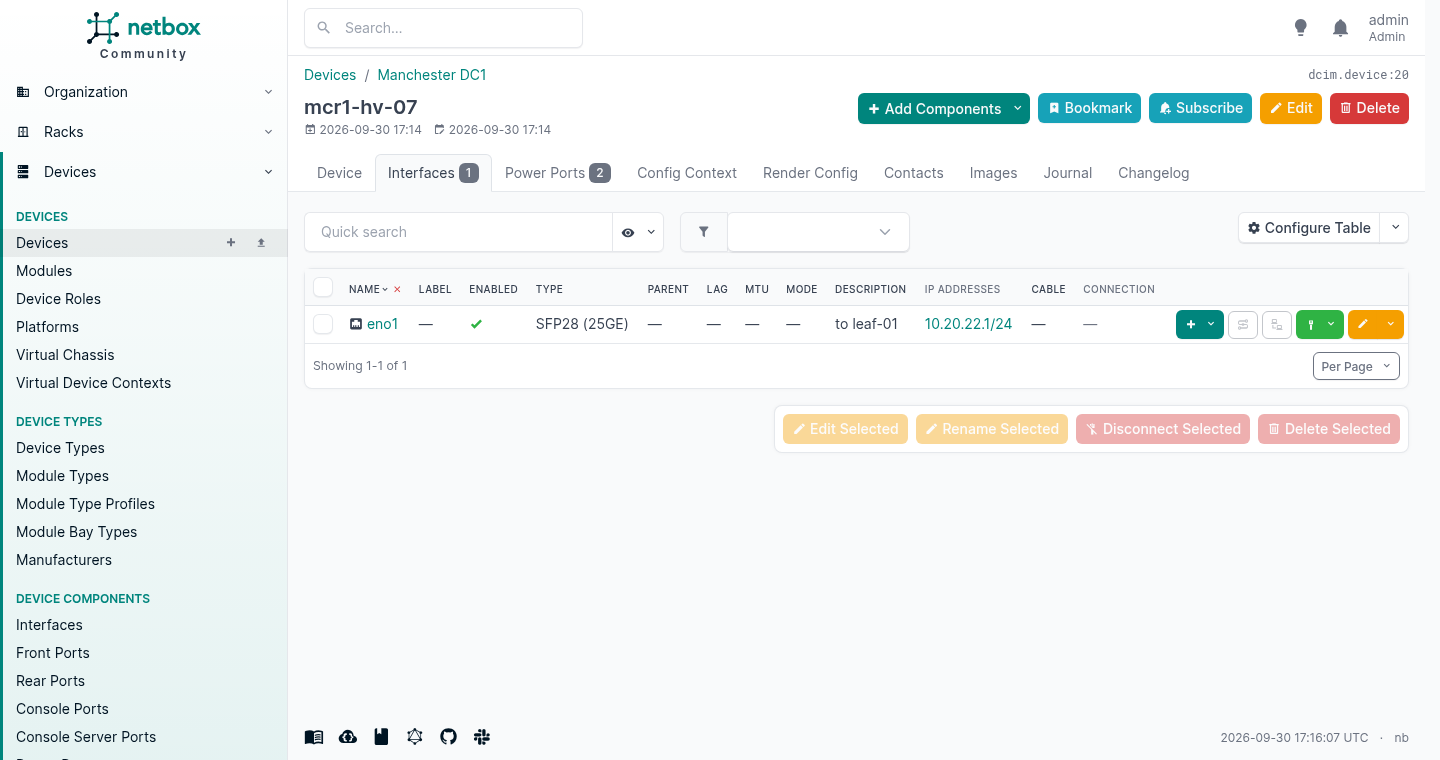
那个 playbook 里的陷阱
一行不改地再跑一次,就会发生这个:
"device   : mcr1-hv-07  (already correct)"
"interface: eno1  (already correct)"
"address  : 10.20.22.2/24  (allocated)"
设备和接口是幂等的。地址不是,而且这不是 bug。state: present 的意思是“让它变成这个样子”。state: new 的意思是“给我一个新的”,每一次都是,而它恰恰就是这么做的:跑两次之后,一个接口上有了两个地址。
如果你确实是在置备新东西,这没问题;如果你把它放进一个每晚运行的任务里,它会悄悄吃掉一整个前缀。分配一次并记录结果,或者用 state: present 加上你已经持有的地址。模块做的是你要求它做的事。问题在于,你要求的是不是你真正想要的。
不只是 Ansible
这个集合之所以受关注,是因为大多数网络团队本来就在用 Ansible,但 API 才是产品本身,能和它对话的东西多得很。
| 东西 | 它是什么 | 许可证 |
|---|---|---|
pynetbox | 这个集合自己用的 Python 客户端 | Apache 2.0 |
terraform-provider-netbox | 把 NetBox 对象作为 Terraform 资源来管理,由 e-breuninger 积极维护 | MPL 2.0 |
nornir_netbox | 把 NetBox 作为 Nornir 库存,给写 Python 而不是 YAML 的人用 | Apache 2.0 |
| Prometheus SD | 从 NetBox 给 Prometheus 提供抓取目标 | MIT |
go-netbox | 一个 Go 客户端,不过从 2025年5月起就没人动过 | 见仓库 |
| Diode | NetBox Labs 自己的数据摄取管道,用来把发现的数据推进去 | NetBox Limited Use |
对已经用 Terraform 管理基础设施的人来说,Terraform 那一项最有意思,因为它让一个 plan 同时创建云资源和记录它的 NetBox 条目,而不是把后一半留给某人的记性。15
Diode 的许可证和 Branching、Custom Objects 一样,所以在它上面搭东西之前,同样的解读也适用。
这一个下午到底买到了什么
上面所有内容花了我一台机器上的一天,而这一天的大部分时间都花在灌数据上,好让页面里有东西可看。两种方式的安装都是二十分钟。真正要紧的是那些决定,而它们都在第一个小时里做出:租户先于一切,设备类型先于设备,数字写在类型上而不是写在设备上。
你因此得到的不是文档。这个区别,没人会去分,直到两样都经历过:文档是你写完之后就不再维护的东西。你得到的是一个拒绝容纳矛盾的数据库:它不让你把两样东西放进同一个 U,不让你把一个机柜放进属于另一个站点的位置,也不让你把一台设备建在一个不存在的类型上。每一次拒绝,都是你六个月后不用再吵的一场架。
而且它会告诉你没人问过它的事。那个机柜设备装了 28.6%,电力却用了 90.7%。没有人专门去找这件事。它只是因为有人在一个设备类型上填过一次功率就自己冒了出来,而这就是“把下一批订单装进那里”和“吃了苦头才发现”之间的区别。
老实的提醒,和每个真相来源都一样。它的价值只等于你为保持它正确所付出的成本,而唯一能熬过一个忙碌季度的版本,是数据一错就会有东西明显坏掉的那种。把你的监控、置备或防火墙规则接上去从它读取,一条错误的记录就不再是某人迟早会处理的文档问题。它会变成某个星期二早上九点半的一次故障,上面写着一个名字。这听起来像是代价。它就是整个机制本身。
也不会有人为此感谢你。一份正确的记录,体现为一次花了两周而不是一个季度的迁移,一次花了一个下午的审计,一个在电话里得到了直截了当回答的客户。这些都不会出现在某份报表上你的名字旁边。
照样去做。另一种选择是一个连自己都描述不清的企业,而一个连自己都描述不清的企业不是在被经营。它是在被记着,而记得的人一年比一年少。
NetBox, Introduction — “Today, the open source project is stewarded by NetBox Labs and a team of volunteer maintainers”,以及它 2015 年起源于 DigitalOcean、2016年6月开源的经过。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
NetBox, LICENSE.txt — Apache License 2.0,版权归 DigitalOcean, LLC。起源和管理方信息见 the introduction。 ↩︎ ↩︎
Nautobot v1.0.0 release notes — “a divergent fork of NetBox 2.10”,发布于 2021年4月26日,并列出了它相对 NetBox 2.10 增加的内容。 ↩︎ ↩︎
Network to Code, “Why Did Network to Code Fork NetBox?”,2021年2月25日 — 关于 SLA 和长期支持的理由、愿景的分歧,以及“the NetBox project team suggested that we should consider forking”。 ↩︎
NetBox Labs 成立于 2023 年,是 IBM 收购 NS1 之后从 NS1 分拆出来的,联合创始人之一是 NetBox 首席维护者 Jeremy Stretch,并于 2023年4月宣布完成 2000 万美元 A 轮融资:NetBox Labs, “Let’s Go: Announcing NetBox Labs” 以及 the Series A announcement。 ↩︎
NetBox Labs, NetBox Enterprise — 自行管理的商业版,提供“24/7 expert assistance from the NetBox Labs team”;NetBox Cloud 是托管版本。该页面未公布具体的 SLA 条款。 ↩︎
两个项目的 star 和 fork 数、发布日期和许可证,于 2026年9月30日读自 GitHub API:netbox-community/netbox 和 nautobot/nautobot。Nautobot 并行发布的 3.2.x 和 2.4.x 日期均为 2026年9月28日。 ↩︎
netbox-community/netbox-docker — 社区维护的容器栈,Apache 2.0。 ↩︎
NetBox, Installation — 受支持版本表;PostgreSQL 和 Redis 最低版本的提高见 the v4.7 release notes。版本和发行版信息读自
netbox/release.yaml。 ↩︎NetBox Limited Use License 1.0 — netbox-custom-objects 采用此许可证,netbox-branching 采用的与之完全相同。文中引用的两段条款均为原文。 ↩︎
NetBox, HTTP Server installation, “What’s Next?” — “Some of the most popular plugins include” NetBox Branching、NetBox Custom Objects、NetBox DNS 和 NetBox BGP,未提及任何许可条款。 ↩︎
NetBox, Data Validation configuration —
FIELD_CHOICES,以及表示扩展而非替换的加号后缀:“To replace the available choices, specify the app, model, and field name separated by dots … To extend the available choices, append a plus sign”。 ↩︎netboxlabs/netbox-custom-objects documentation — “Deleting a Custom Object Type drops an entire database table and should be done with caution.” ↩︎
netbox.netbox on Ansible Galaxy 和 netbox-community/ansible_modules — 版本 3.23.0,GPL-3.0,91 个模块加上
nb_inventory库存插件。下载次数于 2026年9月30日读自 Galaxy。文中展示的一切都是用 ansible-core 2.21.4 和 pynetbox 7.8.0 跑出来的。 ↩︎许可证、活跃度和 star 数于 2026年9月30日读自各项目:pynetbox(Apache 2.0)、terraform-provider-netbox(MPL 2.0,Terraform registry 上为 v6.0.0-rc.1)、nornir_netbox(Apache 2.0)、netbox-plugin-prometheus-sd(MIT)、go-netbox(最后一次推送为 2025年5月9日),以及 Diode,它采用与 Branching 和 Custom Objects 相同的 NetBox Limited Use License 1.0。 ↩︎