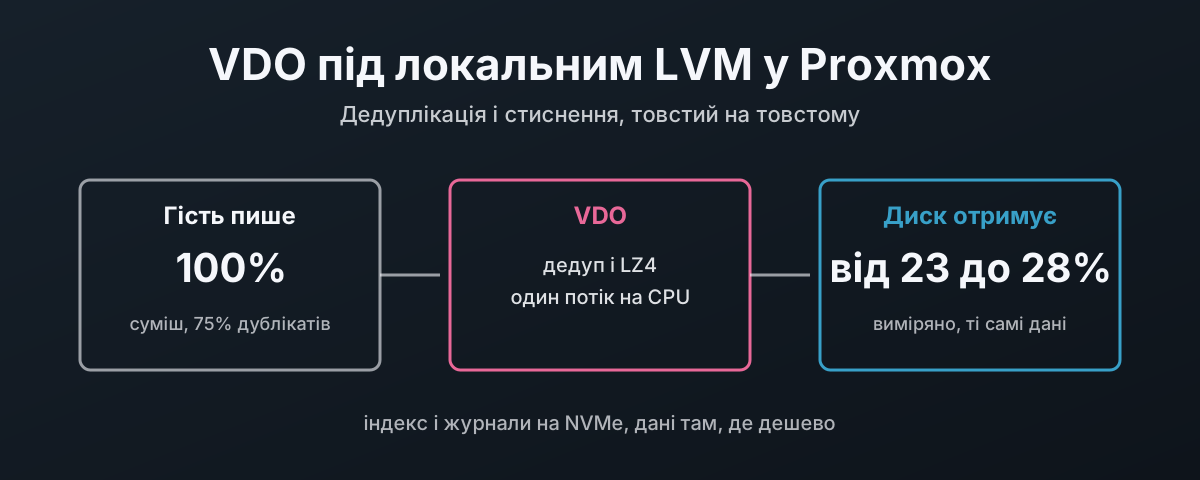
До диска доходить менше байтів
VDO це шар дедуплікації і стиснення в ядрі Linux. Він сидить під групою томів і працює блоками по 4 KiB. Кожен блок, який він уже бачив, він зберігає один раз.
Що це означає для заліза, просто. До диска доходить менше байтів. Я записував через VDO суміш, яка на 75 % складалася з дублікатів і на 50 % стискалася, по 30 секунд за раз, і власні лічильники диска показали, що він отримав від 23 до 28 % того, що записав гість. Шість повних клонів диска шаблону додали між собою 8 блоків даних. Тридцять два кілобайти.
Менше байтів означає менше зносу і менше роботи для будь-якого кешу на диску чи на контролері перед ним. Щоб туди дістатися, доводиться платити процесором і затримкою, і на швидкому диску ця ціна виміряна нижче порівняно з тим самим Optane зовсім без VDO. На повільних обертових дисках та сама ціна розчиняється в часі пошуку, і саме тут стає цікаво.
Усе, що далі, визначають два правила. Стек товстий на товстому: ніщо над VDO, і сам VDO, не може обіцяти більше місця, ніж має диск. А власні метадані VDO, його індекс і журнали, можуть жити на NVMe, тоді як дані живуть десь повільніше.
Кожне число тут отримано на одному хості Proxmox VE 9.2, Ryzen 7 5700G з 16 CPU, ядро 7.0.14-25-pve, LVM 2.03.31 і інструменти Debian vdo 8.3.1.1, на двох дисках Intel Optane, які потім затерли.
Що таке VDO і де він сидить
Ядро описує dm-vdo як ціль device-mapper, яка «provides block-level deduplication, compression, and thin provisioning»1. Кожен вхідний блок на 4 KiB хешується. Якщо ідентичний блок уже збережено, VDO записує посилання замість копії. Блоки, що не є дублікатами, проходять крізь LZ4 і пакуються по кілька в один фізичний блок, а блоки з самих нулів не зберігаються взагалі2.
Усім цим керує LVM.
lvcreate --type vdo створює пул VDO, який тримає реальні блоки, і VDO LV поверх нього з таким віртуальним розміром, який попросиш2.
Товста група томів іде на VDO LV, і Proxmox використовує її як звичайне сховище lvm.
| Шар | Назва в лабораторії | Що робить |
|---|---|---|
| Диски VM | vm-9901-disk-0 і так далі | товсті LV, які створює Proxmox |
| Група томів | vdovg, 35 GiB | звичайний LVM, його читає сховище lvm у Proxmox |
| VDO LV | vdolab/vdolv, 35 GiB віртуальних | дедуп, LZ4, нульові блоки відкинуто |
| Пул VDO | vdolab/vdopool, 40 GiB | реальні блоки, метадані та індекс VDO |
| Фізичний | nvme8n1 | VG vdolab |
Товстий на товстому, або ніяк
VDO сам по собі є тонким провізором: VDO LV можна дати будь-який віртуальний розмір. Зроби його більшим, ніж може вмістити пул, і група томів зверху буде товстою на обіцянці, а це тонкий на тонкому, просто на шар нижче. Саме так я і зробив під час першої збірки, VDO LV на 120 GiB на пулі в 40 GiB, і Proxmox показував третину сховища вільною, тоді як VDO був повний.
Тож задавай розмір VDO LV під те, що пул справді може адресувати, і не більше.
lvcreate друкує цю цифру, «can address 36.00 GB» на цьому пулі в 40 GiB, а карта блоків VDO для логічного простору береться з того самого місця, тож я дав йому 35 GiB.
Потім я довів це важким способом. Один диск VM, що забрав усі екстенти, які дав би Proxmox, 34 GiB, заповнений від початку до кінця випадковими даними, з якими VDO нічого не може вдіяти:
# vdostats --human-readable
Device                    Size      Used Available Use% Space saving%
vdolab-vdopool-vpool     40.0G     38.1G      1.9G  95%            0%
Диск закінчився на власному кінці, як і має товстий диск. У VDO лишалося 1,9 GiB вільного, більше, ніж 1 GiB, який Proxmox ще міг виділити. Цифра Proxmox і є реальною межею, і VDO не може закінчитися першим.
Від чого ти відмовляєшся, то це від переобіцянки: місце, яке заощаджує дедуплікація, з’являється як диск, на який ніколи не пишуть, а не як додаткові диски для Proxmox. Для цього допису, який про залізо, це правильний обмін. І пул lvmthin на це теж не став. Два тонкі шари це дві бухгалтерські книги3.
Скільки це коштує, ще до першого збереженого байта
VDO тримає індекс дедуплікації, індекс UDS, на самому пулі.
Порожній пул на 40 GiB показав 4,0 GiB зайнятими і 36,0 GiB доступними.
vdolistmetadata, з того самого пакета vdo, перелічує кожен блок метаданих на пристрої і пояснює майже все:
| Область | Блоків по 4 KiB | Розмір |
|---|---|---|
| Індекс UDS | 679 127 | 2,59 GiB |
| Журнал відновлення | 32 768 | 128 MiB |
| Лічильники посилань і журнали, 18 слебів | 6372 | 25 MiB |
| Місце, замале для дев’ятнадцятого слеба | 336 555 | 1,28 GiB |
| Разом | близько 4,0 GiB |
Рядок із залишком варто знати: слеби мають 2 GiB, тож задавай розмір пулу цілими слебами плюс накладні витрати, інакше залишок просто не використовується.
Другий рахунок це RAM. Його платиш, хоч пул зайнятий, хоч простоює:
| Витрата | Правило з lvmvdo(7) | Цей пул на 40 GiB |
|---|---|---|
| Фіксована | 38 MiB | 38 MiB |
| Кеш карти блоків | 1,15 MiB на MiB кешу, мінімум 150 MiB | 150 MiB (128 MiB за замовчуванням) |
| Фізичний простір | 268 MiB на TiB | 11 MiB |
| Індекс UDS (dense) | мінімум 250 MiB, за замовчуванням | 256 MiB |
| Разом | близько 455 MiB |
Щільний індекс за замовчуванням покриває вікно дедуплікації приблизно в 256 GiB, бо щільний індекс з 1 GiB RAM «maintains a 1 TiB deduplication window»2. Кеш карти блоків на 128 MiB розраховано на «efficient access to 100 GB of logical space at a time», і документація ядра називає його найважливішим значенням, яке слід підлаштовувати, коли робочий набір зростає1.
Збираємо стек
Хай LVM бачить PV на LV
Група томів сидить на LV, а LVM за замовчуванням ігнорує LV як фізичні томи.
devices/scan_lvs це вмикає, і довідник LVM містить попередження, яке йде разом із цим: «Caution is required to avoid using PVs that belong to guest images stored on LVs»4.
Інакше гість, який використовує LVM усередині власного диска, побачив би, як його групи томів з’являються на хості.
Тож фільтр теж змінюється. Те саме редагування. Штатний фільтр на цьому хості відкидав лише zvol від ZFS і пристрої RBD. Я додав відкидання для кожного диска VM у Proxmox:
# lvmconfig devices/global_filter devices/scan_lvs
global_filter=["r|/dev/zd.*|","r|/dev/rbd.*|","r|/dev/mapper/.*-(vm|base)--[0-9]+--disk--[0-9]+|"]
scan_lvs=1
Той самий довідник каже, що scan_lvs «does not enable autoactivation of layered VGs»4.
Proxmox це й не потрібно. Його плагін LVM активує кожен диск через lvchange -aey, коли стартує VM5.
Я перевірив це так, як усе лишається після завантаження: усе деактивовано, а потім запускаються ті самі udev-виклики pvscan. VG під VDO піднялася, а qm start сам активував диск VM.
Підступ лежить нижче. Коли VG під VDO була неповною, той самий qm start падав з «Volume group „vdovg“ not found».
Пул VDO, товстий, з налаштуваннями в рядку створення
Форматувальник лежить у пакеті Debian vdo6:
# apt install vdo
Потім пул.
-L це реальний простір, -V віртуальний розмір, який тримають у межах того, що пул може адресувати.
Розкладка потоків і розмір discard ідуть у тому самому рядку, бо жодне з них не можна змінити пізніше, не зупинивши всі VM на пулі:
# pvcreate /dev/nvme8n1
  Physical volume "/dev/nvme8n1" successfully created.
# vgcreate vdolab /dev/nvme8n1
  Volume group "vdolab" successfully created
# lvcreate -y --type vdo -L 40G -V 35G -n vdolv vdolab/vdopool /dev/nvme8n1 --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  Wiping vdo signature on /dev/vdolab/vdopool.
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "vdolv" created.
# dmsetup table vdolab-vdopool-vpool
0 73402368 vdo V4 /dev/dm-7 10485760 4096 32768 16380 deduplication on compression on maxDiscard 4096 ack 1 bio 2 bioRotationInterval 64 cpu 3 hash 2 logical 4 physical 4
Розкладка потоків та, що виміряна нижче для хоста з 16 CPU; max_discard=4096 має власний розділ.
Група томів і сховище Proxmox
# pvcreate /dev/vdolab/vdolv
  Physical volume "/dev/vdolab/vdolv" successfully created.
# vgcreate vdovg /dev/vdolab/vdolv
  Volume group "vdovg" successfully created
# pvesm add lvm vdo-lvm --vgname vdovg --content images,rootdir --on-volume-remove discard=1
# pvesm status | grep -E "Name|vdo-lvm"
Name             Type     Status     Total (KiB)      Used (KiB) Available (KiB)        %
vdo-lvm           lvm     active        36696064               0        36696064    0.00%
on-volume-remove discard=1 важливий, і про нього йдеться нижче.
Що заощадила дедуплікація
Я записував те, що хост Proxmox справді зберігає, і після кожного запису читав лічильники блоків VDO.
logical blocks used це те, що записали шари вище; data blocks used це те, що зберіг VDO. Обидва в блоках по 4 KiB.
| Що записано | Додано логічних блоків | Додано блоків даних | Заощаджено |
|---|---|---|---|
| rootfs Rocky Linux 10, ext4 на диску 4 GiB | 114 505 | 60 537 | 47 % |
Шість його повних клонів (qm clone --full, близько 4 с кожен) | 6 291 456 | 8 | 99,9999 % |
| ISO Proxmox Datacenter Manager 1.1, 1,36 GiB | 356 172 | 351 965 | 1,2 % |
Його перезбірка -auto, майже ті самі байти | 356 399 | 40 | 99,99 % |
| 4 GiB нулів | 1 048 575 | 0 | 100 % |
| 1 GiB випадкових даних | 262 143 | 262 144 | 0 % |
Кожен клон записав усі 4 GiB, нулі включно, бо повний клон на товстий LV копіює кожен блок. VDO зберіг нулі як ніщо, а решту як посилання.
VDO дуже добрий на даних, які вже бачив. І на нічому. Він марний на даних, які вже стиснуті чи зашифровані, і тому перший ISO, здебільшого squashfs, заощадив 1,2 %.
З шаблоном і шістьма його клонами на місці Proxmox показував сховище зайнятим на 80,01 %, 28 GiB товстих дисків із 35. Диск тримав 4,3 GiB, і більшість цього був індекс. На товстому сховищі в цьому й суть: Proxmox рахує, що виділено, а диск несе те, що справді відрізняється.
Що диск отримує насправді
Економія на диску це знімок. Залізу важливий потік.
Тож я вимірював байти, що доходять до диска під час запису: fio на 30 секунд, лічильник записів диска з /sys/block до і після, той самий Optane з VDO і без нього, по два рази.
Лічильник чесний. За весь прогін він набрав 794 GB, і власний SMART диска «Data Units Written» теж зрушив на 794 GB.
| Навантаження, 30 с | Без VDO | З VDO, 16 потоків | Байтів доходить до диска |
|---|---|---|---|
| 4k випадковий запис, QD32, 4 завдання, 75 % дублікатів, 50 % стиснення | 582 013 IOPS, p99 244 мкс | 460 887 IOPS, p99 1,05 мс | 28 % |
| 128k запис, QD8, 75 % дублікатів, 50 % стиснення | 2345 MiB/s, p99 490 мкс | 2179 MiB/s, p99 1,02 мс | 23 % |
| 4k випадковий запис, QD32, 4 завдання, випадкові дані | 571 721 IOPS | від 272 366 до 381 005 IOPS | від 59 до 100 % |
| 128k запис, QD8, випадкові дані | 2346 MiB/s | від 1051 до 1854 MiB/s | 100 % |
На реалістичній суміші VDO зберіг від 79 до 93 % пропускної здатності голого диска і відправив йому чверть байтів. На повністю випадкових даних він нічого не заощаджує і коштує багато, а два прогони розійшлися так сильно, що я наводжу лише діапазон.
Хвостова затримка це власна обробка VDO, а не диск. p99 близько мілісекунди, проти чверті мілісекунди на голому диску.
Optane не має кешу, який можна розвантажити
Ці диски самі про це кажуть: vwc 0 з nvme id-ctrl, write through у /sys/block.
Optane пише на місці без проміжного DRAM чи SLC, тож на цьому залізі виграш це байти і знос, а не кеш диска, що заповнюється повільніше.
NAND SSD з кешем SLC або RAID-контролер з кешем зворотного запису це місця, де менше байтів купує ще й чутливість. Про це розділ про RAID6 нижче.
Підбираємо потоки VDO під CPU
Із коробки LVM дає VDO десять потоків: один logical, один physical, одну hash zone, два CPU, чотири на bio submission, один на acknowledgement. На хості з 16 CPU це лишає більшу частину машини без діла, тоді як робота VDO з картою блоків стоїть у черзі за одним логічним потоком.
Документація ядра пояснює ці регулятори1. Логічні потоки володіють кожен «a disjoint section of the block map», фізичні потоки «a disjoint section of the data blocks», і обидва «can increase throughput», тоді як зайві потоки «can waste resources and increase contention». Логічних потоків може бути до 60, фізичних до 16, і пулу потрібен щонайменше один слеб на фізичний потік. При 18 слебах цьому пулу місця досить.
| Розкладка | logical | physical | hash | cpu | bio | ack | Разом |
|---|---|---|---|---|---|---|---|
| Типові для LVM | 1 | 1 | 1 | 2 | 4 | 1 | 10 |
| Під 16 CPU | 4 | 4 | 2 | 3 | 2 | 1 | 16 |
| Удвічі більше | 8 | 8 | 4 | 6 | 2 | 2 | 30 |
Кожна розкладка двічі проганяла ті самі завдання fio, по черзі, з випадковими даними, плюс читання всіх семи дисків клонів одночасно, так, як разом завантажуються сім VM:
| Тест, середнє з двох прогонів | Типові | Під 16 CPU | Удвічі більше |
|---|---|---|---|
| 4k випадковий запис, QD32, 4 завдання | 292 466 IOPS | 365 314 IOPS | 302 461 IOPS |
| 4k випадковий запис p99, 4 завдання | від 2,1 до 3,7 мс | від 1,5 до 1,6 мс | від 2,1 до 2,2 мс |
| 1M послідовний запис | 1153 MiB/s | 1729 MiB/s | 1507 MiB/s |
| 4k випадкове читання, QD32, 4 завдання | 507 450 IOPS | 503 827 IOPS | 485 263 IOPS |
| Сім дисків клонів, читання одночасно | 7,5 с | 3,1 с | 3,4 с |
Розкладка під кількість CPU виграє майже все: на чверть більше паралельних записів, у півтора раза більше на послідовних записах, сім дисків читаються в 2,4 раза швидше, і щільніший хвіст. Подвоєння ще раз гірше в усьому. Це та конкуренція, про яку попереджає документація. Типові значення також були найменш стабільними: читання семи дисків гуляло від 6,1 до 8,8 с між прогонами.
Як таке, правило: один потік VDO на CPU, розподілений за типами, як вище, з фізичними потоками, обмеженими кількістю слебів.
Скільки VDO коштує на швидкому залізі
Той самий Optane без VDO проти VDO з підібраними потоками, випадкові дані, середнє з двох прогонів:
| Тест | Optane, без VDO | VDO, 16 потоків |
|---|---|---|
| 4k випадковий запис, QD1 | 42 294 IOPS, 19,4 мкс | 55 806 IOPS, 12,1 мкс |
| 4k випадковий запис, QD32 | 142 416 IOPS | 144 292 IOPS |
| 4k випадковий запис, QD32, 4 завдання | 572 293 IOPS | 365 314 IOPS |
| 4k випадкове читання, QD1 | 55 276 IOPS, 14,4 мкс | 27 988 IOPS, 31,4 мкс |
| 4k випадкове читання, QD32, 4 завдання | 586 463 IOPS | 503 827 IOPS |
| 1M послідовний запис, QD8 | 2348 MiB/s | 1729 MiB/s |
| Сім дисків шаблону, читання одночасно | 11,1 с | 3,1 с |
Читай це прямо. Одне випадкове читання крізь VDO займає більш ніж удвічі довше. Паралельні випадкові записи втрачають більше третини, послідовні записи чверть. На такому швидкому диску 17 мкс додаткової роботи VDO на читання це більша частина самого читання.
Те, що запис QD1 крізь VDO швидший, не є безкоштовним обідом. Далеко ні. VDO підтверджує запис ще до того, як той опинився на диску, і документація ядра прямо каже, що «unflushed writes may or may not persist after a crash»1. Це число вимірює підтвердження. Гість, який робить flush, а так робить кожна файлова система, отримує ту надійність, яку просить.
Рядок про сім дисків VDO виграє вщент, і варто чітко сказати чому. Сім звичайних копій мусять прочитати 28 GiB реальних байтів, нулі включно. VDO читає один набір спільних блоків і пропускає нулі.
Тож на швидкій флеш-пам’яті VDO міняє затримку на байти. Але кожна з цих мікросекунд це фіксована ціна, і вона не росте, коли диск під ним стає повільнішим.
Кладемо метадані VDO на NVMe
У VDO немає окремого пристрою для метаданих. Усе живе на одному LV пулу. Але код dm-vdo показує, що розкладка фіксована, а LV можна зібрати зі шматків на різних дисках.
Код форматування розміщує корені карти блоків від початку області даних, потім зведення слебів і журнал відновлення від кінця, а середину заповнює слебами7.
Індекс UDS сидить перед усім цим, одразу після блока геометрії.
vdolistmetadata підтвердив це на лабораторному пулі:
| Блоки | Що | Де сидить |
|---|---|---|
| від 0 до 679 188 | геометрія, індекс UDS, суперблок, корені карти блоків | перші 2,59 GiB |
| усередині кожного слеба на 2 GiB | дані, листки карти блоків, 130 блоків посилань і журнал слеба на 224 блоки | розкидані по пулу |
| від 10 452 928 до 10 485 695 | журнал відновлення | майже останні 128 MiB |
| від 10 485 696 до 10 485 759 | зведення слебів | найостанніші 256 KiB |
Тож збирай LV пулу з трьох шматків: голова на NVMe, середина на повільному диску, хвіст на NVMe.
Потім перетвори його на пул VDO, що lvmvdo(7) документує для наявного LV2.
Тут nvme6n1 грає роль NVMe, а nvme8n1 роль повільного диска:
# lvcreate -y -L 3G -n splitpool vdolab /dev/nvme6n1
  Logical volume "splitpool" created.
# lvextend -l +9408 vdolab/splitpool /dev/nvme8n1
  Size of logical volume vdolab/splitpool changed from 3.00 GiB (768 extents) to 39.75 GiB (10176 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvextend -l +64 vdolab/splitpool /dev/nvme6n1
  Size of logical volume vdolab/splitpool changed from 39.75 GiB (10176 extents) to 40.00 GiB (10240 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvconvert -y --type vdo-pool -n splitlv -V 35G vdolab/splitpool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  WARNING: Converting logical volume vdolab/splitpool to VDO pool volume with formatting.
  THIS WILL DESTROY CONTENT OF LOGICAL VOLUME (filesystem etc.)
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "splitlv" created.
  Converted vdolab/splitpool to VDO pool volume and created virtual vdolab/splitlv VDO volume.
Потім перевір, що VDO поклав свої метадані туди, де лежать екстенти:
# vdolistmetadata /dev/mapper/vdolab-splitpool_vdata | grep -v "slab [0-9]* \(reference\|journal\)"
0 .. 0: geometry block
1 .. 679127: index
679128 .. 679128: super block
679129 .. 679188: block map tree roots
10452928 .. 10485695: recovery journal
10485696 .. 10485759: slab summary
Екстент це 1024 блоки. Голова на NVMe це екстенти від 0 до 767, блоки від 0 до 786 431, що покриває індекс і корені, плюс близько 420 MiB даних першого слеба, які їдуть заодно. Хвіст на NVMe це екстенти від 10 176 до 10 239, блоки від 10 420 224 і далі, що покриває журнал відновлення і зведення слебів.
Скільки роботи VDO переїжджає разом із ними, на 30-секундний прогін, з підрахунком по пристроях:
| Навантаження | Операцій запису на NVMe | Операцій запису на диск даних | Частка NVMe |
|---|---|---|---|
| 4k випадковий запис, 75 % дублікатів, 50 % стиснення | від 388 430 до 538 223 | від 3,42 до 3,63 мільйона | від 10 до 13 % |
| 128k запис, 75 % дублікатів, 50 % стиснення | від 458 214 до 634 167 | від 3,30 до 3,53 мільйона | від 12 до 15 % |
| 4k випадковий запис, випадкові дані | від 181 457 до 384 507 | від 3,25 до 8,49 мільйона | від 4 до 5 % |
| 4k випадкове читання | 0 записів, 2 % читань | 0 |
Десь десята частина операцій запису: журнал відновлення, оновлення індексу і той шматок слеба 0 на голові NVMe. Це дрібні розкидані записи метаданих, саме той тип, з яким обертовий диск справляється найгірше. На NVMe вони ніщо.
Два обмеження.
Метадані кожного слеба, лічильники посилань, журнали слебів і листки карти блоків, живуть усередині слебів і лишаються з даними.
І я не перевіряв нарощування розділеного пулу. Журнал розміщується від кінця, тож після будь-якого lvextend знову запусти vdolistmetadata і подивися, куди він подівся, перш ніж йому довіряти.
VDO на bcache: один NVMe, дві ролі
bcache це інший спосіб поставити флеш перед повільними дисками. Саме його я вже використовую під Ceph на обертових дисках, з кожним налаштуванням, поясненим у дописі про bcache. Тож питання в тому, що VDO робить із кешем bcache, коли сидить поверх нього.
Один NVMe виконує обидві флеш-ролі, поділений на два розділи:
| Пристрій | Розмір | Роль |
|---|---|---|
nvme8n1p1 | 32 GiB | кеш bcache, writeback |
nvme8n1p2 | 8 GiB | голова і хвіст VDO: індекс, корені, журнал відновлення, зведення слебів |
nvme6n1 | 349 GiB | опорний пристрій bcache, де живуть дані |
/dev/bcache0 | 349 GiB | середина пулу VDO, слеби |
Обидва диски знову Optane, тож nvme6n1 грає роль обертового диска.
Пам’ятай про це для кожної цифри нижче. Опорний пристрій тут швидкий, тож це вимірює, що доходить до кешу, а не скільки часу шпинделю треба, щоб його спорожнити.
Розділи і набір кешу, з налаштуваннями з того допису:
# sgdisk --zap-all /dev/nvme8n1
# sgdisk -n 1:0:+32G -c 1:bcache-cache -n 2:0:+8G -c 2:vdo-meta /dev/nvme8n1
# blockdev --rereadpt /dev/nvme8n1
# apt install bcache-tools
# make-bcache -C /dev/nvme8n1p1 -B /dev/nvme6n1 --writeback
# B=/sys/block/bcache0/bcache
# echo 0 > $B/sequential_cutoff
# echo 40 > $B/writeback_percent
# echo 81920 > $B/writeback_rate
# echo 20480 > $B/writeback_rate_minimum
# CS=/sys/fs/bcache/47bac36f-a1d5-4e8e-8695-2e7ff944172d
# echo 0 > $CS/congested_read_threshold_us
# echo 0 > $CS/congested_write_threshold_us
Ці рядки echo живуть до наступного перезавантаження. Правило udev у дописі про bcache робить їх постійними.
Потім пул, розділений так само, як вище, з nvme8n1p2 для двох кінців і bcache0 для середини:
# pvcreate /dev/bcache0 /dev/nvme8n1p2
# vgcreate vdolab /dev/bcache0 /dev/nvme8n1p2
# lvcreate -y -L 3G -n vdopool vdolab /dev/nvme8n1p2
# lvextend -l +9408 vdolab/vdopool /dev/bcache0
# lvextend -l +64 vdolab/vdopool /dev/nvme8n1p2
# lvconvert -y --type vdo-pool -n vdolv -V 35G vdolab/vdopool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
# lvs -a --segments -o lv_name,lv_size,segtype,seg_start_pe,seg_size_pe,devices vdolab
  LV              LSize  Type     Start SSize Devices
  vdolv           35.00g vdo          0  8960 vdopool(0)
  vdopool         40.00g vdo-pool     0 10240 vdopool_vdata(0)
  [vdopool_vdata] 40.00g linear       0   768 /dev/nvme8n1p2(0)
  [vdopool_vdata] 40.00g linear     768  9408 /dev/bcache0(0)
  [vdopool_vdata] 40.00g linear   10176    64 /dev/nvme8n1p2(768)
vdolistmetadata надрукував ті самі діапазони блоків, що й для розділеної збірки, тож індекс і обидва журнали сидять на nvme8n1p2.
vdovg і сховище Proxmox ідуть зверху точно як раніше.
Що доходить до кешу
Порівнюється LV на 8 GiB прямо на bcache0 з LV на 8 GiB у vdovg, ті самі завдання fio по 30 секунд, двічі, з кешем, начисто скинутим між кожним прогоном.
Лічильники пристроїв у /sys/class/block кажуть, куди пішли байти.
| 75 % дублікатів, 50 % стиснення, 30 с | лише bcache | VDO на bcache |
|---|---|---|
| 4k випадковий запис, QD32, 4 завдання | 212 222 і 205 585 IOPS | 390 206 і 304 757 IOPS |
| p99 | 1,89 і 2,04 мс | 1,45 і 2,54 мс |
| Гість записав | 24,29 і 23,53 GiB | 44,67 і 34,88 GiB |
| Записано в кеш bcache | 25,00 і 24,26 GiB | 11,48 і 10,44 GiB |
| Записано в розділ метаданих VDO | 1,18 і 0,59 GiB | |
| Записів у кеш на байт гостя | 103 % | 26 і 30 % |
| Лишилося брудним у кеші наприкінці | 6,0 і 6,5 GiB | 5,5 і 5,2 GiB |
| 128k запис, QD8 | 2001 і 1985 MiB/s | 1878 і 1416 MiB/s |
| Записів у кеш на байт гостя, 128k | 101 % | 24 і 27 % |
Сам bcache упирався приблизно в 210 000 дрібних записів на секунду і записував у кеш кожен байт плюс 3 % власних. Постав VDO попереду, і кеш отримав чверть байтів. На першому прогоні той самий кеш потім тримав 390 206 записів на секунду, майже вдвічі більше, і все одно закінчив із меншою кількістю брудних даних, що чекають на повільний диск. Межею був кеш. VDO її посунув.
Другий прогін чесніший для пулу, яким уже користувалися. fio за замовчуванням щоразу ініціалізує свої генератори однаково8, тож другий прогін писав дані, які індекс уже бачив, і які вказували на блоки, що відтоді було звільнено через discard. VDO вважає індекс підказками і читає кожен блок-кандидат, щоб перевірити, що це справді дублікат, перш ніж його спільно використати9. Під час тесту лише на запис цей другий прогін прочитав назад 7,11 GiB з кешу і 1,20 GiB з диска даних. Перший прочитав 0,12 GiB. Застарілі поради не безкоштовні, а на пулі, де VM приходять і йдуть, якісь завжди будуть.
Випадкові дані це інший бік:
| Випадкові дані, 30 с | лише bcache | VDO на bcache |
|---|---|---|
| 4k випадковий запис, QD32, 4 завдання | 205 984 і 203 066 IOPS | 203 186 і 85 882 IOPS |
| p99 | 2,04 і 2,15 мс | 5,7 і 17,7 мс |
| 128k запис, QD8 | 2038 і 2017 MiB/s | 878 і 357 MiB/s |
| 4k випадкове читання, QD1 | 36 609 і 36 639 IOPS, 21,6 мкс | 26 345 і 26 202 IOPS, 33,6 і 33,7 мкс |
| 4k випадкове читання, QD32, 4 завдання | 471 585 і 471 730 IOPS | 335 461 і 336 941 IOPS |
Заощаджувати нічого, тож VDO це чисті накладні витрати, а на прогоні із застарілим індексом він більш ніж удвічі зменшив кількість дрібних записів. Кожне читання в обох колонках ішло з кешу. 12 мкс від VDO зверху це та сама фіксована ціна, яку він додає на голому Optane.
Тож там, де дані повторюються, ці двоє добре складаються. Кеш отримує чверть байтів, довше витримує сплеск і має менше скидати на шпинделі. Там, де дані не повторюються, bcache краще сам по собі.
На апаратному HDD RAID6: міркування, а не вимірювання
У мене немає хоста з HDD RAID6 для тестів, тож цей розділ це міркування, побудовані на вимірюваннях вище. Виміряй свій масив, перш ніж на це покладатися.
| На HDD RAID6 | Що змінює VDO |
|---|---|
| Записи, що доходять до масиву | приблизно чверть, на суміші, як та, що виміряна |
| Кеш зворотного запису контролера | заповнюється вчетверо повільніше, тож витримує сплеск приблизно вчетверо довше |
| Процесорна ціна VDO | 17 мкс на читання, що губляться в пошуку на 5–10 мс |
| Записи журналу відновлення | десь десята частина операцій запису, дрібні і з flush: клади їх на NVMe |
| Пошук в індексі | стеж за dedupe advice timeouts у vdostats; на повільному сховищі VDO може кинути пошук і все одно записати дублікат |
| Читання одного клону від початку до кінця | повільніше: його блоки вказують назад у блоки шаблону, розкидані по масиву |
Перші два рядки це відповідь щодо заліза. Поки в кеші контролера з батареєю чи флеш-резервом є місце, гість бачить затримку кешу. Коли він заповнюється, гість бачить шпинделі. Надсилай йому чверть байтів, і той самий кеш дає приблизно вчетверо більший запас і має вчетверо менше скидати. Розділ про bcache вище це саме те, виміряне з програмним кешем на місці кешу контролера.
Третій рядок пояснює, чому VDO більше пасує повільним дискам, ніж швидким. На Optane VDO подвоїв затримку читання. На дисках 7200 об/хв та сама фіксована ціна розчиняється в одному пошуку.
Останні три це ціни. Буря завантажень однакових клонів стає швидшою, але читання одного клону від початку до кінця стає повільнішим, бо дедуплікація його розкидає. А власні дрібні записи VDO теж падають на масив, і це аргумент на користь розділеної розкладки вище: індекс і журнал на NVMe, слеби на RAID6.
Видаляєш диск: змуси Proxmox зробити discard
Видалення LV звільняє його екстенти в LVM. Воно не каже VDO, що блоки не використовуються, тож VDO їх тримає. Документація ядра пояснює, чому це важливо: «If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space»1. На товстому сховищі він не може закінчитися, але не звільнені через discard блоки однаково є місцем на диску, яке тримають для даних, що нікому не належать.
Опція сховища on-volume-remove discard=1 це виправлення. Proxmox описує її як надсилання «discard (TRIM) requests before removal»5:
| Видалення | Звільнено блоків VDO |
|---|---|
звичайне сховище lvm, диск з 1 GiB даних | 0 |
з on-volume-remove discard=1, те саме | 262 140, увесь 1 GiB |
Щоправда, на великому диску це повільно.
Видалення диска на 34 GiB із тесту заповнення зайняло в Proxmox 262,6 с, тоді як blkdiscard на таких самих даних упорався з 15 GiB за 2,25 с.
Тож для чогось великого спершу зроби blkdiscard диска, а потім видаляй.
Розмір discard теж важливий. Типовий max_discard у VDO це один блок на 4 KiB на запит1:
| Discard 15 GiB випадкових даних | Минуло часу | CPU (sys) |
|---|---|---|
max_discard=1, за замовчуванням | 8,06 с | 8,06 с |
max_discard=4096, 16 MiB | 2,25 с | 0,00 с |
Усередині гостей увімкни опцію диска Discard, щоб їхній TRIM доходив до сховища10, і запускай fstrim за розкладом.
Де він вартий свого місця
| Підходить | Не підходить |
|---|---|
| багато VM з тих самих кількох шаблонів | бази даних і чутлива до затримки робота на глибині |
| HDD RAID6 за контролером з кешем зворотного запису | хост повністю на NVMe, якому потрібна кожна мікросекунда |
| обертові дані з NVMe для метаданих VDO | уже стиснуті дані: медіа, резервні копії, ISO |
| bcache перед обертовими даними, де дані повторюються | bcache перед даними, що не повторюються |
| диски, де межею є витривалість до запису | зашифровані гостьові диски, які ніколи не дедуплікуються |
| хост, де на кожен пул є вільні пів гігабайта RAM | малий пул, де індекс з’їдає десяту частину |
| Налаштування | За замовчуванням | Задати | Змінити пізніше |
|---|---|---|---|
Віртуальний розмір VDO -V | що попросиш | не більше, ніж пул може адресувати | лише збільшити, ніколи не зменшити |
| Потоки VDO | 10, один логічний | один на CPU, розподілені як вище | лише при зупинених VM пулу |
max_discard | 1, тобто 4 KiB | 4096, тобто 16 MiB | лише при зупинених VM пулу |
on-volume-remove у сховищі | не задано | discard=1 | так, pvesm set |
| Discard на кожному віртуальному диску | вимкнено | увімкнено | так, для кожного диска |
scan_lvs і фільтр | 0, без відкидання дисків VM | 1, диски VM відкинуто | так, у lvm.conf |
Нічого з цього не складно. Нічого з цього не стоїть за замовчуванням.
Найдешевший запис той, який ти ніколи не надсилаєш
Що мене вражає у VDO, то це те, як погано його продають. Він з’являється як спосіб покласти на диск більше, ніж диск вміщує, і це найменш корисне, що він робить. Я зробив так випадково під час першої збірки, і Proxmox показував третину сховища вільною, тоді як VDO був повний. Переобіцянка це позика, і диск вимагає її повернути на повній швидкості запису.
Справжня цінність у рядку, який більшість людей ніколи не вимірює. Чверть байтів, що доходять до диска, це чверть зносу і кеш контролера, якого вистачає вчетверо довше. Це не місткість. Це залізо, яке робить менше роботи для того самого результату, а це єдиний вид економії, який потім не вкусить тебе.
Він коштує процесора, а на швидкій флеш-пам’яті коштує затримки, і обидві ціни фіксовані. Ось обмін, сказаний прямо: процесорний час, витрачений, щоб повільна й дорога частина машини робила менше. На обертових дисках за RAID-контролером чи bcache, з індексом і журналом на NVMe, ця сума виходить добре. На хості повністю з Optane здебільшого ні.
І сам про себе він не подбає. Кожне значення за замовчуванням, яке має значення, хибне для цієї роботи: десять потоків на шістнадцять CPU, розмір discard, що спалює ядро, віртуальний розмір, який можна задати будь-яким, і нічого в конфігурації сховища, що казало б Proxmox віддавати місце назад. Нічого з цього не приховано. Усе це є в документації.
Тож збирай його товстим, один раз, як слід, з налаштуваннями в рядку створення і метаданими там, де їм місце. Зроби так, і диск робить чверть роботи. Пропусти, і ти купив ще один шар, який обіцяє більше, ніж має.
Linux kernel documentation — dm-vdo — ціль «provides block-level deduplication, compression, and thin provisioning»; «If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space»; «unflushed writes may or may not persist after a crash»; кеш карти блоків на 128 MB підтримує «efficient access to 100 GB of logical space at a time»; параметри потоків, їхні межі й поради щодо налаштування; maxDiscard «in 4096-byte blocks». ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
lvmvdo(7) — Support for Virtual Data Optimizer in LVM — пул VDO і VDO LV, перетворення наявного LV через
lvconvert --type vdo-pool, використання пам’яті, щільний індекс і його вікно в 1 TiB на GiB RAM, і «You cannot reduce the size of a VDOPoolLV». ↩︎ ↩︎ ↩︎ ↩︎Linux kernel source — drivers/md/dm-thin.c —
disable_discard_passdown_if_not_supported()вимикає передавання discard донизу, коли пристрій даних не може прийняти цілий тонкий chunk, а саме це і робить типове налаштування VDO під тонким пулом. ↩︎LVM2 — conf/example.conf.in —
devices/scan_lvs: «Caution is required to avoid using PVs that belong to guest images stored on LVs» і «This option does not enable autoactivation of layered VGs». ↩︎ ↩︎Proxmox pve-storage — LVMPlugin.pm — властивість
on-volume-remove, «Use ‘discard=1’ to issue discard (TRIM) requests before removal»; томи активуються поодинці черезlvchange -aey, а не черезvgchange -aly. ↩︎ ↩︎Debian trixie — package vdo — «Management tools for Virtual Data Optimizer», версія 8.3.1.1-1, яка надає
vdoformat,vdostatsіvdolistmetadata. ↩︎Linux kernel source — drivers/md/dm-vdo/encodings.c —
vdo_initialize_layout()створює розділ карти блоків на початку, розділи зведення слебів і журналу відновлення в кінці, а депо слебів з того, що лишилося. ↩︎fio documentation — randrepeat — «Seed all random number generators in a predictable way so the pattern is repeatable across runs. Default: true.» ↩︎
Linux kernel documentation — Design of dm-vdo — «vdo treats the locations in the index as hints, and reads each indicated block to verify that it is indeed a duplicate before sharing the existing block with a new one.» ↩︎
Proxmox VE documentation — Qemu/KVM Virtual Machines, Trim/Discard — «For the guest to be able to issue TRIM commands, you must enable the Discard option on the drive.» ↩︎