Проблема
Це спливло під час роботи з клієнтом, коли ми проєктували розгортання Proxmox VE з NVMe passthrough для навантаження, чутливого до затримок.
Клієнт ще до дзвінка провів власні бенчмарки.
На хості fio по NVMe-диску показував 700K IOPS випадкового читання із затримкою завершення менше 10 мкс.
Усередині ВМ, з тим самим диском і тим самим тестом, виходило приблизно вдвічі менше.
Очевидне вони вже перевірили. Диск не змінювався. Прошивка не змінювалася. Слот PCIe ніхто не переставляв. Вони вже почали думати, чи passthrough взагалі правильний підхід.
Правильний. Те, що вони бачили, це податок IOMMU. Він ловить людей, бо ніхто не каже тобі про нього, доки ти не поставив усе на passthrough. Добра новина: більшу частину накладних витрат можна повернути, щойно зрозумієш, звідки вони беруться.
Глибше
Проблеми, які треба було розв’язати
Дати ВМ прямий доступ до фізичного PCIe-пристрою звучить просто. На практиці це одна з найважчих задач у віртуалізації систем. Кілька речей, які на bare metal працюють самі собою, стають небезпечними, коли пристрій ділять між хостом і гостем.
Ізоляція DMA
Це фундаментальна проблема.
PCIe-пристрої не ходять через CPU, щоб читати й писати пам’ять. Вони використовують Direct Memory Access. Вони пишуть прямо за фізичними адресами RAM. На bare metal це нормально. Пристрій і ОС довіряють одне одному.
Під віртуалізацією гостьова ВМ має власне бачення фізичної пам’яті. Адреси, які гостьовий драйвер дає NVMe-контролеру, це гостьові фізичні адреси. Вони не відповідають тим самим місцям у RAM хоста. Якщо пристрій використає їх напряму, він читатиме й писатиме не ту пам’ять. Це псує хост, інші ВМ, або і те, і те.
Гірше, зловмисний чи забаглений гостьовий драйвер міг би навмисно запрограмувати пристрій робити DMA в будь-яку частину пам’яті хоста. Фактично це root-доступ до всієї машини без жодної експлуатації вразливості гіпервізора.
Розв’язок це IOMMU: апаратний блок трансляції (Intel VT-d, AMD-Vi), що стоїть між кожним PCIe-пристроєм і основною пам’яттю. Він веде власні таблиці сторінок, окремі від таблиць CPU. Кожен DMA-запит від пристрою проходить через IOMMU, який транслює гостьові фізичні адреси в фізичні адреси хоста і блокує будь-який доступ поза областями пам’яті, виділеними гостю.
Без IOMMU безпечний passthrough неможливий. З ним пристрій ізольований.
Групування пристроїв
IOMMU не ізолює окремі пристрої. Він ізолює групи.
Специфікація PCIe визначає Access Control Services (ACS), які вирішують, чи можуть пристрої на одній шині говорити один з одним напряму, тобто peer-to-peer DMA, не проходячи через root complex, де сидить IOMMU. Якщо два пристрої ділять PCIe-комутатор, який не забезпечує ACS, один пристрій може робити DMA у простір пам’яті іншого, повністю оминаючи IOMMU.
Ядро об’єднує пристрої, які потенційно можуть дістатися один до одного без контролю IOMMU, в одну IOMMU-групу. Якщо твій NVMe-контролер ділить групу з іншим пристроєм, передача лише NVMe ламає модель ізоляції. Інший пристрій у групі все ще можна використати як обхідний канал повз IOMMU.
Серверне обладнання з повноцінною підтримкою ACS на кожному мості й комутаторі зазвичай дає кожному пристрою власну групу. Споживчі й робочі плати часто зсипають кілька пристроїв докупи, бо root complex PCIe не реалізує ACS на кожному порту.
Proxmox несе патч ядра pcie_acs_override, який каже ядру вважати кожен пристрій ізольованим незалежно від апаратної підтримки ACS.
На практиці це працює, але це брехня ядру про топологію обладнання.
У продуктивній системі чисті групи, підкріплені справжнім апаратним ACS, завжди кращі.
Доставка переривань
На bare metal, коли NVMe-контролер завершує операцію вводу-виводу, він надсилає MSI-X-переривання прямо в CPU. CPU обробляє його за кілька сотень наносекунд.
Під віртуалізацією це переривання має дістатися гостя, а не хоста. Наївний підхід: перехоплювати кожне переривання в гіпервізорі, викликати VM exit, впорснути переривання в гостя і продовжити. Це працює, але кожен VM exit коштує 5–20 мкс. На високих IOPS, сотні тисяч переривань за секунду, накладні витрати суттєві.
Апаратний розв’язок це posted interrupts. Intel APICv і AMD AVIC дозволяють IOMMU записати переривання прямо у віртуальну сторінку APIC гостя взагалі без VM exit. Гість бачить переривання так, ніби воно прийшло від обладнання bare metal. Накладні витрати падають до кількох сотень наносекунд.
Не всі платформи підтримують posted interrupts. Старіші CPU, деякі чипсети робочих станцій і деякі версії BIOS не відкривають цю можливість. Коли її немає, кожне переривання йде повільним шляхом, і програмного обходу не існує.
Скидання пристрою
Коли ВМ вимикається або падає, переданий пристрій має повернутися в чистий, відомий стан. Інакше його не можна передати іншій ВМ чи забрати назад хосту.
На bare metal ОС акуратно вимикає драйвер пристрою. При passthrough гість може впасти, користувач може примусово зупинити ВМ, або гіпервізор може вбити процес. Пристрій може бути посеред передачі, з DMA-операціями в польоті.
PCIe визначає для цього Function Level Reset (FLR): спосіб скинути одну функцію пристрою, не зачіпаючи решту шини. NVMe-контролери зазвичай підтримують FLR і справляються з ним добре. GPU відомі тим, що роблять це погано, але це інша стаття.
Якщо FLR не підтримується, запасний варіант це скидання вторинної шини, яке скидає все за цим PCIe-мостом. Якщо на мосту є інші пристрої, їх теж скине. У гіршому разі єдиний спосіб повернути пристрій це повне перезавантаження хоста.
Накладні витрати трансляції адрес
IOMMU розв’язує проблему безпеки. Як такий, він не опційний. Але він приносить проблему продуктивності.
Кожна DMA-операція тепер проходить через додатковий рівень трансляції адрес. IOMMU має власний TLB, IOTLB, і коли в ньому є влучання, накладні витрати малі. Коли промах, IOMMU мусить пройти свої таблиці сторінок, і це додає справжню затримку кожній зачепленій операції вводу-виводу.
Це і є податок IOMMU. Решта статті про те, звідки він береться і як його зменшити.
Відображення BAR і адресний простір
Кожен PCIe-пристрій відкриває один або кілька Base Address Registers (BAR), які відображають внутрішні регістри й пам’ять пристрою в MMIO-адресний простір хоста. CPU хоста звертається до пристрою через ці відображення. Щоб passthrough працював, гіпервізор мусить правильно показати ці відображення гостю.
Традиційно розміри BAR фіксував BIOS під час завантаження, і вони вміщалися в застаріле 32-бітне вікно MMIO нижче 4 ГБ. Це працювало, поки BAR були малими. Сучасні GPU змінили картину. Фреймбуфер на 24 ГБ потребує BAR на 24 ГБ, а він не влазить у 32-бітний адресний простір.
Resizable BAR (ReBAR), який ще продають як AMD Smart Access Memory (SAM), це можливість PCIe, що дозволяє заново узгодити розмір BAR після завантаження. Для GPU це суттєва функція. Замість доступу до фреймбуфера через вікно 256 МБ і гортання його шматками хост відображає всю VRAM за раз.
Для NVMe прямий вплив менший. BAR NVMe-контролерів зазвичай мають від 16 КБ до 64 КБ для набору регістрів контролера (BAR0). Специфікація NVMe визначає Controller Memory Buffer (CMB), який може відкрити більший BAR для черг подання, розміщених у пристрої, але більшість дисків його не реалізують. ReBAR не змінює пропускну здатність NVMe так, як змінює для GPU.
Важить він у контексті NVMe passthrough через спільне середовище PCIe. Якщо ти передаєш NVMe-диск поруч із GPU на тому самому хості, розширеному BAR GPU потрібен адресний простір вище межі 4 ГБ. BIOS, IOMMU і віртуальна топологія PCIe мають усе це вмістити. Помилка в розподілі адресного простору означає, що пристрої не ініціалізуються, і NVMe passthrough падає разом з усім іншим.
Ризик утрати живлення
На віртуальному диску порядок записів і цілісність після збою забезпечують гіпервізор і шар зберігання. При passthrough гість говорить прямо з флеш-пам’яттю. Якщо хост утратить живлення посеред запису, те, що прошивка NVMe-контролера робить, або не робить, зі своїм кешем запису, вирішує, чи ти втратиш дані.
Корпоративні NVMe-диски мають конденсатори захисту від утрати живлення (PLP), які безпечно скидають кеш запису під час збою живлення. Споживчі диски без PLP можуть цього не зробити. При passthrough між гостем і обладнанням немає страхувальної сітки гіпервізора.
Для продуктивного навантаження корпоративний диск із PLP не опція, а обов’язок.
Операційні компроміси
Passthrough також забирає можливості, які дають віртуальні диски.
Переданий пристрій фізично прикручений до конкретного хоста. ВМ не можна мігрувати наживо, поки пристрій під’єднано. У кластері Proxmox з HA падіння вузла означає, що ВМ лягає і холодно стартує на іншому вузлі. Безшовного перемикання немає.
Диск також невидимий для vzdump і Proxmox Backup Server.
Він не потрапить у знімки ВМ чи заплановані резервні копії.
Окрема стратегія резервного копіювання, на рівні гостя, файлової системи чи застосунку, має бути на місці до того, як навантаження піде в роботу.
Як насправді працює VFIO passthrough
Коли ти передаєш PCIe-пристрій у ВМ, гіпервізор віддає гостю пряме керування MMIO-регістрами пристрою. Гостьовий драйвер говорить із NVMe-контролером так, ніби працює на bare metal. Ця частина майже нативна. Доступ до MMIO-регістрів іде через Extended Page Tables (EPT в Intel, NPT в AMD) і зазвичай завершується без VM exit.
Ціна з’являється на шляху DMA. Кожна DMA-операція проходить через IOMMU для трансляції адрес, і, як описано вище, ця трансляція має ціну. Особливо на промахах IOTLB.
Чому бенчмарки виглядають гірше, ніж реальність
Ось де більшість людей помиляються з тестуванням.
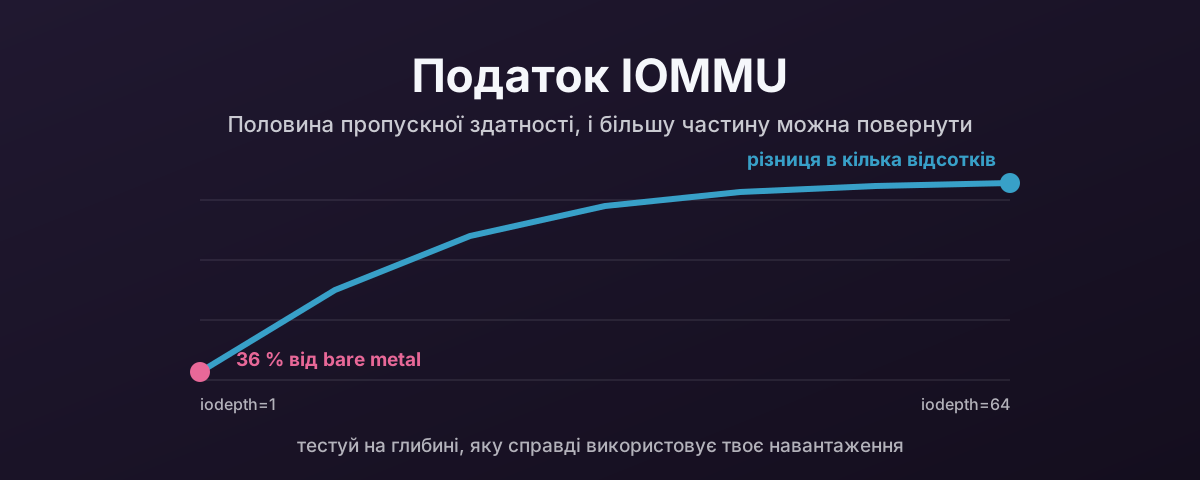
У гілці форуму Proxmox, з якої почалася ця стаття, користувачі запускали fio з iodepth=1.
На такій глибині черги fio подає одну операцію, чекає її завершення, потім подає наступну.
Тест просто міряє затримку на операцію.
Кожна мікросекунда накладних витрат IOMMU проявляється повністю.
Цифри з тієї гілки розповідають усе ясно.
Затримка завершення на bare metal у середньому була близько 10 мкс.
Усередині ВМ у середньому близько 28 мкс.
Ці зайві ~18 мкс на операцію це накладні витрати трансляції IOMMU.
На iodepth=1 вони прямо вдвічі зрізають пропускну здатність, бо пропускна здатність дорівнює 1 / latency, коли в польоті лише одна операція.
Підніми глибину черги до 32 чи 64, а саме так NVMe-диски задумано працювати, і картина змінюється. Коли в польоті багато операцій, накладні витрати IOMMU розподіляються між усіма. Контролер обробляє завершення, поки відбуваються нові трансляції. Пропускна здатність відновлюється до кількох відсотків від bare metal.
Практичний висновок такий. Якщо твоє навантаження працює на глибині черги понад 4, втрата пропускної здатності через IOMMU, найпевніше, нехтовно мала. Це покриває більшість навантажень баз даних, віртуалізації та зберігання. Якщо твоє навантаження чутливе до затримок на малій глибині черги, певні застосунки реального часу, синхронні операції з метаданими, ти це відчуєш.
Запускай бенчмарки на реалістичній глибині черги, перш ніж вирішити, що passthrough надто повільний:
# Bare metal baseline — run on the host before binding to vfio-pci
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting

# Same test inside the VM after passthrough
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Порівняй процентилі clat (затримки завершення) і цифри IOPS.
На iodepth=32 з чотирма завданнями розрив має бути в одиницях відсоткових пунктів, а не 50 %.
Вирівнювання NUMA
Для цього є окрема стаття. Див. Вирівнювання NUMA в Proxmox VE: чому це важливо і як зробити правильно.
Коротко: у багатосокетних системах кожен PCIe-пристрій підключено до конкретного сокета. Якщо NVMe-диск на вузлі NUMA 1, а vCPU ВМ прив’язані до вузла 0, кожне завершення DMA перетинає міжсокетний канал. Це додає 50–100 нс на операцію. На високих IOPS різниця в пропускній здатності між вирівняною і невирівняною NUMA становить 20–30 %.
Перевір через cat /sys/bus/pci/devices/0000:XX:00.0/numa_node, потім прив’яжи vCPU ВМ до ядер того самого вузла параметром affinity у конфігурації ВМ.
В односокетних системах це не проблема.
PCIe Active State Power Management (ASPM)
Для цього є окрема стаття. Див. PCIe ASPM і чому його варто вимкнути для passthrough.
Коротко: ASPM дозволяє PCIe-лінкам переходити в стани низького енергоспоживання, коли вони простоюють.
При passthrough хост досі керує фізичним лінком, але пристроєм володіє гість.
Коли гість подає операцію, а лінк спить, час пробудження додає затримку.
Симптом це широкий розкид процентилів clat. p99 може бути в 5–10 разів вищим за середнє, тоді як середнє виглядає нормально.
Вимкни його на хості через pcie_aspm=off у командному рядку ядра.
Також додай disable_idle_d3=1 до параметрів модуля vfio-pci, якщо твій NVMe-контролер має проблеми з відновленням зі станів живлення. Samsung 990 EVO Plus відомий порушник.
MaxPayloadSize (MPS)
Для цього є окрема стаття. Див. PCIe MaxPayloadSize: безкоштовний виграш продуктивності для passthrough.
Коротко: PCIe-пристрої передають дані в Transaction Layer Packets.
Віртуальний root complex QEMU за замовчуванням має максимальне корисне навантаження 128 байт.
Більшість пристроїв підтримують 256 або 512 байт.
Додавання pci=pcie_bus_perf до командного рядка ядра хоста встановлює MPS на максимум, який дозволяє батьківська шина кожного пристрою.
Це невеликий приріст пропускної здатності, низькі одиниці відсотків, але він безкоштовний і без мінусів.
Resizable BAR і апертура MMIO
Проблема відображення BAR, описана раніше, має практичні кроки і з боку BIOS, і з боку ВМ.
Спершу ввімкни Above 4G Decoding у BIOS. Це дозволяє відображати BAR в адресний простір вище межі 4 ГБ, що потрібно для будь-якого пристрою з великими BAR. Вмикай навіть для passthrough лише NVMe. Мінусів немає, а це вбереже від проблем, якщо пізніше додаси GPU чи інший пристрій із великим BAR.
Якщо в BIOS є ReBAR, увімкни і його. На продуктивність NVMe це прямо не вплине, але дозволить GPU на тому самому хості використовувати повне відображення фреймбуфера.
З боку ВМ віртуальному root complex Q35 у QEMU потрібне достатньо велике 64-бітне вікно MMIO, щоб гість бачив розширені BAR. За замовчуванням OVMF виділяє відносно мале вікно. Для passthrough лише NVMe цього досить. BAR NVMe вміщаються вільно. Але якщо у ВМ передано і NVMe, і GPU, збільш апертуру MMIO:
args: -fw_cfg name=opt/ovmf/X-PciMmio64Mb,string=65536
Це каже OVMF виділити 64 ГБ 64-бітного простору MMIO, досить для більшості фреймбуферів GPU поруч із малим BAR NVMe-контролера.
Підтримка ReBAR у QEMU покращується, але досі не безшовна. Деякі GPU AMD (Vega і новіші) викликають помилки драйвера (Code 43 у Windows) з увімкненим ReBAR під QEMU. Якщо натрапиш на це, першим кроком вимкни ReBAR у BIOS. На NVMe passthrough це ніяк не вплине.
Що Resizable BAR робить з боку GPU і чому Intel вважає його обов’язковим для Arc, тоді як NVIDIA вмикає його для кожної гри окремо, дивись у PCIe Resizable BAR і сучасні GPU.
Обробка переривань
Проблема доставки переривань, описана раніше, має практичний крок налаштування. Posted interrupts (APICv в Intel, AVIC в AMD) можуть бути не ввімкнені за замовчуванням.
Перевір, чи вони активні:
# Intel — look for "Posted-Interrupts" in dmesg
dmesg | grep -i "posted"

# AMD — check AVIC support
dmesg | grep -i "avic"
На системах AMD EPYC увімкни AVIC у модулі KVM, якщо він не ввімкнений за замовчуванням:
# /etc/modprobe.d/kvm.conf
options kvm_amd avic=1
На системах Intel APICv з posted interrupts зазвичай вмикається автоматично, коли активний VT-d.
Якщо твоя платформа не підтримує posted interrupts, програмного обходу немає. Це апаратна можливість. Але варто перевірити, що вона справді ввімкнена, перш ніж вирішити, що повільного шляху не уникнути.
Прив’язка переривань і вирівнювання черг
NVMe-контролери використовують кілька пар черг подання й завершення. Зазвичай одну на ядро CPU. Коли vCPU ВМ не збігаються з фізичними ядрами, що обробляють переривання NVMe, завершенням доводиться перетинати ядра через міжпроцесорні переривання. Це додає затримку.
Усередині гостя перевір, скільки черг вводу-виводу створив драйвер NVMe і як вони розподілені:
# List NVMe IO queues
cat /proc/interrupts | grep nvme

# Check affinity
for irq in $(grep nvme /proc/interrupts | awk '{print $1}' | tr -d ':'); do
    echo "IRQ $irq: $(cat /proc/irq/$irq/smp_affinity_list)"
done
В ідеалі переривання кожної черги вводу-виводу NVMe має бути прив’язане до vCPU, який подає в цю чергу. Більшість сучасних драйверів NVMe роблять це автоматично. Але варто перевірити, особливо якщо ти вручну прив’язав vCPU або зменшив кількість vCPU нижче кількості черг контролера.
Завжди Q35, а не i440fx
Це заслуговує окремої статті. Див. Завжди Q35, а не i440fx.
Коротко: i440fx показує пласку застарілу шину PCI. Q35 показує повноцінний root complex PCIe. Передані пристрої на i440fx виглядають як застарілі PCI, а це ламає багаточергову доставку переривань MSI-X. NVMe-контролерам потрібен MSI-X для їхньої архітектури «черга на ядро». Без нього всі завершення вводу-виводу йдуть через одне переривання, і на високих IOPS ти отримуєш вузьке місце, яке не виправить жодне налаштування ядра.
У Proxmox 8.x і новіших Q35 типовий для нових ВМ. Якщо ти робиш passthrough на старій ВМ, яка досі на i440fx, переведи її. RHEL 10 формально оголосив i440fx застарілим, і ширша екосистема KVM іде слідом.
Усе разом
Ось підсумок кроків налаштування в порядку впливу.
Вирівнювання NUMA: переконайся, що NVMe-диск і vCPU ВМ на одному вузлі NUMA. Лише це може дати різницю в пропускній здатності 20–30 % на багатосокетних системах.
ASPM вимкнено: додай pcie_aspm=off до командного рядка ядра хоста.
Прибирає тремтіння затримки від переходів між станами живлення PCIe-лінка.
Реалістична глибина черги: тестуй на iodepth=32 або вище, а не на iodepth=1.
Накладні витрати IOMMU, що домінують на малій глибині черги, розподіляються на реалістичній глибині.
Posted interrupts: перевір, що APICv (Intel) або AVIC (AMD) активні. Зменшує накладні витрати на переривання з мікросекунд до наносекунд.
Оптимізація MPS: додай pci=pcie_bus_perf до командного рядка ядра хоста.
Встановлює MaxPayloadSize на максимум, який підтримує топологія.
Керування живленням vfio-pci: додай disable_idle_d3=1, якщо твій NVMe-контролер має проблеми зі станами живлення при passthrough.
Спільний командний рядок ядра хоста для вузла Proxmox з NVMe passthrough на системі AMD EPYC виглядав би приблизно так:
GRUB_CMDLINE_LINUX_DEFAULT="quiet amd_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Для Intel:
GRUB_CMDLINE_LINUX_DEFAULT="quiet intel_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Коли passthrough того не вартий
Перш ніж іти цим шляхом, варто спитати, чи тобі взагалі потрібен NVMe passthrough.
VirtIO-SCSI і VirtIO-BLK з віртуальним диском на NVMe вже дуже ефективні. Накладні витрати порівняно з passthrough зазвичай 5–10 % по затримці. Різниця в пропускній здатності для більшості навантажень нехтовна.
Passthrough має сенс, коли гостьовій ОС треба керувати пристроєм напряму. Сюди входять моніторинг SMART, оновлення прошивки, керування TRIM/discard і специфічні функції NVMe на кшталт reservations. Він також має сенс для навантажень, чутливих до затримок, де важать навіть кілька мікросекунд. Певні рушії баз даних і прийом даних у реальному часі потрапляють у цю категорію.
Для всього іншого операційні компроміси, розглянуті раніше, втрата живої міграції, втрата знімків та інтеграції з резервним копіюванням, зазвичай переважують невеликий виграш у продуктивності.
Нема нічого розумного в тому, щоб обирати важчий шлях, коли легший робить свою справу.
Перевірка змін
Після застосування кроків налаштування перевір, що все працює як слід:
# Host side — confirm IOMMU is in passthrough mode
dmesg | grep -i iommu

# Confirm ASPM is disabled
lspci -vv | grep -i "ASPM Disabled"

# Check MPS on the NVMe controller
lspci -vv -s XX:00.0 | grep MaxPayload

# Inside the VM — run the fio comparison
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Порівняй результати ВМ зі своїм раніше знятим базовим рівнем bare metal.
На iodepth=32 ти маєш побачити пропускну здатність у межах 5 % від bare metal.
Середня затримка завершення має бути в межах 10–15 мкс від цифр хоста.
Якщо розрив досі великий, спершу перевір вирівнювання NUMA.
Це фактор, який пропускають найчастіше.
А ще він нічого не коштує, крім зміни конфігурації, і це найкращий різновид проблеми, яка може тобі залишитися.
Джерела
- Linux kernel PCI documentation — MPS and MRRS tuning options — авторитетне джерело для
pcie_bus_perf,pcie_bus_safeі пов’язаних параметрів - Proxmox VE Administration Guide — PCI(e) Passthrough — офіційна документація Proxmox про налаштування передачі пристроїв через VFIO
- Proxmox Forum — NVMe Passthrough Performance — обговорення в спільноті, з якого почалася ця стаття