Що таке MPS
Пристрої PCIe передають дані пакетами, які називаються Transaction Layer Packets (TLP). Кожен TLP має заголовок і корисне навантаження. Найбільший розмір цього навантаження і є MaxPayloadSize (MPS).
MPS узгоджується між пристроєм і його висхідним мостом під час тренування лінку. Узгоджене значення дорівнює меншому з того, що підтримує пристрій, і того, що дозволяє міст. Кожен міст і комутатор на шляху між пристроєм і root complex має власну можливість MPS. Остаточний MPS будь-якого пристрою визначає найвужче місце в ланцюжку.
Типові значення MPS: 128, 256 і 512 байтів. Деякі пристрої підтримують 1024 або навіть 4096 байтів, але на практиці для контролерів NVMe і мережевих карт звичайні 256 або 512. GPU часто підтримують 256 байтів.
Чому це важливо
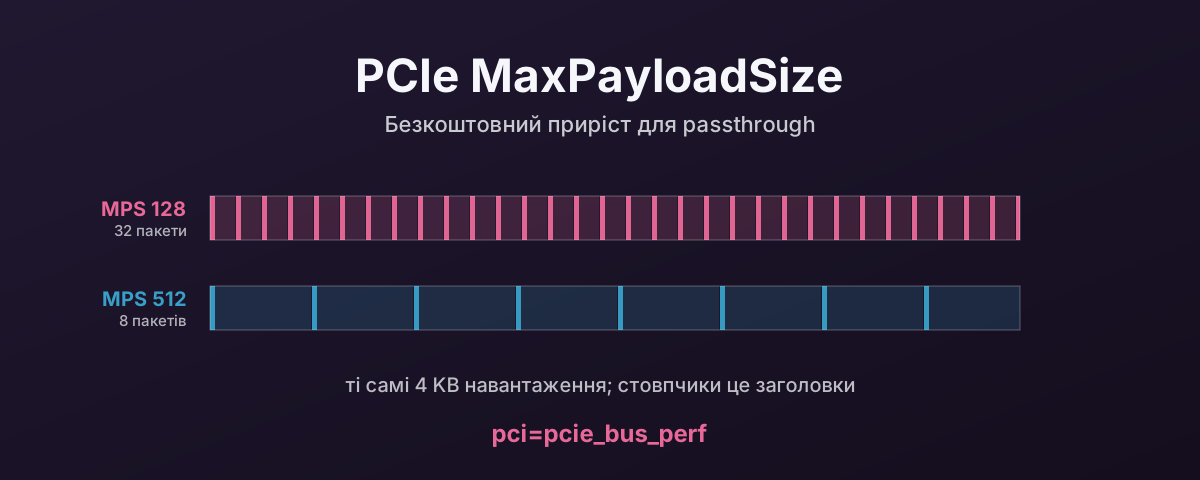
Більший MPS означає менше пакетів для того самого обсягу даних. Операція вводу-виводу на 4KB при MPS 128 потребує 32 TLP. Та сама передача при MPS 512 потребує 8 TLP.
Кожен TLP несе накладні витрати протоколу: заголовок, CRC, кадрування. Менше TLP означає менше накладних витрат на кожен переданий байт. На високій пропускній здатності цю різницю можна виміряти. Не драматично. Але реально. І це ті самі накладні витрати, сплачені на кожному пакеті.
MPS також впливає на те, наскільки добре використовується лінк PCIe. Менші навантаження означають, що лінк витрачає більше часу на заголовки відносно даних. Більші навантаження зсувають співвідношення в бік корисних даних.
На затримку це впливає менше, ніж на пропускну здатність. Одне читання 4KB при MPS 128 проти 512 не покаже різниці в затримці, яку варто міряти, бо TLP ідуть конвеєром. Але дай високі IOPS із багатьма передачами в польоті, і менші накладні витрати від більшого MPS складаються.
Проблема при passthrough
На голому залізі BIOS встановлює MPS під час POST залежно від топології PCIe. Сучасний серверний BIOS зазвичай ставить MPS на максимум, який підтримує топологія, як правило 256 або 512 байтів.
Під QEMU root complex віртуального чипсета Q35 має власну можливість MPS.
За замовчуванням він показує низький MPS.
Типова політика MPS ядра Linux (pcie_bus_default) встановлює MPS кожного пристрою рівним MPS його батьківського моста, а у віртуальній топології це означає значення за замовчуванням root complex у QEMU. Часто 128 байтів.
Тож пристрій, що вміє 512-байтові навантаження, працює на 128, бо віртуальний root complex поставив стелю.
Як це виправити: на боці хоста
Скажи ядру встановлювати MPS на максимум, який підтримує батьківська шина кожного пристрою:
# Add to GRUB_CMDLINE_LINUX_DEFAULT in /etc/default/grub
pci=pcie_bus_perf
Це встановлює MPS кожного пристрою на найбільше значення, яке дозволяє його батьківська шина. Відповідно воно також налаштовує MRRS (Max Read Request Size). Вихідний код ядра каже, що воно гарантує: MPS пристрою не більший за MPS його батька. Так ланцюжок лишається узгодженим, а розміри передач найкращими.
Після перезавантаження перевір новий MPS:
# Check MPS on a specific device
lspci -vv -s XX:00.0 | grep -i "MaxPayload"
Ти маєш побачити MaxPayload 256 bytes або MaxPayload 512 bytes замість типових 128.
Інші параметри ядра
Ядро пропонує п’ять політик MPS, кожна задається через параметр завантаження pci=:
pcie_bus_tune_off: зовсім не чіпати MPS.
Використовувати те, що встановив BIOS.
На голому залізі з добрим BIOS цього часто досить.
Під QEMU BIOS це OVMF або SeaBIOS, які можуть не оптимізувати MPS.
pcie_bus_default: типова політика ядра.
Встановлює MPS кожного пристрою рівним MPS його висхідного моста.
Обережно й безпечно, але продуктивність не максимізує.
pcie_bus_safe: встановлює MPS на найбільше значення, яке підтримують усі пристрої в системі.
Корисно для закритих систем, де ти знаєш усі пристрої і нічого не підключатимуть на ходу.
Трохи агресивніше за типову.
pcie_bus_perf: встановлює MPS для кожного пристрою окремо на найбільше значення, яке дозволяє батьківська шина.
Кожен пристрій отримує найкращий MPS, який підтримує його локальна топологія.
Це правильний вибір для passthrough, бо він оптимізує кожен шлях незалежно.
pcie_bus_peer2peer: встановлює MPS на 128 байтів на всьому.
Кожен пристрій говорить найменшим спільним розміром.
Використовується, коли пристроям треба робити DMA безпосередньо один до одного (GPU до GPU, GPU до NIC через RDMA).
Для звичайного passthrough не корисно.
pcie_bus_perf це правильна політика для passthrough.
Як це виправити: на боці гостя
pci=pcie_bus_perf можна задати і в конфігурації завантаження ядра гостя.
Чи дасть це практичний ефект, залежить від того, як QEMU показує віртуальну топологію PCIe.
Віртуальний root complex обмежує те, що гість може узгодити.
У тестах тримається саме виправлення на боці хоста. Хост володіє фізичним пристроєм, і його налаштування MPS визначає реальний розмір TLP на дроті. Налаштування гостя зачіпає лише віртуальну топологію всередині VM, і чи змінить це реальну поведінку, залежить від того, як QEMU показує шлях PCIe для цього пристрою.
Задай його на хості. Задати ще й у гості не зашкодить, але не покладайся лише на це.
Що таке MRRS
Max Read Request Size (MRRS) пов’язаний, але окремий. MPS обмежує, скільки даних пристрій може надіслати в одному TLP. MRRS обмежує, скільки даних пристрій може запросити одним запитом на читання.
Пристрій з MRRS 4096 може видати один запит на читання 4KB. Відповідь повертається кількома TLP, кожен розміром до MPS. Вищий MRRS означає, що пристрій може запросити більше даних за транзакцію, і на шині менше TLP запитів на читання.
pci=pcie_bus_perf встановлює і MPS, і MRRS на їхні оптимальні значення.
Налаштовувати їх окремо не треба.
Вплив порівняно з іншим тюнінгом
Різниця в MPS між 128 і 512 байтами впливає на продуктивність менше, ніж вирівнювання NUMA чи ASPM. Зазвичай це покращення пропускної здатності на низькі одиниці відсотків. У тестах затримки на малій глибині черги ти його не побачиш.
Але це безкоштовна оптимізація. Один параметр ядра, жодних мінусів, жодного ризику сумісності. Немає жодної причини не задати його на будь-якій системі з passthrough.
Це не коштує нічого, а за залізо ти вже заплатив. То й бери те, що купив.
Джерела
- Linux kernel PCI Kconfig — MPS and MRRS tuning options — авторитетне джерело для всіх п’яти політик MPS
- Linux Plumbers Conference 2017 — MPS vs MRRS (PDF) — доповідь Sinan Kaya про те, як ядро працює з MPS/MRRS