Що таке NUMA
NUMA означає Non-Uniform Memory Access, тобто неоднорідний доступ до пам’яті. На односокетній системі кожне ядро процесора звертається до всієї оперативної пам’яті через той самий контролер пам’яті. Час доступу однаковий, хоч би яке ядро робило запит і хоч би де дані лежали у фізичній пам’яті.
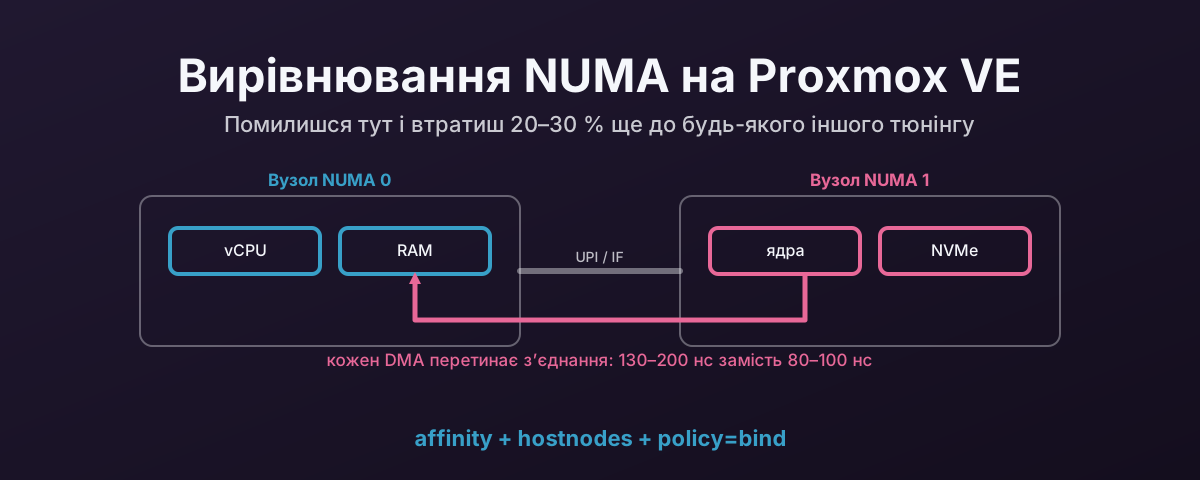
На багатосокетній системі кожен сокет має власний контролер пам’яті й власний банк RAM. Ядро на сокеті 0 швидко звертається до RAM, підключеної до сокета 0: це локальна пам’ять. Воно може звернутися й до RAM сокета 1, але такий запит мусить перетнути міжсокетне з’єднання (Intel UPI, AMD Infinity Fabric). Це віддалена пам’ять, і вона повільніша.
Ядро Linux називає кожен сокет разом із його локальною пам’яттю вузлом NUMA. Двосокетна система AMD EPYC має щонайменше два вузли NUMA. Деякі процесори EPYC показують чотири вузли NUMA на сокет (по одному на CCD), що дає вісім вузлів на двосокетній платі.
Різниця між локальним і віддаленим доступом до пам’яті зовсім не тонка. Локальний доступ триває близько 80–100 нс. Віддалений близько 130–200 нс. Це штраф 50–100 % на кожну операцію з пам’яттю. Сам по собі це дуже мале число. Коли його платиш за кожен доступ до пам’яті впродовж усього життя VM, воно перестає бути малим.
Чому це важливо для віртуалізації
Коли Proxmox створює VM, він виділяє vCPU і RAM. За замовчуванням ці vCPU можуть виконуватися на будь-якому фізичному ядрі будь-якого сокета. RAM віртуальної машини може виділятися з пулу пам’яті будь-якого вузла NUMA.
Якщо планувальник ставить vCPU на сокет 0, а RAM віртуальної машини лежить на сокеті 1, кожен доступ цього vCPU до пам’яті перетинає міжсокетне з’єднання. Якщо vCPU стрибають між сокетами, а вони стрибатимуть, якщо їх не закріпити, картина доступу до пам’яті перетворюється на безлад. Частина доступів локальна, частина віддалена, і продуктивність VM смикається відповідно.
Для загальних навантажень, як-от вебсервер, файловий сервер чи десктопна VM, з цим часто можна жити. Накладні витрати є, але вони розмазані по багатьох операціях і не домінують.
Для навантажень з інтенсивним вводом-виводом, як-от бази даних, сервери зберігання, будь-що з важким дисковим чи мережевим IO, штраф накопичується. Кожне завершення DMA, кожна доставка переривання, кожне копіювання буфера означає доступ до пам’яті. Якщо ці доступи перетинають сокети, накладні витрати швидко ростуть.
Чому це важливо для passthrough
Пристрої PCIe фізично підключені до конкретного сокета. Кожен сокет має власний кореневий комплекс PCIe. Накопичувач NVMe у слоті 3 може сидіти на лініях PCIe сокета 0. GPU у слоті 5 може сидіти на лініях сокета 1.
Коли пристрій виконує DMA, дані потрапляють у пам’ять того вузла NUMA, на який їх відображає IOMMU. Якщо RAM віртуальної машини виділена з локального для пристрою вузла, запис DMA йде прямо в локальну пам’ять. Якщо RAM на іншому вузлі, кожна операція DMA перетинає міжсокетне з’єднання.
Для накопичувача NVMe, що робить сотні тисяч IOPS, цей штраф 50–100 нс на операцію накопичується.
При iodepth=32 з випадковим читанням блоками 4 КБ різниця в пропускній здатності між вирівняною і невирівняною NUMA може сягати 20–30 %.
І це ще до того, як ти глянув на накладні витрати IOMMU, ASPM, MPS чи будь-що інше.
Те саме стосується мережевих карт, GPU і будь-якого іншого прокинутого пристрою. Трафік DMA пристрою має потрапляти в локальну пам’ять, а vCPU, що обробляють цей трафік, мають бути на тому самому вузлі.
Як перевірити свою топологію
На якому вузлі NUMA сидить пристрій
# Replace 0000:XX:00.0 with your device's PCI address from lspci
cat /sys/bus/pci/devices/0000:XX:00.0/numa_node
Команда повертає номер вузла NUMA.
Якщо вона повертає -1, ядро не змогло визначити вузол. Таке іноді трапляється з пристроями за певними комутаторами PCIe.
У такому разі простеж топологію PCIe вручну через lspci -tv і зістав кореневий порт із сокетом.
Повна схема NUMA
numactl --hardware
Це показує кожен вузол NUMA, скільки на ньому ядер, скільки пам’яті підключено і відстань (відносну вартість) між вузлами.
Приклад виводу з двосокетної системи EPYC:
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
node 0 size: 131072 MB
node 1 cpus: 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31
node 1 size: 131072 MB
node distances:
node   0   1
  0:  10  32
  1:  32  10
Таблиця відстаней показує відносну вартість. 10 означає локально. 32 означає віддалено. Більші числа означають більше переходів. На EPYC із чотирма вузлами на сокет деякі пари вузлів мають відстань 32, а інші 16, залежно від того, на якому CCD вони сидять.
Зістав пристрої з вузлами
# List all PCI devices and their NUMA nodes
for dev in /sys/bus/pci/devices/*; do
    node=$(cat "$dev/numa_node" 2>/dev/null)
    echo "$(basename $dev) node=$node $(lspci -s $(basename $dev) 2>/dev/null | cut -d' ' -f2-)"
done
Так ти отримуєш повну картину того, які пристрої на яких вузлах. Шукай свої контролери NVMe, мережеві карти й усі GPU, які прокидаєш.
Як вирівняти VM у Proxmox
Закріпи vCPU на правильному вузлі
У файлі конфігурації VM (/etc/pve/qemu-server/<vmid>.conf):
numa: 1
affinity: 0-15    # Adjust to match cores on the correct NUMA node
Параметр affinity закріплює vCPU віртуальної машини за конкретними фізичними ядрами.
Задай йому діапазон ядер на тому самому вузлі NUMA, що й прокинутий пристрій.
Якщо твій NVMe на вузлі 1, а вузол 1 має ядра 16–31, задай affinity: 16-31.
Якщо VM потрібно лише 8 vCPU, закріпи її на підмножині: affinity: 16-23.
Виділи пам’ять із правильного вузла
Увімкнений numa: 1 у конфігурації VM каже Proxmox показати VM топологію NUMA.
QEMU спробує виділити пам’ять VM з того вузла NUMA, на якому закріплені vCPU.
Для явного керування можна задати топологію NUMA в конфігурації VM:
numa0: cpus=0-7,hostnodes=0,memory=16384,policy=bind
Це каже QEMU прив’язати перший вузол NUMA віртуальної машини (вузол 0 з погляду гостя) до вузла NUMA 0 хоста, використовуючи ядра 0–7 і 16 ГБ пам’яті.
policy=bind гарантує, що пам’ять виділяється суворо з цього вузла, а не з інших, коли локальний пул під тиском.
Перевір закріплення
Після запуску VM перевір, що vCPU справді працюють там, де ти очікуєш:
# Find the QEMU process
pgrep -a qemu | grep <vmid>

# Check CPU affinity of the process
taskset -cp <pid>

# Or check per-vCPU thread affinity
for tid in $(ls /proc/<pid>/task/); do
    echo "Thread $tid: $(taskset -cp $tid 2>/dev/null)"
done
Типові помилки
Жодного закріплення
Якщо не задати affinity, vCPU віртуальної машини можуть виконуватися на будь-якому ядрі.
Планувальник ядра переноситиме їх між вузлами, балансуючи навантаження.
Щоразу, коли vCPU мігрує з одного вузла на інший, усі дані, з якими він працював у кеші старого вузла, стають віддаленими.
Для звичайних VM це прийнятно. Для VM із passthrough і важким IO ні.
Закріплення на не тому вузлі
Перевір вузол NUMA пристрою, перш ніж закріплювати.
Не припускай.
На деяких материнських платах нумерація фізичних слотів не збігається з прив’язкою до вузлів NUMA очевидним чином.
Завжди перевіряй через cat /sys/bus/pci/devices/.../numa_node.
Перевантаження вузла
Якщо закріпити забагато VM на одному вузлі NUMA, його ядра стають перевантаженими, а локальний пул пам’яті закінчується. Коли пам’ять переливається на віддалений вузол, ти отримуєш найгірше з обох світів: закріплені vCPU з віддаленою пам’яттю.
Розподіляй VM між вузлами рівномірно. Якщо маєш два вузли NUMA і чотири VM, розклади їх порівну.
Забута виділена пам’ять
Закріплення vCPU без керування виділенням пам’яті дає половину вигоди.
vCPU на правильному вузлі, а пам’ять може й не бути.
Використовуй policy=bind або щонайменше ввімкни numa: 1, щоб виділення пам’яті в QEMU йшло за закріпленням CPU.
Односокетні системи
На односокетній системі все на вузлі NUMA 0. Є лише один контролер пам’яті й один набір ліній PCIe. Вирівнювання NUMA тут не турбота.
Можна все одно задати numa: 1 у конфігурації VM, це нічого не зламає, але й не допоможе.
Один сокет, один контролер пам’яті, нема чого вирівнювати.
Прибережи зусилля для машини, у якої їх два.
Тож вигода в продуктивності, описана тут, стосується лише багатосокетних систем, де існує міжсокетне з’єднання.
Джерела
- Proxmox VE Administration Guide — CPU and NUMA Configuration — офіційна документація про закріплення vCPU та параметри NUMA
- Linux kernel NUMA documentation — довідка про політики пам’яті ядра
- AMD EPYC 7003 Series — BIOS & Workload Tuning Guide (doc 58002) — документація AMD про NUMA на сокет і топологію CCD/CCX