Питання, з якого починається кожна оцінка Proxmox
«Чи Proxmox справді корпоративного рівня?»
Воно виникає майже в кожній розмові про міграцію, і тривога під ним майже ніколи не стосується вебінтерфейсу. Ніхто всерйоз не боїться, що панель у браузері зіпсує його дані. Люди насправді питають, чи те, що стоїть між віртуальною машиною та залізом, тобто компонент, який має не пускати одного орендаря в пам’ять іншого, завжди і без жодної помилки, є серйозною інженерною роботою чи спільнотним проєктом, який просто став популярним.
Саме через це й варто нервувати. Просто тривога спрямована не на той рівень, бо Proxmox VE не містить гіпервізора.
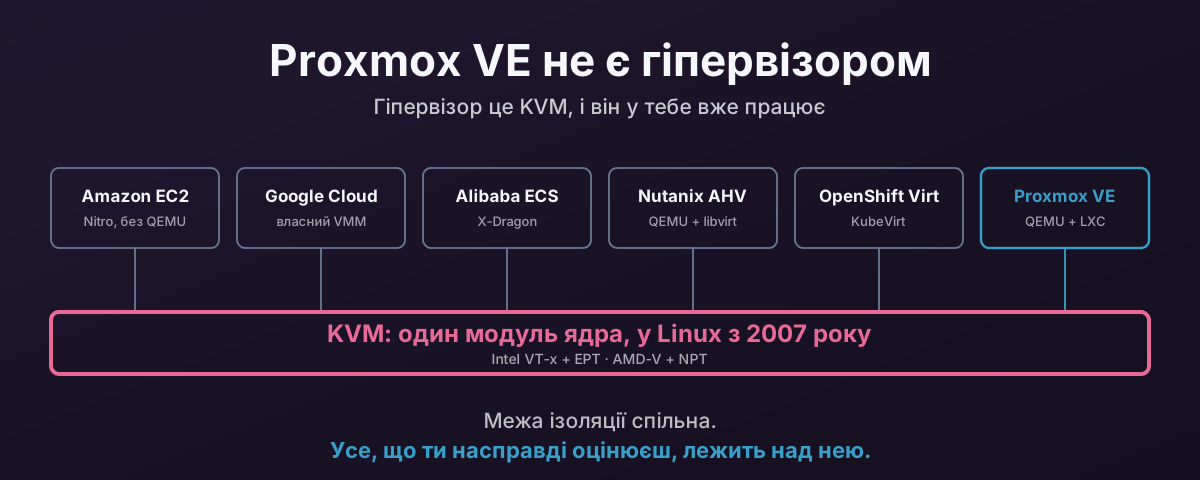
Гіпервізор це KVM. Він є частиною Linux, він там із 2007 року, і якщо твоя організація користується EC2, Google Cloud, Oracle Cloud, Alibaba Cloud, DigitalOcean чи Nutanix, ти вже сьогодні запускаєш його в продакшені. Тобі просто ніколи не доводилося про це думати, бо рівнями вище володів хтось інший.
Цей допис про те, що насправді означає ця спільна основа. Обидві її половини: ту частину аргументу, яка справді тримається, і ту, яку перебільшують у слайдах вендорів.
Proxmox VE є рівнем керування
Віртуалізація в Linux складається з чотирьох окремих рівнів, які створюють і підтримують чотири різні групи людей.
1. Апаратні розширення віртуалізації. Intel VT-x з EPT або AMD-V з NPT. Кремній. Саме це дає гостьовій системі змогу запускати власне ядро з нативною швидкістю і з власними таблицями сторінок, без жодної емуляції інструкцій.
2. KVM, гіпервізор.
Модулі ядра: kvm.ko для архітектурно незалежного ядра плюс kvm-intel.ko або kvm-amd.ko для розширень вендора. Це компонент, який володіє межею ізоляції. Він налаштовує керувальні структури віртуальної машини гостя, обробляє виходи з ВМ, керує таблицями сторінок другого рівня і доставляє переривання.
3. VMM, монітор віртуальних машин, у просторі користувача. У Proxmox VE це QEMU. Він будує віртуальну материнську плату: чипсет, топологію PCIe, диски, мережеві карти, послідовні порти, прошивку. KVM виконує CPU; QEMU вирішує, яке залізо, на думку гостя, у нього є.
4. Рівень керування.
Це і є Proxmox VE: pve-manager і pveproxy для API та інтерфейсу, qemu-server, щоб перетворити файл конфігурації ВМ на командний рядок QEMU, pve-container для LXC, pmxcfs поверх Corosync для реплікованої конфігурації кластера, pve-ha-manager для фенсингу й перезапуску, плюс стек брандмауера та SDN.
Ці чотири рівні є і на платформі, з якої ти мігруєш, і виконують ті самі чотири завдання: vCenter є рівнем 4, VMkernel є рівнем 2. Я повернуся до цього порівняння, щойно всі частини будуть на столі.
Що Proxmox насправді підтримує
Рівнем 4 Proxmox VE володіє повністю. Але було б неправильно казати, що рівні 2 і 3 він лише пакує, і це найпоширеніше хибне уявлення про те, що робить компанія.
pve-qemu на момент написання несе 78 патчів проти upstream QEMU у своєму файлі series:
debian/patches/series. Більша частина черги є власною інженерною роботою Proxmox, і вся вона лежить на рівні 3: жоден із цих патчів не торкається kvm.ko.Вони також збирають власне ядро і підтримують пакування або патчі для більшої частини довколишнього стеку: pve-edk2-firmware для OVMF, плюс lxc, zfsonlinux, openvswitch, libiscsi, corosync-pve, lvm і ceph.
Тож справжня межа така: увесь рівень 4, значна інженерна робота всередині рівня 3 і ядро, яке вони компілюють. Чого вони не зробили, то це не написали гіпервізор. Код KVM рівня 2 є upstream Linux.
І ніщо з цього не є критикою Proxmox. Власне, саме тому компанії розміру Proxmox взагалі можна довірити цю роботу. Невелика компанія у Відні не сіла писати гіпервізор з нуля; вони побудувалися на тому, за супровід якого Intel, AMD, Red Hat, Google, Amazon і IBM уже платили інженерам, і витратили власні зусилля на рівень над ним та на інтеграційну роботу, якої цей рівень потребує. Саме там команда такого розміру може щось змінити, і черга патчів показує, що вони це роблять.
Що таке KVM насправді
KVM розшифровується як Kernel-based Virtual Machine, і назва точна: це функція ядра, а не програма.
Завантаж модулі, і Linux отримає символьний пристрій /dev/kvm плюс невеликий набір викликів ioctl на ньому: KVM_CREATE_VM, KVM_CREATE_VCPU, KVM_SET_USER_MEMORY_REGION, KVM_RUN.
Цей інтерфейс і є всім API гіпервізора. Усе, що може відкрити файловий дескриптор і викликати ioctl, може створювати віртуальні машини.
Його написав Avi Kivity у Qumranet, і його злили в Linux 2.6.20, випущений у лютому 2007 року, дев’ятнадцять років тому. Red Hat придбала Qumranet у 2008 році, і відтоді KVM постачається в кожному випуску ядра, у звичному для ядра ритмі дев’ять-десять тижнів. Його портовано далеко за межі x86: arm64, POWER, s390 на IBM Z і RISC-V.
Важливий архітектурний момент полягає в тому, чому він маленький.
У KVM немає планувальника, бо він є в Linux. vCPU є звичайним потоком хоста, і completely fair scheduler ставить його на ядро, як будь-який інший потік. У нього немає менеджера пам’яті, бо він є в Linux. Оперативна пам’ять гостя є звичайним відображенням у просторі користувача, тож її можна витісняти, підкріплювати hugepages або розміщувати на вузлі NUMA тими самими механізмами, що й для будь-якого іншого процесу. У нього немає стеку драйверів, блокового рівня, мережевого стеку чи файлової системи, бо все це в Linux уже було, і саме з ними тестує твій постачальник заліза.
Це і є справжній аргумент про зрілість, і він набагато сильніший за номер версії. Кожне покращення балансування NUMA, кожна зміна в io_uring, кожен мережевий драйвер, кожен новий обхід помилок CPU, що потрапляє в Linux, потрапляє під твої віртуальні машини, бо немає окремого ядра гіпервізора, на яке хтось мав би це портувати.
Аргумент про тип 1 проводить межу не там
Заперечення, яке надійно йде слідом, звучить так: KVM «лише гіпервізор типу 2». Він працює на хостовій ОС, на відміну від ESXi, який працює на голому залізі.
Ця таксономія старша за апаратну віртуалізацію на три десятиліття, і те, навколо чого вона проводила межу, вже давно не там, де всі думають.
Що насправді відбувається, коли працює vCPU
QEMU викликає ioctl(vcpu_fd, KVM_RUN). Керування переходить у kvm.ko, який завантажує стан CPU гостя і виконує VMLAUNCH. Від цієї інструкції до наступного виходу з ВМ гість виконується безпосередньо на фізичному ядрі, у гостьовому режимі, з власними таблицями сторінок, активними через EPT, на повній апаратній швидкості. Під ним нема нічого, що б щось інтерпретувало. «Хостова ОС» не на цьому шляху. Вона навіть не працює на цьому ядрі.
Коли гість робить щось, що потребує обробки, CPU виходить до хоста і потрапляє в kvm.ko, у ядро, рівно на той рівень привілеїв, який займає VMkernel в ESXi. Більшість виходів розв’язуються просто там, із поверненням у гостя, і простір користувача навіть не залучається.
В ESXi такий самий поділ
А тепер подивися на платформу, яка нібито доводить цю відмінність.
Власна архітектурна документація VMware описує VMkernel як «a POSIX-like operating system», що надає «process creation and control, signals, file system, and process threads». Це операційна система, за описом її автора. А запущена ВМ в ESXi не є чимось усередині ядра: вона є групою процесів userworld: VMM на кожен віртуальний CPU, який віртуалізує інструкції гостя і керує його пам’яттю, і процес VMX на кожну ВМ, який обробляє введення-виведення пристроїв, не критичних для продуктивності, і спілкується з менеджером знімків та віддаленою консоллю.
Прочитай це, тримаючи в голові QEMU. Контекст виконання на кожен vCPU в ядрі, процес у просторі користувача на кожну ВМ, що займається емуляцією пристроїв і керуванням. VMware розділила це з тієї самої причини, що й усі інші.
Hyper-V нічим не відрізняється. Документація Microsoft прямо каже, що Virtual Machine Worker Process, vmwp.exe, є «a user mode component of the virtualization stack», що запускається на кожну ВМ, і що всі емульовані пристрої реалізовано в ньому, і працює він у кореневому розділі, яким є Fisher-Price OS (Windows). Навіть Xen, архітектура, якій таксономія пасує найкраще, потребує для роботи Linux загального призначення в dom0, а модель пристроїв для повністю віртуалізованих гостей бере з QEMU.
То де ж межа?
Критерієм ніколи не було «чи використовує він простір користувача». Таксономія Голдберга з початку 1970-х питає, чи гіпервізор є застосунком, що працює на вже наявній операційній системі, яка вже володіє залізом і займається плануванням. Це тип 2, хостований гіпервізор: VMware Workstation, VirtualBox, Parallels Desktop, звичайний QEMU без прискорення. Ти встановлюєш ОС загального призначення, потім установлюєш на неї програму, і ця програма просить в ОС пам’ять і час CPU, як будь-яка інша програма.
KVM не такий. kvm.ko не є програмою поверх Linux. Він є частиною Linux, виконується на тому самому рівні привілеїв, що й код, який володіє залізом, і коли гість виходить, він потрапляє саме туди. Під гіпервізором немає хостової ОС. Ядро і є гіпервізором. Proxmox VE постачає це ядро як систему, точно так, як ESXi постачає VMkernel як систему.
А версію «йому потрібен простір користувача, отже, це тип 2» врятувати неможливо, бо якщо застосовувати її послідовно, під неї потрапляє все. Жодна ВМ не працює на ESXi без свого процесу VMX, жодна на Hyper-V без vmwp.exe, жодна на Xen як HVM-гість без QEMU. Тест, який кладе кожен наявний на ринку гіпервізор в один кошик, нічого не розрізняє.
| Ядро, що володіє віртуалізацією CPU і пам’яті | Модель пристроїв у просторі користувача на кожну ВМ | Потрібна вже наявна хостова ОС? | |
|---|---|---|---|
| VMware ESXi | VMkernel | VMX на кожну ВМ | Ні |
| Microsoft Hyper-V | гіпервізор плюс кореневий розділ Fisher-Price OS (Windows) | vmwp.exe | Ні |
| Xen | гіпервізор Xen плюс Linux у dom0 | QEMU, у dom0 або в stub-домені | Ні |
| KVM | kvm.ko | QEMU | Ні |
| VirtualBox, VMware Workstation | ядро хоста, через установлений драйвер | сам застосунок | Так |
Чотири продукти, одна форма, а потім п’ятий рядок, який справді інший. Саме для опису цього останнього рядка вигадали «тип 2», і це єдиний, де залізом уже керувало щось інше.
Тож таксономія все ще проводить межу. Просто зовсім не там, де припускає аргумент: KVM і ESXi по один бік від неї. Назвати KVM типом 2 означає взяти слово з категорії VirtualBox і застосувати його до чогось, що архітектурно належить до категорії ESXi.
Отже, у процесі оцінки ця мітка не робить жодної корисної роботи, бо обидва продукти, між якими ти обираєш, лежать в одній коробці. Різниця не в номері типу. Вона в тому, що один вендор також написав ядро і не дає тобі його прочитати: це відмінність у ліцензуванні та прозорості, вбрана в одяг архітектурної діаграми. Nutanix показує це на комерційному прикладі: він постачає той самий код KVM, що й Proxmox, і описує AHV як bare-metal гіпервізор типу 1. Той самий код, протилежна мітка, інший відділ маркетингу.
У звинуваченні таки ховається справжня проблема, і вона заслуговує на кращу назву: ядро загального призначення виконує тисячу завдань, яких не виконує спеціалізоване, а це більше коду і більша поверхня атаки поряд із межею ізоляції. Це законно і вимірювано, і я повертаюся до цього ближче до кінця.
Де насправді відбувається робота
Єдине місце, де інстинкт «воно ж на хостовій ОС» має реальний сенс, це обробка виходів, тож варто чітко розуміти, куди йде який вихід.
| Гість робить ось це | Обробляє | Вартість |
|---|---|---|
| Звертається до сторінки, ще не відображеної в EPT/NPT | kvm.ko, у ядрі | Один вихід, мікросекунди |
| Пише у свій локальний APIC | Сам CPU, через APICv/AVIC | Часто жодного виходу |
| Надсилає міжпроцесорне переривання | Posted interrupts в залізі | Часто без виходу |
Передає дані через чергу virtio-net з vhost-net | Потік ядра, без стрибка в простір користувача | Один doorbell |
| Читає регістр емульованого контролера e1000 чи IDE | Аж до QEMU | Вихід плюс повний цикл у просторі користувача |
Лише останній рядок хоч трохи схожий на карикатуру типу 2, і саме його ти прибираєш інженерно: використовуєш пристрої virtio і не показуєш емульоване застаріле залізо, яке тобі не потрібне. Та сама логіка стоїть за вибором Q35 замість i440fx: менше перехоплених звертань до регістрів, менше застарілих пристроїв для обходу.
Хостова ОС є перевагою, а не баластом
Друга половина цього балансу ніколи не потрапляє в аргумент, тож ось вона: вузол Proxmox є машиною, на якій справді можна працювати. Це Debian, тож увесь архів Debian на відстані одного apt install.
- Моніторинг, який ти вже використовуєш: Prometheus node exporter,
smartmontools, твій наявний агент, а не те, що вирішить показати аплаєнс. - Діагностика, коли щось повільно:
fio,iperf3,nvme-cli,perf,bpftrace. - Агенти резервного копіювання від будь-якого вендора, що постачає бінарник для Linux.
- Керування конфігурацією, тож гіпервізор стоїть у тому самому інвентарі Ansible, що й усе інше, а не є особливим випадком.
fwupdдля прошивок, на залізі, вендор якого підтримує LVFS.
Ніщо з цього не потребує формату плагінів, підписаного пакета чи благословення вендора. Порівняй із моделлю ESXi, де оболонку навмисно обмежено, сторонній код приходить як VIB, а менеджера пакетів, до якого можна дотягнутися, немає взагалі.
Це сягає стеку зберігання
Агенти моніторингу є нудною версією цього. Власна документація Proxmox про зберігання перелічує нативні плагіни, dir, NFS, CIFS, CephFS, ZFS, BTRFS, LVM, LVM-thin, iSCSI, FC/SAS, RBD, ZFS-over-iSCSI, PBS, а потім додає речення, яке варто сприйняти буквально:
you may use all storage technologies available for Debian Linux
Це твердження про те, де проходить межа, і механізм за ним загальний: доведи блоковий пристрій до кожного вузла, поклади на нього LVM, додай його як сховище LVM з увімкненим shared. Саме так працюють підтримувані шляхи Fibre Channel та iSCSI, тож усе, що може дати спільний блоковий пристрій, може піти тим самим маршрутом.
NVMe over TCP або RDMA є випадком, про який варто знати, бо він швидкий, сучасний і відсутній у тому списку плагінів. nvme-tcp і nvme-rdma є драйверами хоста в дереві Linux (NVMe/TCP є в mainline з 5.0), тож компілювати нічого не треба. nvme-cli є пакетом Debian (nvme discover, потім nvme connect), а nvmetcli налаштовує ціль nvmet у ядрі на іншому кінці. Підключений простір імен з’являється як /dev/nvmeXnY, і далі це звичайний блоковий пристрій.
ATA over Ethernet доводить те саме з протилежного кінця спектра: давній, маловідомий і так само непідтримуваний як плагін. Драйвер aoe є в mainline; aoetools дає тобі aoe-discover і aoe-stat; vblade перетворює будь-який файл чи блоковий пристрій на іншій машині на ціль. Той самий маршрут, той самий результат.
Жоден із них не є API плагінів, SDK чи програмою сертифікації. Це те, що відбувається, коли рівень зберігання гіпервізора і є блоковим рівнем Linux.
Чесні застереження, бо це виглядає як фокус, доки не настане третя ночі. Жоден із цих транспортів не є протестованим типом сховища Proxmox, тож інтеграція та її режими відмов, поведінка при перепідключенні, multipath, тайм-аути під навантаженням, на тобі: тобі їх і тестувати, перш ніж на цьому житиме щось важливе. А AoE є голим протоколом рівня 2, без маршрутизації і без автентифікації, тож йому місце в ізольованому VLAN для зберігання і більше ніде. NVMe/TCP принаймні має модель виявлення і може маршрутизуватися, і багато в чому саме тому зараз варто братися за нього.
Хто ще запускає KVM
Ось звідки береться твердження «він у тебе вже працює». Кожна платформа нижче запускає той самий модуль ядра.
| Платформа | Де ти з нею стикаєшся | Частина KVM | VMM у просторі користувача |
|---|---|---|---|
| Amazon EC2 (Nitro) | Публічна хмара | Основний модуль KVM | Власний: QEMU прибрано, модель пристроїв у картах Nitro |
| AWS Lambda, Fargate | Serverless | /dev/kvm | Firecracker: мінімальний монітор microVM на Rust |
| Google Compute Engine | Публічна хмара | KVM від самого запуску | Власний VMM Google, навмисно не QEMU |
| Alibaba Cloud ECS | Публічна хмара | Спрощений KVM (X-Dragon) | Власний, мережа і зберігання винесені на карту MoC |
| Oracle Cloud (OCI) | Публічна хмара | Oracle Linux KVM, той самий стек, який Oracle постачає для власних дата-центрів | Похідний від QEMU |
| DigitalOcean, Linode/Akamai, Vultr, Hetzner, OVHcloud, Scaleway, UpCloud | Публічна хмара | Стоковий KVM | QEMU |
| Nutanix AHV | Власна HCI | Стоковий KVM | QEMU з libvirt і Open vSwitch |
| OpenStack (Nova) | Приватна хмара | Стоковий KVM | QEMU через libvirt, драйвер за замовчуванням і найкраще протестований |
| Apache CloudStack, OpenNebula, oVirt | Власна інфраструктура | Стоковий KVM | QEMU через libvirt |
| OpenShift Virtualisation, SUSE Harvester | Kubernetes | Стоковий KVM | QEMU усередині пода, через KubeVirt |
| Proxmox VE | Власна інфраструктура | Стоковий KVM | QEMU, а поруч LXC для контейнерів |
Усі лишають половину в ядрі й переписують половину в просторі користувача
Гіперскейлери не форкнули KVM. Вони форкнули роботу QEMU.
AWS перевела EC2 з Xen на гіпервізор Nitro, побудований на основному модулі ядра KVM, з повністю викинутим QEMU. Модель пристроїв натомість живе в спеціальних картах Nitro, і саме так вони отримують продуктивність, яку не відрізнити від голого заліза. Кожен тип інстансу EC2 поточного покоління працює на цьому. Окремо Lambda і Fargate запускають Firecracker, спеціально створений VMM на Rust, який говорить із тим самим /dev/kvm.
Google запускає кожну ВМ Compute Engine на KVM із самого запуску Compute Engine і написала власний VMM у просторі користувача замість QEMU, прямо для того, щоб уникнути величезної матриці гостей, пристроїв і режимів QEMU. Вони також пішли іншим шляхом і зміцнили модуль ядра в upstream, прибравши емульовані пристрої, які нікому не були потрібні, і звузивши набір емульованих інструкцій. Ця робота є в тому KVM, який запускаєш ти.
Alibaba зробила те саме з X-Dragon: урізаний гіпервізор KVM, віртуалізацію мережі та зберігання якого винесено на карту MoC на основі FPGA.
Nutanix AHV є KVM плюс libvirt плюс QEMU плюс Open vSwitch плюс оркестрація Nutanix: з усіх комерційних продуктів у тому списку це найближчий родич Proxmox VE. Інший рівень 4 і зовсім інший рахунок.
Proxmox VE лишає QEMU навмисно
Таблицю спокусливо читати як рейтинг, де AWS і Google угорі, бо замінили QEMU. Це хибне прочитання, бо їхнє обмеження не твоє.
AWS і Google працюють з одним апаратним профілем, у масштабі, де одна помилка в емуляції пристрою є подією для всього парку, і вони контролюють кожну межу гостьового образу, яка їх цікавить. У такому світі широта QEMU майже повністю є тягарем, тож видалити його очевидно правильно.
Ти не в такому світі.
У тебе є образ аплаєнса 2013 року, якому потрібен e1000. У тебе є ВМ із Fisher-Price OS (Windows), тип машини якої має лишатися зафіксованим до кінця її життя. У тебе є GPU для прокидання, емульований SAS-контролер, щоб задовольнити інсталятор, сховище змінних UEFI, яке треба зберегти. QEMU саме те, що дає платформі загального призначення змогу сказати на все це «так».
Те, що AWS називає поверхнею атаки, ти називаєш матрицею сумісності. Обидва описи точні; різниця в тому, чи можеш ти обирати свої навантаження.
Це також пояснює форму тієї черги патчів. AWS і Google розв’язали резервне копіювання і знімки поза VMM, у власних сервісах зберігання. У Proxmox не було сервісу зберігання, щоб розв’язати це там, тож вони поклали це в QEMU, і саме тому savevm-async і блоковий драйвер PBS існують як патчі, а не як продукти.
І це варто знати з практичної причини: ті частини Proxmox VE, яких тобі найбільше бракуватиме, саме ті, яких немає в upstream. Конфігурації твоїх ВМ є звичайним текстом, а образи дисків мають стандартні формати, тож машина переїде. Але знімок зі станом RAM і інкрементальний ланцюжок Proxmox Backup Server залежать від форку QEMU від Proxmox. Це набагато легша залежність, ніж пропрієтарний гіпервізор, бо форк публічний, під AGPL, і ти можеш прочитати кожен патч у ньому, але вона не нульова, і фраза «жодної прив’язки на рівні програмного забезпечення» має нести цю примітку.
То чи він корпоративного рівня?
Лінива форма цього аргументу не працює, і варто сказати це прямо. «AWS використовує KVM, отже Proxmox VE корпоративного рівня» є хибним висновком: він бере твердження про один рівень і тихо застосовує його до цілого продукту.
Ось версія, яка тримається.
Спільним є той рівень, який найважче зробити правильно і найнебезпечніше зробити неправильно. Віртуалізація CPU і пам’яті та межа ізоляції між орендарями є тією частиною, де помилка означає злам, а не простій. Цей код рецензують інженери, яким платять Amazon, Google, Red Hat, Intel, AMD, IBM і Alibaba, а його помилки знаходять ті, хто керує найбільшими парками у світі, зазвичай раніше, ніж ядро дійде до тебе. Коли вразливість виходу з гостя таки з’являється, виправлення приходить звичайним оновленням ядра, яке ти й так збирався встановити. Ти не чекаєш на цикл випусків одного вендора для гіпервізора, який бачить лише цей вендор.
Не спільним є все, що над межею. А отже, питання зводиться до двох, на які відповісти набагато легше:
- Чи достатньо добрий рівень керування для того, як ти працюєш?
- Чи можеш ти купити для нього підтримку на умовах, з якими зможеш жити?
Обидва можна перевірити в пілотному проєкті й записати в контракт. Жодне не вимагає віри в гіпервізор.
Це набагато краща позиція, ніж та, яку припускає початкове питання: що тебе просять довіритися новому гіпервізору від невеликого вендора. Не просять. Специфічний для Proxmox код є рівнем керування, переважно на Perl і дедалі більше на Rust, плюс та черга патчів до QEMU, і зверни увагу, куди лягають патчі: модель пристроїв і шлях резервного копіювання, а не межа ізоляції.
Також варто знати, чого тобі коштує збій специфічного для Proxmox рівня. Процеси QEMU є звичайними незалежними процесами на хості, тож падіння pveproxy не зупиняє жодної віртуальної машини. Це зовсім інший радіус ураження, ніж втрата компонента, який володіє межею ізоляції.
Чого тобі не дає «той самий гіпервізор»
Саме тут документи вендорів, що вселяють упевненість, зазвичай зупиняються, і це дещо каже про те, для кого їх написано. Це корисніша половина.
Він не дає тобі надійності AWS. Доступність Nitro дуже мало пов’язана з KVM. Вона походить від площини керування, мережевої фабрики, сервісу зберігання, керування потужностями та операційної практики навколо всього цього. Надійність твого кластера походитиме від дизайну кворуму Corosync, конфігурації фенсингу, вибору сховища та резервування мережі. У KVM немає думки щодо жодного з них. Спільний гіпервізор із гіперскейлером не успадковує їхньої експлуатації.
Він не дає тобі поверхні атаки Nitro, і саме тут влучає законна половина звинувачення в типі 2.
Ти запускаєш QEMU на ядрі загального призначення, а історично саме в моделі пристроїв QEMU жили найпам’ятніші виходи з ВМ: VENOM, в емульованому контролері дискет, яким ніхто не користувався, є канонічним прикладом. Google тоді могла зазначити, що Compute Engine не постраждав саме тому, що не запускає QEMU. Ти його запускаєш, тож компенсаційні заходи на тобі: віддавай перевагу virtio над емульованим залізом, не показуй пристроїв, які тобі не потрібні, не чіпай профілі AppArmor і оновлюй QEMU з тією самою дисципліною, що й ядро. Патчі extra/ від Proxmox саме так і роблять це за тебе, і цілком розумно перевіряти, чи вони досі це роблять.
Він не робить поведінку ВМ переносною між платформами.
Вибір моделі CPU, версіонування типу машини, сумісність живої міграції та поведінка годинника вирішуються на рівнях 3 і 4, і вони всюди різні. Кластер зі змішаними поколіннями CPU все одно покарає тебе за тип CPU host, а годинники гостей усе одно дрейфують, хоч би який логотип стояв на платформі. Той самий гіпервізор не означає ту саму поведінку.
Він не відповідає на питання підтримки, а саме воно цікавить закупівлі, і цілком слушно. Proxmox VE розповсюджується під AGPLv3, і запускати його в продакшені безкоштовно. Підписка купує протестований корпоративний репозиторій і підтримку вендора, від €120 за сокет на рік. Власна підтримка Proxmox працює в робочі години Австрії, тож цілодобове покриття дають партнери, а не Відень. croit, де я працюю, є одним із таких партнерів і покриває 24/7, 365 днів на рік. Це комерційні переговори, а не технічний ризик, і те, що це саме комерційні переговори, є сенсом усього, що вище.
Що насправді оцінювати замість цього
Якщо з гіпервізором усе вирішено, пілотний проєкт має витратити свій час на рівень, який справді специфічний для Proxmox VE:
- Фенсинг і HA. Вимкни живлення на вузлі з працюючими HA-гостями і заміряй час перезапуску. Потім зроби це з двома вузлами і переконайся, що решта поводиться так, як ти очікуєш, коли кворум втрачено.
- Жива міграція між поколіннями CPU. З тією моделлю CPU, на якій ти справді збираєшся стандартизуватися, а не з
host. - Резервне копіювання і, що важливіше, відновлення. Час відновлення під навантаженням, а не час резервного копіювання. Нікому ще не дякували за швидкий бекап.
- Модель прав доступу. Чи можеш ти дати команді застосунку консоль і керування живленням лише їхніх ВМ і нічого більше, досить детально, щоб задовольнити аудитора.
- API. Усе, що робить вебінтерфейс, є викликом API; якщо твоя автоматизація не може ним керувати, платформа не впишеться в те, як ти працюєш.
- Шлях оновлення. Оновлення мажорної версії на пілотному кластері, поки на ньому ще немає 400 ВМ.
Жодне з цих питань не про KVM. У цьому, власне, і суть.
Гіпервізор є вирішеною частиною. Витрачай пілотний проєкт на ті частини, які такими не є.
Джерела
Сам KVM
- KVM API documentation — інтерфейс ioctl
/dev/kvm, який і є всім контрактом гіпервізора - Linux 2.6.20 release notes — випуск, у який злили KVM, лютий 2007 року
- Some KVM developments — LWN, січень 2007 року, про KVM у дні після того, як він потрапив у mainline
Як побудовано інші гіпервізори
- Interpreting virtual machine monitor and executable failures — власний опис Broadcom запущеної ВМ ESXi як «several processes or userworlds», з одним VMM на vCPU і одним VMX на ВМ
- The Architecture of VMware ESXi (PDF) — whitepaper, що називає VMkernel «a POSIX-like operating system» із процесами, сигналами, файловою системою і потоками. Посилання на дзеркало, бо оригінальна URL-адреса VMware не пережила реорганізацію Broadcom, що саме по собі є маленьким коментарем щодо безперервності вендорів
- Hyper-V architecture — Microsoft про Virtual Machine Worker Process як компонент режиму користувача, по одному на ВМ, де живуть усі емульовані пристрої
- The Nutanix Bible — AHV architecture — AHV, описаний як KVM з libvirt, QEMU і Open vSwitch
Хто запускає KVM і як вони його змінили
- 7 ways we harden our KVM hypervisor at Google Cloud — Google про запуск KVM без QEMU і про зміцнення, яке вони зробили в upstream
- The AWS Nitro System — які типи інстансів EC2 працюють на гіпервізорі Nitro
- AWS EC2 Virtualization 2017: Introducing Nitro — розбір переходу з Xen на KVM від Brendan Gregg, досі найзрозуміліший його опис
- Firecracker — мінімальний VMM від AWS на основі KVM, що стоїть за Lambda і Fargate
- Alibaba Cloud’s sixth-generation ECS instances — гіпервізор X-Dragon і винесення на MoC
- KubeVirt — модель QEMU/KVM у поді, що стоїть за OpenShift Virtualisation і Harvester
- OpenStack Nova hypervisor support matrix — KVM як еталонний драйвер
Що підтримує Proxmox
- The Proxmox GitHub organisation — 89 репозиторіїв, зокрема
pve-qemu,pve-kernel,pve-edk2-firmwareі пакування дляlxc,zfsonlinux,openvswitch,libiscsi,corosync-pveіceph pve-qemupatch series — 78 патчів, порахованих вище, і найшвидший спосіб побачити, що саме Proxmox додає до QEMU- Proxmox VE storage documentation — список нативних плагінів, які типи сховищ спільні, і рядок про використання всіх технологій зберігання, доступних для Debian Linux
nvme-cliіnvmetcli— інструменти хоста й цілі NVMe-oF;aoetoolsіvbladeдля відповідника ATA over Ethernet. Усе в Debian trixie, на якому побудовано Proxmox VE 9- Proxmox VE pricing and subscription tiers — що покриває підписка
Розкриття: я працюю в croit, Gold Partner Proxmox. Технічні твердження вище мають джерела, і їх можна перевірити; комерційний абзац є тією частиною, де в мене є інтерес, тож стався до нього відповідно.