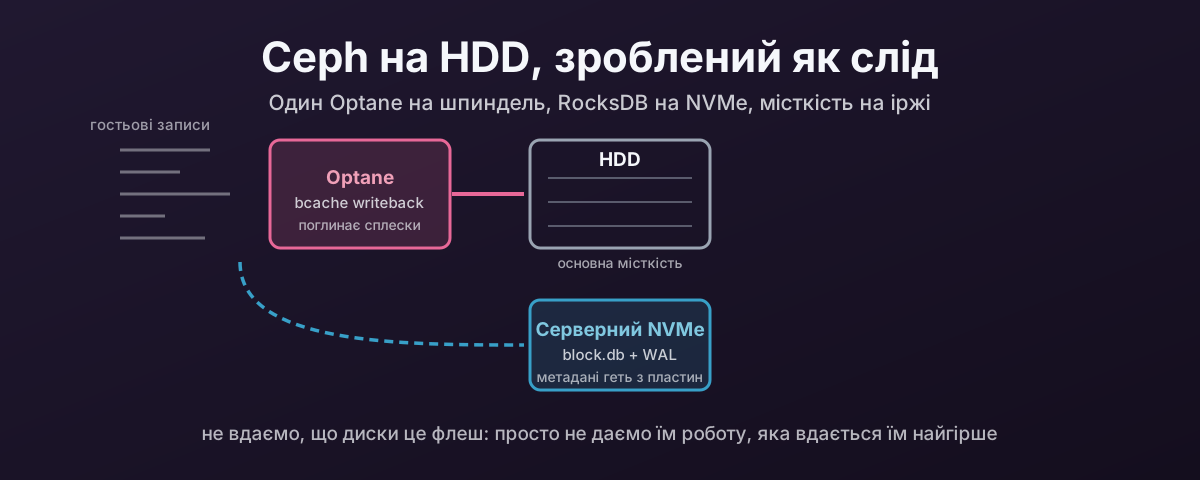
Чому HDD знову в меню
Роками порада була настільки простою, що влазила на стікер: став усе на SSD.
Ця порада була правильною, а ще й дешевою. Сьогодні ні те, ні те вже не зовсім правда. Постачання NAND скоротилося, попит з боку ШІ підняв ціни на флеш, і місткі NVMe стало важко виправдати для ощадливого розгортання Proxmox, такого, що має працювати, бути надійним і коштувати так мало, як дозволяє чесність.
Корпоративні HDD знову цікаві з тієї ж причини, що й завжди: місткість на кожен фунт, і ніщо інше навіть близько не стоїть.
Підступ у тому, що кожен, хто запускав VM на дисках, що крутяться, знає, як погано це може закінчитися. Цей досвід справжній, і зазвичай винна в ньому архітектура, а не диски.
Звинувачувати диски, щоправда, легше. Але це неправильно, і це дорого, бо вмовляє людей купувати флеш, який їм не був потрібен.
Усе нижче розраховане на Proxmox із гіперконвергентними OSD Ceph, бо саме там рішення про компонування справді кусаються.
Проблема в затримці, а не в пропускній здатності
Сучасний корпоративний HDD чудово перекачує великі послідовні дані. Вузьким місцем це ніколи не було.
Корпоративний диск на 7,2k RPM дає десь від 80 до 100 IOPS випадкової роботи, бо кожна випадкова операція чекає на переміщення головки й оберт пластини. За двадцять років це число майже не змінилося. Це механіка, а не електроніка. Найпростіший корпоративний SSD віддалений від нього на три чи чотири порядки.
Дай тому самому диску послідовну роботу, і він стане корисним пристроєм. Темп операцій приблизно подвоюється, до близько 200 IOPS, але кожна з цих операцій тепер несе великий блок, бо головка вже на місці й може читати потоком. Тож ти отримуєш справжню пропускну здатність, від 150 до 250 MB/s, за ціною за терабайт, до якої ніщо інше не дотягує.
Ось ця важлива асиметрія, і вона не про те, що «HDD повільні». Диск, що крутиться, добрий у послідовній роботі й безнадійний у випадковій, а два числа близькі лише тому, що обмежена кількість операцій, а не байти.
І це задає все технічне завдання. Ти не намагаєшся зробити диск швидшим. Не вийде. Ти намагаєшся влаштувати так, щоб він проводив час у тому режимі, де він уже компетентний, і щоб дрібний випадковий трафік до нього не доходив. Тож усе, що далі, це одна ідея, застосована двічі.
Проблема в тому, що віртуальні машини не створюють того навантаження, яке HDD вдається. Вони створюють оновлення метаданих, записи журналу, дрібні синхронні скидання, журналювання, господарські дрібниці файлової системи й сплески випадкової активності від десятка гостей одночасно, які приходять на диск упереміш.
Ceph додає до цього свій шар. Кожен запис несе поряд із даними оновлення метаданих RocksDB. Якщо все це лягає на голі шпинделі, диски витрачають час на пошук замість обслуговування, і ти отримуєш симптом, який упізнає кожен адміністратор: високе очікування I/O, мляві гості, непостійна чутливість і кластер, що здається значно повільнішим, ніж обіцяє його паспорт місткості.
Власні рекомендації Ceph щодо заліза прямо кажуть, куди це веде. Вони застерігають: «consider carefully the ostensible cost-per-gigabyte advantage of larger HDDs, and the concomitant limitations of IOPS per TB», і кажуть, що диски понад 8 TB «may be best suited for storage of large files / objects that are not at all performance-sensitive.»
Цю арифметику варто зробити, бо диски, які взагалі роблять це вигідним, великі. Від 20 TB і більше. Диск на 20 TB так само дає свої 80–100 випадкових IOPS, бо місткість не купує тобі жодної операції. Тож він пропонує близько 4–5 випадкових IOPS на терабайт, тоді як диск на 8 TB дає приблизно одинадцять, а диск на 2 TB сорок.
Отже, за власною міркою Ceph, шпиндель на 20 TB глибоко на тій території, куди тобі радять не ставити чутливі до продуктивності навантаження.
Це не аргумент проти їх купівлі. Це причина, з якої існує решта цього допису. Описана нижче схема якраз і робить шпиндель на 20 TB придатним для зберігання VM, бо влаштовує так, щоб дрібна випадкова робота до нього ніколи не доходила.
Забери метадані зі шпинделя
Найцінніша зміна для кластера на HDD: перестати змушувати шпиндель зберігати бухгалтерію Ceph.
BlueStore тримає для кожного OSD три речі: самі дані на block, базу метаданих RocksDB на block.db і журнал попереднього запису на block.wal. За замовчуванням усі три живуть на тому самому пристрої. Постав натомість block.db на NVMe, і величезна частина дрібного випадкового I/O повністю покидає диск.
Документація Ceph щодо заліза каже це прямо: «HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD.»
Тут став справжній корпоративний NVMe, а не споживчий флеш. Причина не в рекламних цифрах бенчмарків. Вона в стабільній затримці під тривалим навантаженням і в захисті від втрати живлення. Документація Ceph говорить прямо: «Enterprise-class SSDs are best for Ceph: they feature power loss protection (PLP)», і «bargain client-class or off-brand SSDs are a false economy.»
Сюди пасують диски класу Samsung PM9A3 і Micron 7450 Pro. Під тиском записів Ceph значно більше дбає про сталість, ніж про пікові цифри, і саме це відрізняє корпоративний диск від швидкого споживчого.
Розмір block.db і чого коштує spillover
Помилися з розміром, і користь тихо випарується, бо коли block.db заповнюється, RocksDB не падає: вона переливається назад на повільний пристрій, рівно туди, де була б і без NVMe.
Це найгірше з обох світів: флеш ти купив, а пошук на шпинделі лишився.
Поточні рекомендації Ceph:
| Навантаження | block.db як частка block |
|---|---|
| RBD / блочне, диски VM | від 1 % до 2 % |
| RGW / об’єктне | щонайменше 4 % |
| Загальна рекомендація при винесенні WAL+DB | щонайменше 2,5 % |
Зберігання VM у Proxmox це рядок RBD, тож 1–2 % це чесна цифра для планування, а 2,5 % комфортне місце, де можна зупинитися.
Порахуй це для диска на 20 TB, і числа привернуть твою увагу:
block.db для одного OSD на 20 TB | |
|---|---|
| При 1 % | 200 GB |
| При 2 % | 400 GB |
| При 2,5 % | 500 GB |
Врахуй кроки рівнів RocksDB нижче, і 300 GB на OSD виявляються розумною точкою приземлення. Корисний крок, найближчий до середини діапазону.
І це змінює те, чим насправді є спільний пристрій метаданих. Вісім OSD на 20 TB хочуть між собою 2,4 TB NVMe; п’ятнадцять, заявлений Ceph максимум за одним NVMe, хочуть 4,5 TB. На таких великих дисках саме місткість DB вирішує, скільки OSD сидить за одним пристроєм, а не співвідношення. Гігабайти в тебе скінчаться задовго до того, як скінчиться благословення Ceph.
Є ще одна тонкість, яку варто знати, бо через неї інтуїтивний розрахунок розміру помиляється. Рівнева структура RocksDB означає, що розділ DB може повністю використати лише розміри, які відповідають сумам її рівнів; історично це давало корисні кроки близько 3 GB, 30 GB і 300 GB, а розміри між ними нічого не дають понад нижчий крок. Округлити 18 GB вгору до 30 GB на практиці часто нічого не коштує; округлення вниз до 20 GB у найгіршому разі не дає нічого понад 3 GB.
Перевіряй spillover після того, як кластер попрацював якийсь час, а не першого дня. Ця проблема наростає повільно.
Окремий пристрій для WAL тобі не потрібен
Це заощаджує розділ і купу возні.
Якщо вказати пристрій DB і не вказати явно пристрій WAL, Ceph автоматично ставить WAL на швидкий пристрій разом із DB. У документації сказано, що «whenever a DB device is specified but an explicit WAL device is not, the WAL will be implicitly colocated with the DB on the faster device.»
Тож «постав DB і WAL на NVMe» це правильна мета, але це один аргумент, а не два. Окремий block.wal має сенс лише тоді, коли в тебе є третій, ще швидший рівень, куди його покласти.
Вимкни кеш запису HDD
Дрібниця, непоказна й легко пропустити.
Документація Ceph зазначає, що продуктивність OSD «may be dramatically increased … by disabling this write cache» на HDD. Енергозалежний кеш у диску переставляє й затримує записи так, що це воює із семантикою скидання Ceph, і його вимкнення зазвичай робить усе швидшим, а не повільнішим.
Із бажаного це стає обов’язковим, щойно з’являється bcache, а це наступний розділ.
Раз уже ти там: HBA з підтримкою RAID тобі не потрібен. Ceph каже це прямо: «You do not need an RoC (RAID-capable) HBA.» Віддай диски OSD.
Один Optane на шпиндель
Винесення метаданих із диска лагодить сталий стан. Сплесків воно не лагодить, бо сплеск дрібних синхронних записів усе одно треба підтвердити, а шпиндель підтверджує зі швидкістю шпинделя.
Для цього й існує bcache, а працює він тут завдяки Optane.
Важить не місткість. Важить поведінка під навантаженням записами. Порівняно з NAND, Optane дає дуже низьку затримку, дуже високу витривалість і жодних обривів через збирання сміття, які роблять продуктивність SSD як кешу запису непередбачуваною, щойно він трохи послужить. Поглинати дрібний, сплесковий, переважно записний трафік це те, що він уміє найкраще у світі.
Компонування, яке важить: один Optane на кожен HDD, кожна пара свій окремий пристрій bcache. Не один Optane на цілу полицю дисків.
Спарювання це свідомий вибір, і воно купує дві речі.
Жодної конкуренції. Кожен шпиндель отримує всю затримку й глибину черги Optane тільки для себе, а не стоїть у черзі за сплесками семи інших OSD.
Домен відмови, який Ceph уже вміє пережити. Спільний кеш запису тримає брудні дані для кожного OSD за ним, тож втрата кешу втрачає їх усіх одразу; при спарюванні один до одного втрата Optane коштує рівно один OSD. Ця відмінність найважливіший наслідок усієї схеми, і вона отримує окремий розгляд у розділі що ти віддаєш натомість.
Це має бути Optane. Не NAND.
Слово «Optane» тут не вподобання бренду й не приємний бонус. Заміна на NAND NVMe, хоч яким дорогим він був би, будує щось, що зношується, і причина у витривалості.
Подивися, де стоїть пристрій кешу. Оскільки ця схема вимикає послідовний обхід bcache, той самий sequential_cutoff=0 у правилі нижче, крізь нього проходить кожен окремий запис до цього OSD: не лише сплески, а все. Це робить кеш пристроєм із найвищим робочим циклом у вузлі, від якого вимагають поглинати обсяг записів цілого диска, що крутиться, протягом усього життя машини.
Витривалість указують у перезаписах диска на день, і різниця тут не поступова:
| Пристрій | Номінальна витривалість |
|---|---|
| Optane P5800X | 100 DWPD |
| Optane P4800X | 30 DWPD |
| Корпоративний NAND для інтенсивного запису, верх лінійки | близько 10 DWPD |
| Корпоративний NAND змішаного використання | 3 DWPD або менше |
| Масовий корпоративний NAND, клас PM9A3, 7450 Pro | близько 1 DWPD |
Optane має від десяти до ста разів більшу витривалість, ніж NAND, який ти інакше туди поставив би. Постав диск на 1 DWPD на ту єдину позицію, яка отримує кожен запис у кластері, і ти збудував не кеш, а витратний матеріал.
Насправді гірше, ніж показує таблиця, бо NAND усередині страждає від підсилення запису, а Optane ні. Номінальний DWPD диска NAND це те, що він приймає на інтерфейсі; те, що насправді поглинають його комірки, більше. Число Optane такої зірочки не потребує.
Перевіряється це під час перебудов. Backfill проганяє терабайти записів крізь уцілілі вузли у стиснуте вікно, кожен байт крізь їхні пристрої кешу: це подія витривалості, а не лише затримки, і вона настає саме тоді, коли тобі найменше хочеться відмови другого пристрою.
Тож два рівні флешу хочуть різних дисків, з різних причин:
| Рівень | Обсяг записів | Що потрібно пристрою |
|---|---|---|
| DB/WAL | невеликий, лише RocksDB | Швидкий корпоративний NVMe. Низька затримка, високі випадкові IOPS, PLP. Корпоративний NAND це правильна технологія; PM9A3 або 7450 Pro це правильна покупка |
| Кеш запису | усе | PLP і витривалість у десятки DWPD. NAND це неправильна технологія за будь-яку ціну |
Купити один тип диска для обох завдань це саме та помилка, від якої цей розділ має вберегти, але не читай перший рядок як дозвіл на економію, бо малий обсяг записів не означає малих вимог.
Пристрій DB/WAL усе одно має бути справді швидким NVMe, з трьох причин, які не мають нічого спільного з кількістю байтів, що крізь нього проходять.
Він обслуговує кожен OSD за ним одночасно, тож черга, яку він бачить, це чотири чи п’ятнадцять наборів трафіку метаданих, а не порція одного диска.
Його затримка лягає прямо на твоїх клієнтів. Пошуки в RocksDB стоять на критичному шляху для знаходження об’єктів, для peering і для scrub, і це дрібні випадкові читання. Саме те навантаження, де розрив між швидким NVMe і посереднім найширший. Кожна мікросекунда множиться на кожен OSD, що від нього залежить.
І компактування сплескове. RocksDB періодично переписує свої рівні, перетворюючи рівномірне оновлення на зосереджений пік читань і записів. Пристрій, що впорається із середнім і застрягне на піку, зупинить кожен OSD за ним в ту саму мить.
Власні співвідношення Ceph усе видають. Вона дозволяє втричі більше OSD за NVMe, ніж за SATA SSD, і це говорять інтерфейс і клас пристрою, а не місткість. Бери NVMe.
Отже: пристрій кешу мусить бути Optane, пристрій DB/WAL може бути NAND, і на жодній із цих позицій не економлять.
Який Optane: часто вистачило б M10 на 32 GB
Ніщо з цього не означає, що найбільший Optane і є правильним. Потрібний тобі пристрій визначає твоє навантаження записами, хоча, як виявляється, вторинний ринок може вирішити це за тебе в будь-якому разі. Арифметика все одно важить, бо показує, що ти купуєш понад міру чи недостатньо.
Почни з того, для чого кеш. Він тримає сплеск, а не диск. При writeback_percent=40 пристрій на 32 GB дає приблизно 13 GB брудного буфера, а це величезна кількість дрібних синхронних записів.
Тож не лякайся співвідношення. Модуль на 32 GB перед диском на 20 TB це 0,16 % від нього, що звучить абсурдно, доки не згадаєш, що це поглинач сплесків, а не кеш робочого набору, який намагається тримати гарячі дані. Пристрій на 375 GB перед тим самим диском це 1,9 %, тобто просто більше запасу, ніж ти використаєш.
І це вводить у гру дешевий край діапазону. Ось маленький споживчий модуль проти частини для дата-центру, бо розрив не там, де люди його чекають:
| Optane Memory M10 32 GB | Optane DC P4800X 375 GB | |
|---|---|---|
| Випадкове читання, 4K | 240 000 IOPS | 550 000 IOPS |
| Випадковий запис, 4K | 65 000 IOPS | порівнянно з читанням |
| Послідовне читання | 1200 MB/s | 2400 MB/s |
| Послідовний запис | 290 MB/s | 2000 MB/s |
| Типова затримка | н/д | менше 10 µs |
| Витривалість | 365 TBW | 12,3 PBW, 30 DWPD |
| Інтерфейс | PCIe 3.0 x2, M.2 2280 | PCIe 3.0 x4, U.2 або AIC |
Спершу подивися на рядок IOPS запису. Маленький M10 робить 65 000 випадкових записів на секунду; шпиндель за ним робить 80. Навіть найдешевший Optane приблизно в 650 разів швидший за диск, який він кешує, тож за віссю продуктивності суперечка закінчена ще до початку. Додатковим IOPS частини DC нікуди подітися, коли нижче по ланцюжку стоїть один диск на 7,2k.
Рядок, що вирішує покупку, це витривалість, де розрив 34×. У перерахунку на щоденний бюджет за п’ять років служби:
| Пристрій | Сталий обсяг записів на день, за п’ять років |
|---|---|
| M10 32 GB, 365 TBW | близько 200 GB/день |
| P4800X 375 GB, 12,3 PBW | близько 6,7 TB/день |
Менше 200 GB записів на день, і M10 на 32 GB доживе до кінця збірки. Удвічі більше, і ти отримаєш два з половиною роки. Справді інтенсивний запис, і частина DC відпрацює свою ціну: не за IOPS, які ти не можеш використати, а за приблизно в тридцять разів більше записів, які вона витримує.
Тож вимірюй, а не вгадуй. nvme smart-log на наявному пристрої кешу дає тобі data_units_written; зніми значення з інтервалом у тиждень, поділи й порівняй із номінальним TBW того, що розглядаєш. bcache тримає власні підсумки в /sys/block/bcacheN/bcache/stats_total/, якщо тобі зручніше читати їх там.
Два застереження щодо M10. Його випадкові цифри вказані для проміжку 8 GB, а не для всього пристрою, тож на кеші, який ти збираєшся тримати значною мірою заповненим, сприймай їх як оптимістичну межу. І це споживча частина без жодної корпоративної заяви про PLP. Носій Optane записується на місці, без буфера DRAM на шляху запису, через що ці модулі поводяться при раптовій втраті живлення значно краще, ніж поводився б споживчий NAND, але «на практиці поводиться добре» це не специфікація. Якщо хочеш гарантію на папері, купи частину серії DC.
Нижня межа це пропускна здатність, а не місткість: оминай модулі на 16 GB
Є друге обмеження, незалежне від усього вище, і воно дискваліфікує найдешевшу частину лінійки.
Кеш мусить бути швидшим за диск у послідовному режимі, інакше він дросель. M10 на 16 GB таким не є, і саме він тебе найбільше спокушатиме, бо коштує майже нічого:
| Послідовний запис | |
|---|---|
| Optane Memory M10 16 GB | 150 MB/s |
| Optane Memory M10 32 GB | 290 MB/s |
| Optane DC P4800X 375 GB | 2000 MB/s |
| Корпоративний HDD на 7,2k | 150–250 MB/s |
Читай перший і останній рядки разом. Модуль на 16 GB пише послідовно приблизно з тією ж швидкістю, що й диск, який він має прискорювати, і повільніше за добрий диск. Для випадкової роботи він лишається неймовірно швидшим, 35 000 IOPS випадкового запису проти 80 у диска, але на послідовному потоці він у кращому разі нічого не дає, а в гіршому стає стелею нижче того, що голий диск робив самотужки.
І ця схема гарантує, що ти в цю стелю впрешся, бо вимкнення послідовного обходу відправляє все крізь кеш, і власна пропускна здатність послідовного запису кешу стає жорсткою стелею для всього OSD. Найболючіше це б’є під час відновлення: backfill OSD на 20 TB майже настільки послідовний, наскільки взагалі буває це навантаження, і обмеження його до 150 MB/s робить і без того повільну перебудову ще повільнішою.
Тож лінійка M10 має нижню межу на 32 GB, і це межа пропускної здатності, а не місткості. Арифметика місткості казала, що 32 GB більш ніж досить; арифметика пропускної здатності виключає 16 GB, хоч як мало тобі треба було зберігати. Обидва тести мають пройти, і дешева частина провалює той, який люди не перевіряють.
Хоч що ти розглядаєш, постав його цифру послідовного запису поряд із 250 MB/s, перш ніж купувати.
Купівля продукту, якого більше ніхто не виробляє
Optane знято з виробництва. Intel згорнула цей бізнес у 2022 році, списавши запаси на 559 мільйонів доларів і припинивши розробку. Нового виробництва немає, поповнень немає; загальна пропозиція відтепер лише зменшується.
Звідси очевидне питання, бо продається його напрочуд багато. Розуміння того, звідки він береться, підказує, що саме ти купуєш.
Це розпродаж складських запасів сервісних запчастин OEM. Велика трійка виробників серверів запасалася Optane як запчастинами для підтримки платформ, у яких його продавала. Ці платформи дійшли кінця життя й випали з підтримки, тож запчастини для них за ніч стали мертвим запасом: склади деталей для машин, які ніхто більше не зобов’язаний за контрактом ремонтувати. Саме ці запаси й течуть на AliExpress і до відновлювачів.
Два наслідки, і обидва добрі новини.
Багато з цього не використовувалося, а не знято з машин. Сервісні запчастини стояли на полиці, чекаючи відмови, яка так і не сталася, тож показник зносу при отриманні часто фактично нульовий: не «кілька років легкої служби», а ні разу не записаний. Перевіряй, а не довіряй: nvme smart-log дає тобі percentage_used і data_units_written, і на справжніх запасах запчастин ці значення мають бути разюче низькими. Усе, що показує реальний знос, це знятий із машини диск, який продають як щось інше, хоча навіть тоді запас витривалості означає, що вживаний Optane може мати більше життя, ніж новенький диск NAND тієї ж місткості.
Це пояснює, які місткості ти знайдеш. Запчастини OEM запасали для серверів, а отже це частини для дата-центрів. Ось уся лінійка, і зверни увагу, звідки починається флагман:
| Частина | Місткості | Форм-фактор |
|---|---|---|
| Optane Memory M10 | 16, 32, 64 GB | M.2 2280, споживчий |
| Optane SSD 800P | 58, 118 GB | M.2 2280, споживчий |
| Optane SSD P1600X | 58, 118 GB | M.2 2280, частина для завантаження й кешу в дата-центрі |
| Optane SSD DC P4801X | 100, 200, 375 GB | M.2 110 mm або U.2 |
| Optane SSD DC P4800X | 375 GB як найменший, 750 GB, 1,5 TB | U.2 або карта розширення |
| Optane SSD P5800X | 400 GB, 800 GB, 1,6 TB | U.2 або карта розширення |
Теоретично маленькі частини M.2 це елегантна відповідь: M10, 800P, P1600X і P4801X на 100 GB усі роблять цю роботу, і дешево. На практиці на ринку їх немає, бо ніхто не складував настільні модулі-прискорювачі як серверні запчастини. Виставлено те, що від 375 GB і вище, залізо класу P4800X.
Тож плануй купувати більше місткості, ніж потрібно для цієї ролі, бо саме це продається. Це не поганий результат. Купивши пристрій кешу з запасом, ти отримуєш 30 DWPD і затримку менше 10 µs, коли твоєму навантаженню треба було лише частку того й того, а для шпинделя на 20 TB, який ти збираєшся тримати роками, це правильний бік, у який помилятися. Це означає, що вхідна ціна вища, ніж підказує арифметика, і що розрахунок розміру вище стає перевіркою від недокупівлі, а не списком покупок.
Три речі, які варто спланувати, бо це розпродаж, а не ланцюжок постачання:
Купуй запасні разом зі збіркою. Скінченний запас розпродається. Коли пристрій відмовить через три роки, ти не замовлятимеш заміну, ти на неї полюватимеш, тож заклади запасні в кошторис зараз, поки запас є.
Чекай на прошивку OEM і перевір простір імен. Частини з програми запчастин постачальника часто несуть прошивку цього постачальника й можуть прийти відформатованими під розмір LBA або з налаштуваннями метаданих під те, для чого їх запасали. Перевір через nvme id-ns, перш ніж будувати на них, і будь готовий зробити nvme format на звичайний 4096-байтовий формат.
Ні гарантії, ні підтримки, ні нових оновлень прошивки. Власне повідомлення Intel про підтримку описує, що згортання означає для пристроїв, які вже в експлуатації, а саме в такому становищі вже перебуває все, що ти купуєш. Перевірити, що частина, яка приїхала, це та сама частина з оголошення, мусиш ти сам.
bcache не замінює винесення DB/WAL
Варто сказати прямо, бо це очевидне місце, де хочеться заощадити, і це не працює: тобі все одно потрібен block.db на NVMe. Обидва шари, а не один чи інший.
Optane це кеш запису. І все. Він скорочує шлях підтвердження для записів, що йдуть на диск, і більше нічого не робить.
RocksDB не лише пише. Ceph постійно читає свої метадані, щоб знаходити об’єкти, обслуговувати peering, відповідати на scrub, а кеш запису не дає читанню рівно нічого, щойно дані з нього скинуто. Не прибирає кеш і трафіку метаданих; він відкладає й групує його, тож кожне оновлення RocksDB рано чи пізно все одно приходить на шпиндель, змагаючись за ті самі пошуки. А компактування перетворює помірне оновлення на значно більший трафік пристрою, ніж записи, що його спричинили.
Тож дві зміни лагодять різні проблеми, і жодна не підміняє іншу:
| Що лагодить | Чого не лагодить | |
|---|---|---|
block.db на NVMe | метадані живуть на флеші, і читання, і записи назавжди зі шпинделя | нічого для сплеску гостьових записів |
| Optane через bcache | затримка підтвердження сплесків для записів даних | нічого для читань метаданих; лише відкладає записи метаданих |
Пропусти винесення DB і залиш Optane, і RocksDB знову на пластині, а її читання обслуговуються на 80 IOPS. Пропусти Optane і залиш винесення DB, і сталий стан пристойний, але сплески все одно застрягають на швидкості шпинделя.
Правило udev, рядок за рядком
Параметри bcache живуть у sysfs, а sysfs скидає їх щоразу, коли пристрій реєструється, тобто при кожному завантаженні. Тож їм місце в правилі udev, а не в скрипті, який хтось мусить не забути запустити:
# /etc/udev/rules.d/99-bcache.rules
ACTION=="add|change", SUBSYSTEM=="block", KERNEL=="bcache*", \
  ATTR{bcache/cache_mode}="writeback", \
  ATTR{bcache/sequential_cutoff}="0", \
  ATTR{bcache/congested_read_threshold_us}="0", \
  ATTR{bcache/writeback_rate}="81920", \
  ATTR{bcache/writeback_rate_minimum}="20480", \
  ATTR{bcache/writeback_percent}="40"
KERNEL=="bcache*" збігається з кожним пристроєм bcache на вузлі, тож одне правило покриває всі пари. ACTION=="add|change" означає, що воно застосовується знову щоразу, коли пристрій з’являється або під’єднується повторно, а не лише при завантаженні.
Що робить кожне налаштування і навіщо:
cache_mode=writeback: увесь сенс. У типовому writethrough запис не підтверджується, доки не дійде до HDD, тож кеш нічого не дає для затримки запису. У writeback підтверджує Optane, а шпиндель наздоганяє пізніше.
sequential_cutoff=0: за замовчуванням bcache розпізнає послідовний I/O і пускає його повз кеш, щойно той перевищує 4 MB, виходячи з теорії, що диск під ним і так добре впорається з послідовним. Нуль вимикає цей обхід, тож кешується все. На гіперконвергентному вузлі це правильне рішення: те, що виглядає послідовним для одного пристрою bcache, перестає бути послідовним на пластині, щойно кілька OSD перемішуються, а тобі потрібно, щоб кожен запис підтверджувався зі швидкістю Optane попри все. Але це накладає одне зобов’язання: без обходу власна пропускна здатність послідовного запису пристрою кешу стає стелею для всього OSD, і саме тому модулі на 16 GB дискваліфіковано.
congested_read_threshold_us=0: bcache стежить за затримкою власного пристрою кешу й починає обходити кеш, коли вважає його перевантаженим, із типовим значенням 2000 µs для читань. Optane не перевантажується так, як NAND, тож тут bcache сумнівається в пристрої, який неправильно виміряв. Нуль вимикає це стеження.
writeback_rate=81920 і writeback_rate_minimum=20480: швидкість фонового скидання, у секторах на секунду, тобто приблизно 40 MB/s цільових із нижньою межею 10 MB/s. PD-регулятор рухає фактичну швидкість між ними. Ціль поставлено біля того, що шпиндель може поглинути послідовно, а нижня межа не дає регулятору придушити скидання майже до нуля й дозволити брудним даним накопичуватися без кінця. Обидва це відправні точки, а не константи; як їх змінити, описано нижче.
writeback_percent=40: скільки кешу bcache дозволить тримати брудним, перш ніж почне жорстко пригальмовувати, проти типових 10. Сорок дає тобі значно глибший буфер для сплесків. Це також означає, що до 40 % цього Optane тримає єдину копію даних у системі, і це компроміс, а також причина, з якої компонування «один на шпиндель» важить. Це значення найбільше варто переглянути, коли ти поспостерігаєш за реальним навантаженням.
Як змінити значення заповнення й скидання пізніше
40 % і дві швидкості вище це значення, які працюють тут, а не універсальні константи. Це перше, що ти захочеш посунути, коли поспостерігаєш за реальним навантаженням, тож варто знати, що є два місця, де їх змінюють, і вони роблять дві різні речі.
sysfs змінює зараз. Правило udev змінює з наступного завантаження. Потрібне і те, і те, і саме в такому порядку.
Зміни наживо, на одному пристрої:
echo 30 > /sys/block/bcache0/bcache/writeback_percent
Або на всіх парах вузла:
for d in /sys/block/bcache*/bcache; do
  echo 30 > "$d/writeback_percent"
done
Швидкість скидання працює так само. Обидва значення в секторах на секунду, тож ці команди вдвічі зменшують ціль і нижню межу:
for d in /sys/block/bcache*/bcache; do
  echo 40960 > "$d/writeback_rate"
  echo 10240 > "$d/writeback_rate_minimum"
done
Це діє негайно й живе рівно до повторної реєстрації пристрою. Документація ядра прямо каже, що ці налаштування «do not persist across reboot», і саме тому й існує правило udev.
Щойно тебе влаштує значення, відредагуй правило й перезавантаж його без перезавантаження машини:
udevadm control --reload
udevadm trigger --subsystem-match=block --action=change
Тут ACTION=="add|change" і відпрацьовує своє. Тригер надсилає подію change пристроям, які вже присутні, тож правило застосовується до працюючого вузла, а не чекає наступного завантаження. Якби правило збігалося лише з add, ця команда нічого б не зробила.
Потім прочитай значення назад, бо помилка в правилі udev не дає жодного сигналу:
grep . /sys/block/bcache*/bcache/writeback_percent
Як знати, в який бік їх рухати
Не налаштовуй це з перших принципів: bcache показує все потрібне в тому самому каталозі sysfs.
dirty_data це те, за чим стежити: скільки даних зараз лежить у кеші й більше ніде. Документація описує його як «continuously updated unlike the cache set’s version, but may be slightly off», і для цієї мети цього досить. Знімай його протягом звичайного робочого дня й вікна резервного копіювання.
cache_hits, cache_misses і cache_hit_ratio кажуть тобі, чи використовується кеш, із застереженням, що «a partial hit is counted as a miss». bypassed рахує IO, що пройшов повз кеш повністю; із sequential_cutoff=0 це число має бути майже пласким, тож якщо воно росте, щось і далі йде в обхід.
Усі вони є і як накопичені підсумки, і як версії, що згасають за останню добу, годину й п’ять хвилин, тож короткі вікна значно корисніші для виявлення проблеми, ніж показник за весь час.
Далі так:
| Симптом | Параметр | Напрямок |
|---|---|---|
| Сплески застрягають: записи посеред сплеску натрапляють на затримку шпинделя | writeback_percent | вгору, для глибшого буфера |
| На кеші відкрито більше даних, ніж тобі комфортно | writeback_percent | вниз |
dirty_data притиснутий до стелі під час звичайної роботи | writeback_rate | вгору: проблема не в буфері, а в зливі |
| Фонове скидання змагається з гостьовими читаннями на шпинделі | writeback_rate | вниз |
dirty_data повзе вгору днями, а не годинами | writeback_rate_minimum | вгору, щоб регулятор не міг придушити все до повзання |
Якщо dirty_data притиснутий до стелі хоч що ти роби, відповідь не в жодному з параметрів: кластер пише швидше, ніж шпинделі можуть поглинути, і чесні рішення це більше шпинделів або менше записів.
Один файл краще не чіпати: writeback_running. Його вимкнення повністю зупиняє writeback, а документація каже, що він «only meant for benchmarking». На робочому OSD це означає, що брудні дані накопичуються, доки кеш не заповниться, і ніколи не зливаються.
Що ти віддаєш натомість
Більшість описів цієї схеми зупиняються на добрих новинах. Ось частини, які справді тобі зашкодять, і кожну з них варто знати до збірки, а не після.
Втрата будь-якого з флеш-пристроїв знищує OSD. Не зупиняє, а знищує. Обидва пристрої тримають стан, якого більше ніде немає: block.db тримає RocksDB, яка надає сенсу block, а кеш writeback тримає кожен ще не скинутий запис. Документація ядра щодо другого не вагається: «In writeback mode you’ll lose data if something happens to your SSD.» Так чи інакше OSD не повертається, його створюють заново й заповнюють через backfill.
Тож це той самий клас ризику, і варто ясно це розуміти, а не вважати страшним саме кеш. Optane не небезпечніший пристрій, ніж NVMe. Їх розділяють дві речі, і жодна з них не тяжкість для окремого OSD.
Перша це радіус ураження, і саме вона повністю виправдовує спарювання. Один Optane на шпиндель означає, що відмова кешу коштує один OSD: втрату одного диска, тобто рівно ту подію, яку реплікований пул існує, щоб поглинути, і з якою Ceph справляється, нікого не будячи вночі. Пристрій DB/WAL спільний, тож його втрата коштує одразу кожен OSD за ним, а це корельована відмова, від якої реплікація тебе не захищає. Та сама відмова, один пристрій проти п’яти.
Друга це те, як відмова себе проявляє, і це операційна пастка. Коли кеш помирає в режимі writeback, пристрій під ним зупиняється й повертає помилки I/O, і це нормально: Ceph позначає OSD як down і працює далі. Поганий випадок це перезавантаження, після якого пристрій під кешем піднімається без під’єднаного кешу. Тоді він виглядає як файлова система, яку можна змонтувати, просто без кожного брудного запису, тобто пошкоджена, а не лише застаріла. Відсутній block.db падає гучно, і OSD відмовляється стартувати; відсутній кеш може впасти тихо й дати тобі змонтувати уламки. Вважай пристрій під bcache таким, що його не можна монтувати без кешу, і ніколи не дозволяй нічому люб’язно змонтувати його за тебе.
bcache сам по собі не гарантує безпечного щодо живлення writeback. Ось де кеш запису HDD перестає бути оптимізацією й стає вимогою: вимкни його й працюй на достатньо свіжому ядрі з обробкою FUA, щоб синхронні записи шанувалися крізь увесь стек, а не підтверджувалися завчасно десь посередині. Пристрій кешу без захисту від втрати живлення погіршує проблему, бо може втратити дані, які вже оголосив збереженими.
І тому число, яке важить, це співвідношення DB/WAL. Ceph дозволяє 4–5 HDD OSD на SATA SSD і не більше 15 на NVMe та застерігає щодо «balancing the risk of reducing costs by placing too many responsibilities into too few failure domains.» На відміну від рівня кешу, тут немає спарювання, яке це стримало б: спільне використання і є сенсом цього пристрою.
На дисках по 20 TB у цьому вся розмова, бо перебудова величезна. Один OSD, що відмовив, це 20 TB для backfill; при 150–250 MB/s, які витримує шпиндель, із пригальмовуванням, щоб відновлення не морило голодом гостей, ти дивишся на понад добу деградованої роботи через один диск. Втрать спільний пристрій DB, що несе п’ять таких, і переносити доведеться 100 TB.
Тож співвідношення насправді не рішення про витрати. Це рішення про те, як довго ти готовий працювати в деградованому стані і скільки трафіку перебудови кластер може нести, водночас обслуговуючи VM.
Схема залежить від пристрою, якого більше ніхто не виробляє. Це той пункт, на який немає технічної відповіді. Optane це правильна частина для позиції кешу, і ніщо сучасне його не замінює: NAND не витримує обсягу записів, а пам’ять на основі CXL, на яку переключилася Intel, не підставляється замість блочного кешу. Тож пом’якшення тут комерційне, а не хитре, воно описане вище, а чесний підсумок такий, що ця архітектура має дату закінчення десь у майбутньому.
Ніщо з цього не робить кластер на HDD повністю флешевим. Тривалий випадковий трафік запису, що випереджає швидкість скидання, заповнить кеш, і щойно той заповниться, ти пишеш зі швидкістю шпинделя з додатковими шарами на шляху. Ця схема поглинає сплески й прибирає накладні витрати метаданих. Вона не виробляє IOPS.
Що з цього виходить
Три рівні, кожен робить ту одну річ, яка йому вдається найкраще, і всі три обов’язкові:
- Optane поглинає сплески випадкових записів, один пристрій на шпиндель. Це має бути Optane, бо кожен запис проходить крізь нього, а витривалість NAND для цієї позиції не годиться
- Швидкий корпоративний NVMe тримає RocksDB і WAL, спільний для кількох OSD у співвідношенні, яке ти обрав свідомо, а не прийняв як є
- HDD дають основну місткість, звільнені і від метаданих, і від сплесків
Сенс не в тому, щоб удавати, ніби диски, що крутяться, це флеш. Сенс у тому, щоб перестати надсилати їм роботу, яка їм вдається найгірше, щоб місткість, за яку ти насправді заплатив, була придатною.
Ось і весь фокус, і нічого хитрого в ньому нема. Постав кожну роботу на пристрій, якому вона вдається, і перестань двічі платити за ті, яким не вдається.
Для гіперконвергентного кластера Proxmox, якому потрібна багатотерабайтна місткість без цін повністю флешевого рішення, це схема, яку можна обстояти. Зібрана як слід, вона здається значно швидшою за голі HDD, відмовляє так, як Ceph уміє обробляти, і гроші йдуть туди, де вони змінюють результат.
Дві пов’язані речі, які варто прочитати поряд: робота з розміром сектора в 4Kn, 512e і 512n дуже важить для того, що шпинделі роблять із записами, які до них доходять, а якщо ти будуєш це на вузлах із прямим підключенням, безкомутаторна сітка описує мережевий бік невеликого кластера Ceph.
Джерела
- Ceph — Hardware Recommendations — застереження про IOPS на TB для великих HDD, «HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD», співвідношення 4–5 HDD на SATA SSD і ≤15 на NVMe, захист від втрати живлення в корпоративних SSD, вимкнення кешу запису HDD і те, що HBA з RoC не потрібен
- Ceph — BlueStore Configuration Reference —
block.dbна рівні 1–2 % відblockдля RBD і щонайменше 4 % для RGW, загальна рекомендація 2,5 %, spillover назад на основний пристрій, розміри рівнів RocksDB за кроками 3/30/300 GB і WAL, що неявно розміщується разом із DB - Linux kernel — bcache admin guide — режими кешу,
sequential_cutoffі його типові 4 MB, типові 2000 µs для перевантаження читань,writeback_rateу секторах на секунду, PD-регуляторwriteback_percent, лічильникиdirty_data/cache_hit_ratio/bypassedта їхні версії, що згасають за добу, годину й п’ять хвилин, застереження, щоwriteback_running«only meant for benchmarking», твердження, що ці налаштування «do not persist across reboot», і «in writeback mode you’ll lose data if something happens to your SSD» - Intel — Optane Memory M10 32 GB specifications — 365 TBW, 240 000 IOPS випадкового читання й 65 000 IOPS випадкового запису при 4K на проміжку 8 GB, 1200/290 MB/s послідовно, PCIe 3.0 x2
- Intel — Optane Memory M10 16 GB specifications — 150 MB/s послідовного запису й 35 000 IOPS випадкового запису, через які ця частина за послідовною пропускною здатністю нижча за диск, що крутиться
- PC Perspective — Optane SSD DC P4800X performance — 550K IOPS випадкового читання 4K у частини на 375 GB, 2400/2000 MB/s послідовно, типова затримка менше 10 µs і 12,3 PBW при 30 DWPD
- ServeTheHome — Optane DC P4801X 100GB M.2 review — маленькі частини M.2 для дата-центрів, для драбини місткостей
- StorageReview — Intel Optane SSD P5800X — рейтинг 100 DWPD, 30 DWPD у P4800X і порівняння з корпоративними дисками NAND, що сягають близько 10 DWPD для частин інтенсивного запису й 3 або менше для змішаного використання
- Bcache — ArchWiki — практичні режими відмов, зокрема пристрій під кешем, що після перезавантаження піднімається без кешу, і вимоги безпеки щодо живлення навколо кешу запису HDD і FUA
- Intel — Optane business update — згортання і що воно означає для гарантії й підтримки пристроїв, які вже в експлуатації, а саме в такому становищі вже перебуває все, що ти купуєш на ринку вторинної переробки