Три способи, якими диск може себе показати
Диск має два розміри блоку, і різниця між ними це вся історія.
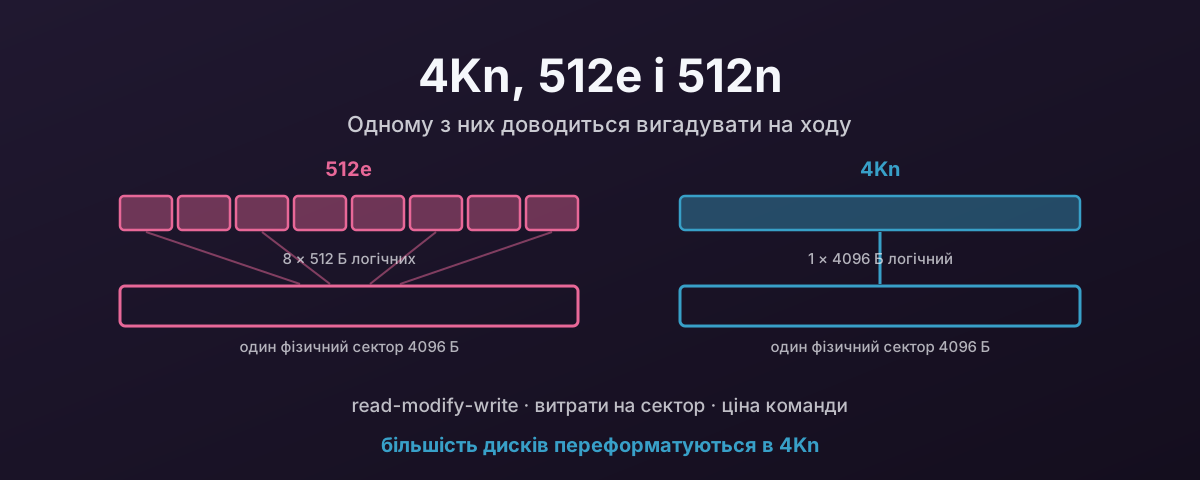
Фізичний сектор це те, з чим насправді працює носій: найменша одиниця, яку диск може прочитати чи записати без додаткової роботи. Логічний блок це те, у чому, як диск каже хосту, він працює: одиниця, якою адресується хост.
У природі трапляються три комбінації.
512n: нативні 512. Обидва розміри по 512 байтів. Це старий світ: жорсткі диски до 2010 року, і нічого такого, що ти купив би новим сьогодні в будь-якому розмірі, вартому уваги.
512e: емуляція 512 байтів. Фізичний сектор має 4096 байтів, але диск повідомляє про 512-байтові логічні блоки і перекладає у прошивці. Це існує з однієї причини: сумісність з операційними системами, завантажувачами і застосунками, які вважали, що 512 буде завжди. Як інженерне рішення досить розумно, і корінь майже всіх проблем, що йдуть далі.
4Kn: нативні 4K. Обидва розміри по 4096 байтів. Диск каже правду, хост адресує його в одиницях, якими користується носій, і між ними немає жодного шару трансляції.
Що робить 512e на кожному невирівняному записі
Читання дешеве в усіх трьох випадках. Диск читає сектор 4K і віддає той 512-байтовий шматок, який ти просив.
Записи це те місце, де вигадка стає дорогою.
Якщо хост записує один 512-байтовий логічний блок, диск не може записати 512 байтів. У носія немає такої одиниці. Тож замість цього він робить ось що:
- Читає весь 4096-байтовий фізичний сектор.
- Вливає в нього 512 байтів нових даних.
- Записує весь 4096-байтовий сектор назад.
Це read-modify-write (читання, зміна, запис), і він перетворює один малий запис на читання плюс запис. На диску, що обертається, це означає чекати, поки пластина знову зробить оберт. Повний оберт на 7200 об/хв це десь 8 мс, яких ти не закладав у бюджет. На флеш-пам’яті ціна інша за своєю природою, і вона не зникає, коли запис завершується. Про це окремий розділ нижче.
Невирівнювання це та версія, що кусає найболючіше. Якщо розділ починається з непарного 512-байтового зсуву, класичний приклад це стара угода про 63 сектори, то кожен 4K-запис файлової системи перетинає два фізичні сектори. Це не один read-modify-write, а два, на кожен окремий запис, назавжди, поки хтось не переробить розділи на диску.
Підсилення запису на флеш-пам’яті
На жорсткому диску read-modify-write коштує тобі оберт, і на цьому все. На флеш-пам’яті він коштує тобі ресурсу диска, і цей рахунок ти оплачуєш раз і платиш далі.
Підсилення запису це відношення того, що насправді записано в NAND, до того, що хост просив записати. Відношення 1,0 означало б, що диск записав рівно те, що йому дали. Воно ніколи не буває 1,0, бо флеш не може перезаписувати на місці: диск програмує свіжу сторінку, позначає стару як застарілу, а збирання сміття пізніше переносить уцілілі сторінки, щоб цілий блок можна було стерти. Ці перенесення теж записи.
512e додає поверх цього шар, якого можна уникнути, і причина це деталь, яку варто сказати чітко: шар трансляції диска відображає одиницями близько 4 КБ, хоч який логічний розмір блоку він оголошує. Диск, що повідомляє про 512-байтові блоки, усередині все одно веде облік одиницями по 4 КБ.
Тож 512-байтовий запис від хоста всередині диска стає таким: прочитати 4-КБ одиницю відображення, влити 512 байтів, запрограмувати нову 4-КБ одиницю. 4096 байтів доходять до NAND, щоб змінилися 512 байтів. Вісім разів більше запису, для цього запису.
Невирівнювання менш драматичне на один запис і гірше загалом. 4-КБ запис, що перетинає дві одиниці відображення, забруднює обидві, тож програмується 8 КБ заради 4 КБ даних. Це 2× підсилення на кожен окремий запис, постійно, поки таблицю розділів не виправлять.
Саме наслідки роблять це важливим, а не просто неохайним:
- Більше записів у NAND означає, що збирання сміття запускається частіше, а його перенесення самі є підсиленням.
- SLC-кеш запису заповнюється швидше, тож диск раніше скочується до свого повільнішого сталого режиму, і стала пропускна здатність запису падає.
- Цикли програмування/стирання витрачаються пропорційно тому, що дійшло до NAND, а не тому, що надіслав хост. Подвой підсилення, і ти вдвічі скоротив життя диска за того самого навантаження.
- Рейтинги витривалості, TBW і DWPD, наводять щодо записів хоста. Підсилення тихо з’їдає цей запас, і диск зношується раніше, ніж обіцяла арифметика гарантії, яку ти робив під час купівлі.
Прямі та синхронні записи це найгірший випадок
Здебільшого кеш сторінок усе це ховає. Ядро накопичує малі записи, об’єднує їх і віддає диску IO розміром 4 КБ або більше, тож read-modify-write ніколи не трапляється.
Два прапорці прибирають цей захист, і застосунки, яким важлива надійність збереження, ставлять обидва.
O_DIRECT обходить кеш сторінок.
Тепер між застосунком і диском немає нічого, що могло б об’єднати 512-байтовий запис у щось розміром із сектор.
O_SYNC або O_DSYNC вимагає, щоб запис був на стабільному носії, перш ніж виклик поверне керування.
Це не дає диску прийняти запис у нестійкий буфер і пізніше поєднати його із сусідами.
Склади їх разом, і кожен 512-байтовий запис стає повним циклом read-modify-write, який має завершитися зараз, сам по собі, без нічого, на що його можна розкласти. Саме тут підсилення на диску 512e наближається до свого теоретичного 8×, і це точно той шаблон, який дає журнал комітів бази даних, ZIL у ZFS чи WAL у Ceph BlueStore.
На корпоративному обладнанні це рятує захист від втрати живлення. Диск із PLP може підтвердити синхронний запис, щойно той опинився в DRAM-буфері з резервом від конденсаторів, а це надійно, і все одно об’єднувати записи всередині перед програмуванням NAND. Споживчий диск без PLP мусить дійти до флеш-пам’яті, перш ніж може відповісти, тож платить повну ціну за кожен запис. Ще одна причина, чому PLP не опція для такого навантаження.
У Proxmox режим кешу вирішує, що з цього ти отримаєш:
cache=noneцеO_DIRECT: стандартне значення PVE і правильний вибір для all-flash HA. Кеш сторінок хоста поза шляхом, тож шаблони запису гостя доходять до диска такими, якими гість їх видав.cache=directsyncцеO_DIRECTплюсO_DSYNC: кожен запис синхронний. Це нішеве налаштування для виділених дисків під журнали баз даних, непридатне для загальних навантажень.
На пристрої 512e cache=directsync із гостем, що комітить 512-байтовими записами, це чи не найменш ефективне з доступних налаштувань: жодного об’єднання на хості, жодного об’єднання на диску і read-modify-write на кожен коміт.
А ось частина, яка робить 4Kn структурною річчю, а не просто бажаною.
O_DIRECT вимагає, щоб зсув, довжина і буфер були вирівняні за логічним розміром блоку диска.
На диску 512e це 512 байтів, тож 512-байтовий прямий запис дозволений, і диск тихо за нього платить.
На 4Kn логічний блок має 4096, тож найменший прямий запис, який прийме ядро, і є 4 КБ.
Патологічний шаблон перестає бути чимось, чого треба уникати, і стає чимось, чого стек не може виразити.
Накладні витрати на носії
Друга ціна структурна, і саме через неї взагалі існує Advanced Format.
Сектор це не лише його дані. На жорсткому диску кожен несе синхромітку, щоб голівка знала, де сектор починається, проміжок, щоб сусідні сектори не налазили один на одного, адресний маркер і поле ECC для виправлення помилок читання.
З 512-байтовими секторами ти платиш усе це вісім разів на кожні 4K даних. З одним сектором 4K ти платиш раз.
Це має два наслідки, і другий важить більше за перший:
- Частина пластини, що була накладними витратами, стає корисною ємністю. Це була заявлена мотивація галузі під час переходу на Advanced Format, у межах кількох відсотків.
- Поле ECC може бути значно більшим за тих самих загальних накладних витрат. Один сильний код, що захищає 4096 байтів, виправляє набагато більше, ніж вісім слабких кодів, що захищають по 512 байтів. Коли поверхнева щільність росла, це перестало бути приємною дрібницею і стало єдиним способом тримати частоту помилок прийнятною.
У флеш-пам’яті немає синхроміток чи проміжків на оберт, але та сама логіка діє рівнем вище: NAND програмується сторінками, сторінки значно більші за 512 байтів, а таблиці відображення диска мають запис на кожну адресовану одиницю. Менші логічні блоки означають більше метаданих для обліку тієї самої ємності.
Накладні витрати в хості: команди і переривання
Третю ціну люди пропускають, бо вона взагалі не на диску.
Логічний розмір блоку задає нижню межу того, наскільки малим може бути IO. На диску з 512-байтовим логічним блоком файлова система чи застосунок можуть видати 512-байтовий запис, і кожен такий запис це повний IO: зібрана й надіслана команда, запис у doorbell, елемент у черзі завершень і переривання, що повідомляє про завершення.
Кожне з цього має фіксовану ціну, якій байдуже, скільки даних було задіяно. Перенеси 4 КБ вісьмома 512-байтовими командами, і заплатиш цю ціну вісім разів. Перенеси однією командою 4K, і заплатиш раз.
Два чесні уточнення, бо саме тут аргумент зазвичай перебільшують.
Для великого IO логічний розмір блоку нічого не змінює в кількості команд. Одна команда може описати багато блоків, тож послідовний запис 1 МБ це одна команда, хоч блоки 512 байтів, хоч 4K. Економія реальна лише там, де видається малий IO.
Але там, де малий IO таки видається, ефект зовсім не тонкий: кожен із цих восьми запитів ядро мусить зібрати, запланувати і завершити, кожен зі своїм перериванням MSI-X і переходом із простору користувача в ядро, і на великій глибині черги саме так виникає шторм переривань. Усередині VM ще гірше, бо кожне з цих переривань також перемикання контексту гостя.
А сучасні контролери NVMe об’єднують переривання, тож кількість переривань не дорівнює просто кількості команд. Проте робота з надсилання і завершення на кожну команду лишається, і на кількох сотнях тисяч IOPS ціна CPU на команду становить помітну частку ядра. Це та сама арифметика, що й у posted interrupts у серії про passthrough: малі фіксовані ціни, помножені на дуже велике число.
4Kn, метадані сектора і апаратний RAID
Перехід на формат 4096 + 0 має наслідок, що застає людей зненацька, і він падає просто на апаратний RAID.
Деякі RAID-контролери і масиви зберігання взагалі не використовують звичайних секторів по 512 чи 4096 байтів. Вони форматують диски в розширений розмір, 520 чи 528 байтів, або 4K-відповідники на кшталт 4104, 4160 і 4224, бо ці додаткові байти на сектор і є місцем, де контролер тримає власні метадані. Це інформація захисту T10-PI/DIF або дані цілісності від постачальника, що зберігаються поряд із самими даними, які вони описують.
У формату 4096 + 0 для цього немає місця. Сектор від початку до кінця це дані, і в цьому весь сенс його вибору.
Тож контролер, якому потрібні вбудовані метадані, має три варіанти, і жоден не безкоштовний:
- Відмовитися від диска.
- Переформатувати його назад у розширений формат, скасувавши щойно зроблену роботу з 4Kn.
- Тримати свої метадані десь в іншому місці диска.
Третій варіант це те, де флеш-пам’ять тебе карає. Метадані, записані окремо від даних, які вони описують, це другий запис, за іншим зсувом, що лягає в іншу одиницю відображення. Ще одна сторінка NAND, запрограмована на кожну, яку ти справді хотів записати. Це підсилення з розділу вище, свідомо повернене, щоб нести метадані цілісності, які диск міг би тримати вбудованими задарма, якби ти залишив його в розширеному форматі.
Мати обидва не вийде. Або сектор несе метадані контролера, або він несе лише твої дані.
Ось чому флеш-пам’ять добряче підірвала аргументи на користь апаратного RAID
Решта цього розділу це судження, а не механізм, тож сприймай його саме так.
Апаратний RAID-контролер це програмний RAID у прошивці, що працює на виділеному процесорі. «Апаратне» тут це CPU, трохи DRAM і батарея. Не якийсь принципово інший спосіб рахувати парність. Історично він давав тобі кеш запису з батарейним живленням і винесення обчислення парності, і на флеш-пам’яті обидва аргументи сильно ослабли. Корпоративний NVMe уже має власний кеш, захищений від втрати живлення, а контролер стає стелею пропускної здатності перед пристроями, кожен з яких може наситити кілька гігабайтів на секунду.
Він також забирає в тебе речі, яких ти тепер активно хочеш:
- Стан пристрою зникає. Подробиці SMART, індикатори зносу і журнали постачальника, з яких можна порахувати підсилення запису, ховаються за непрозорою абстракцією.
- Жодних наскрізних контрольних сум. Контролер перевіряє парність, а вона виявляє відсутній диск, а не хибну відповідь від наявного. ZFS і Ceph рахують контрольні суми самих даних і можуть сказати, яка копія хибна: тихе пошкодження, яке контролер пропускає наскрізь. Тож контролер розв’язує не ту задачу.
- Метадані постачальника на дисках прив’язують масив до родини контролерів, а це своя різновидність ненадійності, коли відмовляє саме контролер.
- RAID із парністю робить власний read-modify-write на записах часткової смуги, нашаровуючись поверх усього з розділів вище.
Для Ceph це навіть не питання вподобань. Власні настанови Proxmox щодо гіперконвергентних систем кажуть, що диски мають бути подані в режимі HBA або pass-through, а не за RAID-контролером, і ZFS хоче рівно того самого з тих самих причин.
Тож схема, що випливає з усього цього: HBA замість RAID-контролера, диски у форматі 4Kn з нульовими метаданими, і надлишковість плюс контрольні суми на боці ZFS або Ceph, які справді можуть сказати тобі, коли диск збрехав. Якщо щось у твоєму господарстві справді потребує розширеного формату сектора, це свідомий вибір «або-або», який треба вирішити, поки диски ще порожні. А не те, що виявляєш після того, як OSD уже збудовано.
Де 512e справді кусає
Було б нечесно стверджувати, що 512e руйнує сучасну систему, бо зазвичай це не так.
Поточний стек Linux читає фізичний розмір сектора, вирівнює за ним розділи (parted і sfdisk тепер обидва роблять це за замовчуванням) і використовує 4K-блоки файлової системи.
У такій конфігурації хост видає вирівняний 4K IO розміром 4K, диску ніколи не потрібен read-modify-write, і 512e коштує тобі майже нічого.
Проблеми конкретні:
- Невирівняні розділи, зазвичай успадковані від старого встановлення чи клонованого образу. Два read-modify-write на кожен запис.
- ZFS з
ashift=9на диску 512e, бо ZFS повірила в повідомлені 512. Кожен запис record стає read-modify-write, аashiftзмінити постфактум не можна: пул доведеться перебудувати. - Застосунки, що пишуть 512-байтові записи з O_DIRECT, в обхід об’єднання в кеші сторінок. Так роблять деякі бази даних і чимало замовного ПЗ.
- Усе, що довіряє логічному розміру як справжньому. У цьому і є справжня шкода емуляції: вона роздає число, яке хибне, і все нижче за течією ухвалює рішення на його основі.
4Kn прибирає всю цю категорію. Диск не може збрехати про розмір сектора, якого в нього немає.
Варто, втім, чесно сказати про розмір виграшу. Власні настанови Seagate кажуть, що за 4Kn явно варто гнатися, коли стек повністю оптимізовано під 4K і ти рахуєш кожен IOPS, скажімо, налаштований all-flash рівень. Нижче цього, на правильно вирівняному сучасному Linux, різниця в продуктивності для вирівняного IO часто мала. Інший аргумент це однорідність парку: в однорідно 4Kn господарстві немає сюрпризів зі змішаними форматами, і нікому не треба пам’ятати, які диски брешуть.
Більшість дисків можна конвертувати, якщо дозволяє постачальник
Ось що пропускають: 512e часто це налаштування формату, а не властивість обладнання. Дуже багато корпоративних дисків SAS і SATA, і більшість корпоративних NVMe, постачаються з повідомленим розміром 512 байтів і охоче переформатуються в 4Kn.
Усе наведене нижче знищує кожен байт на пристрої. Перетворення на місці не існує.
NVMe: nvme-cli
Спершу подивися, що підтримує простір імен:
# Lists each LBA format and marks which one is in use
nvme id-ns -H /dev/nvme0n1 | grep -i "lbaf\|data size"
Тобі потрібен формат із Data Size 4096 і Metadata Size 0, позначений як найкращий (Best) і зараз не використовуваний. Тоді застосуй його:
# -l/--lbaf selects the LBA format index from the list above
nvme format /dev/nvme0n1 --lbaf=1 --force
Розмір метаданих важить стільки ж, скільки розмір даних. Деякі заводські формати резервують додаткові байти на сектор, 520 або 4160, щоб нести наскрізні метадані захисту T10-PI/DIF. Якщо ніщо у твоєму стеку їх не використовує, це заповнювач на кожному секторі, тож обери формат із нульовими метаданими і позбудься його. Випадково обраний формат із метаданими також дасть тобі диск, що поводиться не так, як той, який ти хотів створити, а поєднання зміни розміру сектора зі зміною PI може змусити робити повільне повне форматування замість швидкого.
Для всіх дисків хоста запусти цикл. Йому потрібен shopt -s extglob для розширених шаблонів, і він обирає лише формати 4096/0, що не використовуються:
shopt -s extglob

for dev in /dev/nvme+([0-9])n+([0-9]); do
    # Skip anything that is not actually there
    [ -e "$dev" ] || continue

    # An LBA format with 4096-byte data, 0-byte metadata, marked Best, not in use
    lbaf=$(nvme id-ns -H "$dev" \
        | grep -P '(?=.*Metadata Size: 0)(?=.*Data Size: 4096)(?=.*Best)(?!.*in use)' \
        | awk '{found=$3} END {print (found != "" ? found : -1)}')

    if [ "$lbaf" != "-1" ]; then
        echo "Formatting $dev using LBA Format: $lbaf"
        nvme format --force --lbaf="$lbaf" "$dev"
    else
        echo "Skipping $dev: no matching LBA format found."
    fi
done
Дві речі в ньому роблять більше роботи, ніж здається.
Шаблон збігається з просторами імен, nvme0n1, nvme12n3, і навмисно не збігається з розділами на кшталт nvme0n1p1, бо шаблон закінчується після цифр, що йдуть за n. Це різниця між переформатуванням простору імен і чимось непоправним для працюючої системи.
А вибір завжди конвертує лише той диск, який справді пропонує те, що ти просив. Усе інше падає до -1 і пропускається, і це покриває три окремі випадки:
- Диск пропонує лише 512. Формату на 4096 байтів немає, тож конвертувати нема на що, і цикл залишає його в спокої. Він не пробує і не падає на півдорозі.
- Диск уже 4Kn. Формат 4096/0 і є тим, що використовується, а
(?!.*in use)його виключає, тож другий прогін на тому самому хості нічого не робить. Жодного зайвого переформатування кожного диска. - Єдині формати 4096 несуть метадані. Формат 4096 + 8 не задовольняє
Metadata Size: 0, тож цикл не підсуне тобі тихенько диск із T10-PI, якого ти не просив.
Іншими словами, він відмовляє в безпечний бік. Коли не впевнений, пропускає.
Одна примітка щодо переносності: ці lookahead потребують режиму -P (PCRE) у GNU grep. На системі, де grep щось інше, шаблон ні з чим не збігається, і кожен диск пропускається. Дратує, але принаймні помиляється в безпечний бік.
Усе одно прочитай цикл, перш ніж запускати.
Там, де він таки знаходить збіг, він переформатовує без додаткових запитань. nvme format --force двічі не питає.
Йому місце в підготовці машин, на машині, чиї диски нічого не тримають, і ніколи на хості з живим OSD, пулом чи диском VM.
На FreeBSD відповідник це nvmecontrol, де -f це індекс формату:
nvmecontrol format -f 1 nvme0ns1
SAS і SATA: openSeaChest
openSeaChest від Seagate кросплатформний, з відкритим кодом і працює також із дисками інших постачальників.
# Find the handle
openSeaChest_Format --scan

# Ask the drive which sector sizes it will accept
openSeaChest_Format -d /dev/sg1 --showSupportedFormats

# Convert. The confirmation string is deliberately hard to type by accident.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
Ця фраза підтвердження не мій драматизм. Це буквальний рядок, якого вимагає інструмент, і частина «may render the drive inoperable» цілком реальна. Низькорівневе форматування, перерване вимкненням живлення, може залишити диск, якому потрібне ще одне форматування, перш ніж він узагалі запрацює.
Під капотом операція відрізняється залежно від транспорту: SAS і SCSI використовують Format Unit, SATA використовує Set Sector Configuration Ext, шлях швидкого форматування, а NVMe використовує NVM Format. Для диска SAS можна викликати Format Unit напряму, і зверни увагу, що ця опція бере коротший рядок підтвердження:
openSeaChest_Format -d /dev/sg1 --formatUnit 4096 --poll \
    --confirm this-will-erase-data
Дві різні опції, два різні рядки підтвердження: переплутаєш їх, і інструмент відмовиться.
Там, де диск підтримує швидке форматування, розмір сектора змінюється за секунди, а не за години; диск потім виконує свою роботу з цілісності та фонову роботу, і запис твоїх справжніх даних на нього скорочує цей фоновий час. Повне форматування пише нулі від початку до кінця і на великому диску, що обертається, може тривати від багатьох годин до кількох днів.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 --fastFormat \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
SCSI: sg_format
Для всього, що розмовляє SCSI, ту саму роботу зробить sg3_utils:
# --size requires --format; expect hours on a large spinning disk
sg_format --format --size=4096 /dev/sdb

# Fast format where the drive supports it — seconds instead of hours
sg_format --format --size=4096 --ffmt=1 /dev/sdb
sg_format дає тобі 15-секундний зворотний відлік, перш ніж почати, і --quick його пропускає.
Його документація також попереджає про конкретну відмову, про яку варто знати: якщо зміна розміру блоку вдалася, а форматування потім не вдалося, диск може опинитися в стані «format corrupt», і для відновлення потрібне ще одне форматування.
Перш ніж щось конвертувати
- Перевір шлях завантаження. Диск 4Kn як завантажувальний пристрій потребує UEFI і ОС, яка це підтримує. Сучасний Linux у порядку. Старіший Windows ні, а деякі апаратні RAID-контролери досі взагалі відмовляються від 4Kn.
- Зроби це, поки диск нічого не тримає. Переробка постфактум означає: евакуювати, конвертувати, відновити.
- Зроби один, потім перевір. Конвертуй один диск, підтверди повідомлені розміри, потім роби решту.
- Розраховуй на години на диску, що обертається, без швидкого форматування. Не запускай низькорівневе форматування на машині, яка скоро тобі знову потрібна.
Перевірка того, що в тебе є
# LOG-SEC is what the host addresses, PHY-SEC is what the medium uses
lsblk -o NAME,MODEL,SIZE,LOG-SEC,PHY-SEC

# The same, from sysfs
cat /sys/block/sda/queue/logical_block_size
cat /sys/block/sda/queue/physical_block_size

# SMART states both, and this is the clearest 512e signature there is
smartctl -a /dev/sda | grep -i "sector size"
512 bytes logical, 4096 bytes physical це диск 512e.
Однакові числа означають нативний формат: 512n, якщо обидва 512, 4Kn, якщо обидва 4096.
І перевір, що розділи справді вирівняні:
parted /dev/sda align-check optimal 1
ZFS, Ceph і віртуальні диски
ZFS: явно задавай ashift=12 під час створення пулу і не покладайся на повідомлений диском розмір, бо на 512e він скаже тобі 9 і помилиться. Змінити це пізніше не можна.
Ceph: мінімальний розмір виділення BlueStore на флеш-пам’яті має бути 4 КБ. Сучасний Ceph за замовчуванням ставить 4096, але старіші збірки за замовчуванням ставили більше, близько 16 КБ на SSD і 64 КБ на HDD, а це погано пасує дискам VM на RBD, бо вони видають багато малих випадкових записів по 4 КБ, і 4-КБ запис, що лягає в одиницю виділення 16 або 64 КБ, і підсилює запис, і марнує решту на заповнювач. Це фіксується під час створення OSD, тож задати треба до створення чи перебудови:
ceph config set global bluestore_min_alloc_size_ssd 4096 # new or rebuilt OSDs only
Є відповідний bluestore_min_alloc_size_hdd. Наявні OSD зберігають те, з чим їх збудували, тож зміна означає їх перебудову.
Віртуальні диски: гість бачить те, що показує гіпервізор, а не диск під ним, тож диск 4Kn під VM усе одно віддає гостю 512-байтові блоки, якщо ти не скажеш інакше. Тримати стек у 4K від початку до кінця означає сказати QEMU показувати 4K, а в Proxmox це рядок сирих аргументів у /etc/pve/qemu-server/<vmid>.conf:
args: -global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096
Саме цей рядок справді змушує QEMU працювати в 4Kn для цих дисків: -global застосовує його до кожного пристрою scsi-hd на VM, тож гостю кажуть 4096 і для логічного, і для фізичного розміру блоку, і він розбиває та вирівнює відповідно.
Не бери весь рядок у лапки. Proxmox розбирає args: через Text::ParseWords::shellwords, тож ось це:
args: "-global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096"
зливається в один аргумент: лапки враховуються й прибираються, і QEMU отримує одну довгу опцію, яку неможливо розібрати, замість чотирьох. Без лапок той самий рядок розпадається на -global, scsi-hd.physical_block_size=4k, -global, scsi-hd.logical_block_size=4096, а це те, що тобі потрібно. Цю помилку легко зробити, бо взяти в лапки це правильний інстинкт у командному рядку, а відмова, VM, що не стартує і скаржиться на опцію, не вказує назад на лапки.
Зроби це до встановлення гостьової ОС. Зміна розміру блоку диска під уже встановленою системою може зробити її незавантажуваною, бо розмітку розділів і завантажувач записано під 512-байтові сектори. Зверни також увагу, що args: це запасний вихід для експертів поза керуванням GUI, і взаємодію з живою міграцією та знімками варто перевірити за актуальною документацією Proxmox.
Коли гість каже 512, а хост каже 4K
Це випадок, який варто зрозуміти як слід, бо саме його ти отримуєш за замовчуванням після всієї роботи вище.
QEMU показує гостю 512-байтові логічні блоки, якщо йому не сказати інакше, хоч яким є пристрій під ним. Тож ти можеш конвертувати кожен диск у хості в 4Kn, а VM зверху все одно чутимуть 512, і повірять у це.
Тоді гість розбиває диск на межах по 512 байтів, бо може, і видає 512-байтовий IO, бо може. Але пристрій хоста тепер справді має 4096-байтовий логічний блок, і 512-байтового запису він не прийме. Щось мусить узгодити одне з одним, і це щось хост: QEMU читає навколишні 4 КБ, вливає в них 512 байтів гостя і записує все назад.
Ти не прибрав емуляцію. Ти переніс її з прошивки диска у свій гіпервізор, де вона коштує CPU хоста і буфер перекидання замість циклів диска.
З cache=none це теж не м’який штраф. O_DIRECT щодо пристрою 4Kn вимагає зсувів і довжин, вирівняних по 4 КБ, тож запис гостя менший за 4K не можна просто передати далі: вирівнювання треба виправити в QEMU ще до того, як IO взагалі буде видано.
І випадок із невирівнюванням повертається рівнем вище. Гість, розбитий з гранулярністю 512 байтів, ставить свої 4-КБ записи файлової системи на зсуви, що перетинають два 4-КБ блоки хоста, тож кожен стає двома read-modify-write на хості. Та сама відмова, що й невирівняний розділ на голому диску 512e, тільки тепер вона відбувається всередині VM, де ніхто її не шукає.
Тож правило таке: якщо хост 4Kn, показуй 4K і гостю, і роби це до того, як стане ОС.
Виняток це підтримка в гостях, а саме через неї 512e і існує:
- Гості Linux працюють з 4Kn без жодного клопоту.
- Windows підтримує 4Kn для томів даних починаючи з Windows 8 і Server 2012, а завантаження з 4Kn потребує UEFI.
- Усе старіше, Windows 7 і раніше, взагалі не вміє 4Kn. Для них віртуальний диск, що показує 512, це ціна їхнього запуску, і узгоджувати буде хост. Якщо це важить, тримай таких гостей на сховищі, де це коштує тобі найменше, а не на найшвидшому рівні.
Перевір, що гість зрештою отримав, зсередини гостя:
lsblk -o NAME,LOG-SEC,PHY-SEC
512 тут на хості 4Kn означає, що описане вище узгодження відбувається на кожному невирівняному записі.
Джерела
- OpenZFS — Workload Tuning —
ashift, чому2^ashiftце найменший можливий IO на vdev, і зауваження, що «many devices misreport their sector sizes» nvme-formatman page —--lbaf,--namespace-id,--sesі--forcesg_formatman page —--sizeразом із--format, опція швидкого форматування і попередження про стан format-corrupt- openSeaChest — утиліти Seagate для дисків з відкритим кодом, зокрема
--setSectorSizeі--showSupportedFormats - openSeaChest wiki — Format, Fast Format, And Sector Sizes — який транспорт використовує яку команду і коли застосовне швидке форматування
nvmecontrol(8)— відповідник для FreeBSD- Linux block layer documentation — як ядро моделює логічні та фізичні розміри блоків