Відсік, що бере будь-що
Аргумент на користь трирежимного адаптера справді добрий, і його варто як слід викласти, перш ніж розбирати на частини.
Купи шасі з бекплейном U.3 і трирежимним контролером, і кожен відсік для дисків стає універсальним. У слот 0 можна поставити диск SAS 24G, у слот 1 дешевий завантажувальний SATA, у слот 2 SSD NVMe Gen4, а адаптер домовиться з тим, що там опиниться. Broadcom називає цей кремній Tri-Mode SerDes; стандарт відсіку зветься SFF-TA-1001, відомий як U.3, і він визначає спільний роз’єм для SAS x1/x2, SATA та NVMe на x1, x2 або x4. Керування описує SFF-TA-1005, Universal Backplane Management: так корпус з’ясовує, з чим він насправді говорить, і запалює потрібні індикатори активності.
Для того, хто специфікує сервери, це розв’язує справжню й дратівливу проблему. Більше не треба вирішувати протокол сховища на етапі замовлення, тримати два артикули шасі чи раптом з’ясовувати, що відсіки під NVMe це чотири ліворуч, а твої диски пішли в інші двадцять. Один номер деталі покриває весь парк, і господарство на SAS може переходити на NVMe по одному диску, а не по одному шасі.
Нічого з цього не маркетинг. Саме тому ці адаптери й продаються, і вдавати інакше було б безглуздо.
Але гнучкість не безплатна, і рахунок оплачують не фунтами. Його оплачують чергами.
Що насправді відбувається з диском
SSD NVMe це кінцевий пристрій PCIe. У сервері з прямим підключенням його чотири лінії йдуть до кореневого комплексу CPU, через ретаймер чи комутатор PCIe, але електрично й логічно це пристрій на шині PCIe. Ядро його перелічує, прив’язує драйвер nvme, і відтоді драйвер говорить із регістрами диска напряму.
Постав той самий диск за трирежимний адаптер, і це перестає бути правдою.
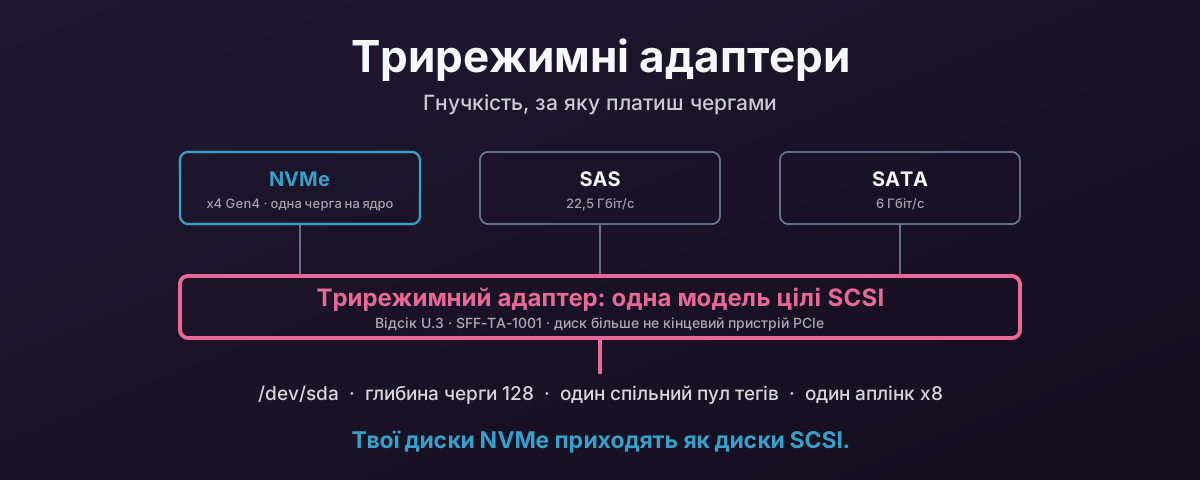
Лінії диска тепер закінчуються на контролері. Документація Broadcom називає відповідний блок PCIe device bridge, і слово «міст» тут робить багато роботи: це не прозорий комутатор, що пересилає транзакції твого CPU до диска, який той ще бачить. Кінцевим пристроєм PCIe, який перелічує твій хост, є адаптер. Диск це ціль, що висить по той бік, і мікропрограма контролера заново породжує кожен запит вводу-виводу.
Тож адаптер не пропускає твої команди NVMe. Він їх закінчує і говорить із диском від твого імені.
Звідси питання: яким протоколом він говорить із тобою?
ОС ніколи не бачить диска NVMe
SCSI.
Встав SSD NVMe у трирежимний HBA від Broadcom, і він з’явиться не як /dev/nvme0n1. Він з’явиться як /dev/sdb, прив’язаний до mpt3sas, того самого драйвера, що вже понад десять років керує контролерами SAS від LSI. nvme list нічого не повертає. lsblk -o NAME,TRAN показує транспорт sas. Для кожного шару стеку сховища вище драйвера ти купив диск SAS.
Це не вада і не обмеження мікропрограми, яке колись виправлять. Це задум. Подати все як ціль SCSI саме і є тим, як один адаптер обслуговує три протоколи: контролер зводить SAS, SATA і NVMe до однієї моделі пристрою, а хост отримує один драйвер, один шлях перелічення, один набір інструментів. Гнучкість у рекламі і подання через SCSI в dmesg є тим самим архітектурним рішенням, на яке дивляться з різних кінців.
Покоління 9500 і 9600 таки додають механізм пропускання, щоб інструменти постачальника могли дістатися до адміністративних команд NVMe диска, і новіші частини Broadcom набагато краще показують стан диска, ніж 9400. Але це бічний канал керування. Шлях даних, кожне читання й запис, що їх видає твоє навантаження, досі йде стеком SCSI.
А стек SCSI має модель черг, старшу за флеш на двадцять років.
Модель черг, від якої ти щойно відмовився
Це та частина, що справді коштує тобі продуктивності, і про неї варто говорити точно, бо причина не в тому, що «NVMe швидший за SAS».
Головне проєктне рішення NVMe було не в швидшому дроті. Воно було в тому, щоб перестати вдавати, ніби пристрій зберігання є однією послідовною річчю.
Специфікація дозволяє до 65 535 пар черг вводу-виводу, і цю цифру наводить кожне пояснення NVMe. Це не те число, за яке варто хапатися. Жоден диск не реалізує нічого близького, тож будь-хто, хто справді дивився на робочу систему, може відмахнутися від порівняння, і матиме рацію. Справжнє число менше, непоказне, і доводить суть краще.
Тож ось справжній диск. Не корпоративний: OEM-SSD SK Hynix на 256 ГБ, з тих, що їх впаюють у ноутбук середнього класу, у 16-ядерній машині.
$ nproc
16
$ cat /sys/class/nvme/nvme0/queue_count
17
$ ls /sys/block/nvme0n1/mq | wc -l
16
$ cat /sys/block/nvme0n1/queue/nr_requests
1023
Сімнадцять черг: одна адміністративна і шістнадцять черг вводу-виводу на шістнадцять ядер. Кожна завглибшки 1023 команди. Відповідність один до одного: кожна апаратна черга прив’язана рівно до одного CPU:
$ cd /sys/block/nvme0n1/mq && grep -H . */cpu_list
0/cpu_list:1
1/cpu_list:9
2/cpu_list:3
3/cpu_list:11
...
Один CPU на чергу, до самого низу: апаратна черга 0 обслуговує ядро 1 і більше нічого.
Ось що на практиці означає «у NVMe багато черг». Не 65 535, а одна на ядро, скільки б ядер у тебе не було. Linux створює пару черг на кожен CPU, аж до того, скільки дасть контролер, а контролери дають набагато більше, ніж є ядер у типовому сервері, тож на практиці число дорівнює кількості ядер. Постав цей диск у 64-ядерну машину, і отримаєш 64.
Саме з цього поділу по ядрах і береться продуктивність:
- Ядро подає запит у власну чергу. Без блокування, бо жодне інше ядро її не торкається.
- Кожна черга має власний вектор MSI-X, прив’язаний до цього ядра.
- Переривання завершення повертається на те ядро, що видало запит, де вже лежать потрібні рядки кешу.
- Усі шістнадцять ядер можуть працювати одночасно, ніколи не змагаючись за спільну структуру.
Паралелізм росте разом із кількістю ядер, і робота жодного ядра ніколи не стоїть у черзі за чужою. Так робить дешевий споживчий диск. Це базовий рівень.
Тепер подивися, що отримує диск за адаптером. Числа нижче не оцінки, а константи в основному драйвері mpt3sas.
Глибину черги на пристрій задає ioc->max_nvme_qd, яку драйвер бере з того, що повідомляє мікропрограма контролера, а інакше відкочується до типового значення часу компіляції в drivers/scsi/mpt3sas/mpt3sas_base.h:
#define MPT3SAS_SATA_QUEUE_DEPTH	32
#define MPT3SAS_SAS_QUEUE_DEPTH		254
#define MPT3SAS_RAID_QUEUE_DEPTH	128
#define MPT3SAS_NVME_QUEUE_DEPTH	128
128. Пристрій, здатний тримати десятки тисяч незавершених команд, отримує глибину черги 128, і зверни увагу: це менше за типові 254 для SAS двома рядками вище. Можливості самого диска в рішенні не беруть участі. Число приходить від контролера.
З кількістю апаратних черг ще гірше, і драйвер цього не приховує. З mpt3sas_scsih.c:
shost->nr_hw_queues = 1;

if (shost->host_tagset) {
	shost->nr_hw_queues =
	    ioc->reply_queue_count - ioc->high_iops_queues;
	...
	dev_info(&ioc->pdev->dev,
	    "Max SCSIIO MPT commands: %d shared with nr_hw_queues = %d\n",
	    shost->can_queue, shost->nr_hw_queues);
}
Прочитай уважно, бо тут відбуваються три окремі речі.
Типово апаратна черга одна. nr_hw_queues = 1. Багато черг буває лише на контролерах gen35 з увімкненою функцією host_tagset, і навіть тоді це те, що власна історія комітів драйвера описує як імітовані численні апаратні черги: обладнання контролера вводу-виводу має одну чергу подання з кількома чергами відповідей, а blk-mq натягують поверх цього.
Кількість черг приходить від контролера, а не від кількості ядер. Це reply_queue_count мінус черги high-IOPS, тобто те, скільки векторів MSI-X виділив адаптер. Вона не має нічого спільного з тим, скільки в тебе CPU, і не росте, коли додаєш диски. Це точна протилежність диска вище, де кількість черг і була кількістю ядер.
І пул тегів спільний. host_tagset означає рівно те, що написано: один пул тегів на весь адаптер хоста, і той рядок журналу прямо каже «shared». Кожен диск на карті бере з того самого набору слотів команд. У шасі на двадцять чотири відсіки двадцять чотири диски змагаються за теги одного контролера.
Постав їх поруч. Той ноутбучний SSD мав шістнадцять приватних черг по 1023, по одній на ядро, і відповідав лише собі. Той самий диск за адаптером отримує частку черг відповідей карти, 128 незавершених команд і двадцять трьох сусідів, що черпають із того самого пулу.
Тож утрата не в тому, що SCSI повільний. Сучасний SCSI на blk-mq у порядку. Утрата структурна:
- Черги належать адаптеру, а не диску. Додаючи диски, ти ділиш фіксований ресурс, а не збільшуєш його.
- Пул тегів спільний на весь хост. Один диск під важким навантаженням може заморити голодом інші так, як це просто неможливо, коли кожен диск має власні черги.
- Глибину на пристрій обмежено 128, хоч би що диск міг витримати.
- Локальність переривань слабшає. Завершення приходять на ту чергу відповідей, яку використав контролер, а не обов’язково на ядро, що подало запит.
За глибини черги 1 чи 2, коли однопотоковий процес час від часу щось читає, нічого з цього не помітно. Ти виміряєш ту саму затримку в обох випадках, у межах шуму. Штраф з’являється саме там, де ти купував NVMe, щоб допомогти: багато ядер видають багато одночасних запитів. Що глибше навантаження, то більша частина диска, за яку ти заплатив, лишається недосяжною.
Аплінк це один слот x8
Модель черг це тонка проблема. Стеля пропускної здатності очевидна, і її можна прочитати у власних описах продуктів Broadcom без жодного бенчмарка.
HBA серії 9500 це карта x8 PCIe Gen 4.0. Опубліковані Broadcom цифри для неї: 13 700 МБ/с на послідовному читанні блоками 256K і 3 млн IOPS на випадковому читанні 4K. Той самий опис каже, що вона підтримує до 32 пристроїв NVMe.
Постав ці два числа поруч, і питання відповідає саме на себе: скільки дисків треба, щоб вичерпати адаптер?
Небагато, і щороку менше. SSD Gen4 x4 дає приблизно 7 ГБ/с. SSD Gen5 x4 приблизно 14. Обидва звичайні деталі у 2026 році: Gen4 заповнює ринок уживаних U.2, а Gen5 ти отримуєш, купуючи нове.
| Стеля | Дисків Gen4, щоб її досягти | Дисків Gen5, щоб її досягти |
|---|---|---|
| HBA 9500: 13 700 МБ/с послідовно | 2 | 1 |
| HBA 9500: 3 млн IOPS (4K RR) | 3 | 1–2 |
| eHBA 9600: 6,4 млн IOPS (4K RR) | ~6 | ~3 |
| MegaRAID 9600: 1,1 млн IOPS RAID 5 (4K RW) | ~1 | ~1 |
Прочитай верхній рядок ще раз. Один SSD Gen5 вичерпує всю послідовну стелю HBA 9500. Один диск, у карті, розрахованій на тридцять два. Усе, що далі, це місткість. Не продуктивність.
А нижній рядок мав би зупинити замовлення: на MegaRAID поточного покоління повна полиця NVMe в RAID 5 дає приблизно стільки, скільки один звичайний диск сам по собі.
Диски навіть не підключаються на x4
Під спільним аплінком є другий обмежувач, його легко проґавити, бо він сидить у таблиці специфікацій, а не в заголовку.
PERC 12 User’s Guide від Dell, що охоплює трирежимні контролери H965i, каже:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3) and 16 GT/s (Gen 4) at maximum x2 lane width.
Кожен диск NVMe отримує дві лінії, а не чотири. Тож ще до будь-якої боротьби за аплінк, до пулу тегів, до трансляції в SCSI диск Gen4 уже опускається приблизно до 3,5 ГБ/с, половини того, що він може. Постав у цей відсік диск Gen5, і він домовиться до Gen4 x2 та дасть приблизно чверть своєї номінальної пропускної здатності.
Варто точно сказати, що це змінює, а що ні. Це не означає, що адаптера вистачає надовше. Щоб заповнити аплінк 9500, треба близько чотирьох дисків, обмежених x2, замість двох, але лише тому, що кожен диск дає вдвічі менше. Вузьке місце переїхало з аплінку вниз, на лінк диска. Загальне, що можна витиснути, не покращилося.
З прямим підключенням ті самі тридцять два диски мали б кожен власний шлях x4 до кореневого комплексу, на тому поколінні, про яке домовляться диск і CPU.
Рядок RAID 5 у тій таблиці заслуговує окремого погляду, бо це власне число Broadcom, і його опубліковано без прикрас. З опису серії 9600:
900K to 1.1M RAID 5 IOPS (4K RW)
RAID з парністю в мікропрограмі контролера це найдорожче, що можна попросити від трирежимної карти, і ось поточне покоління за цією роботою. Варто прочитати, перш ніж хтось специфікує RAID 5 на двадцяти чотирьох дисках NVMe і чекатиме продуктивності двадцяти чотирьох дисків.
А як щодо карти x16?
Очевидне заперечення до всього вище: 9500 це карта x8 Gen4, і стеля є наслідком вузького лінку до хоста. Дай адаптеру шістнадцять ліній Gen5, і проблема зникне.
Заперечення чесне, і воно заслуговує найсильнішого прикладу, а не солом’яного опудала. Тож візьмімо PERC13 H975i від Dell: поточне покоління, і приблизно найкраще, що буває серед трирежимних. Його посібник користувача вказує «Gen 4 and Gen 5 PCIe x16 host interfaces», а StorageReview виміряв 52,5 ГБ/с і 12,5 млн IOPS на контролер, на до шістнадцяти дисків NVMe.
Це серйозні числа, і вони суттєво змінюють картину. Проти 13 700 МБ/с і 3 млн IOPS у 9500 це приблизно вчетверо більша пропускна здатність і вчетверо більше IOPS, розкладені на вдвічі меншу кількість дисків. Dell не просто розширив трубу: вони ще й удвічі зменшили розгалуження, і коефіцієнт перепідписки від цього покращився. Особливо щодо IOPS: 12,5 млн на шістнадцять дисків це близько 780K на диск, що близько до того, що звичайний диск дає сам. На цьому етапі контролер справді не те, що тебе стримує.
Тож віддаймо належне: сучасна трирежимна карта x16 Gen5 набагато кращий інженерний виріб, ніж x8 Gen4, і якщо пропускна здатність була твоїм єдиним запереченням, x16 здебільшого на нього відповідає.
Три речі вона не виправляє.
Диски досі підключаються на x2. Оце мене здивувало. Посібник PERC13, описуючи контролер Gen5 x16, досі каже:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3), 16 GT/s (Gen 4), and 32 GT/s (Gen 5) at maximum x2 lane width.
Ширший лінк до хоста не розширює лінки до дисків нижче. Кожен диск NVMe на найновішому, найшвидшому трирежимному RAID-контролері, який продає Dell, досі підключено двома лініями замість чотирьох, і він досі віддає половину своєї пропускної здатності ще до того, як станеться будь-що інше.
Модель черг зовсім не зачеплено. Ніщо в розділі цього допису про черги не залежить від ширини лінку до хоста. nr_hw_queues береться з виділення черг відповідей MSI-X контролера; глибина 128 на пристрій є константою драйвера й мікропрограми; пул тегів спільний на весь хост, бо так каже host_tagset. Розшир лінк до хоста до x16, x32, до чого завгодно: диски досі є цілями SCSI, що ділять черги карти, досі немає /dev/nvme0n1, і ти досі не можеш віддати диск у ВМ.
І x16 не створює пропускну здатність, він розгалужує лінії, які в тебе вже були. Ось аргумент, що справді все вирішує. Шістнадцять ліній Gen5 у PERC13 дають тобі 52,5 ГБ/с, поділені на шістнадцять відсіків. Ті самі шістнадцять ліній, підключені напряму до чотирьох дисків Gen5 на x4, дають приблизно 56 ГБ/с на чотири відсіки: ту саму пропускну здатність із тих самих ліній, тільки кожен диск отримує повні x4, власну пару черг на ядро і справжній вузол пристрою nvme.
Тож чесно описати трирежимну карту x16 можна не як «швидший адаптер». Це мультиплексор ліній: він перетворює фіксований бюджет ліній на більше відсіків для дисків і бере з тебе за це перетворення модель черг. Чи вигідна ця угода, залежить від одного. Відсіки чи паралелізм.
Що буває, коли заповнюєш усі відсіки
Що приводить нас до випадку, який справді важить, бо ніхто не купує шасі на 24 відсіки, щоб поставити в нього чотири диски.
Після точки насичення сумарна лінія пласка. Додаючи диски, додаєш місткість, і більше нічого, тож продуктивність на диск падає як 1/N. За реалістичної кількості дисків ця арифметика безжальна:
| Дисків на HBA 9500 | Сумарно | На диск | Частка диска Gen4 |
|---|---|---|---|
| 2 | 13,7 ГБ/с | 6,9 ГБ/с | 98 % |
| 12 | 13,7 ГБ/с | 1,14 ГБ/с | 16 % |
| 24 | 13,7 ГБ/с | 0,57 ГБ/с | 8 % |
Подивися на нижній рядок. Двадцять чотири диски NVMe за HBA 9500 дають близько 570 МБ/с кожен. SSD SATA дає близько 550. Ти купив двадцять чотири диски NVMe, заплатив за трирежимний контролер, щоб їх підключити, і прийшов до пропускної здатності на диск класу SATA.
Арифметика IOPS має ту саму форму: 3 млн на двадцять чотири диски це по 125K, проти 1 млн, які звичайний диск Gen4 дає сам, тобто близько восьмої частини того, чим ти володієш.
Карта x16 помітно це покращує, але не рятує. PERC13 з усіма шістнадцятьма дисками дає 52,5 ГБ/с ÷ 16 = 3,3 ГБ/с на диск, або приблизно 23 % диска Gen5, і це ще до того, як лінк x2 знову поділить це навпіл.
Два ефекти за великої кількості дисків гірші, ніж підказує ділення:
- Голодування тегів зачіпає інші пристрої. Спільний пул тегів хоста означає, що один диск під важким навантаженням може забрати слоти, потрібні іншим дискам. Двадцять чотири пристрої, кожному з яких номінально дозволено 128 незавершених команд, разом хочуть 3072, і всі беруть з одного
can_queueконтролера. Блокування на голові черги між окремими дисками є режимом відмови, якого просто не існує, коли кожен диск володіє своїми чергами. - Перебудови б’ють по всьому. Перебудова парності на заповненій полиці насичує єдиний спільний аплінк, тож передній план вводу-виводу до кожного іншого диска на карті деградує водночас. З дисками на незалежних лініях і програмним RAID перебудова змагається за CPU, а не за одну трубу.
Коли нічого з цього не важить
Є важлива противага, і через неї чимало трирежимних серверів на 24 відсіки працюють цілком щасливо.
Стеля адаптера кусає лише тоді, коли щось нижче за течією може спожити більше, ніж він дає. Сервер з 2 × 25GbE має 6,2 ГБ/с мережі: він не заповнить навіть HBA 9500. Якщо ці двадцять чотири диски є шаром місткості, що роздає файли через цей лінк, адаптер і близько не вузьке місце, і арифметика на диск вище не має значення.
Важити це починає тоді, коли споживач стає швидшим за карту: 100GbE (12,5 ГБ/с) сам по собі ставить тебе врівень із усією послідовною стелею 9500, а локальні навантаження (бази даних, компіляція, аналітика, хости віртуалізації із завантаженими гостями) взагалі не мають мережі на шляху.
Тож питання щодо заповненої полиці не «чи повільний адаптер», а «що це споживатиме, і чи може воно спожити більше, ніж дає карта?» Якщо відповідь лінк 25GbE, не хвилюйся. Якщо відповідь 100GbE, NVMe-oF чи локальна база даних, карта є твоїм вузьким місцем, і кількість дисків робить гірше.
Що ще зникає
Крім пропускної здатності, подання диска NVMe як диска SCSI означає, що специфічні для NVMe частини твого інструментарію перестають працювати:
| Пряме підключення | За трирежимним адаптером | |
|---|---|---|
| Вузол пристрою | /dev/nvme0n1 | /dev/sdb |
| Драйвер | nvme | mpt3sas / mpi3mr |
nvme-cli | Працює | Нема з чим говорити |
| Дані про стан | Сторінки журналу NVMe SMART | Трансльовані сторінки журналу SCSI |
| Керування просторами імен | Так | Ні |
| Оновлення мікропрограми | nvme fw-download | Інструмент постачальника через контролер |
| Форматування / очищення | NVMe Format NVM | Відповідники SCSI, якщо реалізовані |
| Апаратні черги | Одна пара на ядро (16 на машині вище) | Черги відповідей карти, спільні для всіх дисків |
| Глибина черги | 1023 на чергу | 128 на пристрій |
Один наслідок підловлює людей досить часто, щоб назвати його окремо: ти не можеш прокинути окремий диск у віртуальну машину. Для passthrough PCIe диск має бути кінцевим пристроєм PCIe з власною групою IOMMU, а за трирежимним адаптером він ним не є: єдиний наявний пристрій PCIe це контролер. Можна прокинути весь адаптер з усіма дисками на ньому, або нічого. Якщо твій план передбачав віддати певні диски NVMe певним гостям, рішення щодо бекплейна вже ухвалило це за тебе.
То кому це справді потрібно у 2026 році?
Ось де аргумент з початку цього допису має зустрітися з важчим питанням, бо світу, під який його задумали, здебільшого вже немає.
Трирежимність задумали тоді, коли NVMe був дорогим шаром, який додавали до господарства на SAS. У 2026 році все навпаки: NVMe є типовим, корпоративних дисків U.2 на вторинному ринку багато і вони дешеві, а «змішані SAS, SATA і NVMe в одному шасі» описує дедалі менше справжніх розгортань. То хто ж це купує?
Здебільшого ніхто, і свідомо. Чесна відповідь така: більшість трирежимних контролерів ніхто не обирав. Вони просто приїхали, бо постачальник сервера ставить такий, а ставить він його тому, що один артикул бекплейна U.3 дає йому продавати конфігурації з SAS, SATA і NVMe з того самого шасі. Це перемога ланцюга постачання для OEM. Для твоєї продуктивності вона не робить нічого, і тому її ніколи так і не продавали.
Три класичні виправдання вже погано тримаються:
«Мені потрібні змішані типи дисків». Рідко в тому самому шасі, і навіть коли так, трирежимність не єдиний шлях. Звичайний SAS HBA для обертових дисків плюс NVMe, підключений до кореневого комплексу, дає тобі обидва, і жоден не штрафується. Змішане господарство не означає змішаного контролера.
«Мені бракує ліній PCIe». Це був справжній аргумент у 2019 році, на 40-лінійних платформах з 24 відсіками. Односокетний Epyc Genoa чи Turin має 128 ліній. Двадцять чотири диски на x4 це 96. Дефіциту, що виправдовував зведення дисків за одним контролером, майже не лишилося, а де він є, комутатор PCIe робить цю роботу без закінчення протоколу.
«Відсіки мають бути універсальними». Цей варто розібрати обережно, бо саме ним найчастіше виправдовують не той компонент. U.3 це стандарт бекплейна, а не вимога до контролера. Бекплейн U.3 можна підключити кабелями прямо до ліній PCIe CPU замість трирежимного контролера, і постачальники документують обидві топології. Можна залишити універсальні відсіки і прибрати податок. Якщо тобі дістався трирежимний сервер, найцінніше, що можна перевірити, це чи можна перекомутувати бекплейн напряму.
Що насправді лишається:
- Апаратний RAID за великої щільності, коли його вимагає політика чи платформа: вимога аудиту, матриця підтримки, розгортання Windows чи ESXi без програмного шару, що зробив би цю роботу. Це справжній ринок, що лишився, це єдиний випадок, коли ти купуєш рушій RAID, а не підключення, і на поточному кремнії це спроможний продукт: шістнадцять дисків NVMe в апаратному RAID 5 з кешем під захистом суперконденсатора, з шістнадцяти ліній, це те, чого пряме підключення взагалі запропонувати не може.
- Великі обсяги на SAS HDD, де £/ТБ досі рішуче за обертовими дисками. Але це робота звичайного SAS HBA, і дешевшого.
- Дуже велика кількість відсіків і зовнішні корпуси, де експандери SAS сягають далі й ширше, ніж PCIe.
- Навантаження, що ніколи не йдуть углиб. Якщо твої глибини черг однозначні, нічого з цього не помітно. Чимало справжніх систем цілком щасливо тут живуть.
Є ще простий експлуатаційний аргумент: один тип корпусу, один драйвер, одна запчастина на полиці, і для хоста віртуалізації загального призначення це чогось справді варте. Тільки оціни це чесно проти того факту, що, згідно з таблицею вище, один диск Gen5 може вичерпати всю послідовну стелю карти.
Коли це не той інструмент
Обмін стає поганим пропорційно тому, скільки паралельності має твоє навантаження.
Ceph найочевидніший випадок. Вузол сховища запускає один OSD на диск, кожен із власними пулами потоків, усі видають запити водночас, а потім клієнти цілого кластера навантажують їх паралельно. Це найгірший випадок для спільного пулу тегів: двадцять чотири демони змагаються за слоти команд одного контролера, кожен диск обмежено 128 незавершеними, усе зведено через один аплінк x8. Постав ці диски прямо на кореневий комплекс, і кожен OSD отримає власні черги, власні теги і власні лінії. У вузла Ceph цілком на NVMe не повинно бути трирежимного адаптера на шляху даних.
Та сама логіка стосується цілей NVMe-oF, де ти переекспортуєш диски і кожен шар серіалізації накопичується; баз даних з глибоким асинхронним вводом-виводом; і всього, що побудовано на io_uring чи SPDK, які існують саме для того, щоб використовувати черги на ядро, які адаптер щойно відібрав.
Загальне правило: що більше паралелізму твоє ПЗ мало використовувати за задумом, то більше бере з тебе за це трирежимний адаптер.
Як дізнатися, що в тебе є
Якщо тобі дістався сервер і ти хочеш знати, по який бік цього ти стоїш:
# What is the transport? "nvme" is direct, "sas" means it went through a controller
lsblk -o NAME,TRAN,MODEL,SIZE

# Is there a tri-mode controller in the machine at all?
lspci -nn | grep -Ei 'sas|megaraid|serial attached'

# Which driver claimed the disk?
ls -l /sys/block/sdb/device/driver

# Per-device queue depth — 128 is the mpt3sas NVMe default
cat /sys/block/sdb/device/queue_depth

# How many hardware queues does this device actually get?
ls /sys/block/sdb/mq/ | wc -l
ls /sys/block/nvme0n1/mq/ | wc -l    # compare against a direct-attached drive

# On a direct-attached drive, what did the controller actually grant?
# One admin queue plus one I/O queue per core, so expect nproc + 1
cat /sys/class/nvme/nvme0/queue_count
nproc

# The driver says it out loud at load time
dmesg | grep -i 'nr_hw_queues'
Остання команда друкує рядок Max SCSIIO MPT commands: N shared with nr_hw_queues = M, процитований раніше. Якщо nvme list порожній на машині, про яку тобі казали, що вона вся на флеші NVMe, причина в адаптері.
Коротко
Трирежимний адаптер перетворює твої диски NVMe на диски SCSI. Це перетворення не побічний ефект. Це те, як одна карта обслуговує три протоколи, і саме це ти купуєш.
Те, від чого ти відмовляєшся, конкретне й вимірюване: пари черг на ядро замінено спільними чергами відповідей контролера, глибина на пристрій 128, пул тегів, поділений між усіма дисками на карті, лінк x2 там, де диск хотів x4, і один спільний аплінк там, де кожен диск раніше мав власний шлях до кореневого комплексу. Адаптер перестає бути з’єднанням і стає вузьким місцем, і на поточному обладнанні стає ним швидко: два диски Gen4 досягають HBA 9500, чотири диски Gen5 досягають навіть PERC13.
Ширший лінк до хоста допомагає (карта x16 Gen5 має приблизно вчетверо більшу пропускну здатність і IOPS, ніж x8 Gen4), але форми не змінює. Він купує відсіки, а не паралелізм: ті самі шістнадцять ліній, підключені прямо до чотирьох дисків, дають ту саму пропускну здатність без жодного податку на черги. І заповнену полицю він не рятує. Двадцять чотири диски за 9500 отримують близько 570 МБ/с кожен, тобто стільки, скільки дає SSD SATA.
У 2019 році, коли NVMe був шаром, який додавали до господарства на SAS, а платформам бракувало ліній, це був розумний обмін. У 2026 році здебільшого ні. NVMe є типовим, уживані диски U.2 дешеві, односокетний Epyc має ліній із запасом, а єдина перевага, що досі стоїть, універсальні відсіки для дисків, належить бекплейну U.3, а не контролеру. Дуже часто можна залишити відсіки і прибрати податок, підключивши бекплейн кабелями прямо до CPU.
Тож купуй трирежимний адаптер, якщо купуєш його рушій RAID і він тобі потрібен. Не купуй його заради гнучкості, а якщо він тобі дістався в шасі, повному NVMe, піди й з’ясуй, як підключено той бекплейн.
Немає сенсу платити двічі за диски, якими потім не можеш як слід користуватися.