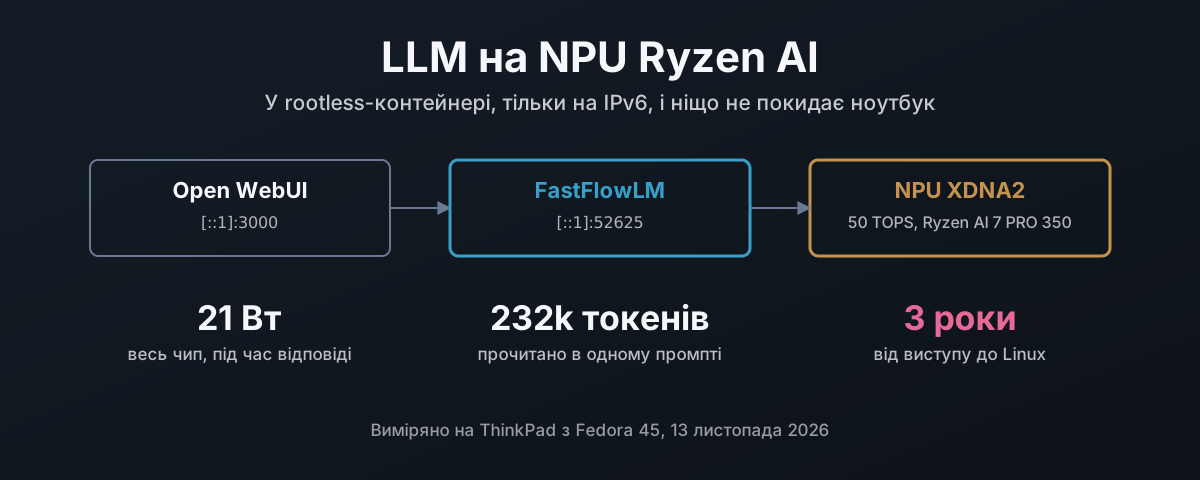
50 TOPS, які нічого не роблять
Кожен ноутбук з Ryzen AI, проданий за останні два роки, має всередині нейропроцесор (Neural Processing Unit, NPU), шматок кремнію, створений ні для чого, крім математики, на якій стоять моделі AI. У моєму, ThinkPad з Ryzen AI 7 PRO 350, AMD оцінює його до 50 TOPS, трильйонів операцій за секунду1. Ти за нього заплатив. На стандартному встановленні Linux він не робить нічого.
Цього року це змінилося. Після налаштування NPU крутить мовну модель на 4 мільярди параметрів за вікном чату, плюс розпізнавання мовлення, усе на ноутбуці, без облікового запису, без підписки і без того, щоб щось покидало машину, а для всього, що ти волів би не вводити на чужому сайті, саме в цьому й суть. Увесь чип споживає близько 21 Вт, поки відповідає, а в простої менше 9 Вт.
| Що працює | Де | Адреса |
|---|---|---|
| Qwen 3.5 4B, контекст 256k токенів | NPU, у контейнері | http://[::1]:52625/v1 |
Розпізнавання мовлення: Whisper від OpenAI, whisper-v3:turbo | NPU, той самий контейнер | та сама, /audio/transcriptions |
| Open WebUI, сторінка чату | CPU, у контейнері | http://[::1]:3000 |
| драйвер ядра amdxdna, мікропрограма | хост | /dev/accel/accel0 |
Збирання визначили два правила. На хост ідуть тільки драйвер ядра та його мікропрограма; кожен фреймворк для моделей працює в rootless-контейнері podman. І кожен сервіс слухає тільки на петлі IPv6, на IPv4 нічого взагалі. Обидва виявилися меншою роботою, ніж робити все абияк, і обидва зловили проблеми, які інакше я б випустив.
Що для цього треба на Linux
NPU в цьому чипі належить до другого покоління AMD, XDNA2. Це важливо, бо програми, що запускають на ньому мовні моделі, підтримують частини з XDNA2 (серії Ryzen AI 300 і 400, Strix Halo), а не перше покоління в Ryzen 7040 і 80402. Перевір свій, перш ніж починати:
$ lspci -nn | grep -i 'neural\|signal processing'
c5:00.1 Signal processing controller [1180]: Advanced Micro Devices, Inc. [AMD] Strix/Krackan/Krackan2/Strix Halo Neural Processing Unit [1022:17f0] (rev 20)
Між цим пристроєм і відповіддю в чаті стоять чотири шари, і поділ між хостом і контейнером і є весь задум:
| Шар | Що це | Де живе |
|---|---|---|
amdxdna | драйвер ядра, створює /dev/accel/accel03 | хост, через DKMS |
| мікропрограма NPU | npu_7.sbin, 1.1.2.64 на цьому чипі | хост, з linux-firmware |
XRT + плагін amdxdna | бібліотека середовища виконання AMD і її бекенд для NPU | контейнер |
| FastFlowLM | середовище виконання LLM, разом з ядрами для NPU | контейнер |
Ядро 7.x постачає amdxdna у дереві, але AMD спершу розробляє його у власному репозиторії, і плагін простору користувача має відповідати модулю ядра, з яким говорить4. Розрив між ними чималий. На цьому ноутбуці:
| У дереві, Fedora 7.2.15 і 7.3.3 | Поза деревом, amd/xdna-driver на 24dfd686 | |
|---|---|---|
| Інтерфейс драйвера | 0.105 | 0.19 |
| Версія модуля | немає | 2.27.0_20261113 |
| PCI ID NPU, які він бере | 6 | 8 |
| Файли мікропрограми, які він просить | 7 | 59 |
| Мікропрограма, яку вантажить цей чип | 17f0_10/npu_7.sbin, 1.1.2.64 | той самий файл |
Дев’ять версій інтерфейсу різниці, і Linux 7.3, найновіший випуск, досі несе 0.10. Єдине, у чому вони згодні, це мікропрограма, і вона приходить з linux-firmware від Fedora, а не з жодного з драйверів. Тож я збираю обидві половини з одного коміту amd/xdna-driver, кладу модуль на хост, а відповідний простір користувача запікаю в образ.
Драйвер: збери все, залиш тільки шматок для ядра
amd/xdna-driver несе XRT як git-підмодуль, і збирання дає RPM для XRT і пакет плагіна. Пакет плагіна також несе вихідний код драйвера, який реєструє в DKMS (Dynamic Kernel Module Support, штука, що перезбирає модуль під кожне нове ядро). Нічого складного:
git clone --recursive https://github.com/amd/xdna-driver.git && cd xdna-driver
sudo ./tools/amdxdna_deps.sh
(cd xrt/build && ./build.sh -npu -opt)    # XRT RPMs in xrt/build/Release/
(cd build && ./build.sh -release)         # plugin RPM, driver source inside
На Fedora 45 скрипт залежностей завершується помилкою. Не зважай:
| Він просить | Що відбувається | Чи важливо? |
|---|---|---|
protobuf-devel | конфліктує з установленим protobuf3-compiler | ні, без нього XRT лише пропускає інструмент трасування |
redhat-lsb | такого пакета немає, Fedora його прибрала | ні |
| усе інше | уже встановлено |
Останній позначений тегом випуск там з лютого, тож main і є каналом випусків. Я перейшов з травневої збірки на листопадову: 550 комітів, XRT з 2.23 до 2.27.
Оновлення видаляє драйвер, який щойно встановило
Моя перша спроба оновлення забрала модуль зовсім. RPM запускає скрипт встановлення нового пакета, який збирає і реєструє новий драйвер у DKMS, а потім запускає скрипт видалення старого пакета. Той скрипт видалення читає версію драйвера з файлу, який новий пакет уже перезаписав, тож скасовує реєстрацію щойно встановленої версії. Вивід dnf каже це двома рядками, один за одним:
>>> Successfully installed and enabled DKMS for xrt-amdxdna/2.27.0
>>> Removing driver source: xrt-amdxdna/2.27.0...
Ніщо не впало, ніщо не почервоніло, і наступне завантаження тихенько підхопило б те, що постачалося з ядром. Можна спитати, чому скрипт видалення запускається під час оновлення, не перевіривши, чи це оновлення? RPM передає цю відповідь кожному скриптлету першим аргументом. Це один if.
Через це ж хост тепер не отримує RPM узагалі. Вихідний код драйвера лежить архівом усередині пакета плагіна, тож я витягаю його і віддаю DKMS напряму:
T=$(mktemp -d) && rpm2cpio xrt_plugin*.rpm | (cd $T && cpio -idm --quiet)
D=$T/opt/xilinx/xrt/share/amdxdna
sudo mkdir -p /usr/src/xrt-amdxdna-2.27.0
sudo tar -xf $D/amdxdna.tar.gz -C /usr/src/xrt-amdxdna-2.27.0
sudo cp $D/dkms.conf $D/configure_kernel.sh /usr/src/xrt-amdxdna-2.27.0/
sudo dkms install xrt-amdxdna/2.27.0
sudo modprobe -r amdxdna; sudo modprobe amdxdna
Без перезавантаження. Це Linux, і на цей момент ніщо не тримає пристрій відкритим, тож модуль міняється наживо. Далі DKMS перезбирає його для кожного ядра, яке встановлює dnf; коли прийшло 7.3.3, модуль був зібраний ще до того, як я в нього перезавантажився.
Перевір, що завантажилася саме збірка DKMS, а не та, що в дереві, і що мікропрограма досить нова. FastFlowLM хоче 1.1.0.0 або новішу2:
$ modinfo -F filename amdxdna
/lib/modules/7.2.15-300.fc45.x86_64/extra/amdxdna.ko.xz
$ cat /sys/bus/pci/drivers/amdxdna/*/fw_version
1.1.2.64
$ journalctl -k | grep 'Initialized amdxdna'
[drm] Initialized amdxdna_accel_driver 0.19.0 for 0000:c5:00.1 on minor 0
DKMS не видаляє власний модуль ядра, а відсуває його вбік, у /var/lib/dkms/xrt-amdxdna/original_module/, тож якщо прибрати збірку DKMS, він повернеться на місце.
І ще одне, чого не чіпай: amd_iommu=off у командному рядку ядра вимикає NPU2.
FastFlowLM у контейнері
FastFlowLM є середовищем виконання, яке робить NPU корисним для мовних моделей. Це командний рядок у стилі Ollama і сервер, сумісний з OpenAI, написаний під XDNA2, і цього року він перейшов в організацію ROCm від AMD6. Саме середовище під ліцензією MIT. Ядра для NPU, які він постачає, закриті бінарні файли, які можна вільно використовувати й поширювати без змін7. Я б волів, щоб вони були відкриті, і кажу це прямо, але вони лежать у репозиторії, і нічого не треба тягнути звідкись іще.
Образ складається з трьох стадій на Fedora 45: XRT зі збирання драйвера, FastFlowLM, скомпільований проти нього, а потім середовище виконання лише з тим, що потрібно. Частина, яка має значення:
FROM registry.fedoraproject.org/fedora:45 AS xrt
ARG XDNA_COMMIT
COPY dist/xdna-${XDNA_COMMIT}/ /rpms/
RUN dnf -y install /rpms/xrt_2*-base.rpm /rpms/xrt_2*-npu.rpm \
 && rpm -i --noscripts --nodeps --nosignature \
        --excludepath=/usr/lib/firmware --excludepath=/opt/xilinx/xrt/share/amdxdna \
        /rpms/xrt_plugin*.rpm \
 && echo /opt/xilinx/xrt/lib64 > /etc/ld.so.conf.d/xrt.conf && ldconfig
Кожен із цих прапорців там тому, що без нього щось ламалося:
| Проблема | Рішення |
|---|---|
| Скрипти плагіна збирають модуль ядра, а йому місце на хості | --noscripts, і вихідний код драйвера та мікропрограма виключені |
| RPM 6 у Fedora 45 за замовчуванням вимагає перевірки підписів8, а самостійно зібраний RPM не підписаний | --nosignature: я його зібрав, я знаю, звідки він |
Бібліотеки XRT лежать у lib64, якого немає в шляху лінкера | /etc/ld.so.conf.d/xrt.conf усередині образу |
FastFlowLM шукає XRT через pkg-config, а setup.sh від XRT не задає шлях | PKG_CONFIG_PATH=/opt/xilinx/xrt/lib64/pkgconfig на стадії збирання |
Готовий образ важить 609 МБ, а його тег несе коміт драйвера, fastflowlm:v1.0.12-xdna24dfd686. Перевірка стану порівнює його з комітом, який повідомляє завантажений модуль, і падає, якщо вони різні. Образ, зібраний не під той драйвер, є єдиною несправністю тут, яку справді важко діагностувати, тож її ловлять раніше, ніж вона туди дійде.
Контейнер отримує один пристрій, NPU, і ліміт блокування пам’яті, потрібний FastFlowLM, щоб закріпити свої буфери:
podman run --rm --device /dev/accel/accel0 --ulimit memlock=-1:-1 \
  localhost/fastflowlm:v1.0.12-xdna24dfd686 validate
[Linux]  NPU: /dev/accel/accel0 with 8 columns
[Linux]  NPU FW Version: 1.1.2.64
[Linux]  Memlock Limit: infinity
Власний самотест AMD, xrt-smi validate, показав для NPU 51 TOPS на множенні матриць. Це ті 50 з коробки, і вони таки є.
Запуск під час старту, тільки на IPv6
Quadlet перетворює короткий файл .container на сервіс systemd9. Як користувацький юніт він працює без root, від мого імені, а з увімкненим lingering стартує під час завантаження, навіть коли ніхто не ввійшов10:
[Unit]
Description=FastFlowLM NPU server
ConditionPathExists=/dev/accel/accel0

[Container]
Image=localhost/fastflowlm:v1.0.12-xdna24dfd686
AddDevice=/dev/accel/accel0
Ulimit=memlock=-1:-1
Network=host
Volume=%h/.config/flm:/models:Z
Exec=serve qwen3.5:4b --host ::1 --port 52625 -c 262144 -a whisper-v3:turbo
StopSignal=SIGINT

[Install]
WantedBy=default.target
loginctl enable-linger $USER
cp fastflowlm.container ~/.config/containers/systemd/
systemctl --user daemon-reload && systemctl --user start fastflowlm
-c 262144 задає вікно контексту, а тест контексту нижче пояснює, чому воно таке велике. -a whisper-v3:turbo завантажує другу модель поруч із моделлю чату, ту, що перетворює мовлення на текст; вона має окремий розділ.
Три рядки там я вивчив на власних ґулях:
| Рядок | Без нього |
|---|---|
StopSignal=SIGINT | FastFlowLM ігнорує SIGTERM, сигнал зупинки podman, і його вбивають через десять секунд |
--host ::1 | він слухає на 127.0.0.1, IPv4 |
::1, а не [::1] | форма в дужках не розбирається; дужкам місце всередині URL |
Доведи адресу, а не вір їй:
$ ss -ltn 'sport = :52625'
LISTEN 0  4096  [::1]:52625  [::]:*
$ curl -s http://127.0.0.1:52625/v1/models || echo refused
refused
localhost і далі працює для всього, що розв’язує його спершу в ::1, а так роблять і /etc/hosts у Fedora, і Chrome.
Що воно вміє, у вимірах
Дев’ять моделей через власний бенчмарк FastFlowLM; декодування означає швидкість, з якою тече відповідь:
| Модель | Декодування, контекст 1k | Декодування, контекст 8k | Читання промпту, 8k |
|---|---|---|---|
llama3.2:1b | 77 ток/с | 56 ток/с | 2009 ток/с |
qwen3.5:2b | 32 | 29 | 1533 |
llama3.2:3b | 30 | 20 | 857 |
phi4-mini-it:4b | 25 | 17 | 744 |
qwen3:4b | 23 | 15 | 613 |
qwen3.5:4b | 17 | 15 | 657 |
gemma4-it:e4b | 14 | 12 | 642 |
qwen3:8b | 13 | 10 | 418 |
qwen3.5:9b | 11 | 10 | 451 |
Людина читає зі швидкістю п’ять-вісім токенів за секунду, тож кожна з них іде попереду тебе. Декодування приблизно падає вдвічі щоразу, коли модель подвоюється, а саме цього й чекаєш, коли межу ставить пропускна здатність пам’яті, а не обчислення. Я запускаю qwen3.5:4b. Phi-4 mini швидша, але Qwen 3.5 тримає швидкість, коли розмова росте, працює із зображеннями і викликами інструментів і має кеш промптів, який рятує від перечитування всієї історії на кожному ході. Це й вирішує.
256 000 токенів контексту
Qwen 3.5 зроблено під вікно на 262 144 токени11, а FastFlowLM за замовчуванням ставить 32 768. За цією межею він робить дещо, про що варто знати: пише в журнал Max length reached, stopping prefilling і закриває з’єднання без відповіді і без помилки, тож вікно чату стоїть з порожньою відповіддю, а ти гадаєш, що впало: модель, сервер чи браузер.
Тож я підняв його через -c 262144 і перевірив як слід. Код, захований у першому рядку промпту на 232 250 токенів, це приблизно 175 000 слів, і запит на нього в самому кінці:
| Контекст 8k | Контекст 232k | |
|---|---|---|
| Відповідь | правильна | правильна, AMBER-FALCON-7731 |
| Читання промпту | 657 ток/с | 210 ток/с |
| Очікування першого слова | 12 секунд | 18,4 хвилини |
| Декодування | 15 ток/с | 2,4 ток/с |
| Зарезервована пам’ять | ~5 ГБ | ~12,7 ГБ |
Працює. Повільно. І пам’ять резервується, користуєшся ти вікном чи ні. Маючи в машині 90 ГБ, я заплачу цю ціну, щоб довга вставка отримала відповідь, а не тихо зникла.
Чи може допомогти GPU?
У тому самому чипі є Radeon 860M, тож очевидне питання: чи може вона взяти частину навантаження. Розділити одну модель між NPU і GPU, читаючи промпт на одному і пишучи відповідь на іншому, сьогодні не вміє жодне середовище на Linux. А от запустити друге середовище на GPU можна, тож я це виміряв.
«Ефективно» тут означає швидкість і енергію разом. Драйвер amdgpu без root показує потужність пакета для всього чипа, а драйвер amdxdna окремо показує NPU, тож кожен запуск нижче знімався чотири рази на секунду. Скрізь та сама модель у 4 бітах.
З тих середовищ для GPU, які я дивився, запрацювало одне:
| Середовище | Результат на 860M |
|---|---|
| llama.cpp, бекенд Vulkan12 | працює; образ 881 МБ |
| llama.cpp, бекенд ROCm | бачить GPU, потім падає з segfault на першій же роботі, з підміною версії GPU чи без неї; образ 23 ГБ |
| MLC-LLM, Vulkan13 | його компілятор падає з segfault, збираючи архітектуру Qwen 3.5 |
| vLLM, SGLang | не пробував: створені для GPU в дата-центрах і багатьох користувачів, а не для вбудованої GPU на 8 блоків |
І NPU проти того, що запрацювало:
| Qwen 3.5 4B | NPU, FastFlowLM | GPU, llama.cpp Vulkan |
|---|---|---|
| Простій, модель завантажена | 8,6 Вт | 16,0 Вт, проти 9,7 Вт, коли зупинено |
| Читання промпту, ~6k токенів | 557 ток/с при 23,8 Вт | 411 ток/с при 46,1 Вт |
| Енергія на токен промпту | 0,043 Дж | 0,112 Дж |
| Декодування | 18,2 ток/с при 21,0 Вт | 23,5 ток/с при 40,7 Вт |
| Енергія на згенерований токен | 1,16 Дж | 1,73 Дж |
GPU пише відповіді приблизно на 29 % швидше. І палить на це вдвічі більше потужності. NPU читає промпти швидше і менш ніж за половину енергії. Більше число видно в простої: сервер на GPU, завантажений і бездіяльний, коштує 6,3 Вт понад ту саму машину, де він зупинений, і так цілий день. Запуск обох одночасно опустив NPU з 18,2 до 14,2 токена за секунду, а GPU з 23,5 до 13,9, бо вони ділять ту саму пам’ять. Тож контейнер для GPU існує, але я запускаю його, коли мені потрібна друга модель, і під час старту він не вмикається.
Сам NPU в кожному запуску брав менше 2 Вт. Більшість із тих 21 Вт забирають CPU і пам’ять, що його годують. Ось стеля, за якою варто стежити в майбутніх випусках FastFlowLM.
Розпізнавання мовлення теж на NPU
Whisper є моделлю розпізнавання мовлення від OpenAI: на вході звук, на виході текст, 99 мов, і випущена під ліцензією MIT, тож працює будь-де, нікого не питаючи14. Large-v3 є поточною повнорозмірною версією. Turbo є тією самою моделлю, у якої декодер, половину, що виписує текст, урізано з 32 шарів до 4. Картка моделі описує цей обмін прямо: «way faster, at the expense of a minor quality degradation». На 809 мільйонах параметрів вона вп’ятеро менша за модель чату.
FastFlowLM постачає її вже перетвореною для NPU як whisper-v3:turbo, завантаження на 623 МБ, і вантажить поруч із моделлю чату через -a whisper-v3:turbo. Сам по собі Whisper він не віддаватиме; має бути завантажена ще й модель чату. Звук іде на стандартну кінцеву точку транскрипції OpenAI, і текст повертається.
| 19,6 секунди мовлення | |
|---|---|
| Перший запит, завантаження Whisper | 6,2 с |
| Після цього | 2,0 с, приблизно вдесятеро швидше за реальний час |
| Потужність усього чипа | ~24,7 Вт |
| Точність | кожне слово правильно |
Щоправда, написано американським фальшивим правописом: «color» і «program». API Whisper приймає prompt, і промпту, написаного справжнім британським правописом, англійською Англії, звідки ця мова походить, досить, щоб це виправити:
curl -s 'http://[::1]:52625/v1/audio/transcriptions' -F file=@speech.wav \
  -F model=whisper-v3:turbo -F language=en \
  -F 'prompt=British English spelling: colour, programme, organise, centre.'
Нам узагалі не мало б доводитися виправляти ці моделі. Whisper навчали на 99 мовах, а він однаково пише англійську по-американському, поки йому не скажеш інакше, бо люди, які його зробили, вважають свій правопис типовим, а чужий опцією, яку треба окремо просити. Це той дратівливий американський дефолтизм, який ненавидить решта світу, і він вшитий як упередження. Системний промпт для моделі чату несе ту саму вказівку, у розділі нижче, з тієї самої причини.
Вікно чату і 7000 токенів, яких ти не вводив
Open WebUI є вебінтерфейсом у браузері15, у власному контейнері, так само прив’язаний до [::1]:3000 і спрямований на NPU. Його кнопка мікрофона йде до Whisper на NPU, а не до власного типового варіанта, який завантажив би модель і крутив її на CPU.
Перше повідомлення, яке я йому надіслав, мало двадцять слів. До NPU воно дійшло як промпт на 7223 токени, бо Open WebUI 0.13 чіпляє до кожного повідомлення визначення всіх своїх вбудованих інструментів (пам’ять, нотатки, календар, автоматизації, вебпошук), а адміністратор отримує їх усі.
| Те саме питання на двадцять слів | Промпт, надісланий на NPU | Очікування першого слова |
|---|---|---|
| Вбудовані інструменти увімкнені, за замовчуванням | 7223 токени | ~12 с |
| Вбудовані інструменти вимкнені для моделі | 127 токенів | менше 1 с |
Для локальної моделі це має бути вимкнено за замовчуванням. Дванадцять секунд на кожну відповідь.
А ще вона впевнено сказала мені, що її «trained by Google» і що працює вона «on Google’s advanced infrastructure». Це модель Qwen від Alibaba, що працює на ноутбуці. Повна нісенітниця, і такого не має бути.
Річ не в налаштуванні. Модель бачить тільки текст, який їй надіслали, а назва у випадному списку служить міткою для сервера, моделі її не передають. Тож ця відповідь узялася від самої моделі, і вона помилилася в єдиному факті про себе, у якому не має бути жодного сумніву. Це вада дизайну, і відповідає за неї той, хто випустив модель.
Alibaba знала, як цьому запобігти. Шаблон чату Qwen 2.5 відкривав кожну розмову рядком «You are Qwen, created by Alibaba Cloud», якщо ти не дав чогось іншого16. Qwen 3 цей рядок прибрав17, і Qwen 3.5 теж постачається без нього18. Нічим його не замінили, і судячи з тієї відповіді, модель так і не навчили цього достатньо, щоб вона впоралася сама. Спитай модель 4B «що ти таке?» без промпту, і вона відступить на найпоширенішу відповідь у своїх навчальних даних, а це відповідь когось іншого.
Чи це дрібниця? Ні. Модель, яка з повною впевненістю скаже тобі, хто її зробив і в чийому дата-центрі вона працює, і помилиться в обох, так само вчинить з усім іншим, чого не може перевірити. Тут ти знаєш правильну відповідь. Здебільшого не знатимеш.
Тож їй треба сказати, у системному промпті:
| На питання «що ти таке і на чому працюєш?» | Відповідь |
|---|---|
| Без системного промпту | «a large language model trained by Google… Google’s advanced infrastructure» |
| З ним | «Qwen 3.5, a large language model created by Alibaba… running locally on your Lenovo ThinkPad using the AMD Ryzen AI 7 PRO 350’s NPU via FastFlowLM» |
Той самий промпт каже їй писати британською англійською, знову через американський дефолтизм, який є й у Whisper. Коли сказано, пише. Який сьогодні день, вона однаково сказати не може. Модель без календаря та інтернету вгадує дати й недавні події, і не завжди в цьому зізнається, хоч що там просить промпт.
Три роки, щоб запустити AI на Linux
AMD вивела Ryzen AI на сцену в січні 2023 як «the first dedicated artificial intelligence hardware in an x86 processor»19. Відлічи від того виступу:
| Коли | Що сталося на Linux | Після виступу |
|---|---|---|
| 4 січня 2023 | оголошено Ryzen AI, у Ryzen 7040 | |
| 25 січня 2024 | amd/xdna-driver опубліковано на GitHub4 | 1 рік |
| 24 березня 2025 | amdxdna в основній гілці Linux, 6.1420 | 2 роки 2 місяці |
| 27 березня 2025 | виходить цей чип, Ryzen AI 7 PRO 3501 | 2 роки 2 місяці |
| 11 березня 2026 | FastFlowLM 0.9.35, перший нативний випуск для Linux21 | 3 роки 2 місяці |
| 11 серпня 2026 | FastFlowLM 1.0.0, тепер під ROCm від AMD6 | 3 роки 7 місяців |
| сьогодні | досі жодного середовища для LLM на 7040 і 80402 | 3 роки 10 місяців |
Три роки і два місяці, щоб узагалі запустити мовну модель на NPU під Linux, і зробило це не власне ПЗ AMD. Зробив FastFlowLM, проєкт, що почався поза компанією і цього року був прийнятий під ROCm. Його нотатки до випуску для Linux відкриваються словами «The wait is finally over», а далі кажуть, що він використовує «the exact same recipe you already know and love on Windows»21. Fisher-Price OS (Windows) отримала це першою, і вони так і сказали. Власне ПЗ AMD, Ryzen AI Software, досі каже в поточних нотатках до випуску: «Model generation is not supported on Linux in this release»22.
Тим, хто купив перше покоління, ще гірше. Ноутбук з Ryzen 7040 з 2023 року має NPU, якого не торкнеться жодне середовище для мовних моделей на Linux, і ніде не опубліковано, що таке з’явиться. Той самий значок.
Можна спитати чому? Не хто, а чому. Що в процесі AMD дозволило продавати чип з AI в назві, тоді як ПЗ, щоб користуватися цим AI на Linux, з’явилося через роки, і то ззовні? У специфікації написано «Up to 50 TOPS»1. На значку написано Ryzen AI. Обидва написи є заявами людині, яка купує ноутбук, і в перший рік цього чипа на Linux обидві не були варті нічого.
Націлено на Copilot, а не на дата-центр
Справа не в тому, що Linux для AMD складний. У дата-центрі Linux першокласний, і AMD це знає: El Capitan у Lawrence Livermore побудовано на процесорах AMD EPYC і прискорювачах AMD Instinct, до червня цього року це був найшвидший комп’ютер у світі23, і працює він на TOSS, власній збірці Red Hat Linux від Livermore24. Уявляєш, як AMD продає прискорювач Instinct і каже покупцеві, що ПЗ для Linux колись згодом буде, і від когось іншого? Не буде такого. AMD навіть написала драйвер ядра для цього NPU і завела його в основну гілку. Останній шар, той, що змушує залізо робити роботу, під яку його продали, і лишився чекати.
Це взагалі ніколи не мало бути проєктом для ноутбуків. Та сама архітектура XDNA того ж року пішла в карту для дата-центрів, Alveo V70, яку продавали як «the first Alveo production card leveraging AMD XDNA architecture with AI Engines»25. Збудуй один програмний стек для AI Engine, спершу під Linux, як і решту дата-центру, і ноутбук отримає його задарма. Сервер теж. Маленький ощадливий прискорювач якраз і є тим, що хочеться роздавати віртуальним машинам, кожній по шматочку, для малих моделей, яким не потрібна ціла GPU. Ядро навчилося цього тільки цього року, розділяючи NPU на віртуальні функції на нових частинах AIE426. На NPU в цьому ноутбуці воно цього не вміє зовсім.
Натомість зусилля пішли на Fisher-Price OS (Windows) і на Copilot. AMD запустила покоління цього чипа як процесори, що «Unlock Transformational AI Experiences for Windows Copilot+ PCs»27. Майже ніхто не купився. Машини Copilot+ становили 2,3 % ПК з Fisher-Price OS (Windows), проданих у першому кварталі 2025, а новіші функції Copilot від Microsoft однаково працюють у хмарі: «only one of its new AI capabilities actually requires an NPU»28. Microsoft також повідомляє, що її дохід від виробників ПК упав на 7 % через «lower PC market demand», при «roughly 30% of the installed base still on Windows 10»29. Тож NPU націлили на операційну систему, на яку люди не оновлюються, щоб запускати асистента, якого вони не просили і який здебільшого NPU не використовує.
І AI будують не там. Люди, які цим заробляють на життя, сидять на Linux, бо там працюють їхні інструменти. TensorFlow прямо каже, що 2.10 «was the last TensorFlow release that supported GPU on native-Windows»30. Сервер моделей vLLM «does not support Windows natively»31. JAX називає свою збірку для Fisher-Price OS (Windows) експериментальною, а підтримку AMD позначає як «AMD GPU (Linux)»32. Там, де Fisher-Price OS (Windows) таки запускає ці інструменти, це відбувається через WSL 2, що за власним описом Microsoft є «an actual Linux kernel inside a managed VM»33. AMD націлила свій AI-чип на той єдиний десктоп, яким професія AI не користується. Часткової підтримки цього замало, AMD.
А потім AMD продає себе інвесторам як AI-компанію. 11 листопада 2025 її голова правління і CEO сказала, що AMD «is uniquely positioned to lead the next generation of high-performance and AI computing», у пресрелізі, який хвалиться зростанням «AI PC portfolio 2.5x since 2024» і завершується словами «full-stack AI solutions»34. Повний стек. На AI PC з цього допису верхівка того стеку прийшла від проєкту, який AMD не починала, а на першому поколінні вона так і не прийшла. AI-компанія, чий власний AI-чип три роки чекав, щоб запустити AI на операційній системі, на якій стоїть її бізнес у дата-центрах? Сміхота.
Першокласну підтримку описати просто. Вона працює в день, коли ти купуєш машину, на операційній системі, якою ти користуєшся, від компанії, що продала тобі чип. Цей NPU до такого ще не дотягнув. Я купив ноутбук заради всього іншого, а NPU йшов у комплекті, і тільки тому це опис роботи, а не скарга. Кожен, хто купив такий заради AI на значку і сидить на Linux, купив обіцянку, яку виконали пізно, і виконав хтось інший.
Володій кремнієм, за який заплатив
NPU прийшов разом з ноутбуком. Так, як його продають, це та частина, що робить машину готовою до AI, а AI, який пропонують, чужий, у чужому дата-центрі, і читає те, що ти вводиш, щоб за нього можна було заплатити якось інакше. Самому залізу така домовленість ні до чого. Модель 4B на 21 Вт відповідає на питання, прочитає вставку на 175 000 слів, якщо даси їй часу, і запише те, що ти кажеш, і ніщо з цього не покидає стола.
Готовим ПЗ це не назвеш, і кожна шорсткість вище коштувала години, щоб її знайти, і рядка-двох, щоб виправити. Ось скільки коштує відкритий код, коли ним справді користуєшся. І це все одно краща угода, ніж брати ту саму можливість назад в оренду, а за ту годину ти купуєш знання, як воно працює.
Контейнери тримають усе чесним. На хості нічого, крім модуля ядра та його мікропрограми, один пристрій, переданий одному контейнеру, адреса, до якої ніхто інший не дістанеться, і перевірка, що падає тієї ж миті, коли частини перестають збігатися. Це забрало день. І працюватиме далі, бо я знаю, навіщо там кожен рядок, а перевірка скаже мені того ранку, коли один із них перестане бути правдою.
AMD — Ryzen AI 7 PRO 350 — 8 ядер, 16 потоків, Radeon 860M, «NPU TOPS: Up to 50 TOPS», дата виходу «3/27/2025». ↩︎ ↩︎ ↩︎
Lemonade — LLMs on Linux with FastFlowLM — тільки XDNA2 (Ryzen AI 300/400, Strix Halo), не XDNA1; мікропрограма NPU 1.1.0.0 або новіша; не став
amd_iommu=off. ↩︎ ↩︎ ↩︎ ↩︎Linux kernel documentation — amdxdna — драйвер прискорювача в дереві ядра для NPU від AMD. ↩︎
amd/xdna-driver — драйвер, підмодуль XRT і плагін; базовий пакет XRT збирай з доданого підмодуля, щоб він працював із плагіном; репозиторій створено 25 січня 2024. ↩︎ ↩︎
Linux v7.3 — drivers/accel/amdxdna/amdxdna_pci_drv.c —
AMDXDNA_DRIVER_MAJOR 0,AMDXDNA_DRIVER_MINOR 10; так само у v7.2. ↩︎ROCm/FastFlowLM — середовище виконання LLM на NPU для XDNA2, сервер, сумісний з OpenAI, частина ROCm з v1.0.0; тут використано випуск v1.0.12. ↩︎ ↩︎
FastFlowLM — LICENSE_BINARY.txt — умови для доданих бінарних ядер NPU. ↩︎
RPM 6.0.0 release notes — «RPM defaults to enforcing signature checking». ↩︎
podman-systemd.unit(5) — юніти Quadlet
.container, зокремаAddDevice=,Ulimit=,StopSignal=іExec=. ↩︎loginctl(1) —
enable-lingerзапускає менеджер користувача під час завантаження і тримає його після виходу з сеансу. ↩︎Qwen/Qwen3.5-4B — «Context Length: 262,144 natively»; гібрид шарів Gated DeltaNet і gated attention. ↩︎
ggml-org/llama.cpp — образ контейнера
server-vulkan, використаний для запусків на GPU, збірка 12352. ↩︎mlc-ai/mlc-llm — перевірено з нічними пакетами 0.26. ↩︎
openai/whisper-large-v3-turbo — «a state-of-the-art model for automatic speech recognition (ASR) and speech translation»; урізано з large-v3, «the number of decoding layers have reduced from 32 to 4»; 809M параметрів; ліцензія MIT. ↩︎
open-webui/open-webui — тут використано випуск v0.13.3. ↩︎
Qwen/Qwen2.5-7B-Instruct — tokenizer_config.json — типове системне повідомлення шаблону чату: «You are Qwen, created by Alibaba Cloud. You are a helpful assistant.» ↩︎
Qwen/Qwen3-4B — tokenizer_config.json — шаблон чату без типового системного повідомлення. ↩︎
Qwen/Qwen3.5-4B — tokenizer_config.json — шаблон чату без типового системного повідомлення. ↩︎
AMD — AMD Highlights Future of High-Performance and Adaptive Computing During Opening Keynote of CES 2023 — 4 січня 2023: «AMD also unveiled Ryzen AI Technology – the first dedicated artificial intelligence hardware in an x86 processor.» ↩︎
Kernel Newbies — Linux 6.14 — випущено в понеділок, 24 березня 2025; «an amdxdna driver for AMD NPUs». ↩︎
FastFlowLM v0.9.35 release notes — 11 березня 2026: «The wait is finally over… FastFlowLM is officially available natively on Linux!» ↩︎ ↩︎
AMD — Ryzen AI Software release notes — відомі проблеми: «Model generation is not supported on Linux in this release.» ↩︎
TOP500 — June 2026 — «LineShine debuts as the new No. 1 system, ending El Capitan’s run atop the list»; El Capitan «is based on AMD 4th generation EPYC processors… and AMD Instinct MI300A accelerators». ↩︎
LLNL — TOSS: Speeding Up Commodity Cluster Computing — «a fully functional cluster operating system, based on Red Hat Linux». ↩︎
AMD — Alveo V70 — «the first Alveo production card leveraging AMD XDNA architecture with AI Engines… designed for AI inference efficiency». ↩︎
Linux — accel/amdxdna: Add basic support for AIE4 devices — «Add initial support for AIE4 devices (PCI device IDs 0x17F2 and 0x1B0B), including… SR-IOV enablement». Таблиця драйвера дає записи віртуальних функцій лише цим частинам; NPU цього ноутбука —
17f0. ↩︎AMD — AMD Unveils Next-Gen “Zen 5” Ryzen Processors to Power Advanced AI Experiences — Computex, 2 червня 2024: «AMD Ryzen AI 300 Series Processors Unlock Transformational AI Experiences for Windows Copilot+ PCs». ↩︎
Engadget — Microsoft’s Copilot+ AI PC plan fizzled, but it still served a purpose — 5 грудня 2025: системи Copilot+ «made up just 2.3 percent of Windows machines sold in the first quarter of 2025»; «only one of its new AI capabilities actually requires an NPU». ↩︎
Windows Latest — Microsoft admits its end of support was the real Windows 11 sales driver — 31 липня 2026, цитата з дзвінка Microsoft щодо результатів: «Windows OEM and Devices revenue decreased 7%… driven by lower PC market demand»; «roughly 30% of the installed base still on Windows 10». ↩︎
TensorFlow — Install TensorFlow with pip — «TensorFlow 2.10 was the last TensorFlow release that supported GPU on native-Windows.» ↩︎
vLLM — GPU installation — «vLLM does not support Windows natively». ↩︎
JAX — Installation — CPU-пакети для «Windows, x86_64 (experimental)»; розділи про GPU для NVIDIA, Google Cloud TPU, Mac і «AMD GPU (Linux)». ↩︎
Microsoft — Comparing WSL versions — «the use of an actual Linux kernel inside a managed VM». ↩︎
AMD — AMD Unveils Strategy to Lead the $1 Trillion Compute Market and Accelerate Next Phase of Growth — Financial Analyst Day, 11 листопада 2025: «AMD is uniquely positioned to lead the next generation of high-performance and AI computing»; «AMD has expanded its AI PC portfolio 2.5x since 2024»; «AMD delivers full-stack AI solutions». ↩︎