Цього разу хост існує. Просто не на тому гіпервізорі
Минулого разу проблема була в тому, що машини, названої в інвентарі, ще не існувало: ні IP, ні SSH, ні Python, нічого, до чого можна підключитися. Кожне завдання доводилося делегувати кудись інде.
Міграція з VMware перевертає це й нічого не змінює. Машина існує, вона працює, люди нею користуються. Ти все одно ніколи до неї не підключаєшся. Це ім’я і торба змінних, що описують щось, що треба відбудувати деінде. Кожне завдання так само виконується на керівному вузлі, тільки тепер на іншому кінці два API замість одного.
Пару слів про те, що це таке. Цей допис про дизайн і плейбук, а не бойова історія. Я ще не проганяв його проти продакшн-середовища від початку до кінця. Усе, що я кажу нижче про поведінку модулів, прочитано з коду, що постачається, і перевірено, і я прямо кажу, де твердження походить із вихідного коду, а не з запуску. Коли я зроблю справжню міграцію з ним, цифри й несподіванки отримають окремий допис.
Версії, на яких це перевірено:
$ ansible --version | head -1
ansible [core 2.20.7]

$ ansible-galaxy collection list | grep -E 'vmware|proxmox'
community.proxmox 1.6.0
community.vmware  6.2.1
vmware.vmware     2.9.0
Фрагменти нижче вирізано з одного плейбука: migrate.yml, динамічний інвентар vSphere у inventory/vmware.vms.yml і один group_vars/all.yml. Назви датацентру, вузла й сховища я зробив загальними, щоб легше читалося.
Форма роботи
П’ять кроків, і лише останній щось коштує.
Порядок і є весь дизайн. Виявлення нічого не змінює. Побудова мережі змінює тільки Proxmox. Побудова оболонок змінює тільки Proxmox, а оболонку без диска дешево видалити. Перенесення дисків повільне, але живе. Тільки останній етап щось вимикає.
Покинь усе на півдорозі, і кожен гість досі працює на VMware, недоторканий.
Дві колекції, і одну з них списують
Тобі потрібні обидві, і не з тієї причини, яку ти припустив би.
collections:
  - name: community.vmware
    version: ">=6.2.1"
  - name: vmware.vmware
    version: ">=2.5.0"
  - name: community.proxmox
    version: ">=1.6.0"
community.vmware це стара, широка колекція, і її розбирають. Її MANIFEST.json оголошує {"vmware.vmware": ">=2.5.0"} жорсткою залежністю, тож встановлення першої тягне за собою другу, просив ти про це чи ні. Модулі переїжджають по одному, і ті, по які ти тягнешся під час міграції, перебувають на різних етапах цього переїзду:
vmware_dvs_portgroup_info: досі тільки вcommunity.vmware, і саме він читає твої VLAN.vmware_vmotion: досі тільки вcommunity.vmware.vmware_guest_powerstate: застарілий, видаляється вcommunity.vmware7.0.0. Використовуйvmware.vmware.vm_powerstate.vmware_vm_inventory: застарілий, видаляється в 7.0.0. Використовуйvmware.vmware.vms.
Ansible попереджає про застарілі модулі під час першого запуску, і це порядно з його боку:
[DEPRECATION WARNING]: community.vmware.vmware_guest_powerstate has been deprecated.
Use vmware.vmware.vm_powerstate instead. This feature will be removed from
collection 'community.vmware' version 7.0.0.
Про плагін інвентарю він не попереджає, бо плагіни інвентарю розбираються раніше, ніж запускається цей механізм. Доведеться піти й прочитати плагін.
У цьому розколі є третя пастка. vmware.vmware.vm_portgroup_info виглядає точно як те, чого хоче мережева міграція: по VM, по NIC, дає портгрупу і VLAN. Але він побудований на ModuleRestBase і імпортує com.vmware.vapi, а це означає, що йому потрібен vSphere Automation SDK на керівному вузлі, а не лише pyVmomi. Його задокументоване повернення теж застаріле: блок RETURN обіцяє name і vlan_id, тоді як код насправді будує portgroup_name і словник vlan_info для розподіленого випадку. Я пішов іншим шляхом, нижче, і не потребував жодного з них.
Інвентар і є виявленням
У цьому плейбуку немає етапу «піди й знайди VM», бо на момент запуску першого завдання інвентар це вже зробив, одним запитом до property collector, а не циклом по кожній VM.
# inventory/vmware.vms.yml
plugin: vmware.vmware.vms

hostname: "{{ lookup('ansible.builtin.env', 'VMWARE_HOST') }}"
username: "{{ lookup('ansible.builtin.env', 'VMWARE_USER') }}"
password: "{{ lookup('ansible.builtin.env', 'VMWARE_PASSWORD') }}"
validate_certs: false

search_paths:
  - /Datacenter-1

properties:
  - name
  - config.name
  - config.uuid
  - config.guestId
  - config.firmware
  - config.template
  - config.hardware.numCPU
  - config.hardware.numCoresPerSocket
  - config.hardware.memoryMB
  - config.hardware.device
  - summary.runtime.powerState

gather_compute_objects: true
hostnames: ['name']
filter_expressions:
  - 'config.template'
Назва файлу має значення. verify_file плагіна визнає своїми тільки файли, що закінчуються на vms.yml, vms.yaml, vmware_vms.yml або vmware_vms.yaml. Назви його vcenter.yml, і він мовчки не стане твоїм інвентарем.
search_paths фільтрує до запиту, а не після. На великому середовищі це різниця між секундами й хвилинами, на відміну від filter_expressions, про який документація каже прямо: він виконується після збору і «does not affect the speed of the inventory plugin».
filter_expressions відкидає хост, коли вираз істинний. Тож config.template прибирає шаблони, що вперше читається задом наперед.
А важливий рядок це config.hardware.device, якого немає в жодному типовому списку властивостей. Це весь апаратний інвентар VM, і він несе три речі, без яких ця міграція не може рушити: MAC кожного NIC, ключ dvportgroup, до якого підключено кожен NIC, і шлях на datastore кожного диска. Без нього ти повертаєшся до циклу vmware_guest_info, один запит туди й назад на кожну VM.
Пристрої повертаються як JSON із збереженим типом vSphere у _vimtype. Це варто знати, бо саме так відрізняють NIC від диска. Я перевірив кодувальник, а не гадав:
{
  "_vimtype": "vim.vm.device.VirtualVmxnet3",
  "macAddress": "00:50:56:87:a5:9a",
  "backing": {
    "_vimtype": "...DistributedVirtualPortBackingInfo",
    "port": {
      "_vimtype": "vim.dvs.PortConnection",
      "portgroupKey": "dvportgroup-1014"
    }
  }
}
Тож блок compose може витягти незручні шляхи нагору в пласкі hostvars:
compose:
  vm_moid: moid
  vm_firmware: config.firmware
  vm_memory_mb: config.hardware.memoryMB
  vm_num_cpu: config.hardware.numCPU

  # A virtual NIC is any device with a MAC. Filtering on _vimtype does not
  # work cleanly here, because VMXNET3, E1000 and SR-IOV cards are all
  # different types with no shared substring.
  vm_nics: >-
    config.hardware.device
    | selectattr('macAddress', 'defined')
    | selectattr('macAddress', 'ne', None) | list

  # Disks are one exact type, so this one can match on it.
  vm_disks: >-
    config.hardware.device
    | selectattr('_vimtype', 'eq', 'vim.vm.device.VirtualDisk') | list
Ця асиметрія реальна, і на ній люди спотикаються. Немає типу VirtualEthernetCard, з яким можна зіставити. Це абстрактний базовий клас, а vCenter насправді віддає тобі VirtualVmxnet3, VirtualE1000, VirtualE1000e, VirtualPCNet32 або VirtualSriovEthernetCard. Спільного для них усіх підрядка немає. А от мати MAC уміє тільки NIC.
Кожен info-модуль ховає поле, яке тобі потрібне
Це червона нитка всієї роботи, і коли побачиш це тричі, починаєш перевіряти кожне типове значення, перш ніж писати завдання.
vmware_dvs_portgroup_info має шість опцій show_*. П’ять типово true. Шоста це show_vlan_info, і вона типово false.
show_mac_learning=dict(type='bool', default=True),
show_network_policy=dict(type='bool', default=True),
show_teaming_policy=dict(type='bool', default=True),
show_uplinks=dict(type='bool', default=True),
show_port_policy=dict(type='bool', default=True),
show_vlan_info=dict(type='bool', default=False),
Не чіпай її, і отримаєш політику навчання MAC, політику teaming, порядок uplink і політику портів для кожної портгрупи в середовищі. Усе, крім тегу VLAN, а це єдине поле, про яке мережева міграція насправді питає. Тож завдання вивернуте навиворіт відносно того, що написав би інстинкт: увімкни одне, вимкни решту п’ять.
- name: Read the distributed portgroups
  community.vmware.vmware_dvs_portgroup_info:
    datacenter: "{{ vcenter_datacenter }}"
    show_vlan_info: true
    show_network_policy: false
    show_teaming_policy: false
    show_port_policy: false
    show_mac_learning: false
    show_uplinks: false
  register: dvs_pgs
Це не поодинокий випадок. vmware.vmware.vms має gather_compute_objects, яке заповнює cluster і esxi_host: типово false. community.vmware.vmware_vm_info має show_allocated, блок із CPU та пам’яттю: типово false. В усіх трьох випадках поле, яке дорого збирати, і є тим, що потрібне міграції, а типове значення захищає сценарій звітування тільки на читання, в якому ти не перебуваєш.
vlan_id має три різні типи
Потім ти отримуєш теги VLAN і бачиш, що вони не однієї форми. Просто з get_vlan_info:
if isinstance(vlan_obj, vim...TrunkVlanSpec):
    ...
    return dict(trunk=True, pvlan=False, vlan_id=vlan_id_list)
elif isinstance(vlan_obj, vim...PvlanSpec):
    return dict(trunk=False, pvlan=True, vlan_id=str(vlan_obj.pvlanId))
else:
    return dict(trunk=False, pvlan=False, vlan_id=str(vlan_obj.vlanId))
Портгрупа доступу дає рядок "100". PVLAN дає рядок. Транк дає список рядків, кожен або "20", або "20-30". І на кожному розподіленому комутаторі є щонайменше один транк, створював ти його чи ні, бо uplink-портгрупа це транк, що несе "0-4094".
Тож | int тобі недоступний, доки не викинеш дві інші форми:
access_pgs: >-
  {{ dvs_pgs.dvs_portgroup_info | dict2items | map(attribute='value') | flatten
     | rejectattr('vlan_info.trunk') | rejectattr('vlan_info.pvlan')
     | rejectattr('vlan_info.vlan_id', 'in', ['0', 0])
     | list }}
Три відкидання, саме в такому порядку. Транки йдуть геть, PVLAN ідуть геть, а потім ідуть нетеговані портгрупи, що заодно прибирає uplink-групи й усе на VLAN 0.
Я не перекладаю транки чи PVLAN автоматично і заперечив би кожному, хто це робить. Транк VMware, що приземляється на Proxmox, потребує або зони Q-in-Q, або VNet з підтримкою VLAN, і яке з них правильне, залежить від того, що очікує бачити гість. Це рішення, а не відображення. Плейбук друкує їх і йде далі:
TASK [Report what was found]
ok: [localhost] => {
    "msg": "3 access portgroups -> [100, 200]. Not translated:
            ['dvs_001-uplink'] (trunks), ['isolated'] (PVLANs)."
}
Віддзеркалення VLAN у SDN
Одна VLAN-зона, прив’язана до мосту, потім один VNet на кожен VLAN із тегом на ньому.
- name: Create the VLAN zone
  community.proxmox.proxmox_zone:
    zone: "{{ sdn_zone }}"
    type: vlan
    bridge: "{{ sdn_bridge }}"
    mtu: "{{ sdn_mtu }}"
    state: present

- name: Create one VNet per VMware VLAN
  community.proxmox.proxmox_vnet:
    vnet: "{{ sdn_vnet_prefix }}{{ item.vlan_info.vlan_id | int }}"
    zone: "{{ sdn_zone }}"
    tag: "{{ item.vlan_info.vlan_id | int }}"
    alias: "{{ item.portgroup_name }}"
    state: present
  loop: "{{ access_pgs | unique(attribute='vlan_info.vlan_id') }}"
  throttle: 1
Імена VNet короткі й обмежені, а імена портгруп VMware ні. Production-Web-Tier-VLAN100 це цілком звичайне ім’я портгрупи і неможливе ім’я VNet. Тож ім’я генерується, v100, з тегу, а оригінал, зрозумілий людині, іде в alias, де лишається видимим в інтерфейсі та у виводі pvesh. Виведення імені з VLAN, а не з портгрупи, ще й означає, що відображення можна відтворити простим оглядом через пів року.
Дві портгрупи на одному VLAN зливаються в один VNet. Це правильно, вони й у VMware були одним широкомовним доменом, але ти маєш бачити, як це стається, і саме це робить unique(attribute='vlan_info.vlan_id'). Дві портгрупи з іменами prod-web і prod-web-b, обидві на VLAN 100, дають один v100.
throttle: 1 це не обережність, це сам модуль. Кожен запис SDN у community.proxmox бере глобальне блокування кластера, застосовує відкладену конфігурацію і звільняє його: get_global_sdn_lock(), потім apply_sdn_changes_and_release_lock(). Запусти їх паралельно, і вони все одно стануть у чергу на блокуванні; throttle просто не дає тобі вдавати інакше. Варто знати й те, що відкат у разі збою залежить від версії: модуль перевіряє is_lock_and_rollback_supported і на старішому PVE повідомляє, що відкотити не вдалося, замість того щоб відкотити.
Одна косметична річ, через яку ти засумніваєшся в собі. У версії 1.6.0 proxmox_vnet виводить увесь свій словник параметрів як попередження Ansible під час кожного створення:
self.module.warn(f"{vnet_params}")
self.proxmox_api.cluster().sdn().vnets().post(**vnet_params)
Це налагоджувальний рядок, який хтось забув прибрати. Це шум, а не несправність.
Збудуй оболонки без дисків
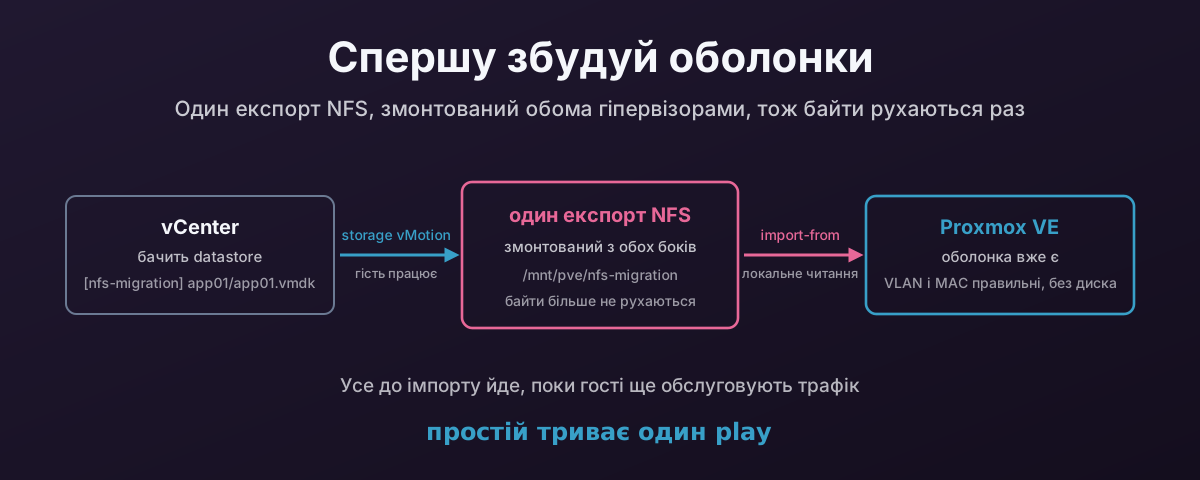
Тепер VM, і саме тут дизайн себе виправдовує. Кожна VM будується в Proxmox із правильною кількістю CPU, правильною пам’яттю, правильною прошивкою і правильними NIC на правильних VLAN. Без жодних дисків.
Оболонку без диска швидко створити, видалити її нічого не коштує, а якщо хтось випадково її запустить, вона завантажиться до запрошення PXE. Можна збудувати чотириста таких за пообіддя, подивитися на результат, вирішити, що не те, видалити все й зробити знову. Нічого не скопійовано, нічого не вимкнено, і ніхто нічого не помітив.
Похідні значення це оголошення, а не завдання. Ansible обчислює їх ліниво для того хоста, що зараз в області дії, тож кожна VM отримує свої без жодного set_fact:
# group_vars/all.yml
pve_vmid: "{{ vmid_base | int + (vm_moid | regex_replace('^vm-', '') | int) }}"
pve_bios: "{{ 'ovmf' if vm_firmware == 'efi' else 'seabios' }}"
pve_cores: "{{ vm_cores_per_socket | int }}"
pve_sockets: "{{ ((vm_num_cpu | int) / (vm_cores_per_socket | int)) | round(0, 'ceil') | int }}"
VMID береться з MoID у vCenter. vm-42 стає 20042. Це важливіше, ніж здається: етап перемикання має знайти VM, яку створив етап побудови, а повторний запуск має потрапити на ту саму, а не тихо збудувати другу. Якщо дозволити API виділити наступний вільний ID, а саме це стається, коли пропускаєш vmid, і про це я писав минулого разу, це стає неможливим.
Пам’ять не потребує перетворення. VMware повідомляє config.hardware.memoryMB, і Proxmox хоче MB. Сокети потребують: VMware дає загальну кількість vCPU і ядер на сокет, Proxmox хоче сокети та ядра.
- name: Create the VM shell
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    name: "{{ inventory_hostname }}"
    cores: "{{ pve_cores }}"
    sockets: "{{ pve_sockets }}"
    memory: "{{ vm_memory_mb }}"
    ostype: "{{ pve_ostype }}"
    bios: "{{ pve_bios }}"
    scsihw: "{{ default_scsihw }}"
    efidisk0: "{{ {'storage': pve_target_storage, 'efitype': '4m',
                   'pre_enrolled_keys': false}
                  if pve_bios == 'ovmf' else omit }}"
    agent: "enabled=1"
    onboot: false
    state: present
onboot: false навмисно. Ніщо не повинно запускатися саме посеред міграції, а надто машина, в чиї диски досі пише інший гіпервізор.
Прошивка мусить бути правильною. UEFI-гість, імпортований на VM із SeaBIOS, імпортується ідеально, а потім відмовиться завантажуватися, і ти вб’єш на це годину. config.firmware це efi або bios, і вони прямо відображаються на ovmf і seabios. UEFI-гостю також потрібен диск змінних EFI, який треба створити разом із VM; чому, дивись нижче.
proxmox_kvm не виправить NIC і не скаже тобі про це
Минулого разу я писав, що proxmox_kvm відмовляється сходитися до стану, замість того щоб оновлювати. Ось гостріша версія цього, яка вкусила мене, поки я це писав, і про яку варто сказати точно.
update типово false, тож повторний запуск проти VM, яка вже існує, нічого не робить. Гаразд, і це задокументовано. Але постав update: true, і модуль однаково відмовляється чіпати деякі параметри:
# If update, don't update disk (virtio, efidisk0, tpmstate0, ide, sata, scsi)
# and network interface, unless update_unsafe=True
if update_unsafe is False:
    ...
    if "efidisk0" in kwargs:
        del kwargs["efidisk0"]
Він видаляє їх із запиту й іде далі. Тож ти виправляєш NIC у відображенні інвентарю, перезапускаєш із update: true, бачиш, як Ansible звітує changed, а NIC такий самий неправильний, яким був. changed правдивий, щось інше в запиті оновилося, але не те, що ти виправляв.
update_unsafe: true знімає обмеження, і назва чесна. Той самий захист стосується дисків, тож на VM, яка має диски, небезпечне оновлення це добрий спосіб отримати другу копію одного з них. Це не перемикач, по який варто тягнутися під час міграції.
Вихід у тому, щоб узагалі не використовувати net. NIC додаються через proxmox_nic, модуль, уся робота якого це один інтерфейс і який сходиться як слід:
- name: Attach each NIC to its VNet
  delegate_to: localhost
  community.proxmox.proxmox_nic:
    vmid: "{{ pve_vmid }}"
    interface: "net{{ idx }}"
    bridge: "{{ sdn_vnet_prefix }}{{ pg_vlan[item.backing.port.portgroupKey] }}"
    mac: "{{ item.macAddress }}"
    model: "{{ default_net_model }}"
    state: present
  loop: "{{ vm_nics }}"
  loop_control:
    index_var: idx
Це той самий поділ, до якого я дійшов минулого разу: proxmox_kvm, щоб визначити машину, proxmox_disk і proxmox_nic для того, що змінюється потім. Параметр називається mac, а не mac_addr.
efidisk0 так само винести не можна, proxmox_disk не має ні efitype, ні pre_enrolled_keys, тож його треба додати під час створення і правильно з першого разу.
Перенось MAC. VMware роздає MAC із 00:50:56:..., і Proxmox прийме їх без заперечень. Збереження означає, що резервації DHCP досі збігаються, ліцензії, прив’язані до MAC, досі проходять перевірку, а будь-яке правило брандмауера, написане під MAC, досі спрацьовує. Зміна означає день дрібних загадок. proxmox_nic приймає й model: vmxnet3, якщо потрібно, щоб гість бачив ту саму NIC, що й раніше, але на KVM краща карта virtio, а гість Windows так чи інакше захоче нових драйверів.
Відмовляй, а не вгадуй
NIC на стандартній портгрупі взагалі не має backing.port. Її backing це NetworkBackingInfo з deviceName. Її не буде у відображенні, і правильно буде зупинитися:
- name: Every NIC must sit on a distributed portgroup with a VNet
  ansible.builtin.assert:
    that:
      - vm_nics | rejectattr('backing.port.portgroupKey', 'defined') | list | length == 0
      - vm_nics | map(attribute='backing.port.portgroupKey')
          | reject('in', pg_vlan.keys() | list) | list | length == 0
    fail_msg: >-
      {{ inventory_hostname }} has NICs that do not map to a Proxmox VNet.
      Attaching it to the wrong network is worse than not building it.
Дві умови, а не одна, бо перша має виконатися раніше за другу: map(attribute=...) по NIC без port вибухне на невизначеному пошуку. Спершу відкинь безформні, потім перевір решту за відображенням.
Один експорт, змонтований двічі
Ось частина, яка робить усе це дешевим.
Постав експорт NFS там, де обидва гіпервізори можуть його змонтувати. vCenter бачить datastore під назвою nfs-migration; вузли Proxmox монтують той самий експорт і бачать /mnt/pve/nfs-migration. Тепер перенеси VMDK на нього через storage vMotion.
Storage vMotion живий. Гість обслуговує трафік увесь час. Нічого не перемикається, вікно не потрібне, і його можна покинути на півдорозі без жодних наслідків, крім змарнованого вводу-виводу. Це найповільніший етап з великим відривом, і він нічого не коштує.
- name: Relocate to the NFS datastore
  delegate_to: localhost
  throttle: 2
  community.vmware.vmware_vmotion:
    moid: "{{ vm_moid }}"
    destination_datastore: "{{ nfs_datastore_vmware }}"
    timeout: "{{ vmotion_timeout }}"
timeout типово 3600, одна година. VMDK на 2 TB не встигне, і збій тихо підлий: завдання Ansible падає, а vMotion продовжує працювати у vCenter. Тепер у тебе плейбук, який каже, що впав, і середовище, яке досі зайняте. Постав значення, що відповідає твоєму реальному сховищу.
throttle: 2, бо вузьке місце не керівний вузол. Storage vMotion обмежений масивом і мережею. Шість одночасно не дають тобі ушестеро більшої пропускної здатності; вони дають шість повільних міграцій і злу команду сховища.
Модуль ідемпотентний саме так, як тобі треба: він ставить storage_vmotion_needed = False, якщо VM уже на цільовому datastore, тож повторний запуск, щоб підхопити відсталих, безпечний.
На момент, коли це завершиться, байти лежать на сховищі, яке Proxmox уже монтує. Тож ніщо інше не мусить їх копіювати. Ніколи.
Перемикання
Це єдиний етап, що коштує простою, і порядок усередині нього не обговорюється.
Спершу проблема, яку легко пропустити: інвентар тепер застарів. Його зібрано до vMotion, тож vm_disks досі тримає старі шляхи datastore. Імпортуй із них, і ти вкажеш Proxmox на шлях, якого він не бачить.
- name: Re-read the inventory now the disks have moved
  ansible.builtin.meta: refresh_inventory
Через це ж у конфігурації інвентарю вимкнено кешування. Теплий кеш віддав би refresh_inventory саме ті застарілі дані, які той мав замінити. Це справжній компроміс, vCenter не швидкий, але хибний шлях тут означає зірване перемикання у вікні, а зайвий запит дешевий у порівнянні.
Потім вимкнення. Імпорт VMDK, який хост ESXi досі тримає відкритим, дає в кращому разі аварійно-узгоджену копію:
- name: Shut the guest down in VMware
  delegate_to: localhost
  vmware.vmware.vm_powerstate:
    moid: "{{ vm_moid }}"
    state: "{{ 'shutdown-guest' if vm_power_state == 'poweredOn' else 'powered-off' }}"
    timeout: 600
    force: true
shutdown-guest це коректне вимкнення через VMware Tools; force: true жорстко зупиняє все, що не вимкнеться за тайм-аут. У новому модулі параметр називається timeout, а не state_change_timeout, як було в застарілому.
Потім імпорт, який і є стрижнем:
- name: Import each VMDK onto its VM
  delegate_to: localhost
  throttle: 2
  community.proxmox.proxmox_disk:
    vmid: "{{ pve_vmid }}"
    disk: "scsi{{ idx }}"
    storage: "{{ pve_target_storage }}"
    import_from: >-
      {{ item.backing.fileName
         | regex_replace('^\[[^\]]+\]\s*', '/mnt/pve/' ~ nfs_storage_pve ~ '/') }}
    format: "{{ pve_target_format }}"
    timeout: "{{ import_timeout }}"
    create: regular
    state: present
  loop: "{{ vm_disks }}"
  loop_control:
    index_var: idx
regex_replace виконує переклад між двома світами. vCenter називає диск [nfs-migration] app01/app01.vmdk; Proxmox дістається до того самого файлу за шляхом /mnt/pve/nfs-migration/app01/app01.vmdk. Той самий експорт, ті самі байти, жодної другої копії. Ти береш дескриптор .vmdk і ігноруєш -flat.vmdk поруч: qemu-img читає дескриптор і йде за ним до екстенту.
Три речі про import_from, усі є в модулі і всі варто знати до того, як відкриється вікно.
Він спрацьовує тільки під час створення. У гілці оновлення:
# 'import_from' fails on disk updates
playbook_config = self.get_create_attributes()
playbook_config.pop("import_from", None)
Якщо scsi0 на цій VM уже існує, параметр відкидається, і ти отримуєш звичайне оновлення. Тож повторний запуск після невдалого імпорту не імпортує знову. Він мовчки не робить нічого і звітує про успіх. Якщо імпорт пішов не так, видали диск, перш ніж пробувати знову.
timeout типово 600 секунд. Десять хвилин, щоб імпортувати й перетворити диск віртуальної машини. Власна документація модуля каже його збільшити; послухай поради.
І абсолютний шлях потребує root. Документація каже про це прямо:
<STORAGE>:<VMID>/<FULL_NAME>or<ABSOLUTE_PATH>/<FULL_NAME>.<STORAGE>:import/<FULL_NAME>for PVE 9.x and later, to use storage’s import directory. Attention! Only root can use absolute paths.
Що незграбно лягає проти поради, яку я дав минулого разу і якої досі тримаюся: використовуй обмежений API-токен, а не root. Ця порада чинна для кожного іншого етапу тут: виявлення, SDN, побудова оболонок, налаштування порядку завантаження чудово працюють із токеном. Це одне завдання ні, і жодні привілеї ролі цього не змінять, бо обмеження стосується того, що користувач є root, а не дозволу.
Є три чесні виходи, і немає хитрого четвертого:
- PVE 9.x: використовуй
<storage>:import/<file>і лишайся на токені. - PVE 8.x: виконай це одне завдання як
root@pam, і тільки його. - PVE 8.x, без root через API: запусти натомість
qm importdiskчерез SSH.
Плейбук підтримує перші два через прапорець, бо вдавати інакше означало б просто перекласти проблему на того, хто його запускає.
Нарешті порядок завантаження, який є звичайним оновленням і тому не зачеплений обмеженням update_unsafe:
- name: Boot from the first imported disk
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    boot: "order=scsi0"
    update: true
Ніщо не запускає гостя. Це навмисно. Запусти його вручну, подивися, як він підніметься, і тільки тоді думай про видалення будь-чого у VMware.
Запуск
Усе це один плейбук із тегами за етапами, бо це не ті кроки, які хочеться запускати разом:
ansible-playbook migrate.yml --tags discover   # look, change nothing
ansible-playbook migrate.yml --tags sdn        # build the VLANs
ansible-playbook migrate.yml --tags build      # build the diskless shells
ansible-playbook migrate.yml --tags relocate   # storage vMotion, live
ansible-playbook migrate.yml --tags cutover    # power off and import
--limit тобі друг протягом усього шляху. Спершу одну VM. Потім один кластер. Плейбуку байдуже, скільки ти відкусиш, а інвентар дає тобі групи задарма: power_poweredOn, cluster_<name>, а також vmware_windows і vmware_linux з блоку groups.
Перевір, на що цілишся, перш ніж цілитися:
ansible-inventory --graph
ansible-inventory --host some-vm
На що я ще зважав би
Речі, які я очікую знайти, коли це зустрінеться зі справжнім середовищем, записані зараз, щоб потім я не міг сказати, що бачив їх наперед:
- Гості Windows не завантажаться чисто з контролера VirtIO SCSI, якщо драйвера там заздалегідь немає.
virtio-scsi-singleце правильний контролер і неправильний для VM Windows, яка його ніколи не бачила. Це окрема проблема, і нічого з вищенаведеного її не розв’язує. - VMware Tools варто зняти до переїзду, а не після.
- Знімки. VM з ланцюжком знімків має більше одного
.vmdkна диск, і імпорт базового дає стан до знімка. Спершу консолідуй. - Порядок
config.hardware.deviceвирішує, який диск станеscsi0. Скрізь, де я дивився, він збігався з власним порядком гостя, але я перевірив би це на сервері бази даних із кількома дисками, перш ніж довіряти у вікні. - Незалежні та RDM-диски не переносяться через storage vMotion, як звичайні.
Ніщо з цього не змінює форму. Спершу збудуй оболонки, переноси диски, поки все ще працює, і тримай простій лише на тому етапі, якому він потрібен.