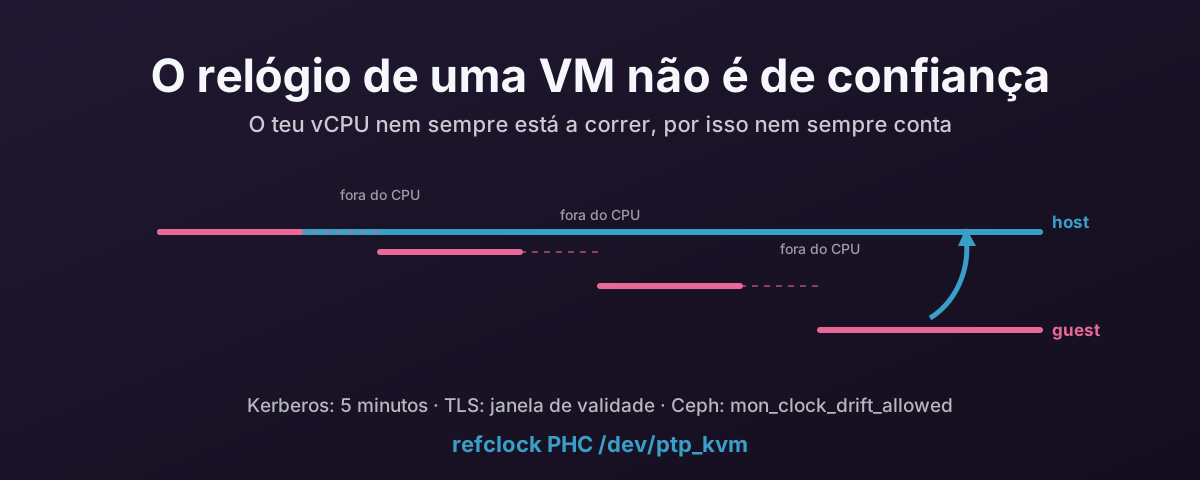
O pressuposto de todos os relógios
O relógio de um computador funciona a contar algo regular e a confiar que continua a contar. Um cristal oscila, um contador incrementa, e o software calcula quanto tempo passou.
A virtualização quebra a parte da confiança.
A própria documentação do kernel sobre a gestão do tempo em KVM resume o problema numa frase: «the virtual operating system does not run with 100% usage of the CPU, despite the fact that it may very well make that assumption.» Tudo o que se segue decorre daí.
O teu vCPU nem sempre está a correr
Um vCPU é uma thread no host. Corre quando o escalonador do host assim o decide.
Quando não está a correr, o guest não está apenas parado. Está ausente. Não consegue contar, não consegue atender uma interrupção de temporizador, e não tem maneira de saber quanto tempo esteve fora. O host regista isso como steal time, que é o nome honesto para «tempo que te aconteceu em vez de ser para ti».
É nas interrupções de temporizador que isto dói mais. Um guest que pede um tick periódico está a pedir ao host que entregue interrupções a um ritmo fixo, e o host nem sempre consegue. Outra vez da documentação do kernel: «the host virtualization engine may not be able to deliver the proper number of interrupts per second, and so guest time may fall behind.»
Quanto mais alto o ritmo de ticks, pior fica, e um host sobrecomprometido piora ainda mais. É também por isso que um host ocupado degrada a gestão do tempo dos guests sossegados. Estão todos em fila pelos mesmos núcleos físicos.
Os contadores também não são teus
Se os ticks periódicos não são fiáveis, a resposta óbvia é ler um contador. Isso tem os seus próprios problemas.
O TSC é o rápido, e a documentação do kernel não tem rodeios sobre ele: «The TSC is a CPU-local clock in most implementations… the TSCs of different CPUs may start at different times.» O ritmo pode variar com os estados de energia do processador, e em peças mais antigas para por completo quando o núcleo fica inativo. Um vCPU que migra entre núcleos físicos pode, portanto, ler um contador que discorda daquele que leu um microssegundo antes.
As alternativas são piores de outra maneira. O HPET, o PIT e o temporizador ACPI PM são todos dispositivos emulados, por isso cada leitura é uma armadilha para o hypervisor. Correto, e caro o suficiente para que um guest que lê o relógio num ciclo apertado dê por isso.
É por isso que existem relógios paravirtuais. Em KVM, o kvm-clock deixa o host publicar a sua própria gestão do tempo numa estrutura partilhada que o guest lê diretamente: sem armadilha, sem contagem, sem pressupor que o guest estava acordado.
É também por isso que deves deixar a fonte de relógio do guest em paz, em vez de forçares tsc ou hpet porque um post num fórum disse que era mais rápido.
Migração, snapshots e suspensão
A migração a quente, o restauro de um snapshot e a suspensão/retoma fazem todos o mesmo ao relógio de um guest: param-no e depois voltam a pô-lo a andar noutro sítio.
O que o guest vê não é deriva, é um salto. O relógio tinha um valor e agora tem outro, sem nada pelo meio. Migrar para um host cujo TSC corre a uma frequência diferente agrava isto.
Os saltos importam porque o software que corrige relógios foi feito para corrigir deriva, não teletransporte.
Isto não é um problema do KVM
É tentador ler tudo o que está acima como uma falha do KVM. Não é.
Todos os hypervisors trazem um relógio paravirtual, porque todos têm o mesmo problema estrutural: o KVM tem o kvm-clock, o Hyper-V tem a sua página de TSC de referência, a VMware tem um contador de pseudo-desempenho mais sincronização pelas Tools, o Xen tem o seu pvclock. São quatro implementações independentes do mesmo remendo.
A conclusão da própria documentação do kernel é que aqui não há solução perfeita. Só compromissos entre precisão, desempenho e complexidade.
Se o preferires da boca de um fabricante em vez de programadores do kernel, a fronteira de suporte da Microsoft para tempo de alta precisão é notavelmente franca. Para afirmar uma precisão de 50 ms num sistema Windows virtualizado, um dos requisitos indicados é que «the one-day average CPU utilization of the host must not exceed 90%.» Para 1 ms, o host tem de ficar abaixo dos 80%.
Lê outra vez: a precisão do relógio do guest está documentada como dependente de quão ocupado está o host. Isso não é uma peculiaridade do Windows, é a mesma física que a documentação do kernel descreve, escrita como fronteira de suporte.
Porque é que NTP dentro do guest é a ferramenta errada
O NTP é bom naquilo para que foi concebido: uma máquina com um oscilador real que anda ligeiramente adiantado ou atrasado, corrigido medindo a ida e volta até um servidor remoto e ajustando suavemente o relógio local.
Cada um desses pressupostos é frágil numa VM.
O oscilador local não está ligeiramente errado, está intermitentemente ausente. A medição da ida e volta é feita por um processo que pode ser desescalonado entre ler o relógio e enviar o pacote, o que corrompe a própria medição. E as correções necessárias depois de uma migração são saltos, que um algoritmo de ajuste gradual trata mal ou recusa à partida.
O chrony aguenta-se muito melhor do que o ntpd aqui. Ajusta mais depressa, tolera saltos e é honesto sobre a sua própria incerteza. Mas continua a resolver o problema errado: ir buscar o tempo através de uma rede a um servidor stratum 2 a 20 ms de distância, quando a hora certa está no hypervisor, do outro lado de uma única fronteira de memória.
O que obténs na prática é um guest que está quase sempre certo, ocasionalmente desviado dezenas ou centenas de milissegundos, e nunca bem capaz de te dizer qual das duas.
O que o desvio parte de facto
Ninguém se interessa por relógios por eles próprios. Interessa-se quando alguma coisa deixa de funcionar.
Kerberos e Active Directory
O Kerberos depende do tempo por desenho, porque a validade de um ticket é expressa como uma janela temporal.
A documentação do krb5.conf do MIT define clockskew como «the maximum allowable amount of clockskew in seconds that the library will tolerate before assuming that a Kerberos message is invalid», e o valor por omissão é de 300 segundos, cinco minutos.
Passa disso e a autenticação não se degrada, falha.
Como a autenticação do Active Directory é Kerberos, isso significa logons no domínio, net use, ligações ao SQL Server, Exchange, partilhas de ficheiros, tudo.
Cinco minutos parece generoso até um guest saltar para trás depois do restauro de um snapshot.
TLS
Um certificado traz uma janela de validade: notBefore e notAfter.
Um guest cujo relógio está atrasado rejeita um certificado emitido esta manhã porque, tanto quanto sabe, o certificado ainda não é válido.
Um guest cujo relógio está adiantado rejeita um que na realidade ainda não expirou.
A mesma aritmética rege a frescura do OCSP e das CRL, as claims nbf/exp de um JWT e os códigos TOTP de autenticação multifator, que vivem em janelas de 30 segundos.
Um relógio desviado 45 segundos é uma falha de autenticação com uma mensagem de erro muito confusa.
Ceph
Os monitores do Ceph preocupam-se com isto mais do que quase qualquer outra coisa na pilha, porque o seu consenso depende disso.
O health check MON_CLOCK_SKEW dispara quando «the clocks on hosts running Ceph Monitor daemons are not well-synchronized». Concretamente, quando o desvio excede mon_clock_drift_allowed.
O conselho da documentação é sincronizar com ntpd ou chrony contra várias fontes, e nota que a sincronização entre monitores importa particularmente.
Podes subir o mon_clock_drift_allowed, mas a documentação é clara: tem de ficar «significantly below the mon_lease interval». Como tal, é um orçamento pequeno, e gastá-lo a tapar um problema de gestão do tempo do hypervisor não é boa troca.
Tudo o resto
Os registos entre hosts deixam de se correlacionar, o que transforma a cronologia de um incidente em adivinhação. A replicação de bases de dados e o consenso distribuído, etcd, Galera, tudo o que use leases de líder, ficam infelizes. As janelas de backup e de monitorização saem de alinhamento com aquilo que deviam observar.
Os guests Windows desviam-se de outra maneira
O Windows merece uma nota à parte, porque o seu serviço de tempo foi construído com outros objetivos e nota-se.
A Microsoft diz claramente que as versões anteriores ao Windows 10 1607 / Server 2016 «can’t guarantee highly accurate time». O que o serviço Windows Time oferecia nessas versões era «the necessary time accuracy to satisfy Kerberos version 5 authentication requirements» e «loosely accurate time» para máquinas numa floresta AD comum. Mais apertado do que isso estava «outside of the design specification… and weren’t supported.»
Por outras palavras, o Windows antigo procura ficar dentro da janela de cinco minutos do Kerberos, não estar certo. O que está bem até alguma coisa no teu parque precisar de melhor. Uma máquina Windows virtualizada desviada 90 segundos autentica-se alegremente enquanto escreve registos que não se correlacionam com nada.
O Windows 10 e o Server 2016 em diante conseguem 1 s, 50 ms ou até 1 ms, mas só nas condições citadas acima, incluindo os limites de utilização do CPU do host. A Microsoft nota também que «anything that introduces network asymmetry, such as a one-way satellite connection or high CPU load on the target system, will negatively influence accuracy». Um vCPU disputado é carga alta de CPU no sistema alvo com outro nome.
Não há ptp_kvm para Windows. O que tens em vez disso:
- Os enlightenments de relógio do Hyper-V. O Proxmox já os expõe aos guests Windows. O
PVE::QemuServer::CPUConfigdefinehv_timeao lado dehv_vapic,hv_spinlocks,hv_relaxedehv_synic. Ohv_timeé o relógio paravirtual, e é o equivalente do lado Windows aokvm-clock. Está ligado por omissão nas VMs do tipo Windows; não há nada para ativar. - O agente de guest do QEMU. Com o agente instalado, o host pode empurrar a sua hora para o guest depois de uma retoma ou do restauro de um snapshot, o que trata o caso do salto, que é o que o NTP trata pior.
- Escolhe uma autoridade. A falha clássica do Windows numa VM são duas fontes de tempo à luta: sincronização host-guest e sincronização pela hierarquia do domínio, ambas a corrigir o mesmo relógio em sentidos opostos. Num guest membro de um domínio, deixa ganhar a hierarquia do domínio e impede o host de lhe empurrar a hora. Num guest isolado, a sincronização pelo host está bem. Nunca as duas.
Se queres saber exatamente o que o teu hypervisor está a dizer a uma dada VM sobre o tempo, pergunta-lhe em vez de adivinhares:
# Everything Proxmox actually passes to QEMU for this VM, including -rtc and CPU flags
qm showcmd <vmid> --pretty
A solução em QEMU/KVM: ptp_kvm
Para guests Linux em KVM há uma resposta como deve ser, e não é «mais servidores NTP».
O ptp_kvm deixa o guest perguntar ao host que horas são, diretamente, através de uma hypercall: KVM_HC_CLOCK_PAIRING em x86, e uma chamada de firmware equivalente em arm64.
O kernel apresenta isso como um dispositivo de relógio de hardware PTP, por isso no espaço de utilizador parece uma fonte de relógio de precisão como outra qualquer, e o chrony pode usá-lo como relógio de referência.
As propriedades que importam:
- Sem rede. Sem jitter, sem assimetria, sem stratum, sem pacotes. O caminho é uma fronteira de memória.
- Abaixo do microssegundo. A precisão é limitada pela hypercall, não por uma ida e volta através de um centro de dados.
- Contorna a parte avariada. O guest não está a contar nada nem a estimar uma ida e volta. Está a ler um valor que o host calculou com um relógio que esteve a correr o tempo todo.
Implementação
Aplica isto a todas as VMs Linux que tenham o driver. O hypervisor anfitrião precisa de NTP ou PTP próprio a funcionar. O ptp_kvm entrega ao guest a hora do host, por isso herda o erro do host.
1. Carrega o módulo do kernel no arranque.
# /etc/modules-load.d/ptp_kvm.conf
ptp_kvm
2. Dá-lhe um nome estável e deixa o chrony lê-lo.
# /etc/udev/rules.d/90-ptp-kvm.rules
ACTION=="add", SUBSYSTEM=="ptp", ATTR{clock_name}=="kvm", SYMLINK+="ptp_kvm", GROUP="chrony", MODE="0660"
O symlink importa porque a numeração dos dispositivos PTP não é estável. O /dev/ptp0 pode ser o relógio de uma placa de rede num arranque e o relógio KVM no seguinte. Fazer a correspondência pelo clock_name apanha o certo sempre.
3. Aponta o chrony para ele e retira as pools.
Edita /etc/chrony/chrony.conf em Debian e Ubuntu, ou /etc/chrony.conf na família RHEL. Apaga as linhas pool e usa:
refclock PHC /dev/ptp_kvm poll 2 stratum 1 delay 0.0004
Retirar as pools não é arrumação opcional. Deixá-las lá pede ao chrony que concilie uma referência local abaixo do microssegundo com servidores na internet a dezenas de milissegundos, e as fontes da internet só podem piorar a resposta.
4. Reinicia e verifica.
systemctl restart chronyd # or chrony, on Debian/Ubuntu
Verificar
# The symlink exists and points at the KVM clock
ls -l /dev/ptp_kvm
cat /sys/class/ptp/ptp*/clock_name

# chrony should be using PHC0 as its selected source
chronyc sources -v

# and the offset should be microseconds, not milliseconds
chronyc tracking
No chronyc sources, o refclock PHC aparece como #* PHC0 depois de selecionado. O # marca uma referência de hardware local em vez de um par na rede, e o * marca-o como o que está em uso.
Se o vires listado mas não selecionado, o chrony não o aceitou: verifica as permissões no dispositivo e se o grupo chrony na regra udev corresponde ao utilizador com que o chrony corre de facto na tua distribuição.
Ressalvas
- O host tem de estar certo. Isto faz o guest concordar com o host, o que só é útil se o host concordar com a realidade. Dá aos hypervisors NTP ou PTP a sério.
- Todos os guests precisam disto. Um parque em que metade das VMs usa
ptp_kvme a outra metade usa pools da internet é um parque com duas autoridades de tempo. - A migração a quente não é problema, e é precisamente o objetivo. Depois de migrar, o guest lê o relógio do novo host. Desde que os hosts concordem entre si, o guest nunca vê um salto.
- Só KVM. É uma hypercall do KVM. Hypervisors aninhados ou de outro tipo não apresentam o dispositivo, e a regra udev simplesmente não dispara. É uma falha limpa em vez de uma resposta errada em silêncio.
O que não fazer
- Não forces a fonte de relógio. Deixa o
kvm-clockem paz. Forçartscouhpetna linha de comandos do kernel do guest troca um relógio paravirtual concebido para esta situação por um contador que nunca foi teu. - Não corras
ntpdatenemhwclocka partir do cron. Isso é um salto com horário marcado, que é exatamente o que as bases de dados e o Kerberos detestam. - Não mantenhas as pools «como alternativa». Com um refclock a funcionar não são uma alternativa, são uma segunda opinião de uma fonte pior.
- Não subas o
mon_clock_drift_allowede digas que está resolvido. Gastaste parte de um orçamento que existe para a realidade da rede, para tolerar um problema que tem solução conhecida.
Esta última merece ser dita com todas as letras: alargar o limiar não é arranjar o relógio. É mudar o alarme de sítio para que deixe de tocar.
Referências
- Linux kernel — KVM timekeeping — porque é que o tempo do guest se atrasa, o problema do TSC como relógio local, e a conclusão de que só existem compromissos
- Linux kernel — PTP_KVM — a interface de hypercall por trás do dispositivo de relógio PTP
- Linux kernel — KVM x86 hypercalls —
KVM_HC_CLOCK_PAIRING, o lado x86 - chrony — chrony.conf — a diretiva
refclocke as opções do driver PHC - MIT Kerberos — krb5.conf —
clockskewe o seu valor por omissão de 300 segundos - Microsoft — support boundary for high accuracy time — os objetivos de precisão, e as condições de utilização do CPU do host para sistemas virtualizados
- Ceph — health checks —
MON_CLOCK_SKEW,mon_clock_drift_allowede a sua relação common_lease