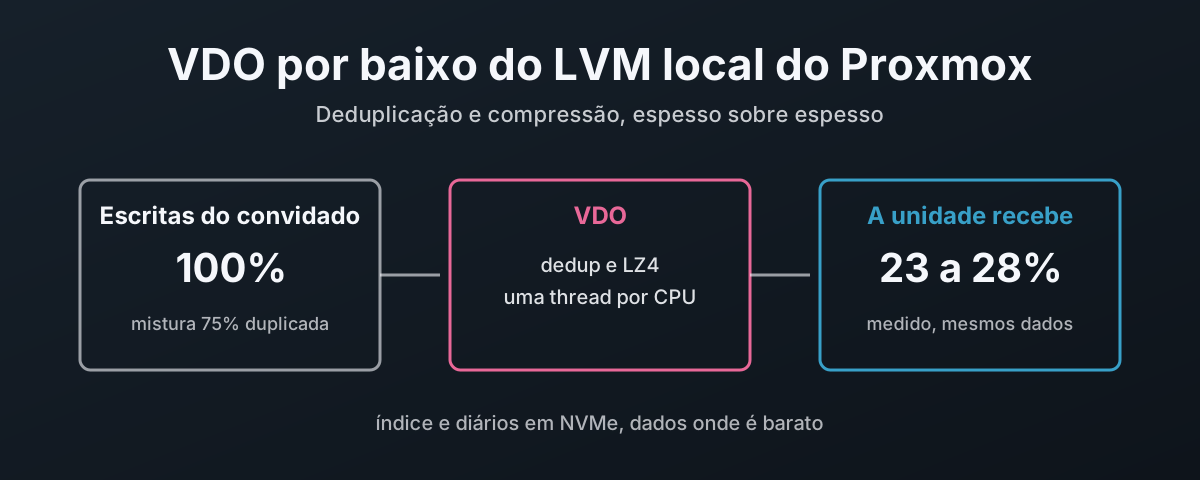
Chegam menos bytes à unidade
O VDO é a camada de deduplicação e compressão do kernel Linux. Fica por baixo de um grupo de volumes e trabalha em blocos de 4 KiB. Cada bloco que já viu antes, guarda-o uma só vez.
O que isso significa para o hardware é simples. Chegam menos bytes à unidade. Escrevi através do VDO uma mistura que era 75% duplicada e 50% compressível, 30 segundos de cada vez, e os contadores da própria unidade disseram que ela recebeu 23 a 28% do que o convidado escreveu. Seis clones completos de um disco de modelo acrescentaram 8 blocos de dados entre todos. Trinta e dois kilobytes.
Menos bytes é menos desgaste, e menos trabalho para qualquer cache na unidade ou no controlador à frente dela. Para lá chegar custa CPU e latência, e numa unidade rápida esse custo é medido mais abaixo face ao mesmo Optane sem VDO nenhum. Em discos rotativos lentos, o mesmo custo desaparece nos tempos de procura, e é aí que isto fica interessante.
Há duas regras que moldam tudo o que se segue. A pilha é espesso sobre espesso: nada por cima do VDO, nem o próprio VDO, pode prometer mais espaço do que a unidade tem. E os metadados do próprio VDO, o índice e os diários, podem viver em NVMe enquanto os dados vivem num sítio mais lento.
Todos os números aqui vêm de um único anfitrião Proxmox VE 9.2, um Ryzen 7 5700G com 16 CPUs, kernel 7.0.14-25-pve, LVM 2.03.31 e as ferramentas vdo 8.3.1.1 da Debian, em duas unidades Intel Optane que foram apagadas no fim.
O que é o VDO e onde fica
O kernel descreve o dm-vdo como um alvo device-mapper que «provides block-level deduplication, compression, and thin provisioning»1. Cada bloco de 4 KiB que entra é passado por uma função de hash. Se um bloco idêntico já estiver guardado, o VDO regista uma referência em vez de uma cópia. Os blocos que não são duplicados passam pelo LZ4 e são empacotados vários num bloco físico, e os blocos só com zeros nem sequer são guardados2.
É o LVM que conduz tudo.
O lvcreate --type vdo cria um pool VDO, que guarda os blocos reais, e um LV VDO por cima dele com o tamanho virtual que pedires2.
Um grupo de volumes espesso vai para cima do LV VDO, e o Proxmox usa-o como armazenamento lvm normal.
| Camada | Nome no laboratório | O que faz |
|---|---|---|
| Discos das VMs | vm-9901-disk-0 e por aí fora | LVs espessos, criados pelo Proxmox |
| Grupo de volumes | vdovg, 35 GiB | LVM simples, o que o armazenamento lvm do Proxmox lê |
| LV VDO | vdolab/vdolv, 35 GiB virtuais | deduplicação, LZ4, blocos de zeros descartados |
| Pool VDO | vdolab/vdopool, 40 GiB | os blocos reais, os metadados e o índice do VDO |
| Físico | nvme8n1 | VG vdolab |
Espesso sobre espesso, ou nada
O VDO é ele próprio um aprovisionador fino: ao LV VDO pode ser dado qualquer tamanho virtual. Torna-o maior do que o pool consegue guardar e o grupo de volumes por cima fica espesso sobre uma promessa, o que é fino sobre fino descido uma camada. Fiz exatamente isso na primeira construção, um LV VDO de 120 GiB num pool de 40 GiB, e o Proxmox mostrava um terço do armazenamento livre enquanto o VDO estava cheio.
Por isso dimensiona o LV VDO para o que o pool consegue realmente endereçar, nada mais.
O lvcreate imprime esse número, «can address 36.00 GB» neste pool de 40 GiB, e o mapa de blocos do VDO para o espaço lógico sai do mesmo espaço, por isso dei-lhe 35 GiB.
Depois provei-o da maneira difícil. Um disco de VM a ocupar todas as extensões que o Proxmox lhe deu, 34 GiB, cheio de ponta a ponta com dados aleatórios com os quais o VDO não pode fazer nada:
# vdostats --human-readable
Device                    Size      Used Available Use% Space saving%
vdolab-vdopool-vpool     40.0G     38.1G      1.9G  95%            0%
O disco esgotou-se no seu próprio fim, como um disco espesso deve. O VDO ainda tinha 1,9 GiB livres, mais do que o 1 GiB que o Proxmox ainda tinha para atribuir. O número do Proxmox é o limite real, e o VDO não pode esgotar-se primeiro.
O que perdes é o sobrecompromisso: o espaço que a deduplicação poupa aparece como unidade que nunca chega a ser escrita, não como discos extra para o Proxmox. É a troca certa para este artigo, que é sobre o hardware. E também não ponhas um pool lvmthin por cima. Duas camadas finas são dois livros de contas3.
Quanto custa antes de guardares um byte
O VDO mantém um índice de deduplicação, o índice UDS, no próprio pool.
Um pool vazio de 40 GiB reportava 4,0 GiB usados e 36,0 GiB disponíveis.
O vdolistmetadata, do mesmo pacote vdo, lista todos os blocos de metadados do dispositivo, e explica quase tudo:
| Região | Blocos de 4 KiB | Tamanho |
|---|---|---|
| Índice UDS | 679 127 | 2,59 GiB |
| Diário de recuperação | 32 768 | 128 MiB |
| Contagens de referências e diários, 18 slabs | 6372 | 25 MiB |
| Espaço pequeno demais para um décimo nono slab | 336 555 | 1,28 GiB |
| Total | cerca de 4,0 GiB |
Vale a pena saber a linha das sobras: os slabs têm 2 GiB, por isso dimensiona o pool em slabs inteiros mais a sobrecarga, ou o resto fica simplesmente por usar.
A RAM é a outra fatura. Paga-se esteja o pool ocupado ou parado:
| Custo | Regra do lvmvdo(7) | Este pool de 40 GiB |
|---|---|---|
| Fixo | 38 MiB | 38 MiB |
| Cache do mapa de blocos | 1,15 MiB por MiB de cache, mínimo 150 MiB | 150 MiB (128 MiB por omissão) |
| Espaço físico | 268 MiB por TiB | 11 MiB |
| Índice UDS (denso) | mínimo 250 MiB, o valor por omissão | 256 MiB |
| Total | cerca de 455 MiB |
O índice denso por omissão cobre uma janela de deduplicação de cerca de 256 GiB, já que um índice denso com 1 GiB de RAM «maintains a 1 TiB deduplication window»2. A cache de 128 MiB do mapa de blocos está dimensionada para «efficient access to 100 GB of logical space at a time», e a documentação do kernel aponta-a como o valor mais importante a ajustar à medida que o conjunto de trabalho cresce1.
Construir a pilha
Deixar o LVM ver um PV num LV
O grupo de volumes fica num LV, e por omissão o LVM ignora LVs como volumes físicos.
O devices/scan_lvs liga isso, e a referência do LVM traz o aviso que vem com ele: «Caution is required to avoid using PVs that belong to guest images stored on LVs»4.
Um convidado que use LVM dentro do seu próprio disco veria, de outra forma, os seus grupos de volumes aparecerem no anfitrião.
Por isso o filtro também muda. Na mesma edição. O filtro de origem neste anfitrião só rejeitava zvols ZFS e dispositivos RBD. Acrescentei uma rejeição para todos os discos de VM do Proxmox:
# lvmconfig devices/global_filter devices/scan_lvs
global_filter=["r|/dev/zd.*|","r|/dev/rbd.*|","r|/dev/mapper/.*-(vm|base)--[0-9]+--disk--[0-9]+|"]
scan_lvs=1
A mesma referência diz que o scan_lvs «does not enable autoactivation of layered VGs»4.
O Proxmox não precisa disso. O seu plugin LVM ativa cada disco com lvchange -aey quando a VM arranca5.
Testei-o da forma como um arranque deixa as coisas, tudo desativado e depois as mesmas execuções udev do pvscan: o VG por baixo do VDO subiu, e o qm start ativou ele próprio o disco da VM.
O senão está por baixo. Com o VG por baixo do VDO incompleto, o mesmo qm start falhou com «Volume group “vdovg” not found».
O pool VDO, espesso, com as definições na linha de criação
O formatador está no pacote vdo da Debian6:
# apt install vdo
Depois o pool.
O -L é o espaço real, o -V o tamanho virtual, mantido dentro do que o pool consegue endereçar.
A disposição das threads e o tamanho do discard vão na mesma linha, porque nenhum dos dois pode ser mudado depois sem parar todas as VMs do pool:
# pvcreate /dev/nvme8n1
  Physical volume "/dev/nvme8n1" successfully created.
# vgcreate vdolab /dev/nvme8n1
  Volume group "vdolab" successfully created
# lvcreate -y --type vdo -L 40G -V 35G -n vdolv vdolab/vdopool /dev/nvme8n1 --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  Wiping vdo signature on /dev/vdolab/vdopool.
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "vdolv" created.
# dmsetup table vdolab-vdopool-vpool
0 73402368 vdo V4 /dev/dm-7 10485760 4096 32768 16380 deduplication on compression on maxDiscard 4096 ack 1 bio 2 bioRotationInterval 64 cpu 3 hash 2 logical 4 physical 4
A disposição das threads é a que é medida mais abaixo para um anfitrião de 16 CPUs; o max_discard=4096 tem a sua própria secção.
O grupo de volumes e o armazenamento do Proxmox
# pvcreate /dev/vdolab/vdolv
  Physical volume "/dev/vdolab/vdolv" successfully created.
# vgcreate vdovg /dev/vdolab/vdolv
  Volume group "vdovg" successfully created
# pvesm add lvm vdo-lvm --vgname vdovg --content images,rootdir --on-volume-remove discard=1
# pvesm status | grep -E "Name|vdo-lvm"
Name             Type     Status     Total (KiB)      Used (KiB) Available (KiB)        %
vdo-lvm           lvm     active        36696064               0        36696064    0.00%
O on-volume-remove discard=1 importa, e é tratado mais abaixo.
O que a deduplicação poupou
Escrevi coisas que um anfitrião Proxmox guarda de facto e li os contadores de blocos do VDO depois de cada uma.
logical blocks used é o que as camadas de cima escreveram; data blocks used é o que o VDO guardou. Ambos em blocos de 4 KiB.
| O que foi escrito | Blocos lógicos acrescentados | Blocos de dados acrescentados | Poupado |
|---|---|---|---|
| Rootfs do Rocky Linux 10, ext4 num disco de 4 GiB | 114 505 | 60 537 | 47% |
Seis clones completos dele (qm clone --full, cerca de 4 s cada) | 6 291 456 | 8 | 99,9999% |
| ISO do Proxmox Datacenter Manager 1.1, 1,36 GiB | 356 172 | 351 965 | 1,2% |
A sua reconstrução -auto, praticamente os mesmos bytes | 356 399 | 40 | 99,99% |
| 4 GiB de zeros | 1 048 575 | 0 | 100% |
| 1 GiB de dados aleatórios | 262 143 | 262 144 | 0% |
Cada clone escreveu os 4 GiB todos, zeros incluídos, porque um clone completo para um LV espesso copia todos os blocos. O VDO guardou os zeros como nada e o resto como referências.
O VDO é muito bom com dados que já viu antes. E com o nada. É inútil com dados que já estão comprimidos ou cifrados, e é por isso que a primeira ISO, sobretudo squashfs, poupou 1,2%.
Com o modelo e os seus seis clones no lugar, o Proxmox mostrava o armazenamento 80,01% usado, 28 GiB de discos espessos em 35. A unidade tinha 4,3 GiB, e a maior parte disso era o índice. Em armazenamento espesso é esse o ponto: o Proxmox conta o que foi atribuído, e a unidade carrega o que é realmente diferente.
O que a unidade recebe realmente
As poupanças em disco são uma fotografia. O hardware importa-se com o fluxo.
Por isso medi os bytes que chegam à unidade durante a escrita: fio durante 30 segundos, o contador de escritas da unidade em /sys/block antes e depois, o mesmo Optane com e sem VDO, duas vezes cada.
O contador é honesto. Ao longo de toda a execução somou 794 GB, e o «Data Units Written» do SMART da própria unidade também se moveu 794 GB.
| Carga, 30 s | Sem VDO | Com VDO, 16 threads | Bytes que chegam à unidade |
|---|---|---|---|
| Escrita aleatória 4k, QD32, 4 trabalhos, 75% dup, 50% compress | 582 013 IOPS, p99 244 µs | 460 887 IOPS, p99 1,05 ms | 28% |
| Escrita 128k, QD8, 75% dup, 50% compress | 2345 MiB/s, p99 490 µs | 2179 MiB/s, p99 1,02 ms | 23% |
| Escrita aleatória 4k, QD32, 4 trabalhos, dados aleatórios | 571 721 IOPS | 272 366 a 381 005 IOPS | 59 a 100% |
| Escrita 128k, QD8, dados aleatórios | 2346 MiB/s | 1051 a 1854 MiB/s | 100% |
Numa mistura realista, o VDO manteve 79 a 93% do débito da unidade nua e enviou-lhe um quarto dos bytes. Com dados completamente aleatórios não poupa nada e custa muito, e as duas execuções discordaram tanto que só dou o intervalo.
A latência de cauda é o processamento do próprio VDO, não a unidade. Um p99 de cerca de um milissegundo, contra um quarto disso sem VDO.
O Optane não tem cache para aliviar
Estas unidades dizem-no elas próprias: vwc 0 no nvme id-ctrl, write through em /sys/block.
Um Optane escreve no lugar sem área de passagem em DRAM ou SLC, por isso neste hardware o ganho são os bytes e o desgaste, não uma cache da unidade que enche mais devagar.
Um SSD NAND com cache SLC, ou um controlador RAID com cache write-back, é onde menos bytes também compram capacidade de resposta. É a secção de RAID6 mais abaixo.
Ajustar as threads do VDO às CPUs
De origem, o LVM dá ao VDO dez threads: uma lógica, uma física, uma de zona de hash, duas de CPU, quatro de submissão bio, uma de confirmação. Num anfitrião de 16 CPUs isso deixa a maior parte da máquina parada enquanto o trabalho do mapa de blocos do VDO fica em fila atrás de uma única thread lógica.
A documentação do kernel explica os botões1. As threads lógicas são cada uma dona de «a disjoint section of the block map», as físicas de «a disjoint section of the data blocks», e ambas «can increase throughput», enquanto threads a mais «can waste resources and increase contention». As threads lógicas vão até 60, as físicas até 16, e o pool precisa de pelo menos um slab por thread física. Com 18 slabs, este tem espaço.
| Disposição | logical | physical | hash | cpu | bio | ack | Total |
|---|---|---|---|---|---|---|---|
| Valores por omissão do LVM | 1 | 1 | 1 | 2 | 4 | 1 | 10 |
| Ajustada a 16 CPUs | 4 | 4 | 2 | 3 | 2 | 1 | 16 |
| O dobro disso | 8 | 8 | 4 | 6 | 2 | 2 | 30 |
Cada disposição correu os mesmos trabalhos fio duas vezes, intercalados, com dados aleatórios, mais os sete discos clone lidos ao mesmo tempo, da forma como sete VMs arrancam juntas:
| Teste, média de duas execuções | Por omissão | Ajustada a 16 CPUs | O dobro disso |
|---|---|---|---|
| Escrita aleatória 4k, QD32, 4 trabalhos | 292 466 IOPS | 365 314 IOPS | 302 461 IOPS |
| p99 da escrita aleatória 4k, 4 trabalhos | 2,1 a 3,7 ms | 1,5 a 1,6 ms | 2,1 a 2,2 ms |
| Escrita sequencial 1M | 1153 MiB/s | 1729 MiB/s | 1507 MiB/s |
| Leitura aleatória 4k, QD32, 4 trabalhos | 507 450 IOPS | 503 827 IOPS | 485 263 IOPS |
| Sete discos clone lidos ao mesmo tempo | 7,5 s | 3,1 s | 3,4 s |
A disposição ajustada ao número de CPUs ganha quase tudo: mais um quarto de escritas paralelas, mais metade nas escritas sequenciais, sete discos lidos 2,4 vezes mais depressa, e uma cauda mais apertada. Duplicar outra vez é pior em toda a linha. É a contenção de que a documentação avisa. Os valores por omissão foram também os menos estáveis, com a leitura dos sete discos a oscilar entre 6,1 e 8,8 s de uma execução para a outra.
Como tal, a regra é uma thread do VDO por CPU, distribuídas pelos tipos como acima, com as threads físicas limitadas pelo número de slabs.
Quanto custa o VDO em hardware rápido
O mesmo Optane sem VDO, contra o VDO com as threads ajustadas, dados aleatórios, média de duas execuções:
| Teste | Optane, sem VDO | VDO, 16 threads |
|---|---|---|
| Escrita aleatória 4k, QD1 | 42 294 IOPS, 19,4 µs | 55 806 IOPS, 12,1 µs |
| Escrita aleatória 4k, QD32 | 142 416 IOPS | 144 292 IOPS |
| Escrita aleatória 4k, QD32, 4 trabalhos | 572 293 IOPS | 365 314 IOPS |
| Leitura aleatória 4k, QD1 | 55 276 IOPS, 14,4 µs | 27 988 IOPS, 31,4 µs |
| Leitura aleatória 4k, QD32, 4 trabalhos | 586 463 IOPS | 503 827 IOPS |
| Escrita sequencial 1M, QD8 | 2348 MiB/s | 1729 MiB/s |
| Sete discos de modelo lidos ao mesmo tempo | 11,1 s | 3,1 s |
Lê-o sem rodeios. Uma única leitura aleatória demora mais do dobro através do VDO. As escritas aleatórias paralelas perdem mais de um terço, as escritas sequenciais um quarto. Numa unidade tão rápida, os 17 µs de trabalho extra do VDO por leitura são a maior parte da leitura.
A escrita QD1 ser mais rápida através do VDO não é um almoço grátis. Longe disso. O VDO confirma uma escrita antes de ela estar na unidade, e a documentação do kernel diz claramente que «unflushed writes may or may not persist after a crash»1. Esse número mede uma confirmação. Um convidado que faça flush, e todos os sistemas de ficheiros fazem, recebe a durabilidade que pede.
A linha dos sete discos é a que o VDO ganha sem discussão, e vale a pena perceber porquê. Sete cópias simples têm de ler 28 GiB de bytes reais, zeros incluídos. O VDO lê um conjunto de blocos partilhados e salta os zeros.
Portanto, em flash rápido, o VDO troca latência por bytes. Cada um desses microssegundos é custo fixo, porém, e não cresce quando a unidade por baixo fica mais lenta.
Pôr os metadados do VDO em NVMe
O VDO não tem um dispositivo de metadados separado. Tudo vive no único LV do pool. Mas o código-fonte do dm-vdo mostra que a disposição é fixa, e um LV pode ser construído a partir de pedaços em unidades diferentes.
O código de formatação coloca as raízes do mapa de blocos a partir do início da região de dados, depois o resumo dos slabs e o diário de recuperação a partir do fim, e enche o meio com slabs7.
O índice UDS fica antes de tudo isso, logo a seguir ao bloco de geometria.
O vdolistmetadata confirmou-o no pool do laboratório:
| Blocos | O quê | Onde fica |
|---|---|---|
| 0 a 679 188 | geometria, índice UDS, superbloco, raízes do mapa de blocos | os primeiros 2,59 GiB |
| dentro de cada slab de 2 GiB | dados, folhas do mapa de blocos, 130 blocos de referências e um diário de slab de 224 blocos | espalhados pelo pool |
| 10 452 928 a 10 485 695 | diário de recuperação | os últimos 128 MiB, quase |
| 10 485 696 a 10 485 759 | resumo dos slabs | os últimos 256 KiB de todos |
Por isso constrói o LV do pool em três pedaços: a cabeça em NVMe, o meio na unidade lenta, a cauda em NVMe.
Depois converte-o num pool VDO, o que o lvmvdo(7) documenta para um LV existente2.
Aqui o nvme6n1 faz de NVMe e o nvme8n1 de unidade lenta:
# lvcreate -y -L 3G -n splitpool vdolab /dev/nvme6n1
  Logical volume "splitpool" created.
# lvextend -l +9408 vdolab/splitpool /dev/nvme8n1
  Size of logical volume vdolab/splitpool changed from 3.00 GiB (768 extents) to 39.75 GiB (10176 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvextend -l +64 vdolab/splitpool /dev/nvme6n1
  Size of logical volume vdolab/splitpool changed from 39.75 GiB (10176 extents) to 40.00 GiB (10240 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvconvert -y --type vdo-pool -n splitlv -V 35G vdolab/splitpool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  WARNING: Converting logical volume vdolab/splitpool to VDO pool volume with formatting.
  THIS WILL DESTROY CONTENT OF LOGICAL VOLUME (filesystem etc.)
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "splitlv" created.
  Converted vdolab/splitpool to VDO pool volume and created virtual vdolab/splitlv VDO volume.
Depois confirma que o VDO pôs os metadados onde estão as extensões:
# vdolistmetadata /dev/mapper/vdolab-splitpool_vdata | grep -v "slab [0-9]* \(reference\|journal\)"
0 .. 0: geometry block
1 .. 679127: index
679128 .. 679128: super block
679129 .. 679188: block map tree roots
10452928 .. 10485695: recovery journal
10485696 .. 10485759: slab summary
Uma extensão são 1024 blocos. A cabeça em NVMe são as extensões 0 a 767, blocos 0 a 786 431, o que cobre o índice e as raízes, com cerca de 420 MiB dos dados do primeiro slab à boleia. A cauda em NVMe são as extensões 10 176 a 10 239, blocos 10 420 224 em diante, o que cobre o diário de recuperação e o resumo dos slabs.
Quanto do trabalho do VDO vai com eles, por execução de 30 segundos, contado por dispositivo:
| Carga | I/Os de escrita no NVMe | I/Os de escrita na unidade de dados | Fatia do NVMe |
|---|---|---|---|
| Escrita aleatória 4k, 75% dup, 50% compress | 388 430 a 538 223 | 3,42 a 3,63 milhões | 10 a 13% |
| Escrita 128k, 75% dup, 50% compress | 458 214 a 634 167 | 3,30 a 3,53 milhões | 12 a 15% |
| Escrita aleatória 4k, dados aleatórios | 181 457 a 384 507 | 3,25 a 8,49 milhões | 4 a 5% |
| Leitura aleatória 4k | 0 escritas, 2% das leituras | 0 |
Mais ou menos um décimo das operações de escrita: o diário de recuperação, as atualizações do índice, e aquela fatia do slab 0 na cabeça em NVMe. São escritas de metadados pequenas e dispersas, o tipo que um disco rotativo pior aguenta. Em NVMe não são nada.
Dois limites.
Os metadados por slab, contagens de referências, diários de slab e folhas do mapa de blocos, vivem dentro dos slabs, e ficam com os dados.
E não testei aumentar um pool dividido. O diário é colocado a partir do fim, por isso depois de qualquer lvextend corre o vdolistmetadata outra vez e vê para onde foi antes de confiares nele.
VDO sobre bcache: um NVMe, dois trabalhos
O bcache é a outra maneira de pôr flash à frente de discos lentos. É o que já uso por baixo do Ceph em unidades rotativas, com todas as definições explicadas no artigo sobre o bcache. Por isso a pergunta é o que o VDO faz a uma cache bcache quando fica por cima dela.
Um NVMe faz os dois trabalhos de flash, dividido em duas partições:
| Dispositivo | Tamanho | Trabalho |
|---|---|---|
nvme8n1p1 | 32 GiB | cache do bcache, writeback |
nvme8n1p2 | 8 GiB | cabeça e cauda do VDO: índice, raízes, diário de recuperação, resumo dos slabs |
nvme6n1 | 349 GiB | dispositivo de suporte do bcache, onde vivem os dados |
/dev/bcache0 | 349 GiB | o meio do pool VDO, os slabs |
As duas unidades são outra vez Optanes, por isso o nvme6n1 está a fazer de disco rotativo.
Tem isso em mente em todos os números abaixo. O dispositivo de suporte aqui é rápido, por isso isto mede o que chega à cache, não quanto tempo um disco demora a esvaziá-la.
As partições e o conjunto de cache, com as definições desse artigo:
# sgdisk --zap-all /dev/nvme8n1
# sgdisk -n 1:0:+32G -c 1:bcache-cache -n 2:0:+8G -c 2:vdo-meta /dev/nvme8n1
# blockdev --rereadpt /dev/nvme8n1
# apt install bcache-tools
# make-bcache -C /dev/nvme8n1p1 -B /dev/nvme6n1 --writeback
# B=/sys/block/bcache0/bcache
# echo 0 > $B/sequential_cutoff
# echo 40 > $B/writeback_percent
# echo 81920 > $B/writeback_rate
# echo 20480 > $B/writeback_rate_minimum
# CS=/sys/fs/bcache/47bac36f-a1d5-4e8e-8695-2e7ff944172d
# echo 0 > $CS/congested_read_threshold_us
# echo 0 > $CS/congested_write_threshold_us
Essas linhas echo duram até ao próximo arranque. A regra udev do artigo sobre o bcache é o que as faz ficar.
Depois o pool, dividido da mesma forma que acima, com o nvme8n1p2 para as duas pontas e o bcache0 para o meio:
# pvcreate /dev/bcache0 /dev/nvme8n1p2
# vgcreate vdolab /dev/bcache0 /dev/nvme8n1p2
# lvcreate -y -L 3G -n vdopool vdolab /dev/nvme8n1p2
# lvextend -l +9408 vdolab/vdopool /dev/bcache0
# lvextend -l +64 vdolab/vdopool /dev/nvme8n1p2
# lvconvert -y --type vdo-pool -n vdolv -V 35G vdolab/vdopool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
# lvs -a --segments -o lv_name,lv_size,segtype,seg_start_pe,seg_size_pe,devices vdolab
  LV              LSize  Type     Start SSize Devices
  vdolv           35.00g vdo          0  8960 vdopool(0)
  vdopool         40.00g vdo-pool     0 10240 vdopool_vdata(0)
  [vdopool_vdata] 40.00g linear       0   768 /dev/nvme8n1p2(0)
  [vdopool_vdata] 40.00g linear     768  9408 /dev/bcache0(0)
  [vdopool_vdata] 40.00g linear   10176    64 /dev/nvme8n1p2(768)
O vdolistmetadata imprimiu os mesmos intervalos de blocos que a construção dividida, por isso o índice e os dois diários ficam no nvme8n1p2.
O vdovg e o armazenamento do Proxmox vão para cima exatamente como antes.
O que chega à cache
A comparação é um LV de 8 GiB diretamente no bcache0 contra um LV de 8 GiB no vdovg, os mesmos trabalhos fio durante 30 segundos, duas vezes, com a cache esvaziada e limpa entre cada execução.
Os contadores dos dispositivos em /sys/class/block dizem para onde foram os bytes.
| 75% dup, 50% compress, 30 s | Só bcache | VDO sobre bcache |
|---|---|---|
| Escrita aleatória 4k, QD32, 4 trabalhos | 212 222 e 205 585 IOPS | 390 206 e 304 757 IOPS |
| p99 | 1,89 e 2,04 ms | 1,45 e 2,54 ms |
| O convidado escreveu | 24,29 e 23,53 GiB | 44,67 e 34,88 GiB |
| Escrito na cache do bcache | 25,00 e 24,26 GiB | 11,48 e 10,44 GiB |
| Escrito na partição de metadados do VDO | 1,18 e 0,59 GiB | |
| Escritas na cache por byte do convidado | 103% | 26 e 30% |
| Deixado sujo na cache no fim | 6,0 e 6,5 GiB | 5,5 e 5,2 GiB |
| Escrita 128k, QD8 | 2001 e 1985 MiB/s | 1878 e 1416 MiB/s |
| Escritas na cache por byte do convidado, 128k | 101% | 24 e 27% |
O bcache sozinho chegou ao máximo de cerca de 210 000 escritas pequenas por segundo, e escreveu cada byte na cache mais 3% seus. Põe o VDO à frente e a cache recebeu um quarto dos bytes. Na primeira execução, a mesma cache aguentou então 390 206 escritas por segundo, quase o dobro, e mesmo assim acabou com menos dados sujos à espera da unidade lenta. A cache era o limite. O VDO mudou-o de sítio.
A segunda execução é a honesta para um pool que já está em uso. O fio semeia os seus geradores da mesma maneira em todas as execuções, por omissão8, por isso a segunda execução escreveu dados que o índice já tinha visto, a apontar para blocos que entretanto tinham sido descartados. O VDO trata o índice como pistas e lê cada bloco candidato para verificar que é mesmo um duplicado antes de o partilhar9. Durante um teste só de escrita, essa segunda execução leu 7,11 GiB de volta da cache e 1,20 GiB da unidade de dados. A primeira leu 0,12 GiB. Um conselho desatualizado não é de graça, e num pool onde as VMs vêm e vão vai haver sempre algum.
Os dados aleatórios são o outro lado da questão:
| Dados aleatórios, 30 s | Só bcache | VDO sobre bcache |
|---|---|---|
| Escrita aleatória 4k, QD32, 4 trabalhos | 205 984 e 203 066 IOPS | 203 186 e 85 882 IOPS |
| p99 | 2,04 e 2,15 ms | 5,7 e 17,7 ms |
| Escrita 128k, QD8 | 2038 e 2017 MiB/s | 878 e 357 MiB/s |
| Leitura aleatória 4k, QD1 | 36 609 e 36 639 IOPS, 21,6 µs | 26 345 e 26 202 IOPS, 33,6 e 33,7 µs |
| Leitura aleatória 4k, QD32, 4 trabalhos | 471 585 e 471 730 IOPS | 335 461 e 336 941 IOPS |
Nada para poupar, por isso o VDO é pura sobrecarga, e na execução com o índice desatualizado mais do que reduziu para metade as escritas pequenas. Todas as leituras nas duas colunas vieram da cache. Os 12 µs a mais do VDO são o mesmo custo fixo que acrescenta no Optane nu.
Portanto, onde os dados se repetem, os dois empilham-se bem. A cache recebe um quarto dos bytes, aguenta uma rajada durante mais tempo, e tem menos para escrever de volta para os discos. Onde não se repetem, o bcache fica melhor sozinho.
Em RAID6 de hardware com HDD: raciocinado, não medido
Não tenho nenhum anfitrião com RAID6 em HDD onde testar, por isso esta secção é raciocínio construído sobre as medições acima. Mede o teu próprio array antes de confiares nela.
| Em RAID6 com HDD | O que o VDO muda |
|---|---|
| Escritas que chegam ao array | cerca de um quarto, numa mistura como a que foi medida |
| Cache write-back do controlador | enche a um quarto do ritmo, por isso aguenta uma rajada cerca de quatro vezes mais tempo |
| Custo de CPU do VDO | 17 µs por leitura, perdidos dentro de uma procura de 5 a 10 ms |
| Escritas do diário de recuperação | mais ou menos um décimo dos I/Os de escrita, pequenas e com flush: põe-nas em NVMe |
| Consultas ao índice | vigia o dedupe advice timeouts no vdostats; em armazenamento lento o VDO pode desistir de procurar e escrever o duplicado na mesma |
| Ler um clone do princípio ao fim | mais lento: os seus blocos apontam para os do modelo, espalhados pelo array |
As duas primeiras linhas são a resposta do hardware. Enquanto a cache do controlador, com bateria ou com flash, tem espaço, o convidado vê a latência da cache. Quando enche, o convidado vê os discos. Manda-lhe um quarto dos bytes e a mesma cache dá cerca de quatro vezes a folga, e tem um quarto para esvaziar. A secção do bcache acima é isso medido com uma cache em software no lugar da do controlador.
A terceira é a razão pela qual o VDO pertence mais aos discos lentos do que aos rápidos. No Optane, o VDO duplicou a latência de leitura. Em unidades de 7200 rpm, o mesmo custo fixo desaparece numa procura.
As três últimas são os custos. Uma tempestade de arranque de clones idênticos fica mais rápida, mas um clone lido de ponta a ponta fica mais lento, porque a deduplicação o espalha. E as pequenas escritas do próprio VDO também caem no array, que é o argumento a favor da disposição dividida acima: índice e diário em NVMe, slabs no RAID6.
Apagar um disco: fazer o Proxmox descartá-lo
Remover um LV liberta as suas extensões no LVM. Não diz ao VDO que os blocos estão por usar, por isso o VDO fica com eles. A documentação do kernel diz porque é que isso importa: «If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space»1. Em armazenamento espesso não se pode esgotar, mas os blocos não descartados continuam a ser espaço de unidade reservado para dados que não são de ninguém.
A opção on-volume-remove discard=1 no armazenamento é a solução. O Proxmox descreve-a como emitir «discard (TRIM) requests before removal»5:
| Apagar | Blocos VDO libertados |
|---|---|
armazenamento lvm simples, um disco com 1 GiB | 0 |
com on-volume-remove discard=1, o mesmo | 262 140, o 1 GiB todo |
Mas é lento num disco grande.
Apagar o disco de 34 GiB do teste de enchimento levou 262,6 s ao Proxmox, enquanto o blkdiscard no mesmo tipo de dados despachou 15 GiB em 2,25 s.
Por isso, para tudo o que for grande, faz blkdiscard ao disco primeiro e depois apaga-o.
O tamanho do discard também importa. O max_discard por omissão do VDO é um bloco de 4 KiB por pedido1:
| Discard de 15 GiB de dados aleatórios | Tempo decorrido | CPU (sys) |
|---|---|---|
max_discard=1, o valor por omissão | 8,06 s | 8,06 s |
max_discard=4096, 16 MiB | 2,25 s | 0,00 s |
Dentro dos convidados, liga a opção Discard da unidade para que o TRIM deles chegue ao armazenamento10, e corre o fstrim de forma agendada.
Onde merece o seu lugar
| Serve | Não serve |
|---|---|
| muitas VMs a partir dos mesmos poucos modelos | bases de dados e trabalho limitado pela latência em profundidade |
| RAID6 em HDD atrás de uma cache write-back do controlador | um anfitrião todo NVMe que precisa de cada microssegundo |
| dados em discos rotativos com um NVMe para os metadados do VDO | dados já comprimidos: multimédia, cópias de segurança, ISO |
| bcache à frente de dados rotativos, onde os dados se repetem | bcache à frente de dados que não se repetem |
| unidades em que a resistência à escrita é o limite | discos de convidados cifrados, que nunca deduplicam |
| um anfitrião com meio gigabyte de RAM de sobra por pool | um pool pequeno, onde o índice come um décimo |
| Definição | Por omissão | Define-a como | Mudá-la depois |
|---|---|---|---|
Tamanho virtual do VDO -V | o que pedires | não mais do que o pool consegue endereçar | só aumentar, nunca encolher |
| Threads do VDO | 10, uma lógica | uma por CPU, distribuídas como acima | só com as VMs do pool paradas |
max_discard | 1, que são 4 KiB | 4096, que são 16 MiB | só com as VMs do pool paradas |
on-volume-remove no armazenamento | não definido | discard=1 | sim, pvesm set |
| Discard em cada disco virtual | desligado | ligado | sim, por disco |
scan_lvs e o filtro | 0, sem rejeição de discos de VM | 1, discos de VM rejeitados | sim, no lvm.conf |
Nada disto é difícil. Nada disto é o valor por omissão.
A escrita mais barata é a que nunca envias
O que me impressiona no VDO é quão mal ele é vendido. Aparece como uma maneira de pôr num disco mais do que o disco guarda, e essa é a coisa menos útil que faz. Fi-lo sem querer na primeira construção, e o Proxmox mostrava um terço do armazenamento livre enquanto o VDO estava cheio. O sobrecompromisso é um empréstimo, e a unidade cobra-o à velocidade máxima de escrita.
O valor real está na linha que a maior parte das pessoas nunca mede. Um quarto dos bytes a chegar à unidade é um quarto do desgaste e uma cache do controlador que dura quatro vezes mais. Isso não é capacidade. É o hardware a fazer menos trabalho para o mesmo resultado, que é o único tipo de poupança que não volta para te morder.
Custa CPU, e em flash rápido custa latência, e ambos são fixos. É essa a troca, dita sem rodeios: tempo de processador gasto para que a parte lenta e cara da máquina faça menos. Em discos rotativos atrás de um controlador RAID ou de um bcache, com o índice e o diário num NVMe, essa conta sai bem. Num anfitrião todo Optane, na maior parte dos casos não sai.
E não toma conta de si próprio. Todos os valores por omissão que importam estão errados para este trabalho: dez threads em dezasseis CPUs, um tamanho de discard que queima um núcleo, um tamanho virtual que se pode pôr em qualquer coisa, e nada na configuração do armazenamento a dizer ao Proxmox para devolver espaço. Nada disso está escondido. Está tudo na documentação.
Por isso constrói-o espesso, uma vez, como deve ser, com as definições na linha de criação e os metadados onde pertencem. Faz isso e a unidade faz um quarto do trabalho. Salta isso e compraste mais uma camada que promete mais do que tem.
Linux kernel documentation — dm-vdo — o alvo «provides block-level deduplication, compression, and thin provisioning»; «If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space»; «unflushed writes may or may not persist after a crash»; a cache de 128 MB do mapa de blocos permite «efficient access to 100 GB of logical space at a time»; os parâmetros das threads, os seus limites e as orientações de afinação; maxDiscard «in 4096-byte blocks». ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
lvmvdo(7) — Support for Virtual Data Optimizer in LVM — pool VDO e LV VDO, a conversão de um LV existente com
lvconvert --type vdo-pool, o uso de memória, o índice denso e a sua janela de 1 TiB por GiB de RAM, e «You cannot reduce the size of a VDOPoolLV». ↩︎ ↩︎ ↩︎ ↩︎Linux kernel source — drivers/md/dm-thin.c — o
disable_discard_passdown_if_not_supported()desliga a passagem do discard quando o dispositivo de dados não consegue receber um bloco fino inteiro, que é o que o valor por omissão do VDO faz por baixo de um thin pool. ↩︎LVM2 — conf/example.conf.in —
devices/scan_lvs: «Caution is required to avoid using PVs that belong to guest images stored on LVs» e «This option does not enable autoactivation of layered VGs». ↩︎ ↩︎Proxmox pve-storage — LVMPlugin.pm — a propriedade
on-volume-remove, «Use ‘discard=1’ to issue discard (TRIM) requests before removal»; os volumes são ativados individualmente comlvchange -aeyem vez devgchange -aly. ↩︎ ↩︎Debian trixie — package vdo — «Management tools for Virtual Data Optimizer», versão 8.3.1.1-1, que fornece o
vdoformat, ovdostatse ovdolistmetadata. ↩︎Linux kernel source — drivers/md/dm-vdo/encodings.c — o
vdo_initialize_layout()cria a partição do mapa de blocos no início, as partições do resumo dos slabs e do diário de recuperação no fim, e o depósito de slabs com o que sobra. ↩︎fio documentation — randrepeat — «Seed all random number generators in a predictable way so the pattern is repeatable across runs. Default: true.» ↩︎
Linux kernel documentation — Design of dm-vdo — «vdo treats the locations in the index as hints, and reads each indicated block to verify that it is indeed a duplicate before sharing the existing block with a new one.» ↩︎
Proxmox VE documentation — Qemu/KVM Virtual Machines, Trim/Discard — «For the guest to be able to issue TRIM commands, you must enable the Discard option on the drive.» ↩︎