O problema
Isto surgiu durante um trabalho com um cliente em que estávamos a desenhar uma implementação de Proxmox VE com passthrough de NVMe para uma carga de trabalho sensível à latência.
O cliente tinha feito o seu próprio benchmarking antes da chamada.
No host, o fio contra o disco NVMe reportava 700K IOPS de leitura aleatória com latência de conclusão abaixo dos 10µs.
Dentro da VM, com o mesmo disco e o mesmo teste, obtinham mais ou menos metade disso.
Já tinham verificado as coisas óbvias. O disco não tinha mudado. O firmware não tinha mudado. A ranhura PCIe não tinha saído do sítio. Começavam a perguntar-se se o passthrough era de todo a abordagem errada.
Não era. O que estavam a ver é o imposto do IOMMU. Apanha muita gente desprevenida porque ninguém te fala dele antes de te comprometeres com um desenho baseado em passthrough. A boa notícia é que a maior parte da sobrecarga é recuperável, assim que percebes de onde vem.
Em profundidade
Os problemas que tinham de ser resolvidos
Dar a uma VM acesso direto a um dispositivo PCIe físico parece simples. Na prática, é um dos problemas mais difíceis da virtualização de sistemas. Algumas coisas que funcionam sozinhas em bare metal tornam-se perigosas quando um dispositivo é partilhado entre um host e um convidado.
Isolamento de DMA
Este é o problema fundamental.
Os dispositivos PCIe não passam pelo CPU para ler e escrever na memória. Usam Direct Memory Access. Escrevem diretamente em endereços físicos da RAM. Em bare metal, não há problema. O dispositivo e o sistema operativo confiam um no outro.
Com virtualização, a VM convidada tem a sua própria visão da memória física. Os endereços que o driver do convidado entrega ao controlador NVMe são endereços físicos do convidado. Não correspondem às mesmas posições na RAM do host. Se o dispositivo os usar diretamente, lê e escreve na memória errada. Isso corrompe o host, outras VMs, ou ambos.
Pior ainda, um driver convidado malicioso ou com erros poderia programar deliberadamente o dispositivo para fazer DMA para qualquer parte da memória do host. Na prática, isso é acesso root à máquina inteira sem nunca explorar um erro do hipervisor.
A solução é o IOMMU — uma unidade de tradução em hardware (Intel VT-d, AMD-Vi) que fica entre cada dispositivo PCIe e a memória principal. Mantém as suas próprias tabelas de páginas, separadas das do CPU. Cada pedido de DMA do dispositivo passa pelo IOMMU, que traduz endereços físicos do convidado em endereços físicos do host e bloqueia qualquer acesso fora das regiões de memória atribuídas ao convidado.
Sem o IOMMU, um passthrough seguro é impossível. Com ele, o dispositivo fica contido.
Agrupamento de dispositivos
O IOMMU não isola dispositivos individuais. Isola grupos.
A especificação PCIe define os Access Control Services (ACS), que determinam se os dispositivos no mesmo barramento podem falar diretamente uns com os outros — DMA ponto a ponto — sem passar pelo root complex onde está o IOMMU. Se dois dispositivos partilham um switch PCIe que não impõe ACS, um deles pode fazer DMA para o espaço de memória do outro, contornando por completo o IOMMU.
O kernel agrupa num único grupo IOMMU os dispositivos que se podem alcançar uns aos outros sem a fiscalização do IOMMU. Se o teu controlador NVMe partilha um grupo com outro dispositivo, passar apenas o NVMe quebra o modelo de isolamento. O outro dispositivo do grupo continuaria a poder servir de canal lateral à volta do IOMMU.
Hardware de classe servidor, com suporte ACS correto em cada bridge e switch, dá normalmente a cada dispositivo o seu próprio grupo. As placas de consumo e de workstation juntam muitas vezes vários dispositivos, porque o root complex PCIe não implementa ACS em todas as portas.
O Proxmox inclui um patch do kernel — pcie_acs_override — que diz ao kernel para tratar cada dispositivo como isolado, independentemente do suporte ACS do hardware.
Na prática funciona, mas está a mentir ao kernel sobre a topologia do hardware.
Num sistema de produção, grupos limpos sustentados por ACS real no hardware são sempre preferíveis.
Entrega de interrupções
Em bare metal, quando um controlador NVMe conclui uma operação de IO, dispara uma interrupção MSI-X diretamente para o CPU. O CPU trata-a em poucas centenas de nanossegundos.
Com virtualização, essa interrupção tem de chegar ao convidado, não ao host. A abordagem ingénua é intercetar cada interrupção no hipervisor, provocar uma saída da VM, injetar a interrupção no convidado e retomar. Funciona, mas cada saída da VM custa 5–20µs. Com IOPS altos — centenas de milhares de interrupções por segundo — a sobrecarga é substancial.
A solução em hardware são as interrupções postadas (posted interrupts). O APICv da Intel e o AVIC da AMD permitem ao IOMMU escrever a interrupção diretamente na página APIC virtual do convidado sem provocar qualquer saída da VM. O convidado vê a interrupção como se viesse de hardware em bare metal. A sobrecarga desce para poucas centenas de nanossegundos.
Nem todas as plataformas suportam interrupções postadas. CPUs mais antigos, alguns chipsets de workstation e algumas versões de BIOS não expõem a capacidade. Quando faltam, cada interrupção vai pelo caminho lento, e não há solução em software.
Reposição do dispositivo
Quando uma VM se desliga ou falha, o dispositivo passado tem de voltar a um estado limpo e conhecido. Caso contrário, não pode ser reatribuído a outra VM nem recuperado pelo host.
Em bare metal, o sistema operativo desliga o driver do dispositivo de forma ordenada. Com passthrough, o convidado pode falhar, o utilizador pode forçar a paragem da VM, ou o hipervisor pode matar o processo. O dispositivo pode estar a meio de uma transferência, com operações de DMA em curso.
O PCIe define o Function Level Reset (FLR) para isto — uma forma de repor uma única função de um dispositivo sem afetar o resto do barramento. Os controladores NVMe geralmente suportam FLR e lidam bem com ele. As GPUs são notoriamente más nisto, mas isso é outro artigo.
Se o FLR não for suportado, a alternativa é uma reposição do barramento secundário, que repõe tudo o que está por trás dessa bridge PCIe. Se a bridge tiver outros dispositivos, também são todos repostos. No pior caso, um reinício completo do host é a única forma de recuperar o dispositivo.
Sobrecarga da tradução de endereços
O IOMMU resolve o problema da segurança. Como tal, não é opcional. Mas introduz um problema de desempenho.
Cada operação de DMA passa agora por um nível extra de tradução de endereços. O IOMMU tem o seu próprio TLB — o IOTLB — e, quando acerta, a sobrecarga é pequena. Quando falha, o IOMMU tem de percorrer as suas tabelas de páginas, e isso acrescenta latência real a cada operação de IO afetada.
Este é o imposto do IOMMU. O resto deste artigo trata de perceber de onde vem e como o minimizar.
Mapeamento de BARs e espaço de endereços
Cada dispositivo PCIe expõe um ou mais Base Address Registers (BARs), que mapeiam os registos internos e a memória do dispositivo no espaço de endereços MMIO do host. O CPU do host acede ao dispositivo através destes mapeamentos. Para o passthrough funcionar, o hipervisor tem de apresentar estes mapeamentos corretamente ao convidado.
Tradicionalmente, os tamanhos dos BARs eram fixados no arranque pela BIOS e cabiam na janela MMIO legada de 32 bits abaixo dos 4GB. Isso funcionava enquanto os BARs eram pequenos. As GPUs modernas mudaram o cenário. Um framebuffer de 24GB precisa de um BAR de 24GB, que não cabe num espaço de endereços de 32 bits.
O Resizable BAR (ReBAR) — também comercializado como AMD Smart Access Memory (SAM) — é uma capacidade PCIe que permite renegociar o tamanho do BAR depois do arranque. Para as GPUs, é uma funcionalidade importante. Em vez de aceder ao framebuffer por uma janela de 256MB e ir paginando por blocos, o host mapeia a VRAM inteira de uma só vez.
Para o NVMe, o impacto direto é menor. Os BARs dos controladores NVMe têm normalmente entre 16KB e 64KB para o conjunto de registos do controlador (BAR0). A especificação NVMe define um Controller Memory Buffer (CMB) que pode expor um BAR maior para filas de submissão residentes no host, mas a maioria dos discos não o implementa. O ReBAR não altera o débito do NVMe da forma que altera nas GPUs.
A razão pela qual importa num contexto de passthrough de NVMe é o ambiente PCIe partilhado. Se estás a passar um disco NVMe ao lado de uma GPU no mesmo host, o BAR redimensionado da GPU precisa de espaço de endereços acima do limite dos 4GB. A BIOS, o IOMMU e a topologia PCIe virtual têm todos de acomodar isso. Errar a atribuição do espaço de endereços significa que os dispositivos não inicializam, e o passthrough do NVMe falha juntamente com tudo o resto.
Exposição a falhas de energia
Num disco virtual, o hipervisor e a camada de armazenamento tratam da ordem das escritas e da consistência após falhas. Com passthrough, o convidado fala diretamente com a flash. Se o host perder a energia a meio de uma escrita, o que o firmware do controlador NVMe faz — ou não faz — com a sua cache de escrita determina se perdes dados.
Os discos NVMe empresariais têm condensadores de proteção contra falhas de energia (PLP) que esvaziam a cache de escrita em segurança durante um corte de energia. Os discos de consumo sem PLP podem não o fazer. Com passthrough, não há rede de segurança do hipervisor entre o convidado e o hardware.
Para uma carga de trabalho de produção, um disco empresarial com PLP não é opcional.
Compromissos operacionais
O passthrough também retira capacidades que os discos virtuais oferecem.
Um dispositivo passado fica fisicamente preso a um host específico. A VM não pode ser migrada em direto enquanto o dispositivo estiver ligado. Num cluster Proxmox com HA, a falha de um nó significa que a VM vai abaixo e arranca a frio noutro nó. Não há failover transparente.
O disco também é invisível para o vzdump e para o Proxmox Backup Server.
Não será incluído nos snapshots da VM nem nas cópias de segurança agendadas.
É preciso ter uma estratégia de cópias de segurança separada — ao nível do convidado, do sistema de ficheiros ou da aplicação — antes de a carga de trabalho entrar em produção.
Como o passthrough VFIO funciona de facto
Quando passas um dispositivo PCIe a uma VM, o hipervisor dá ao convidado o controlo direto dos registos MMIO do dispositivo. O driver do convidado fala com o controlador NVMe como se estivesse a correr em bare metal. Essa parte é quase nativa. O acesso aos registos MMIO passa pelas Extended Page Tables (EPT na Intel, NPT na AMD) e normalmente conclui-se sem uma saída da VM.
O caminho do DMA é onde aparece o custo. Cada operação de DMA passa pelo IOMMU para a tradução de endereços e, como descrito acima, essa tradução tem um preço. Sobretudo nas falhas do IOTLB.
Porque é que os benchmarks parecem piores do que a realidade
É aqui que a maioria das pessoas erra nos testes.
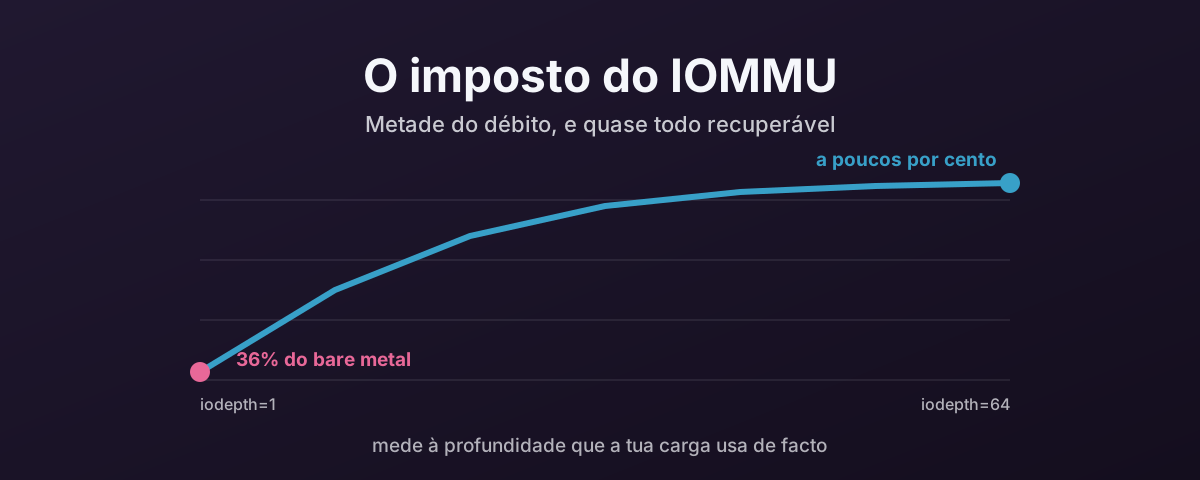
Uma discussão no fórum do Proxmox que deu origem a este artigo tinha utilizadores a correr o fio com iodepth=1.
Com essa profundidade de fila, o fio submete um IO, espera que termine e depois submete o seguinte.
O teste está apenas a medir a latência por IO.
Cada microssegundo de sobrecarga do IOMMU aparece por inteiro.
Os números dessa discussão contam a história com clareza.
A latência de conclusão em bare metal rondava em média os 10µs.
Dentro da VM, rondava em média os 28µs.
Esses ~18µs extra por IO são a sobrecarga da tradução do IOMMU.
Com iodepth=1, corta diretamente o débito para metade, porque o débito é igual a 1 / latency quando só há um IO em curso.
Sobe a profundidade de fila para 32 ou 64 — que é como os discos NVMe foram desenhados para funcionar — e o cenário muda. Com vários IOs em curso, a sobrecarga do IOMMU é amortizada por todos eles. O controlador processa conclusões enquanto acontecem novas traduções. O débito recupera para poucos por cento do bare metal.
A conclusão prática é esta. Se a tua carga de trabalho corre com profundidades de fila acima de 4, a penalização de débito do IOMMU é provavelmente desprezável. Isso cobre a maioria das cargas de bases de dados, virtualização e armazenamento. Se a tua carga de trabalho é sensível à latência com profundidades de fila baixas — certas aplicações de tempo real, operações síncronas de metadados — vais senti-la.
Corre os teus benchmarks com profundidades de fila realistas antes de concluíres que o passthrough é demasiado lento:
# Bare metal baseline — run on the host before binding to vfio-pci
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting

# Same test inside the VM after passthrough
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Compara os percentis de clat (latência de conclusão) e os números de IOPS.
Com iodepth=32 e quatro jobs, a diferença deve ser de um só dígito em pontos percentuais, não de 50%.
Alinhamento NUMA
Isto tem o seu próprio artigo. Vê Alinhamento NUMA no Proxmox VE — porque importa e como o acertar.
A versão curta: em sistemas com vários sockets, cada dispositivo PCIe está ligado a um socket específico. Se o disco NVMe estiver no nó NUMA 1 e os vCPUs da VM estiverem fixados no nó 0, cada conclusão de DMA atravessa a ligação entre sockets. Isso acrescenta 50–100ns por operação. Com IOPS altos, a diferença de débito entre NUMA alinhado e desalinhado é de 20–30%.
Verifica com cat /sys/bus/pci/devices/0000:XX:00.0/numa_node e depois fixa os vCPUs da VM em núcleos do mesmo nó com o parâmetro affinity na configuração da VM.
Em sistemas com um só socket, isto não é uma preocupação.
PCIe Active State Power Management (ASPM)
Isto tem o seu próprio artigo. Vê O ASPM do PCIe e porque o deves desativar para passthrough.
A versão curta: o ASPM permite que as ligações PCIe entrem em estados de baixo consumo quando estão inativas.
Com passthrough, o host continua a controlar a ligação física, mas é o convidado que é dono do dispositivo.
Quando o convidado submete IO e a ligação está adormecida, o tempo de despertar acrescenta latência.
O sintoma é uma grande dispersão nos teus percentis de clat. O p99 pode ser 5–10x mais alto do que a média, enquanto a média parece normal.
Desativa-o no host com pcie_aspm=off na linha de comandos do kernel.
Acrescenta também disable_idle_d3=1 às opções do módulo vfio-pci se o teu controlador NVMe tiver problemas a recuperar de estados de energia. O Samsung 990 EVO Plus é um infrator conhecido.
MaxPayloadSize (MPS)
Isto tem o seu próprio artigo. Vê O MaxPayloadSize do PCIe — um ganho de desempenho gratuito para passthrough.
A versão curta: os dispositivos PCIe transferem dados em Transaction Layer Packets.
O root complex virtual do QEMU usa por omissão um payload máximo de 128 bytes.
A maioria dos dispositivos suporta 256 ou 512 bytes.
Acrescentar pci=pcie_bus_perf à linha de comandos do kernel do host define o MPS no máximo que o barramento pai de cada dispositivo permite.
É uma pequena melhoria de débito — um só dígito baixo em percentagem — mas é gratuita e não tem desvantagens.
Resizable BAR e abertura MMIO
O problema de mapeamento de BARs descrito antes tem passos práticos tanto do lado da BIOS como do lado da VM.
Primeiro, ativa o Above 4G Decoding na BIOS. Isto permite mapear os BARs em espaço de endereços acima do limite dos 4GB, o que é obrigatório para qualquer dispositivo com BARs grandes. Ativa-o mesmo para passthrough só de NVMe. Não tem desvantagens e evita problemas se mais tarde acrescentares uma GPU ou outro dispositivo com BAR grande.
Se o ReBAR estiver disponível na BIOS, ativa-o também. Não afeta diretamente o desempenho do NVMe, mas permite que as GPUs no mesmo host usem o mapeamento completo do seu framebuffer.
Do lado da VM, o root complex Q35 virtual do QEMU precisa de uma janela MMIO de 64 bits suficientemente grande para o convidado ver os BARs redimensionados. Por omissão, o OVMF atribui uma janela relativamente pequena. Para passthrough só de NVMe, isto chega. Os BARs do NVMe cabem com folga. Mas se a VM tiver tanto um NVMe como uma GPU passados, aumenta a abertura MMIO:
args: -fw_cfg name=opt/ovmf/X-PciMmio64Mb,string=65536
Isto diz ao OVMF para atribuir 64GB de espaço MMIO de 64 bits, o suficiente para a maioria dos framebuffers de GPU ao lado do pequeno BAR do controlador NVMe.
O suporte de ReBAR no QEMU tem vindo a melhorar, mas ainda não é transparente. Algumas GPUs AMD (Vega e mais recentes) provocam erros no driver (Code 43 no Windows) com o ReBAR ativo no QEMU. Se te acontecer, desativa o ReBAR na BIOS como primeiro passo. O passthrough do NVMe não é afetado de uma forma ou de outra.
Para o que o Resizable BAR faz do lado das GPUs, e porque é que a Intel o trata como obrigatório na Arc enquanto a NVIDIA o ativa jogo a jogo, vê O Resizable BAR do PCIe e as GPUs modernas.
Tratamento de interrupções
O problema da entrega de interrupções descrito antes tem um passo prático de afinação. As interrupções postadas (APICv na Intel, AVIC na AMD) podem não estar ativas por omissão.
Verifica se estão ativas:
# Intel — look for "Posted-Interrupts" in dmesg
dmesg | grep -i "posted"

# AMD — check AVIC support
dmesg | grep -i "avic"
Em sistemas AMD EPYC, ativa o AVIC no módulo KVM se não estiver ligado por omissão:
# /etc/modprobe.d/kvm.conf
options kvm_amd avic=1
Em sistemas Intel, o APICv com interrupções postadas costuma ficar ativo automaticamente quando o VT-d está ativo.
Se a tua plataforma não suporta interrupções postadas, não há solução em software. É uma capacidade do hardware. Mas vale a pena confirmar que está mesmo ligada antes de assumires que o caminho lento é inevitável.
Afinidade de interrupções e alinhamento de filas
Os controladores NVMe usam vários pares de filas de submissão e de conclusão. Normalmente um por núcleo de CPU. Quando os vCPUs da VM não estão alinhados com os núcleos físicos que tratam as interrupções do NVMe, as conclusões têm de atravessar núcleos através de interrupções entre processadores. Isso acrescenta latência.
Dentro do convidado, verifica quantas filas de IO o driver NVMe criou e como estão mapeadas:
# List NVMe IO queues
cat /proc/interrupts | grep nvme

# Check affinity
for irq in $(grep nvme /proc/interrupts | awk '{print $1}' | tr -d ':'); do
    echo "IRQ $irq: $(cat /proc/irq/$irq/smp_affinity_list)"
done
Idealmente, a interrupção de cada fila de IO do NVMe deve ter afinidade com o vCPU que submete para essa fila. A maioria dos drivers NVMe modernos trata disto automaticamente. Mas vale a pena confirmar, sobretudo se fixaste vCPUs à mão ou reduziste o número de vCPUs abaixo do número de filas do controlador.
Usa sempre Q35, não i440fx
Isto merece o seu próprio artigo. Vê Usa sempre Q35, não i440fx.
A versão curta: o i440fx apresenta um barramento PCI legado e plano. O Q35 apresenta um root complex PCIe a sério. Os dispositivos passados no i440fx aparecem como PCI legado, o que quebra a entrega de interrupções MSI-X com várias filas. Os controladores NVMe precisam de MSI-X para a sua arquitetura de uma fila por núcleo. Sem ele, todas as conclusões de IO passam por uma única interrupção e ficas com um estrangulamento com IOPS altos que nenhuma afinação do kernel vai resolver.
No Proxmox 8.x e posteriores, o Q35 é o predefinido para VMs novas. Se estás a fazer passthrough numa VM mais antiga que ainda é i440fx, muda-a. O RHEL 10 descontinuou formalmente o i440fx, e o resto do ecossistema KVM vai pelo mesmo caminho.
Juntar tudo
Aqui fica um resumo dos passos de afinação, por ordem de impacto.
Alinhamento NUMA — garante que o disco NVMe e os vCPUs da VM estão no mesmo nó NUMA. Só isto pode representar uma diferença de débito de 20–30% em sistemas com vários sockets.
ASPM desligado — acrescenta pcie_aspm=off à linha de comandos do kernel do host.
Elimina a variação de latência causada pelas transições de estado de energia da ligação PCIe.
Profundidades de fila realistas — testa com iodepth=32 ou mais, não com iodepth=1.
A sobrecarga do IOMMU que domina com profundidades de fila baixas é amortizada com profundidades realistas.
Interrupções postadas — confirma que o APICv (Intel) ou o AVIC (AMD) está ativo. Reduz a sobrecarga por interrupção de microssegundos para nanossegundos.
Otimização do MPS — acrescenta pci=pcie_bus_perf à linha de comandos do kernel do host.
Define o MaxPayloadSize no máximo que a topologia suporta.
Gestão de energia do vfio-pci — acrescenta disable_idle_d3=1 se o teu controlador NVMe tiver problemas de estados de energia com passthrough.
Uma linha de comandos do kernel do host combinada, para um nó Proxmox a fazer passthrough de NVMe num sistema AMD EPYC, seria mais ou menos assim:
GRUB_CMDLINE_LINUX_DEFAULT="quiet amd_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Para Intel:
GRUB_CMDLINE_LINUX_DEFAULT="quiet intel_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Quando o passthrough não compensa
Antes de ires por este caminho, vale a pena perguntares se precisas mesmo de passthrough de NVMe.
O VirtIO-SCSI e o VirtIO-BLK com um disco virtual assente em NVMe já são muito eficientes. A sobrecarga em relação ao passthrough é normalmente de 5–10% na latência. A diferença de débito é desprezável para a maioria das cargas de trabalho.
O passthrough faz sentido quando precisas que o sistema operativo convidado gira o dispositivo diretamente. Isso inclui a monitorização SMART, as atualizações de firmware, o controlo de TRIM/discard e funcionalidades NVMe específicas como as reservas. Também faz sentido para cargas de trabalho sensíveis à latência, onde até poucos microssegundos contam. Certos motores de bases de dados e a ingestão de dados em tempo real cabem nessa categoria.
Para tudo o resto, os compromissos operacionais tratados antes — perda da migração em direto, perda dos snapshots e da integração com as cópias de segurança — costumam pesar mais do que o pequeno ganho de desempenho.
Não há nada de esperto em escolher o caminho mais difícil quando o mais fácil faz o trabalho.
Verificar as tuas alterações
Depois de aplicares os passos de afinação, confirma que está tudo a funcionar como esperado:
# Host side — confirm IOMMU is in passthrough mode
dmesg | grep -i iommu

# Confirm ASPM is disabled
lspci -vv | grep -i "ASPM Disabled"

# Check MPS on the NVMe controller
lspci -vv -s XX:00.0 | grep MaxPayload

# Inside the VM — run the fio comparison
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Compara os resultados da VM com a tua linha de base anterior em bare metal.
Com iodepth=32, deves ver um débito a menos de 5% do bare metal.
As médias da latência de conclusão devem ficar a menos de 10–15µs dos números do host.
Se a diferença continuar grande, verifica primeiro o alinhamento NUMA.
É o fator mais esquecido.
E não custa nada além de uma alteração de configuração, o que faz dele o melhor tipo de problema com que se pode ficar.
Referências
- Linux kernel PCI documentation — MPS and MRRS tuning options — a fonte de referência para
pcie_bus_perf,pcie_bus_safee os parâmetros relacionados - Proxmox VE Administration Guide — PCI(e) Passthrough — documentação oficial do Proxmox sobre a configuração do passthrough de dispositivos com VFIO
- Proxmox Forum — NVMe Passthrough Performance — a discussão da comunidade que deu origem a este artigo