O que é o MPS
Os dispositivos PCIe transferem dados em pacotes chamados Transaction Layer Packets (TLP). Cada TLP tem um cabeçalho e um payload. O tamanho máximo desse payload é o MaxPayloadSize (MPS).
O MPS é negociado entre um dispositivo e a sua bridge a montante durante o treino do link. O valor negociado é o menor entre o que o dispositivo suporta e o que a bridge permite. Cada bridge e cada switch no caminho entre o dispositivo e o root complex tem a sua própria capacidade de MPS. O MPS final de qualquer dispositivo é definido pelo ponto mais estreito da cadeia.
Os valores de MPS comuns são 128, 256 e 512 bytes. Alguns dispositivos suportam 1024 ou até 4096 bytes, mas na prática 256 ou 512 é o típico para controladores NVMe e placas de rede. As GPU suportam muitas vezes 256 bytes.
Porque é que importa
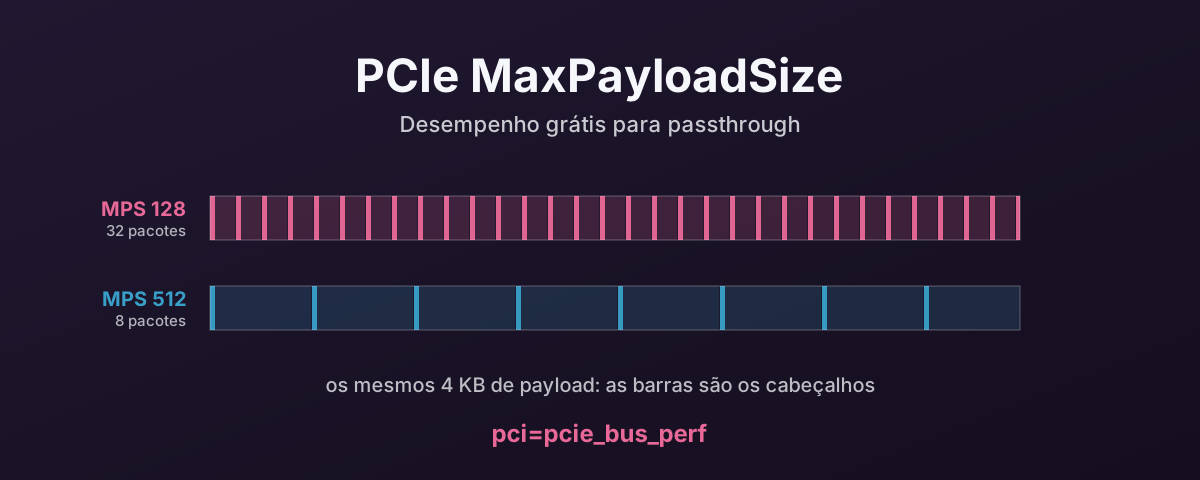
Um MPS maior significa menos pacotes para a mesma quantidade de dados. Um IO de 4 KB transferido com MPS 128 precisa de 32 TLP. A mesma transferência com MPS 512 precisa de 8 TLP.
Cada TLP leva overhead de protocolo: o cabeçalho, o CRC, o enquadramento. Menos TLP significa menos overhead de protocolo por byte transferido. Com débito elevado, essa diferença mede-se. Não é dramática. Mas é real. E é o mesmo overhead, pago em cada pacote.
O MPS também afeta o aproveitamento do link PCIe. Payloads mais pequenos fazem o link gastar mais tempo em cabeçalhos em relação aos dados. Payloads maiores deslocam a proporção para os dados úteis.
O impacto na latência é menor do que no débito. Uma única leitura de 4 KB com MPS 128 contra 512 não vai mostrar uma diferença de latência que valha a pena medir, porque os TLP seguem em pipeline. Mas força muitas IOPS com muitas transferências em curso e o overhead menor de um MPS maior vai somando.
O problema sob passthrough
Em bare metal, a BIOS define o MPS durante o POST com base na topologia PCIe. Uma BIOS de servidor moderna define normalmente o MPS no máximo que a topologia suporta, em geral 256 ou 512 bytes.
Sob QEMU, o root complex do chipset virtual Q35 tem a sua própria capacidade de MPS.
Por omissão, apresenta um MPS baixo.
A política de MPS por omissão do kernel Linux (pcie_bus_default) põe o MPS de cada dispositivo igual ao da sua bridge mãe, o que numa topologia virtual significa o valor por omissão do root complex do QEMU. Muitas vezes 128 bytes.
Como tal, um dispositivo capaz de payloads de 512 bytes trabalha a 128 porque o root complex virtual fixou o teto.
Como corrigir: do lado do host
Diz ao kernel para definir o MPS no máximo que o barramento pai de cada dispositivo suporta:
# Add to GRUB_CMDLINE_LINUX_DEFAULT in /etc/default/grub
pci=pcie_bus_perf
Isto define o MPS de cada dispositivo no maior valor que o seu barramento pai permite. Também define o MRRS (Max Read Request Size) em conformidade. O código-fonte do kernel diz que garante que o MPS de um dispositivo não é maior do que o do pai. Isso mantém a cadeia consistente e obtém os melhores tamanhos de transferência.
Depois de reiniciar, verifica o novo MPS:
# Check MPS on a specific device
lspci -vv -s XX:00.0 | grep -i "MaxPayload"
Deves ver MaxPayload 256 bytes ou MaxPayload 512 bytes em vez do 128 por omissão.
As outras opções do kernel
O kernel oferece cinco políticas de MPS, cada uma definida com o parâmetro de arranque pci=:
pcie_bus_tune_off: não mexe no MPS.
Usa o que a BIOS tiver definido.
Em bare metal com uma boa BIOS, isto muitas vezes chega.
Sob QEMU, a BIOS é OVMF ou SeaBIOS, que podem não otimizar o MPS.
pcie_bus_default: o valor por omissão do kernel.
Põe o MPS de cada dispositivo igual ao da sua bridge a montante.
Conservador e seguro, mas não maximiza o desempenho.
pcie_bus_safe: define o MPS no maior valor suportado por todos os dispositivos do sistema.
Útil em sistemas fechados onde conheces todos os dispositivos e nada vai ser ligado a quente.
Ligeiramente mais agressivo do que o valor por omissão.
pcie_bus_perf: define o MPS por dispositivo no maior valor que o barramento pai permite.
Cada dispositivo recebe o melhor MPS que a sua topologia local suporta.
É a escolha certa para passthrough porque otimiza cada caminho de forma independente.
pcie_bus_peer2peer: define o MPS em 128 bytes em tudo.
Todos os dispositivos falam no menor tamanho comum.
Usa-se quando os dispositivos precisam de fazer DMA diretamente uns para os outros (GPU para GPU, GPU para NIC via RDMA).
Não serve para passthrough normal.
pcie_bus_perf é o certo para passthrough.
Como corrigir: do lado do guest
Também podes definir pci=pcie_bus_perf na configuração de arranque do kernel do guest.
Se isso tem algum efeito prático depende de como o QEMU apresenta a topologia PCIe virtual.
O root complex virtual limita o que o guest consegue negociar.
Nos testes, a correção do lado do host é a que pega. O host é dono do dispositivo físico, e a sua definição de MPS fixa o tamanho real dos TLP no fio. A definição do guest só mexe na topologia virtual dentro da VM, e se isso muda o comportamento real depende de como o QEMU apresenta o caminho PCIe desse dispositivo.
Define-o no host. Defini-lo também no guest não faz mal, mas não contes só com isso.
O que é o MRRS
O Max Read Request Size (MRRS) está relacionado, mas é outra coisa. O MPS limita quantos dados um dispositivo pode enviar num TLP. O MRRS limita quantos dados um dispositivo pode pedir num pedido de leitura.
Um dispositivo com MRRS 4096 pode emitir um único pedido de leitura de 4 KB. A resposta volta em vários TLP, cada um até ao tamanho do MPS. Um MRRS maior significa que o dispositivo pode pedir mais dados por transação, o que reduz o número de TLP de pedido de leitura no barramento.
pci=pcie_bus_perf define tanto o MPS como o MRRS nos seus valores ótimos.
Não precisas de os afinar em separado.
Impacto face a outras afinações
A diferença de MPS entre 128 e 512 bytes tem um impacto no desempenho menor do que o alinhamento NUMA ou o ASPM. É tipicamente uma melhoria de uma percentagem baixa de um só dígito no débito. Não a vais ver em benchmarks de latência com filas pouco profundas.
Mas é uma otimização grátis. Um parâmetro do kernel, sem desvantagens, sem risco de compatibilidade. Não há razão nenhuma para não o definir em qualquer sistema que faça passthrough.
Não custa nada, e o hardware já está pago. Mais vale teres aquilo que compraste.
Referências
- Linux kernel PCI Kconfig — opções de afinação de MPS e MRRS — fonte de referência para as cinco políticas de MPS
- Linux Plumbers Conference 2017 — MPS vs MRRS (PDF) — a apresentação de Sinan Kaya sobre o tratamento de MPS/MRRS no kernel