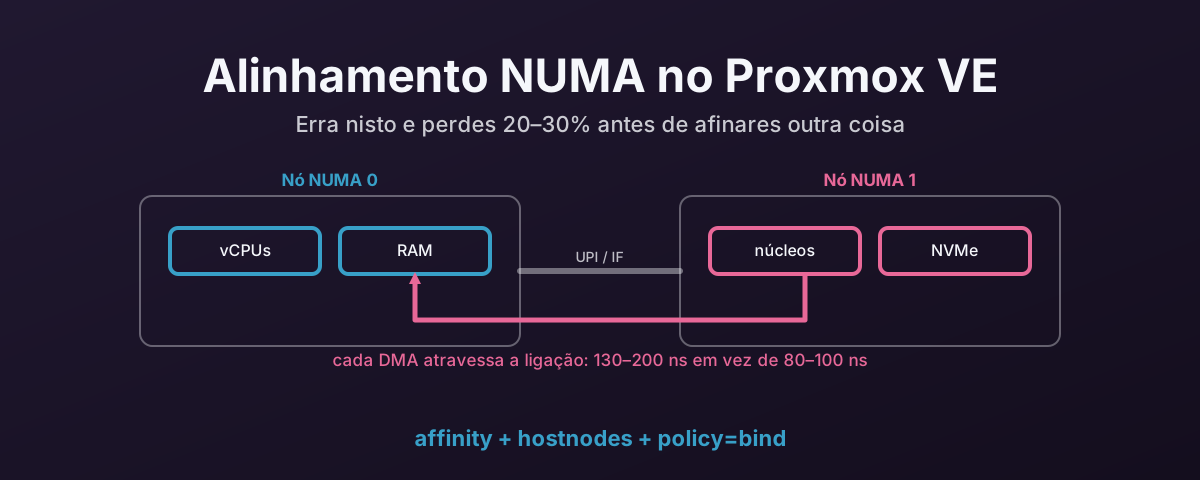
O que é NUMA
NUMA significa Non-Uniform Memory Access, acesso não uniforme à memória. Num sistema de um só socket, todos os núcleos da CPU acedem a toda a RAM do sistema através do mesmo controlador de memória. O tempo de acesso é o mesmo, seja qual for o núcleo que faz o pedido ou o sítio onde os dados estão na memória física.
Num sistema multi-socket, cada socket de CPU tem o seu próprio controlador de memória e o seu próprio banco de RAM. Um núcleo no socket 0 acede depressa à RAM ligada ao socket 0: é a memória local. Também consegue aceder à RAM ligada ao socket 1, mas esse pedido tem de atravessar a ligação entre sockets (Intel UPI, AMD Infinity Fabric). Essa é a memória remota, e é mais lenta.
O kernel chama nó NUMA a cada conjunto de socket e respetiva memória local. Um sistema AMD EPYC de dois sockets tem pelo menos dois nós NUMA. Alguns processadores EPYC expõem quatro nós NUMA por socket (um por CCD), o que dá oito nós numa placa de dois sockets.
A diferença de desempenho entre o acesso à memória local e à remota não é subtil. O acesso local anda pelos 80–100ns. O acesso remoto anda pelos 130–200ns. É uma penalização de 50–100% por cada operação de memória. Sozinho, é um número muito pequeno. Pago em cada acesso à memória durante toda a vida da VM, deixa de ser pequeno.
Porque importa para a virtualização
Quando o Proxmox cria uma VM, atribui vCPUs e RAM. Por omissão, essas vCPUs podem ser escalonadas em qualquer núcleo físico de qualquer socket. A RAM da VM pode ser alocada a partir do conjunto de memória de qualquer nó NUMA.
Se o escalonador põe uma vCPU no socket 0 e a RAM da VM está no socket 1, cada acesso à memória que essa vCPU faz atravessa a ligação entre sockets. Se as vCPUs saltam de socket em socket, e saltam se não estiverem fixadas, o padrão de acesso à memória fica uma confusão. Alguns acessos são locais, outros remotos, e o desempenho da VM oscila em conformidade.
Para cargas genéricas, como um servidor web, um servidor de ficheiros ou uma VM de secretária, isto costuma ser suportável. O custo existe, mas espalha-se por muitas operações e não domina.
Para cargas intensivas em IO, como bases de dados, servidores de armazenamento ou qualquer coisa com muito IO de disco ou de rede, a penalização acumula-se. Cada conclusão de DMA, cada entrega de interrupção, cada cópia de buffer envolve acesso à memória. Se esses acessos atravessam sockets, o custo soma-se depressa.
Porque importa para o passthrough
Os dispositivos PCIe estão fisicamente ligados a um socket de CPU concreto. Cada socket tem o seu próprio root complex PCIe. A unidade NVMe na ranhura 3 pode estar nas linhas PCIe do socket 0. A GPU na ranhura 5 pode estar nas do socket 1.
Quando um dispositivo faz DMA, os dados vão para a memória ligada ao nó NUMA para onde a IOMMU os mapeia. Se a RAM da VM for alocada a partir do nó local do dispositivo, a escrita DMA vai diretamente para a memória local. Se a RAM estiver no outro nó, cada operação DMA atravessa a ligação entre sockets.
Para uma unidade NVMe a fazer centenas de milhares de IOPS, essa penalização de 50–100ns por operação soma-se.
Com iodepth=32 e leituras aleatórias de 4KB, a diferença de débito entre NUMA alinhado e desalinhado pode chegar a 20–30%.
E isto antes de olhares para o custo da IOMMU, para o ASPM, para o MPS ou para qualquer outra coisa.
O mesmo se aplica a placas de rede, GPUs e qualquer outro dispositivo em passthrough. O tráfego DMA do dispositivo deve cair em memória local, e as vCPUs que processam esse tráfego devem estar no mesmo nó.
Como verificar a tua topologia
Descobrir em que nó NUMA está um dispositivo
# Replace 0000:XX:00.0 with your device's PCI address from lspci
cat /sys/bus/pci/devices/0000:XX:00.0/numa_node
Isto devolve o número do nó NUMA.
Se devolver -1, o kernel não conseguiu determinar o nó. Isso acontece por vezes com dispositivos atrás de certos switches PCIe.
Nesse caso, segue a topologia PCIe à mão com lspci -tv e faz corresponder a root port ao socket.
Ver a disposição NUMA completa
numactl --hardware
Isto mostra-te cada nó NUMA, quantos núcleos de CPU tem, quanta memória está ligada e a distância (custo relativo) entre nós.
Exemplo de saída de um sistema EPYC de dois sockets:
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
node 0 size: 131072 MB
node 1 cpus: 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31
node 1 size: 131072 MB
node distances:
node   0   1
  0:  10  32
  1:  32  10
A tabela de distâncias diz-te o custo relativo. 10 é local. 32 é remoto. Números mais altos significam mais saltos. Em configurações EPYC com quatro nós por socket, alguns pares de nós têm distância 32 e outros 16, conforme o CCD em que estão.
Mapear dispositivos para nós
# List all PCI devices and their NUMA nodes
for dev in /sys/bus/pci/devices/*; do
    node=$(cat "$dev/numa_node" 2>/dev/null)
    echo "$(basename $dev) node=$node $(lspci -s $(basename $dev) 2>/dev/null | cut -d' ' -f2-)"
done
Isto dá-te o quadro completo de que dispositivos estão em que nós. Procura os teus controladores NVMe, as placas de rede e as GPUs que estás a passar à VM.
Como alinhar uma VM no Proxmox
Fixar as vCPUs no nó certo
No ficheiro de configuração da VM (/etc/pve/qemu-server/<vmid>.conf):
numa: 1
affinity: 0-15    # Adjust to match cores on the correct NUMA node
O parâmetro affinity fixa as vCPUs da VM a núcleos físicos específicos.
Define-o com o intervalo de núcleos do mesmo nó NUMA que o teu dispositivo em passthrough.
Se o teu NVMe está no nó 1 e o nó 1 tem os núcleos 16–31, define affinity: 16-31.
Se a VM só precisa de 8 vCPUs, fixa-a a um subconjunto: affinity: 16-23.
Alocar a memória a partir do nó certo
Ativar numa: 1 na configuração da VM diz ao Proxmox para apresentar à VM uma topologia NUMA.
O QEMU tenta alocar a memória da VM a partir do nó NUMA onde as vCPUs estão fixadas.
Para controlo explícito, podes definir a topologia NUMA na configuração da VM:
numa0: cpus=0-7,hostnodes=0,memory=16384,policy=bind
Isto diz ao QEMU para associar o primeiro nó NUMA da VM (o nó 0 do ponto de vista do convidado) ao nó NUMA 0 do anfitrião, usando os núcleos 0–7 e 16GB de memória.
O policy=bind garante que a memória é alocada estritamente a partir desse nó, em vez de recorrer a outros nós se o conjunto local estiver sob pressão.
Verificar a fixação
Depois de arrancar a VM, confirma que as vCPUs estão mesmo a correr onde esperas:
# Find the QEMU process
pgrep -a qemu | grep <vmid>

# Check CPU affinity of the process
taskset -cp <pid>

# Or check per-vCPU thread affinity
for tid in $(ls /proc/<pid>/task/); do
    echo "Thread $tid: $(taskset -cp $tid 2>/dev/null)"
done
Erros comuns
Não fixar de todo
Se não definires affinity, as vCPUs da VM podem ser escalonadas em qualquer núcleo.
O escalonador do kernel vai movê-las entre nós para equilibrar a carga.
Sempre que uma vCPU migra de um nó para outro, os dados com que estava a trabalhar na cache do nó antigo passam a ser remotos.
Para VMs genéricas isto é aceitável. Para VMs com passthrough e muito IO, não é.
Fixar no nó errado
Verifica o nó NUMA do dispositivo antes de fixares.
Não presumas.
Em algumas motherboards, a numeração física das ranhuras não corresponde de forma óbvia à atribuição dos nós NUMA.
Confirma sempre com cat /sys/bus/pci/devices/.../numa_node.
Sobrecarregar um nó
Se fixares demasiadas VMs ao mesmo nó NUMA, os núcleos desse nó ficam sobrecarregados e o conjunto de memória local esgota-se. Quando a memória transborda para o nó remoto, ficas com o pior dos dois mundos: vCPUs fixadas com memória remota.
Distribui as VMs pelos nós. Se tens dois nós NUMA e quatro VMs, reparte-as por igual.
Esquecer a alocação de memória
Fixar as vCPUs sem controlar também a alocação de memória dá-te metade do benefício.
As vCPUs estão no nó certo, mas a memória pode não estar.
Usa policy=bind ou, no mínimo, ativa numa: 1 para que a alocação do QEMU acompanhe a fixação das CPUs.
Sistemas de um só socket
Num sistema de um só socket, tudo está no nó NUMA 0. Há apenas um controlador de memória e um conjunto de linhas PCIe. O alinhamento NUMA não é uma preocupação.
Podes na mesma definir numa: 1 na configuração da VM, não estraga nada, mas também não ajuda.
Um socket, um controlador de memória, nada para alinhar.
Guarda o esforço para uma máquina que tenha dois.
Como tal, os ganhos de desempenho aqui descritos aplicam-se apenas a sistemas multi-socket, onde existe a ligação entre sockets.
Referências
- Proxmox VE Administration Guide — CPU and NUMA Configuration — documentação oficial sobre fixação de vCPUs e opções NUMA
- Linux kernel NUMA documentation — referência das políticas de memória do kernel
- AMD EPYC 7003 Series — BIOS & Workload Tuning Guide (doc 58002) — documentação da AMD sobre NUMA por socket e a topologia CCD/CCX