A pergunta com que começa qualquer avaliação do Proxmox
«O Proxmox é mesmo de nível empresarial?»
Surge em quase todas as conversas de migração, e a preocupação por baixo dela quase nunca é a interface web. Ninguém teme a sério que um painel no navegador lhe corrompa os dados. O que as pessoas estão a perguntar é se aquilo que fica entre uma máquina virtual e o hardware — o componente que tem de manter um inquilino fora da memória de outro, para sempre, sem um único erro — é uma peça de engenharia séria ou um projeto comunitário que ficou popular.
É exatamente a coisa certa com que ficar nervoso. Só está apontada à camada errada, porque o Proxmox VE não contém um hipervisor.
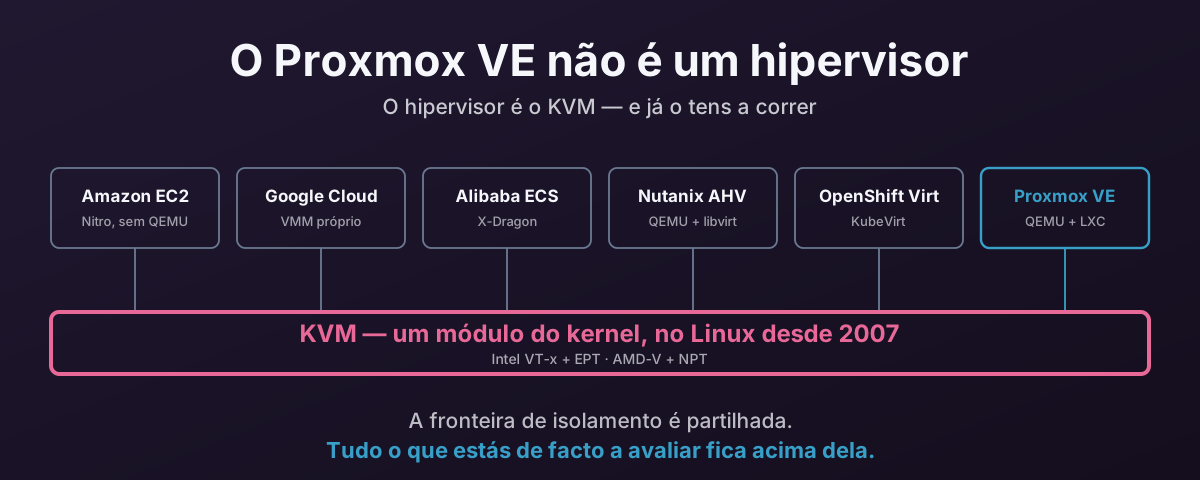
O hipervisor é o KVM. Faz parte do Linux, está lá desde 2007 e, se a tua organização usa EC2, Google Cloud, Oracle Cloud, Alibaba Cloud, DigitalOcean ou Nutanix, já o tens a correr em produção hoje — simplesmente nunca tiveste de pensar nele, porque as camadas de cima eram de outra pessoa.
Este artigo é sobre o que essa base comum significa de facto. As duas metades: a parte do argumento que se aguenta mesmo e a parte que é exagerada nos diapositivos dos fornecedores.
O Proxmox VE é uma camada de gestão
A virtualização em Linux são quatro camadas distintas, construídas e mantidas por quatro grupos diferentes de pessoas.
1. Extensões de virtualização do hardware. Intel VT-x com EPT, ou AMD-V com NPT. Silício. É isto que permite a um convidado correr o seu próprio kernel à velocidade nativa com as suas próprias tabelas de páginas, sem nada a emular instruções.
2. KVM — o hipervisor.
Módulos do kernel: kvm.ko para o núcleo independente da arquitetura, mais kvm-intel.ko ou kvm-amd.ko para as extensões do fabricante. É este o componente dono da fronteira de isolamento. Prepara as estruturas de controlo da máquina virtual do convidado, trata as saídas de VM, gere as tabelas de páginas de segundo nível e entrega as interrupções.
3. O VMM — o monitor de máquinas virtuais, em espaço de utilizador. No Proxmox VE é o QEMU. Constrói a placa-mãe virtual: chipset, topologia PCIe, discos, placas de rede, portas série, firmware. O KVM corre o CPU; o QEMU decide que hardware o convidado julga ter.
4. A camada de gestão.
É o Proxmox VE: pve-manager e pveproxy para a API e a interface, qemu-server para transformar um ficheiro de configuração de VM numa linha de comandos do QEMU, pve-container para o LXC, pmxcfs por cima do Corosync para a configuração replicada do cluster, pve-ha-manager para o fencing e o reinício, mais a firewall e a pilha SDN.
Essas quatro camadas também existem na plataforma de onde estás a migrar, a fazer os mesmos quatro trabalhos — o vCenter é a camada 4, o VMkernel é a camada 2 — e volto a essa comparação quando as peças estiverem todas em cima da mesa.
O que o Proxmox mantém de facto
O Proxmox VE é dono da camada 4 por inteiro. Mas seria errado dizer que se limita a empacotar as camadas 2 e 3, e essa é a leitura errada mais comum do que a empresa faz.
O pve-qemu traz 78 patches contra o QEMU upstream no seu ficheiro series, no momento em que escrevo:
debian/patches/series. A maior parte da fila é engenharia do próprio Proxmox, e toda ela fica na camada 3 — nenhum destes patches toca no kvm.ko.Também compilam o seu próprio kernel, e mantêm empacotamento ou patches para a maior parte da pilha à volta — pve-edk2-firmware para o OVMF, mais lxc, zfsonlinux, openvswitch, libiscsi, corosync-pve, lvm e ceph.
Portanto a fronteira real é: toda a camada 4, engenharia substancial dentro da camada 3 e um kernel que eles compilam. O que não fizeram foi escrever um hipervisor. O código KVM da camada 2 é Linux upstream.
E nada disto é uma crítica ao Proxmox. Como tal, é a razão por que se pode confiar o trabalho a uma empresa do tamanho do Proxmox. Uma pequena empresa em Viena não se sentou a escrever um hipervisor de raiz; construiu sobre um que a Intel, a AMD, a Red Hat, a Google, a Amazon e a IBM já pagavam a engenheiros para manter, e gastou o seu próprio esforço na camada de cima e no trabalho de integração de que essa camada precisa. É aí que uma equipa daquele tamanho pode fazer a diferença, e a fila de patches mostra-os a fazê-la.
O que o KVM é de facto
KVM significa Kernel-based Virtual Machine, e o nome é exato: é uma funcionalidade do kernel, não um programa.
Carrega os módulos e o Linux ganha um dispositivo de caracteres, /dev/kvm, mais um pequeno conjunto de chamadas ioctl sobre ele — KVM_CREATE_VM, KVM_CREATE_VCPU, KVM_SET_USER_MEMORY_REGION, KVM_RUN.
Essa interface é toda a API do hipervisor. Qualquer coisa capaz de abrir um descritor de ficheiro e chamar ioctl pode criar máquinas virtuais.
Foi escrito por Avi Kivity na Qumranet e integrado no Linux 2.6.20, lançado em fevereiro de 2007 — há dezanove anos. A Red Hat comprou a Qumranet em 2008, e o KVM saiu em todas as versões do kernel desde então, ao ritmo habitual do kernel de nove a dez semanas. Foi portado muito para lá do x86: arm64, POWER, s390 no IBM Z e RISC-V.
O ponto de arquitetura importante é porque é pequeno.
O KVM não tem um escalonador, porque o Linux tem um. Um vCPU é uma thread normal do anfitrião, e o completely fair scheduler põe-na num núcleo como qualquer outra thread. Não tem um gestor de memória, porque o Linux tem um. A RAM do convidado é um mapeamento normal em espaço de utilizador, por isso pode ir para paginação, ser suportada por hugepages ou ser colocada num nó NUMA com a mesma maquinaria de qualquer outro processo. Não tem uma pilha de controladores, uma camada de blocos, uma pilha de rede nem um sistema de ficheiros, porque o Linux já tinha tudo isso e são esses que o fabricante do teu hardware está a testar.
Esse é o verdadeiro argumento da maturidade, e é muito mais forte do que um número de versão. Cada melhoria no balanceamento NUMA, cada alteração ao io_uring, cada controlador de rede, cada nova solução para uma errata de CPU que entra no Linux entra por baixo das tuas máquinas virtuais, porque não existe um kernel de hipervisor à parte para onde alguém tenha de a portar.
O argumento do tipo 1 traça a linha no sítio errado
A objeção que se segue, invariavelmente, é que o KVM é «só um hipervisor de tipo 2». Corre num SO anfitrião, ao contrário do ESXi, que corre em bare metal.
Essa taxonomia é três décadas mais velha do que a virtualização por hardware, e aquilo à volta do qual traçava uma linha já não está onde se julga.
O que acontece de facto quando um vCPU corre
O QEMU chama ioctl(vcpu_fd, KVM_RUN). O controlo passa para o kvm.ko, que carrega o estado do CPU do convidado e executa VMLAUNCH. Dessa instrução até à saída de VM seguinte, o convidado está a executar diretamente no núcleo físico, em modo convidado, com as suas próprias tabelas de páginas ativas através do EPT, à velocidade total do hardware. Não há nada por baixo dele a interpretar seja o que for. O «SO anfitrião» não está no caminho. Nem sequer está a correr nesse núcleo.
Quando o convidado faz algo que precisa de tratamento, o CPU sai para o anfitrião — e cai no kvm.ko, no kernel, exatamente no nível de privilégio que o VMkernel do ESXi ocupa. A maioria das saídas é resolvida ali mesmo e reentrada sem o espaço de utilizador alguma vez ser envolvido.
O ESXi tem a mesma divisão
Agora olha para a plataforma que supostamente prova a distinção.
A própria documentação de arquitetura da VMware descreve o VMkernel como «a POSIX-like operating system», que fornece «process creation and control, signals, file system, and process threads». Isso é um sistema operativo, pela descrição do seu autor. E uma VM em execução no ESXi não é uma coisa dentro do kernel — é um grupo de processos userworld: um VMM por CPU virtual, que virtualiza as instruções do convidado e gere a sua memória, e um processo VMX por VM, que trata a E/S para os dispositivos que não são críticos para o desempenho e fala com o gestor de snapshots e com a consola remota.
Lê isso a pensar no QEMU. Contexto de execução por vCPU no kernel, processo por VM em espaço de utilizador a fazer emulação de dispositivos e gestão. A VMware dividiu-o pela mesma razão que toda a gente.
O Hyper-V não é diferente. A documentação da Microsoft é explícita: o Virtual Machine Worker Process, vmwp.exe, é «a user mode component of the virtualization stack», lançado por VM, e todos os dispositivos emulados estão implementados nele — a correr na partição raiz, que é Windows. Até o Xen, a arquitetura a que a taxonomia melhor se ajusta, precisa de um Linux de uso geral no dom0 para funcionar, e vai buscar ao QEMU o modelo de dispositivos para os convidados totalmente virtualizados.
Então onde fica a linha?
O critério nunca foi «usa espaço de utilizador». A taxonomia de Goldberg, do início dos anos 70, pergunta se o hipervisor é uma aplicação a correr num sistema operativo preexistente que já é dono do hardware e faz o escalonamento. Isso é um hipervisor de tipo 2, alojado: VMware Workstation, VirtualBox, Parallels Desktop, QEMU simples sem aceleração. Instalas um SO de uso geral, depois instalas um programa nele, e esse programa pede ao SO memória e tempo de CPU como qualquer outro programa.
Não é isso que o KVM é. O kvm.ko não é um programa por cima do Linux. Faz parte do Linux, executa no mesmo nível de privilégio do código que é dono do hardware, e quando um convidado sai cai ali diretamente. Não há nenhum SO anfitrião por baixo do hipervisor. O kernel é o hipervisor. O Proxmox VE entrega esse kernel como o sistema, exatamente como o ESXi entrega o VMkernel como o sistema.
E a versão «precisa de espaço de utilizador, logo é tipo 2» não tem salvação, porque aplicada de forma coerente apanha tudo. Nenhuma VM corre no ESXi sem o seu processo VMX, nenhuma no Hyper-V sem vmwp.exe, nenhuma no Xen como convidado HVM sem QEMU. Um teste que põe todos os hipervisores no mercado no mesmo balde não está a distinguir nada.
| Kernel dono da virtualização do CPU e da memória | Modelo de dispositivos por VM em espaço de utilizador | Precisa de um SO anfitrião preexistente? | |
|---|---|---|---|
| VMware ESXi | VMkernel | VMX por VM | Não |
| Microsoft Hyper-V | hipervisor mais a partição raiz Windows | vmwp.exe | Não |
| Xen | hipervisor Xen mais Linux no dom0 | QEMU, no dom0 ou num stub domain | Não |
| KVM | kvm.ko | QEMU | Não |
| VirtualBox, VMware Workstation | o kernel do anfitrião, através de um controlador instalado | a própria aplicação | Sim |
Quatro produtos, uma forma — e depois uma quinta linha que é genuinamente diferente. Essa última linha é o que «tipo 2» foi cunhado para descrever, e é a única em que outra coisa já mandava no hardware.
Portanto a taxonomia ainda traça uma linha. Só que não a traça nem perto de onde o argumento presume: o KVM e o ESXi estão do mesmo lado dela. Chamar tipo 2 ao KVM é pedir emprestada uma palavra à categoria do VirtualBox e aplicá-la a algo que, em arquitetura, está na categoria do ESXi.
O que deixa o rótulo sem fazer trabalho útil nenhum numa avaliação, porque os dois produtos entre os quais estás a escolher estão na mesma caixa. O que difere não é o número do tipo. É que um dos fornecedores também escreveu o kernel e não te deixa lê-lo — uma distinção de licenciamento e de transparência vestida com a roupa de um diagrama de arquitetura. A Nutanix mostra o ponto comercialmente: entrega o mesmo código KVM que o Proxmox e descreve o AHV como um hipervisor bare-metal de tipo 1. O mesmo código, o rótulo oposto, um departamento de marketing diferente.
Há uma preocupação real escondida dentro da acusação, e merece um nome melhor: um kernel de uso geral faz mil trabalhos que um feito de propósito não faz, o que significa mais código e mais superfície de ataque ao lado da fronteira de isolamento. Isso é legítimo e mensurável, e volto a ele perto do fim.
Onde o trabalho acontece de facto
O único sítio onde o instinto «está num SO anfitrião» tem razão de ser é o tratamento das saídas, por isso vale a pena ser claro sobre que saídas vão para onde.
| O convidado faz isto | Tratado por | Custo |
|---|---|---|
| Toca numa página ainda não mapeada no EPT/NPT | kvm.ko, no kernel | Uma saída, microssegundos |
| Escreve no seu APIC local | O próprio CPU, via APICv/AVIC | Muitas vezes nenhuma saída |
| Envia uma interrupção entre processadores | Posted interrupts em hardware | Muitas vezes nenhuma saída |
Transmite numa fila virtio-net com vhost-net | Thread do kernel, sem passar pelo espaço de utilizador | Um doorbell |
| Lê um registo num controlador e1000 ou IDE emulado | Até lá fora, ao QEMU | Saída mais uma ida e volta ao espaço de utilizador |
Só a última linha se parece de alguma forma com a caricatura do tipo 2 — e é também a linha que eliminas com engenharia, usando dispositivos virtio e não apresentando hardware legado emulado de que não precisas. É o mesmo raciocínio por trás de escolher o Q35 em vez do i440fx: menos acessos a registos intercetados, menos dispositivos legados a percorrer.
O SO anfitrião é uma funcionalidade, não bagagem
A outra metade dessas contas nunca chega ao argumento, por isso aqui está: um nó Proxmox é uma máquina em que podes realmente trabalhar. É Debian, por isso todo o repositório do Debian está a um apt install de distância.
- A monitorização que já tens — um node exporter do Prometheus,
smartmontools, o teu agente atual — em vez do que o appliance decidir expor. - Diagnóstico quando algo está lento:
fio,iperf3,nvme-cli,perf,bpftrace. - Agentes de backup de qualquer fornecedor que entregue um binário Linux.
- Gestão de configuração, para que o hipervisor fique no mesmo inventário Ansible que tudo o resto em vez de ser um caso especial.
fwupdpara firmware, em hardware cujo fabricante suporte o LVFS.
Nada disso precisa de um formato de plugin, de um pacote assinado ou da bênção do fornecedor. Compara com o modelo do ESXi, onde a shell é deliberadamente restrita, o código de terceiros chega como um VIB e não há gestor de pacotes nenhum a que recorrer.
Chega à pilha de armazenamento
Os agentes de monitorização são a versão aborrecida disto. A própria documentação de armazenamento do Proxmox enumera os plugins nativos — dir, NFS, CIFS, CephFS, ZFS, BTRFS, LVM, LVM-thin, iSCSI, FC/SAS, RBD, ZFS-over-iSCSI, PBS — e depois acrescenta uma frase que vale a pena levar à letra:
you may use all storage technologies available for Debian Linux
É uma afirmação sobre onde fica a fronteira, e o mecanismo por trás dela é genérico: põe um dispositivo de blocos em cada nó, mete LVM em cima, adiciona-o como armazenamento LVM com shared ativado. É exatamente assim que funcionam os caminhos suportados de Fibre Channel e iSCSI, por isso qualquer coisa capaz de produzir um dispositivo de blocos partilhado pode usar a mesma rota.
NVMe sobre TCP ou RDMA é o caso que vale a pena conhecer, porque é rápido, atual e ausente dessa lista de plugins. O nvme-tcp e o nvme-rdma são controladores de anfitrião Linux na árvore principal — o NVMe/TCP está no mainline desde o 5.0 — por isso não há nada para compilar. O nvme-cli é um pacote Debian (nvme discover, depois nvme connect), e o nvmetcli configura o alvo nvmet do kernel na outra ponta. Um namespace ligado aparece como /dev/nvmeXnY, e daí em diante é um dispositivo de blocos normal.
ATA over Ethernet faz o mesmo ponto do extremo oposto do espectro — antigo, obscuro, igualmente sem suporte como plugin. O controlador aoe está no mainline; o aoetools dá-te aoe-discover e aoe-stat; o vblade transforma qualquer ficheiro ou dispositivo de blocos noutra máquina num alvo. A mesma rota, o mesmo resultado.
Nenhum dos dois é uma API de plugins, um SDK ou um programa de certificação. É o que acontece quando a camada de armazenamento do hipervisor é a camada de blocos do Linux.
As ressalvas honestas, porque isto parece um truque de salão até serem 3 da manhã. Nenhum dos transportes é um tipo de armazenamento do Proxmox testado, por isso a integração e os seus modos de falha — comportamento de religação, multipath, timeouts sob carga — são teus para assumir e teus para testar antes de qualquer coisa importante viver lá. E o AoE é um protocolo de camada 2 nu, não encaminhável e sem autenticação, por isso pertence a uma VLAN de armazenamento isolada e a mais lado nenhum. O NVMe/TCP ao menos tem um modelo de descoberta e pode ser encaminhado, e é em boa parte por isso que é o que se deve escolher agora.
Quem mais corre KVM
É daqui que vem a afirmação «já o tens a correr». Todas as plataformas abaixo correm o mesmo módulo do kernel.
| Plataforma | Onde a encontras | A parte KVM | O VMM em espaço de utilizador |
|---|---|---|---|
| Amazon EC2 (Nitro) | Nuvem pública | Módulo central do KVM | À medida — QEMU removido, modelo de dispositivos nas placas Nitro |
| AWS Lambda, Fargate | Serverless | /dev/kvm | Firecracker — um monitor de microVM mínimo em Rust |
| Google Compute Engine | Nuvem pública | KVM desde o lançamento | O VMM da própria Google, deliberadamente não QEMU |
| Alibaba Cloud ECS | Nuvem pública | KVM simplificado (X-Dragon) | À medida, com rede e armazenamento descarregados para uma placa MoC |
| Oracle Cloud (OCI) | Nuvem pública | Oracle Linux KVM — a mesma pilha que a Oracle entrega on-premises | Linhagem QEMU |
| DigitalOcean, Linode/Akamai, Vultr, Hetzner, OVHcloud, Scaleway, UpCloud | Nuvem pública | KVM de série | QEMU |
| Nutanix AHV | HCI on-premises | KVM de série | QEMU com libvirt e Open vSwitch |
| OpenStack (Nova) | Nuvem privada | KVM de série | QEMU via libvirt — o controlador por omissão e o mais testado |
| Apache CloudStack, OpenNebula, oVirt | On-premises | KVM de série | QEMU via libvirt |
| OpenShift Virtualisation, SUSE Harvester | Kubernetes | KVM de série | QEMU dentro de um pod, via KubeVirt |
| Proxmox VE | On-premises | KVM de série | QEMU, com LXC ao lado para contentores |
Todos ficam com a metade do kernel e reescrevem a do espaço de utilizador
Os hyperscalers não fizeram um fork do KVM. Fizeram um fork do trabalho do QEMU.
A AWS passou o EC2 do Xen para o hipervisor Nitro, que é construído sobre o módulo central do KVM com o QEMU deitado fora por completo. O modelo de dispositivos vive antes em placas Nitro dedicadas, que é como conseguem um desempenho indistinguível do bare metal. Todos os tipos de instância EC2 da geração atual correm isto. À parte, o Lambda e o Fargate correm o Firecracker, um VMM feito de propósito em Rust que fala com o mesmo /dev/kvm.
A Google corre todas as VMs do Compute Engine em KVM desde que o Compute Engine foi lançado, e escreveu o seu próprio VMM em espaço de utilizador em vez de usar o QEMU, explicitamente para evitar a enorme matriz de convidados, dispositivos e modos do QEMU. Também foram no sentido contrário e endureceram o módulo do kernel no upstream, removendo dispositivos emulados de que ninguém precisava e estreitando o conjunto de instruções emuladas. Esse trabalho está no KVM que tens a correr.
A Alibaba fez a mesma forma de coisa com o X-Dragon: um hipervisor KVM despojado, com a virtualização de rede e de armazenamento descarregada para uma placa MoC baseada em FPGA.
O Nutanix AHV é KVM mais libvirt mais QEMU mais Open vSwitch mais a orquestração da Nutanix — de todos os produtos comerciais dessa lista, o parente mais próximo que o Proxmox VE tem. Uma camada 4 diferente, e uma fatura muito diferente.
O Proxmox VE mantém o QEMU de propósito
É tentador ler a tabela como uma classificação, com a AWS e a Google no topo por terem substituído o QEMU. É a leitura errada, porque a restrição deles não é a tua.
A AWS e a Google correm um único perfil de hardware, a uma escala em que um único bug de emulação de dispositivos é um evento em toda a frota, e controlam todas as fronteiras de imagem de convidado que lhes importam. Nesse mundo a amplitude do QEMU é quase toda passivo, por isso apagá-la é obviamente correto.
Tu não estás nesse mundo.
Tens uma imagem de appliance de 2013 que quer uma e1000. Tens uma VM Windows cujo tipo de máquina tem de ficar fixo para o resto da vida. Tens uma GPU para passar, um controlador SAS emulado para satisfazer um instalador, um armazém de variáveis UEFI para preservar. O QEMU é exatamente o que permite a uma plataforma de uso geral dizer que sim a tudo isso.
Aquilo a que a AWS chama superfície de ataque é aquilo a que tu chamas matriz de compatibilidade. As duas descrições estão certas; a diferença é se podes escolher as tuas cargas de trabalho.
Também explica a forma daquela fila de patches. A AWS e a Google resolveram o backup e os snapshots fora do VMM, nos seus próprios serviços de armazenamento. O Proxmox não tinha um serviço de armazenamento onde o resolver, por isso pôs isso no QEMU — e é por isso que o savevm-async e o controlador de blocos do PBS existem como patches e não como produtos.
E vale a pena saber isto por uma razão prática: as partes do Proxmox VE de que mais sentirias falta são as partes que não estão no upstream. As configurações das tuas VMs são texto simples e as imagens de disco estão em formatos normais, por isso uma máquina muda-se. Mas um snapshot que inclui o estado da RAM, e uma cadeia incremental do Proxmox Backup Server, dependem do fork do QEMU do Proxmox. É uma dependência muito mais leve do que um hipervisor proprietário — o fork é público, AGPL, e podes ler todos os patches que tem — mas não é zero, e «sem lock-in ao nível do software» devia levar essa nota de rodapé.
Então — é de nível empresarial?
A forma preguiçosa deste argumento não funciona, e vale a pena dizê-lo claramente. «A AWS usa KVM, portanto o Proxmox VE é de nível empresarial» é um non sequitur: pega numa afirmação sobre uma camada e aplica-a às escondidas a um produto inteiro.
Eis a versão que se aguenta.
O que é partilhado é a camada mais difícil de acertar e mais perigosa de errar. A virtualização do CPU e da memória, e a fronteira de isolamento entre inquilinos, é a parte em que um bug é uma violação e não uma indisponibilidade. Esse código é revisto por engenheiros pagos pela Amazon, Google, Red Hat, Intel, AMD, IBM e Alibaba, e os seus bugs são encontrados pelas casas que correm as maiores frotas que existem — normalmente antes de o kernel chegar até ti. Quando uma vulnerabilidade de fuga do convidado aparece mesmo, a correção chega pela atualização normal do kernel que ias aplicar de qualquer maneira. Não estás à espera do ciclo de lançamentos de um fornecedor para um hipervisor que só esse fornecedor consegue ver.
O que não é partilhado é tudo acima da fronteira. O que significa que a pergunta se reduz a duas muito mais respondíveis:
- A camada de gestão é boa o suficiente para a forma como operas?
- Consegues comprar suporte para ela em termos com que consigas viver?
As duas podem ser testadas numa prova de conceito e escritas num contrato. Nenhuma exige fé num hipervisor.
É uma posição muito melhor do que aquela que a pergunta original presume — que te estão a pedir para confiar num hipervisor novo de um fornecedor pequeno. Não estão. O código específico do Proxmox é uma camada de gestão sobretudo em Perl e cada vez mais em Rust, mais aquela fila de patches contra o QEMU, e repara onde os patches caem: no modelo de dispositivos e no caminho de backup, não na fronteira de isolamento.
Também vale a pena saber o que te custa a falha da camada específica do Proxmox. Os processos QEMU são processos independentes normais no anfitrião, por isso o pveproxy ir abaixo não para uma única máquina virtual. É um raio de impacto muito diferente de perder o componente dono da fronteira de isolamento.
O que «o mesmo hipervisor» não te compra
É aqui que os documentos de confiança dos fornecedores costumam parar, o que te diz alguma coisa sobre para quem são escritos. É a metade mais útil.
Não te compra a fiabilidade da AWS. A disponibilidade do Nitro tem muito pouco a ver com o KVM. Vem do plano de controlo, da fabric de rede, do serviço de armazenamento, da gestão de capacidade e da prática operacional à volta disso. A fiabilidade do teu cluster vai vir do desenho do quórum do Corosync, da configuração do fencing, da escolha de armazenamento e da redundância de rede. O KVM não tem opinião sobre nada disso. Partilhar um hipervisor com um hyperscaler não herda as operações deles.
Não te compra a superfície de ataque do Nitro, e é aqui que cai a metade legítima da acusação de tipo 2.
Estás a correr o QEMU num kernel de uso geral, e historicamente o modelo de dispositivos do QEMU é onde viveram as fugas de VM memoráveis — o VENOM, num controlador de disquetes emulado que ninguém usava, é o exemplo canónico. A Google pôde notar na altura que o Compute Engine não foi afetado precisamente porque não corre QEMU. Tu corres, por isso os controlos compensatórios são teus: prefere virtio a hardware emulado, não apresentes dispositivos de que não precisas, deixa os perfis do AppArmor em paz e aplica patches ao QEMU com a mesma disciplina que ao kernel. Os patches extra/ do Proxmox são eles a fazer exatamente isso em teu nome, e é razoável verificar que ainda o fazem.
Não torna o comportamento das VMs portável entre plataformas.
A seleção do modelo de CPU, o versionamento do tipo de máquina, a compatibilidade da migração em direto e o comportamento do relógio são todos decididos nas camadas 3 e 4, e diferem em todo o lado. Um cluster com gerações de CPU misturadas vai continuar a castigar-te por pores o tipo de CPU em host, e os relógios dos convidados continuam a derivar seja qual for o logótipo da plataforma. O mesmo hipervisor não é o mesmo comportamento.
Não responde à pergunta do suporte — que é a que as compras realmente querem saber, e com razão. O Proxmox VE é AGPLv3 e gratuito para correr em produção. A subscrição compra o repositório testado para empresas e o suporte do fornecedor, a partir de 120 € por socket por ano. O suporte do próprio Proxmox é prestado em horário de expediente austríaco, por isso a cobertura a qualquer hora vem de parceiros e não de Viena. A croit, onde trabalho, é um desses parceiros, e cobre 24/7, 365 dias por ano. Isso é uma negociação comercial, não um risco técnico — e ser uma negociação comercial é o objetivo de tudo o que está acima.
O que avaliar de facto em vez disso
Se o hipervisor está resolvido, uma prova de conceito deve gastar o tempo na camada que é genuinamente específica do Proxmox VE:
- Fencing e HA. Corta a energia a um nó com convidados HA a correr e cronometra o reinício. Depois fá-lo a dois nós e confirma que os restantes se comportam como esperas quando o quórum se perde.
- Migração em direto entre gerações de CPU. Com o modelo de CPU que tencionas mesmo normalizar, não
host. - Backup e, mais importante, restauro. Tempos de restauro sob carga, não tempos de backup. Nunca ninguém foi agradecido por um backup rápido.
- O modelo de permissões. Se consegues dar a uma equipa de aplicação o controlo da consola e da energia das suas próprias VMs e mais nada, com granularidade suficiente para satisfazer um auditor.
- A API. Tudo o que a interface web faz é uma chamada à API; se a tua automação não a conseguir conduzir, a plataforma não vai encaixar na forma como trabalhas.
- O caminho de atualização. Uma atualização de versão principal no cluster da PoC, antes de teres 400 VMs nele.
Nenhuma destas é uma pergunta sobre o KVM. É mesmo esse o ponto.
O hipervisor é a parte resolvida. Gasta a prova de conceito nas partes que não estão.
Referências
O próprio KVM
- KVM API documentation — a interface ioctl do
/dev/kvm, que é todo o contrato do hipervisor - Linux 2.6.20 release notes — a versão em que o KVM foi integrado, fevereiro de 2007
- Some KVM developments — LWN, janeiro de 2007, sobre o KVM nos dias a seguir à sua entrada no mainline
Como são construídos os outros hipervisores
- Interpreting virtual machine monitor and executable failures — a própria descrição da Broadcom de uma VM ESXi em execução como «several processes or userworlds», com um VMM por vCPU e um VMX por VM
- The Architecture of VMware ESXi (PDF) — o whitepaper que chama ao VMkernel «a POSIX-like operating system» com processos, sinais, um sistema de ficheiros e threads. Ligado através de um espelho porque o URL original da VMware não sobreviveu à reorganização da Broadcom, o que é um pequeno comentário em si sobre a continuidade dos fornecedores
- Hyper-V architecture — a Microsoft sobre o Virtual Machine Worker Process como componente em modo de utilizador, um por VM, onde vivem todos os dispositivos emulados
- The Nutanix Bible — AHV architecture — o AHV descrito como KVM com libvirt, QEMU e Open vSwitch
Quem corre KVM, e como o alterou
- 7 ways we harden our KVM hypervisor at Google Cloud — a Google sobre correr KVM sem QEMU, e o endurecimento que fez no upstream
- The AWS Nitro System — que tipos de instância EC2 correm o hipervisor Nitro
- AWS EC2 Virtualization 2017: Introducing Nitro — o texto de Brendan Gregg sobre a transição do Xen para o KVM, ainda o relato mais claro dela
- Firecracker — o VMM mínimo da AWS baseado em KVM por trás do Lambda e do Fargate
- Alibaba Cloud’s sixth-generation ECS instances — o hipervisor X-Dragon e o descarregamento para a MoC
- KubeVirt — o modelo QEMU/KVM dentro de um pod por trás do OpenShift Virtualisation e do Harvester
- OpenStack Nova hypervisor support matrix — o KVM como controlador de referência
O que o Proxmox mantém
- The Proxmox GitHub organisation — 89 repositórios, incluindo
pve-qemu,pve-kernel,pve-edk2-firmwaree empacotamento paralxc,zfsonlinux,openvswitch,libiscsi,corosync-pveeceph pve-qemupatch series — os 78 patches contados acima, e a forma mais rápida de ver exatamente o que o Proxmox acrescenta ao QEMU- Proxmox VE storage documentation — a lista de plugins nativos, que tipos de armazenamento são partilhados, e a linha sobre usar todas as tecnologias de armazenamento disponíveis para Debian Linux
nvme-clienvmetcli— ferramentas de anfitrião e de alvo NVMe-oF;aoetoolsevbladepara o equivalente ATA over Ethernet. Todos no Debian trixie, que é a base do Proxmox VE 9- Proxmox VE pricing and subscription tiers — o que a subscrição cobre
Declaração de interesses: trabalho para a croit, um Proxmox Gold Partner. As afirmações técnicas acima têm fontes e podem ser verificadas; o parágrafo comercial é a parte em que tenho interesse, por isso trata-o em conformidade.