Porque é que os HDD voltaram ao menu
Durante anos o conselho foi simples o bastante para caber num post-it: põe tudo em SSD.
Esse conselho estava certo, e também era barato. Nenhuma das duas coisas é bem verdade agora. A oferta de NAND apertou, a procura da IA empurrou o preço do flash para cima, e o NVMe de grande capacidade tornou-se difícil de justificar numa instalação Proxmox atenta aos custos, o tipo que tem de estar operacional, ser fiável e sair tão barata quanto a honestidade permite.
Os HDD enterprise voltam a ser interessantes pela mesma razão de sempre: capacidade por libra, e nada mais chega perto.
O senão é que toda a gente que já correu VM em discos rotativos sabe como isso pode correr mal. Essa experiência é real, e normalmente a culpa é da arquitetura e não dos discos.
Culpar os discos é mais fácil, atenção. Também está errado, e sai caro, porque convence as pessoas a comprar flash de que não precisavam.
Tudo o que se segue parte do princípio de Proxmox com OSD Ceph hiperconvergentes, porque é aí que as decisões de disposição mordem a sério.
O problema é a latência, não o débito
Um HDD enterprise moderno move grandes dados sequenciais perfeitamente bem. Esse nunca foi o gargalo.
Um disco enterprise de 7200 RPM entrega algo como 80 a 100 IOPS de trabalho aleatório, porque cada operação aleatória espera por um posicionamento da cabeça e por uma rotação do prato. Esse número quase não mexeu em vinte anos. É mecânica, não eletrónica. Um SSD enterprise de entrada está a três ou quatro ordens de grandeza dele.
Dá ao mesmo disco trabalho sequencial e é um dispositivo útil. A taxa de operações mais ou menos duplica, para cerca de 200 IOPS, mas cada uma dessas operações leva agora um bloco grande, porque a cabeça já está no sítio certo e pode continuar a debitar. Portanto tens débito real, 150 a 250 MB/s, a um preço por terabyte em que nada mais toca.
Essa é a assimetria importante, e não é «os HDD são lentos». Um disco rotativo é bom em trabalho sequencial e inútil em trabalho aleatório, e os dois números só estão próximos porque o que tem limite é a contagem de operações, não os bytes.
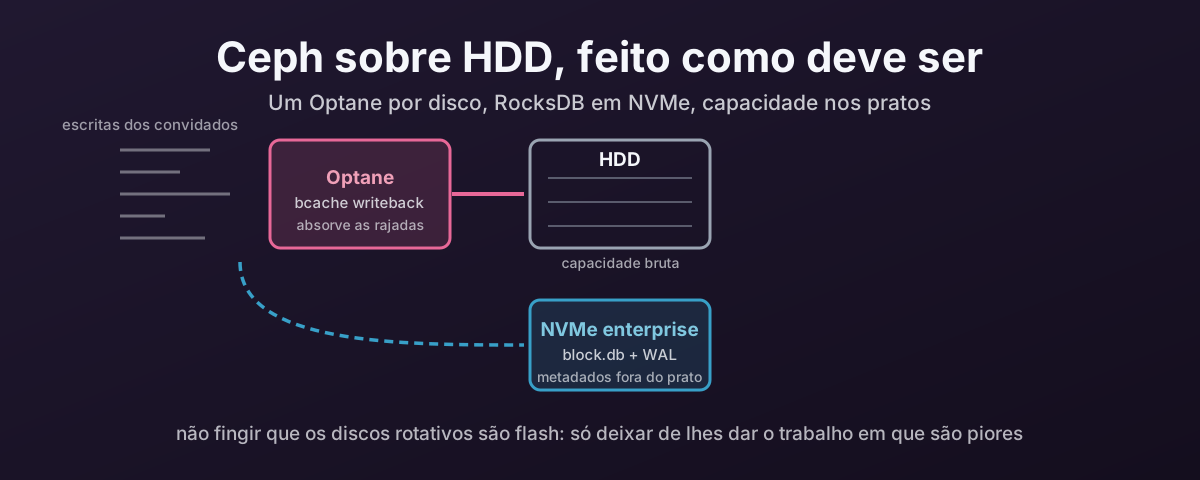
O que define todo o caderno de encargos. Não estás a tentar tornar o disco mais rápido. Não consegues. Estás a tentar arranjar maneira de ele passar o tempo no modo em que já é competente, e de manter o tráfego pequeno e aleatório longe dele. Assim sendo, tudo o que se segue é essa ideia aplicada duas vezes.
O problema é que as máquinas virtuais não geram a carga em que os HDD são bons. Geram atualizações de metadados, escritas de diário, pequenos flushes síncronos, registos, manutenção do sistema de ficheiros e rajadas de atividade aleatória de uma dúzia de convidados ao mesmo tempo, que chegam intercaladas ao disco.
O Ceph junta a isto a sua própria camada. Cada escrita leva atualizações de metadados do RocksDB ao lado dos dados. Se tudo isso cair em discos rotativos crus, os discos passam o tempo a posicionar a cabeça em vez de servir, e tens o sintoma que qualquer administrador reconhece: espera de I/O alta, convidados lentos, resposta inconsistente e um cluster que parece muito mais lento do que a ficha de capacidade sugere.
A própria orientação de hardware do Ceph é direta sobre onde isto vai dar. Avisa para «consider carefully the ostensible cost-per-gigabyte advantage of larger HDDs, and the concomitant limitations of IOPS per TB», e diz que os discos acima de 8 TB «may be best suited for storage of large files / objects that are not at all performance-sensitive.»
Vale a pena fazer essa conta, porque os discos que tornam isto económico, para começar, são os grandes. 20 TB para cima. Um disco de 20 TB continua a fazer os seus 80 a 100 IOPS aleatórios, porque a capacidade não te compra operação nenhuma. Portanto oferece cerca de 4 a 5 IOPS aleatórios por terabyte, onde um disco de 8 TB consegue uns onze, e um de 2 TB quarenta.
Pela própria medida do Ceph, então, um disco rotativo de 20 TB está bem dentro do território onde ele te diz para não pôr cargas sensíveis ao desempenho.
Isso não é um argumento contra comprá-los. É a razão de existir o resto deste artigo. O desenho abaixo é exatamente o que torna viável um disco de 20 TB para armazenamento de VM, arranjando as coisas para que o trabalho pequeno e aleatório nunca lá chegue.
Tira os metadados do disco rotativo
A alteração de maior valor num cluster sobre HDD é deixar de obrigar o disco rotativo a guardar a contabilidade do Ceph.
O BlueStore guarda três coisas por OSD: os próprios dados em block, a base de dados de metadados RocksDB em block.db e o registo de escrita antecipada (write-ahead log) em block.wal. Por omissão, as três vivem no mesmo dispositivo. Põe o block.db em NVMe e uma grande quantidade de I/O pequeno e aleatório sai do disco por completo.
A documentação de hardware do Ceph di-lo sem rodeios: «HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD.»
Usa aqui NVMe enterprise a sério, não flash de consumo. A razão não são os números de benchmark de montra. É a latência estável sob carga contínua, e a proteção contra perda de energia. A documentação do Ceph é direta: «Enterprise-class SSDs are best for Ceph: they feature power loss protection (PLP)», e «bargain client-class or off-brand SSDs are a false economy.»
Discos da classe Samsung PM9A3 e Micron 7450 Pro são o género de coisa que pertence aqui. Sob pressão de escrita, o Ceph preocupa-se muito mais com a consistência do que com os números de pico, e é exatamente isso que separa um disco enterprise de um disco de consumo rápido.
Dimensionar o block.db, e quanto custa o transbordo
Erra o tamanho e o benefício evapora-se em silêncio, porque quando o block.db enche, o RocksDB não falha: transborda de volta para o dispositivo lento, exatamente onde estaria sem o NVMe.
É o pior dos dois mundos: compraste o flash e continuas a posicionar cabeças no disco rotativo.
A orientação atual do Ceph:
| Carga | block.db como fração de block |
|---|---|
| RBD / bloco, discos de VM | 1% a 2% |
| RGW / objetos | pelo menos 4% |
| Recomendação geral ao descarregar WAL+DB | pelo menos 2,5% |
O armazenamento de VM no Proxmox é a linha RBD, portanto 1–2% é o número honesto para planear, e 2,5% é um sítio confortável para ficar.
Faz essa conta para um disco de 20 TB e os números chamam a atenção:
block.db para um OSD de 20 TB | |
|---|---|
| A 1% | 200 GB |
| A 2% | 400 GB |
| A 2,5% | 500 GB |
Junta isso aos degraus de nível do RocksDB abaixo e 300 GB por OSD é o ponto de aterragem sensato. O degrau útil mais perto do meio do intervalo.
O que muda aquilo que o dispositivo de metadados partilhado realmente é. Oito OSD de 20 TB querem 2,4 TB de NVMe entre eles; quinze, o máximo declarado pelo Ceph atrás de um NVMe, querem 4,5 TB. Em discos tão grandes, é a capacidade de DB que decide quantos OSD ficam atrás de um dispositivo, não a proporção. Vais ficar sem gigabytes muito antes de ficar sem a bênção do Ceph.
Há mais um pormenor que vale a pena saber, porque torna errado o dimensionamento intuitivo. A estrutura de níveis do RocksDB faz com que uma partição de DB só consiga usar por completo tamanhos que correspondem às somas dos seus níveis, o que historicamente produziu degraus úteis por volta de 3 GB, 30 GB e 300 GB, sem que os tamanhos intermédios ofereçam nada a mais do que o degrau de baixo. Arredondar 18 GB para cima, para 30 GB, sai muitas vezes de graça na prática; arredondar para baixo, para 20 GB, no pior caso não te compra nada a mais do que 3 GB.
Verifica o transbordo depois de o cluster estar a correr há algum tempo, não no primeiro dia. É um problema de instalação lenta.
Não precisas de um dispositivo WAL separado
Este poupa uma partição e muita trapalhada.
Se indicares um dispositivo de DB e nenhum dispositivo WAL explícito, o Ceph põe o WAL automaticamente no dispositivo rápido, junto com a DB. A documentação diz que «whenever a DB device is specified but an explicit WAL device is not, the WAL will be implicitly colocated with the DB on the faster device.»
Portanto «põe a DB e o WAL em NVMe» é o objetivo certo, mas é um argumento, não dois. Um block.wal separado só faz sentido se tiveres uma terceira camada, mais rápida, onde o pôr.
Desliga a cache de escrita do HDD
Pequeno, sem glamour, e fácil de deixar escapar.
A documentação do Ceph nota que o desempenho do OSD «may be dramatically increased … by disabling this write cache» nos HDD. A cache volátil do disco reordena e atrasa escritas de formas que lutam contra a semântica de flush do Ceph, e desligá-la costuma tornar as coisas mais rápidas, não mais lentas.
Passa de aconselhável a obrigatório assim que o bcache entra em jogo, que é a secção seguinte.
Já que estás aí: não precisas de um HBA com RAID. O Ceph di-lo diretamente: «You do not need an RoC (RAID-capable) HBA.» Dá os discos aos OSD.
Um Optane por disco rotativo
Tirar os metadados do disco resolve o estado estável. Não resolve as rajadas, porque uma rajada de pequenas escritas síncronas continua a ter de ser confirmada, e o disco rotativo continua a confirmar à velocidade de disco rotativo.
É para isso que serve o bcache, e o que o faz funcionar aqui é o Optane.
O que importa não é a capacidade. É o comportamento sob carga de escrita. Face à NAND, o Optane oferece latência muito baixa, resistência muito alta e nenhum dos precipícios de recolha de lixo que tornam imprevisível o desempenho de um SSD como cache de escrita depois de algum tempo em serviço. Absorver tráfego pequeno, em rajadas e pesado em escritas é aquilo em que é o melhor do mundo.
A disposição que importa: um Optane por HDD, cada par com o seu próprio dispositivo bcache. Não um Optane partilhado por uma prateleira inteira de discos.
O emparelhamento é uma escolha deliberada, e compra duas coisas.
Nenhuma contenção. Cada disco rotativo tem para si a latência e a profundidade de fila de um Optane inteiro, em vez de ficar na fila atrás das rajadas de outros sete OSD.
Um domínio de falha que o Ceph já sabe sobreviver. Uma cache de escrita partilhada guarda dados sujos de todos os OSD que tem atrás, portanto perdê-la perde-os todos de uma vez; emparelhada um para um, perder um Optane custa exatamente um OSD. Essa distinção é a consequência mais importante deste desenho, e tem o seu próprio tratamento em o que estás a trocar.
Isto tem de ser Optane. Não NAND.
A palavra «Optane» não é aqui uma preferência de marca nem um extra simpático. Substituir por um NVMe NAND, por mais caro que seja, constrói uma coisa que se gasta, e a razão é a resistência.
Olha para onde fica o dispositivo de cache. Como este desenho desliga o desvio sequencial do bcache, o sequential_cutoff=0 em a regra abaixo, cada uma das escritas para esse OSD passa por ele: não só as rajadas, tudo. Isso faz da cache o dispositivo com o ciclo de trabalho mais alto do nó, a quem se pede que absorva o volume de escrita de um disco rotativo inteiro durante a vida da máquina.
A resistência é indicada em escritas do disco inteiro por dia (DWPD), e a diferença não é marginal:
| Dispositivo | Resistência nominal |
|---|---|
| Optane P5800X | 100 DWPD |
| Optane P4800X | 30 DWPD |
| NAND enterprise de escrita intensiva, topo de gama | cerca de 10 DWPD |
| NAND enterprise de uso misto | 3 DWPD ou menos |
| NAND enterprise corrente, classe PM9A3, 7450 Pro | cerca de 1 DWPD |
O Optane tem entre dez e cem vezes a resistência da NAND que porias ali de outro modo. Põe um disco de 1 DWPD na única posição que recebe todas as escritas do cluster e não construíste uma cache, construíste um consumível.
É pior do que a tabela sugere, porque a NAND sofre amplificação de escrita internamente e o Optane não. O DWPD nominal de um disco NAND é o que ele aguenta na interface; o que as suas células absorvem de facto é mais. O número do Optane não precisa de asterisco nenhum.
As reconstruções são onde isso é posto à prova. O backfill empurra terabytes de escritas pelos nós sobreviventes numa janela comprimida, cada byte a passar pelos dispositivos de cache deles: um evento de resistência, não apenas de latência, que chega exatamente quando menos queres que um segundo dispositivo falhe.
Portanto as duas camadas de flash querem discos diferentes, por razões diferentes:
| Camada | Volume de escrita | O que o dispositivo precisa |
|---|---|---|
| DB/WAL | pequeno, só RocksDB | Um NVMe enterprise rápido. Latência baixa, IOPS aleatórios altos, PLP. A NAND enterprise é a tecnologia certa; um PM9A3 ou um 7450 Pro é a compra certa |
| Cache de escrita | tudo | PLP e resistência nas dezenas de DWPD. A NAND é a tecnologia errada a qualquer preço |
Comprar um só tipo de disco para os dois trabalhos é o erro que esta secção existe para evitar, mas não leias a primeira linha como licença para poupar, porque volume de escrita baixo não é exigência baixa.
O dispositivo DB/WAL continua a ter de ser NVMe genuinamente rápido, por três razões que nada têm a ver com quantos bytes o atravessam.
Serve todos os OSD que tem atrás ao mesmo tempo, portanto a fila que vê são quatro ou quinze conjuntos de tráfego de metadados, não o de um só disco.
A sua latência cai diretamente nos teus clientes. As consultas ao RocksDB estão no caminho crítico para encontrar objetos, para o peering e para o scrub, e são pequenas leituras aleatórias. A carga onde a diferença entre um NVMe rápido e um medíocre é maior. Cada microssegundo é multiplicado por cada OSD que dele depende.
E a compactação vem em rajadas. O RocksDB reescreve periodicamente os seus níveis, transformando uma rotação constante num pico concentrado de leituras e escritas. Um dispositivo que aguenta a média e encrava no pico encrava todos os OSD que tem atrás no mesmo momento.
As próprias proporções do Ceph denunciam-no. Permite três vezes mais OSD atrás de um NVMe do que atrás de um SSD SATA, e isso é a interface e a classe do dispositivo a falar, não a capacidade. Usa NVMe.
Portanto: o dispositivo de cache tem de ser Optane, o dispositivo DB/WAL pode ser NAND, e nenhuma das posições é onde se poupa dinheiro.
Que Optane: um M10 de 32 GB chegaria muitas vezes
Nada disso quer dizer que o maior Optane seja o certo. O dispositivo de que precisas é decidido pela tua carga de escrita, embora, afinal, o mercado de segunda mão possa decidir por ti de qualquer forma. A aritmética continua a importar, porque te diz o que estás a comprar a mais ou a menos.
Começa pelo que a cache serve. Guarda uma rajada, não um disco. Com writeback_percent=40, um dispositivo de 32 GB dá cerca de 13 GB de buffer sujo, o que é um número enorme de pequenas escritas síncronas.
Portanto não te deixes assustar pela proporção. Um módulo de 32 GB à frente de um disco de 20 TB é 0,16% dele, o que parece absurdo até te lembrares de que é um absorvedor de rajadas e não uma cache de conjunto de trabalho a tentar guardar dados quentes. Um dispositivo de 375 GB à frente do mesmo disco é 1,9%, o que é simplesmente mais folga do que vais usar.
O que põe em jogo a ponta barata da gama. Aqui está o pequeno módulo de consumo contra a peça de centro de dados, porque a diferença não está onde as pessoas esperam:
| Optane Memory M10 32 GB | Optane DC P4800X 375 GB | |
|---|---|---|
| Leitura aleatória, 4K | 240 000 IOPS | 550 000 IOPS |
| Escrita aleatória, 4K | 65 000 IOPS | comparável à leitura |
| Leitura sequencial | 1200 MB/s | 2400 MB/s |
| Escrita sequencial | 290 MB/s | 2000 MB/s |
| Latência típica | — | abaixo de 10 µs |
| Resistência | 365 TBW | 12,3 PBW, 30 DWPD |
| Interface | PCIe 3.0 x2, M.2 2280 | PCIe 3.0 x4, U.2 ou AIC |
Olha primeiro para a linha de IOPS de escrita. O pequeno M10 faz 65 000 escritas aleatórias por segundo; o disco rotativo atrás dele faz 80. Mesmo o Optane mais barato é cerca de 650 vezes o disco que está a servir de cache, portanto no eixo do desempenho a discussão acaba antes de começar. Os IOPS a mais da peça DC não têm para onde ir quando há um só disco de 7200 RPM a jusante.
A linha que decide a compra é a resistência, onde a diferença é de 34×. Convertida num orçamento diário ao longo de uma vida de cinco anos:
| Dispositivo | Escritas sustentáveis por dia, ao longo de cinco anos |
|---|---|
| M10 32 GB, 365 TBW | cerca de 200 GB/dia |
| P4800X 375 GB, 12,3 PBW | cerca de 6,7 TB/dia |
Abaixo de 200 GB de escritas por dia, um M10 de 32 GB aguenta a montagem toda. Ao dobro disso, tens dois anos e meio. Com uma carga realmente pesada em escritas, a peça DC ganha o seu preço, não pelos IOPS, que não consegues usar, mas pelas trinta e tal vezes mais escrita que tolera.
Portanto mede em vez de adivinhar. nvme smart-log num dispositivo de cache existente dá-te data_units_written; tira uma amostra com uma semana de intervalo, divide e compara com o TBW nominal do que estiveres a considerar. O bcache guarda os seus próprios totais em /sys/block/bcacheN/bcache/stats_total/, se preferires lê-los aí.
Duas ressalvas sobre o M10. Os seus números aleatórios são indicados sobre uma extensão de 8 GB e não sobre o dispositivo inteiro, portanto numa cache que tencionas correr bastante cheia, trata-os como o lado otimista. E é uma peça de consumo sem nenhuma alegação de PLP enterprise: o meio do Optane é escrito no lugar, sem buffer DRAM no caminho de escrita, e é por isso que estes módulos se portam muito melhor numa falha súbita de energia do que a NAND de consumo, mas «porta-se bem na prática» não é uma especificação. Se queres a garantia por escrito, compra uma peça da série DC.
O mínimo é a largura de banda, não a capacidade: esquece os módulos de 16 GB
Há uma segunda restrição, independente de tudo o que está acima, e desqualifica a peça mais barata da gama.
A cache tem de ser mais rápida do que o disco em sequencial, ou é um estrangulador. O M10 de 16 GB não é, e é o módulo que mais te vai tentar, porque é quase de graça:
| Escrita sequencial | |
|---|---|
| Optane Memory M10 16 GB | 150 MB/s |
| Optane Memory M10 32 GB | 290 MB/s |
| Optane DC P4800X 375 GB | 2000 MB/s |
| Um HDD enterprise de 7200 RPM | 150–250 MB/s |
Lê a primeira e a última linhas juntas. Um módulo de 16 GB escreve em sequencial mais ou menos à mesma velocidade do disco rotativo que devia acelerar, e mais devagar do que um bom. Continua a ser tremendamente mais rápido em trabalho aleatório, 35 000 IOPS de escrita aleatória contra os 80 do disco, mas num fluxo sequencial é, no melhor dos casos, um empate e, no pior, um teto abaixo do que o disco nu conseguia sozinho.
E este desenho garante que dás com esse teto, porque desligar o desvio sequencial manda tudo pela cache, fazendo da largura de banda de escrita sequencial da própria cache o teto rígido de todo o OSD. A recuperação é onde morde com mais força: fazer o backfill de um OSD de 20 TB é praticamente o mais sequencial que esta carga consegue ser, e limitá-lo a 150 MB/s torna mais lenta uma reconstrução que já era lenta.
Portanto a linha M10 tem um mínimo em 32 GB, e é um mínimo de largura de banda, não de capacidade. A aritmética da capacidade dizia que 32 GB chegavam e sobravam; a aritmética da largura de banda exclui os 16 GB, por pouco que precisasses de guardar. Os dois testes têm de passar, e a peça barata chumba no que as pessoas não verificam.
Seja o que for que estiveres a considerar, põe o seu valor de escrita sequencial ao lado de 250 MB/s antes de o comprares.
Comprar um produto que já ninguém fabrica
O Optane foi descontinuado. A Intel encerrou o negócio em 2022, abateu 559 milhões de dólares de inventário e terminou o desenvolvimento. Não há produção nova nem reposição; a oferta total só desce daqui para a frente.
O que levanta uma pergunta óbvia, porque há uma quantidade surpreendente à venda. Perceber de onde vem diz-te o que estás a comprar.
É inventário de peças de assistência dos OEM a ser liquidado. Os três grandes fabricantes de servidores tinham Optane em stock como peças sobresselentes para suportar as plataformas onde o venderam. Essas plataformas chegaram ao fim de vida e saíram do suporte, por isso as peças que as sustentavam tornaram-se stock morto de um dia para o outro: armazéns de peças para máquinas que ninguém é contratualmente obrigado a reparar. Esse inventário é o que está a escorrer para o AliExpress e para os recondicionadores.
Duas consequências, e ambas são boas notícias.
Muito disto está por usar, não foi retirado de máquinas. As peças de assistência ficaram numa prateleira à espera de uma avaria que nunca veio, por isso o desgaste à chegada é muitas vezes efetivamente zero: não «alguns anos de serviço leve», mas nunca escrito. Verifica em vez de confiar: nvme smart-log dá-te percentage_used e data_units_written, e em stock genuíno de peças de assistência esses valores devem ser espantosamente baixos. Tudo o que mostre desgaste real é uma peça retirada a ser vendida como outra coisa, embora mesmo assim a folga de resistência faça com que um Optane usado possa ter mais vida pela frente do que um disco NAND novo da mesma capacidade.
Explica que capacidades vais encontrar. As peças de assistência dos OEM eram para servidores, o que quer dizer peças de centro de dados. Aqui está a gama completa, e repara onde começa o topo de gama:
| Peça | Capacidades | Formato |
|---|---|---|
| Optane Memory M10 | 16, 32, 64 GB | M.2 2280, consumo |
| Optane SSD 800P | 58, 118 GB | M.2 2280, consumo |
| Optane SSD P1600X | 58, 118 GB | M.2 2280, peça de arranque e cache para centro de dados |
| Optane SSD DC P4801X | 100, 200, 375 GB | M.2 110 mm ou U.2 |
| Optane SSD DC P4800X | 375 GB no mínimo, 750 GB, 1,5 TB | U.2 ou placa de expansão |
| Optane SSD P5800X | 400 GB, 800 GB, 1,6 TB | U.2 ou placa de expansão |
Em teoria, as pequenas peças M.2 são a resposta elegante: o M10, o 800P, o P1600X e o P4801X de 100 GB fazem todos o trabalho, e barato. Na prática, o mercado não as tem, porque ninguém armazenou módulos aceleradores de secretária como peças de assistência de servidores. O que aparece listado é de 375 GB para cima, hardware da classe P4800X.
Portanto conta com comprar mais capacidade do que o papel precisa, porque é isso que está à venda. Não é um mau resultado. Comprar a mais um dispositivo de cache deixa-te com 30 DWPD e latência abaixo de 10 µs quando a tua carga pedia uma fração de qualquer um dos dois, e para um disco de 20 TB que tencionas manter durante anos, é para esse lado que se deve errar. Quer dizer, isso sim, que o preço de entrada é mais alto do que a aritmética sugere, e que o dimensionamento acima passa a ser uma verificação contra comprar a menos em vez de uma lista de compras.
Três coisas a planear, já que isto é uma liquidação e não uma cadeia de abastecimento:
Compra as peças sobresselentes com a montagem. Está a ser escoado um stock finito. Quando um dispositivo falhar daqui a três anos não vais encomendar um substituto, vais andar à caça de um, por isso põe as sobresselentes no orçamento agora, enquanto o stock lá está.
Conta com firmware OEM e verifica o namespace. As peças do programa de sobresselentes de um fabricante trazem muitas vezes o firmware desse fabricante e podem chegar formatadas com um tamanho de LBA ou com definições de metadados adequadas àquilo para que estavam em stock. Confirma com nvme id-ns antes de construíres em cima, e está pronto para fazer nvme format para um formato simples de 4096 bytes.
Não há garantia, nem suporte, nem mais atualizações de firmware. O próprio aviso de suporte da Intel cobre o que o encerramento significa para dispositivos já em serviço, que é a situação em que já está qualquer coisa que compres. Verificar que a peça que chegou é a peça do anúncio fica por tua conta.
O bcache não substitui a descarga do DB/WAL
Vale a pena dizê-lo explicitamente, porque é o sítio óbvio onde tentar poupar dinheiro e não funciona: continuas a precisar do block.db em NVMe. As duas camadas, não uma ou a outra.
O Optane é uma cache de escrita. É só isso. Encurta o caminho de confirmação das escritas a caminho do disco, e não faz mais nada.
O RocksDB não se limita a escrever. O Ceph lê os seus metadados constantemente, para encontrar objetos, para servir o peering, para responder aos scrubs, e uma cache de escrita não oferece rigorosamente nada a uma leitura quando os dados já foram despejados dela. Nem a cache remove o tráfego de metadados; adia-o e agrupa-o, portanto cada atualização do RocksDB acaba por chegar ao disco rotativo, a disputar os mesmos posicionamentos de cabeça. E a compactação transforma uma rotação modesta em muito mais tráfego no dispositivo do que as escritas que a causaram.
Portanto as duas alterações resolvem problemas diferentes e nenhuma substitui a outra:
| O que resolve | O que não resolve | |
|---|---|---|
block.db em NVMe | os metadados vivem em flash, leituras e escritas, fora do disco rotativo para sempre | nada para uma rajada de escritas dos convidados |
| Optane via bcache | latência de confirmação de rajadas para escritas de dados | nada para leituras de metadados; só adia as escritas de metadados |
Salta a descarga da DB e mantém o Optane, e o RocksDB volta ao prato com as leituras servidas a 80 IOPS. Salta o Optane e mantém a descarga da DB, e o estado estável é decente, mas as rajadas continuam a encravar à velocidade do disco rotativo.
A regra udev, linha a linha
Os parâmetros do bcache vivem no sysfs, e o sysfs repõe-nos sempre que o dispositivo é registado, ou seja, em cada arranque. Portanto pertencem a uma regra udev e não a um script que alguém tem de se lembrar de correr:
# /etc/udev/rules.d/99-bcache.rules
ACTION=="add|change", SUBSYSTEM=="block", KERNEL=="bcache*", \
  ATTR{bcache/cache_mode}="writeback", \
  ATTR{bcache/sequential_cutoff}="0", \
  ATTR{bcache/congested_read_threshold_us}="0", \
  ATTR{bcache/writeback_rate}="81920", \
  ATTR{bcache/writeback_rate_minimum}="20480", \
  ATTR{bcache/writeback_percent}="40"
KERNEL=="bcache*" apanha todos os dispositivos bcache do nó, portanto uma regra cobre todos os pares. ACTION=="add|change" quer dizer que volta a aplicar-se sempre que um dispositivo aparece ou é reanexado, não só no arranque.
O que cada definição está a fazer, e porquê:
cache_mode=writeback: a razão de tudo. No writethrough por omissão, uma escrita só é confirmada quando chega ao HDD, portanto a cache não faz nada pela latência de escrita. Em writeback, o Optane confirma e o disco rotativo apanha-o depois.
sequential_cutoff=0: por omissão, o bcache deteta I/O sequencial e encaminha-o diretamente ao lado da cache assim que passa os 4 MB, com a teoria de que o disco de suporte lida bem com o sequencial. Zero desativa esse desvio, para que tudo passe pela cache. Num nó hiperconvergente essa é a decisão certa: o que parece sequencial para um dispositivo bcache deixa de ser sequencial no prato assim que vários OSD se intercalam, e queres cada escrita confirmada à velocidade do Optane de qualquer forma. Traz, no entanto, uma obrigação: sem desvio, a largura de banda de escrita sequencial do próprio dispositivo de cache torna-se o teto de todo o OSD, que é porque é que os módulos de 16 GB estão desqualificados.
congested_read_threshold_us=0: o bcache vigia a latência do seu próprio dispositivo de cache e começa a contornar a cache quando o julga congestionado, por omissão a 2000 µs para leituras. O Optane não fica congestionado como a NAND, portanto isto é o bcache a duvidar de um dispositivo que mediu mal. Zero desliga essa vigilância.
writeback_rate=81920 e writeback_rate_minimum=20480: a taxa de despejo em segundo plano, em setores por segundo, ou seja, um alvo de uns 40 MB/s com um mínimo de 10 MB/s. Um controlador PD move a taxa real entre os dois. O alvo fica perto do que um disco rotativo consegue absorver em sequencial, e o mínimo impede o controlador de estrangular o despejo até perto de zero e deixar os dados sujos acumularem-se indefinidamente. Ambos são pontos de partida e não constantes; como os mudar está mais abaixo.
writeback_percent=40: quanto da cache o bcache deixa ficar sujo antes de travar com força, contra um valor por omissão de 10. Quarenta dá-te um buffer de rajadas muito mais fundo. Também quer dizer que até 40% desse Optane guarda a única cópia de dados no sistema, que é o preço a pagar, e é a razão pela qual a disposição de um por disco rotativo importa. Este é o valor que mais vale a pena rever depois de teres observado uma carga real.
Mudar os valores de enchimento e despejo mais tarde
Os 40% e as duas taxas acima são os valores que correm aqui, não constantes universais. São a primeira coisa que vais querer mexer depois de observares uma carga real, por isso vale a pena saber que há dois sítios para os mudar, que fazem duas coisas diferentes.
O sysfs muda-o agora. A regra udev muda-o no próximo arranque. Queres as duas, e por essa ordem.
Muda-o em direto, num dispositivo:
echo 30 > /sys/block/bcache0/bcache/writeback_percent
Ou em todos os pares do nó:
for d in /sys/block/bcache*/bcache; do
  echo 30 > "$d/writeback_percent"
done
A taxa de despejo funciona da mesma maneira. Ambos os valores estão em setores por segundo, portanto estes reduzem para metade o alvo e o mínimo:
for d in /sys/block/bcache*/bcache; do
  echo 40960 > "$d/writeback_rate"
  echo 10240 > "$d/writeback_rate_minimum"
done
Isso tem efeito imediato e sobrevive exatamente até o dispositivo voltar a ser registado. A documentação do kernel é explícita em que estas definições «do not persist across reboot», que é a razão inteira de a regra udev existir.
Quando estiveres satisfeito com um valor, edita a regra e recarrega-a sem reiniciar:
udevadm control --reload
udevadm trigger --subsystem-match=block --action=change
É aqui que o ACTION=="add|change" mostra o que vale. O trigger dispara um evento change para dispositivos que já estão presentes, portanto a regra volta a aplicar-se a um nó em funcionamento em vez de esperar pelo próximo arranque. Se a regra apanhasse só add, aquele comando não faria nada.
Depois lê os valores de volta, porque um erro de escrita numa regra udev falha em silêncio:
grep . /sys/block/bcache*/bcache/writeback_percent
Saber para que lado os mexer
Não afines isto a partir de princípios teóricos: o bcache expõe o que precisas no mesmo diretório do sysfs.
O dirty_data é o que deves vigiar: quantos dados estão neste momento na cache e em mais lado nenhum. A documentação descreve-o como «continuously updated unlike the cache set’s version, but may be slightly off», o que serve bem para este fim. Tira amostras ao longo de um dia normal de trabalho e de uma janela de backup.
cache_hits, cache_misses e cache_hit_ratio dizem-te se a cache está a ser usada, com a ressalva de que «a partial hit is counted as a miss». bypassed conta o IO que passou ao lado da cache por completo; com sequential_cutoff=0 deve ficar quase plano, portanto um número a crescer quer dizer que alguma coisa ainda a está a contornar.
Todos esses vêm como totais acumulados mais versões que decaem ao longo do último dia, hora e cinco minutos, o que torna os de janela curta muito mais úteis para detetar um problema do que o número de toda a vida.
A partir daí:
| Sintoma | Botão | Direção |
|---|---|---|
| As rajadas encravam: as escritas batem na latência do disco rotativo a meio da rajada | writeback_percent | para cima, para um buffer mais fundo |
| Mais dados expostos na cache do que te deixa confortável | writeback_percent | para baixo |
dirty_data encostado ao teto durante o trabalho normal | writeback_rate | para cima: o problema não é o buffer, é o escoamento |
| O despejo em segundo plano a competir com as leituras dos convidados no disco rotativo | writeback_rate | para baixo |
dirty_data a subir devagar ao longo de dias e não de horas | writeback_rate_minimum | para cima, para o controlador não estrangular até rastejar |
Se o dirty_data ficar encostado ao teto faças o que fizeres, nenhum dos botões é a resposta: o cluster está a escrever mais depressa do que os discos rotativos conseguem absorver, e as soluções honestas são mais discos rotativos ou menos escritas.
Um ficheiro para deixar em paz: writeback_running. Desligá-lo para o writeback por completo, e a documentação diz que é «only meant for benchmarking». Num OSD de produção quer dizer que os dados sujos se acumulam até a cache encher e nunca escoam.
O que estás a trocar
A maior parte dos textos sobre este desenho para nas boas notícias. Estas são as partes que te vão doer de facto, e vale a pena conhecer cada uma antes de construíres e não depois.
Perder qualquer um dos dispositivos flash destrói o OSD. Não o para: destrói-o. Os dois dispositivos guardam estado que não existe em mais lado nenhum: o block.db guarda o RocksDB que dá sentido ao block, e uma cache writeback guarda todas as escritas ainda não despejadas. A documentação do kernel não hesita sobre a segunda: «In writeback mode you’ll lose data if something happens to your SSD.» De uma maneira ou de outra o OSD não volta; é recriado e passa por backfill.
Portanto são a mesma classe de risco, e vale a pena ser claro quanto a isso em vez de tratar a cache como a assustadora. O Optane não é um dispositivo mais perigoso do que o NVMe. Duas coisas os separam, e nenhuma é a gravidade por OSD.
A primeira é o raio de impacto, e é a justificação inteira do emparelhamento. Um Optane por disco rotativo quer dizer que uma falha de cache custa um OSD, uma perda de um só disco, que é exatamente o evento que um pool replicado existe para absorver, e que o Ceph trata sem que ninguém seja chamado de madrugada. O dispositivo DB/WAL é partilhado, portanto perdê-lo custa todos os OSD que tem atrás de uma vez, o que é uma falha correlacionada contra a qual a replicação não te protege. A mesma falha, um dispositivo contra cinco.
A segunda é a forma como a falha se apresenta, e esta é uma armadilha operacional. Quando uma cache morre em writeback, o dispositivo de suporte para e devolve erros de I/O, o que está bem: o Ceph marca o OSD como em baixo e segue em frente. O caso mau é um reinício em que o dispositivo de suporte arranca sem a sua cache anexada. Parece então um sistema de ficheiros montável a que simplesmente faltam todas as escritas sujas, o que é corrupção e não apenas dados desatualizados. Um block.db em falta falha ruidosamente e o OSD recusa-se a arrancar; uma cache em falta pode falhar em silêncio e deixar-te montar os destroços. Trata um dispositivo de suporte bcache como não montável sem a sua cache, e nunca deixes nada montá-lo por ti com boas intenções.
O bcache, por si só, não garante writeback seguro face a falhas de energia. É aqui que a cache de escrita do HDD deixa de ser uma otimização e passa a ser um requisito: desliga-a, e corre um kernel suficientemente recente para ter o tratamento de FUA, para que as escritas síncronas sejam respeitadas ao longo da pilha em vez de confirmadas cedo algures no meio. Um dispositivo de cache sem proteção contra perda de energia agrava o problema, porque pode perder dados que já declarou seguros.
O que faz da proporção DB/WAL o número que importa. O Ceph permite 4–5 OSD HDD por SSD SATA e não mais de 15 por NVMe, e avisa sobre «balancing the risk of reducing costs by placing too many responsibilities into too few failure domains.» Ao contrário da camada de cache, não há emparelhamento disponível para conter este; partilhar é a razão de ser do dispositivo.
Em discos de 20 TB essa é a conversa toda, porque a reconstrução é enorme. Um OSD falhado são 20 TB de backfill; aos 150–250 MB/s que um disco rotativo sustenta, estrangulado para que a recuperação não deixe os convidados à fome, estás a olhar para bem mais de um dia de funcionamento degradado por um só disco. Perde um dispositivo de DB partilhado que leva cinco deles e há 100 TB para mover.
Portanto a proporção não é bem uma decisão de custo. É uma decisão sobre quanto tempo estás disposto a correr degradado, e quanto tráfego de reconstrução o cluster aguenta enquanto continua a servir VM.
O desenho depende de um dispositivo que já ninguém fabrica. Este é o que não tem resposta técnica. O Optane é a peça certa para a posição de cache e nada atual o substitui: a NAND não aguenta o volume de escrita, e a memória baseada em CXL para onde a Intel se virou não é um substituto direto para uma cache de blocos. Portanto a mitigação é comercial e não engenhosa, está tratada acima, e o resumo honesto é que esta arquitetura tem uma data de fim algures no futuro.
Nada disto faz de um cluster HDD um cluster todo em flash. Um tráfego de escrita aleatória contínuo que ultrapasse a taxa de despejo vai encher a cache, e uma vez cheia estás a escrever à velocidade do disco rotativo com camadas a mais no caminho. Este desenho absorve rajadas e remove a sobrecarga de metadados. Não fabrica IOPS.
No que tudo isto se resume
Três camadas, cada uma a fazer a única coisa em que é melhor, e as três são necessárias:
- O Optane absorve as rajadas de escrita aleatória, um dispositivo por disco rotativo. Tem de ser Optane, porque todas as escritas o atravessam e a resistência da NAND é errada para essa posição
- Um NVMe enterprise rápido guarda o RocksDB e o WAL, partilhado por um punhado de OSD numa proporção que escolheste deliberadamente em vez de aceitares
- Os HDD dão a capacidade bruta, livres tanto dos metadados como das rajadas
A ideia não é fingir que os discos rotativos são flash. É deixar de lhes mandar o trabalho em que são piores, para que a capacidade por que realmente pagaste seja utilizável.
É esse o truque todo, e não tem nada de engenhoso. Põe cada trabalho no dispositivo que é bom nele, e deixa de pagar duas vezes pelos que não são.
Para um cluster Proxmox hiperconvergente que precisa de capacidade de vários terabytes sem preços de tudo em flash, este é um desenho defensável. Bem construído, parece muito mais rápido do que HDD crus, falha de maneiras que o Ceph foi feito para tratar, e o dinheiro vai para onde muda o resultado.
Duas leituras relacionadas que vale a pena fazer ao lado desta: o trabalho sobre tamanhos de setor em 4Kn, 512e e 512n conta muito para o que os discos rotativos fazem com as escritas que lhes chegam, e se estiveres a construir isto em nós com armazenamento direto, a malha sem switch cobre o lado da rede de um pequeno cluster Ceph.
Referências
- Ceph — Hardware Recommendations — o aviso sobre IOPS por TB nos HDD grandes, «HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD», as proporções de 4–5 HDD por SSD SATA e ≤15 por NVMe, a proteção contra perda de energia nos SSD enterprise, desligar a cache de escrita do HDD e não precisar de um HBA RoC
- Ceph — BlueStore Configuration Reference —
block.dba 1–2% deblockpara RBD e pelo menos 4% para RGW, a recomendação geral de 2,5%, o transbordo de volta para o dispositivo principal, os tamanhos de nível do RocksDB por trás dos degraus de 3/30/300 GB, e o WAL implicitamente colocado junto da DB - Linux kernel — bcache admin guide — os modos de cache,
sequential_cutoffe o seu valor por omissão de 4 MB, os 2000 µs por omissão para congestionamento de leitura,writeback_rateem setores por segundo, o controlador PD dowriteback_percent, os contadoresdirty_data/cache_hit_ratio/bypassede as suas versões decrescentes de um dia, uma hora e cinco minutos, o aviso de quewriteback_runningé «only meant for benchmarking», a afirmação de que estas definições «do not persist across reboot», e «in writeback mode you’ll lose data if something happens to your SSD» - Intel — Optane Memory M10 32 GB specifications — 365 TBW, 240 000 IOPS de leitura aleatória e 65 000 de escrita aleatória a 4K sobre uma extensão de 8 GB, 1200/290 MB/s em sequencial, PCIe 3.0 x2
- Intel — Optane Memory M10 16 GB specifications — os 150 MB/s de escrita sequencial e os 35 000 IOPS de escrita aleatória que põem esta peça abaixo de um disco rotativo em débito sequencial
- PC Perspective — Optane SSD DC P4800X performance — os 550K IOPS de leitura aleatória a 4K da peça de 375 GB, 2400/2000 MB/s em sequencial, latência típica abaixo de 10 µs e 12,3 PBW a 30 DWPD
- ServeTheHome — Optane DC P4801X 100GB M.2 review — as peças M.2 de centro de dados de pequena capacidade, para a escada de capacidades
- StorageReview — Intel Optane SSD P5800X — a classificação de 100 DWPD, os 30 DWPD do P4800X, e a comparação com os discos NAND enterprise que chegam a cerca de 10 DWPD nas peças de escrita intensiva e a 3 ou menos nas de uso misto
- Bcache — ArchWiki — os modos de falha práticos, incluindo um dispositivo de suporte que arranca sem a sua cache depois de um reinício, e os requisitos de segurança face a falhas de energia em torno da cache de escrita do HDD e do FUA
- Intel — Optane business update — o encerramento, e o que significa para a garantia e o suporte de dispositivos já em serviço, que é a situação em que já está qualquer coisa que compres no mercado de recicladores