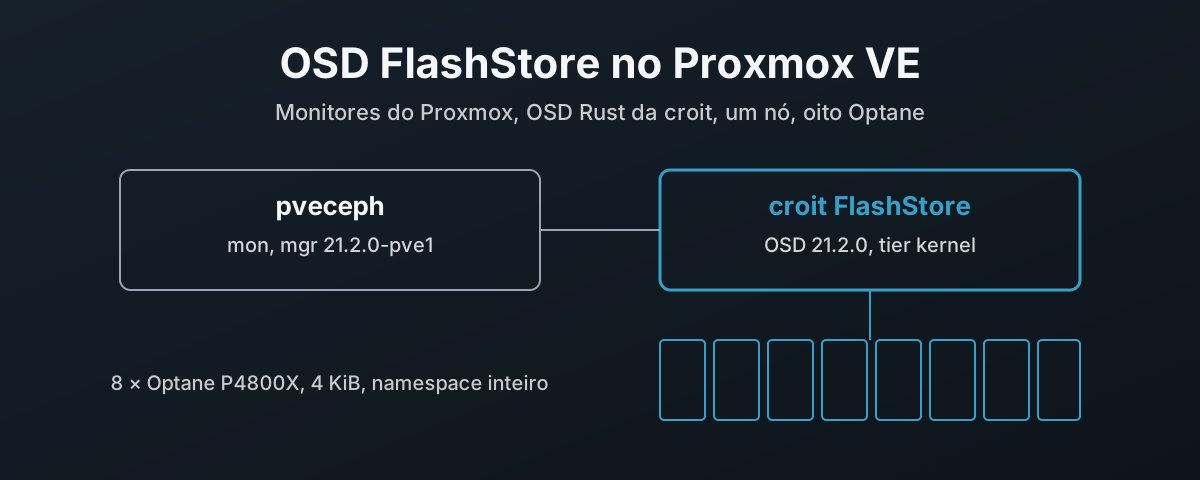
Um OSD em Rust, no dia em que saiu
A croit pôs o FlashStore OSD em preview pública a 9 de novembro de 20261.
É um OSD de Ceph escrito de raiz em Rust, com o seu próprio armazenamento de objetos no lugar do BlueStore, e fala o protocolo de rede do Ceph.
A promessa é que encaixa num cluster que já tens a correr: os teus monitores, os teus managers, a tua CLI ceph e os teus clientes ficam como estão, e substituis um disco de cada vez1.
Essa promessa importa mais a uma casa Proxmox do que à maioria.
Num nó Proxmox VE hiperconvergido, o Ceph não é algo que instalas à parte.
Vem da GUI do Proxmox, dos repositórios do próprio Proxmox, compilado e corrigido pelo Proxmox, e tudo é conduzido pelo pveceph.
Se um OSD de outra pessoa conseguir encaixar ali dentro sem o partir, ganhas um motor de armazenamento novo sem abdicar das ferramentas.
Se não conseguir, descobres da pior maneira, num nó que também está a correr as tuas VM.
Por isso experimentei.
Trabalho para a croit, que faz o FlashStore. É por isso que o experimentei dois dias depois de sair, e é também a razão por que nada do que se segue é suavizado. É uma preview, o README diz que «not yet recommended for production data»1, e isto é um relato do que foi preciso em hardware real, não uma brochura.
Resposta curta: funciona. Oito OSD FlashStore estão a servir uma pool RBD a uma VM num nó Proxmox VE 9.2 de origem enquanto escrevo isto, HEALTH_OK. A resposta longa é que foram precisas duas correções que a documentação não menciona, uma por causa da forma como o Proxmox guarda a configuração do Ceph e outra por causa do kernel do Proxmox, e o resto deste artigo são essas correções e a forma como foram encontradas. Se só o queres a correr, há um script perto do fim que faz tudo, e já foi corrido neste nó.
A máquina
O laboratório é um único nó, pve2, na minha rede de casa, e é um mini PC Minisforum B550 de 2021, uma porcaria.
Ceph num só nó não é forma de correr produção, e a regra CRUSH mais abaixo é o preço disso, mas cada passo aqui é igual num nó que tenha vizinhos.
| Proxmox VE | pve-manager 9.2.26, kernel 7.0.14-28-pve, Debian 13.7 |
| Máquina | Mini PC Minisforum B550, 2021; a placa reporta BESSTAR TECH B550, BIOS 5.17 |
| CPU | AMD Ryzen 7 5700G, 8 núcleos, 16 threads, 1 nó NUMA |
| Memória | 58 GiB |
| Discos OSD | 8 × Intel Optane P4800X 375 GB (6 com marca Dell, 2 Intel de retalho) |
| PCIe até aos Optane | os oito atrás de um único switch Broadcom PEX880xx, numa só ligação PCIe 3.0 x16 a partir da APU |
| Disco de arranque | WD SN750 512 GB, VG pve, mantido fora de tudo isto |
| Rede | uma porta de 2,5 GbE, vmbr0 |
| FlashStore | snapshot-2026-11-10, commit upstream c5792750020e2 |
Os Optane estão lá porque o FlashStore tem dois requisitos rígidos em que muitos discos chumbam.
O disco tem de ter proteção contra falhas de energia, e o namespace tem de usar blocos de 4096 bytes, como namespace inteiro, sem partições nem sistema de ficheiros1.
O FlashStore confirma uma escrita quando ela está durável no disco, por isso um disco que mente sobre a durabilidade com uma cache volátil é recusado no mkfs3.
Todos os P4800X reportam ausência de cache de escrita volátil nos seus dados Identify (vwc 0), que é o próprio disco a dizer que a cache não pode perder uma escrita confirmada.
Como tal, o mini PC é o fator limitante desta análise, não o FlashStore e não os discos. Oito núcleos quer dizer um por OSD e nenhum de sobra, 58 GiB têm de alimentar o Ceph e as VM, e oito Optane partilham uma ligação PCIe 3.0 porque é tudo o que a APU tem para dar. Lê cada número abaixo como aquilo que esta máquina permite.
Umbrella ou nada
O FlashStore é construído para uma versão do Ceph de cada vez.
O branch decide: o main fala Ceph 21.2.0 Umbrella, e um branch v20.2.4 fala 20.2.4 Tentacle4.
O daemon verifica a versão do cluster quando arranca e recusa uma que esteja fora da sua janela4.
Os pacotes na página de lançamento são compilados a partir do main, e o próprio binário di-lo: croit-flashstore-osd 21.2.0 umbrella.
O Proxmox VE 9 oferece três repositórios de Ceph, e só um deles bate certo.
O Tentacle é o padrão do Proxmox, então é a escolha segura?
É o que não vai funcionar.
O repositório do Proxmox leva o Tentacle até ao 20.2.5-pve1, e o branch Tentacle do FlashStore aponta exatamente ao 20.2.4.
O Umbrella no repositório do Proxmox é o 21.2.0-pve1, a mesma versão que o main aponta.
O Proxmox não esconde o que o Umbrella é.
O PVE/Ceph/Releases.pm lista-o com unsupported => 15, e o assistente da GUI di-lo por palavras simples no momento em que o escolhes.
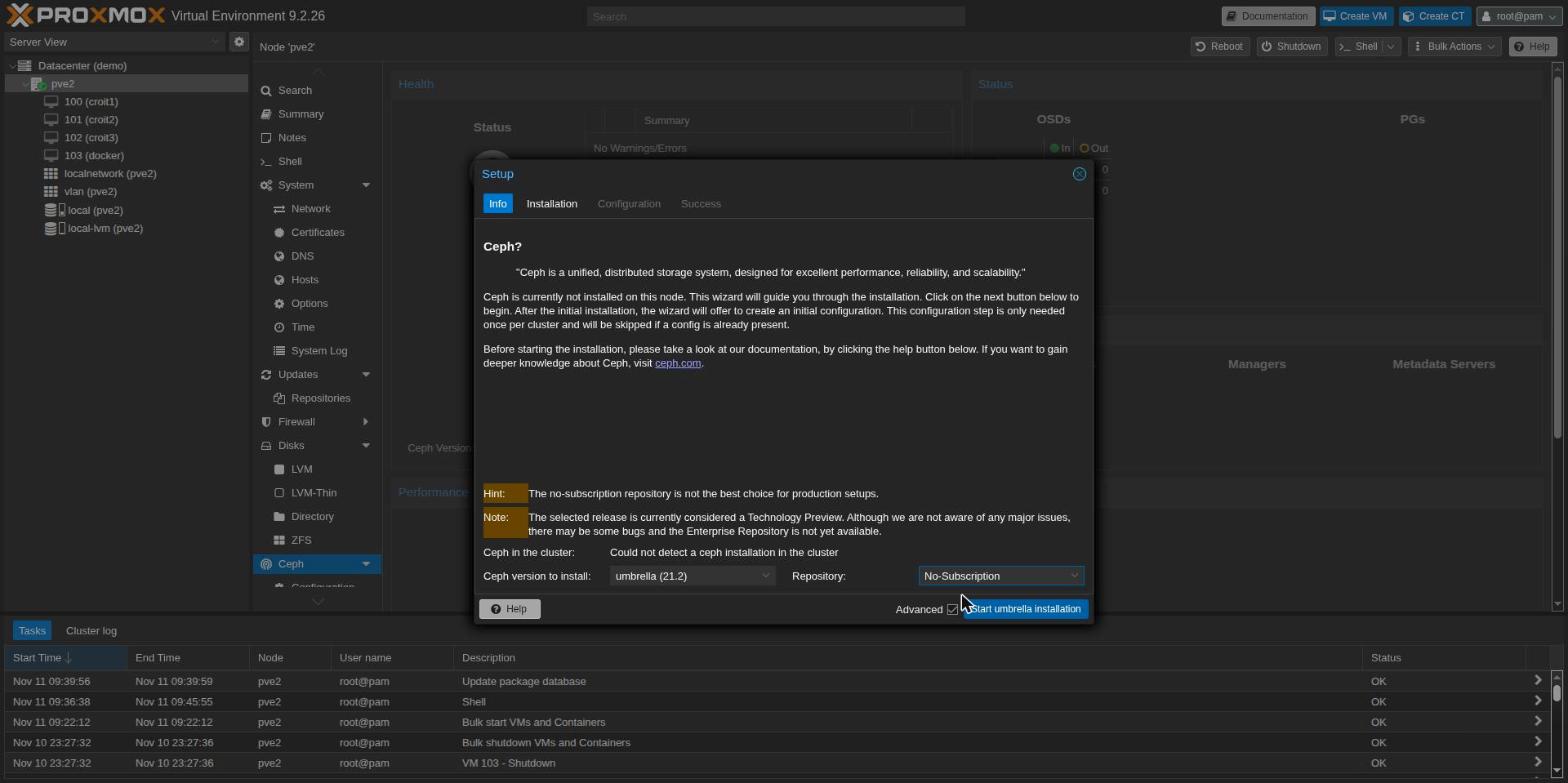
«Technology Preview», sem repositório enterprise, e o instalador pergunta uma segunda vez no terminal, continue (y/N)?, antes de tocar no apt.
É a quantidade certa de aviso, e vale a pena lê-lo como uma afirmação sobre a pilha inteira: um OSD em preview numa versão do Ceph em preview.
A instalação é Proxmox de origem. Datacenter → Ceph → Install, versão Umbrella, repositório No-Subscription, depois a rede pública e o primeiro monitor.
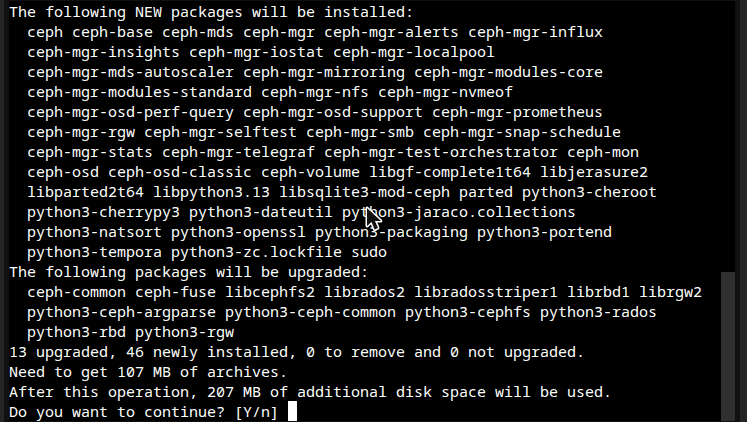
Treze pacotes atualizados, 46 novos, 107 MB descarregados.
Uma coisa nessa lista é nova no Umbrella: ceph-osd-classic ao lado de ceph-osd.
Nenhum é usado aqui, porque nunca é criado nenhum OSD clássico.
Cerca de um minuto depois, o mon.pve2 e o mgr.pve2 estavam a correr, o ceph versions reportava 21.2.0 … umbrella, e a saúde estava OK, sem nada para guardar ainda.
Quatro discos a 512 bytes
Quatro dos oito Optane tinham sido passados a uma VM de laboratório e ainda estavam no formato de 512 bytes, com etiquetas ZFS antigas. Outros dois tinham o formato certo e as mesmas etiquetas. A correção para ambos é simples: tirá-los da VM, formatar para 4 KiB, apagar as etiquetas.
O P4800X oferece 4096 bytes sem metadados como formato LBA 3, que o nvme id-ns reporta como lbaf 3 : ms:0 lbads:12.
nvme format /dev/nvme0n1 --lbaf=3 --force --timeout=900000
wipefs -a /dev/nvme0n1
sgdisk --zap-all /dev/nvme0n1
A primeira tentativa falhou, e uma posterior também.
Das duas vezes, o nvme format voltou com Interrupted system call e o disco continuava a 512 bytes.
O registo do kernel tem a razão:
nvme nvme0: I/O tag 0 (0000) opcode 0x2 (Admin Cmd) QID 0 timeout, reset controller
nvme nvme1: I/O tag 9 (0009) opcode 0x6 (Admin Cmd) QID 0 timeout, reset controller
O opcode 0x2 é Get Log Page e o 0x6 é Identify.
Nenhum deles é a formatação.
Um P4800X formata o suporte inteiro, e isso demorou entre 345 e 351 segundos por disco aqui.
Enquanto corre, o controlador não responde a outros comandos de administração, por isso tudo o que faça uma pergunta ao disco fica à espera.
Ao fim do timeout de administração de 60 segundos do kernel, este desiste e faz reset ao controlador, e o reset mata a formatação.
| Tentativa | O que chegou ao disco | Resultado |
|---|---|---|
| nvme0, primeira | um Get Log Page às 09:53:04, a meio da instalação do Ceph | abortada, ainda 512 B |
| nvme0, numa unit | nada | 4 KiB em 345 s |
| nvme1 | o meu próprio nvme list, a verificar o progresso | abortada, ainda 512 B |
| nvme2, nvme3 | nada | 4 KiB em 351 s e 350 s |
| nvme1, sozinho | nada | 4 KiB em 346 s |
A correção é correr cada formatação numa unit transitória com um timeout longo, um disco de cada vez, e deixar os discos em paz até acabar:
systemd-run --unit=fmt4k /root/fmt4k.sh
journalctl -u fmt4k -f       # read progress from the journal, not from the drive
Assim, a única verificação de progresso é o journal, e nada chega ao controlador.
Os oito passaram então a ler 4 KiB no nvme list.
O pacote
A página de lançamento tem pacotes .deb e .rpm, com o Debian 13 trixie entre eles, que é a base do Proxmox VE 92.
Uma só compilação serve todas as distribuições, e precisa de glibc 2.34 ou mais recente6.
B=https://github.com/croit/ceph-rust/releases/download/snapshot-2026-11-10-0b6783237291
curl -LO "$B/flashstore_21.2.0+git.20261110063351.c5792750020e_debian-trixie_amd64.deb"
curl -LO "$B/sha256sums.txt"
sha256sum flashstore_*_debian-trixie_amd64.deb
grep debian-trixie/flashstore_ sha256sums.txt
Verifica-o à mão.
O sha256sum -c não consegue verificar este download, porque o ficheiro de checksums chama-lhe debian-trixie/flashstore_…_amd64.deb enquanto o asset se chama flashstore_…_debian-trixie_amd64.deb.
Os hashes coincidem, ce1fb352…26c8 dos dois lados, por isso o ficheiro está bom e só a lista está desfasada dos assets.
apt install ./flashstore_*_debian-trixie_amd64.deb
croit-flashstore-osd --version
croit-flashstore-osd 21.2.0 umbrella (build 0.0.0) git c5792750020e
net tiers: kernel (+rdma upgrade)
Instalou-se sem problemas ao lado do ceph-osd e do ceph-osd-classic do próprio Proxmox.
O pacote instala um ceph-osd.target mínimo apenas nos hosts que não tenham um6, e o Proxmox já tem, por isso as units do FlashStore ficam penduradas no mesmo target onde ficariam as clássicas.
Três coisas sobre o pacote que vale a pena saber antes de escreveres scripts contra ele:
| O que a documentação diz | O que o pacote é | |
|---|---|---|
| Nome do pacote | apt remove flashstore …6 | croit-flashstore-osd, o ficheiro do asset é flashstore_… |
| Backends de armazenamento | o conjunto de funcionalidades de produção do main é knet,spdk,rdma,mimalloc1 | sem SPDK: o --check reporta «SPDK NVMe driver: compiled out» |
Valores de flashstore_dev | spdk:<pci>, ou file: em compilações de desenvolvimento7 | o tier kernel, kernel:/dev/…, é o único caminho de armazenamento real nesta compilação |
A linha do meio importa.
O tier SPDK, o driver NVMe em espaço de utilizador que precisa do disco ligado ao vfio-pci, não está no pacote Debian publicado.
O que está lá é o tier kernel: o disco fica no driver nvme do próprio kernel e o FlashStore fala com ele através do io_uring.
O código-fonte mostra-o compilado, porque a funcionalidade knet puxa o kernel-nvme8, embora a linha de resumo da verificação do host diga que está «compiled out of this build».
Essa linha está errada.
Um leitor que confie nela parava ali mesmo.
O que a verificação do host diz
O croit-flashstore-osd --check é só de leitura e corre antes de qualquer coisa ser escrita.
Verifica a compilação, o CPU, a memória, a IOMMU, cada controlador NVMe, a placa de rede, o kernel e a configuração, e imprime a correção exata para cada problema encontrado9.
Neste nó correu 115 verificações, e é boa: cada problema vem com o comando que o resolve, o que me poupou um monte de escavação.
| Problema | Resultado | O que fiz |
|---|---|---|
| Hugepages: nenhuma reservada | FAIL | reservei os 16 GiB que pedia, persistidos em /etc/sysctl.d |
| Disco de arranque SN750: cache de escrita volátil | FAIL | nada, não é candidato a OSD |
vfio-pci não carregado | WARN | nada, esta compilação não tem SPDK para o usar |
| limite de memlock 8 MiB | WARN | nada, mede a shell; a unit define LimitMEMLOCK=infinity |
sem isolcpus / nohz_full | WARN | registado, afinação de latência |
IOMMU em tradução, não iommu=pt | WARN | registado |
init_on_alloc=1 | WARN | registado, custa 15 a 20% de CPU em leituras grandes, segundo diz |
| porta de 2,5 GbE, anéis da placa por omissão, IRQ em cinco CPU | WARN | registado |
| 8 × P4800X: sem VWC, 4096+0 ativo, x4 a 8 GT/s, livres | OK | |
| io_uring com SEND_ZC e buffers fixos, kernel 7.0 | OK |
Conta com o segundo FAIL.
A verificação conta todos os controladores da máquina, e o SSD de arranque tem cache de escrita, por isso chumba no teste de proteção contra falhas de energia, embora a mesma verificação o marque corretamente como «in use, not a candidate».
O tutorial diz que exit 0 quer dizer nenhum FAIL9.
Em qualquer host que arranque de um SSD de consumo, que são muitos hosts Proxmox, o --check não consegue sair com 0, corrijas o que corrigires.
Escreve os scripts contra as linhas de cada verificação, não contra o código de saída.
Os WARN de afinação ficaram. Cada um precisa de uma alteração na linha de comandos do kernel e de um reboot, e isto é uma instalação, não um benchmark. São a lista certa para trabalhar antes de alguém citar um número desta máquina.
Núcleos e hugepages para oito OSD
O FlashStore corre uma thread por núcleo, e a verificação explica o que isso quer dizer: «one core = one shard/PG owner», no máximo 8 núcleos por OSD, e cada núcleo de OSD no seu próprio núcleo físico, em vez de o partilhar com um irmão SMT.
Oito núcleos físicos e oito OSD dá um núcleo para cada, flashstore_lcores = 0 até 7, com os irmãos SMT deixados ao Proxmox e às VM.
Corrida de novo com isso na configuração, a verificação marca todos os planos de núcleos como OK.
Olha outra vez para as hugepages.
A verificação pede 2048 MiB por OSD, que é o --mem por omissão do daemon, por isso oito OSD precisam de 16 GiB reservados.
Em funcionamento, cada OSD usou 512 MiB dos seus 2048.
Isso bate com a nota de desenho da própria croit para o backend kernel, que orçamenta um quarto do --mem para o seu alocador de payload10.
Portanto, nesta máquina, com os oito a correr, 12 GiB de RAM ficam reservados como hugepages em que nada toca, num host que também tem VM para alimentar.
Um nó de armazenamento encolheria os ombros.
Num nó Proxmox, essa memória era uma VM, e mais abaixo é cortada para o que os OSD usam.
Posso perguntar porque é que não consegue ler o ceph.conf?
Com os discos formatados, o pacote instalado e a verificação do host limpa, o primeiro OSD não arrancava.
croit-flashstore-tool: refused: /etc/ceph/ceph.conf: Permission denied (os error 13)
No Proxmox, o /etc/ceph/ceph.conf é um symlink para o /etc/pve/ceph.conf, e o /etc/pve é o pmxcfs, o sistema de ficheiros do cluster que mantém a configuração de todos os nós sincronizada.
Os ficheiros ali são root:www-data 0640, e o pmxcfs não te deixa mudar isso ficheiro a ficheiro11.
Os daemons Ceph do próprio Proxmox safam-se porque arrancam como root, leem a configuração e depois descem para o utilizador ceph, que é o que faz o --setuser ceph --setgroup ceph em todas as units ceph-osd@.
A unit do FlashStore não arranca como root.
É User=ceph desde a primeira instrução, ExecStartPre incluído12, por isso nunca chega a ler o ficheiro.
Posso perguntar porque é que um pacote compilado para Debian, para um produto que se diz drop-in, não foi experimentado na plataforma Ceph baseada em Debian mais comum que existe? Não estou a perguntar quem. O pveceph guarda a sua configuração no pmxcfs, e todos os OSD FlashStore num nó gerido pelo pveceph vão bater nisto no primeiro arranque.
O daemon já tem a resposta embutida.
O seu código descreve uma descida clássica com --setuser/--setgroup: «started as root by a classic unit (--setuser ceph --setgroup ceph), the daemon becomes that user before it opens the store, a socket or a file»13.
Portanto, um drop-in que arranque a unit da forma como o Proxmox arranca os seus próprios OSD devia bastar.
Não bastou bem. Arrancado como root simples, a recusa seguinte foi o disco.
activate: device kernel:/dev/ng0n1 not ready: /dev/nvme0n1: Permission denied (os error 13)
O CapabilityBoundingSet da unit deixa de fora o CAP_DAC_OVERRIDE12, por isso o root fica sujeito às permissões normais dos ficheiros, e os nós do namespace pertencem a ceph:ceph.
Arrancar como root com o grupo definido como ceph cobre as duas coisas: o root é dono do ficheiro de configuração, o grupo ceph abre o disco, e o daemon desce para ceph antes de fazer qualquer outra coisa.
# /etc/systemd/system/croit-flashstore-osd@.service.d/pve-ceph-conf.conf
[Service]
User=root
Group=ceph
ExecStart=
ExecStart=/usr/bin/croit-flashstore-osd run --id %i --cluster ${CLUSTER} -f --setuser ceph --setgroup ceph
O daemon confirma a descida no seu próprio registo: set uid:gid to 64045:64045 (ceph).
Há uma correção mais curta, SupplementaryGroups=www-data, e não a usei.
Deixaria o OSD ler todos os ficheiros legíveis pelo grupo em /etc/pve, não só a configuração do Ceph.
Um OSD não tem nada que ler o resto da configuração do cluster, e o drop-in acima não lhe dá nada além do que o Proxmox dá aos seus.
Depois, os nós de dispositivo.
A documentação do FlashStore diz que o nó do namespace tem de poder ser escrito pelo ceph, «(udev rule)»14, e o pacote não traz nenhuma.
Esta apanha os discos pelo modelo, por isso não pode apanhar o disco de arranque, faça a numeração o que fizer:
# /etc/udev/rules.d/70-croit-flashstore-optane.rules
SUBSYSTEM=="nvme-generic", KERNEL=="ng*n*", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
SUBSYSTEM=="block", KERNEL=="nvme*n*", ENV{DEVTYPE}=="disk", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
Depois do udevadm trigger, os dezasseis nós dos Optane ficaram ceph:ceph 0660 e o SN750 ficou root.
O passthrough que este kernel não faz
O tier kernel tem dois modos, e o nó que indicas escolhe entre eles.
O kernel:/dev/ngXnY envia comandos NVMe diretamente ao disco através do io_uring, a que a croit chama kernel-cmd.
O kernel:/dev/nvmeXnY faz leituras e escritas O_DIRECT no dispositivo de blocos, chamado kernel ou direto10.
A croit mediu o kernel-cmd à frente em todas as células que testou10, e o próprio quick start do README usa-o1, por isso foi o que configurei.
Com as permissões resolvidas, o daemon desceu para ceph, leu a sua configuração e parou na primeira leitura:
croit-flashstore-osd: --dev kernel:/dev/ng0n1: /dev/ng0n1: kernel-cmd fixed-buffer probe read: Errno(13)
A mesma sonda tinha passado um minuto antes no activate, que ainda tinha as capabilities do root.
Por isso a pergunta é se este kernel deixa um processo sem privilégios enviar comandos de I/O pelo /dev/ngXnY.
Isso responde-se sem o FlashStore, com a mesma leitura feita pelo nvme-cli, como ceph:
| Como | Comando em /dev/ng0n1 | Resultado |
|---|---|---|
ceph | Identify Namespace | permitido |
ceph | Read, LBA 0, 4 KiB | Permission denied |
root | Read, LBA 0, 4 KiB | permitido |
Os oito Optane deram a mesma resposta, incluindo dois que eu nunca tinha formatado nem feito reset, a correr firmware da Intel e não da Dell. Portanto não são os discos e não são as formatações da manhã.
O upstream diz que devia funcionar.
No Linux 7.0, o nvme_cmd_allowed() deixa um processo sem privilégios enviar um comando de I/O quando o registo Commands Supported and Effects do disco o marca como suportado sem efeitos invulgares, e só exige uma abertura com escrita para comandos que escrevam ou alterem dados15.
O registo de efeitos do P4800X marca o Read como suportado, 00000001, e mais nada.
A leitura é permitida.
O kernel do Proxmox não é o do upstream.
O seu changelog para esta compilação inclui uma correção retroportada exatamente neste caminho, CVE-2026-90227: nvme/ioctl: check SUBMIT_IO with nvme_cmd_allowed(), que à primeira vista cobre um ioctl diferente do que testei.
Não identifiquei que alteração no kernel 7.0.14-28-pve faz a diferença, e não vou adivinhar.
O que é certo é o comportamento: neste kernel, o I/O NVMe em passthrough sem privilégios é recusado.
O FlashStore tem um recurso para o passthrough recusado, e não disparou.
A nota de desenho da croit diz que, quando o Identify é recusado, um dispositivo kernel-cmd passa para I/O direto no seu nó de blocos e di-lo no arranque10.
Aqui o Identify é permitido e o Read não, por isso o recurso nunca dispara e o OSD para em vez disso.
Ao I/O direto não interessa. É uma linha por OSD:
flashstore_store_backend = kernel
Com isso, o osd.0 subiu.
croit-flashstore-osd: store mounted (1 shards, replayed 4 txns in 16 ms)
croit-flashstore-osd: set uid:gid to 64045:64045 (ceph)
[    1.398] crush location set (create-or-move updating item name 'osd.0' weight 0.3359 at location {host=pve2,root=default} to crush map)
[    2.406] osd.0 is now active (up_from 10, map 10)
Ativo em 2,4 segundos.
Preparar e arrancar os OSD
Cada OSD tem uma secção na configuração do Ceph, o que no Proxmox quer dizer editar o /etc/pve/ceph.conf, e não há mal nenhum em fazê-lo à mão.
[osd.0]
	flashstore_dev = spdk:0000:05:00.0
	flashstore_store_backend = kernel
	flashstore_lcores = 0
O dispositivo é indicado pelo endereço PCI, não por /dev/nvme0n1, e o prefixo spdk: aqui não quer dizer SPDK.
Com um backend kernel definido, o daemon procura o endereço no sysfs em cada arranque e encontra os nós atuais do controlador10.
Isso importa aqui.
O disco de arranque SN750 era nvme7 em outubro e é nvme8 agora, e os minors dos nós genéricos também não seguem a ordem dos discos, com ng1n1 no minor 0 e ng0n1 no minor 2.
Uma configuração que diga /dev/nvme4n1 pode apontar para outro disco depois de um reboot.
Uma configuração que diga 0000:0b:00.0 não pode.
Depois, um comando por disco, que escreve o armazenamento e regista o OSD no monitor:
croit-flashstore-tool prepare --dev spdk:0000:05:00.0 --id 0
kernel-cmd /dev/ng0n1: fixed-buffer NVMe passthrough probe ok (IORING_URING_CMD_FIXED on)
mkfs: device lba 4096 B x 91573146 (375083606016 B), awupf 1 lba, vwc false, max_xfer 32 lba
mkfs: 1 store shards, WAL ring 4096 MiB each
osd.0 prepared in /var/lib/ceph/osd/ceph-0
Dois segundos, como root.
O prepare lê a chave de bootstrap de /var/lib/ceph/bootstrap-osd/ceph.keyring16, que o pveceph só escreve da primeira vez que cria um OSD seu, por isso, sem OSD clássicos, tem de ser obtida primeiro:
ceph auth get client.bootstrap-osd -o /var/lib/ceph/bootstrap-osd/ceph.keyring
Seis discos ficaram preparados à primeira. Dois foram recusados:
croit-flashstore-tool: refused: device is not empty (non-zero data in the first 8192 bytes); --wipe destroys it
croit-flashstore-tool: refused: device is not empty (non-zero data at 65536 bytes); --wipe destroys it
O lsblk e o blkid tinham ambos reportado esses dois discos como vazios.
O que lá estava era a área de metadados em texto de um grupo de volumes LVM de um laboratório anterior, removido há muito, com a etiqueta do início já a zeros.
A sonda do FlashStore lê os primeiros 8 KiB e as regiões aos 64 KiB e aos 256 KiB17, o que é mais longe do que as ferramentas habituais olham, e tinha razão.
Recusar um disco que tenha seja o que for, a não ser que lhe digam --wipe, é exatamente o que uma ferramenta de OSD deve fazer.
Apagá-los é uma decisão de quem é dono dos discos, não da ferramenta.
Depois de isso estar decidido, o --wipe preparou ambos em cerca de dois segundos, e juntaram-se depois da instalação mais abaixo, e é por isso que a captura do painel e os números da instalação mostram seis.
Depois arranca-os:
systemctl enable --now croit-flashstore-osd@0
ID  CLASS  WEIGHT   TYPE NAME      STATUS  REWEIGHT  PRI-AFF
-1         2.01535  root default
-3         2.01535      host pve2
 0   nvme  0.33589          osd.0      up   1.00000  1.00000
 1   nvme  0.33589          osd.1      up   1.00000  1.00000
 2   nvme  0.33589          osd.2      up   1.00000  1.00000
 3   nvme  0.33589          osd.3      up   1.00000  1.00000
 4   nvme  0.33589          osd.4      up   1.00000  1.00000
 5   nvme  0.33589          osd.5      up   1.00000  1.00000
Cada OSD pôs-se sob host=pve2 com a classe de dispositivo nvme.
Vale a pena ler uma vez o que dizem de si próprios ao cluster:
| Campo | Monitor e manager | OSD FlashStore |
|---|---|---|
ceph versions | 21.2.0 (087cd25db8f1) umbrella (dev - None) | 21.2.0 (b060042deb05) umbrella (dev - croit-flashstore-osd) |
| Compilado por | Proxmox, pacotes -pve1 | croit, a partir do commit upstream v21.2.0 que o README indica1 |
osd_objectstore | bluestore, com todos os campos bluestore_bdev_* preenchidos | |
| O que é de facto | FlashStore, sem BlueFS, sem RocksDB |
A resposta BlueStore é deliberada.
O flashstore_report_objectstore tem bluestore por omissão porque os monitores clássicos só ativam algumas funcionalidades quando todos os OSD o reportam, por isso o valor por omissão mantém um cluster misto a funcionar7.
Não é verdade, e vale a pena sabê-lo antes de leres os metadados do cluster e acreditares neles.
O que o Proxmox faz deles
O painel de OSD do Proxmox lista os seis, up e in, classe nvme, versão 21.2.0, 344 GiB cada.
Também lhes chama FileStore.
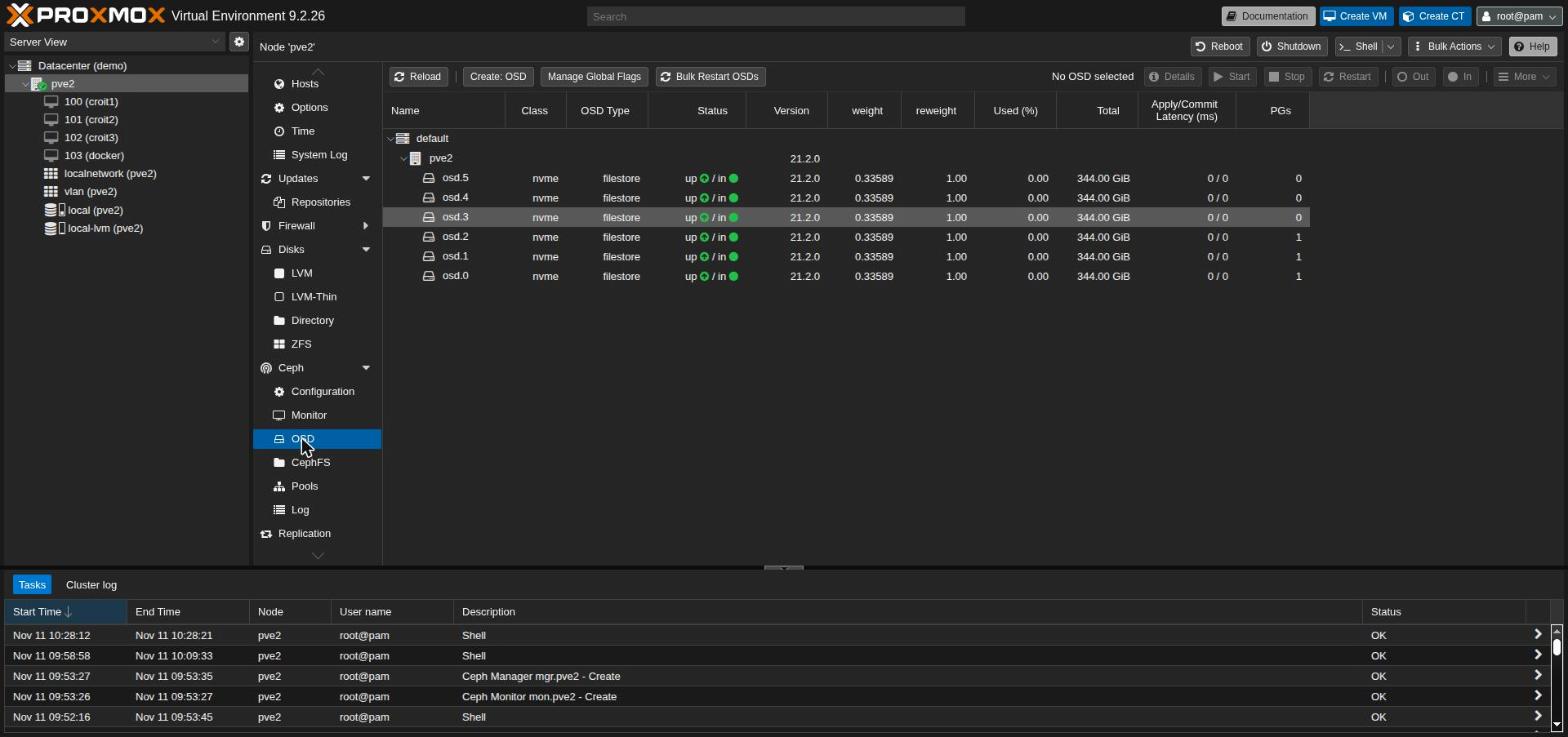
O FileStore é o armazenamento de objetos que o BlueStore substituiu.
O Proxmox decide a etiqueta em PVE/API2/Ceph/OSD.pm: se os metadados do OSD tiverem uma chave bluefs é BlueStore, e tudo o resto é FileStore18.
O FlashStore não tem BlueFS, porque não há RocksDB por baixo, por isso reporta BlueStore num campo e é etiquetado como FileStore a partir de outro.
Nenhum está certo.
E o painel é onde a maioria dos administradores Proxmox olha primeiro.
As colunas de latência mostram 0 / 0 em repouso.
Durante a instalação abaixo, o ceph osd perf reportou latências de commit de 0 a 3 ms nos seis.
O Start, o Stop e o Restart do painel atuam no ceph-osd@N, a unit clássica, que não é o que está a correr19.
Como tal, o painel é uma vista destes OSD, não um controlo deles.
Usa systemctl … croit-flashstore-osd@N e a CLI para tudo o que mexa nos daemons, e deixa bem quietos o Create: OSD e o Destroy nestes.
Uma pool, um armazenamento e uma VM Fisher-Price OS (Windows)
O primeiro PG do cluster, a pool .mgr do manager, ficou undersized+degraded assim que os OSD subiram.
A culpa é do nó único.
A replicated_rule por omissão põe cada cópia num host diferente, e há um host.
ceph osd crush rule create-replicated replicated_osd default osd nvme
ceph osd pool set .mgr crush_rule replicated_osd
Uma regra com domínio de falha osd e classe de dispositivo nvme20 põe cada cópia num OSD diferente, e o PG passou a active+clean em segundos.
Num cluster real com três ou mais hosts, mantém a regra por host e salta isto.
Tudo o que vem a seguir é a GUI do Proxmox normal.
Ceph → Pools → Create: nome flashstore, size 3, min size 2, regra replicated_osd, Add as Storage marcado.
Passou para size 2, min size 1 mais tarde, para o teste de carga mais abaixo.
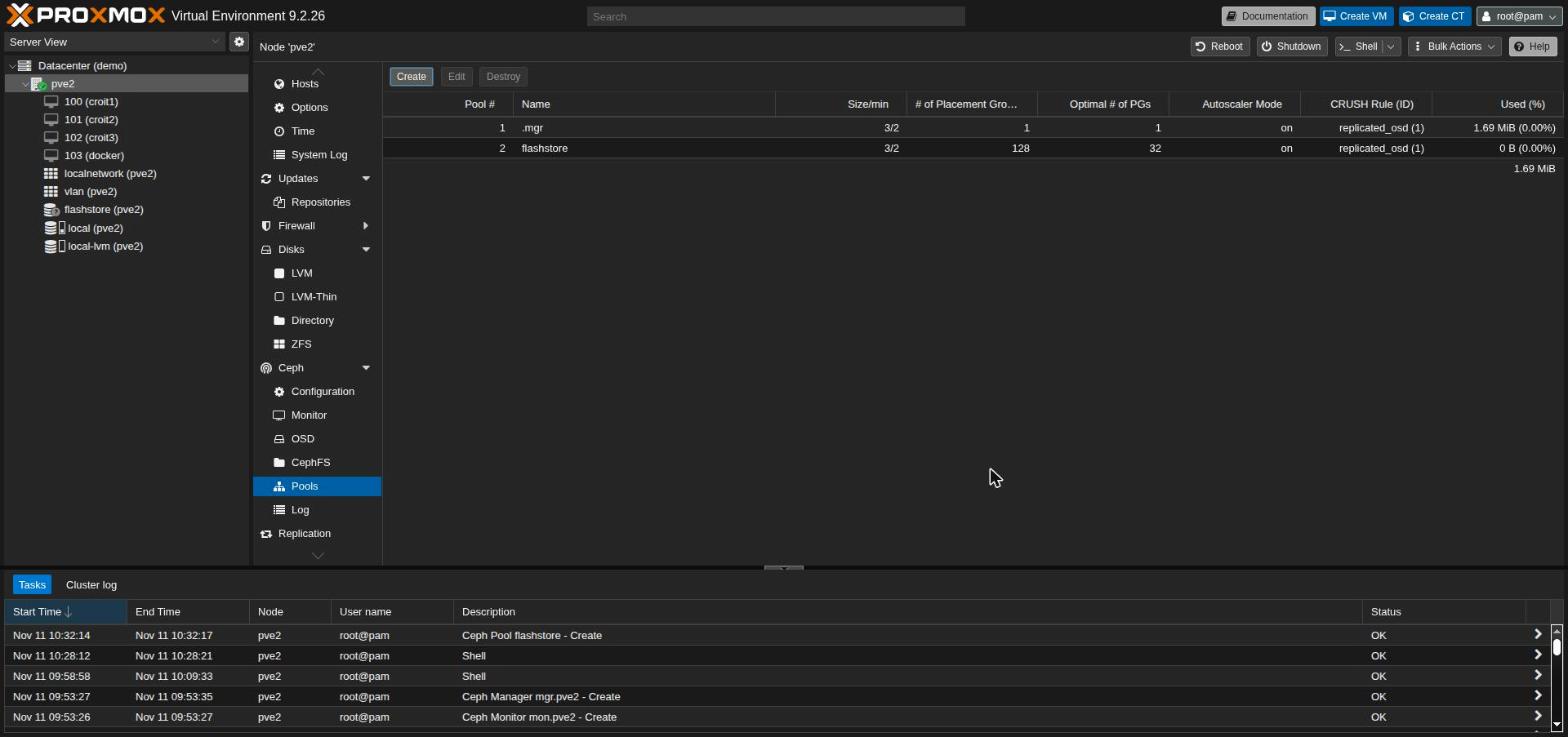
O Proxmox criou a pool e a definição de armazenamento RBD de uma vez, e o flashstore apareceu na árvore com 654 GiB utilizáveis, que são os 2 TiB brutos divididos por três cópias, menos o overhead.
129 PG passaram a active+clean, e o autoscaler baixou a nova pool de 128 para 32 pouco depois.
O convidado de teste é uma VM Fisher-Price OS (Windows).
Não é uma preferência, é o que uma grande parte dos clientes corre de facto nas suas pools Proxmox, por isso é a carga que conta: 16 GiB de memória, 4 núcleos, um disco de 60 GiB no flashstore com discard e iothread ligados.
Também é tagarela com o disco e ineficiente a usá-lo, que é precisamente a ideia: um teste de armazenamento quer o convidado que mais se apoia no disco.
A amostrar a pool a cada dez segundos durante os primeiros quinze minutos da instalação:
| Escritas na pool | mediana de 9,3 MB/s quando ativa, pico de 302 MB/s |
| Operações de escrita | pico de 2486 por segundo |
| Leituras na pool | pico de 60 MB/s |
| Espaço bruto usado | 35 GiB em seis OSD |
| Saúde | HEALTH_OK nas 90 amostras |
| Reinícios de OSD | 0 |
| Memória residente dos OSD | 565 a 871 MiB cada, depois |
São números de um instalador, com a VM e os OSD no mesmo host e os WARN de afinação por tocar, e não dizem nada sobre a velocidade do FlashStore. O que dizem é que um cliente Proxmox clássico conduziu a instalação de um sistema operativo em OSD de Rust, 35 GiB brutos, sem uma falha, que é a promessa que este artigo se propôs testar.
O que faz sob carga
Uma instalação prova que funciona. Não te diz como é usar a VM.
Por isso a VM levou com o CrystalDiskMark 9.0.321, três vezes: o perfil Real World Performance [+Mix], Read&Write [+Mix], um ficheiro de 16 GiB em C: e uma mistura de 70/30 de leitura e escrita, uma vez com três passagens e duas com nove. Esse perfil corre tudo um pedido de cada vez numa só thread, que é o que um desktop ou uma pequena base de dados fazem de facto, não o que faz uma ficha técnica.
Nessa altura, a configuração já tinha avançado desde a instalação. A VM tinha seis núcleos, e a pool tinha sido mudada na GUI para size 2, min size 1 e 256 PG. Size 2 com min size 1 é uma definição de laboratório numa só máquina: com uma cópia restante, a pool continua a aceitar escritas que uma única falha pode depois perder. Noutros sítios, mantém 3 e 2.
O disco estava no padrão do Proxmox, sem cache, que é o padrão desde o Proxmox 222.
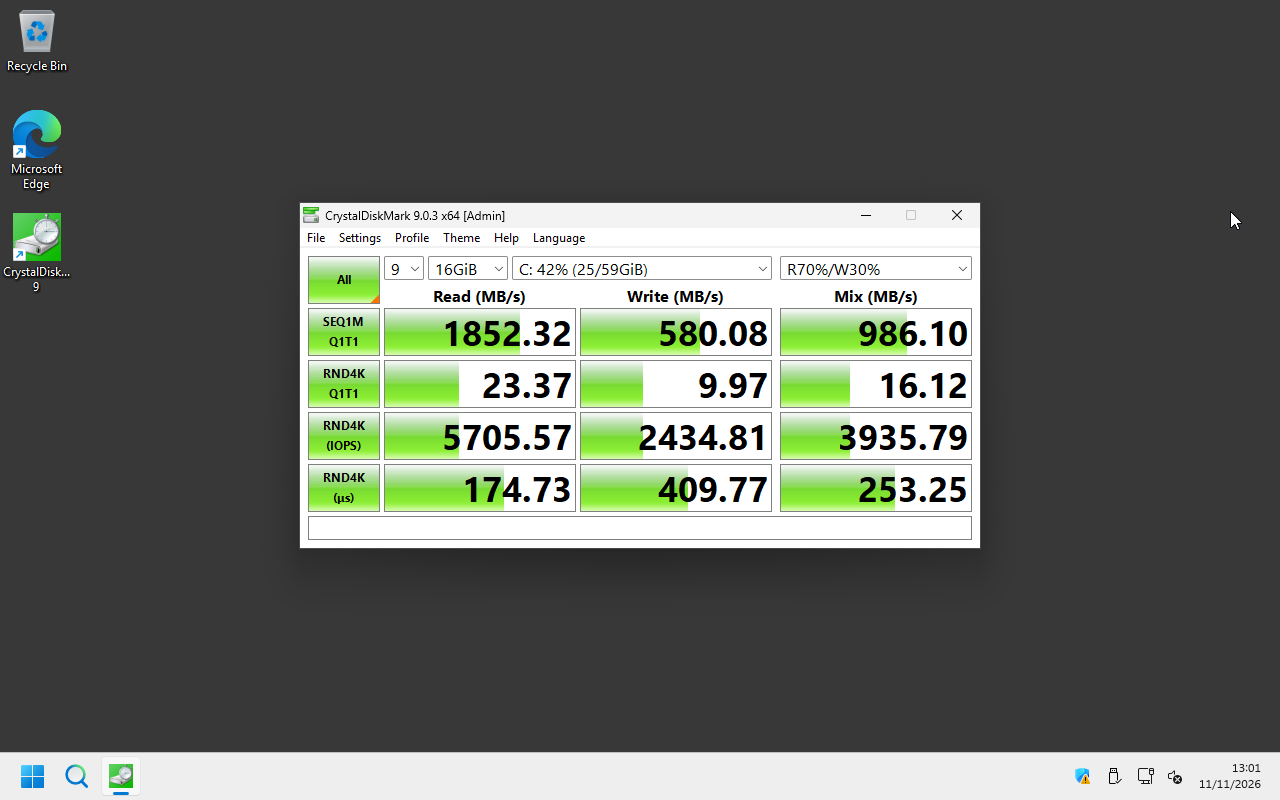
| Real World Performance [+Mix], 16 GiB | 3 passagens | 9 passagens | 9 passagens outra vez |
|---|---|---|---|
| SEQ1M Q1T1 leitura | 1279,71 MB/s | 1675,33 MB/s | 1852,32 MB/s |
| SEQ1M Q1T1 escrita | 563,67 MB/s | 576,65 MB/s | 580,08 MB/s |
| SEQ1M Q1T1 mistura | 1043,75 MB/s | 1043,28 MB/s | 986,10 MB/s |
| RND4K Q1T1 leitura | 5342 IOPS, 186,57 µs | 5659 IOPS, 176,17 µs | 5706 IOPS, 174,73 µs |
| RND4K Q1T1 escrita | 2419 IOPS, 412,51 µs | 2405 IOPS, 414,79 µs | 2435 IOPS, 409,77 µs |
| RND4K Q1T1 mistura | 3938 IOPS, 253,13 µs | 3826 IOPS, 260,49 µs | 3936 IOPS, 253,25 µs |
As escritas e a latência de blocos pequenos mantêm-se dentro de cerca de 1% de execução para execução. A leitura sequencial sobe 45% ao longo das três. É o primeiro sinal de que a coluna de leitura não está a medir o que parece.
O host foi amostrado a cada cinco segundos durante as três, a partir do /proc/diskstats para os oito Optane, do ceph status para a pool e do /proc para cada processo e thread, e as duas vistas não contam a mesma história.
Escritas: o disco é a parte pequena
| Uma escrita aleatória de 4 KiB de cada vez, última execução | |
|---|---|
| Tempo por escrita, visto pela VM | 409,77 µs |
| Tempo por escrita, em cada Optane | 17 µs |
| Escritas que chegam aos Optane por escrita da VM | 4,05: duas cópias, cerca de duas escritas cada |
| Escritas sequenciais grandes | 580 MB/s a partir da VM, 1,14 GB/s nos Optane, a segunda cópia a duplicá-lo |
O disco é menos de 5% de uma escrita pequena. Os outros 393 µs são a viagem: o QEMU, o librbd, o messenger até ao OSD, o próprio OSD e a espera pela segunda cópia. Nada disso foi medido em separado aqui, por isso não vou pôr um número em cada peça. O que isto diz é que, nesta máquina, os Optane não são o limite para I/O um de cada vez, e um disco mais rápido não mexeria muito nesses 410. O limite passou para o cliente, o librbd que o Proxmox fornece, e há mais para vir sobre isso quando o librustyrbd da própria croit for instalado aqui.
Leituras: a cache, não os Optane
Na última execução, a passagem de leitura aleatória de 4 KiB fez 5700 leituras por segundo em todo o ficheiro de 16 GiB, e os oito Optane não leram rigorosamente nada.
A passagem sequencial chegou a 2,2 GB/s na pool enquanto as leituras dos próprios discos caíam de 755 MB/s para zero.
O CrystalDiskMark contorna a cache do convidado e o disco não tem nenhuma no QEMU, por isso a memória que faz o trabalho está nos OSD.
O flashstore_obj_cache está ligado por omissão nesta compilação, a parte de cada OSD do ficheiro é de cerca de 2 GiB com size 2, e cada OSD tinha crescido para cerca de 2,6 GiB.
O FlashStore não reporta os seus acertos, por isso chama-lhe quase certo e não provado.
É também por isso que a leitura sequencial subiu a cada execução: mais do ficheiro já lá estava.
Trata a coluna de leitura como um número de cache, não de armazenamento.
CPU: para onde foram os núcleos
| Última execução, em núcleos | Host ocupado | OSD | vCPU do convidado | librbd e cliente Ceph | QEMU |
|---|---|---|---|---|---|
| Em repouso entre passagens | 20 a 24% | 3,3 | 0,1 | 0,03 | 0,03 |
| Escrita aleatória de 4 KiB | 30% | 3,9 | 0,38 | 0,20 | 0,08 |
| Leitura aleatória de 4 KiB | 30% | 3,6 | 0,47 | 0,39 | 0,15 |
| Mistura sequencial | 41 a 53% | 3,8 | 1,5 a 2,3 | 0,5 | 0,12 |
As três colunas da VM vêm das suas threads: o QEMU dá nome às vCPU do convidado, e as threads de messenger e de trabalho do librbd correm dentro do mesmo processo.
A coluna dos OSD quase não se mexe. Oito OSD em polling custam 3,3 núcleos sem fazer nada e 3,9 a fundo, por isso, numa máquina de 16 threads, um quinto do CPU vai-se antes de uma VM pedir seja o que for. Mais nada chegou perto do seu limite. A thread individual mais ocupada foi uma vCPU do convidado a 47%, e a mais ocupada do librbd ficou abaixo dos 15%. Com um pedido de cada vez, o limite é a espera, não o trabalho, e um número de CPU não consegue mostrar uma espera.
Memória: planeia para o pico
| Nas três execuções | |
|---|---|
| Saúde | HEALTH_OK em todas as amostras, todos os PG active+clean, nenhum reinício de OSD |
| Hugepages em uso | 4 GiB do princípio ao fim |
| Memória do host por distribuir, com uma VM de 16 GiB a correr | 3,1 a 4,0 GiB |
A linha das hugepages é a secção do orçamento outra vez, desta vez sob carga: 512 MiB por OSD, e os outros 12 GiB nunca tocados.
A memória normal é o número a vigiar, porque a cache acima é feita dela. Assim que uma leitura puxou o ficheiro, cada OSD ficou em cerca de 2,5 GiB, e foi isto que o Ceph ocupou num host de 58,7 GiB:
| Memória do Ceph no pico, alvo por omissão de 4 GiB | |
|---|---|
| Processos OSD, os oito juntos | 19,9 GiB, 2,4 a 2,6 GiB cada |
| Hugepages reservadas para os OSD | 16 GiB, 4 GiB usados |
| Monitor e manager | 0,3 GiB |
| Total | 36,2 GiB, 62% do host |
| Por distribuir pelo host, com uma VM de 16 GiB a correr | 3,6 GiB |
Volta, mas não segundo nenhum calendário que eu conseguisse ver.
Manteve-se nos 19,9 GiB durante 25 minutos, intervalos em repouso incluídos, depois caiu para 13,9 GiB no fim da última execução, e o host voltou a ter 10,2 GiB para distribuir.
O osd_memory_target esteve no seu valor por omissão de 4 GiB por OSD durante tudo isso, por isso oito OSD tinham direito a 32 GiB antes de se contar uma única hugepage.
Num nó que também é suposto correr VM, o pico é o orçamento a calcular antes dos discos, e é onde os 12 GiB parados de hugepages mais doem.
Três VM ao mesmo tempo, com um orçamento mais apertado
Uma VM deixa espaço de sobra. Três é onde o orçamento tem de estar certo. Por isso mudaram primeiro duas definições.
ceph config set osd osd_memory_target 1073741824   # 1 GiB per OSD, was 4
sysctl -w vm.nr_hugepages=2048                     # what eight OSDs use, was 8192
O alvo não precisa de mais nada: todos os OSD reportaram o novo valor em segundos, e foram reiniciados um de cada vez na mesma, com os 257 PG de volta a active+clean antes do seguinte.
As hugepages têm um senão.
Antes de cada arranque de OSD, o croit-flashstore-prep quer um --mem inteiro livre, 2048 MiB, e aumenta a pool se faltar, mas nunca a volta a baixar.
Reiniciar o osd.7 depois do corte levou a pool logo de volta para cima:
croit-flashstore-prep[7]: hugepages 2048kB: free 256 < need 1024, nr_hugepages 2048 -> 2816
Portanto, o mínimo que sobrevive a um reinício ou a um reboot é o que os OSD usam mais a margem de um arranque: 2816 páginas, 5,5 GiB, contra os 16 GiB que a verificação pede. O script de instalação mais abaixo agora reserva exatamente isso. Cortar de volta para 2048 depois de os oito estarem de pé compra mais 1,5 GiB até ao próximo reinício.
Depois, três clones da VM, com 10 GiB cada, correram o CrystalDiskMark no mesmo momento: Real World Performance [+Mix], três passagens, mas num ficheiro de 1 GiB cada em vez de 16 GiB. Isso torna a coluna de leitura ainda mais um número de cache, por isso lê as escritas.
| CrystalDiskMark, três VM ao mesmo tempo | VM 104 | VM 105 | VM 106 | As três | Uma VM sozinha |
|---|---|---|---|---|---|
| SEQ1M Q1T1 escrita | 346,99 MB/s | 318,99 MB/s | 446,98 MB/s | 1113 MB/s | 580,08 MB/s |
| SEQ1M Q1T1 leitura | 796,05 MB/s | 905,03 MB/s | 1160,93 MB/s | 2862 MB/s | 1852,32 MB/s |
| RND4K Q1T1 escrita | 1901 IOPS | 1928 IOPS | 1862 IOPS | 5691 IOPS | 2435 IOPS |
| RND4K Q1T1 latência de escrita | 524,56 µs | 517,00 µs | 535,42 µs | 409,77 µs | |
| RND4K Q1T1 leitura | 3773 IOPS | 3916 IOPS | 3909 IOPS | 11 598 IOPS | 5706 IOPS |
| RND4K Q1T1 mistura | 2978 IOPS | 3027 IOPS | 3411 IOPS | 9416 IOPS | 3936 IOPS |
Três VM tiveram 2,3 vezes as escritas pequenas de uma, e cada uma pagou cerca de 27% em latência por isso. Os Optane continuavam a não ser a razão. Chegaram a um pico de 20 900 escritas por segundo a 17 µs cada, os mesmos 17 µs de uma VM, e o mais ocupado dos oito estava 14% ocupado.
| Host, a cada cinco segundos durante a execução | Alvo por omissão de 4 GiB, uma VM | Alvo de 1 GiB, três VM |
|---|---|---|
| Maior processo OSD | 2,7 GiB | 1,15 GiB no pico, 0,8 depois |
| Os oito processos OSD juntos | 19,9 GiB | 8,0 GiB no pico, 5,8 depois |
| Hugepages reservadas | 16 GiB, 4 usados | 4 GiB, todos usados |
| Memória dada às VM | 16 GiB | 30 GiB |
| Memória do host por distribuir, no mínimo | 3,1 GiB | 14,8 GiB |
| Crescimento da swap | nenhum | nenhum |
Portanto, o FlashStore cumpre de facto o osd_memory_target.
Passou 15% acima no pico de uma passagem de leitura e voltou para baixo, com a cache a fazer o seu trabalho dentro do orçamento em vez de fora dele.
Entre o alvo e o corte, 26 GiB voltaram para as VM na mesma máquina.
| CPU em núcleos, três VM | Host ocupado | OSD | Convidados | librbd e cliente Ceph | QEMU |
|---|---|---|---|---|---|
| Três arranques de Fisher-Price OS (Windows) | 81 a 89% | 3,4 a 3,6 | 6,3 a 7,9 | 0,4 a 0,7 | 0,3 |
| Benchmark | 42 a 73% | 3,7 a 4,5 | 1,2 a 4,0 | 0,4 a 1,6 | 0,2 a 0,4 |
| Em repouso depois | 20 a 24% | 3,3 | 0,3 | 0 | 0 |
Arrancar três convidados puxou mais pelo CPU do que fazer-lhes o benchmark. O armazenamento por baixo nunca chegou perto disso, que é o mini PC a definir o limite, como sempre ia acontecer.
Tudo isto, num só script
Tudo o que está acima está num só script. Dá-lhe os endereços PCI dos discos que queres como OSD e ele faz o resto, pela ordem em que este artigo o fez, com as duas correções do Proxmox embutidas.
flashstore-pve-setup.sh: OSD FlashStore num nó Proxmox VElspci -D -d ::0108 # find the drives
bash flashstore-pve-setup.sh --dry-run 0000:05:00.0 # show the plan, change nothing
bash flashstore-pve-setup.sh 0000:05:00.0 0000:06:00.0
| Verifica | Escreve | Corre |
|---|---|---|
| Proxmox VE 9 e Ceph 21.2.0 Umbrella | o keyring bootstrap-osd | uma leitura em passthrough como ceph, para escolher kernel-cmd ou kernel |
| cada disco: NVMe, sem cache de escrita, não montado, particionado nem ocupado | o drop-in de root-depois---setuser | prepare e systemctl enable --now por disco |
| nenhum dado nas regiões que a própria sonda do FlashStore lê | uma regra udev por disco, identificado pelo número de série | a verificação do host, parando só no que os OSD precisam |
| blocos de 4 KiB | uma secção [osd.N] por disco, um núcleo físico cada | o download do pacote, verificado contra o SHA-256 do lançamento |
Nada é destruído a não ser que peças.
O --format-4k reformata um disco que não esteja a 4 KiB, um de cada vez na sua própria unit para que nada o interrompa, e o --wipe deixa-o sobrescrever um disco que tenha dados.
O --single-node acrescenta a regra replicated_osd, e corrê-lo outra vez salta os discos que já são OSD.
Foi testado aqui, não só escrito.
Recusou o SN750 pela sua cache de escrita, recusou o disco do osd.7 enquanto ainda tinha um armazenamento, e depois, com o osd.7 eliminado e os seus nós devolvidos ao root, reconstruiu-o do zero em 10,5 segundos, escolhendo sozinho o backend kernel.
O que não faz é instalar o Ceph.
Esse passo pede-te que aceites uma Technology Preview, e essa decisão é tua, não de um script.
O que precisa de correção
Nada disto trava um administrador determinado, e tudo isto travaria um administrador ocupado. Cada item é uma afirmação que a croit faz a quem descarrega o pacote, e bati em cada um à primeira tentativa.
| Onde | O que acontece | O que o corrigiria |
|---|---|---|
| unit systemd | User=ceph não consegue ler o pmxcfs, por isso o OSD nunca arranca num nó pveceph | fornecer o arranque root-depois---setuser, ou um drop-in para Proxmox |
| recurso do kernel-cmd | só recua se o Identify for recusado; no kernel do PVE é o Read que é recusado e o OSD para | recuar para I/O direto em qualquer I/O em passthrough recusado |
| udev | a documentação exige uma regra que dê ao ceph os nós do namespace; não vem nenhuma | fornecer uma ligada aos dispositivos configurados |
resumo do --check | diz que o kernel NVMe está «compiled out» quando é o único caminho de armazenamento compilado | corrigir a etiqueta |
código de saída do --check | o SSD de arranque chumba no teste de PLP, por isso o exit 0 é inalcançável | pontuar só dispositivos configurados ou candidatos |
| hugepages | dimensiona 2048 MiB por OSD, e o prep quer isso livre a cada arranque; o backend kernel usa 512 | dimensionar o backend kernel pelo que usa, e deixar o prep pedir o mesmo |
sha256sums.txt | os nomes dos ficheiros não batem com os assets do lançamento | nomeá-los como publicados |
| nome do pacote | a documentação diz apt remove flashstore; o pacote é croit-flashstore-osd | um só nome, ou o certo na documentação |
referência do flashstore_dev | lista só spdk: e file: | documentar kernel: e spdk: com um backend kernel |
Nada disto é trabalho novo. O daemon já tem a descida de privilégios, o backend direto e a lógica de recurso. Só ainda não foram ligados para a plataforma onde a maioria das pessoas o vai experimentar primeiro.
Uma preview é onde descobres isto
Uma preview é o sítio certo para cada um destes problemas, e o sítio errado para os deixar ficar. É para isso que serve uma preview: alguém leva-a para casa, põe-na no hardware que tem de facto, e escreve onde é que ela cai. As partes que importam aguentaram. O armazenamento subiu em milissegundos, os OSD juntaram-se a um cluster construído pelas ferramentas de outra pessoa, e a instalação de um sistema operativo foi para eles sem uma falha.
O que a fez tropeçar foi tudo o que está à volta do daemon. Um ficheiro de configuração num sistema de ficheiros que a unit não conseguia ler, um kernel que diz não a uma chamada que o upstream permite, um disco de arranque que a verificação não deixava de contar. Nada disso é difícil. Tudo isso é a diferença entre software que funciona e software que funciona na tua máquina, e a única forma de fechar essa diferença é testar nas máquinas que as pessoas têm em vez de nas que construíste para isso.
Apesar de tudo, é um começo promissor. Num mini PC fraquinho, com a ponta do cliente ainda no librbd clássico e os oito discos numa só ligação PCIe 3.0, os Optane trabalham aqui mais do que com o BlueStore. À medida que isto se desenvolver, vou voltar a ele e escavar mais fundo, à medida que mais da pilha for substituída, e com uma olhadela ao CephFS2 também.
«Drop-in» é uma promessa feita a um administrador que não tem tempo para ler o código-fonte. Os monitores do Proxmox, a GUI do Proxmox, o kernel do Proxmox e um pacote de outra pessoa é exatamente a situação para que essa promessa existe. Agora quase a cumpre. Nove pequenas correções e vai cumprir, e prefiro ser eu a encontrá-las numa quarta-feira de manhã do que um cliente a encontrá-las numa sexta-feira à noite.
croit/ceph-rust README — preview pública desde 9 de novembro de 2026, «not yet recommended for production data», requisitos, quick start, conjunto de funcionalidades de produção, commit do Ceph testado. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
croit/ceph-rust release snapshot-2026-11-10 — os pacotes usados aqui, incluindo
flashstore_…_debian-trixie_amd64.debesha256sums.txt. ↩︎ ↩︎croit/ceph-rust — hardware requirements — verificação da cache de escrita volátil, hugepages, notas sobre versões do kernel. ↩︎
croit/ceph-rust — branches and versions — o
mainaponta ao v21.2.0, ov20.2.4aponta ao v20.2.4; «The daemon refuses a cluster release outside its supported window.» ↩︎ ↩︎Proxmox pve-manager, PVE/Ceph/Releases.pm —
umbrellalistado comrelease => '21.2'eunsupported => 1. ↩︎croit/ceph-rust — build and install packages — distribuições, glibc 2.34, tratamento do
ceph-osd.target, a linhaapt remove. ↩︎ ↩︎ ↩︎croit/ceph-rust — configuration reference —
flashstore_dev,flashstore_lcores,flashstore_report_objectstoree porque é que o valor por omissão ébluestore. ↩︎ ↩︎croit-flashstore-osd Cargo.toml — linha 29,
knet = [… "kernel-nvme"]. ↩︎croit/ceph-rust — first OSD tutorial — a verificação do host só de leitura; «Exit 0 means no FAIL.» ↩︎ ↩︎
croit/ceph-rust — ADR 0169, kernel NVMe backend — os dois modos kernel, a comparação medida, o orçamento do alocador de payload, a resolução de endereços
spdk:e o recurso só para Identify (emenda 6). Acrescentado ao repositório na mesma noite do lançamento. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎Proxmox VE — Proxmox Cluster File System (pmxcfs) — o sistema de ficheiros do cluster em
/etc/pvee o seu dono e permissões fixos. ↩︎croit-flashstore-osd@.service —
User=ceph,ExecStartPre=… activate, e umCapabilityBoundingSetsemCAP_DAC_OVERRIDE. ↩︎ ↩︎croit-flashstore-osd privdrop.rs — a descida de privilégios clássica com
--setuser/--setgroup. ↩︎croit/ceph-rust — prepare the host — «the namespace node must be readable and writable by user
ceph(udev rule)». ↩︎Linux v7.0, drivers/nvme/host/ioctl.c —
nvme_cmd_allowed(), a regra para o passthrough NVMe sem privilégios. ↩︎croit/ceph-rust — security — «
preparedefaults--keyringto/var/lib/ceph/bootstrap-osd/<cluster>.keyring». ↩︎croit/ceph-rust — prepare, activate and list — a sonda de dispositivo não vazio e o
--wipe. ↩︎Proxmox pve-manager, PVE/API2/Ceph/OSD.pm — o
osdtypesó ébluestorequando os metadados levambluefs, senão éfilestore. ↩︎Proxmox pve-manager, PVE/Ceph/Services.pm — o
ceph_service_cmd()mapeiaosd.Npara a unit systemdceph-osd@N. ↩︎Ceph documentation — CRUSH maps — regras replicadas, domínios de falha e classes de dispositivo. ↩︎
CrystalDiskMark — o benchmark de discos da Crystal Dew World; «Various measure mode (Peak/Real World/Demo)». ↩︎
Proxmox VE wiki — Performance Tweaks — os modos de cache de disco: «cache=none seems to be the best performance and is the default since Proxmox 2.X». ↩︎