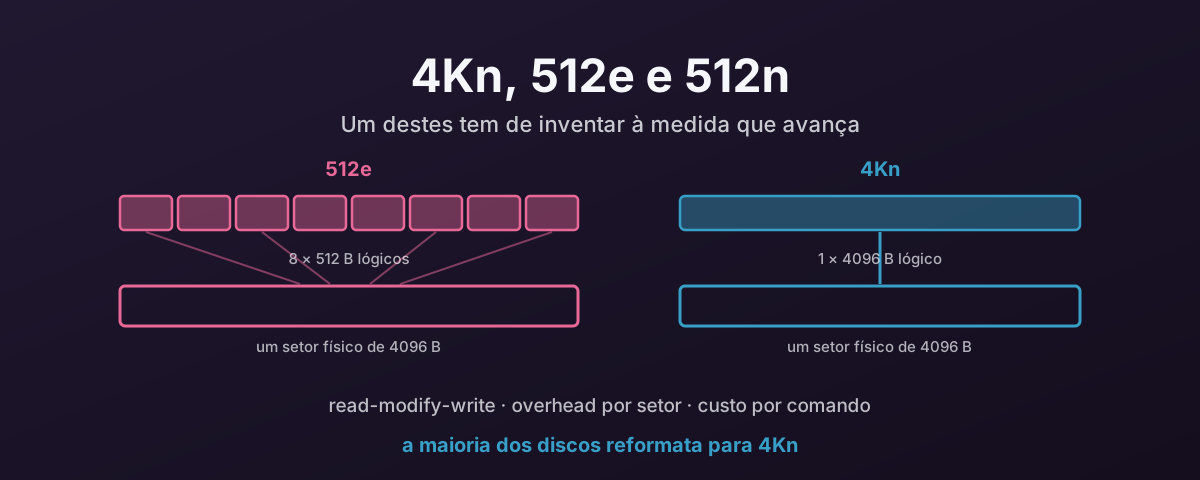
Três formas de um disco se apresentar
Um disco tem dois tamanhos de bloco, e a diferença entre eles é a história toda.
O setor físico é a unidade com que o suporte trabalha de facto — a unidade mais pequena que o disco consegue ler ou escrever sem trabalho extra. O bloco lógico é a unidade com que o disco diz ao host que trabalha — a unidade que o host endereça.
Há três combinações por aí.
512n — 512 nativo. Os dois tamanhos são 512 bytes. É o mundo antigo: discos rígidos de antes de 2010, e nada que comprasses novo hoje em qualquer capacidade que valha a pena.
512e — emulação de 512 bytes. O setor físico tem 4096 bytes, mas o disco reporta blocos lógicos de 512 bytes e traduz no firmware. Existe por uma única razão: compatibilidade com sistemas operativos, bootloaders e aplicações que assumiram 512 para sempre. Razoável como engenharia, e a raiz de quase todos os problemas que se seguem.
4Kn — 4K nativo. Os dois tamanhos são 4096 bytes. O disco diz a verdade, o host endereça-o na unidade que o suporte usa, e não há camada de tradução pelo meio.
O que o 512e faz em cada escrita desalinhada
Uma leitura é barata nos três casos. O disco lê o setor de 4K e devolve a fatia de 512 bytes que pediste.
As escritas são onde a ficção sai cara.
Se o host escreve um único bloco lógico de 512 bytes, o disco não consegue escrever 512 bytes. O suporte não tem essa unidade. Por isso faz isto em vez disso:
- Lê o setor físico inteiro de 4096 bytes.
- Junta-lhe os 512 bytes de dados novos.
- Escreve de volta o setor inteiro de 4096 bytes.
Isso é um read-modify-write, e transforma uma escrita pequena numa leitura mais uma escrita. Num disco rotativo, isso quer dizer esperar que o prato dê a volta outra vez. Uma rotação completa a 7200 rpm são uns 8 ms com que não contavas. Em flash o custo é de outra natureza, e não desaparece quando a escrita acaba. Esse tem a sua própria secção mais abaixo.
O desalinhamento é a versão disto que morde com mais força. Se uma partição começa num deslocamento de 512 bytes ímpar — o caso clássico é a velha convenção dos 63 setores — então cada escrita de 4K do sistema de ficheiros atravessa dois setores físicos. Isso não é um read-modify-write, são dois, em cada escrita, para sempre, até alguém voltar a particionar o disco.
Amplificação de escrita em flash
Num disco rígido, o read-modify-write custa-te uma rotação e acabou. Em flash custa-te vida útil do disco, e essa é uma conta que pagas uma vez e continuas a pagar.
A amplificação de escrita é a razão entre o que foi de facto escrito na NAND e o que o host pediu para escrever. Uma razão de 1,0 quereria dizer que o disco escreveu exatamente o que lhe deram. Nunca é 1,0, porque a flash não consegue sobrescrever no lugar: o disco programa uma página nova, marca a antiga como obsoleta, e mais tarde a recolha de lixo realoca as páginas sobreviventes para que um bloco inteiro possa ser apagado. Essas realocações também são escritas.
O 512e acrescenta uma camada evitável por cima disso, e a razão é um pormenor que vale a pena dizer com clareza: a camada de tradução do disco mapeia em unidades de cerca de 4 KB, seja qual for o tamanho de bloco lógico que anuncia. Um disco que reporta blocos de 512 bytes continua a gerir unidades de 4 KB internamente.
Assim, uma escrita de 512 bytes vinda do host torna-se, dentro do disco: ler a unidade de mapeamento de 4 KB, juntar-lhe os 512 bytes, programar uma nova unidade de 4 KB. Chegam 4096 bytes à NAND para que 512 bytes pudessem mudar. Oito vezes a escrita, para essa escrita.
O desalinhamento é menos dramático por escrita e pior no total. Uma escrita de 4 KB que atravessa duas unidades de mapeamento suja as duas, por isso são programados 8 KB para 4 KB de dados. Isso é uma amplificação de 2× em cada escrita, permanentemente, até a tabela de partições ser corrigida.
Os efeitos em cadeia são o que faz isto importar, em vez de ser só desarrumado:
- Mais escritas na NAND quer dizer que a recolha de lixo corre mais vezes, e as suas realocações são elas próprias amplificação.
- Uma cache de escrita SLC enche mais cedo, por isso o disco cai mais cedo para o seu regime estável mais lento e o débito de escrita sustentado desce.
- Os ciclos de programação/apagamento são consumidos em proporção ao que chegou à NAND, não ao que o host enviou. Duplica a amplificação e reduziste para metade a vida do disco para a mesma carga.
- As classificações de resistência — TBW, DWPD — são dadas em relação às escritas do host. A amplificação come essa margem em silêncio, e o disco desgasta-se antes das contas da garantia que fizeste quando o compraste.
As escritas diretas e síncronas são o pior caso
Na maior parte do tempo, a page cache esconde tudo isto. O kernel acumula escritas pequenas, junta-as e envia IO de 4 KB ou maior para o disco, por isso o read-modify-write nunca acontece.
Duas flags retiram essa proteção, e as aplicações que se preocupam com durabilidade ativam as duas.
O O_DIRECT contorna a page cache.
Já não há nada entre a aplicação e o disco para juntar uma escrita de 512 bytes em algo do tamanho de um setor.
O O_SYNC ou o O_DSYNC exige que a escrita esteja em suporte estável antes de a chamada voltar.
Isso impede o disco de absorver a escrita num buffer volátil e de a combinar mais tarde com as vizinhas.
Junta as duas e cada escrita de 512 bytes é um ciclo completo de read-modify-write que tem de acabar agora, sozinho, sem nada contra o qual se amortizar. É aí que a amplificação num disco 512e se aproxima dos seus 8× teóricos, e é exatamente o padrão que produzem o registo de commits de uma base de dados, um ZIL do ZFS ou um WAL do BlueStore do Ceph.
A proteção contra falhas de energia é o que salva isto em hardware empresarial. Um disco com PLP pode confirmar uma escrita síncrona assim que ela está num buffer DRAM suportado por condensadores, que é durável, e continuar a juntar internamente antes de programar a NAND. Um disco de consumo sem PLP tem de chegar à flash antes de poder responder, por isso paga o custo completo por escrita. Mais uma razão para o PLP não ser opcional neste tipo de carga.
No Proxmox, é o modo de cache que decide qual destes tens:
cache=noneéO_DIRECT— o padrão do PVE, e a escolha certa para HA all-flash. A page cache do host fica fora do caminho, por isso os padrões de escrita do convidado chegam ao disco tal como o convidado os emitiu.cache=directsyncéO_DIRECTmaisO_DSYNC— todas as escritas síncronas. É uma definição de nicho para discos dedicados a registos de bases de dados e inutilizável para cargas gerais.
Num dispositivo de suporte 512e, cache=directsync com um convidado a fazer commits em registos de 512 bytes é praticamente a disposição menos eficiente que existe: sem agregação no host, sem agregação no disco, e um read-modify-write por commit.
E aqui está a parte que torna o 4Kn estrutural em vez de apenas preferível.
O O_DIRECT exige que o deslocamento, o comprimento e o buffer estejam alinhados ao tamanho de bloco lógico do disco.
Num disco 512e isso são 512 bytes, por isso uma escrita direta de 512 bytes é legal e o disco paga-a em silêncio.
No 4Kn o bloco lógico é 4096, por isso a escrita direta mais pequena que o kernel aceita é de 4 KB.
O padrão patológico deixa de ser algo que tens de evitar e passa a ser algo que a pilha não consegue exprimir.
Overhead no suporte físico
O segundo custo é estrutural, e é a razão de o Advanced Format sequer existir.
Um setor não é só os seus dados. Num disco rígido, cada um leva uma marca de sincronização para a cabeça saber onde o setor começa, um intervalo para que setores consecutivos não se atropelem, um marcador de endereço e um campo ECC para corrigir erros de leitura.
Com setores de 512 bytes pagas tudo isso oito vezes por cada 4K de dados. Com um setor de 4K pagas uma vez.
Isso tem duas consequências, e a segunda importa mais do que a primeira:
- Parte do prato que era overhead passa a ser capacidade utilizável. Foi esta a motivação declarada da indústria durante a transição para o Advanced Format, na ordem de poucas unidades percentuais.
- O campo ECC pode ser muito maior para o mesmo overhead total. Um código forte a proteger 4096 bytes corrige muito mais do que oito códigos fracos a proteger 512 bytes cada. À medida que a densidade de gravação subiu, isso deixou de ser um extra e passou a ser a única forma de manter as taxas de erro aceitáveis.
A flash não tem marcas de sincronização nem intervalos de rotação, mas a mesma lógica aplica-se um nível acima: a NAND é programada em páginas, as páginas são muito maiores do que 512 bytes, e as tabelas de mapeamento do disco têm uma entrada por unidade endereçável. Blocos lógicos mais pequenos querem dizer mais metadados para gerir a mesma capacidade.
Overhead no host: comandos e interrupções
O terceiro custo é o que as pessoas não veem, porque nem sequer está no disco.
O tamanho de bloco lógico define o mínimo do tamanho de um IO. Num disco com blocos lógicos de 512 bytes, um sistema de ficheiros ou uma aplicação pode emitir uma escrita de 512 bytes, e cada uma é um IO completo: um comando construído e submetido, uma escrita no doorbell, uma entrada na fila de conclusão e uma interrupção a dizer que acabou.
Cada um destes tem um custo fixo que não quer saber de quantos dados estavam envolvidos. Move 4 KB como oito comandos de 512 bytes e pagas esse custo oito vezes. Move-os como um comando de 4K e pagas uma vez.
Duas ressalvas honestas, porque é aqui que o argumento costuma ser exagerado.
Para IO grande, o tamanho de bloco lógico não muda nada no número de comandos. Um único comando pode descrever muitos blocos, por isso uma escrita sequencial de 1 MB é um comando, sejam os blocos de 512 bytes ou de 4K. A poupança só é real onde se está a emitir IO pequeno.
Mas onde se está a emitir IO pequeno, o efeito não é subtil: cada um desses oito pedidos é um que o kernel tem de construir, agendar e concluir, cada um com a sua própria interrupção MSI-X e transição de utilizador para kernel, e com filas profundas é assim que se chega a uma tempestade de interrupções. Dentro de uma VM é pior ainda, porque cada uma dessas interrupções é também uma mudança de contexto do convidado.
E os controladores NVMe modernos agregam interrupções, por isso o número de interrupções não é simplesmente o número de comandos. O trabalho de submissão e conclusão por comando mantém-se, no entanto, e a algumas centenas de milhares de IOPS o custo de CPU por comando é uma fração mensurável de um núcleo. É a mesma aritmética das posted interrupts na série sobre passthrough — custos fixos pequenos multiplicados por um número muito grande.
4Kn, metadados de setor e RAID por hardware
Passar para um formato 4096 + 0 tem uma consequência que apanha as pessoas desprevenidas, e cai em cheio no RAID por hardware.
Alguns controladores RAID e storage arrays não usam setores simples de 512 ou 4096 bytes. Formatam os discos com um tamanho estendido — 520 ou 528 bytes, ou os equivalentes 4K como 4104, 4160 e 4224 — porque esses bytes extra por setor são onde o controlador guarda os seus próprios metadados. Isso é informação de proteção T10-PI/DIF, ou dados de integridade do fabricante, guardados em linha com os próprios dados que descrevem.
Um formato 4096 + 0 não tem onde os pôr. O setor é dados, de ponta a ponta, e é esse o objetivo de o escolher.
Assim, um controlador que quer metadados em linha tem três opções, e nenhuma é de borla:
- Recusar o disco.
- Reformatá-lo de volta para um formato estendido, desfazendo o trabalho 4Kn que acabaste de fazer.
- Guardar os seus metadados noutro sítio do disco.
A terceira é onde a flash te castiga. Metadados escritos separadamente dos dados que descrevem são uma segunda escrita, noutro deslocamento, a cair noutra unidade de mapeamento. Mais uma página NAND programada por cada uma que querias de facto escrever. É a amplificação da secção acima, reintroduzida de propósito, para transportar metadados de integridade que o disco podia ter guardado em linha de borla se o tivesses deixado num formato estendido.
Não podes ter as duas coisas. Ou o setor leva os metadados do controlador, ou leva só os teus dados.
E é por isso que a flash minou bastante a defesa do RAID por hardware
O resto disto é opinião e não mecanismo, por isso toma-o como tal.
Um controlador RAID por hardware é RAID em firmware a correr num processador dedicado. O «hardware» é um CPU, alguma DRAM e uma bateria. Não é uma forma fundamentalmente diferente de calcular paridade. O que historicamente te comprava era uma cache de escrita com bateria e a descarga do cálculo de paridade, e em flash ambos os argumentos enfraqueceram muito. O NVMe empresarial já tem uma cache própria protegida contra falhas de energia, e o controlador torna-se um teto de largura de banda à frente de dispositivos que conseguem, cada um, saturar vários gigabytes por segundo.
Também te custa coisas que agora queres ativamente:
- O estado do dispositivo desaparece. O detalhe SMART, os indicadores de desgaste e os registos do fabricante que te deixam calcular a amplificação de escrita ficam todos atrás de uma abstração opaca.
- Sem checksums de ponta a ponta. Um controlador verifica a paridade, que deteta um disco em falta, não uma resposta errada de um que está presente. O ZFS e o Ceph fazem checksum dos próprios dados e conseguem dizer-te qual cópia está errada — corrupção silenciosa que um controlador deixa passar direitinha. Como tal, o controlador está a resolver o problema errado.
- Os metadados do fabricante nos discos prendem o array a uma família de controladores, o que é uma forma própria de pouca fiabilidade quando o que falha é o controlador.
- O RAID com paridade faz o seu próprio read-modify-write nas escritas de faixa parcial, empilhado por cima de tudo o que está nas secções acima.
Para o Ceph isto nem sequer é uma preferência. A orientação do próprio Proxmox para hiperconvergência é que os discos têm de ser apresentados em modo HBA ou pass-through, não atrás de um controlador RAID, e o ZFS quer exatamente o mesmo pelas mesmas razões.
Portanto, a disposição que decorre de tudo isto é: um HBA em vez de um controlador RAID, discos formatados em 4Kn com zero metadados, e redundância mais checksums feitos pelo ZFS ou pelo Ceph, que conseguem de facto dizer-te quando um disco mentiu. Se alguma coisa no teu parque precisar mesmo de um formato de setor estendido, isso é uma escolha deliberada a resolver enquanto os discos ainda estão vazios. Não algo a descobrir depois de os OSD estarem construídos.
Onde o 512e morde de facto
Seria desonesto dizer que o 512e arruína um sistema moderno, porque normalmente não arruína.
Uma pilha Linux atual lê o tamanho do setor físico, alinha as partições a ele — o parted e o sfdisk já fazem isso por omissão — e usa blocos de 4K no sistema de ficheiros.
Nessa configuração o host emite IO de 4K alinhado a 4K, o disco nunca precisa de um read-modify-write, e o 512e não te custa praticamente nada.
Os problemas são concretos:
- Partições desalinhadas, normalmente herdadas de uma instalação antiga ou de uma imagem clonada. Dois read-modify-writes em cada escrita.
- ZFS com
ashift=9num disco 512e, porque o ZFS acreditou nos 512 reportados. Cada escrita de registo torna-se um read-modify-write, e não podes mudar oashiftdepois do facto — a pool tem de ser reconstruída. - Aplicações que escrevem registos de 512 bytes com O_DIRECT, contornando a agregação da page cache. Algumas bases de dados e muito software feito por medida fazem isto.
- Tudo o que confia que o tamanho lógico é o real. Esse é o verdadeiro mal da emulação: distribui um número que está errado, e as coisas a jusante tomam decisões com ele.
O 4Kn elimina a categoria inteira. O disco não pode mentir sobre um tamanho de setor que não tem.
Vale a pena ser franco quanto ao tamanho do prémio, no entanto. A orientação da própria Seagate é que o 4Kn vale claramente a pena quando a pilha está totalmente otimizada para 4K e estás a contar cada IOPS — uma camada all-flash afinada, por exemplo. Abaixo disso, num Linux moderno corretamente alinhado, a diferença de desempenho para IO alinhado é muitas vezes pequena. O outro argumento é a consistência da frota: um parque uniformemente 4Kn não tem surpresas de formatos misturados, e ninguém tem de se lembrar de quais discos mentem.
A maioria dos discos pode ser convertida — se o fabricante deixar
Esta é a parte que passa despercebida: o 512e é muitas vezes uma definição de formato, não uma propriedade do hardware. Muitíssimos discos SAS e SATA empresariais, e a maior parte do NVMe empresarial, saem de fábrica a reportar 512 bytes e reformatam para 4Kn sem problemas.
Tudo o que se segue destrói todos os bytes do dispositivo. Não há conversão no lugar.
NVMe — nvme-cli
Vê primeiro o que o namespace suporta:
# Lists each LBA format and marks which one is in use
nvme id-ns -H /dev/nvme0n1 | grep -i "lbaf\|data size"
Queres um formato com Data Size 4096 e Metadata Size 0, marcado como best e que não esteja em uso. Depois aplica-o:
# -l/--lbaf selects the LBA format index from the list above
nvme format /dev/nvme0n1 --lbaf=1 --force
O tamanho dos metadados importa tanto como o tamanho dos dados. Alguns formatos de fábrica reservam bytes extra por setor — 520, ou 4160 — para transportar metadados de proteção T10-PI/DIF de ponta a ponta. Se nada na tua pilha os consome, é enchimento em cada setor, por isso escolhe o formato com zero metadados e livra-te disso. Escolher por engano um formato com metadados também te dá um disco que se comporta de forma diferente daquele que querias criar, e combinar uma mudança de tamanho de setor com uma mudança de PI pode forçar uma formatação completa lenta em vez de uma rápida.
Para os discos de um host inteiro, faz um ciclo. Isto precisa de shopt -s extglob para os globs estendidos, e só seleciona formatos que sejam 4096/0 e não estejam em uso:
shopt -s extglob

for dev in /dev/nvme+([0-9])n+([0-9]); do
    # Skip anything that is not actually there
    [ -e "$dev" ] || continue

    # An LBA format with 4096-byte data, 0-byte metadata, marked Best, not in use
    lbaf=$(nvme id-ns -H "$dev" \
        | grep -P '(?=.*Metadata Size: 0)(?=.*Data Size: 4096)(?=.*Best)(?!.*in use)' \
        | awk '{found=$3} END {print (found != "" ? found : -1)}')

    if [ "$lbaf" != "-1" ]; then
        echo "Formatting $dev using LBA Format: $lbaf"
        nvme format --force --lbaf="$lbaf" "$dev"
    else
        echo "Skipping $dev: no matching LBA format found."
    fi
done
Há duas coisas ali que fazem mais trabalho do que parece.
O glob apanha namespaces — nvme0n1, nvme12n3 — e deliberadamente não apanha partições como nvme0n1p1, porque o padrão acaba depois dos dígitos a seguir ao n. Essa é a diferença entre reformatar um namespace e fazer algo irrecuperável a um sistema em funcionamento.
E a seleção só converte um disco que ofereça de facto o que pediste. Tudo o resto cai para -1 e é saltado, o que cobre três casos distintos:
- O disco só oferece 512. Não existe formato de 4096 bytes, por isso não há nada para onde converter e o ciclo deixa-o em paz. Não tenta, e não falha a meio.
- O disco já é 4Kn. O formato 4096/0 é o que está em uso, e o
(?!.*in use)exclui-o — por isso uma segunda passagem pelo mesmo host não faz nada. Nenhuma reformatação desnecessária de todos os discos. - Os únicos formatos de 4096 levam metadados. Um formato 4096 + 8 não satisfaz
Metadata Size: 0, por isso o ciclo não te entrega discretamente um disco T10-PI que não pediste.
Por outras palavras, falha fechado. Quando não tem a certeza, salta.
Uma nota de portabilidade: esses lookaheads precisam do modo -P (PCRE) do grep da GNU. Num sistema em que o grep seja outra coisa, o padrão não apanha nada e todos os discos são saltados. Irritante, mas pelo menos erra para o lado seguro.
Lê o ciclo antes de o correres, mesmo assim.
Onde apanha, reformata sem mais perguntas. O nvme format --force não pergunta duas vezes.
Pertence ao aprovisionamento, numa máquina cujos discos não têm nada, nunca num host com um OSD, uma pool ou um disco de VM ativo.
No FreeBSD o equivalente é o nvmecontrol, onde -f é o índice do formato:
nvmecontrol format -f 1 nvme0ns1
SAS e SATA — openSeaChest
O openSeaChest da Seagate é multiplataforma, open source, e funciona também em discos de outros fabricantes.
# Find the handle
openSeaChest_Format --scan

# Ask the drive which sector sizes it will accept
openSeaChest_Format -d /dev/sg1 --showSupportedFormats

# Convert. The confirmation string is deliberately hard to type by accident.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
Essa frase de confirmação não sou eu a ser dramático. É a string literal que a ferramenta exige, e a parte «may render the drive inoperable» é real. Uma formatação de baixo nível interrompida por um corte de energia pode deixar um disco a precisar de outra formatação antes de voltar sequer a funcionar.
Por baixo, a operação difere conforme o transporte: SAS e SCSI usam Format Unit, SATA usa Set Sector Configuration Ext — o caminho de formatação rápida — e NVMe usa NVM Format. Num disco SAS podes chamar o Format Unit diretamente, e nota que esta opção leva a string de confirmação mais curta:
openSeaChest_Format -d /dev/sg1 --formatUnit 4096 --poll \
    --confirm this-will-erase-data
Duas opções diferentes, duas strings de confirmação diferentes — troca-as e a ferramenta recusa.
Onde o disco suporta formatação rápida, o tamanho de setor muda em segundos em vez de horas; o disco faz depois o seu trabalho de integridade e em segundo plano, e escrever os teus dados reais nele reduz esse tempo em segundo plano. Uma formatação completa escreve zeros de ponta a ponta e pode levar muitas horas, até dias, num disco rotativo grande.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 --fastFormat \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
SCSI — sg_format
Para tudo o que fale SCSI, o sg3_utils faz o mesmo trabalho:
# --size requires --format; expect hours on a large spinning disk
sg_format --format --size=4096 /dev/sdb

# Fast format where the drive supports it — seconds instead of hours
sg_format --format --size=4096 --ffmt=1 /dev/sdb
O sg_format dá-te uma contagem decrescente de 15 segundos antes de avançar, que o --quick salta.
A sua documentação também avisa de uma falha concreta que vale a pena conhecer: se a mudança de tamanho de bloco tiver sucesso mas a formatação depois falhar, o disco pode ficar num estado «format corrupt» e precisa de outra formatação para recuperar.
Antes de converteres seja o que for
- Verifica o caminho de arranque. Um disco 4Kn como dispositivo de arranque precisa de UEFI e de um SO que o suporte. O Linux moderno não tem problema. O Windows mais antigo tem, e alguns controladores RAID por hardware ainda recusam o 4Kn por completo.
- Fá-lo antes de o disco ter alguma coisa. Fazê-lo depois quer dizer evacuar, converter, restaurar.
- Faz um, depois verifica. Converte um único disco, confirma os tamanhos reportados, depois faz os restantes.
- Conta com horas num disco rotativo sem formatação rápida. Não comeces uma formatação de baixo nível numa máquina de que precisas de volta em breve.
Verificar o que tens
# LOG-SEC is what the host addresses, PHY-SEC is what the medium uses
lsblk -o NAME,MODEL,SIZE,LOG-SEC,PHY-SEC

# The same, from sysfs
cat /sys/block/sda/queue/logical_block_size
cat /sys/block/sda/queue/physical_block_size

# SMART states both, and this is the clearest 512e signature there is
smartctl -a /dev/sda | grep -i "sector size"
512 bytes logical, 4096 bytes physical é um disco 512e.
Números iguais querem dizer nativo — 512n se ambos forem 512, 4Kn se ambos forem 4096.
E verifica se as partições estão mesmo alinhadas:
parted /dev/sda align-check optimal 1
ZFS, Ceph e discos virtuais
ZFS — define ashift=12 explicitamente ao criar uma pool, e não confies no tamanho reportado pelo disco, porque no 512e ele vai dizer-te 9 e estar errado. Não pode ser mudado depois.
Ceph — o tamanho mínimo de alocação do BlueStore deve ser 4 KB em flash. O Ceph moderno usa 4096 por omissão, mas versões mais antigas usavam valores mais altos — cerca de 16 KB em SSD e 64 KB em HDD — e isso serve mal os discos de VM em RBD, porque emitem muitas escritas aleatórias pequenas de 4 KB, e uma escrita de 4 KB a cair numa unidade de alocação de 16 ou 64 KB amplifica a escrita e desperdiça o resto em enchimento. É fixado quando o OSD é criado, por isso tem de ser definido antes de criar ou reconstruir:
ceph config set global bluestore_min_alloc_size_ssd 4096 # new or rebuilt OSDs only
Há um bluestore_min_alloc_size_hdd correspondente. Os OSD existentes mantêm aquilo com que foram construídos, por isso mudá-lo quer dizer reconstruí-los.
Discos virtuais — um convidado vê o que o hipervisor lhe apresenta, não o disco por baixo, por isso um disco 4Kn debaixo de uma VM continua a entregar ao convidado blocos de 512 bytes, a não ser que digas o contrário. Manter a pilha em 4K de ponta a ponta quer dizer dizer ao QEMU para apresentar 4K, o que no Proxmox é uma linha de argumentos em bruto em /etc/pve/qemu-server/<vmid>.conf:
args: -global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096
Essa linha é o que obriga de facto o QEMU a 4Kn para esses discos — o -global aplica-a a todos os dispositivos scsi-hd da VM, por isso é dito ao convidado 4096 tanto para o tamanho de bloco lógico como para o físico, e ele particiona e alinha em conformidade.
Não ponhas a string toda entre aspas. O Proxmox interpreta o args: com Text::ParseWords::shellwords, por isso isto:
args: "-global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096"
colapsa num único argumento — as aspas são respeitadas e retiradas, e o QEMU recebe uma opção comprida e impossível de interpretar em vez de quatro. Sem aspas, a mesma linha divide-se em -global, scsi-hd.physical_block_size=4k, -global, scsi-hd.logical_block_size=4096, que é o que queres. É um erro fácil de cometer porque pôr aspas é o instinto certo numa linha de comandos, e a falha — uma VM que não arranca, a queixar-se da opção — não aponta de volta para as aspas.
Faz isto antes de instalar o SO do convidado. Mudar o tamanho de bloco de um disco debaixo de um sistema já instalado pode deixá-lo sem arrancar, porque o esquema de partições e o bootloader foram escritos para setores de 512 bytes. Nota também que o args: é uma saída de emergência para especialistas fora da gestão da GUI, e a interação com a migração em direto e os snapshots merece ser verificada de novo contra a documentação atual do Proxmox.
Quando o convidado diz 512 e o host diz 4K
Este é o caso que vale a pena perceber bem, porque é o que tens por omissão depois de fazeres todo o trabalho acima.
O QEMU apresenta blocos lógicos de 512 bytes ao convidado, a não ser que lhe digam o contrário, seja qual for o dispositivo de suporte. Por isso podes converter todos os discos do host para 4Kn, e as VM por cima continuam a ouvir 512 — e vão acreditar.
O convidado particiona então em fronteiras de 512 bytes porque pode, e emite IO de 512 bytes porque pode. Mas o dispositivo do host tem agora genuinamente um bloco lógico de 4096 bytes, e não aceita uma escrita de 512 bytes. Alguma coisa tem de conciliar as duas, e essa coisa é o host: o QEMU lê os 4 KB à volta, junta-lhes os 512 bytes do convidado e escreve tudo de volta.
Não eliminaste a emulação. Mudaste-a do firmware do disco para o teu hipervisor, onde custa CPU do host e um buffer intermédio em vez de ciclos do disco.
Com cache=none, isto também não é uma penalização ligeira. O O_DIRECT contra um dispositivo 4Kn exige deslocamentos e comprimentos alinhados a 4 KB, por isso uma escrita do convidado abaixo de 4K não pode simplesmente passar — o alinhamento tem de ser corrigido no QEMU antes de o IO sequer ser emitido.
E o caso do desalinhamento volta uma camada acima. Um convidado particionado com granularidade de 512 bytes põe as escritas de 4 KB do seu sistema de ficheiros em deslocamentos que atravessam dois blocos de 4 KB do host, por isso cada uma torna-se dois read-modify-writes no host. A mesma falha de uma partição desalinhada num disco 512e sem nada por cima, só que agora está a acontecer dentro de uma VM onde ninguém a procura.
Portanto a regra é: se o host é 4Kn, apresenta 4K também ao convidado, e fá-lo antes de o SO ser instalado.
A exceção é o suporte do convidado, que é a razão toda de o 512e existir:
- Os convidados Linux lidam com 4Kn sem drama.
- O Windows suporta 4Kn para volumes de dados a partir do Windows 8 e do Server 2012, e arrancar de 4Kn pede UEFI.
- Tudo o que for mais antigo — Windows 7 e anteriores — não consegue fazer 4Kn de todo. Para esses, um disco virtual a apresentar 512 é o preço de os correr, e o host faz a conciliação. Se isso importar, mantém esses convidados em armazenamento onde te custe menos, e não na tua camada mais rápida.
Verifica com o que o convidado ficou de facto, a partir de dentro do convidado:
lsblk -o NAME,LOG-SEC,PHY-SEC
Um 512 aí num host 4Kn quer dizer que a conciliação acima está a acontecer em cada escrita desalinhada.
Referências
- OpenZFS — Workload Tuning — o
ashift, porque é que2^ashifté o IO mais pequeno possível num vdev, e a observação de que «many devices misreport their sector sizes» - Página man do
nvme-format—--lbaf,--namespace-id,--sese--force - Página man do
sg_format—--sizecom--format, a opção de formatação rápida e o aviso de format-corrupt - openSeaChest — os utilitários de disco open source da Seagate, incluindo
--setSectorSizee--showSupportedFormats - Wiki do openSeaChest — Format, Fast Format, And Sector Sizes — que transporte usa que comando, e quando se aplica a formatação rápida
nvmecontrol(8)— o equivalente no FreeBSD- Documentação da camada de blocos do Linux — como o kernel modela os tamanhos de bloco lógico e físico