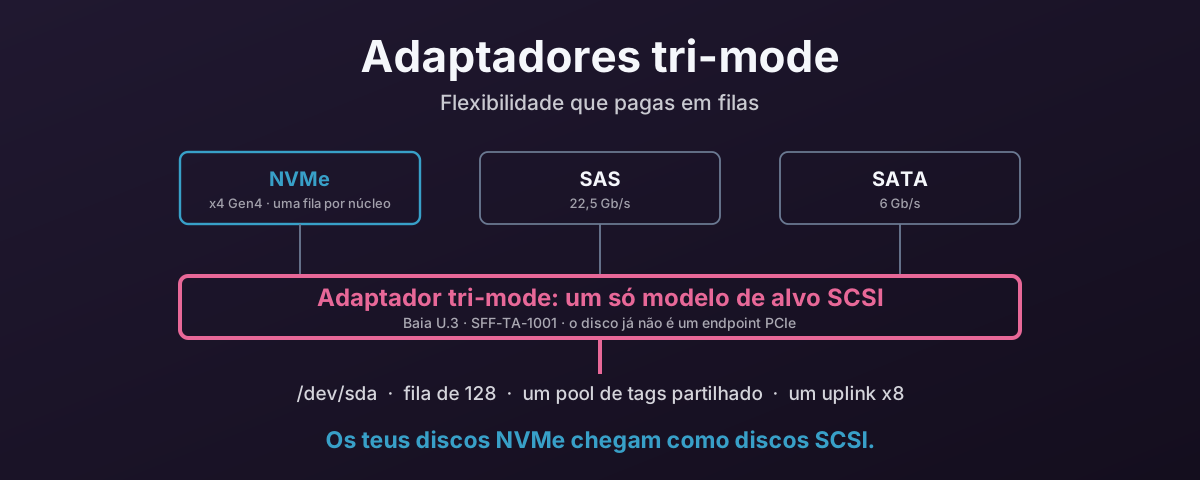
A baia que aceita tudo
O argumento de venda de um adaptador tri-mode é genuinamente bom, e vale a pena expô-lo como deve ser antes de o desmontar.
Compra um chassis com um backplane U.3 e um controlador tri-mode, e todas as baias passam a ser universais. A ranhura 0 pode levar um disco SAS de 24G, a ranhura 1 um dispositivo de arranque SATA barato, a ranhura 2 um SSD NVMe Gen4, e o adaptador negoceia o que aparecer. A Broadcom chama ao silício Tri-Mode SerDes; a norma da baia é a SFF-TA-1001, conhecida como U.3, que define um conector comum para SAS x1/x2, SATA e NVMe em x1, x2 ou x4. O lado da gestão é a SFF-TA-1005, Universal Backplane Management, que é como o compartimento descobre com o que está de facto a falar e acende os LED de atividade certos.
Para quem especifica servidores, isso resolve um problema real e irritante. Já não tens de decidir o protocolo de armazenamento na altura da nota de encomenda, nem manter dois SKU de chassis, nem descobrir que as baias com NVMe são as quatro da esquerda e os teus discos foram para as outras vinte. Um único número de peça cobre o parque todo, e um parque SAS pode passar para NVMe um disco de cada vez em vez de um chassis de cada vez.
Nada disto é marketing. É a razão por que estes adaptadores vendem, e seria parvo fingir o contrário.
Mas a flexibilidade não é de borla, e a conta não se paga em libras. Paga-se em filas.
O que acontece de facto ao disco
Um SSD NVMe é um endpoint PCIe. Num servidor com ligação direta, as suas quatro lanes vão até ao root complex do CPU, através de um retimer ou de um switch PCIe, mas elétrica e logicamente é um dispositivo no barramento PCIe. O kernel enumera-o, associa-lhe o driver nvme, e a partir daí o driver fala diretamente com os registos do disco.
Põe o mesmo disco atrás de um adaptador tri-mode e isso deixa de ser verdade.
As lanes do disco terminam agora no controlador. A documentação da Broadcom chama ao bloco relevante a PCIe device bridge, e a palavra bridge está a fazer muito trabalho: isto não é um switch transparente que encaminha as transações do teu CPU para um disco que ele ainda consegue ver. O adaptador é o endpoint PCIe que o teu host enumera. O disco é um alvo pendurado do outro lado, e o firmware do controlador volta a originar cada I/O.
Portanto o adaptador não está a deixar passar os teus comandos NVMe. Está a terminá-los, e a falar com o disco em teu nome.
O que levanta a questão de que protocolo fala contigo.
O SO nunca vê um disco NVMe
Fala SCSI.
Liga um SSD NVMe a um HBA tri-mode da Broadcom e ele não aparece como /dev/nvme0n1. Aparece como /dev/sdb, associado ao mpt3sas, o mesmo driver que gere controladores SAS da LSI há mais de uma década. O nvme list não devolve nada. O lsblk -o NAME,TRAN indica o transporte como sas. No que toca a todas as camadas da pilha de armazenamento acima do driver, compraste um disco SAS.
Isto não é um bug nem uma limitação do firmware à espera de ser corrigida. É o desenho. Apresentar tudo como alvo SCSI é exatamente como um adaptador serve três protocolos: o controlador normaliza SAS, SATA e NVMe num único modelo de dispositivo, e o host fica com um driver, um caminho de enumeração, um conjunto de ferramentas. A flexibilidade do marketing e a apresentação SCSI no dmesg são a mesma decisão de arquitetura vista de cada uma das pontas.
As gerações 9500 e 9600 acrescentam um mecanismo de passthrough para que as ferramentas do fabricante cheguem aos comandos de administração NVMe do disco, e as peças mais recentes da Broadcom são muito melhores a mostrar a saúde do disco do que a 9400 era. Mas isso é um canal lateral de gestão. O caminho dos dados, cada leitura e escrita que a tua carga de trabalho emite, continua a descer pela pilha SCSI.
E a pilha SCSI tem um modelo de filas vinte anos mais velho do que o flash.
O modelo de filas de que acabaste de abdicar
Esta é a parte que te custa de facto desempenho, e vale a pena ser preciso, porque «o NVMe é mais rápido do que o SAS» não é a razão.
A decisão central de desenho do NVMe não foi um fio mais rápido. Foi deixar de fingir que um dispositivo de armazenamento é uma coisa única e serializada.
A especificação permite até 65 535 pares de filas de I/O, e esse número aparece em todos os textos explicativos de NVMe que por aí andam. É o número errado para ir buscar. Nenhum disco implementa nada que se pareça, por isso qualquer pessoa que já tenha olhado para um sistema a correr pode descartar a comparação, e teria razão. O número real é mais pequeno, sem brilho, e defende melhor o argumento.
Portanto, aqui está um disco real. Não é uma peça empresarial: um SSD OEM SK Hynix de 256 GB, do género que vem soldado num portátil de gama média, numa máquina de 16 núcleos.
$ nproc
16
$ cat /sys/class/nvme/nvme0/queue_count
17
$ ls /sys/block/nvme0n1/mq | wc -l
16
$ cat /sys/block/nvme0n1/queue/nr_requests
1023
Dezassete filas: uma fila de administração e dezasseis filas de I/O para dezasseis núcleos. Cada uma com 1023 comandos de profundidade. A correspondência é de um para um, cada fila de hardware está associada a exatamente um CPU:
$ cd /sys/block/nvme0n1/mq && grep -H . */cpu_list
0/cpu_list:1
1/cpu_list:9
2/cpu_list:3
3/cpu_list:11
...
Um CPU por fila, até ao fim: a fila de hardware 0 serve o núcleo 1 e mais nada.
É isso que «o NVMe tem muitas filas» quer dizer na prática. Não 65 535: uma por núcleo, sejam quantos forem os núcleos que tens. O Linux cria um par de filas por CPU até ao que o controlador conceder, e os controladores concedem muito mais do que um servidor típico tem de núcleos, por isso na prática o número é o número de núcleos. Põe este disco numa máquina de 64 núcleos e tens 64.
É dessa divisão por núcleo que vem o desempenho:
- Um núcleo submete para a sua própria fila. Sem lock, porque nenhum outro núcleo lhe toca.
- Cada fila tem o seu próprio vetor MSI-X, com afinidade a esse núcleo.
- A interrupção de conclusão volta ao núcleo que emitiu o I/O, onde as linhas de cache relevantes já estão.
- Os dezasseis núcleos podem ter I/O em curso ao mesmo tempo sem nunca disputarem uma estrutura partilhada.
O paralelismo escala com o número de núcleos, e o trabalho de nenhum núcleo fica alguma vez na fila atrás do de outro. Um disco barato de consumo faz isto. É o mínimo.
Agora vê o que o disco recebe atrás do adaptador. Os números abaixo não são estimativas: são constantes no driver mpt3sas do kernel principal.
A profundidade de fila por dispositivo é definida a partir de ioc->max_nvme_qd, que o driver vai buscar ao que o firmware do controlador reporta e, caso contrário, recorre a um valor por omissão de compilação em drivers/scsi/mpt3sas/mpt3sas_base.h:
#define MPT3SAS_SATA_QUEUE_DEPTH	32
#define MPT3SAS_SAS_QUEUE_DEPTH		254
#define MPT3SAS_RAID_QUEUE_DEPTH	128
#define MPT3SAS_NVME_QUEUE_DEPTH	128
128. Um dispositivo capaz de dezenas de milhares de comandos pendentes recebe uma profundidade de fila de 128, e repara que é menos funda do que o valor por omissão do SAS, 254, duas linhas acima. As capacidades do próprio disco nunca entram na decisão. O número vem do controlador.
O número de filas de hardware é pior, e o driver é franco quanto a isso. Do mpt3sas_scsih.c:
shost->nr_hw_queues = 1;

if (shost->host_tagset) {
	shost->nr_hw_queues =
	    ioc->reply_queue_count - ioc->high_iops_queues;
	...
	dev_info(&ioc->pdev->dev,
	    "Max SCSIIO MPT commands: %d shared with nr_hw_queues = %d\n",
	    shost->can_queue, shost->nr_hw_queues);
}
Lê isso com atenção, porque estão a acontecer três coisas distintas.
O valor por omissão é uma fila de hardware. nr_hw_queues = 1. As várias filas só acontecem em controladores gen35 com a funcionalidade host_tagset ativada, e mesmo aí são aquilo que o próprio histórico de commits do driver descreve como várias filas de hardware simuladas: o hardware do controlador de I/O é uma única fila de submissão com várias filas de resposta, e o blk-mq está a ser encaixado por cima disso.
O número de filas vem do controlador, não do número de núcleos. É reply_queue_count menos as filas de IOPS altos, a atribuição de vetores MSI-X do adaptador. Não tem nada a ver com quantos CPU tens, e não cresce quando acrescentas discos. É a inversão exata do disco acima, onde o número de filas era o número de núcleos.
E o pool de tags é partilhado. host_tagset quer dizer exatamente o que diz: um pool de tags para o adaptador do host inteiro, e aquela linha de registo diz «shared» em voz alta. Todos os discos da placa vão buscar ao mesmo conjunto de slots de comando. Um chassis de vinte e quatro baias tem vinte e quatro discos a disputar as tags de um controlador.
Põe os dois lado a lado. Aquele SSD de portátil tinha dezasseis filas privadas de 1023, uma por núcleo, sem responder a mais ninguém. O mesmo disco atrás do adaptador recebe uma parte das filas de resposta da placa, 128 comandos pendentes e vinte e três vizinhos a ir buscar ao mesmo pool.
Portanto a perda não é o SCSI ser lento. O SCSI moderno sobre blk-mq está bem. A perda é estrutural:
- As filas pertencem ao adaptador, não ao disco. Acrescentar discos divide um recurso fixo em vez de o aumentar.
- O pool de tags é partilhado por todo o host. Um disco sob carga pesada pode deixar os outros à fome de uma maneira que simplesmente não pode acontecer quando cada disco tem as suas próprias filas.
- A profundidade por dispositivo está limitada a 128, independentemente do que o disco aguenta.
- A localidade das interrupções fica enfraquecida. As conclusões chegam na fila de resposta que o controlador usou, não necessariamente no núcleo que submeteu.
Com uma profundidade de fila de 1 ou 2, um processo de uma só thread a fazer leituras ocasionais, nada disto se nota. Mede-se a mesma latência das duas maneiras, dentro do ruído. A penalização aparece exatamente onde compraste NVMe para ajudar: muitos núcleos a emitir muitos I/O em simultâneo. Quanto mais funda a carga de trabalho, mais do disco pagaste sem lhe conseguir chegar.
O uplink é uma ranhura x8
O modelo de filas é o problema subtil. O teto de largura de banda é o óbvio, e podes lê-lo nas fichas de produto da própria Broadcom sem precisares de um benchmark.
O HBA da série 9500 é uma placa x8 PCIe Gen 4.0. Os números publicados pela Broadcom para ela são 13 700 MB/s em leitura sequencial de 256K e 3M IOPS em leitura aleatória de 4K. A mesma ficha diz que suporta até 32 dispositivos NVMe.
Põe esses dois números lado a lado e a pergunta responde-se sozinha: quantos discos são precisos para esgotar o adaptador?
Não muitos, e menos todos os anos. Um SSD Gen4 x4 faz cerca de 7 GB/s. Um SSD Gen5 x4 faz cerca de 14. Ambos são peças comuns em 2026: Gen4 é aquilo de que o mercado de U.2 usados está cheio, e Gen5 é o que tens se comprares novo.
| Teto | Discos Gen4 para o atingir | Discos Gen5 para o atingir |
|---|---|---|
| HBA 9500 — 13 700 MB/s sequencial | 2 | 1 |
| HBA 9500 — 3M IOPS (4K RR) | 3 | 1–2 |
| eHBA 9600 — 6,4M IOPS (4K RR) | ~6 | ~3 |
| MegaRAID 9600 — 1,1M IOPS RAID 5 (4K RW) | ~1 | ~1 |
Lê outra vez a linha de cima. Um único SSD Gen5 atinge todo o teto sequencial de um HBA 9500. Um disco, numa placa preparada para trinta e dois. Tudo o que vem depois é capacidade. Não desempenho.
E a linha de baixo é a que devia travar uma nota de encomenda: no MegaRAID da geração atual, uma prateleira cheia de NVMe em RAID 5 entrega mais ou menos o que um disco comum faz sozinho.
Os discos nem sequer ligam a x4
Há um segundo estrangulamento por baixo do uplink partilhado, fácil de não ver porque está numa tabela de especificações e não num título.
O PERC 12 User’s Guide da Dell, que cobre os controladores tri-mode H965i, diz:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3) and 16 GT/s (Gen 4) at maximum x2 lane width.
Cada disco NVMe recebe duas lanes, não quatro. Portanto, antes de qualquer disputa pelo uplink, antes do pool de tags, antes da tradução SCSI, um disco Gen4 já está reduzido a cerca de 3,5 GB/s, metade do que consegue fazer. Põe um disco Gen5 nessa baia e ele negoceia para baixo até Gen4 x2 e entrega mais ou menos um quarto da largura de banda nominal.
Vale a pena ser preciso sobre o que isto muda e não muda. Não quer dizer que o adaptador chega mais longe. São precisos uns quatro discos limitados a x2 para encher o uplink da 9500 em vez de dois, mas só porque cada disco contribui com metade. O estrangulamento passou do uplink para a ligação do disco. O total que consegues extrair não melhorou.
Com ligação direta, esses mesmos trinta e dois discos teriam cada um o seu caminho x4 até ao root complex, na geração que o disco e o CPU conseguirem negociar.
A linha do RAID 5 naquela tabela merece um olhar à parte, porque é um número da própria Broadcom e é publicado sem rodeios. Da ficha da série 9600:
900K to 1.1M RAID 5 IOPS (4K RW)
RAID de paridade no firmware do controlador é a coisa mais cara que podes pedir a uma placa tri-mode, e isto é a geração atual a fazê-lo. Vale a pena ler antes de alguém especificar RAID 5 em vinte e quatro discos NVMe e esperar o desempenho de vinte e quatro discos.
E uma placa x16?
A objeção óbvia a tudo o que está acima é que a 9500 é uma placa x8 Gen4, e o teto é um artefacto de uma ligação ao host estreita. Dá ao adaptador dezasseis lanes de Gen5 e o problema desaparece.
É uma objeção justa, e merece o exemplo mais forte em vez de um espantalho. Então pega no PERC13 H975i da Dell, a geração atual, e mais ou menos o melhor que o tri-mode consegue ser. O seu guia do utilizador especifica «Gen 4 and Gen 5 PCIe x16 host interfaces», e a StorageReview mediu 52,5 GB/s e 12,5M IOPS por controlador, com até dezasseis discos NVMe.
São números sérios, e mudam bastante o quadro. Face aos 13 700 MB/s e 3M IOPS da 9500, é cerca de quatro vezes a largura de banda e quatro vezes os IOPS, repartidos por metade dos discos. A Dell não se limitou a alargar o tubo: também reduziu o fan-out para metade, e a razão de sobresubscrição melhorou por consequência. Nos IOPS em particular, 12,5M por dezasseis discos dá cerca de 780K por disco, o que está perto do que um disco comum entrega sozinho. Nesse ponto o controlador não é genuinamente o que te está a travar.
Mérito a quem o tem, portanto: uma placa tri-mode x16 Gen5 moderna é uma peça de engenharia muito melhor do que uma x8 Gen4, e se a largura de banda era a tua única objeção, a x16 responde-lhe em grande parte.
Há três coisas que não resolve.
Os discos continuam a ligar a x2. Esta foi a que me surpreendeu. O guia do PERC13, a descrever um controlador Gen5 x16, continua a dizer:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3), 16 GT/s (Gen 4), and 32 GT/s (Gen 5) at maximum x2 lane width.
Uma ligação ao host mais larga não alarga as ligações aos discos a jusante. Todos os discos NVMe no controlador RAID tri-mode mais recente e mais rápido que a Dell vende continuam ligados por duas lanes em vez de quatro, e continuam a abdicar de metade da largura de banda antes de qualquer outra coisa acontecer.
O modelo de filas fica completamente intocado. Nada na secção de filas deste artigo depende da largura da ligação ao host. O nr_hw_queues vem da atribuição de filas de resposta MSI-X do controlador; a profundidade por dispositivo de 128 é uma constante do driver e do firmware; o pool de tags é partilhado por todo o host porque o host_tagset assim o diz. Alarga a ligação ao host para x16, x32, o que quiseres: os discos continuam a ser alvos SCSI a partilhar as filas da placa, continua a não haver /dev/nvme0n1, e continuas a não conseguir passar um disco a uma VM.
E a x16 não fabrica largura de banda: distribui lanes que já tinhas. Este é o argumento que de facto arruma a questão. Dezasseis lanes Gen5 para um PERC13 dão-te 52,5 GB/s partilhados por dezasseis baias. Essas mesmas dezasseis lanes ligadas diretamente a quatro discos Gen5 a x4 dão-te cerca de 56 GB/s por quatro baias, a mesma largura de banda das mesmas lanes, só que cada disco recebe o seu x4 completo, o seu próprio par de filas por núcleo e um nó de dispositivo nvme a sério.
Portanto a maneira honesta de descrever uma placa tri-mode x16 não é «um adaptador mais rápido». É um multiplexador de lanes: converte um orçamento fixo de lanes em mais baias, e cobra-te o modelo de filas pela conversão. Se o negócio vale a pena depende de uma coisa. Baias ou paralelismo.
O que acontece quando enches as baias todas
O que nos traz ao caso que importa de facto, porque ninguém compra um chassis de 24 baias para lhe meter quatro discos.
Depois do ponto de saturação, a linha agregada é plana. Acrescentar discos acrescenta capacidade, e mais nada, por isso o desempenho por disco cai como 1/N. Essa aritmética é implacável com populações realistas:
| Discos num HBA 9500 | Agregado | Por disco | Fração de um disco Gen4 |
|---|---|---|---|
| 2 | 13,7 GB/s | 6,9 GB/s | 98% |
| 12 | 13,7 GB/s | 1,14 GB/s | 16% |
| 24 | 13,7 GB/s | 0,57 GB/s | 8% |
Olha para a linha de baixo. Vinte e quatro discos NVMe atrás de um HBA 9500 entregam cerca de 570 MB/s cada um. Um SSD SATA faz à volta de 550. Compraste vinte e quatro discos NVMe, pagaste um controlador tri-mode para os ligar, e chegaste a uma largura de banda por disco de classe SATA.
A aritmética dos IOPS tem a mesma forma: 3M repartidos por vinte e quatro discos dá 125K a cada um, contra o 1M que um disco Gen4 comum consegue sozinho, cerca de um oitavo do que tens.
A placa x16 melhora isto consideravelmente mas não escapa. Um PERC13 com os seus dezasseis discos completos dá 52,5 GB/s ÷ 16 = 3,3 GB/s por disco, ou cerca de 23% de um disco Gen5, e isso antes de a ligação x2 o reduzir outra vez a metade.
Com muitos discos há dois efeitos piores do que a divisão sugere:
- A falta de tags atravessa dispositivos. O pool de tags partilhado pelo host significa que um único disco sob carga pesada pode consumir slots de que os outros discos precisam. Vinte e quatro dispositivos, cada um nominalmente com direito a 128 comandos pendentes, querem 3072 entre todos, tirados do
can_queuede um só controlador. O bloqueio na cabeça da fila entre discos distintos é um modo de falha que simplesmente não existe quando cada disco é dono das suas filas. - As reconstruções atingem tudo. A reconstrução de paridade numa prateleira cheia satura o único uplink partilhado, por isso o I/O em primeiro plano para todos os outros discos da placa degrada-se ao mesmo tempo. Com os discos em lanes independentes e RAID por software, a reconstrução disputa CPU, não um único tubo.
Quando nada disto importa
Há um contrapeso importante, e é a razão por que muitos servidores tri-mode de 24 baias correm perfeitamente felizes.
O teto do adaptador só morde se alguma coisa a jusante conseguir consumir mais do que ele entrega. Um servidor com 2 × 25GbE tem 6,2 GB/s de rede: não consegue encher nem um HBA 9500. Se esses vinte e quatro discos forem uma camada de capacidade a servir ficheiros por essa ligação, o adaptador está longe de ser o estrangulamento e a aritmética por disco acima é irrelevante.
O momento em que começa a importar é quando o consumidor fica mais rápido do que a placa: 100GbE (12,5 GB/s) põe-te sozinho ao nível de todo o teto sequencial de uma 9500, e as cargas locais, bases de dados, compilação, análise de dados, hosts de virtualização com guests ocupados, não têm rede nenhuma no caminho.
Portanto a pergunta a fazer sobre uma prateleira cheia não é «o adaptador é lento?» mas «o que é que vai consumir isto, e consegue consumir mais do que a placa entrega?» Se a resposta for uma ligação de 25GbE, deixa de te preocupar. Se a resposta for 100GbE, NVMe-oF ou uma base de dados local, a placa é o teu estrangulamento e o número de discos está a piorá-lo.
O que mais desaparece
Para além do débito, apresentar um disco NVMe como disco SCSI faz com que as partes específicas de NVMe das tuas ferramentas deixem de funcionar:
| Ligação direta | Atrás de um adaptador tri-mode | |
|---|---|---|
| Nó de dispositivo | /dev/nvme0n1 | /dev/sdb |
| Driver | nvme | mpt3sas / mpi3mr |
nvme-cli | Funciona | Nada com que falar |
| Dados de saúde | Páginas de registo SMART NVMe | Páginas de registo SCSI traduzidas |
| Gestão de namespaces | Sim | Não |
| Atualizações de firmware | nvme fw-download | Ferramenta do fabricante através do controlador |
| Format / sanitize | NVMe Format NVM | Equivalentes SCSI, se implementados |
| Filas de hardware | Um par por núcleo (16 na máquina acima) | As filas de resposta da placa, partilhadas por todos os discos |
| Profundidade de fila | 1023 por fila | 128 por dispositivo |
Há uma consequência que apanha as pessoas desprevenidas vezes suficientes para merecer menção à parte: não consegues passar um disco individual para uma máquina virtual. O passthrough PCIe precisa que o disco seja um endpoint PCIe com o seu próprio grupo IOMMU, e atrás de um adaptador tri-mode não é: o único dispositivo PCIe presente é o controlador. Podes passar o adaptador inteiro, com todos os discos ligados a ele, ou nada. Se o teu plano passava por entregar discos NVMe específicos a guests específicos, a decisão do backplane já tomou essa decisão por ti.
Então quem é que quer isto em 2026?
É aqui que o argumento de venda do início deste artigo tem de enfrentar uma pergunta mais difícil, porque o mundo para que foi concebido já quase desapareceu.
O tri-mode foi concebido quando o NVMe era a camada cara que acrescentavas a um parque SAS. Em 2026 isso está ao contrário: o NVMe é o padrão, os discos empresariais U.2 abundam e são baratos no mercado de usados, e «SAS, SATA e NVMe misturados num chassis» descreve cada vez menos implementações reais. Então quem é que o compra de facto?
Quase ninguém, de propósito. A resposta honesta é que a maioria dos controladores tri-mode não foi escolhida. Chegaram, porque o fabricante do servidor envia um, e o fabricante envia um porque um único SKU de backplane U.3 lhe permite vender configurações SAS, SATA e NVMe a partir do mesmo chassis. É uma vitória da cadeia de abastecimento para o OEM. Não faz nada pelo teu desempenho e, como tal, nunca foi vendido como fazendo.
Três das justificações clássicas já não se aguentam bem:
«Preciso de tipos de disco misturados.» Raramente no mesmo chassis, e mesmo quando precisas, o tri-mode não é a única maneira. Um HBA SAS simples para os discos rotativos mais NVMe ligado ao root complex dá-te os dois, sem penalizar nenhum. Parque misto não implica controlador misto.
«Não tenho lanes PCIe suficientes.» Este era o argumento real em 2019, em plataformas de 40 lanes com 24 baias. Um Epyc Genoa ou Turin de um só socket tem 128 lanes. Vinte e quatro discos a x4 são 96. A escassez que justificava agregar discos atrás de um controlador quase desapareceu, e onde não desapareceu, um switch PCIe faz o trabalho sem terminar o protocolo.
«As baias têm de ser universais.» Este merece ser separado com cuidado, porque é o argumento mais usado para justificar o componente errado. O U.3 é uma norma de backplane, não um requisito de controlador. Um backplane U.3 pode ser cablado diretamente às lanes PCIe do CPU em vez de passar por um controlador tri-mode, e os fabricantes documentam as duas topologias. Podes manter as baias universais e eliminar a portagem. Se herdaste um servidor tri-mode, a coisa mais valiosa que podes verificar é se o backplane pode ser recablado em ligação direta.
O que sobra de facto:
- RAID por hardware em densidade, onde uma política ou a plataforma o exigem: um requisito de auditoria, uma matriz de suporte, uma implementação Windows ou ESXi sem camada de software para fazer o trabalho. Este é o mercado real que resta, é o único caso em que estás a comprar o motor RAID e não a conectividade, e no silício atual é um produto capaz: dezasseis discos NVMe em RAID 5 por hardware com uma cache protegida por supercondensador, a partir de dezasseis lanes, é algo que a ligação direta não consegue oferecer de todo.
- Capacidade em massa de HDD SAS, onde o £/TB ainda pertence decisivamente aos discos rotativos. Mas isso é trabalho para um HBA SAS simples, e mais barato.
- Números de baias muito grandes e compartimentos externos, onde os expansores SAS chegam mais longe e mais largo do que o PCIe.
- Cargas de trabalho que nunca vão fundo. Se as tuas profundidades de fila ficam em um dígito, nada disto se nota. Muitos sistemas reais vivem aqui bastante felizes.
Há também um argumento operacional simples, um tipo de compartimento, um driver, uma peça sobressalente na prateleira, e para um host de virtualização de uso geral isso vale alguma coisa de real. Só tens de o pôr honestamente na balança contra o facto de que, segundo a tabela acima, um disco Gen5 consegue atingir todo o teto sequencial da placa.
Quando é a ferramenta errada
A troca piora na proporção da concorrência que a tua carga de trabalho tem.
O Ceph é o caso mais claro. Um nó de armazenamento corre um OSD por disco, cada um com os seus próprios pools de threads, todos a emitir I/O ao mesmo tempo, e depois os clientes de um cluster inteiro atacam-nos em simultâneo. Esse é o pior caso do pool de tags partilhado: vinte e quatro daemons a disputar os slots de comando de um controlador, cada disco limitado a 128 pendentes, tudo afunilado por um uplink x8. Põe esses discos diretamente no root complex e cada OSD fica com as suas próprias filas, as suas próprias tags e as suas próprias lanes. Um nó Ceph todo NVMe não devia ter um adaptador tri-mode no caminho dos dados.
A mesma lógica aplica-se a alvos NVMe-oF, onde estás a reexportar discos e cada camada de serialização se acumula; a bases de dados com I/O assíncrono fundo; e a tudo o que é construído sobre io_uring ou SPDK, que existem precisamente para explorar filas por núcleo que o adaptador acabou de levar.
A regra geral: quanto mais paralelismo o teu software foi escrito para explorar, mais um adaptador tri-mode te cobra por ele.
Como saber o que tens
Se herdaste um servidor e queres saber de que lado disto estás:
# What is the transport? "nvme" is direct, "sas" means it went through a controller
lsblk -o NAME,TRAN,MODEL,SIZE

# Is there a tri-mode controller in the machine at all?
lspci -nn | grep -Ei 'sas|megaraid|serial attached'

# Which driver claimed the disk?
ls -l /sys/block/sdb/device/driver

# Per-device queue depth — 128 is the mpt3sas NVMe default
cat /sys/block/sdb/device/queue_depth

# How many hardware queues does this device actually get?
ls /sys/block/sdb/mq/ | wc -l
ls /sys/block/nvme0n1/mq/ | wc -l    # compare against a direct-attached drive

# On a direct-attached drive, what did the controller actually grant?
# One admin queue plus one I/O queue per core, so expect nproc + 1
cat /sys/class/nvme/nvme0/queue_count
nproc

# The driver says it out loud at load time
dmesg | grep -i 'nr_hw_queues'
Esse último imprime a linha Max SCSIIO MPT commands: N shared with nr_hw_queues = M citada acima. Se o nvme list estiver vazio numa máquina que te disseram ser toda flash NVMe, a culpa é do adaptador.
A versão curta
Um adaptador tri-mode converte os teus discos NVMe em discos SCSI. Essa conversão não é um efeito secundário. É como uma placa serve três protocolos, e é o que estás a comprar.
Aquilo de que abdicas é específico e mensurável: pares de filas por núcleo substituídos pelas filas de resposta partilhadas de um controlador, uma profundidade por dispositivo de 128, um pool de tags dividido por todos os discos da placa, uma ligação x2 onde o disco queria x4, e um uplink partilhado onde cada disco tinha antes o seu próprio caminho até ao root complex. O adaptador deixa de ser uma ligação e passa a ser o estrangulamento, e no hardware atual passa a sê-lo depressa: dois discos Gen4 atingem um HBA 9500, quatro discos Gen5 atingem até um PERC13.
Uma ligação ao host mais larga ajuda, uma placa x16 Gen5 tem cerca de quatro vezes a largura de banda e os IOPS de uma x8 Gen4, mas não muda a forma. Compra baias, não paralelismo: as mesmas dezasseis lanes ligadas diretamente a quatro discos entregam a mesma largura de banda sem nenhuma da portagem das filas. E não salva uma prateleira cheia. Vinte e quatro discos atrás de uma 9500 recebem cerca de 570 MB/s cada um, que é o que um SSD SATA faz.
Em 2019, quando o NVMe era a camada que acrescentavas a um parque SAS e as plataformas tinham poucas lanes, era uma troca razoável. Em 2026 normalmente não é. O NVMe é o padrão, os discos U.2 usados são baratos, um Epyc de um só socket tem lanes de sobra, e o único benefício que se mantém, as baias universais, pertence ao backplane U.3, não ao controlador. Muitas vezes consegues manter as baias e eliminar a portagem cablando o backplane diretamente ao CPU.
Portanto compra um adaptador tri-mode se estás a comprar o seu motor RAID e precisas de um. Não o compres pela flexibilidade e, se herdaste um num chassis cheio de NVMe, vai descobrir como está cablado esse backplane.
Não faz sentido pagar duas vezes por discos que depois não consegues usar como deve ser.