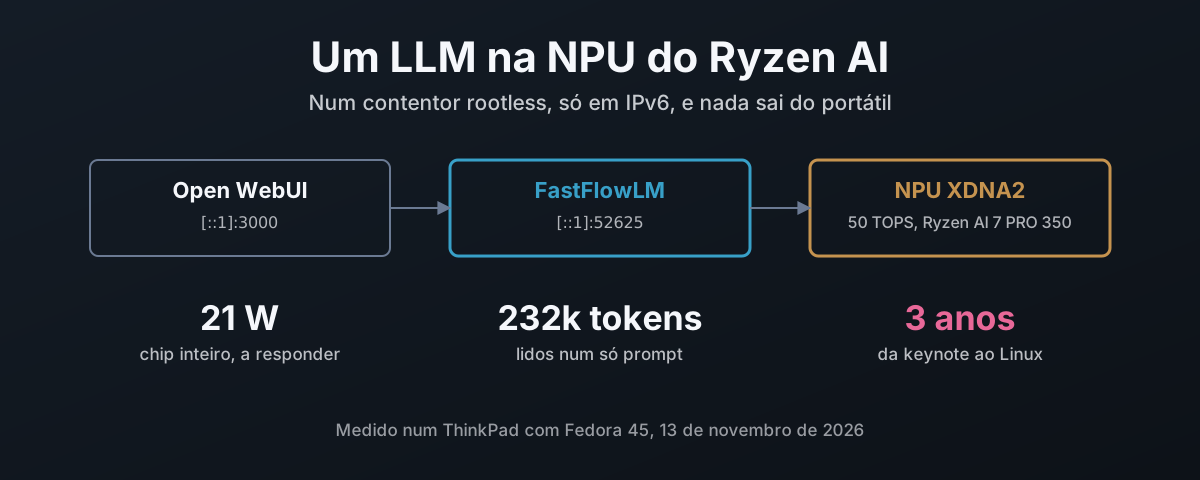
50 TOPS a fazer nada
Todos os portáteis Ryzen AI vendidos nos últimos dois anos têm lá dentro uma Neural Processing Unit (NPU), um bloco de silício feito apenas para a matemática por trás dos modelos de IA. No meu, um ThinkPad com um Ryzen AI 7 PRO 350, a AMD classifica-a em até 50 TOPS, biliões de operações por segundo1. Pagaste por ela. Numa instalação Linux de base não faz nada.
Isso mudou este ano. Depois de configurada, a NPU corre um modelo de linguagem de 4 mil milhões de parâmetros por trás de uma janela de chat, mais voz para texto, tudo no portátil, sem conta, sem subscrição e sem nada a sair da máquina, o que, para tudo o que preferias não escrever no site de outra pessoa, é exatamente o objetivo. O chip inteiro consome cerca de 21 W enquanto responde, e em repouso fica abaixo dos 9 W.
| O que corre | Onde | Endereço |
|---|---|---|
| Qwen 3.5 4B, contexto de 256k tokens | NPU, num contentor | http://[::1]:52625/v1 |
Voz para texto: o Whisper da OpenAI, whisper-v3:turbo | NPU, mesmo contentor | o mesmo, /audio/transcriptions |
| Open WebUI, a página de chat | CPU, num contentor | http://[::1]:3000 |
| driver de kernel amdxdna, firmware | host | /dev/accel/accel0 |
Duas regras moldaram a construção. Só o driver do kernel e o seu firmware vão para o host; todas as frameworks de modelos correm num contentor podman rootless. E todos os serviços escutam apenas no loopback IPv6, sem nada em IPv4. Ambas acabaram por dar menos trabalho do que fazer as coisas à trouxe-mouxe, e ambas apanharam problemas que de outra forma eu teria deixado passar.
O que é preciso em Linux
A NPU deste chip é o design de segunda geração da AMD, XDNA2. Isso importa, porque o software que corre modelos de linguagem nela suporta peças XDNA2 (séries Ryzen AI 300 e 400, Strix Halo) e não a primeira geração dos Ryzen 7040 e 80402. Verifica a tua antes de começares:
$ lspci -nn | grep -i 'neural\|signal processing'
c5:00.1 Signal processing controller [1180]: Advanced Micro Devices, Inc. [AMD] Strix/Krackan/Krackan2/Strix Halo Neural Processing Unit [1022:17f0] (rev 20)
Há quatro camadas entre esse dispositivo e uma resposta no chat, e a divisão entre host e contentor é todo o design:
| Camada | O que é | Vive em |
|---|---|---|
amdxdna | driver de kernel, cria /dev/accel/accel03 | host, via DKMS |
| Firmware da NPU | npu_7.sbin, 1.1.2.64 neste chip | host, do linux-firmware |
XRT + plugin amdxdna | a biblioteca de runtime da AMD e o seu backend para a NPU | contentor |
| FastFlowLM | o runtime de LLM, kernels da NPU incluídos | contentor |
O kernel 7.x traz o amdxdna na árvore, mas a AMD desenvolve-o primeiro no seu próprio repositório, e o
plugin de espaço de utilizador tem de corresponder ao módulo de kernel com que fala4. A distância entre os dois
não é pequena. Neste portátil:
| Na árvore, 7.2.15 e 7.3.3 do Fedora | Fora da árvore, amd/xdna-driver em 24dfd686 | |
|---|---|---|
| Interface do driver | 0.105 | 0.19 |
| Versão do módulo | nenhuma | 2.27.0_20261113 |
| IDs PCI de NPU que associa | 6 | 8 |
| Ficheiros de firmware que pede | 7 | 59 |
| Firmware que este chip carrega | 17f0_10/npu_7.sbin, 1.1.2.64 | o mesmo ficheiro |
Nove versões de interface de diferença, e o Linux 7.3, a versão mais recente, ainda traz a 0.10. A única
coisa em que concordam é o firmware, e esse vem do linux-firmware do Fedora, não de nenhum dos
drivers. Por isso compilo as duas metades a partir de um só commit do amd/xdna-driver, ponho o módulo no host
e meto o espaço de utilizador correspondente na imagem.
O driver: compila tudo, fica só com a parte do kernel
O amd/xdna-driver traz o XRT como submódulo git, e compilá-lo produz RPMs para o XRT e um
pacote de plugin. O pacote de plugin também traz o código-fonte do driver, que regista no
DKMS (Dynamic Kernel Module Support, a coisa que recompila um módulo para cada kernel novo).
Nada disto é difícil:
git clone --recursive https://github.com/amd/xdna-driver.git && cd xdna-driver
sudo ./tools/amdxdna_deps.sh
(cd xrt/build && ./build.sh -npu -opt)    # XRT RPMs in xrt/build/Release/
(cd build && ./build.sh -release)         # plugin RPM, driver source inside
No Fedora 45 o script de dependências termina num erro. Ignora-o:
| Pede | O que acontece | Importa? |
|---|---|---|
protobuf-devel | entra em conflito com um protobuf3-compiler instalado | não, sem ele o XRT só salta uma ferramenta de tracing |
redhat-lsb | não existe tal pacote, o Fedora deixou-o cair | não |
| tudo o resto | já instalado |
A última versão com tag lá é de fevereiro, por isso o main é o canal de lançamento. Passei de uma
compilação de maio para a de novembro: 550 commits, XRT 2.23 para 2.27.
O upgrade apaga o driver que acabou de instalar
A minha primeira tentativa de upgrade levou o módulo por completo. O RPM corre o script de instalação
do pacote novo, que compila e regista o novo driver no DKMS, e depois corre o script de remoção
do pacote antigo. Esse script de remoção lê a versão do driver de um ficheiro que o pacote novo já
sobrescreveu, por isso desregista a versão que acabou de ser instalada. A saída do dnf
di-lo em duas linhas, uma a seguir à outra:
>>> Successfully installed and enabled DKMS for xrt-amdxdna/2.27.0
>>> Removing driver source: xrt-amdxdna/2.27.0...
Nada falhou, nada ficou a vermelho, e o arranque seguinte teria carregado discretamente o que quer que o kernel
trouxesse em vez dele. Posso perguntar porque é que um script de remoção corre num upgrade sem verificar se é
um upgrade? O RPM entrega essa resposta a cada scriptlet como primeiro argumento. É um if.
É também a razão pela qual o host já não recebe os RPMs de todo. O código-fonte do driver é um tarball dentro do pacote de plugin, por isso tiro-o de lá e entrego-o diretamente ao DKMS:
T=$(mktemp -d) && rpm2cpio xrt_plugin*.rpm | (cd $T && cpio -idm --quiet)
D=$T/opt/xilinx/xrt/share/amdxdna
sudo mkdir -p /usr/src/xrt-amdxdna-2.27.0
sudo tar -xf $D/amdxdna.tar.gz -C /usr/src/xrt-amdxdna-2.27.0
sudo cp $D/dkms.conf $D/configure_kernel.sh /usr/src/xrt-amdxdna-2.27.0/
sudo dkms install xrt-amdxdna/2.27.0
sudo modprobe -r amdxdna; sudo modprobe amdxdna
Sem reinício. É Linux, e nada tem o dispositivo aberto nesse momento, por isso o módulo troca
a quente. O DKMS depois
recompila-o para cada kernel que o dnf instala; quando o 7.3.3 chegou, já estava compilado antes de eu ter
reiniciado para ele.
Verifica que foi a compilação DKMS que carregou e não a da árvore, e que o firmware é suficientemente recente. O FastFlowLM quer 1.1.0.0 ou posterior2:
$ modinfo -F filename amdxdna
/lib/modules/7.2.15-300.fc45.x86_64/extra/amdxdna.ko.xz
$ cat /sys/bus/pci/drivers/amdxdna/*/fw_version
1.1.2.64
$ journalctl -k | grep 'Initialized amdxdna'
[drm] Initialized amdxdna_accel_driver 0.19.0 for 0000:c5:00.1 on minor 0
O DKMS põe de lado o módulo do próprio kernel em vez de o apagar, em
/var/lib/dkms/xrt-amdxdna/original_module/, por isso retirar a compilação DKMS repõe-no.
Mais uma coisa em que não deves mexer: amd_iommu=off na linha de comandos do kernel desativa a NPU2.
FastFlowLM num contentor
O FastFlowLM é o runtime que torna a NPU útil para modelos de linguagem. É uma linha de comandos ao estilo do Ollama e um servidor compatível com OpenAI, escrito para XDNA2, e passou para a organização ROCm da AMD este ano6. O runtime tem licença MIT. Os kernels da NPU que traz são binários fechados, livres de usar e redistribuir sem modificações7. Preferia que fossem abertos, e digo-o, mas estão no repositório e nada tem de ser descarregado de mais lado nenhum.
A imagem são três fases sobre o Fedora 45: o XRT da compilação do driver, o FastFlowLM compilado contra ele, e depois um runtime só com o que precisa. A parte que importa:
FROM registry.fedoraproject.org/fedora:45 AS xrt
ARG XDNA_COMMIT
COPY dist/xdna-${XDNA_COMMIT}/ /rpms/
RUN dnf -y install /rpms/xrt_2*-base.rpm /rpms/xrt_2*-npu.rpm \
 && rpm -i --noscripts --nodeps --nosignature \
        --excludepath=/usr/lib/firmware --excludepath=/opt/xilinx/xrt/share/amdxdna \
        /rpms/xrt_plugin*.rpm \
 && echo /opt/xilinx/xrt/lib64 > /etc/ld.so.conf.d/xrt.conf && ldconfig
Cada uma dessas flags está lá porque algo partiu sem ela:
| Problema | Correção |
|---|---|
| Os scripts do plugin compilam um módulo de kernel, que pertence ao host | --noscripts, e o código-fonte do driver e o firmware excluídos |
| O RPM 6 do Fedora 45 impõe a verificação de assinaturas por predefinição8, e um RPM compilado por mim não está assinado | --nosignature: compilei-o eu, sei de onde veio |
As bibliotecas do XRT estão em lib64, que não está no caminho do linker | /etc/ld.so.conf.d/xrt.conf dentro da imagem |
O FastFlowLM encontra o XRT através do pkg-config, e o setup.sh do XRT não define o caminho | PKG_CONFIG_PATH=/opt/xilinx/xrt/lib64/pkgconfig na fase de compilação |
A imagem final tem 609 MB, e a sua tag traz o commit do driver,
fastflowlm:v1.0.12-xdna24dfd686. Uma verificação de saúde compara-o com o commit que o módulo
carregado reporta e falha se forem diferentes. Uma imagem compilada para o driver errado é a única avaria
aqui que é realmente confusa de diagnosticar, por isso é apanhada antes de chegar tão longe.
O contentor recebe um dispositivo, a NPU, e o limite de memory-lock de que o FastFlowLM precisa para fixar os seus buffers:
podman run --rm --device /dev/accel/accel0 --ulimit memlock=-1:-1 \
  localhost/fastflowlm:v1.0.12-xdna24dfd686 validate
[Linux]  NPU: /dev/accel/accel0 with 8 columns
[Linux]  NPU FW Version: 1.1.2.64
[Linux]  Memlock Limit: infinity
O autoteste da própria AMD, xrt-smi validate, pôs a NPU nos 51 TOPS numa multiplicação de matrizes. São os
50 da caixa, entregues.
Arrancar com o sistema, só em IPv6
O Quadlet transforma um pequeno ficheiro .container num serviço systemd9. Como unidade de utilizador corre
rootless, como eu, e com o lingering ligado arranca com o sistema sem ninguém com sessão iniciada10:
[Unit]
Description=FastFlowLM NPU server
ConditionPathExists=/dev/accel/accel0

[Container]
Image=localhost/fastflowlm:v1.0.12-xdna24dfd686
AddDevice=/dev/accel/accel0
Ulimit=memlock=-1:-1
Network=host
Volume=%h/.config/flm:/models:Z
Exec=serve qwen3.5:4b --host ::1 --port 52625 -c 262144 -a whisper-v3:turbo
StopSignal=SIGINT

[Install]
WantedBy=default.target
loginctl enable-linger $USER
cp fastflowlm.container ~/.config/containers/systemd/
systemctl --user daemon-reload && systemctl --user start fastflowlm
-c 262144 define a janela de contexto, e o teste de contexto mais abaixo é
a razão de ser tão grande. -a whisper-v3:turbo carrega um segundo modelo ao lado do modelo de chat, um que
transforma voz em texto; tem a sua própria secção.
Três linhas ali foram aprendidas à custa de erros:
| Linha | Sem ela |
|---|---|
StopSignal=SIGINT | o FastFlowLM ignora o SIGTERM, o sinal de paragem do podman, e é morto dez segundos depois |
--host ::1 | escuta em 127.0.0.1, IPv4 |
::1, não [::1] | a forma com parênteses retos não é interpretada; os parênteses pertencem a um URL |
Prova o endereço em vez de confiares nele:
$ ss -ltn 'sport = :52625'
LISTEN 0  4096  [::1]:52625  [::]:*
$ curl -s http://127.0.0.1:52625/v1/models || echo refused
refused
localhost continua a funcionar para tudo o que o resolva primeiro para ::1, o que o
/etc/hosts do Fedora e o Chrome fazem.
O que faz, medido
Nove modelos pelo benchmark do próprio FastFlowLM, sendo a descodificação a velocidade a que a resposta flui:
| Modelo | Descodificação, contexto 1k | Descodificação, contexto 8k | Leitura do prompt, 8k |
|---|---|---|---|
llama3.2:1b | 77 tok/s | 56 tok/s | 2009 tok/s |
qwen3.5:2b | 32 | 29 | 1533 |
llama3.2:3b | 30 | 20 | 857 |
phi4-mini-it:4b | 25 | 17 | 744 |
qwen3:4b | 23 | 15 | 613 |
qwen3.5:4b | 17 | 15 | 657 |
gemma4-it:e4b | 14 | 12 | 642 |
qwen3:8b | 13 | 10 | 418 |
qwen3.5:9b | 11 | 10 | 451 |
O ritmo de leitura é de cinco a oito tokens por segundo, por isso qualquer um destes vai à tua frente. A descodificação
cai mais ou menos para metade cada vez que o modelo duplica, que é o que se espera quando o limite é a largura de banda
da memória e não o cálculo. Eu corro o qwen3.5:4b. O Phi-4 mini é mais rápido, mas o Qwen 3.5 mantém a velocidade à medida que a conversa cresce,
lida com imagens e chamadas de ferramentas, e mantém uma cache de prompt que poupa a releitura de todo o histórico a
cada vez. É isso que decide.
256 000 tokens de contexto
O Qwen 3.5 foi feito para uma janela de 262 144 tokens11, e o FastFlowLM usa 32 768 por predefinição. Para lá desse
limite faz uma coisa que vale a pena saber: regista Max length reached, stopping prefilling
e fecha a ligação sem resposta e sem erro, por isso a janela de chat fica ali parada com uma resposta
vazia e tens de adivinhar se quem caiu foi o modelo, o servidor ou o navegador.
Por isso subi-o com -c 262144 e testei-o como deve ser. Um código escondido na primeira linha de um
prompt de 232 250 tokens, cerca de 175 000 palavras, pedido no fim:
| Contexto 8k | Contexto 232k | |
|---|---|---|
| Resposta | correta | correta, AMBER-FALCON-7731 |
| Leitura do prompt | 657 tok/s | 210 tok/s |
| Espera pela primeira palavra | 12 segundos | 18,4 minutos |
| Descodificação | 15 tok/s | 2,4 tok/s |
| Memória reservada | ~5 GB | ~12,7 GB |
Funciona. É lento. E a memória fica reservada quer uses a janela quer não. Com 90 GB na máquina, pago isso para ter uma colagem longa respondida em vez de silenciosamente descartada.
A GPU pode ajudar?
O mesmo chip tem uma Radeon 860M, por isso a pergunta óbvia é se pode ficar com parte da carga. Dividir um modelo entre a NPU e a GPU, lendo o prompt numa e escrevendo a resposta na outra, não é algo que algum runtime Linux faça hoje. Correr um segundo runtime na GPU é, por isso medi isso.
«Eficiente» aqui significa velocidade e energia juntas. O driver amdgpu reporta a potência do pacote para
o chip inteiro sem root, e o driver amdxdna reporta a NPU sozinha, por isso cada execução
abaixo foi amostrada quatro vezes por segundo. O mesmo modelo a 4 bits em todas.
Dos runtimes de GPU que vi, um funcionou:
| Runtime | Resultado na 860M |
|---|---|
| llama.cpp, backend Vulkan12 | funciona; imagem de 881 MB |
| llama.cpp, backend ROCm | vê a GPU e depois dá segfault no primeiro trabalho, com ou sem um override da versão da GPU; imagem de 23 GB |
| MLC-LLM, Vulkan13 | o seu compilador dá segfault ao compilar a arquitetura do Qwen 3.5 |
| vLLM, SGLang | não experimentados: feitos para GPUs de centro de dados e muitos utilizadores, não para uma iGPU de 8 unidades |
E a NPU contra o que funcionou:
| Qwen 3.5 4B | NPU, FastFlowLM | GPU, llama.cpp Vulkan |
|---|---|---|
| Em repouso, modelo carregado | 8,6 W | 16,0 W, contra 9,7 W com ele parado |
| Leitura do prompt, ~6k tokens | 557 tok/s a 23,8 W | 411 tok/s a 46,1 W |
| Energia por token do prompt | 0,043 J | 0,112 J |
| Descodificação | 18,2 tok/s a 21,0 W | 23,5 tok/s a 40,7 W |
| Energia por token gerado | 1,16 J | 1,73 J |
A GPU escreve respostas cerca de 29% mais depressa. Queima o dobro da potência para o fazer. A NPU lê prompts mais depressa e com menos de metade da energia. O número maior é o do repouso: o servidor na GPU carregado e sem fazer nada custa 6,3 W acima da mesma máquina com ele parado, o dia inteiro. Correr os dois ao mesmo tempo levou a NPU de 18,2 para 14,2 tokens por segundo e a GPU de 23,5 para 13,9, porque partilham a mesma memória. Por isso o contentor da GPU existe, mas é iniciado quando quero um segundo modelo, e não está ativado no arranque.
A própria NPU consumiu menos de 2 W em todas as execuções. A maior parte dos 21 W é o CPU e a memória a alimentá-la. Esse é o teto a vigiar nas próximas versões do FastFlowLM.
Voz para texto também na NPU
O Whisper é o modelo de reconhecimento de voz da OpenAI: áudio à entrada, texto à saída, em 99 línguas, e lançado sob a licença MIT, por isso corre em qualquer lado sem pedir licença a ninguém14. O Large-v3 é a versão completa atual. O Turbo é o mesmo modelo com o seu descodificador, a metade que escreve o texto, cortado de 32 camadas para 4. O model card põe a troca às claras: «way faster, at the expense of a minor quality degradation». Com 809 milhões de parâmetros, tem um quinto do tamanho do modelo de chat.
O FastFlowLM traz-o já convertido para a NPU como whisper-v3:turbo, um download de 623 MB, e
carrega-o ao lado do modelo de chat com -a whisper-v3:turbo. Não serve o Whisper sozinho;
tem de haver também um modelo de chat carregado. O áudio vai para o endpoint de transcrição padrão da OpenAI
e o texto volta.
| 19,6 segundos de fala | |
|---|---|
| Primeiro pedido, a carregar o Whisper | 6,2 s |
| Depois disso | 2,0 s, cerca de dez vezes o tempo real |
| Potência do chip inteiro | ~24,7 W |
| Precisão | todas as palavras certas |
Escritas com as falsas grafias inglesas americanas, atenção: «color» e «program». A API do Whisper aceita um prompt, e um
prompt escrito na verdadeira grafia do inglês britânico, o inglês de Inglaterra, de onde a língua
vem, chega para o corrigir:
curl -s 'http://[::1]:52625/v1/audio/transcriptions' -F file=@speech.wav \
  -F model=whisper-v3:turbo -F language=en \
  -F 'prompt=British English spelling: colour, programme, organise, centre.'
Não devíamos ter de corrigir estes modelos de todo. O Whisper foi treinado em 99 línguas e mesmo assim escreve inglês à americana a menos que lhe digam o contrário, porque as pessoas que o construíram tratam a sua grafia como a predefinição e a de toda a gente como uma opção que tens de pedir. É o irritante «por defeito, à americana» que o resto do mundo detesta, e está embutido como um enviesamento. O prompt de sistema do modelo de chat leva a mesma instrução, na secção abaixo, pela mesma razão.
Uma janela de chat, e 7000 tokens que nunca escreveste
O Open WebUI é o front end no navegador15, no seu próprio contentor, ligado a [::1]:3000 da mesma
forma e apontado à NPU. O seu botão de microfone vai para o Whisper na NPU em vez da sua própria
predefinição, que teria descarregado um modelo e corrido no CPU.
A primeira mensagem que lhe enviei tinha vinte palavras. Chegou à NPU como um prompt de 7223 tokens, porque o Open WebUI 0.13 anexa as definições de todas as suas ferramentas incorporadas (memória, notas, calendário, automatizações, pesquisa na web) a cada mensagem, e um administrador recebe todas elas.
| A mesma pergunta de vinte palavras | Prompt enviado à NPU | Espera pela primeira palavra |
|---|---|---|
| Ferramentas incorporadas ligadas, a predefinição | 7223 tokens | ~12 s |
| Ferramentas incorporadas desligadas para o modelo | 127 tokens | menos de 1 s |
Para um modelo local, essa predefinição devia estar desligada. Doze segundos, em cada resposta.
Também me disse, cheio de confiança, que tinha sido «trained by Google» e que corria «on Google’s advanced infrastructure». É um modelo Qwen, feito pela Alibaba, a correr num portátil. Isso é um completo disparate, e não devia acontecer.
Não é da configuração. Um modelo só vê o texto que lhe é enviado, e o nome na lista pendente é uma etiqueta para o servidor, nunca passada ao modelo. Por isso aquela resposta veio só do modelo, e ele errou o único facto sobre si próprio que nunca devia estar em dúvida. Isso é uma falha de design, e fica com quem lançou o modelo.
A Alibaba sabia como o impedir. O template de chat do Qwen 2.5 abria cada conversa com «You are Qwen, created by Alibaba Cloud» a menos que lhe desses outra coisa16. O Qwen 3 deixou cair essa linha17, e o Qwen 3.5 também sai sem ela18. Nada a substituiu, e a julgar por aquela resposta o modelo nunca a aprendeu bem o suficiente para se safar sozinho. Pergunta a um modelo 4B «what are you?» sem prompt e ele recorre à resposta mais comum nos seus dados de treino, que é a de outra pessoa.
É uma coisa pequena? Não. Um modelo que te diz, com toda a confiança, quem o construiu e em que centro de dados corre, e erra as duas, fará o mesmo com qualquer outra coisa que não possa verificar. Aqui sabes a resposta certa. Na maioria das vezes não vais saber.
Por isso tem de lhe ser dito, num prompt de sistema:
| Pergunta «what are you, and what are you running on?» | Resposta |
|---|---|
| Sem prompt de sistema | «a large language model trained by Google… Google’s advanced infrastructure» |
| Com um | «Qwen 3.5, a large language model created by Alibaba… running locally on your Lenovo ThinkPad using the AMD Ryzen AI 7 PRO 350’s NPU via FastFlowLM» |
O mesmo prompt diz-lhe para escrever em inglês britânico, outra vez por causa do «por defeito, à americana» que o Whisper também tem. Dito, fá-lo. Continua a não conseguir dizer-te que dia é. Um modelo sem calendário e sem internet adivinha datas e acontecimentos recentes, e nem sempre o diz, peça o prompt o que pedir.
Três anos para correr IA em Linux
A AMD pôs o Ryzen AI em palco em janeiro de 2023 como «the first dedicated artificial intelligence hardware in an x86 processor»19. Conta a partir dessa keynote:
| Quando | O que aconteceu em Linux | Depois da keynote |
|---|---|---|
| 4 de janeiro de 2023 | Ryzen AI anunciado, no Ryzen 7040 | |
| 25 de janeiro de 2024 | amd/xdna-driver publicado no GitHub4 | 1 ano |
| 24 de março de 2025 | amdxdna no Linux mainline, 6.1420 | 2 anos e 2 meses |
| 27 de março de 2025 | este chip, o Ryzen AI 7 PRO 350, é lançado1 | 2 anos e 2 meses |
| 11 de março de 2026 | FastFlowLM 0.9.35, a sua primeira versão nativa para Linux21 | 3 anos e 2 meses |
| 11 de agosto de 2026 | FastFlowLM 1.0.0, agora sob o ROCm da AMD6 | 3 anos e 7 meses |
| hoje | ainda nenhum runtime de LLM para os 7040 e 80402 | 3 anos e 10 meses |
Três anos e dois meses para correr um modelo de linguagem na NPU em Linux, ponto, e não foi o software da própria AMD que o fez. Foi o FastFlowLM, um projeto que começou fora da empresa e foi absorvido sob o ROCm este ano. As suas notas de versão para Linux abrem com «The wait is finally over», e depois dizem que usa «the exact same recipe you already know and love on Windows»21. O Fisher-Price OS (Windows) recebeu-o primeiro, e disseram-no. O próprio Ryzen AI Software da AMD ainda diz, nas notas de versão atuais, «Model generation is not supported on Linux in this release»22.
Quem comprou a primeira geração está pior. Um portátil Ryzen 7040 de 2023 tem uma NPU em que nenhum runtime de modelos de linguagem em Linux toca, e nada publicado diz que venha algum. O mesmo emblema.
Posso perguntar porquê? Não quem, porquê. O que é que no processo da AMD deixou vender um chip com IA no nome enquanto o software para usar essa IA em Linux apareceu anos depois, vindo de fora? A ficha técnica diz «Up to 50 TOPS»1. O emblema diz Ryzen AI. Ambas são declarações feitas a quem compra o portátil, e no primeiro ano deste chip em Linux ambas não valeram nada.
Apontado ao Copilot, não ao centro de dados
Não é que a AMD ache o Linux difícil. No centro de dados o Linux é de primeira classe e a AMD sabe-o: o El Capitan, em Lawrence Livermore, são processadores AMD EPYC e aceleradores AMD Instinct, foi o computador mais rápido do mundo até junho deste ano23, e corre o TOSS, a compilação própria de Red Hat Linux de Livermore24. Consegues imaginar a AMD a vender um acelerador Instinct e a dizer ao comprador que o software para Linux viria mais tarde, de outra pessoa? Seria um não. A AMD até escreveu o driver de kernel desta NPU e meteu-o no mainline. A última camada, a que põe o hardware a fazer o trabalho para o qual foi vendido, foi a parte que ficou à espera.
Nunca devia ter sido um projeto de portátil. A mesma arquitetura XDNA foi para uma placa de centro de dados no mesmo ano, a Alveo V70, vendida como «the first Alveo production card leveraging AMD XDNA architecture with AI Engines»25. Constrói uma pilha de software para o AI Engine, Linux primeiro como o resto do centro de dados, e o portátil recebe-a de borla. O servidor também. Um acelerador pequeno e frugal é exatamente o que queres distribuir por máquinas virtuais, uma fatia a cada, para os modelos pequenos que não precisam de uma GPU inteira. O kernel só aprendeu a fazer isso este ano, dividindo uma NPU em funções virtuais nas novas peças AIE426. Na NPU deste portátil não o consegue fazer de todo.
Em vez disso, o esforço foi para o Fisher-Price OS (Windows), e para o Copilot. A AMD lançou a geração deste chip como processadores que «Unlock Transformational AI Experiences for Windows Copilot+ PCs»27. Quase ninguém aderiu. As máquinas Copilot+ foram 2,3% dos PCs Fisher-Price OS (Windows) vendidos no primeiro trimestre de 2025, e as funcionalidades Copilot mais recentes da Microsoft correm na nuvem de qualquer forma: «only one of its new AI capabilities actually requires an NPU»28. A Microsoft também reporta o que ganha com os fabricantes de PCs a cair 7% devido a «lower PC market demand», com «roughly 30% of the installed base still on Windows 10»29. Portanto a NPU foi apontada a um sistema operativo que as pessoas não estão a atualizar, para correr um assistente que não pediram, que na maior parte não usa a NPU.
Também não é onde a IA é construída. As pessoas que fazem isto para ganhar a vida correm Linux, porque é lá que as suas ferramentas correm. O TensorFlow diz claramente que a 2.10 «was the last TensorFlow release that supported GPU on native-Windows»30. O servidor de modelos vLLM «does not support Windows natively»31. O JAX lista a sua compilação para Fisher-Price OS (Windows) como experimental, e o seu suporte AMD como «AMD GPU (Linux)»32. Onde o Fisher-Price OS (Windows) corre de facto estas ferramentas, é através do WSL 2, que pela própria descrição da Microsoft é «an actual Linux kernel inside a managed VM»33. A AMD apontou o seu chip de IA ao único desktop que a profissão de IA não usa. Suportar isso em parte não chega, AMD.
Depois a AMD vende-se aos investidores como uma empresa de IA. A 11 de novembro de 2025, a sua presidente e CEO disse que a AMD «is uniquely positioned to lead the next generation of high-performance and AI computing», num comunicado que se gaba de ter feito crescer o seu «AI PC portfolio 2.5x since 2024» e termina com «full-stack AI solutions»34. Full stack. No PC de IA deste artigo, o topo dessa pilha veio de um projeto que a AMD não começou, e na primeira geração nunca chegou. Uma empresa de IA cujo próprio chip de IA esperou três anos para correr IA no sistema operativo sobre o qual o seu negócio de centro de dados está construído? Ridículo.
O suporte de primeira classe é simples de descrever. Funciona no dia em que compras a máquina, no sistema operativo que corres, vindo da empresa que te vendeu o chip. Esta NPU ainda não chegou lá. Comprei o portátil pelo resto e a NPU veio por arrasto, que é a única razão pela qual isto é um artigo e não uma reclamação. Quem comprou um pela IA do emblema, e corre Linux, comprou uma promessa que foi cumprida tarde, e por outra pessoa.
Sê dono do silício que pagaste
A NPU veio com o portátil. Da forma como é vendida, é a parte que torna a máquina pronta para a IA, e a IA em oferta é a de outra pessoa, no centro de dados de outra pessoa, a ler o que escreves para poder ser paga de outra forma. Nada no hardware precisa desse arranjo. Um modelo 4B a 21 W responde a uma pergunta, lê uma colagem de 175 000 palavras se lhe deres tempo, e escreve o que dizes, e nada disso sai da secretária.
Software acabado não é, e cada aresta por limar acima custou uma hora a encontrar e uma ou duas linhas a corrigir. É isso que o open source custa quando o corres a sério. Continua a ser melhor negócio do que alugar de volta a mesma capacidade, e a hora compra-te saber como funciona.
Os contentores mantêm-no honesto. Nada no host além de um módulo de kernel e o seu firmware, um dispositivo passado a um contentor, um endereço a que mais ninguém chega, e uma verificação que falha no momento em que as peças deixam de corresponder. Levou um dia. Vai continuar a funcionar, porque sei porque é que cada linha lá está e a verificação vai dizer-me na manhã em que uma delas deixar de ser verdade.
AMD — Ryzen AI 7 PRO 350 — 8 núcleos, 16 threads, Radeon 860M, «NPU TOPS: Up to 50 TOPS», data de lançamento «3/27/2025». ↩︎ ↩︎ ↩︎
Lemonade — LLMs on Linux with FastFlowLM — só XDNA2 (Ryzen AI 300/400, Strix Halo), não XDNA1; firmware da NPU 1.1.0.0 ou posterior; não definir
amd_iommu=off. ↩︎ ↩︎ ↩︎ ↩︎Linux kernel documentation — amdxdna — o driver de acelerador na árvore para as NPUs da AMD. ↩︎
amd/xdna-driver — driver, submódulo XRT e plugin; compilar o pacote base do XRT a partir do submódulo incluído para que funcione com o plugin; repositório criado a 25 de janeiro de 2024. ↩︎ ↩︎
Linux v7.3 — drivers/accel/amdxdna/amdxdna_pci_drv.c —
AMDXDNA_DRIVER_MAJOR 0,AMDXDNA_DRIVER_MINOR 10; o mesmo na v7.2. ↩︎ROCm/FastFlowLM — runtime de LLM na NPU para XDNA2, servidor compatível com OpenAI, parte do ROCm desde a v1.0.0; a versão usada aqui é a v1.0.12. ↩︎ ↩︎
FastFlowLM — LICENSE_BINARY.txt — termos para os binários de kernels da NPU incluídos. ↩︎
RPM 6.0.0 release notes — «RPM defaults to enforcing signature checking». ↩︎
podman-systemd.unit(5) — unidades Quadlet
.container, incluindoAddDevice=,Ulimit=,StopSignal=eExec=. ↩︎loginctl(1) —
enable-lingerinicia um gestor de utilizador no arranque e mantém-no a correr depois do fim de sessão. ↩︎Qwen/Qwen3.5-4B — «Context Length: 262,144 natively»; camadas híbridas Gated DeltaNet e de atenção com gating. ↩︎
ggml-org/llama.cpp — a imagem de contentor
server-vulkanusada nas execuções na GPU, build 12352. ↩︎mlc-ai/mlc-llm — testado com os pacotes nightly 0.26. ↩︎
openai/whisper-large-v3-turbo — «a state-of-the-art model for automatic speech recognition (ASR) and speech translation»; podado a partir do large-v3, «the number of decoding layers have reduced from 32 to 4»; 809M parâmetros; licença MIT. ↩︎
open-webui/open-webui — versão v0.13.3 usada aqui. ↩︎
Qwen/Qwen2.5-7B-Instruct — tokenizer_config.json — a mensagem de sistema predefinida do template de chat: «You are Qwen, created by Alibaba Cloud. You are a helpful assistant.» ↩︎
Qwen/Qwen3-4B — tokenizer_config.json — template de chat sem mensagem de sistema predefinida. ↩︎
Qwen/Qwen3.5-4B — tokenizer_config.json — template de chat sem mensagem de sistema predefinida. ↩︎
AMD — AMD Highlights Future of High-Performance and Adaptive Computing During Opening Keynote of CES 2023 — 4 de janeiro de 2023: «AMD also unveiled Ryzen AI Technology – the first dedicated artificial intelligence hardware in an x86 processor.» ↩︎
Kernel Newbies — Linux 6.14 — lançado na segunda-feira, 24 de março de 2025; «an amdxdna driver for AMD NPUs». ↩︎
FastFlowLM v0.9.35 release notes — 11 de março de 2026: «The wait is finally over… FastFlowLM is officially available natively on Linux!» ↩︎ ↩︎
AMD — Ryzen AI Software release notes — problemas conhecidos: «Model generation is not supported on Linux in this release.» ↩︎
TOP500 — June 2026 — «LineShine debuts as the new No. 1 system, ending El Capitan’s run atop the list»; o El Capitan «is based on AMD 4th generation EPYC processors… and AMD Instinct MI300A accelerators». ↩︎
LLNL — TOSS: Speeding Up Commodity Cluster Computing — «a fully functional cluster operating system, based on Red Hat Linux». ↩︎
AMD — Alveo V70 — «the first Alveo production card leveraging AMD XDNA architecture with AI Engines… designed for AI inference efficiency». ↩︎
Linux — accel/amdxdna: Add basic support for AIE4 devices — «Add initial support for AIE4 devices (PCI device IDs 0x17F2 and 0x1B0B), including… SR-IOV enablement». A tabela do driver dá entradas de funções virtuais apenas a essas peças; a NPU deste portátil é a
17f0. ↩︎AMD — AMD Unveils Next-Gen “Zen 5” Ryzen Processors to Power Advanced AI Experiences — Computex, 2 de junho de 2024: «AMD Ryzen AI 300 Series Processors Unlock Transformational AI Experiences for Windows Copilot+ PCs». ↩︎
Engadget — Microsoft’s Copilot+ AI PC plan fizzled, but it still served a purpose — 5 de dezembro de 2025: os sistemas Copilot+ «made up just 2.3 percent of Windows machines sold in the first quarter of 2025»; «only one of its new AI capabilities actually requires an NPU». ↩︎
Windows Latest — Microsoft admits its end of support was the real Windows 11 sales driver — 31 de julho de 2026, citando a apresentação de resultados da Microsoft: «Windows OEM and Devices revenue decreased 7%… driven by lower PC market demand»; «roughly 30% of the installed base still on Windows 10». ↩︎
TensorFlow — Install TensorFlow with pip — «TensorFlow 2.10 was the last TensorFlow release that supported GPU on native-Windows.» ↩︎
vLLM — GPU installation — «vLLM does not support Windows natively». ↩︎
JAX — Installation — wheels de CPU para «Windows, x86_64 (experimental)»; secções de GPU para NVIDIA, Google Cloud TPU, Mac e «AMD GPU (Linux)». ↩︎
Microsoft — Comparing WSL versions — «the use of an actual Linux kernel inside a managed VM». ↩︎
AMD — AMD Unveils Strategy to Lead the $1 Trillion Compute Market and Accelerate Next Phase of Growth — Financial Analyst Day, 11 de novembro de 2025: «AMD is uniquely positioned to lead the next generation of high-performance and AI computing»; «AMD has expanded its AI PC portfolio 2.5x since 2024»; «AMD delivers full-stack AI solutions». ↩︎