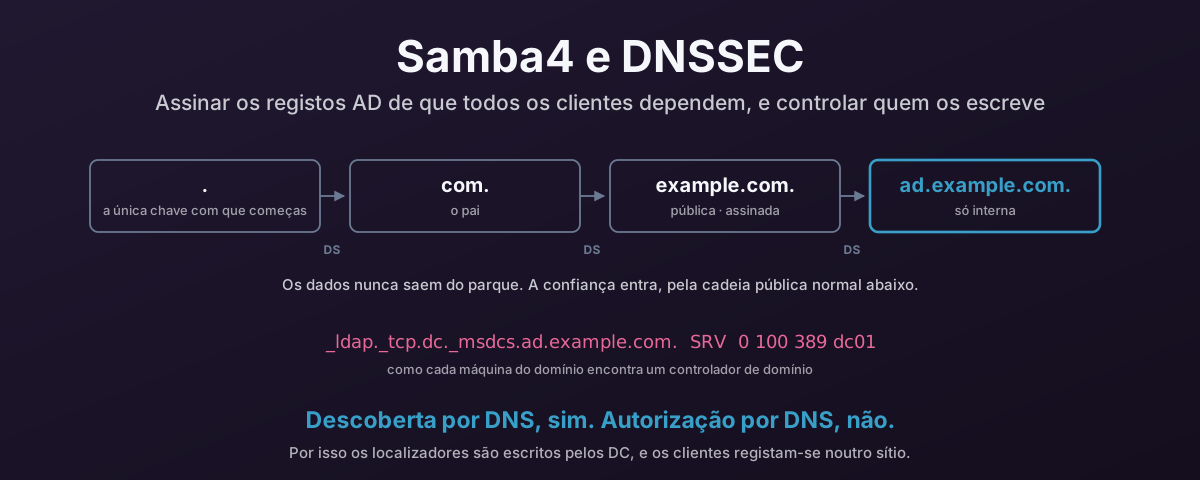
Todas as máquinas de um domínio Active Directory encontram o seu controlador de domínio perguntando ao DNS. Não a partir de uma lista configurada. Pede um registo SRV e vai para onde a resposta a mandar. O que faz de um punhado de registos debaixo de _msdcs a coisa mais crítica para a segurança de toda a zona, e levanta duas perguntas que merecem resposta a sério: como os assinas, e quem tem permissão para os escrever. Nenhuma das duas é feita muitas vezes, e ambas recebem, por omissão, uma má resposta.
Este artigo responde às duas para um controlador de domínio Samba4. BIND com dlz_bind9 a servir o diretório, inline signing, um primário oculto que nenhum cliente alguma vez alcança, uma delegação dentro de uma zona pública para que a cadeia de confiança chegue à raiz, e as atualizações dinâmicas dos clientes mantidas bem longe dos localizadores.
Mas a assinatura só vale alguma coisa se souberes o que protege, e isso obriga a começar um nível abaixo: em como um nome chega sequer a ser resolvido. Por isso o primeiro terço disto é a descida a partir da raiz. Se já sabes isso de cor, salta para os dois backends DNS do Samba.
Um resolver começa a saber quase nada
Vale a pena ter claro o pouco com que um resolver nasce, porque tudo o resto neste artigo decorre disso.
Um resolver recursivo acabado de instalar sabe duas coisas. Sabe os endereços dos servidores raiz: um ficheiro de hints, treze nomes de a.root-servers.net a m.root-servers.net, servidos por anycast a partir de muitas mais instâncias do que treze. E, se validar, conhece uma chave pública: a da raiz.
É toda a configuração de origem. Todos os outros factos que alguma vez vai servir (que servidores têm autoridade sobre uk, onde vive o teu domínio, que endereço tem o teu servidor de correio) são aprendidos em tempo de execução, perguntando, e depois ficam em cache até o TTL expirar.
É um bom desenho. Ninguém tem de distribuir uma lista dos servidores de nomes da internet, e nenhuma entidade central tem de aprovar uma alteração à tua zona. Mas tem uma consequência, e é dela que trata o resto deste artigo: um resolver acredita no que lhe dizem, seja qual for o servidor para onde a resposta anterior o apontou. Tira as assinaturas e a estrutura inteira é uma cadeia de afirmações, cada uma autenticada apenas pelo facto de ter chegado do endereço que a resposta anterior indicou. É muito peso para pendurar num endereço de remetente.
A descida pela árvore
Uma consulta não é uma pergunta. É uma série de referências pela árvore de nomes abaixo, e cada passo é uma consulta separada a um servidor diferente.
Imagina que um cliente quer dc01.ad.example.co.uk. Um resolver com a cache fria faz isto:
- Pergunta a um servidor raiz. A raiz não sabe a resposta e não finge saber. Devolve uma referência: uma secção de resposta vazia e, na secção de autoridade, os registos
NSdeuk, com os endereços desses servidores de nomes como glue na secção adicional. - Pergunta a um servidor de
uk. Outra referência, desta vez para os servidores de nomes deexample.co.uk. - Pergunta a um servidor de
example.co.uk. Sead.example.co.ukestiver delegado (e no desenho mais adiante neste artigo está), mais uma referência. - Pergunta a um servidor de
ad.example.co.uk. Este tem autoridade sobre o nome, por isso responde com o registoAe liga o bit AA (authoritative answer, resposta com autoridade).
Três coisas nessa descida importam mais tarde.
A referência é a delegação. O pai de uma zona não guarda o conteúdo dela. Guarda registos NS que dizem «pergunta ali» e, quando a assinatura entra em cena, um registo DS que diz «e aqui está a impressão digital da chave que deves esperar quando o fizeres». A delegação é o único mecanismo estrutural que o DNS tem, e é ela que vais usar para manter interna uma zona interna.
Quase tudo isto fica em cache. As referências da raiz e do TLD têm TTL longos, por isso um resolver quente salta diretamente para o passo três ou quatro. É por isso que vale a pena atacar a cache de um resolver: envenena uma entrada e redirecionaste tudo o que está debaixo dela durante o TTL que escolheste.
O nome completo não é enviado a todos os servidores. Com a minimização do QNAME, um resolver pergunta à raiz apenas por uk, não por dc01.ad.example.co.uk. Convém saber, se alguma vez fores procurar os teus nomes internos num registo de consultas a montante. Não deviam lá estar.
Stub, recursivo, autoritativo
Três palavras usadas como se fossem sinónimos e que designam trabalhos bem diferentes. A distinção sustenta a metade Active Directory deste artigo, por isso vale a pena fixá-la.
| O que faz | Percorre a árvore? | Guarda dados de zona? | |
|---|---|---|---|
| Resolver stub | A biblioteca ou o serviço local que as tuas aplicações chamam. Pergunta a um servidor configurado e aceita a resposta. | Não | Não |
| Forwarder | Passa as consultas a outro resolver e guarda as respostas em cache. | Não | Não |
| Resolver recursivo | Faz a descida acima, guarda cada passo em cache, valida opcionalmente as assinaturas. | Sim | Não |
| Servidor autoritativo | Responde pelas zonas que lhe foram dadas, e só por essas. Diz «não sei» sobre tudo o resto. | Não | Sim |
A linha importante é a última. Um servidor autoritativo não tem nada que fazer recursão, e um resolver recursivo não tem nada que ser autoritativo. Juntá-los é a forma de obter uma máquina que tanto aceita perguntas arbitrárias dos clientes como guarda dados de que esses clientes dependem, que é exatamente a máquina que não queres que o teu controlador de domínio seja.
Num desktop Linux moderno há mais uma camada de que convém estar ciente. O systemd-resolved corre um listener stub no endereço de loopback e escreve um resolv.conf a apontar para si próprio, com options edns0 trust-ad. É nesse trust-ad que deves reparar: diz ao stub para acreditar no bit AD (authenticated data, dados autenticados) nas respostas desse servidor. O bit AD sozinho não prova nada; é a afirmação do resolver a montante de que ele validou. Confiar nele é razoável quando o servidor a montante é teu e o salto até ele é de confiança, e não significa nada no resto dos casos.
Como os serviços são realmente encontrados
Um registo A responde a uma pergunta: que endereço tem este nome. Não diz nada sobre em que porta está o serviço, qual de vários servidores preferir, ou o que fazer quando o primeiro está em baixo.
Os registos SRV respondem às três. Segundo o RFC 2782, a forma é:
_service._proto.name. TTL IN SRV priority weight port target
Cada campo justifica o seu lugar:
- Os prefixos com underscore mantêm as etiquetas de serviço num espaço de nomes próprio.
_tcpnunca pode colidir com um host que se chame mesmotcp, porque um nome de host não pode começar por underscore. - A prioridade é a ordem de failover: o valor mais baixo é tentado primeiro. Os servidores com um número de prioridade mais alto só são usados quando tudo o que está abaixo está inalcançável.
- O peso reparte a carga dentro de uma prioridade. Um par com peso 100 e peso 300 recebe aproximadamente um quarto e três quartos dos clientes. É um sorteio proporcional, não round-robin.
- A porta liberta o serviço de um número bem conhecido, que é como um cliente encontra um servidor LDAP na 3268 sem que ninguém a tenha escrito à mão no código.
- O alvo tem de ser um nome com registos
AouAAAA. O RFC 2782 é explícito: não pode ser um CNAME, e um único alvo.significa «este serviço não é oferecido aqui, de propósito», o que é útil publicar deliberadamente.
É isto que torna um domínio localizável em vez de configurado. Uma máquina associada ao domínio não tem uma lista dos teus controladores de domínio. Tem um nome de domínio, e pergunta.
Os nomes que o Active Directory publica
Um domínio AD é, do ponto de vista de um cliente, sobretudo um conjunto de registos SRV. A árvore debaixo de _msdcs é a parte interessante, porque é assim que os clientes distinguem «um servidor LDAP» de «um controlador de domínio para este domínio» de «um catálogo global para esta floresta»:
| Nome | Quem o pede |
|---|---|
_ldap._tcp.<domain> | Tudo o que queira LDAP no domínio |
_ldap._tcp.dc._msdcs.<domain> | Localização do controlador de domínio: o mais importante |
_ldap._tcp.pdc._msdcs.<domain> | Especificamente o emulador PDC |
_ldap._tcp.gc._msdcs.<forest> | Catálogo global |
_kerberos._tcp.<domain>, _kerberos._udp.<domain> | Localização do KDC, antes de existir qualquer ticket |
_kpasswd._tcp.<domain>, _kpasswd._udp.<domain> | Mudanças de palavra-passe |
_ldap._tcp.<site>._sites.dc._msdcs.<domain> | Localização por site: encontrar um DC que esteja perto |
Repara para que serve essa lista. A autenticação Kerberos não pode começar enquanto o cliente não encontrar um KDC, e encontra o KDC pelo DNS. A localização por site significa que a resposta também decide contra que centro de dados um cliente se autentica.
A mesma ideia, modernizada
O SRV tem um sucessor que vale a pena conhecer. Os registos SVCB e HTTPS (RFC 9460) generalizam o padrão: parâmetros de serviço no DNS, incluindo ALPN, porta e sugestões de endereço, num só registo. É assim que um browser aprende a ir diretamente para HTTP/3 sem redirecionamento. O registo HTTPS já está amplamente implementado. O mecanismo é, no espírito, o mesmo do SRV: é o DNS que diz ao cliente como chegar ao serviço. O que significa que o argumento da secção seguinte se aplica a ele exatamente da mesma forma.
Tudo o que vem depois da consulta confia na consulta
Eis o ponto de viragem, e é a razão de um artigo sobre DNS ter uma secção de segurança e não o contrário.
Uma máquina associada ao domínio arranca e pergunta onde está um controlador de domínio. Recebe um nome e uma porta. Liga-se lá e só então começa a fazer todas as coisas que normalmente consideramos a camada de segurança: Kerberos, assinatura LDAP, channel binding, validação de certificados.
E então, o que acontece se a resposta for mentira?
Convém ser justo aqui, porque a resposta não é «catástrofe imediata». O Kerberos foi desenhado com autenticação mútua precisamente para que um cliente não fique à mercê da sua consulta de nomes: um host que não consegue apresentar um ticket de serviço para o nome que o cliente pediu não consegue completar a troca. Recebe uma resposta SRV que aponta para uma máquina sem chave no domínio e, num cliente configurado com rigor, falha.
O dano realista é mais subtil, e está todo nas brechas à volta disso:
- Downgrade. Um cliente que recua para NTLM quando o Kerberos não funciona acabou de ser entregue a quem respondeu.
- Relay e coerção. O atacante não precisa de ser o DC. Ser o nome a que um cliente se liga basta para começar a reencaminhar essa autenticação para um sítio onde ela seja útil.
- Negação de serviço com cara de avaria. Aponta
_ldap._tcp.dc._msdcspara algo que não responde e o domínio fica intermitentemente avariado de uma forma que ninguém diagnostica como DNS durante um bom bocado. - Tudo o que não tem autenticação mútua nenhuma. Sincronização de hora, syslog, monitorização, agentes de backup, aquela coisa HTTP interna com
verify=False. Muitos parques têm mais disto do que gostariam de admitir.
O princípio geral é o que vale a pena levar daqui: o DNS é um mecanismo de descoberta, não um mecanismo de autorização. É perfeitamente razoável encontrar um serviço pelo nome. Não é razoável conceder seja o que for com base num nome, e o número de sistemas que o fazem discretamente (listas de permissões baseadas em PTR, ACL por nome de host, «está na rede interna, por isso tem de ser nosso») é a verdadeira superfície de ataque.
O que o DNSSEC resolve, e o que não resolve
O DNSSEC existe para responder a uma pergunta: esta resposta veio mesmo da zona dona do nome, sem alterações?
Funciona (RFC 4033 e os dois que se lhe seguem) por assinatura, e encadeando as assinaturas até algo em que já confias:
- Cada RRset numa zona assinada tem um
RRSIG: uma assinatura sobre esse conjunto. - As chaves públicas da zona são publicadas como
DNSKEY. - A zona pai publica um registo
DS: um hash da chave do filho. - Esse
DSé, por sua vez, assinado pelo pai, cuja chave tem o hash noDSdo pai dele, e assim por diante até à raiz; e a chave da raiz é a única coisa que o teu resolver já sabia ao nascer.
A negação também é assinada, o que é fácil de esquecer e importa mais do que parece. Sem isso, «esse nome não existe» é uma resposta não autenticada que um atacante pode forjar para fazer algo desaparecer. O NSEC e o NSEC3 dão um «não existe nada entre estes dois nomes» autenticado.
É uma solução real para um problema real. O envenenamento de cache não é teórico: o ataque de Kaminsky tornou o spoofing fora do caminho tão barato que obrigou a aplicar patches de emergência em toda a internet, e as mitigações que se seguiram (aleatorização da porta de origem, mistura de maiúsculas 0x20) são todas tentativas de tornar a adivinhação mais difícil, não de tornar as respostas verificáveis. O trabalho com canais laterais desde então tem-nas corroído repetidamente. As assinaturas são a única coisa dessa lista que muda as regras do jogo em vez de subir o preço.
Agora os limites honestos, porque o DNSSEC é vendido em excesso nos dois sentidos.
Não é confidencialidade. Assinar é autenticação por chave pública; todas as consultas e respostas continuam em texto claro na rede. A privacidade no salto do cliente é o DoT, o DoH ou o DoQ, e esses são um mecanismo diferente a resolver um problema diferente. Cifrar o salto até um resolver que não valida compra-te uma conversa privada com algo a quem ainda se pode mentir.
Não valida o significado, só a origem. O DNSSEC prova que o dono da zona publicou isto. Se o registo estiver errado, ou for malicioso, ou tiver sido escrito por alguém a quem a zona imprudentemente permitiu escrevê-lo, a assinatura é aplicada a isso com a mesma fidelidade. Assinar uma zona que máquinas sem confiança podem escrever não torna o conteúdo fiável: autentica a mentira. Guarda esta frase; o último terço deste artigo é, no essencial, a consequência dela.
Só ajuda se alguém validar. Se o teu resolver não valida, as assinaturas nas zonas que consultas são decoração. E se a validação acontecer num resolver do outro lado da rede em relação ao cliente, o cliente está a confiar no bit AD e no caminho: vê o trust-ad acima.
E precisa de ser operado. Uma assinatura expirada não é uma resposta degradada, é SERVFAIL: o nome apaga-se. Um DS no pai que já não corresponde à chave do filho faz o mesmo. É o custo honesto e, como tal, a automação das secções seguintes importa mais do que a assinatura inicial.
Porque é que um TLD interno inventado não pode ser assinado
É aqui que decisões de nomes tomadas há anos regressam com a fatura, e vale a pena explicar isto bem, porque é a razão de o desenho deste artigo usar um domínio real, de que és dono, para os nomes internos.
Olha outra vez para como a cadeia é construída: a chave de uma zona é garantida por um registo DS no seu pai. Por isso, um resolver validador só consegue autenticar uma zona interna se essa zona tiver um pai disposto e capaz de publicar um DS para ela.
ad.corp.local não tem esse pai. Nem .lan, .home, nem qualquer outra coisa inventada no dia em que o domínio foi criado:
.localestá reservado para o mDNS. Usá-lo para DNS unicast não é só ficar sem assinatura, é uma colisão documentada com o comportamento a que todos os sistemas operativos do edifício têm direito. Tem uma secção própria mais abaixo, porque joga num campeonato diferente dos outros três..lan,.corp,.homesão cadeias de caracteres não registadas. Não há pai para guardar umDS, e as versões candidatadas ficaram retidas sem delegação por causa da confusão de colisão de nomes em parques privados.home.arpaestá devidamente reservado para redes domésticas, o que parece ideal, mas a sua delegação é deliberadamente insegura. Não há caminho assinado até ele, por desenho..internalfoi reservado pela ICANN exatamente para este uso, e resolve o problema da colisão. Não resolve este: sem delegação não háDS, logo não há cadeia.
As tuas opções com uma zona interna sem cadeia são deixá-la sem assinatura, ou configurar uma âncora de confiança local em todos os resolvers validadores do parque e tornares-te a raiz da tua própria ilha privada: uma chave que agora tens de distribuir, monitorizar e rodar à mão, em todos os resolvers, para sempre, com SERVFAIL em todo o domínio como modo de falha.
Há uma resposta muito mais fácil, e é gratuita: faz da zona interna uma delegação dentro de uma zona pública de que já és dono e que já assinas. ad.example.com, delegada a partir de example.com. O DS vai para o pai público. Todos os resolvers validadores do parque passam então a autenticar os nomes internos com a âncora de confiança que já têm, e não distribuis nada.
O conteúdo fica dentro. Só a confiança vem de fora. Essa distinção é o desenho do resto deste artigo.
.local não é uma questão de estilo
Um desses quatro merece secção própria, porque é o que as pessoas defendem, e porque a defesa é sempre a mesma: funciona, usamo-lo há anos, qual é o problema.
O problema é que .local não é uma cadeia não registada que alguém possa um dia vender. É um espaço de nomes que já tem dono e um comportamento definido, e esse comportamento não é «perguntar ao servidor DNS». O RFC 6762 §3 não é meigo:
Any DNS query for a name ending with “.local.” MUST be sent to the mDNS IPv4 link-local multicast address 224.0.0.251 (or its IPv6 equivalent FF02::FB).
Lê o que esse MUST realmente rege. Não é uma afirmação sobre quem é dono da cadeia. É uma instrução sobre para onde vai a consulta, e a resposta é um grupo multicast na ligação local, não o teu controlador de domínio. A mesma secção diz que os nomes debaixo de .local são «meaningful only on the link where they originate», o equivalente DNS de um endereço 169.254.
Portanto, um cliente que siga a especificação corretamente nunca vai perguntar ao teu servidor DNS por um nome .local. Grita na rede e aceita o que responder.
Isso produz um conjunto de falhas com um sabor muito particular:
- A resolução depende do cliente, não do teu DNS. O macOS resolve
.localatravés do Bonjour e sempre o fez; osystemd-resolvedencaminha o domíniolocalpara mDNS por omissão; o Windows faz mDNS desde o Windows 10. Três pilhas, três conjuntos de regras, e nenhuma delas consulta o teu ficheiro de zona. - Para no primeiro router. O mDNS é link-local por desenho. Um nome que resolve numa secretária na mesma VLAN não resolve a partir de outro piso, de outro site ou da VPN: é o pedido de suporte «funciona no escritório, falha em casa» que é fechado quatro vezes como «problema de rede» antes de alguém ler a especificação.
- O comportamento muda debaixo dos teus pés. Se uma dada máquina tenta primeiro multicast, primeiro unicast, ou ambos em paralelo, depende da pilha do resolver e da sua versão. Os parques que correram em
.local«sem problemas durante anos» costumam ser parques onde uma atualização da distribuição ainda não mudou a ordem. - As provas não estão onde as procuras. O registo de consultas do DC não mostra nada, porque nada chegou. As pessoas passam dias no servidor, e a consulta nunca saiu do cliente.
- E não pode ser assinado, que é o ponto desta secção. Sem pai, sem
DS, sem cadeia, sem forma de publicar um.
Agora põe isso debaixo de um domínio Active Directory. O realm deriva do nome do domínio. Os service principals derivam do realm. Os localizadores _msdcs (os registos de que trata este artigo inteiro) ficam debaixo de um sufixo que um cliente conforme é obrigado a resolver aos gritos no segmento local. Estás a construir Kerberos em cima de um espaço de nomes que metade do teu parque resolve com um protocolo desenhado para encontrar impressoras.
E a saída é cara, e é isso que torna a decisão original digna de ser encarada sem sentimentalismos. Não há renomeação no local no Samba. O caminho documentado é samba-tool domain backup rename seguido de uma restauração: tiras uma cópia renomeada da base de dados, semeias um novo DC a partir dela e voltas a juntar todos os outros DC do zero, sem sobreposição permitida entre DC com o nome antigo e com o nome novo. Não é o rendom do Windows, que pelo menos percorre os DC um de cada vez. É uma reconstrução com um nome mais bonito.
Portanto, o resumo honesto. .local para um domínio unicast não é uma preferência, uma convenção, nem um bocado inofensivo de legado. É um conflito documentado com um protocolo que vem ativo em todos os sistemas operativos do edifício, e a fatura chega anos depois sob a forma de falhas de resolução intermitentes e impossíveis de reproduzir e, quando finalmente quiseres assinar a zona, de uma reconstrução do domínio.
O mesmo erro, com outro chapéu
Já que aqui estamos: porta 5353.
O mDNS escuta em UDP 5353, e não é uma porta sobresselente que por acaso está livre. Pôr um serviço DNS unicast normal nela, ou apontar resolvers para :5353 porque a 53 estava ocupada ou precisava de root, faz o mesmo estrago na direção oposta: todas as máquinas com mDNS nesse segmento estão agora a falar com o teu serviço de nomes, e o teu serviço de nomes está agora a receber descoberta de serviços multicast a que nunca devia responder. O nome e a porta são as duas metades de um mesmo espaço de nomes, e ambas já pertencem a outra pessoa.
.local na 53, ou DNS unicast na 5353. O mesmo mal-entendido, a mesma classe de falha intermitente, as mesmas semanas do tempo de outra pessoa.
E sê honesto sobre o que isso te diz
A Microsoft recomendou .local na era do Small Business Server, e é por isso que tantos parques ainda o arrastam, e deixou de o recomendar há muito tempo. Herdar um domínio .local é azar. A maioria das pessoas que estão a ler isto e têm um não o escolheu, e a secção acima é um plano de migração, não uma acusação.
Implementar um é uma questão completamente diferente, e vou ser direto sobre isso, porque suavizá-lo não ajudou ninguém.
Quem implementa .local para Active Directory ou para DNS unicast normal, ou põe um serviço DNS na porta 5353, não é um profissional de TI. Pode ter o título do cargo. Não está a fazer o trabalho. O RFC 6762 está publicado desde 2013, lê-se em vinte minutos, e a frase que arruma a questão inteira está na secção 3. Construir o serviço de nomes de uma empresa num espaço de nomes que a especificação reserva para multicast link-local não é uma decisão de engenharia defensável. É alguém a adivinhar na única parte da pilha em que adivinhar produz falhas que ninguém consegue reproduzir e de que todos culpam a rede.
Essa pessoa deve ser afastada do teu departamento de TI. Não transferida para o lado, não posta a tratar do DNS sob supervisão. Afastada da função. O cargo existe para saber que pacote vai para onde e com que autoridade. Quem não leu o documento que rege o espaço de nomes que escolheu para todas as máquinas do edifício não está a desempenhar esse cargo, e mantê-la lá significa que a próxima decisão deste tamanho vai ser tomada da mesma maneira.
E todos os sistemas em que mexeu devem ser auditados. É a parte que as pessoas saltam, e é a que mais importa. Uma decisão destas nunca é isolada. Quem não verificou o RFC 6762 antes de dar nome ao domínio também não verificou mais nada; por isso vai ver o que mais construiu. Conta encontrar:
- Servidores DNS abertos ao mundo, forwarders a responder a quem quer que pergunte, e nenhuma ACL em lado nenhum.
- Atualização dinâmica escancarada, e contentores de zona com permissões que ninguém revê desde que o domínio foi criado.
- Certificados e Kerberos construídos em cima de nomes que nunca iam resolver de forma consistente, com as falhas tapadas por ficheiros hosts.
- Ficheiros hosts. Por todo o lado. Parques inteiros foram mantidos de pé por eles, precisamente porque o
.localnunca funcionou bem e alguém encontrou um remendo em vez de uma causa. - Regras de firewall e contas de serviço criadas para fazer desaparecer os sintomas, ainda lá, ainda a conceder mais do que alguém hoje se lembra.
Isto não é vingança. É para isso que serve um sinal de competência. Quando encontras uma decisão tomada sem ler a especificação, a resposta correta é assumir que as restantes foram tomadas da mesma maneira e ir verificar, porque a mesma pessoa configurou a tua autenticação, os teus certificados e o teu controlo de acessos, e tu tens agora prova direta de como aborda um problema que não compreende por completo.
Herdar esta confusão custa-te uma migração. Empregar a pessoa que continua a criá-la custa-te bastante mais.
Os dois backends DNS do Samba
Um controlador de domínio Samba AD guarda os seus dados DNS no próprio diretório, e há duas maneiras de os servir.
SAMBA_INTERNAL é o servidor DNS do próprio Samba, embutido no AD DC. Trata das zonas AD e das atualizações dinâmicas autenticadas por Kerberos, e entrega tudo o resto a um forwarder. O Samba descreve-o como suportando «the basic feature required in an AD» e recomenda-o «for simple DNS setups», o que é justo e vale a pena ler à letra. Tem uma secção própria mais abaixo, porque o que ele não faz é mais longo e mais interessante do que o que faz.
BIND9_DLZ corre o BIND como servidor DNS, com o módulo dlz_bind9 do Samba carregado nele. DLZ (Dynamically Loadable Zones) é uma interface do BIND para suportar uma zona com algo que não seja um ficheiro de zona. O módulo responde às consultas do BIND diretamente a partir de sam.ldb, por isso não há cópia, não há passo de exportação e não há sincronização que possa correr mal: o BIND está a ler o diretório enquanto serve.
O servidor DNS interno não faz recursão: não consegue
Começa pela coisa que é quase sempre mal descrita, inclusive por quem o corre.
«O DC é o nosso servidor DNS, faz recursão para os clientes» não é o que está a acontecer, porque o servidor DNS interno não consegue fazer recursão de todo. A própria lista de funcionalidades do Samba di-lo sem rodeios. O DNS interno não suporta:
- funcionar como resolver com cache
- consultas recursivas (mas pode reencaminhar para outro servidor de nomes DNS recursivo)
- assinatura de transações com chave partilhada (TSIG)
- zonas stub
- transferências de zona
- balanceamento de carga Round Robin entre DC
com o scavenging e os forwarders condicionais também listados como não implementados.
Lê os dois primeiros juntos, porque é a história toda. Não consegue resolver, e não consegue guardar em cache. O que o dns forwarder te compra na realidade é um relay: um cliente pergunta ao DC por windowsupdate.com, o DC pergunta a um resolver a sério, a resposta volta através do DC, e depois o DC esquece-a por completo. O cliente seguinte faz a mesma pergunta e tudo acontece outra vez.
Volta à tabela mais acima neste artigo e repara no que isto é: um forwarder sem a cache do forwarder. Tem os custos do papel (um salto extra, uma dependência, mais uma coisa que pode estar em baixo) e nenhum dos benefícios.
Por isso, um DC com SAMBA_INTERNAL a servir o parque não é um servidor DNS no sentido em que as pessoas o entendem. É um proxy sem cache para um resolver a sério, e puseste-o na máquina que guarda o teu diretório.
Porque é que isso é um risco e não apenas uma ineficiência
A ineficiência é fácil de ver: todas as consultas externas do edifício passam a ser uma ida e volta pelo AD DC, permanentemente, sem cache para amortecer. Num domínio sossegado ninguém dá por isso. É exatamente por isso que sobrevive.
O argumento de segurança é o que vale a pena fazer, e tem três partes.
O listener está no processo errado. O DNS interno é uma tarefa de serviço do próprio AD DC, a correr com os privilégios do diretório, e não um daemon separado sob a sua própria conta como é o named. Por isso, aquilo que analisa UDP não autenticado vindo de tudo o que consiga chegar à porta 53 está a correr dentro do processo que serve LDAP e Kerberos e é dono de sam.ldb. O BIND tem trinta anos de atenção hostil, um utilizador dedicado e o hábito de correr numa jail, precisamente porque um listener DNS é um bairro mal frequentado. O servidor interno do Samba é uma funcionalidade de conveniência que por acaso vive nas joias da coroa.
Servir clientes significa estar ao alcance dos clientes. Para ser o servidor DNS do parque, tem de aceitar consultas de todas as estações de trabalho, todas as impressoras, todos os portáteis de prestadores de serviços na VLAN de convidados que alguém ligou em ponte por engano. É uma superfície de ataque grande, permanentemente aberta e não autenticada no host mais valioso que tens, e estás a corrê-la para poupar o custo de um resolver que um Raspberry Pi conseguiria alojar.
E um forwarder aberto ao mundo é a arma de outra pessoa. Um DC que reencaminha para quem quer que pergunte é um forwarder aberto. Quando fica alcançável de fora da tua rede, passa a participar em reflexão e amplificação, o que significa que o tráfego e as queixas de abuso chegam ambos ao teu controlador de domínio. Não há limitação de taxa a que recorrer, porque o servidor interno não tem nenhuma.
Nada disto precisa de uma vulnerabilidade do Samba para ser má ideia. É má ideia só pela forma: põe um serviço não autenticado, exposto à internet por acidente e carregado de parsing no mesmo processo que o teu diretório, para fazer um trabalho que está documentado como não sendo capaz de fazer bem.
Vai cair mais cedo, e levar mais coisas consigo
Convém ser claro sobre o que este argumento não é. Não é uma afirmação de que o código DNS do Samba tem mais bugs do que o do BIND. O BIND tem uma longa lista de CVE, sobretudo porque é a implementação de DNS mais escrutinada que existe, e contar avisos de segurança seria uma má forma de escolher entre os dois.
A comparação que importa é estrutural, e resume-se a três perguntas com três respostas desconfortáveis.
Quem lhe pode enviar um pacote malformado? Com SAMBA_INTERNAL a servir o parque: todas as estações de trabalho, todos os telemóveis na rede sem fios, tudo o que consiga encaminhar para a porta 53 dessa máquina. Com o desenho deste artigo: o signer. Um host, uma chave TSIG, allow-query limitado a ele. Não é uma pequena diferença de grau. É a diferença entre um serviço exposto e um que é, na prática, inalcançável, e ofusca qualquer diferença de qualidade de código entre as duas implementações.
O que cai quando ele cai? É esta que decide a gravidade. O named é um daemon separado sob a sua própria conta; quando morre, o DNS para e o controlador de domínio continua a autenticar. O DNS interno do Samba é uma tarefa de serviço dentro do AD DC, por isso tudo o que o encrave, esgote ou rebente está a acontecer dentro do processo que serve LDAP e Kerberos. Um problema de DNS torna-se uma falha do diretório. E systemctl restart named custa um segundo, ao passo que reiniciar um DC é outro tipo de manhã.
O que podes fazer enquanto está a acontecer? O BIND tem response rate limiting, allow-query, allow-recursion, blackhole, política por vista, e a opção de simplesmente não responder a clientes. O servidor interno tem dns forwarder e um ficheiro de log. Quando algo começa a martelá-lo, não há botão para rodar.
Junta-lhe a cache que falta. Cada consulta de cliente é uma nova ida e volta para fora, por isso uma inundação de consultas custa ao DC uma consulta a montante por pacote em vez de um acerto na cache, e custa-lhe isso no mesmo processo que está a tentar emitir tickets Kerberos. Não precisas de um exploit para isso; precisas de uma manhã movimentada, de uma aplicação mal comportada, ou de alguém a apontar um scanner à VLAN errada. Se for sustentado, apresenta-se como autenticação lenta, e ninguém se lembra de olhar para o DNS.
Portanto sim, mesmo com o DLZ no quadro, o BIND é o sítio mais seguro para isto. O módulo DLZ dá de facto ao named acesso aos dados do Samba, e isso é uma consideração real que este artigo já fez questão de sublinhar. Mas uma falha do named é uma falha de DNS e não do diretório, e neste desenho esse named nem sequer recebe consultas do parque. Os bugs são um facto de qualquer código. O raio de impacto e a alcançabilidade são coisas que escolhes.
E não consegue construir o desenho deste artigo
Há uma razão mais simples e mais definitiva para não ser este o backend aqui.
Não há transferências de zona. A pipeline da secção seguinte (primário oculto, signer, servidores autoritativos independentes) começa com um AXFR a sair do DC. O SAMBA_INTERNAL não tem com que transferir. Também não há TSIG, por isso até a autenticação de que essa transferência precisaria está ausente. E não há assinatura, nem validação de nada do que reencaminha.
Portanto, o resumo honesto do SAMBA_INTERNAL: é o backend que te deixa montar um domínio AD num laboratório num domingo à tarde sem configurar o BIND, e é muito bom nisso. O Samba diz «simple DNS setups» e fala a sério. Não é um resolver, nunca foi construído para ser o serviço DNS de um parque, e no momento em que quiseres assinatura, transferências, vistas, ACL, cache ou limitação de taxa, a resposta não é afiná-lo. Não tem esses botões. A resposta é o BIND.
Se o estás a correr hoje com todos os clientes apontados para o DC, a correção não é urgente, mas também não é opcional: dá aos clientes um resolver validador a sério, e põe o dns forwarder do DC a apontar para ele, para que o DC responda pelas suas próprias zonas e por mais nada.
E esta é a parte sobre a qual quero ser claro, porque «não uses DLZ» é repetido como se fosse uma regra de hardening: o DLZ não é a exposição. É o mecanismo de extração. O que importa não é que módulo está carregado no BIND, é quem tem permissão para falar com esse BIND, e o que acontece à zona a seguir. Um BIND com backend DLZ que só responde a um pedido de transferência do teu signer não é uma superfície de ataque em nenhum sentido interessante. Um DC com SAMBA_INTERNAL a receber todas as consultas de nomes de quatrocentos portáteis é-o, e muito. Só um dos dois aparece nas listas de verificação de hardening, e não é o que importa.
Há duas coisas sobre o DLZ que são verdade e que vale a pena planear em vez de temer:
- O módulo está acoplado à versão do BIND. O Samba distribui um
.soseparado por versão do BIND, e onamed.confindica um em concreto. Uma atualização de versão principal do BIND significa que o módulo correspondente tem de estar no sítio, ou onamednão arranca. É uma dependência de empacotamento a testar com antecedência, não uma propriedade de segurança. - O
namedprecisa de acesso aos dados do Samba, e é por isso que o Samba mantém um diretório dedicado com as partes de que o BIND precisa, em vez de lhe conceder o diretório privado inteiro. A concessão deve ser estreita; vale a pena verificar se ainda o é nos teus DC, já que é o único sítio onde o DLZ alarga de facto o que um comprometimento donamedalcançaria.
A razão pela qual o DLZ é a escolha certa aqui é o que ele permite: a interface DLZ do BIND suporta enumerar uma zona inteira, e é isso que torna possível, de todo, uma transferência de zona a partir de uma zona com backend DLZ. Essa transferência é o primeiro salto da pipeline, e é o BIND a fazê-la, o que significa que o resto da pipeline é configuração BIND normal e não nada de exótico.
Há uma restrição que molda tudo a jusante, e vale a pena dizê-la com clareza, porque é fácil supor o contrário. Uma zona DLZ não pode ela própria ser assinada. A ISC é explícita sobre isso no BIND ARM: o DLZ «is unable to handle DNSSEC-signed data due to its limited API». Não podes pendurar um dnssec-policy na instrução dlz e dar o assunto por arrumado.
O que podes fazer (e o que a ISC sugere para o DLZ no mesmo fôlego) é corrê-lo como primário oculto, com a assinatura feita por uma zona BIND normal que recebe os dados por transferência. É a secção seguinte, e a restrição é a razão de ter a forma que tem.
Convém saber que isto é uma restrição do Samba e não uma lei do Active Directory. O servidor DNS da Microsoft faz assinatura online de zonas dinâmicas integradas no AD desde o Windows Server 2012. A zona é assinada no local, as chaves privadas replicam para os Key Masters através da própria replicação do AD, e as atualizações dinâmicas continuam a funcionar. No Windows, «assinar as partições AD» é uma opção real e a resposta à objeção da rotatividade vem incluída. (No Server 2008 R2 não era: podias assinar uma zona integrada no AD, mas não uma que aceitasse atualizações dinâmicas, e cada alteração obrigava a voltar a assinar à mão; é daí que vem o folclore de que as zonas AD não se podem assinar.)
O Samba não tem equivalente. Nenhum dos backends assina: o servidor interno não tem DNSSEC nenhum, e o DLZ não consegue transportar dados assinados. Por isso, no Samba, a pipeline de transferir e assinar não é um desenho entre vários. É o caminho.
A pipeline de publicação
Agora a forma da coisa. Quatro papéis, e o DC está lá atrás, onde nada lhe chega.
named no DC ou um host separado. Os servidores autoritativos independentes são a única coisa que os clientes alguma vez veem, e são secundários da zona assinada.1. O controlador de domínio: primário oculto. BIND com dlz_bind9, autoritativo para as zonas AD a partir do diretório. Recursão desligada. Nenhum serviço virado para os clientes. allow-transfer restrito apenas ao signer, com TSIG. Do ponto de vista da rede, o DC não serve DNS de todo, e a única coisa que alguma vez o consulta é a máquina seguinte.
2. A instância de assinatura: uma zona BIND normal que recebe os dados por transferência. É aqui que vivem o inline-signing e o dnssec-policy, numa zona com o mesmo nome que guarda a cópia transferida. O BIND mantém a cópia não assinada que recebeu e a cópia assinada que publica como coisas separadas, e volta a assinar à medida que chegam novas transferências. Como é uma transferência e não um ficheiro partilhado, esta instância pode estar no próprio DC (um segundo named no seu próprio endereço) ou num host separado, e a configuração é quase idêntica num caso e noutro.
A troca é a que parece: no DC é uma máquina a menos para correr, enquanto um host separado mantém as chaves privadas fora da máquina que guarda o diretório. Ambas são defensáveis, e a escolha não muda mais nada na pipeline. O que importa é que a assinatura acontece uma vez, num ponto definido, sob uma política de chaves: a diferença entre DNSSEC que operas e DNSSEC que expira às três da manhã.
3. Os servidores autoritativos: a única coisa que os clientes veem. Secundários simples da zona assinada. Não guardam chaves, não assinam nada e não têm caminho para o diretório. Se um for comprometido, o atacante tem uma cópia de uma zona e nenhuma capacidade de forjar um registo novo que valide.
4. Os resolvers. Resolvers recursivos validadores para o parque, que reencaminham condicionalmente as zonas internas para esses servidores autoritativos e percorrem a árvore pública para tudo o resto. É para estes que aponta o resolv.conf dos clientes.
Desta disposição saem duas propriedades que vale a pena enunciar à parte, porque são o objetivo todo:
- A máquina que guarda o diretório não está ao alcance das máquinas que o usam. Um controlador de domínio é o host de maior valor do parque. Dar-lhe um serviço de rede virado para os clientes, que responde a UDP não autenticado de qualquer estação de trabalho, é uma má troca por um serviço que outras máquinas podem prestar.
- A assinatura acontece uma vez, num ponto definido. A objeção habitual a assinar uma zona AD é a rotatividade: o conteúdo muda demasiadas vezes para as assinaturas acompanharem. Essa objeção é, na verdade, uma objeção à disposição por omissão, não à assinatura. Com o registo dos clientes retirado, como a secção seguinte defende que tem de ser, a zona AD muda quando um controlador de domínio é promovido ou despromovido e praticamente nunca noutra altura. Uma zona escrita só por DC é uma zona estável, e uma zona estável é algo banal de assinar. Manter os clientes de fora não é apenas um controlo de segurança; é o que torna a zona sossegada o suficiente para ser assinada sem sobressaltos.
Como a assinatura é realmente montada
A forma acima é a parte importante, mas «uma zona BIND normal que recebe os dados por transferência» merece ser mostrada em vez de descrita, porque a primeira tentativa costuma naufragar ao tentar assinar diretamente o DLZ.
No DC, o lado DLZ fica deliberadamente aborrecido. Serve o diretório, entrega a zona a exatamente um par, e não faz mais nada:
key "transfer-to-signer" {
    algorithm hmac-sha256;
    secret "...";
};

options {
    recursion no;
    allow-query { key transfer-to-signer; localhost; };
    allow-transfer { key transfer-to-signer; };
    notify no;
};

dlz "AD DNS Zone" {
    database "dlopen /usr/lib64/samba/bind9/dlz_bind9_18.so";
};
Repara que o .so traz a versão principal do BIND no nome. É o acoplamento de versões da secção anterior tornado concreto: uma atualização do BIND precisa do módulo Samba correspondente no sítio antes de o named arrancar.
Do lado da assinatura, a zona é um secundário comum com as opções de assinatura acrescentadas. É esta a parte que não pode viver no DLZ:
dnssec-policy "ad-internal" {
    keys {
        ksk lifetime P365D algorithm ecdsa256;
        zsk lifetime P90D  algorithm ecdsa256;
    };
};

zone "ad.example.com" {
    type secondary;
    primaries { 192.0.2.10 key transfer-to-signer; };
    file "ad.example.com.axfr";
    inline-signing yes;
    dnssec-policy "ad-internal";
    allow-transfer { key transfer-to-public; };
    also-notify { 192.0.2.20; 192.0.2.21; };
};
Que isto funcione num secundário é o detalhe que sustenta tudo, e o ARM di-lo diretamente:
If
yes, BIND 9 maintains a separate signed version of the zone. An unsigned zone is transferred in or loaded from disk and the signed version of the zone is served with, possibly, a different serial number.
Portanto, o BIND mantém duas cópias: a não assinada que recebeu, escrita em file, e a assinada que serve, escrita ao lado com a extensão .signed. Chega uma transferência, a versão assinada é regenerada, e os servidores a jusante recebem um notify, porque a esta altura é uma zona perfeitamente comum. O inline-signing yes é, aliás, o valor por omissão quando há um dnssec-policy associado; está escrito acima porque uma configuração que diz o que faz vale a linha.
A rotação de chaves vem com a política e não com um cron job. As rotações da ZSK não precisam de intervenção nenhuma; as rotações da KSK precisam de que o novo DS chegue ao pai, que é a automação CDS/CDNSKEY de mais adiante neste artigo. rndc dnssec -status ad.example.com diz-te em que ponto do seu ciclo de vida está cada chave.
Se esse bloco corre no DC ou num host próprio é uma questão de para que endereço aponta primaries. No DC é uma segunda instância de named num segundo endereço, a transferir da primeira pelo loopback ou por uma interface de gestão. É isso que «o BIND com DLZ pode ser o signer» significa na prática: o mesmo software, a mesma máquina se quiseres, mas a assinatura acontece na cópia transferida e não na zona DLZ.
O único senão operacional é o notify, e está do lado do DLZ. O manual da ISC é direto: o DLZ «has no built-in support for DNS notify», por isso os servidores secundários não são informados automaticamente das alterações às zonas na base de dados. O Samba pode alterar um registo no diretório e a instância DLZ não faz ideia de que devia avisar alguém.
Por isso, o primeiro salto é um poll, não um push. O signer atualiza-se pelo temporizador SOA da zona que está a transferir, o que significa que:
- A propagação desde uma alteração no DC até um registo assinado e publicado é limitada por esse intervalo de refresh, não por segundos. Promove um DC e os seus novos registos
_msdcsaparecem a jusante até um refresh mais tarde. - Esse intervalo é o botão a rodar se o atraso importar. É uma troca contra a frequência com que queres que o DLZ seja consultado, o que traz à baila a outra coisa que a ISC diz sobre o DLZ: faz consultas à base de dados em tempo real sem cache e é «not recommended for use on high-volume servers».
- Ambas as coisas são argumentos a favor desta topologia, não contra. O único cliente que a instância DLZ alguma vez tem é o signer, a perguntar uma vez por refresh. A carga real de consultas do parque cai nos servidores autoritativos independentes, que servem um ficheiro de zona assinado simples à velocidade máxima.
Tudo o que está a jusante do signer é convencional: os servidores autoritativos são secundários da zona assinada, recebem um notify como deve ser, e nunca tocam no diretório nem numa chave.
Os clientes não podem escrever na zona que contém os localizadores
Esta é a importante, e é uma regra de desenho, não uma definição.
O Active Directory regista registos dinamicamente. Uma máquina junta-se ao domínio e regista-se a si própria; um DC arranca e regista os registos SRV que anunciam os seus serviços. A atualização dinâmica «segura» significa que essas atualizações são autenticadas: a máquina prova que é quem diz ser com as suas próprias credenciais, e há uma ACL por registo, para que uma máquina, em geral, só possa modificar um registo que criou.
Lê isso com atenção, porque a garantia é mais estreita do que parece à primeira vista. A atualização dinâmica segura autentica quem está a escrever. Não avalia o que o registo significa. E o conjunto de contas com direito a escrever é muito mais largo do que as pessoas supõem: numa zona integrada no AD por omissão, o grupo Authenticated Users tem Create All Child Objects no contentor da zona no diretório, porque o ADIDNS guarda cada registo como um objeto AD debaixo de CN=MicrosoftDNS,DC=DomainDnsZones. Não só as contas de máquina: qualquer conta autenticada no domínio, incluindo a de quem abriu o anexo da fatura esta manhã.
O que produz dois modos de falha numa zona que contém tanto registos de clientes como localizadores de serviços:
Os nomes que ainda não existem não pertencem a ninguém. As ACL por registo protegem um registo que já tem dono. Um nome que nunca foi registado não tem objeto onde aplicar uma ACL, por isso a primeira conta a criá-lo fica com ele. É esse o mecanismo por trás de toda a família de ataques ADIDNS, sendo o mais afiado um wildcard: cria * e todos os nomes da zona que ninguém reivindicou explicitamente (erros de escrita, hosts desativados, wpad) resolvem para o atacante. Os registos existentes ficam intactos, e é exatamente por isso que passa despercebido.
O raio de impacto inclui os localizadores. Os registos debaixo de _msdcs são a forma como todos os clientes do domínio encontram um controlador de domínio e um KDC. São os registos mais críticos para a segurança que tens e, numa implementação por omissão, estão na mesma zona em que quatrocentos portáteis escrevem sempre que recebem uma concessão DHCP.
Por isso, a regra: a zona que contém os localizadores é escrita pelos controladores de domínio e por mais nada. O registo dinâmico dos clientes vai para outro sítio.
Outro sítio pode ser uma de duas coisas, e ambas servem:
- Uma subzona delegada servida noutro lado. A zona AD tem uma delegação
NSpara, digamos,dyn.ad.example.com, e os registos caem num servidor separado que aceita as atualizações. As partições do Samba nunca recebem uma escrita de cliente. - Uma zona separada no Samba com a sua própria ACL de atualização. Continua no diretório, mas é uma zona própria, por isso uma escrita de cliente não tem caminho para
_msdcsnem para os registos de um DC.
A primeira dá a separação mais dura; a segunda dá menos trabalho a correr. O que falha a regra não é nenhuma delas. É o valor por omissão, em que as duas coisas vivem juntas. Que é como a maioria dos domínios ainda funciona, porque ninguém o escolheu e ninguém voltou lá para ver.
E há um segundo dividendo, o que liga isto de volta à pipeline. Uma zona escrita só por controladores de domínio é uma zona que quase nunca muda: uma promoção de DC, uma despromoção de DC, e de resto silêncio. Toda a rotatividade numa zona AD por omissão é registo de clientes. Tira isso e a objeção a assinar as partições AD vai com ele: não há um fluxo de atualizações atrás do qual as assinaturas tenham de correr, por isso assiná-la é rotina e não uma luta. A disciplina de escrita e a assinatura são a mesma decisão vista duas vezes.
Ao lado de qualquer uma delas, há uma permissão que deves ir verificar, e num DC Microsoft é a correção direta. Como os registos ADIDNS são objetos do diretório, o direito vem de uma ACL do AD e não de nada no protocolo DNS: Authenticated Users com Create All Child Objects no contentor da zona. Apertar isso é a mitigação mais limpa para o problema dos nomes não reivindicados e do wildcard, e em muitos parques a permissão pode ser retirada por completo quando souberes o que precisa realmente de se registar a si próprio. O DNS AD do Samba guarda os seus registos no diretório da mesma maneira, por isso aplica-se a mesma pergunta: vai ver o que o teu contentor de zona concede realmente.
Mas espera: em 2026 os clientes deviam sequer registar-se?
Tudo o que está acima assume que a atualização dinâmica dos clientes é algo de que precisas e que estás a tentar tornar seguro. Antes de aceitar isso, vale a pena fazer a pergunta que ninguém faz, porque a resposta mudou desde que este comportamento foi desenhado.
O registo dinâmico no DNS foi construído para um desktop. Uma caixa debaixo de uma secretária, um cabo de rede, um endereço que manteve durante anos. Nesse mundo, uma máquina registar o seu próprio nome era arrumado e basicamente verdade.
Agora olha para o que é um cliente em 2026. Acorda no wi-fi de casa. Chega ao escritório e liga-se à rede sem fios da empresa. Vai para uma docking station e apanha também um endereço com fios. Alguém liga a VPN e aparece um adaptador de túnel com um terceiro endereço. Vão para um café, partilham a ligação do telemóvel, e a VPN volta com um quarto. É uma máquina, um nome e meia dúzia de endereços num dia de trabalho, e por omissão vai tentar registar uma boa parte deles.
Por isso a zona enche-se de afirmações que um dia foram verdade.
- O Windows regista todos os adaptadores que tem, a menos que alguém tenha andado a desmarcar Register this connection’s addresses in DNS interface a interface. Um portátil na dock e na VPN é uma máquina com três adaptadores ativos e uma opinião sobre todos eles.
- Vários registos A para um nome não são um estado de erro, são o resultado normal. Uma consulta devolve-os todos, os clientes tentam-nos pela ordem que lhes apetecer, e as ligações a esse nome falham na proporção dos endereços que estão mortos. É este o mecanismo por trás de «o suporte remoto vê a máquina num minuto e no seguinte já não».
- Os endereços da VPN são os piores, porque um endereço de túnel é válido durante uma hora e o registo sobrevive-lhe. O túnel cai, o endereço do pool vai para outra pessoa, e o nome aponta agora para um colega.
- As docking stations baralham a própria identidade. A menos que esteja configurado o pass-through do endereço MAC, a concessão pertence à dock e não ao portátil, por isso num parque de secretárias partilhadas os nomes, as concessões e as máquinas afastam-se uns dos outros todos os dias.
- E a propriedade torna-o permanente. Um registo só pode ser atualizado pela conta que o criou. Quando um registo foi feito pelo DHCP com uma credencial e a máquina tenta depois atualizá-lo com a sua, a atualização falha, em silêncio, e o endereço desatualizado fica exatamente onde está.
A história da limpeza também não é o salvamento que parece. O Samba tem scavenging desde a 4.9, mas vem desligado por omissão (dns zone scavenging = yes, com samba-tool dns zoneoptions --aging=1), e o próprio Samba diz que «should only be enabled on new zones or new installations», porque versões antigas marcavam os registos dinâmicos como estáticos e os estáticos como dinâmicos. Nos parques com mais probabilidade de estarem cheios de lixo, os que correm há anos, a ferramenta para os limpar é precisamente a que te aconselham a não ligar. Também já teve um CVE só seu.
Por isso, faz a pergunta diretamente: o que é que consome de facto o registo A de um portátil?
Na maioria das organizações, muito pouco. Os utilizadores ligam-se a servidores; os servidores não se ligam a portáteis. Os consumidores genuínos são as ferramentas de suporte remoto, o RDP para uma estação de trabalho pelo nome, e o inventário ou a monitorização; e quase todas essas ferramentas mantêm o seu próprio inventário e trabalham a partir de um agente que dá sinal de vida, porque nunca puderam contar com o DNS para clientes móveis.
O que sugere inverter o valor por omissão:
- Os servidores e a infraestrutura recebem registos a partir do provisionamento. Com NetBox e Ansible já no quadro, o registo é criado pela mesma coisa que criou a máquina, está correto por construção, e é removido quando a máquina o for.
- O parque fixo com fios pode receber registos do DHCP se algo precisar realmente deles, com uma única credencial como dona, para que as atualizações não falhem.
- Os clientes móveis não registam nada. São consumidores de DNS, não publicadores. Se algo precisa de chegar a um portátil, precisa de um agente, não de um registo A.
Acabas no mesmo sítio onde o argumento de segurança te pôs, vindo de uma direção completamente diferente. Menos escritores significa uma superfície ADIDNS mais pequena, uma zona que não está cheia de afirmações caducadas e, de volta à pipeline, uma zona sossegada o suficiente para ser assinada sem pensar nisso.
O argumento de segurança diz que os clientes não podem escrever na zona que contém os localizadores. O argumento operacional pergunta porque é que estão sequer a escrever no DNS. Em 2026, para uma frota que muda de endereço cinco vezes por dia, «não estão» é uma resposta perfeitamente boa, e bastante menos trabalho do que tornar segura a confusão que fazem.
Vistas separadas, e de onde vem a confiança
A última peça junta as duas metades do artigo.
Há duas vistas do espaço de nomes. Uma zona pública, publicada na internet, com o punhado de nomes de que o mundo precisa. E uma vista interna (o conteúdo derivado do AD, cada host associado, cada localizador de serviço, a topologia de sites) que o mundo não tem nada que ver. Esse conteúdo é um mapa do parque, e deve ser inalcançável e intransferível a partir de fora.
Mas a confiança para a vista interna vem do lado público, e é isso que torna este desenho melhor do que a habitual ilha de DNS interno:
example.comé pública e assinada, com o seuDSno pai e uma cadeia até à raiz.ad.example.comé delegada a partir dela. O pai público publica a delegação e umDSpara a chave da zona interna.- Os servidores autoritativos internos servem o
ad.example.comassinado. Os resolvers internos validam-no (raiz →com→example.com→ad.example.com) sem usar mais nada além da âncora de confiança da raiz que já tinham.
Sem âncora de confiança local. Sem ilha. Sem chave distribuída à mão. Os dados nunca saem do edifício, e o caminho de validação é o caminho público normal. Quando acrescentas um resolver, ele valida os nomes internos corretamente sem configuração DNSSEC nenhuma.
Sendo franco quanto à troca, porque há uma. Publicar uma delegação e um DS na zona pública significa que a existência de ad.example.com, e os nomes dos seus servidores de nomes, são públicos. O conteúdo não é, e nunca será, mas disseste ao mundo que a zona existe. Em troca, todos os resolvers que tens validam os nomes internos contra a raiz verdadeira. É uma boa troca para a maioria dos parques, e deve ser deliberada, não uma surpresa.
Duas coisas a acertar ao lado disto:
- Mantém a vista interna não enumerável e intransferível. O
allow-transfernos servidores autoritativos internos é para o signer e para os teus próprios secundários, mais nada. E lembra-te de que a negação autenticadaNSECdeixa quem consegue consultar a zona percorrê-la de uma ponta à outra; oNSEC3sobe esse custo, mas o verdadeiro controlo é que quem está de fora não consegue chegar aos servidores de todo. - Automatiza o
DS. UmDSno pai que deixa de corresponder à chave do filho leva o domínio interno inteiro paraSERVFAIL. OCDS/CDNSKEYexiste para que o filho possa sinalizar uma mudança de chave e o pai a possa apanhar sem que um humano edite um registo a meio de uma rotação. Se a zona pai estiver num registrar ou fornecedor que o suporte, usa-o; se não, o procedimento de rotação tem de ficar escrito antes da primeira rotação, não durante.
Pôr o Windows e o Linux a validar de verdade
Tudo até aqui foi sobre publicar uma zona que pode ser verificada. Nada disso faz coisa nenhuma enquanto algo do lado do cliente não insistir em verificá-la. Uma zona perfeitamente assinada e um cliente que nunca verifica uma assinatura dão exatamente a mesma experiência que uma zona não assinada, até ao dia em que não dão.
Só há dois sítios onde a validação pode acontecer, e a diferença entre eles é a diferença entre um controlo de segurança e uma sugestão educada.
Validar no resolver, e confiar no bit AD. O cliente pergunta a um resolver, o resolver faz a criptografia e comunica o resultado ligando um bit (AD, authenticated data) na resposta. O cliente acredita no bit. É o modelo que o Windows usa, e só é tão forte quanto o caminho entre o cliente e o resolver, porque qualquer coisa que consiga responder como se fosse o resolver consegue ligar esse bit.
Validar no próprio cliente. A máquina corre o seu próprio resolver validador, por isso o «caminho até ao resolver» é um socket de loopback dentro da máquina e já não sobra nada para falsificar. É mais forte e, no Linux, é perfeitamente alcançável.
Por omissão, nada
Antes de configurar seja o que for, vale a pena ver o que uma estação de trabalho Linux comum faz de origem. Isto é uma máquina Fedora 44, systemd 259, sem alterações:
$ resolvectl status | head -3
Global
         Protocols: LLMNR=resolve -mDNS -DNSOverTLS DNSSEC=no/unsupported
  resolv.conf mode: stub

$ grep options /etc/resolv.conf
options edns0 trust-ad

$ dig +dnssec cloudflare.com A | grep flags
;; flags: qr rd ra; QUERY: 1, ANSWER: 3, AUTHORITY: 0, ADDITIONAL: 1
Lê os três juntos, porque contam uma pequena história.
O stub está configurado com trust-ad: disseram-lhe para acreditar no bit AD. O systemd-resolved reporta DNSSEC=no/unsupported, por isso não está a validar nada por si. E a resposta para uma zona assinada volta com as flags qr rd ra e sem ad: nada em todo esse caminho afirmou ter validado.
Isso não é uma má configuração. É o valor por omissão. Um cliente pode ser instruído a confiar numa afirmação que nada na cadeia está a fazer. Ninguém está a verificar nada. Vale a pena ficares um minuto com isso antes de configurares mais alguma coisa.
Linux
Três opções, por ordem crescente de quão pouco tens de confiar na rede.
1. systemd-resolved, a validar localmente. Um drop-in, em vez de editar o ficheiro distribuído:
# /etc/systemd/resolved.conf.d/dnssec.conf
[Resolve]
DNSSEC=yes
DNSOverTLS=opportunistic
Depois systemctl restart systemd-resolved e confirma com resolvectl status que a linha diz agora DNSSEC=yes.
A definição com que deves ter cuidado é a do meio. DNSSEC=allow-downgrade parece um compromisso sensato e não é um controlo de segurança; o próprio resolved.conf(5) o diz:
Note that this mode makes DNSSEC validation vulnerable to “downgrade” attacks, where an attacker might be able to trigger a downgrade to non-DNSSEC mode by synthesizing a DNS response that suggests DNSSEC was not supported.
Um atacante que consegue forjar respostas é exatamente o atacante que o DNSSEC existe para travar, por isso um modo que ele pode desligar forjando uma resposta não te compra nada contra ele. É yes ou é decoração.
2. Um resolver validador a sério no host. O validador do systemd-resolved é conveniente, não exaustivo. Onde importa, corre Unbound ou BIND no loopback e aponta o stub para lá:
# unbound: validate against the root anchor, refuse to be stripped
server:
    module-config: "validator iterator"
    auto-trust-anchor-file: "/var/lib/unbound/root.key"
    harden-dnssec-stripped: yes
    val-permissive-mode: no

# the internal zone is reached like any other name — no local anchor needed
forward-zone:
    name: "ad.example.com."
    forward-addr: 192.0.2.53
O equivalente no BIND é uma linha, dnssec-validation auto;, que usa a sua cópia embutida da âncora da raiz e gere a rotação por ti.
3. Em todo o parque, nos resolvers que já corres. São a fase quatro da pipeline mais acima neste artigo. A validação acontece lá, os clientes confiam no bit AD, e o salto entre eles é aquilo que tens de proteger: com DoT, ou com uma rede sobre a qual estejas disposto a fazer essa suposição.
E repara no que não está em nenhuma dessas configurações: uma âncora de confiança para a zona interna. Como ad.example.com é uma delegação dentro de uma zona assinada publicamente, cada um destes valida os nomes internos pela cadeia normal a partir da raiz. É o desenho da secção anterior a pagar-se a si próprio. A alternativa é empurrar uma âncora local para todos os clientes e resolvers do parque, e voltar a empurrá-la a cada rotação.
Windows
Primeiro o importante, porque é constantemente mal compreendido: o DNS Client do Windows não valida DNSSEC. Não faz criptografia nenhuma, não verifica nenhuma assinatura e não guarda nenhuma âncora de confiança. É um resolver stub, e sempre foi.
O que podes fazer é obrigá-lo a recusar respostas que não foram validadas pelo servidor em seu nome. É a Name Resolution Policy Table, e funciona por espaço de nomes, não globalmente:
# Require validated answers for the internal zone
Add-DnsClientNrptRule -Namespace ".ad.example.com" `
    -DnsSecEnable -DnsSecValidationRequired

# What is actually in force on this machine, including from Group Policy
Get-DnsClientNrptPolicy -Effective
Get-DnsClientNrptRule
Para o parque, a mesma coisa vive na Group Policy em Computer Configuration → Policies → Windows Settings → Name Resolution Policy: cria uma regra para o espaço de nomes, marca a opção DNSSEC, e marca a exigência de que o cliente verifique que os dados foram validados pelo servidor DNS.
Daí decorrem duas coisas, e ambas importam.
Algo a montante continua a ter de fazer a validação. A regra NRPT faz o cliente exigir o bit AD; não cria um. O resolver para onde esses clientes apontam tem de ser um resolver validador, ou todos os nomes desse espaço de nomes falham.
E é por isso que a regra NRPT tem opções de IPsec ao lado. A Microsoft pô-las lá pela razão exposta no início desta secção: exigir um bit que qualquer atacante no caminho pode ligar não é grande exigência. Se dependes do modelo em que o resolver valida numa rede sem confiança, o último salto precisa de proteção: IPsec entre cliente e resolver, ou DoT onde o resolver o suporte.
Falha fechado, por isso implementa-o por esta ordem
Forçar a validação converte uma classe de comprometimento silencioso numa classe de falha ruidosa. É a troca certa, e continua a ser uma falha: um RRSIG expirado, um DS no pai que já não corresponde depois de uma rotação, ou um resolver que não consegue chegar à zona pai produzem todos SERVFAIL, e SERVFAIL para _ldap._tcp.dc._msdcs significa que o domínio está em baixo, não degradado.
Por isso faz assim, por esta ordem:
- Liga a validação primeiro nos resolvers, e deixa os clientes em paz. Vigia os
SERVFAILnos logs dos resolvers durante umas semanas: é aqui que encontras a zona que está discretamente avariada há um ano. - Automatiza o
DSantes de forçar seja o que for, como na secção anterior. A maioria das falhas DNSSEC autoinfligidas é uma rotação em que o pai nunca foi atualizado. - Depois força os clientes, um espaço de nomes de cada vez, começando pela tua própria estação de trabalho e por uma OU de teste em vez do parque inteiro.
A falha contra a qual estás a construir é um cliente receber um controlador de domínio forjado. A falha que estás a arriscar é um cliente não receber nada. A segunda é recuperável e óbvia; a primeira não é nem uma coisa nem outra. Vais saber da falha em menos de um minuto. Da outra nunca terias sabido.
Cifrar o último salto: DoT e DoH nos resolvers internos
A secção sobre validação deixou uma coisa pendurada. No modelo em que o resolver valida (o que o Windows te dá), o cliente está a confiar num único bit ligado pelo resolver, e esse bit só vale o caminho por onde viajou. Alguma coisa tem de proteger esse caminho.
O BIND suporta nativamente os dois transportes cifrados, por isso isto é um trabalho de configuração e não de compras:
- DNS over TLS: um bloco
tlsreferenciado a partir delisten-on, por convenção na porta 853. - DNS over HTTPS: o mesmo bloco
tlsmais um blocohttp, na 443. - DoT de saída, porque
forwardersaceita um transporte TLS por endereço ou para a lista inteira. - Transferências de zona sobre TLS, porque a instrução
primariesde uma zonatype secondarytambém aceita um, o que é diretamente útil para a pipeline mais acima neste artigo.
Primeiro, tem claro o que isto compra, porque o DoT e o DNSSEC são confundidos constantemente e não são alternativas. O DNSSEC autentica os dados, desde a zona que os publicou. O DoT protege a conversa com o resolver. Um sobrevive a um resolver hostil e a uma rede hostil entre resolvers; o outro impede a máquina no teu wi-fi de ler e reescrever o que o teu portátil perguntou. Queres os dois, e nenhum substitui o outro. Cifrar o salto até um resolver que não valida é uma conversa privada com algo a quem ainda se pode mentir.
Servi-lo
tls internal-resolver {
    key-file "/etc/pki/dns/resolver.key";
    cert-file "/etc/pki/dns/resolver.pem";
    protocols { TLSv1.3; };
};

http internal-doh {
    endpoints { "/dns-query"; };
};

options {
    dnssec-validation auto;

    listen-on          port  53                          { 192.0.2.53; };
    listen-on          port 853 tls internal-resolver    { 192.0.2.53; };
    listen-on          port 443 tls internal-resolver
                                 http internal-doh       { 192.0.2.53; };
    listen-on-v6       port 853 tls internal-resolver    { 2001:db8::53; };
};
O certificado é o trabalho a sério, e é a parte que se salta. Um cliente que verifica (que é o objetivo todo) precisa de um certificado válido para o nome com que foi configurado, emitido por algo em que já confia. Isso significa a tua CA interna e a tua automação de certificados existente, não a palavra-chave ephemeral. O ephemeral gera um certificado autoassinado descartável; existe para poderes provar que o listener funciona, e não vale nada para um cliente que esteja de facto a verificar.
Reencaminhar por cima dele
Se esses resolvers reencaminham para algum lado em vez de percorrerem a árvore eles próprios, o salto a montante também pode ser cifrado, e há aqui uma distinção que vale a pena acertar:
tls upstream {
    ca-file "/etc/pki/tls/certs/ca-bundle.crt";
    remote-hostname "dns.example.net";
};

options {
    forwarders port 853 tls upstream { 192.0.2.1; };
};
Sem remote-hostname, tens cifra sem autenticação: o tráfego é ilegível para um observador passivo, e um atacante ativo que consiga intercetar a ligação limita-se a apresentar o seu próprio certificado. Com remote-hostname e ca-file, o BIND verifica com quem está a falar. A primeira vale alguma coisa. Só a segunda merece ser chamada controlo.
A metade do cliente não é simétrica
É aqui que um parque misto se torna incómodo, e é a razão para configurar os dois transportes em vez de escolher um.
O Linux faz DoT como deve ser. O systemd-resolved aceita DNSOverTLS=yes para o modo estrito, e o servidor pode receber o nome contra o qual verificar:
[Resolve]
DNS=192.0.2.53#resolver.ad.example.com
DNSOverTLS=yes
DNSSEC=yes
Tal como com DNSSEC=, a definição do meio é a armadilha: DNSOverTLS=opportunistic recua para texto claro quando o TLS não está disponível, o que um atacante capaz de interferir com a ligação consegue arranjar.
O Windows faz DoH, e não DoT. O suporte DoH no cliente chegou com o Windows 11 e o Server 2022, configurado por servidor com um modelo:
$doh = "https://resolver.ad.example.com/dns-query"
netsh dnsclient add encryption server=192.0.2.53 dohtemplate=$doh
O DoT, à data em que escrevo, só apareceu em builds Insider. Por isso, no Windows lançado, a opção cifrada é DoH ou nada, e é exatamente por isso que a secção NRPT mais acima recorreu antes ao IPsec.
Daí servir os dois a partir da mesma instância BIND. DoT para a frota Linux e para tudo o resto que o fale, DoH para o Windows, um resolver, um certificado.
Qual, e onde
Para um resolver interno, o DoT é o melhor transporte e o DoH é a resposta de compatibilidade.
O DoT está na sua própria porta. Podes vê-lo, permiti-lo, negá-lo, e alertar sobre tudo o que faça DNS sem ser por ele. A vantagem do DoH (indistinguível do tráfego web normal na 443) é um benefício real numa rede hostil e um incómodo na tua, onde conseguir distinguir o que é DNS é uma funcionalidade pela qual pagaste. No parque que controlas, prefere o transporte que consegues observar, e corre o DoH porque o Windows não te deixa escolha, não porque seja melhor.
Já que estás aí: cifra as transferências
A pipeline mais acima neste artigo move a zona AD por AXFR, e a secção das vistas separadas sublinhou que o seu conteúdo é um mapa do parque. O TSIG autentica essas transferências; não as esconde. Como a instrução primaries de um secundário aceita uma configuração TLS, a transferência também pode correr sobre TLS (RFC 9103, se quiseres a norma):
zone "ad.example.com" {
    type secondary;
    primaries { 192.0.2.10 port 853 tls xfr-tls key transfer-to-signer; };
    ...
};
Autenticada pela chave, cifrada pelo transporte. Se algum salto dessa pipeline atravessar uma ligação entre sites, um hipervisor que partilhas, ou qualquer coisa onde não porias de bom grado um hub, vale os vinte minutos.
O que não resolve
- Não é validação. Já tratado acima, e vale a pena repetir, porque os fornecedores vendem «DNS seguro» querendo dizer só cifra.
- Não esconde nada do resolver. O resolver vê todas as consultas por inteiro. A cifra protege o caminho, não a privacidade da consulta perante o operador, o que não tem mal nenhum quando o operador és tu.
- Não faz nada por um cliente que não verifica o certificado, e os modos oportunistas podem ser rebaixados exatamente pelo atacante que te preocupa.
- E não é razão para pôr um listener no controlador de domínio. DNS cifrado no DC seria resolver lindamente o problema errado. O DC continua a não responder a ninguém.
Como verificar o que tens
Comandos para correr contra o teu próprio parque. Os resultados são a parte interessante, e um ou dois deles costumam ser leitura desconfortável da primeira vez.
# Walk the tree yourself, one delegation at a time
dig +trace dc01.ad.example.com

# Validate, and show the chain being built
delv +rtrace +vtrace ad.example.com SOA

# Is the resolver you are pointed at actually validating?
# A deliberately broken test name must come back SERVFAIL, not an address
dig @<resolver> dnssec-failed.org A

# What does the estate advertise as a domain controller?
dig SRV _ldap._tcp.dc._msdcs.<domain>
dig SRV _kerberos._udp.<domain>

# Is a DC answering for names it has no business answering?
# Ask it for something it is not authoritative for. "recursion requested
# but not available" is the answer you want. An actual address means it is
# serving the estate — recursing if it is BIND, relaying to the forwarder
# if it is SAMBA_INTERNAL. Either way it should not be doing that.
dig @<dc> www.example.org A

# Is the DC configured as the estate's DNS relay?
grep -E 'dns forwarder|server services' /etc/samba/smb.conf

# Will a DC hand its zone to anybody who asks?
dig @<dc> AXFR ad.example.com

# Which backend is this DC running, and does named have the module?
grep -r dlz /etc/named.conf /var/lib/samba/bind-dns/ 2>/dev/null
samba-tool dns query <dc> <domain> @ ALL

# Is the internal zone chained to the public parent?
dig DS ad.example.com @<public-authoritative-for-example.com>

# What does the local stub actually do with the AD bit, and is the
# hop to the resolver encrypted?
resolvectl status                    # DNSSEC= and DNSOverTLS= per link
grep options /etc/resolv.conf        # trust-ad, trusting whom exactly?

# Did anything in the path claim to have validated? Look for "ad" in the flags
dig +dnssec ad.example.com SOA | grep flags

# Validate independently of whatever the local resolver believes
delv ad.example.com SOA              # "fully validated" is the line you want

# Is the resolver actually listening for DoT, and does its certificate
# match the name clients are configured with?
kdig +tls @192.0.2.53 ad.example.com SOA
openssl s_client -connect 192.0.2.53:853 \
    -servername resolver.ad.example.com </dev/null 2>/dev/null \
    | openssl x509 -noout -subject -dates
E num cliente Windows, para ver se está sequer a exigir alguma coisa:
Get-DnsClientNrptPolicy -Effective    # the rules actually in force
Resolve-DnsName ad.example.com -DnssecOk
Get-DnsClientDohServerAddress         # is the hop to the resolver encrypted?
As duas que mais vezes trazem surpresas são a verificação da recursão e a tentativa de AXFR. Se um DC responder a qualquer uma delas para um cliente arbitrário, a pipeline deste artigo não está montada, diga o que disser o diagrama na wiki.
A terceira é resolvectl status numa máquina em que ninguém mexeu. DNSSEC=no/unsupported ao lado de trust-ad no resolv.conf é o estado normal de um desktop Linux, e significa que o trabalho de assinatura descrito acima não está, neste momento, a ser verificado por ninguém.
A versão curta
Um resolver nasce a conhecer os servidores raiz e uma chave, e aprende tudo o resto por lhe dizerem. Os nomes são encontrados descendo por delegações, e os serviços são encontrados pedindo um registo SRV; por isso, quando um cliente começa a fazer Kerberos com um controlador de domínio, a identidade desse controlador de domínio veio de uma resposta DNS. A descoberta por DNS está certa e não tem mal. A autorização por DNS não está, e uma quantidade surpreendente de infraestrutura fá-la na mesma, discretamente.
O DNSSEC é o que torna essas respostas verificáveis: assinaturas em cada conjunto, um DS em cada pai, uma cadeia até uma única âncora de confiança na raiz, e negação autenticada para que um nome não possa ser feito desaparecer. Compra autenticação da origem e integridade, não privacidade nem correção. Assina o que quer que a zona diga, e é por isso que não pode salvar uma zona que máquinas sem confiança podem escrever. E precisa de um pai: um TLD interno inventado não tem onde pôr um DS, por isso .local, .lan, .internal e home.arpa deixam-te todos ou sem assinatura ou a correr uma ilha privada de chaves distribuídas à mão.
Para um domínio Active Directory, isso produz um desenho e não uma lista de definições. Usa uma delegação dentro de uma zona pública de que és dono, para que a confiança desça pela cadeia normal a partir da raiz enquanto os dados nunca saem. Serve as partições AD com BIND e dlz_bind9 (o DLZ não é o risco, é como tiras a zona do diretório) e deixa o DC ser um primário oculto que transfere para fora e não responde a mais ninguém. Uma zona DLZ não pode ela própria ser assinada, por isso a assinatura é uma zona secundária normal que guarda a cópia transferida, com inline-signing e um dnssec-policy: um segundo named no DC se quiseres menos máquinas, um host separado se quiseres as chaves privadas fora do diretório. Seja como for, é assinada uma vez, num ponto definido, sob uma política de chaves, e o primeiro salto é um poll e não um push, porque o DLZ não consegue enviar um notify. Publica a partir de servidores autoritativos independentes que não guardam chaves e não têm caminho para o diretório.
E mantém os clientes fora da zona que importa. A atualização dinâmica segura autentica o escritor, não o significado, e numa zona integrada no AD por omissão os escritores são os Authenticated Users (todas as contas, não só todas as máquinas), por isso uma zona que contém tanto registos de portáteis como localizadores _msdcs está a um utilizador vítima de phishing de um cliente ouvir, com uma assinatura perfeitamente válida, que o controlador de domínio está noutro sítio. Os registos dos clientes pertencem a uma subzona, delegada para fora ou separada no Samba, onde o pior que uma conta comprometida pode fazer é mentir sobre si própria.
Embora a melhor pergunta seja se os clientes deviam sequer registar-se. Um portátil de 2026 tem um endereço no wi-fi de casa, outro na rede sem fios do escritório, outro através da dock e outro na VPN, e vai alegremente publicar a maior parte deles. O que consome o registo A de um portátil é quase nada: as ferramentas que precisam de chegar a uma estação de trabalho mantêm o seu próprio inventário, porque o DNS nunca foi fiável para clientes móveis. Os registos dos servidores devem vir do provisionamento, e a frota não deve registar nada.
Depois, põe alguma coisa a verificar as assinaturas, porque nada do que está acima vale coisa alguma enquanto um cliente não recusar uma resposta. No Linux isso significa DNSSEC=yes no systemd-resolved, ou um resolver validador a sério no loopback; nunca allow-downgrade, que um atacante capaz de forjar respostas pode simplesmente desligar forjando uma resposta. No Windows significa aceitar que o cliente DNS nunca valida nada por si e usar uma regra NRPT para o obrigar a exigir uma resposta validada pelo resolver, com o último salto protegido, porque essa exigência é um único bit. Liga-a primeiro nos resolvers e vigia os SERVFAIL, automatiza o DS, e depois força os clientes. Falha fechado, que é o sentido certo, e continua a ser uma falha.
Nada disto é exótico. É delegação, transferência e assinatura, as três coisas que o DNS sempre fez, dispostas de modo a que a máquina que guarda o teu diretório não seja a máquina que recebe perguntas do parque de estacionamento, e a que, quando algo mente a um cliente, o cliente dê por isso.