Desta vez o anfitrião existe. Só está no hipervisor errado
Da última vez o problema era que a máquina indicada no inventário ainda não existia — sem IP, sem SSH, sem Python, nada a que ligar. Todas as tarefas tinham de ser delegadas para longe dela.
Uma migração da VMware inverte isso e não muda nada. A máquina existe, está a correr, há pessoas a usá-la. Continuas a nunca te ligar a ela. É um nome e um saco de variáveis que descrevem uma coisa a reconstruir noutro sítio. Todas as tarefas continuam a correr no nó de controlo, e agora há duas APIs do outro lado em vez de uma.
Uma nota sobre o que isto é. Este artigo é o desenho e o playbook, não uma história de guerra. Ainda não o corri de ponta a ponta contra um parque em produção. Tudo o que digo abaixo sobre o comportamento dos módulos foi lido no código distribuído e verificado, e disse claramente onde uma afirmação vem do código-fonte e não de uma execução. Quando tiver feito uma migração real com ele, os números e as surpresas terão um artigo só deles.
Versões contra as quais isto foi verificado:
$ ansible --version | head -1
ansible [core 2.20.7]

$ ansible-galaxy collection list | grep -E 'vmware|proxmox'
community.proxmox 1.6.0
community.vmware  6.2.1
vmware.vmware     2.9.0
Os fragmentos abaixo foram cortados de um único playbook — migrate.yml, um inventário
dinâmico vSphere em inventory/vmware.vms.yml, e um group_vars/all.yml. Tornei
genéricos os nomes do datacenter, dos nós e do armazenamento para facilitar a leitura.
A forma do trabalho
Cinco passos, e só o último custa alguma coisa.
A ordem é o desenho todo. A descoberta não muda nada. Construir a rede só muda o Proxmox. Construir as cascas só muda o Proxmox, e uma casca sem disco é barata de apagar. Mover os discos é lento mas acontece a quente. Só a última play desliga alguma coisa.
Vai-te embora a meio e todos os convidados continuam a correr na VMware, intactos.
Duas coleções, e uma delas está a ser retirada
Precisas das duas, e não pela razão que adivinharias.
collections:
  - name: community.vmware
    version: ">=6.2.1"
  - name: vmware.vmware
    version: ">=2.5.0"
  - name: community.proxmox
    version: ">=1.6.0"
A community.vmware é a coleção antiga e abrangente, e está a ser desmontada. O seu MANIFEST.json declara {"vmware.vmware": ">=2.5.0"} como dependência obrigatória, por isso instalar a primeira traz a segunda, quer a tenhas pedido quer não. Os módulos estão a passar de uma para a outra um de cada vez, e os que usas numa migração estão em fases diferentes dessa passagem:
vmware_dvs_portgroup_info— ainda só nacommunity.vmware, e é ele que lê as tuas VLANs.vmware_vmotion— ainda só nacommunity.vmware.vmware_guest_powerstate— obsoleto, removido nacommunity.vmware7.0.0. Usavmware.vmware.vm_powerstate.vmware_vm_inventory— obsoleto, removido na 7.0.0. Usavmware.vmware.vms.
O Ansible avisa-te das obsolescências dos módulos na primeira execução, o que é decente da parte dele:
[DEPRECATION WARNING]: community.vmware.vmware_guest_powerstate has been deprecated.
Use vmware.vmware.vm_powerstate instead. This feature will be removed from
collection 'community.vmware' version 7.0.0.
Não te avisa do plugin de inventário, porque os plugins de inventário são analisados antes de esse mecanismo estar a correr. Tens de ir ler o plugin.
Há uma terceira armadilha na divisão. O vmware.vmware.vm_portgroup_info parece exatamente o que uma migração de rede quer — por VM, por NIC, dá-te o portgroup e a VLAN. Mas está construído sobre ModuleRestBase e importa com.vmware.vapi, o que quer dizer que precisa do vSphere Automation SDK no nó de controlo, e não apenas do pyVmomi. O valor de retorno documentado também está desatualizado: o bloco RETURN promete name e vlan_id, enquanto o código constrói na verdade portgroup_name e um dicionário vlan_info para o caso distribuído. Fui por outro caminho, mais abaixo, e não precisei de nenhum dos dois.
O inventário é a descoberta
Não há nenhuma play de «ir procurar as VMs» neste playbook, porque quando a primeira tarefa corre o inventário já o fez — numa única consulta ao property collector em vez de um ciclo por VM.
# inventory/vmware.vms.yml
plugin: vmware.vmware.vms

hostname: "{{ lookup('ansible.builtin.env', 'VMWARE_HOST') }}"
username: "{{ lookup('ansible.builtin.env', 'VMWARE_USER') }}"
password: "{{ lookup('ansible.builtin.env', 'VMWARE_PASSWORD') }}"
validate_certs: false

search_paths:
  - /Datacenter-1

properties:
  - name
  - config.name
  - config.uuid
  - config.guestId
  - config.firmware
  - config.template
  - config.hardware.numCPU
  - config.hardware.numCoresPerSocket
  - config.hardware.memoryMB
  - config.hardware.device
  - summary.runtime.powerState

gather_compute_objects: true
hostnames: ['name']
filter_expressions:
  - 'config.template'
O nome do ficheiro importa. O verify_file do plugin só reclama ficheiros que terminem em vms.yml, vms.yaml, vmware_vms.yml ou vmware_vms.yaml. Chama-lhe vcenter.yml e, em silêncio, não é o teu inventário.
O search_paths filtra antes da consulta, não depois. Num parque grande é a diferença entre segundos e minutos — ao contrário do filter_expressions, sobre o qual a documentação é explícita: corre depois da recolha e «does not affect the speed of the inventory plugin».
O filter_expressions descarta um anfitrião quando a expressão é verdadeira. Por isso config.template remove os modelos, o que se lê ao contrário da primeira vez.
E a linha importante é config.hardware.device, que não está em lista de propriedades por omissão nenhuma. É o inventário de hardware completo da VM, e traz três coisas sem as quais esta migração não pode avançar: o MAC de cada NIC, a chave do dvportgroup a que cada NIC está ligada e o caminho no datastore de cada disco. Sem ela voltas a um ciclo de vmware_guest_info, uma ida e volta por VM.
Os dispositivos vêm como JSON com o seu tipo vSphere preservado em _vimtype. Vale a pena saber isso, porque é assim que distingues uma NIC de um disco. Verifiquei o codificador em vez de adivinhar:
{
  "_vimtype": "vim.vm.device.VirtualVmxnet3",
  "macAddress": "00:50:56:87:a5:9a",
  "backing": {
    "_vimtype": "...DistributedVirtualPortBackingInfo",
    "port": {
      "_vimtype": "vim.dvs.PortConnection",
      "portgroupKey": "dvportgroup-1014"
    }
  }
}
Assim, um bloco compose consegue puxar os caminhos complicados para hostvars planas:
compose:
  vm_moid: moid
  vm_firmware: config.firmware
  vm_memory_mb: config.hardware.memoryMB
  vm_num_cpu: config.hardware.numCPU

  # A virtual NIC is any device with a MAC. Filtering on _vimtype does not
  # work cleanly here, because VMXNET3, E1000 and SR-IOV cards are all
  # different types with no shared substring.
  vm_nics: >-
    config.hardware.device
    | selectattr('macAddress', 'defined')
    | selectattr('macAddress', 'ne', None) | list

  # Disks are one exact type, so this one can match on it.
  vm_disks: >-
    config.hardware.device
    | selectattr('_vimtype', 'eq', 'vim.vm.device.VirtualDisk') | list
Essa assimetria é real e apanha muita gente. Não há nenhum tipo VirtualEthernetCard com que fazer correspondência. Essa é a classe base abstrata, e o que o vCenter te entrega na verdade é VirtualVmxnet3, VirtualE1000, VirtualE1000e, VirtualPCNet32 ou VirtualSriovEthernetCard. Não há nenhuma subcadeia comum a todos eles. Ter um MAC, no entanto, é uma coisa que só uma NIC faz.
Cada módulo info esconde o campo de que precisas
Este é o fio condutor do trabalho todo, e depois de o veres três vezes começas a verificar cada valor por omissão antes de escrever a tarefa.
O vmware_dvs_portgroup_info tem seis opções show_*. Cinco são true por omissão. A sexta é show_vlan_info, e é false por omissão.
show_mac_learning=dict(type='bool', default=True),
show_network_policy=dict(type='bool', default=True),
show_teaming_policy=dict(type='bool', default=True),
show_uplinks=dict(type='bool', default=True),
show_port_policy=dict(type='bool', default=True),
show_vlan_info=dict(type='bool', default=False),
Deixa-o como está e recebes a política de aprendizagem de MAC, a política de teaming, a ordem dos uplinks e a política de porta de todos os portgroups do parque. Tudo menos a tag da VLAN, que é o único campo sobre o qual uma migração de rede está realmente a perguntar. Por isso a tarefa fica do avesso em relação ao que escreverias por instinto: liga a única coisa, desliga as outras cinco.
- name: Read the distributed portgroups
  community.vmware.vmware_dvs_portgroup_info:
    datacenter: "{{ vcenter_datacenter }}"
    show_vlan_info: true
    show_network_policy: false
    show_teaming_policy: false
    show_port_policy: false
    show_mac_learning: false
    show_uplinks: false
  register: dvs_pgs
Não é caso único. O vmware.vmware.vms tem gather_compute_objects, que preenche cluster e esxi_host — false por omissão. O community.vmware.vmware_vm_info tem show_allocated, que é o bloco com o CPU e a memória — false por omissão. Nos três casos, o campo caro de recolher é o de que a migração precisa, e o valor por omissão protege um uso de relatório só de leitura que não é aquele em que estás.
O vlan_id tem três tipos diferentes
Depois recebes as tags das VLANs e descobres que não têm todas a mesma forma. Diretamente do get_vlan_info:
if isinstance(vlan_obj, vim...TrunkVlanSpec):
    ...
    return dict(trunk=True, pvlan=False, vlan_id=vlan_id_list)
elif isinstance(vlan_obj, vim...PvlanSpec):
    return dict(trunk=False, pvlan=True, vlan_id=str(vlan_obj.pvlanId))
else:
    return dict(trunk=False, pvlan=False, vlan_id=str(vlan_obj.vlanId))
Um portgroup de acesso dá-te a cadeia "100". Uma PVLAN dá-te uma cadeia. Um trunk dá-te uma lista de cadeias, cada uma "20" ou "20-30". E todos os switches distribuídos têm pelo menos um trunk, quer o tenhas criado quer não, porque o portgroup de uplink é um trunk que leva "0-4094".
Por isso o | int não está ao teu alcance até deitares fora as outras duas formas:
access_pgs: >-
  {{ dvs_pgs.dvs_portgroup_info | dict2items | map(attribute='value') | flatten
     | rejectattr('vlan_info.trunk') | rejectattr('vlan_info.pvlan')
     | rejectattr('vlan_info.vlan_id', 'in', ['0', 0])
     | list }}
Três rejects, por esta ordem. Saem os trunks, saem as PVLANs, e depois saem os portgroups sem tag, o que também despacha os grupos de uplink e tudo o que esteja na VLAN 0.
Não estou a traduzir trunks nem PVLANs automaticamente, e contestaria quem o fizesse. Um trunk da VMware a aterrar no Proxmox precisa ou de uma zona Q-in-Q ou de uma VNet com reconhecimento de VLAN, e qual está certa depende do que o convidado espera ver. Isso é uma decisão, não um mapeamento. O playbook imprime-os e segue em frente:
TASK [Report what was found]
ok: [localhost] => {
    "msg": "3 access portgroups -> [100, 200]. Not translated:
            ['dvs_001-uplink'] (trunks), ['isolated'] (PVLANs)."
}
Espelhar as VLANs no SDN
Uma zona VLAN ligada a uma bridge, e depois uma VNet por VLAN com a tag nela.
- name: Create the VLAN zone
  community.proxmox.proxmox_zone:
    zone: "{{ sdn_zone }}"
    type: vlan
    bridge: "{{ sdn_bridge }}"
    mtu: "{{ sdn_mtu }}"
    state: present

- name: Create one VNet per VMware VLAN
  community.proxmox.proxmox_vnet:
    vnet: "{{ sdn_vnet_prefix }}{{ item.vlan_info.vlan_id | int }}"
    zone: "{{ sdn_zone }}"
    tag: "{{ item.vlan_info.vlan_id | int }}"
    alias: "{{ item.portgroup_name }}"
    state: present
  loop: "{{ access_pgs | unique(attribute='vlan_info.vlan_id') }}"
  throttle: 1
Os nomes das VNets são curtos e restritos, e os nomes dos portgroups da VMware não. Production-Web-Tier-VLAN100 é um nome de portgroup perfeitamente normal e um nome de VNet impossível. Por isso o nome é gerado — v100, a partir da tag — e o original legível vai para alias, onde continua visível na interface e na saída do pvesh. Derivar o nome da VLAN em vez do portgroup também quer dizer que o mapeamento é reversível só de olhar, seis meses depois.
Dois portgroups na mesma VLAN fundem-se numa VNet. Isso está certo — já eram o mesmo domínio de broadcast na VMware — mas deves vê-lo acontecer, e é isso que o unique(attribute='vlan_info.vlan_id') está a fazer. Dois portgroups chamados prod-web e prod-web-b, ambos na VLAN 100, produzem um único v100.
O throttle: 1 não é cautela, é o módulo. Cada escrita SDN na community.proxmox obtém um bloqueio global do cluster, aplica a configuração pendente e liberta-o — get_global_sdn_lock(), depois apply_sdn_changes_and_release_lock(). Corre-as em paralelo e ficam na fila do bloqueio na mesma; o throttle só te impede de fingir o contrário. Vale também a pena saber que a reversão em caso de falha depende da versão — o módulo verifica is_lock_and_rollback_supported e, num PVE mais antigo, diz-te que não conseguiu reverter em vez de o fazer.
Uma coisa cosmética que te vai fazer duvidar de ti próprio. Na 1.6.0, o proxmox_vnet emite o dicionário completo dos seus parâmetros como um aviso do Ansible em cada criação:
self.module.warn(f"{vnet_params}")
self.proxmox_api.cluster().sdn().vnets().post(**vnet_params)
É uma linha de depuração que alguém lá deixou. É ruído, não uma avaria.
Constrói as cascas, sem discos
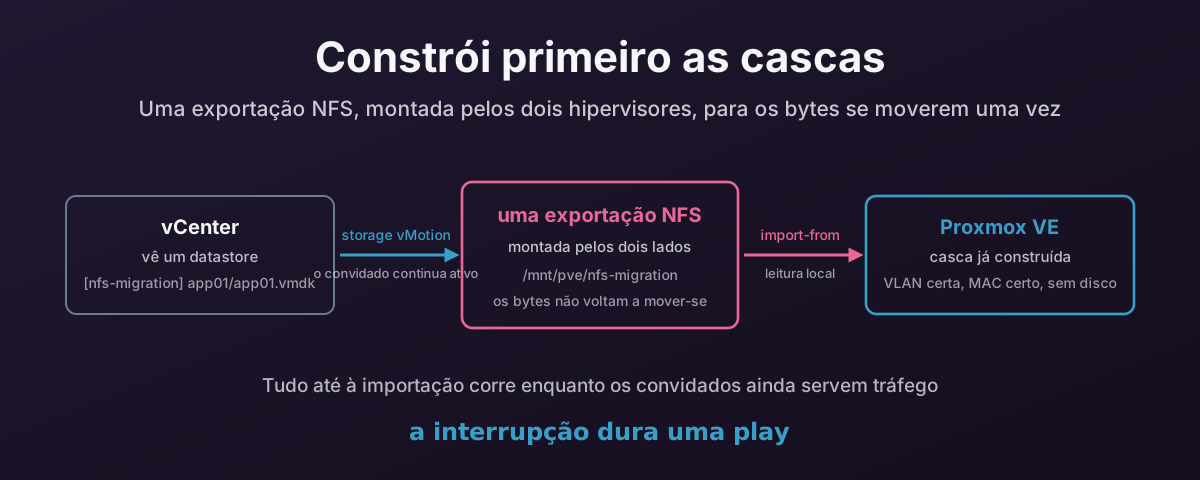
Agora as VMs, e é aqui que o desenho se justifica. Cada VM é construída no Proxmox com o número certo de CPUs, a memória certa, o firmware certo e as NICs certas nas VLANs certas. Sem discos nenhuns.
Uma casca sem discos é rápida de criar, não custa nada a apagar, e arranca para um prompt PXE se alguém a ligar sem querer. Consegues construir quatrocentas numa tarde, olhar para o resultado, decidir que está errado, apagar o lote todo e fazê-lo outra vez. Nada foi copiado, nada foi desligado, e ninguém reparou.
Os valores derivados são declarações, não tarefas. O Ansible avalia-os de forma preguiçosa contra o anfitrião que estiver em âmbito, por isso cada VM recebe os seus sem um único set_fact:
# group_vars/all.yml
pve_vmid: "{{ vmid_base | int + (vm_moid | regex_replace('^vm-', '') | int) }}"
pve_bios: "{{ 'ovmf' if vm_firmware == 'efi' else 'seabios' }}"
pve_cores: "{{ vm_cores_per_socket | int }}"
pve_sockets: "{{ ((vm_num_cpu | int) / (vm_cores_per_socket | int)) | round(0, 'ceil') | int }}"
O VMID vem do MoID do vCenter. vm-42 passa a 20042. Isso importa mais do que parece: a play da passagem tem de encontrar a VM que a play de construção criou, e uma nova execução tem de cair na mesma em vez de construir discretamente uma segunda. Deixar a API atribuir o próximo ID livre — que é o que acontece se omitires vmid, e sobre o que escrevi da última vez — torna isso impossível.
A memória não precisa de conversão. A VMware indica config.hardware.memoryMB e o Proxmox quer MB. Os sockets precisam: a VMware dá-te o total de vCPUs e os núcleos por socket, o Proxmox quer sockets e núcleos.
- name: Create the VM shell
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    name: "{{ inventory_hostname }}"
    cores: "{{ pve_cores }}"
    sockets: "{{ pve_sockets }}"
    memory: "{{ vm_memory_mb }}"
    ostype: "{{ pve_ostype }}"
    bios: "{{ pve_bios }}"
    scsihw: "{{ default_scsihw }}"
    efidisk0: "{{ {'storage': pve_target_storage, 'efitype': '4m',
                   'pre_enrolled_keys': false}
                  if pve_bios == 'ovmf' else omit }}"
    agent: "enabled=1"
    onboot: false
    state: present
onboot: false de propósito. Nada deve arrancar sozinho a meio de uma migração, muito menos uma máquina cujos discos ainda estão a ser escritos por outro hipervisor.
Acertar no firmware não é opcional. Um convidado UEFI importado para uma VM SeaBIOS importa na perfeição e depois recusa-se a arrancar, e vais perder uma hora com isso. O config.firmware é efi ou bios e corresponde diretamente a ovmf e seabios. Um convidado UEFI também precisa de um disco de variáveis EFI, que tem de ser criado com a VM — vê abaixo porquê.
O proxmox_kvm não corrige uma NIC, e não te diz
Da última vez escrevi que o proxmox_kvm se recusa a convergir em vez de atualizar. Eis a versão mais afiada disso, que me mordeu enquanto escrevia isto e sobre a qual vale a pena ser exato.
O update é false por omissão, por isso voltar a correr contra uma VM que já existe não faz nada. Tudo bem, e está documentado. Mas põe update: true e o módulo continua a recusar-se a mexer em alguns parâmetros:
# If update, don't update disk (virtio, efidisk0, tpmstate0, ide, sata, scsi)
# and network interface, unless update_unsafe=True
if update_unsafe is False:
    ...
    if "efidisk0" in kwargs:
        del kwargs["efidisk0"]
Apaga-os do pedido e segue em frente. Então corriges uma NIC no mapeamento do inventário, voltas a correr com update: true, vês o Ansible indicar changed, e a NIC está exatamente tão errada como estava. O changed é verdadeiro — outra coisa no payload foi atualizada — mas não aquilo que estavas a corrigir.
O update_unsafe: true levanta a restrição, e o nome é honesto. A mesma guarda cobre os discos, por isso, numa VM que tem discos, uma atualização insegura é uma boa maneira de arranjar uma segunda cópia de um deles. Não é um interruptor a que se deite a mão durante uma migração.
A saída é não usar net de todo. As NICs entram com o proxmox_nic, um módulo cujo trabalho todo é uma interface e que converge como deve ser:
- name: Attach each NIC to its VNet
  delegate_to: localhost
  community.proxmox.proxmox_nic:
    vmid: "{{ pve_vmid }}"
    interface: "net{{ idx }}"
    bridge: "{{ sdn_vnet_prefix }}{{ pg_vlan[item.backing.port.portgroupKey] }}"
    mac: "{{ item.macAddress }}"
    model: "{{ default_net_model }}"
    state: present
  loop: "{{ vm_nics }}"
  loop_control:
    index_var: idx
É a mesma divisão a que cheguei da última vez: proxmox_kvm para definir a máquina, proxmox_disk e proxmox_nic para as coisas que mudam depois. O parâmetro é mac, não mac_addr.
O efidisk0 não pode ser tirado da mesma forma — o proxmox_disk não tem efitype nem pre_enrolled_keys — por isso tem de entrar no momento da criação e estar certo à primeira.
Leva o MAC contigo. A VMware distribui MACs de 00:50:56:... e o Proxmox aceita-os sem se queixar. Mantê-los quer dizer que as reservas DHCP continuam a corresponder, as licenças presas ao MAC continuam a validar e qualquer regra de firewall escrita contra um MAC continua a disparar. Mudá-los quer dizer um dia de pequenos mistérios. O proxmox_nic também aceita model: vmxnet3 se precisares que o convidado veja a mesma NIC que via antes, mas no KVM a virtio é a melhor placa, e um convidado Windows vai querer drivers novos de qualquer forma.
Recusar em vez de adivinhar
Uma NIC num portgroup standard não tem backing.port nenhum. O seu backing é um NetworkBackingInfo com um deviceName. Não vai estar no mapa, e o certo a fazer é parar:
- name: Every NIC must sit on a distributed portgroup with a VNet
  ansible.builtin.assert:
    that:
      - vm_nics | rejectattr('backing.port.portgroupKey', 'defined') | list | length == 0
      - vm_nics | map(attribute='backing.port.portgroupKey')
          | reject('in', pg_vlan.keys() | list) | list | length == 0
    fail_msg: >-
      {{ inventory_hostname }} has NICs that do not map to a Proxmox VNet.
      Attaching it to the wrong network is worse than not building it.
Duas condições em vez de uma, porque a primeira tem de correr antes da segunda: um map(attribute=...) sobre uma NIC sem port rebentaria na consulta indefinida. Rejeita primeiro as que não têm forma, e depois verifica as restantes contra o mapa.
Uma exportação, montada duas vezes
Eis a parte que torna a coisa toda barata.
Põe uma exportação NFS onde os dois hipervisores a possam montar. O vCenter vê um datastore chamado nfs-migration; os nós Proxmox montam a mesma exportação e veem /mnt/pve/nfs-migration. Agora faz storage vMotion dos VMDKs para lá.
O storage vMotion é a quente. O convidado continua a servir tráfego o tempo todo. Nada é passado, não é preciso janela nenhuma, e pode ser abandonado a meio sem outra consequência além de I/O desperdiçado. É de longe a fase mais lenta e não custa nada.
- name: Relocate to the NFS datastore
  delegate_to: localhost
  throttle: 2
  community.vmware.vmware_vmotion:
    moid: "{{ vm_moid }}"
    destination_datastore: "{{ nfs_datastore_vmware }}"
    timeout: "{{ vmotion_timeout }}"
O timeout é 3600 por omissão — uma hora. Um VMDK de 2 TB não chega lá, e o modo de falha é traiçoeiro de uma forma silenciosa: a tarefa do Ansible falha enquanto o vMotion continua a correr no vCenter. Tens agora um playbook que diz que falhou e um parque que continua ocupado. Define-o com algo que reflita o teu armazenamento real.
throttle: 2, porque o estrangulamento não é o nó de controlo. O storage vMotion está limitado pelo array e pela rede. Seis de uma vez não te dão seis vezes o débito; dão-te seis migrações lentas e uma equipa de armazenamento furiosa.
O módulo é idempotente da forma que queres — define storage_vmotion_needed = False se a VM já estiver no datastore de destino — por isso voltar a correr para apanhar as que ficaram para trás é seguro.
Quando isto termina, os bytes estão num armazenamento que o Proxmox já monta. Como tal, mais nada precisa de os copiar. Nunca.
A passagem
Esta é a única play que custa tempo de indisponibilidade, e a ordem dentro dela não é negociável.
Primeiro, um problema fácil de não ver: o inventário está agora desatualizado. Foi recolhido antes do vMotion, por isso o vm_disks ainda tem os caminhos antigos dos datastores. Importa a partir deles e estás a apontar o Proxmox para um caminho que ele não consegue ver.
- name: Re-read the inventory now the disks have moved
  ansible.builtin.meta: refresh_inventory
É também por isso que a cache está desligada na configuração do inventário. Uma cache quente devolveria ao refresh_inventory exatamente os dados desatualizados que ele foi chamado para substituir. É uma troca real — o vCenter não é rápido — mas um caminho errado aqui é uma passagem falhada dentro de uma janela, e a ida e volta é barata em comparação.
Depois, desligar. Importar um VMDK que um anfitrião ESXi ainda tem aberto dá-te, na melhor das hipóteses, uma cópia consistente com uma falha:
- name: Shut the guest down in VMware
  delegate_to: localhost
  vmware.vmware.vm_powerstate:
    moid: "{{ vm_moid }}"
    state: "{{ 'shutdown-guest' if vm_power_state == 'poweredOn' else 'powered-off' }}"
    timeout: 600
    force: true
O shutdown-guest é um encerramento ordeiro através das VMware Tools; o force: true para à força tudo o que não sair dentro do timeout. No módulo novo o parâmetro é timeout, e não state_change_timeout como era no obsoleto.
Depois a importação, que é o ponto de viragem:
- name: Import each VMDK onto its VM
  delegate_to: localhost
  throttle: 2
  community.proxmox.proxmox_disk:
    vmid: "{{ pve_vmid }}"
    disk: "scsi{{ idx }}"
    storage: "{{ pve_target_storage }}"
    import_from: >-
      {{ item.backing.fileName
         | regex_replace('^\[[^\]]+\]\s*', '/mnt/pve/' ~ nfs_storage_pve ~ '/') }}
    format: "{{ pve_target_format }}"
    timeout: "{{ import_timeout }}"
    create: regular
    state: present
  loop: "{{ vm_disks }}"
  loop_control:
    index_var: idx
O regex_replace está a fazer a tradução entre os dois mundos. O vCenter chama a um disco [nfs-migration] app01/app01.vmdk; o Proxmox chega ao mesmo ficheiro em /mnt/pve/nfs-migration/app01/app01.vmdk. A mesma exportação, os mesmos bytes, nenhuma segunda cópia. Ficas com o descritor .vmdk e ignoras o -flat.vmdk ao lado dele — o qemu-img lê o descritor e segue-o até à extent.
Três coisas sobre o import_from que estão todas no módulo e que vale a pena saber antes de a janela abrir.
Só dispara na criação. No ramo de atualização:
# 'import_from' fails on disk updates
playbook_config = self.get_create_attributes()
playbook_config.pop("import_from", None)
Se o scsi0 já existir nessa VM, o parâmetro é descartado e recebes uma atualização normal. Por isso uma nova execução depois de uma importação falhada não volta a importar. Em silêncio, não faz rigorosamente nada e indica sucesso. Se uma importação correr mal, apaga o disco antes de tentar outra vez.
O timeout é 600 segundos por omissão. Dez minutos, para importar e converter o disco de uma máquina virtual. A própria documentação do módulo diz para o aumentar; segue o conselho.
E um caminho absoluto precisa de root. A documentação é direta sobre isso:
<STORAGE>:<VMID>/<FULL_NAME>or<ABSOLUTE_PATH>/<FULL_NAME>.<STORAGE>:import/<FULL_NAME>for PVE 9.x and later, to use storage’s import directory. Attention! Only root can use absolute paths.
O que cai mal ao lado do conselho que dei da última vez, e que mantenho: usa um token de API com âmbito limitado, não root. Esse conselho vale para todas as outras fases aqui: a descoberta, o SDN, a construção das cascas e a definição da ordem de arranque funcionam todas bem com um token. Esta tarefa não, e nenhuma quantidade de privilégios no papel o vai mudar, porque a restrição é sobre o utilizador ser root e não sobre uma permissão.
Há três saídas honestas, e nenhuma quarta engenhosa:
- PVE 9.x: usa
<storage>:import/<file>e fica com o token. - PVE 8.x: faz esta tarefa como
root@pam, e só esta. - PVE 8.x, sem root pela API: corre antes
qm importdiskpor SSH.
O playbook suporta as duas primeiras através de uma opção, porque fingir o contrário só passaria o problema para quem o corresse.
Por fim a ordem de arranque, que é uma atualização normal e por isso não é afetada pela restrição do update_unsafe:
- name: Boot from the first imported disk
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    boot: "order=scsi0"
    update: true
Nada arranca o convidado. É deliberado. Arranca-o à mão, vê-o subir, e só então pensa em apagar seja o que for na VMware.
Corrê-lo
A coisa toda é um playbook, com tags por fase, porque estes não são passos que queiras correr juntos:
ansible-playbook migrate.yml --tags discover   # look, change nothing
ansible-playbook migrate.yml --tags sdn        # build the VLANs
ansible-playbook migrate.yml --tags build      # build the diskless shells
ansible-playbook migrate.yml --tags relocate   # storage vMotion, live
ansible-playbook migrate.yml --tags cutover    # power off and import
O --limit é teu amigo do princípio ao fim. Faz primeiro uma VM. Faz um cluster. O playbook não tem opinião sobre quanto abocanhas de cada vez, e o inventário dá-te grupos de borla — power_poweredOn, cluster_<name>, mais vmware_windows e vmware_linux do bloco groups.
Verifica para o que estás a apontar antes de apontares:
ansible-inventory --graph
ansible-inventory --host some-vm
O que eu ainda vigiaria
Coisas que espero encontrar quando isto se cruzar com um parque real, escritas agora para que depois não possa dizer que as vi chegar:
- Os convidados Windows não arrancam de forma limpa a partir de um controlador VirtIO SCSI sem o driver estar presente primeiro. O
virtio-scsi-singleé o controlador certo e o errado para entregar a uma VM Windows que nunca o viu. Isso é um problema à parte e não fica resolvido por nada do que está acima. - As VMware Tools devem sair antes da mudança, não depois.
- Snapshots. Uma VM com uma cadeia de snapshots tem mais do que um
.vmdkpor disco, e importar a base dá-te o estado anterior ao snapshot. Consolida primeiro. - A ordem de
config.hardware.deviceé o que decide que disco passa a ser oscsi0. Correspondeu à ordem do próprio convidado em todo o lado onde olhei, mas verificá-la-ia num servidor de base de dados com vários discos antes de confiar nela dentro de uma janela. - Discos independentes e RDM não fazem storage vMotion como os normais.
Nada disso muda a forma. Constrói primeiro as cascas, move os discos enquanto tudo continua a correr, e mantém a interrupção restrita à única play que precisa dela.