O pressuposto que o Ansible normalmente pode fazer
Quase todos os módulos Ansible que já usaste funcionam assim: o Ansible liga-se ao anfitrião indicado no inventário, copia para lá um pequeno programa Python, executa-o e lê o resultado. O anfitrião é a coisa que está a ser alterada e a coisa que faz o trabalho.
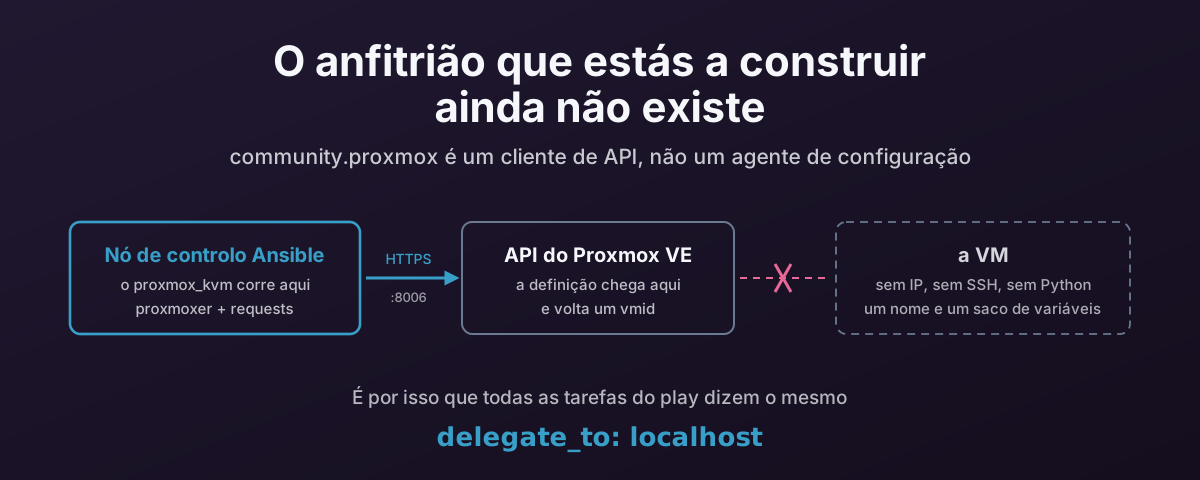
Criar uma máquina virtual quebra isso da forma mais básica possível. O anfitrião que estás a construir não existe. Não tem IP, nem daemon SSH, nem Python, nem sistema operativo. Não há nada a que te ligares.
Por isso o community.proxmox não é um agente de configuração. É um cliente de API que por acaso é distribuído como coleção Ansible. Como tal, tudo neste artigo decorre desse único facto: onde correm as tarefas, como fazes chegar as credenciais, porque é que voltar a executar não faz o que esperas, e porque é que o --check não te está a dizer a verdade.
Os exemplos aqui são versões reduzidas de um playbook que constrói VMs Windows e Linux a partir de registos do NetBox: proxmox-create-vms.yml. Tornei genéricos os nomes de nós, de armazenamento e de bridges para facilitar a leitura; o original está nesse repositório.
Tudo o que afirmo abaixo sobre o comportamento dos módulos foi verificado contra o community.proxmox 1.6.0, que é a versão que tenho instalada:
$ ansible-galaxy collection list community.proxmox
# /home/damien/.ansible/collections/ansible_collections
Collection        Version
----------------- -------
community.proxmox 1.6.0
Primeiro: a coleção mudou de sítio
Se estás a ler um playbook mais antigo ou uma resposta mais antiga, os módulos chamavam-se community.general.proxmox_kvm. Agora vivem numa coleção dedicada, e é aí que o desenvolvimento está a acontecer. A versão 1.6.0 traz 47 módulos, que cobrem Ceph, SDN, firewall, regras de HA e adesão a cluster, nada do qual existia na era do community.general.
ansible-galaxy collection install community.proxmox
pip install 'proxmoxer>=2.0' requests
A dependência Python não é opcional nem vem incluída: a coleção declara requirements: ["proxmoxer >= 2.0", "requests"], e isso tem de estar instalado onde quer que o módulo seja de facto executado, que, como explica a secção seguinte, não é o nó Proxmox.
O requirements.yml, se preferires fixar a versão:
---
collections:
  - name: community.proxmox
    version: ">=1.6.0"
A coleção é testada contra o ansible-core 2.17 a 2.20. Renomear as tuas tarefas community.general.proxmox_* para community.proxmox.proxmox_* é a maior parte da migração.
Todas as tarefas do Proxmox correm em localhost
Duas linhas no topo do play fazem o trabalho pesado, e ambas parecem estar a desligar algo útil:
- name: Create Proxmox virtual machines
  hosts: "{{ target_hosts | default('cluster_pve:&status_planned') }}"
  gather_facts: false
  serial: 1
O gather_facts: false não é uma otimização. A recolha de factos liga-se ao anfitrião do inventário, e o anfitrião do inventário é uma VM que ainda não foi construída. Deixa-a ligada e o play falha antes da primeira tarefa.
Depois, cada tarefa do Proxmox leva delegate_to: localhost:
- name: Create Proxmox VM
  delegate_to: localhost
  register: created_vm
  community.proxmox.proxmox_kvm:
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    api_host: "{{ proxmox_api_ip }}"
    name: "{{ inventory_hostname }}"
    node: "{{ proxmox_api_host }}"
    ...
O anfitrião do inventário passa a ser apenas um nome e um saco de variáveis. O inventory_hostname torna-se o nome da VM; as suas variáveis descrevem a máquina que queres. Nada se liga a ele. A tarefa corre no nó de controlo, que abre uma sessão HTTPS para o api_host e envia uma definição de VM.
Também vais ver isto escrito como local_action:, que é a sintaxe mais antiga para a mesma coisa. O playbook de remoção nesse repositório usa-a em todo o lado. São equivalentes. O delegate_to é a forma atual.
A saída de emergência aponta para o nó
Algumas coisas têm mesmo de acontecer num anfitrião Proxmox, e essas tarefas delegam para um sítio completamente diferente:
- name: Fail if no ISO file exists for the OS
  delegate_to: "{{ proxmox_api_host }}"
  ansible.builtin.stat:
    path: "{{ iso | replace('isos:', '/mnt/pve/isos/template/') }}"
  register: iso_file
  failed_when: not iso_file.stat.exists
Isto é uma ligação SSH real a um nó real, a verificar um caminho real em armazenamento partilhado, porque a API aceita alegremente uma referência a um ISO que não corresponde a nenhum ficheiro, e mais vale descobrires agora do que no arranque. Repara na cirurgia de strings que traduz uma referência de armazenamento PVE (isos:iso/debian.iso) num caminho do sistema de ficheiros. A abstração de armazenamento não está disponível para o stat.
Portanto, um único play tem tarefas a executar em três sítios diferentes, e confundi-los é a forma mais comum de estes playbooks falharem:
qm é a única parte que precisa de SSH para um hipervisor.Credenciais, e uma predefinição prestes a mudar
As opções de autenticação são partilhadas por todos os módulos da coleção através de um fragmento de documentação, por isso são as mesmas em todo o lado: api_host, api_user, e depois ou api_password ou o par api_token_id / api_token_secret. Todas recorrem a variáveis de ambiente quando não são dadas, PROXMOX_HOST, PROXMOX_USER, PROXMOX_PASSWORD, PROXMOX_TOKEN_ID, PROXMOX_TOKEN_SECRET, PROXMOX_VALIDATE_CERTS, que é a forma mais limpa de manter os segredos totalmente fora do play.
Um token de API é a melhor predefinição. Tem âmbito limitado, pode ser revogado sem mudar a palavra-passe de uma pessoa, e pode receber exatamente os privilégios de que o playbook precisa, em vez dos que uma pessoa por acaso tem:
- name: Create Proxmox VM
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    validate_certs: true
    ca_path: /etc/ssl/certs/pve-cluster-ca.pem
Define o validate_certs explicitamente, hoje. A própria documentação da coleção di-lo claramente:
Currently defaults to
falseand changes default totruewith community.proxmox 2.0.0.
O que significa que um playbook que nunca o menciona não está a validar TLS neste momento, e vai começar a validar, e portanto a falhar contra o certificado autoassinado com que vem cada instalação nova do Proxmox, no momento em que alguém correr --upgrade. Mais vale tomar essa decisão de propósito do que tê-la a cair a meio de uma construção. Se vais manter o certificado autoassinado, escreve validate_certs: false e aceita o reparo; se tens uma cadeia como deve ser, aponta o ca_path para ela. Seja como for, fica escrito.
A criação mínima viável
Reduz a tarefa de produção ao que de facto define uma máquina e ela fica legível:
- name: Create Proxmox VM
  delegate_to: localhost
  register: created_vm
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    validate_certs: true

    node: pve1
    name: "{{ inventory_hostname }}"
    cores: "{{ vcpus | int }}"
    memory: "{{ memory }}"
    machine: q35
    bios: ovmf
    ostype: l26
    scsihw: virtio-scsi-single
    scsi:
      scsi0: "vmdata:32,format=qcow2,discard=on,ssd=1"
    sata:
      sata0: "isos:iso/debian-13-netinst.iso,media=cdrom"
    net:
      net0: "virtio,bridge=vmbr0"
    efidisk0:
      storage: vmdata
      format: raw
      efitype: 4m
      pre_enrolled_keys: true
    boot: "order=scsi0;sata0"
    agent: "enabled=1,fstrim_cloned_disks=1"
    onboot: true
    tags:
      - production
Vale a pena saber algumas coisas sobre esta forma antes de escreveres a tua.
As opções de dispositivo são sintaxe PVE dentro de YAML. scsi, sata, net, virtio, ide são todas do tipo dict, com chaves scsi0, net0 e por aí fora, e os valores são as strings de opções separadas por vírgulas tiradas diretamente do man qm: <storage>:<size>,option=value para um disco, [model=]<enum>,option=value para uma NIC. O módulo não as modela; reencaminha-as. Quando algo é rejeitado, a resposta está na referência de opções do PVE, não na documentação do Ansible.
Também vais ver isto escrito como string JSON em vez de um mapeamento YAML:
net: '{"net0":"virtio,bridge={{ vlan_bridge }}"}'
Ambas funcionam. O Ansible converte a string para um parâmetro do tipo dict. A forma JSON existe porque é mais fácil gerar uma estrutura inteira numa só expressão Jinja. A forma de mapeamento é mais fácil de ler seis meses depois.
O boot tem duas gerações de sintaxe. O módulo aceita as letras antigas, em que boot: "cdn" significa «tenta o disco, depois o CD-ROM, depois a rede». O PVE atual quer uma lista ordenada explícita, boot: "order=scsi0;sata0;net0", que não deixa dúvidas sobre qual disco. A forma antiga continua a funcionar. A forma explícita é a que queres em trabalho novo. Uma verdadeira ratoeira enterrada na documentação do módulo: o arranque pela rede requer definir rng0 desde o PVE 8.3.5.
numa e numa_enabled são parâmetros diferentes. O numa_enabled é o booleano que liga o NUMA. O numa é um dict que descreve uma topologia (cpus, hostnodes, memory, policy). Definir numa: true é um erro de tipo, e é uma hora fácil de perder. Se queres saber porque é que isto importa, o alinhamento NUMA no Proxmox trata do problema de fundo.
machine: q35 e bios: ovmf são as predefinições certas, não decoração: esse argumento por inteiro.
Omitir o vmid significa que o módulo pede à API o próximo ID livre. Conveniente, e a causa direta da coisa seguinte.
Porquê serial: 1
«Ir buscar o próximo ID disponível, e depois criar uma VM com ele» são duas chamadas à API com um intervalo no meio. Dois workers a fazer isso ao mesmo tempo podem ler o mesmo ID livre, e o perdedor recebe um erro ou, pior, uma surpresa.
O serial: 1 faz a fase de criação um anfitrião de cada vez. Não é rápido e não precisa de ser. A parte cara de construir uma VM acontece depois de este playbook passar o testemunho. O play correspondente que arranca as VMs terminadas usa serial: 5, porque arrancar não tem nenhum contador partilhado onde haja corrida.
Se preferires ter o paralelismo, atribui tu o VMID a partir da tua fonte de verdade e passa-o explicitamente. Assim não há ler-modificar-escrever nem corrida.
A idempotência não é o que esperas
Esta é a secção para ler duas vezes, porque o proxmox_kvm não se comporta como o ansible.builtin.package.
O name não é uma identidade. Os nomes das VMs não são únicos num cluster Proxmox, e o módulo di-lo. Com state: present e sem vmid, se já existir uma VM com esse nome, o módulo sai com changed=false e msg: "VM with name <x> already exists" e não faz nada. Não compara os teus parâmetros com a realidade. Não converge. Recusa-se.
O update tem false por predefinição. Por isso editar o memory: no teu playbook e voltar a executar não faz nada. A VM fica com a memória com que foi construída, a tarefa reporta sucesso, e nada em lado nenhum te diz que as duas divergiram.
O update: true continua a recusar os parâmetros interessantes. Da documentação do módulo:
Because of the operations of the API and security reasons, I have disabled the update of the following parameters
net,virtio,ide,sata,scsi. Per example updatingnetupdate the MAC address andvirtiocreate always new disk…
O update_unsafe: true levanta essa restrição, e o aviso não está lá para enfeitar:
Use this option with caution because an improper configuration might result in a permanent loss of data (for example disk recreated).
Portanto, o disco que julgavas estar a redimensionar pode ser substituído por um novo e vazio. Não vás por aí: os parâmetros recusados têm os seus próprios módulos, e isso é a secção seguinte.
E o --check não cobre nada disto. A coleção declara o suporte de modo de verificação módulo a módulo, e é inconsistente exatamente na direção errada:
| Módulo | check_mode | diff_mode |
|---|---|---|
proxmox_kvm | nenhum | nenhum |
proxmox_disk | nenhum | nenhum |
proxmox_template | nenhum | nenhum |
proxmox_snap | total | nenhum |
proxmox_nic | total | nenhum |
proxmox_pool | total | nenhum |
A divisão não é «os módulos só de leitura podem, os de escrita não», porque o proxmox_nic cria e apaga interfaces e respeita perfeitamente o modo de verificação. É que os três módulos que lidam com armazenamento e ciclo de vida das VMs não o fazem. Uma execução --check de um playbook de construção salta em silêncio a criação da VM e depois reporta sobre um mundo onde a VM nunca foi feita, por isso cada tarefa a seguir está a raciocinar sobre o estado errado. Num playbook de construção, o --check não é uma rede de segurança, e tratá-lo como tal é pior do que não o correr.
Então faz da existência a barreira
Dado tudo isso, o padrão que funciona é deixar de pedir ao módulo que seja idempotente e decidir tu se deves construir. O playbook de produção fá-lo assim:
- name: Check if VM is present or manually built
  delegate_to: localhost
  community.proxmox.proxmox_vm_info:
    api_host: "{{ proxmox_api_ip }}"
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    name: "{{ inventory_hostname }}"
    config: current
  register: existing_vm
  ignore_errors: true
  failed_when: (existing_vm.proxmox_vms | length) == 0

- name: Configure Proxmox VM
  when: existing_vm is failed
  block:
    - name: Create Proxmox VM
      ...
O proxmox_vm_info com config: current devolve a VM e a sua configuração ativa, ou uma lista vazia. O failed_when transforma «lista vazia» numa falha, o ignore_errors: true impede essa falha de terminar o play, e o when: existing_vm is failed passa a ser «a VM não está lá, constrói-a».
Usar uma tarefa deliberadamente falhada como booleano lê-se mal, e não vou fingir o contrário. A alternativa é when: (existing_vm.proxmox_vms | default([]) | length) == 0, que é honesta quanto a ser uma verificação de comprimento e não precisa de ignore_errors. Ambas funcionam. A versão acima é a que está em produção, e a sua única vantagem real é que o resultado registado traz a configuração existente para as tarefas seguintes lerem.
O que importa é a forma, não a grafia: verifica, depois ramifica, e trata a criação como um acontecimento único. A configuração contínua de uma VM é um problema diferente da existência de uma VM, e este módulo só é bom no segundo.
Discos e NICs têm os seus próprios módulos
Eis a coisa por que passei por cima acima, e muda o quadro todo: os parâmetros que o proxmox_kvm se recusa a atualizar não são uma lacuna na coleção. São delegados. O community.proxmox.proxmox_disk e o community.proxmox.proxmox_nic acrescentam, alteram e removem exatamente as coisas em que o módulo de criação não toca, com chaves nos mesmos nomes scsi0 e net0 que usaste quando construíste a VM.
Ambos se portam melhor do que o proxmox_kvm, e um deles é o único módulo neste fluxo de trabalho que pode ser ensaiado a seco.
proxmox_nic — Acrescentar, mudar a tag ou remover uma interface
- name: Move the VM's primary NIC to a new bridge and VLAN
  delegate_to: localhost
  community.proxmox.proxmox_nic:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    vmid: "{{ created_vm.vmid }}"
    interface: net0
    bridge: vmbr1
    tag: 120
    model: virtio
    mtu: 1
    queues: 4
    firewall: true
    state: present
O interface é a única opção obrigatória além da autenticação, net[n] em que n vai de 0 a 31, e state: present ou absent dá-te acrescentar e remover. O model tem virtio por predefinição, que é a resposta certa a não ser que um convidado não aguente.
A razão de este módulo existir é o endereço MAC. Lembra-te porque é que o proxmox_kvm se recusa a atualizar o net: «updating net update the MAC address». O proxmox_nic resolve isso explicitamente:
When not specified this module will keep the MAC address the same when changing an existing interface.
Portanto, podes mudar a tag de uma VLAN, mudar de bridge, alterar o MTU ou ligar a firewall sem que a identidade da NIC do convidado mude por baixo dele. Isso importa mais do que parece: um MAC novo invalida reservas DHCP, estraga tudo o que esteja licenciado a uma NIC, e dessincroniza o registo de interface do NetBox que o playbook de criação escreveu com tanto cuidado. Este é o módulo que deixa uma alteração de rede do dia 2 ser aborrecida.
Algumas opções que vale a pena conhecer antes de precisares delas:
- O
rateé em MBps, MegaBytes por segundo, não bits. A documentação é explícita e o erro de um fator de oito é muito fácil de cometer. link_down: truedesliga a interface, descrito na documentação como «like pulling the plug». Uma forma limpa de isolar uma VM suspeita sem a parar nem tocar no convidado.trunksrecebe uma lista de IDs de VLAN a deixar passar, para um convidado que faz as suas próprias tags.mtu: 1não é gralha nem um MTU de 1 byte: significa «herda o MTU da bridge», e só se aplica aovirtio.queuesdefine o multiqueue, de 0 a 16. Vale a pena igualar ao número de vCPUs em tudo o que tenha tráfego a sério.
E suporta totalmente o modo de verificação. O --check numa tarefa proxmox_nic diz-te a verdade, o que faz dele a única parte deste fluxo de trabalho que podes ensaiar em segurança. As suas mensagens também são devidamente idempotentes. Uma interface inalterada reporta Nic net0 unchanged on VM with vmid 103 em vez de alegar uma alteração.
proxmox_disk — O ciclo de vida completo do disco
O proxmox_disk é o maior módulo dos três, e o seu state faz cinco trabalhos diferentes:
state | O que acontece | Reversível? |
|---|---|---|
present | cria o disco, ou atualiza as opções de um existente | n/a |
resized | aumenta-o; o PVE não consegue encolher, e a documentação diz para o fazer à mão | não |
detached | passa a unused[n]; o volume e os seus dados ficam | sim |
moved | muda o armazenamento de suporte, ou entrega o disco a outra VM | original mantido salvo delete_moved |
absent | removido do armazenamento de suporte | não |
O espaço entre detached e absent é a rede de segurança que o proxmox_kvm nunca te dá. Desanexar é uma alteração de configuração; apagar destrói dados. Duas palavras diferentes, duas consequências diferentes.
Acrescentar um segundo disco a uma VM que já existe:
- name: Add a data disk
  delegate_to: localhost
  community.proxmox.proxmox_disk:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    vmid: "{{ created_vm.vmid }}"
    disk: scsi1
    storage: vmdata
    size: 200
    format: qcow2
    iothread: true
    aio: io_uring
    discard: "on"
    ssd: true
    backup: true
    state: present
O create é o botão que o proxmox_kvm devia ter tido. Controla o que o state: present pode fazer:
regular(a predefinição): cria o disco se faltar, caso contrário atualiza as suas opções.disabled: só atualiza opções, e nunca cria. É o que deves usar quando estás a mudarcacheouiothreadnum disco que tem de já existir. Não te pode surpreender a fazer aparecer um volume novo porque uma chave estava mal escrita.forced: cria sempre. Um disco existente é desanexado e deixado sem uso, não apagado.
Esse último comportamento é o pormenor importante. O create: forced é a opção com ar destrutivo, e mesmo assim não destrói nada: o volume antigo sobrevive como unusedN e podes voltar a anexá-lo. Compara isso com o proxmox_kvm mais update_unsafe, cujo modo de falha documentado é um disco recriado. Mais ou menos a mesma operação, raio de explosão muito melhor.
Aumentar um disco:
- name: Grow the data disk by 100 GiB
  delegate_to: localhost
  community.proxmox.proxmox_disk:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    vmid: "{{ created_vm.vmid }}"
    disk: scsi1
    size: "+100G"
    state: resized
Atenção às unidades, porque o size muda de significado com o state. Com state: present é GiB como número simples (size: 200). Com state: resized leva um sufixo: +100G para somar ao tamanho atual, ou 500G como alvo absoluto. Um parâmetro, duas convenções, e a falha é silenciosa se adivinhares mal.
Mover um disco para outro armazenamento, que é o caso da migração ao vivo de um só volume:
- name: Move the disk to NVMe storage
  delegate_to: localhost
  community.proxmox.proxmox_disk:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    vmid: "{{ created_vm.vmid }}"
    disk: scsi1
    target_storage: nvme-pool
    bwlimit: 200000
    delete_moved: true
    timeout: 3600
    state: moved
O target_storage move dentro de uma VM; o target_vmid entrega o disco a outra VM e requer o mesmo armazenamento em ambas. São mutuamente exclusivos. O delete_moved tem false por predefinição, por isso, por omissão, acabas com duas cópias e o original ali parado como não usado: seguro, e uma boa forma de encher um pool de armazenamento se nunca lá voltares.
O timeout tem 600 por predefinição aqui, contra 30 no proxmox_kvm. Parâmetro com o mesmo aspeto, diferença de vinte vezes, porque estas operações copiam dados. Aumenta-o para imagens grandes ou armazenamento lento; a documentação di-lo tanto para moved como para import_from.
O que nos leva à opção que faz deste módulo o caminho para V2V e imagens cloud:
import_from: "vmdata:9000/base-debian13.qcow2"
O import_from constrói o disco a partir de um volume existente em vez de alocar um vazio: <STORAGE>:<VMID>/<NAME>, ou <STORAGE>:import/<NAME> usando o diretório de importação do armazenamento no PVE 9.x e posteriores. É mutuamente exclusivo com size, e só o root pode usar caminhos absolutos do sistema de ficheiros.
O resto da lista de parâmetros é a razão para anexar discos com este módulo em vez de diretamente na chamada de criação: cache, aio, iothread, discard, ssd, backup, detect_zeroes, e toda a família de limitação, iops, iops_rd, iops_wr, as variantes _max e _max_length, e os controlos de rajada bps_*_max_length. Nada disso é alcançável através do proxmox_kvm depois da criação.
Duas ressalvas, ambas da própria documentação do módulo:
- Algumas alterações de opções precisam de reinício. «Some updates on options (like
cache) are not being applied instantly and require VM restart.» Uma tarefa verde significa que a configuração foi escrita, não que a VM em execução se esteja a comportar de forma diferente. - Não suporta o modo de verificação.
check_mode: none, tal como oproxmox_kvm. Por isso a coleção divide-se ao meio: as alterações de NICs podem ser ensaiadas com--check, as de discos não.
A divisão do trabalho
| Para fazer isto | Usa |
|---|---|
| Criar a VM | proxmox_kvm, uma vez, condicionado à existência |
| Mudar cores, memória, tags, agent, onboot | proxmox_kvm com update: true |
| Acrescentar, mudar a tag, desligar ou remover uma NIC | proxmox_nic |
| Acrescentar, aumentar, mover, desanexar ou remover um disco | proxmox_disk |
| Snapshot | proxmox_snap (também com modo de verificação total) |
| Tudo o que nenhum deles expõe | qm set por SSH |
Mudar um disco ou uma NIC através do proxmox_kvm | nada: é para isto que serve o update_unsafe, e é por isso que não o deves usar |
Constrói a VM com uma chamada mínima ao proxmox_kvm, e depois anexa os discos e as interfaces com os seus próprios módulos. São mais tarefas, e é a versão em que as alterações do dia 2 têm um caminho que não envolve uma opção cujo risco documentado é perder um disco.
Onde o módulo para
O proxmox_kvm tem uma lista enorme de parâmetros e mesmo assim não cobre tudo o que o qm consegue fazer. Em vez de esperar, o playbook de produção desce para a linha de comandos no nó:
- name: Set RNG source and better SPICE quality
  delegate_to: "{{ proxmox_api_host }}"
  become: true
  ansible.builtin.command:
    cmd: >-
      /usr/sbin/qm set {{ created_vm.vmid }}
      --rng0 source=/dev/urandom
      --spice_enhancements videostreaming=all
Não há nada de errado nisto. Não é idempotente em nenhum sentido útil, porque o qm set é uma escrita e vai reportar changed em cada execução, mas é explícito, é legível, e não finge. Se um módulo ganhar o parâmetro mais tarde, apagas a tarefa.
Outras coisas precisam de uma segunda passagem pelo módulo com update: true, porque não podem ser definidas na mesma chamada que cria a VM:
- name: Add SPICE-compatible USB device
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    node: "{{ proxmox_api_host }}"
    vmid: "{{ created_vm.vmid }}"
    usb:
      usb0: "spice,usb3=1"
    update: true
  when: spice_usb | default(false)
Repara que passa o vmid, não o name. Assim que tens o ID, usa-o. É o único identificador que a API trata como único.
E para as coisas que o QEMU consegue fazer e para as quais o PVE não tem opção, há o args, que é passado tal e qual para a linha de comandos do QEMU:
    args: >-
      -global scsi-hd.physical_block_size=4k
      -global scsi-hd.logical_block_size=4096
Esse apresenta o disco virtual como 4Kn em vez de 512e, o que importa mais do que parece: tamanhos de bloco, 4Kn e 512e. O módulo marca o args como «for experts only», e a razão é que o PVE não o valida e uma flag errada impede a VM de arrancar com um erro que vem do QEMU e não do Proxmox.
O cluster não é instantaneamente consistente
- name: Let registration complete on cluster
  ansible.builtin.pause:
    seconds: 5
  when: created_vm.changed
Uma pause num playbook costuma ser mau sinal, e esta aguenta peso. A chamada de criação regressa quando a API aceitou a definição, o que não é o mesmo que todos os nós concordarem que a VM existe, e a tarefa seguinte quer definir uma ACL em /vms/<vmid>. Cinco segundos de paciência saem mais baratos do que um ciclo de repetição à volta de um erro que só aparece sob carga.
O playbook de remoção tem a mesma forma pela mesma razão: parar, esperar, depois apagar.
Ler de volta o que construíste
O proxmox_kvm documenta três valores de retorno: vmid, status e msg. Na prática vais querer um quarto, e ele não está na documentação.
- name: Get MAC address of VM
  ansible.builtin.set_fact:
    primary_mac_addr: "{{ created_vm.mac.net0 }}"
O created_vm.mac é real, o módulo constrói-o em get_vminfo() e despeja-o no resultado, mas não consta do bloco RETURN documentado, o que significa que nada promete que continue a funcionar. Vale a pena saber exatamente como se comporta, porque tem duas armadilhas:
- Só aparece quando o módulo criou de facto a VM. O
macsó é montado no caminho de criar e implementar. Vai pelo ramo «already exists» e o resultado temvmidemsge mais nada. - Só contém as interfaces que passaste. O código percorre os parâmetros que tu forneceste e escolhe os que correspondem a
net[0-9], depois lê a configuração guardada de cada um a partir da API. Sem parâmetronet, não há chavemac.
É por isso que o playbook de produção precisa das duas metades, e a segunda é feia:
- name: Get MAC address of VM
  ansible.builtin.set_fact:
    primary_mac_addr: >-
      {{ created_vm.mac.net0 if created_vm is defined and created_vm.changed
         else ((existing_vm.proxmox_vms[0].config.net0 | split(','))[0] | split('='))[1] }}
Quando a VM já existia, não há mac, por isso o MAC tem de ser escavado da string de configuração em bruto. O net0 volta da API como virtio=AE:AE:5C:A8:89:85,bridge=vmbr0, portanto: divide pelas vírgulas, fica com o primeiro campo, divide pelo =, fica com a segunda metade. É cirurgia de strings numa resposta de API, e é o custo honesto de um módulo cuja forma de retorno depende do ramo que seguiu.
Se precisas do MAC de forma fiável nos dois casos, vai buscá-lo ao proxmox_vm_info incondicionalmente e analisa uma forma em vez de duas.
Conduzi-lo a partir de uma fonte de verdade
Olha outra vez para a linha que abre o play:
hosts: "{{ target_hosts | default('cluster_pve:&status_planned') }}"
Essa é a arquitetura real, e vale a pena dizê-lo claramente: as VMs a construir não são uma lista num ficheiro de variáveis. São os anfitriões do teu inventário cujo estado registado diz que deviam existir e ainda não existem.
O inventário aqui é o NetBox. Uma VM é pedida criando um registo no NetBox com o estado planned, com o seu CPU, memória, disco, VLAN, dono e plataforma. O playbook seleciona as máquinas planned, constrói-as, atribui um IP, escreve o DNS, e depois põe o registo em staged, momento em que esse anfitrião deixa de corresponder ao padrão de anfitriões do play, e um handler atualiza o inventário para que o play seguinte veja o novo estado:
handlers:
  - name: Refresh inventory
    ansible.builtin.meta: refresh_inventory
O campo de estado é uma máquina de estados, o playbook é uma transição dentro dela, e a coisa toda pode ser executada de novo porque um anfitrião que já avançou deixa de ser selecionado. Essa é uma propriedade muito melhor do que qualquer quantidade de idempotência ao nível do módulo, e é a razão pela qual a tarefa de criação se pode dar ao luxo de ser de uma só vez.
O community.proxmox também traz o seu próprio plugin de inventário, que constrói um inventário a partir do cluster: a escolha certa quando o Proxmox é a fonte de verdade. Aqui é ao contrário: o NetBox é a autoridade e o Proxmox é onde a sua intenção se concretiza. Isso dá um artigo inteiro e vou escrevê-lo à parte.
Desfazer tudo outra vez
Criar sem remover é meio ciclo de vida, e o caminho de remoção tem a sua própria armadilha: não podes apagar uma VM em execução:
- name: Force stop the VM if it is running
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    name: "{{ inventory_hostname }}"
    state: stopped
    force: true
    timeout: 10

- name: Allow the cluster to stop the VM before removing it
  ansible.builtin.pause:
    seconds: 10

- name: Remove the VM from the cluster
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    name: "{{ inventory_hostname }}"
    state: absent
    force: true
    timeout: 10
O state: stopped é um encerramento ordenado, e a interação com o timeout está documentada e vale a pena decorar: se o tempo limite for atingido com force: true, a VM é desligada à força; com force: false, a tarefa falha. Uma janela ordenada de dez segundos seguida de puxar a ficha é uma política razoável para uma máquina que está a ser desmantelada, e péssima para qualquer outra coisa.
A remoção completa (proxmox-remove-vms.yml) desfaz depois o resto do registo: o DNS, o IP atribuído, as interfaces no NetBox, a VM no NetBox, e as entradas obsoletas no known_hosts. Envolve o bloco em ignore_errors: true, o que se defende numa remoção. Estás a remover coisas que podem já ter desaparecido, e uma máquina meio apagada é pior do que um registo barulhento.
O que eu mudaria numa construção de raiz
Tendo lido o código-fonte do módulo e não só a documentação, cinco coisas:
- Usa um token de API, não
api_usermaisapi_password. Com âmbito limitado, revogável, e nunca pertence a uma pessoa. - Define o
validate_certsexplicitamente, antes que a 2.0.0 o mude por baixo de ti. - Atribui tu o VMID a partir da fonte de verdade. Elimina a corrida de ler-modificar-escrever, deixa-te abandonar o
serial: 1, e dá a cada tarefa seguinte um identificador estável em vez de um nome que não é único. - Cria a VM despida, e depois anexa os discos e NICs com
proxmox_diskeproxmox_nic. Mais tarefas, mas cada disco e interface passa a ter um módulo que o pode alterar mais tarde, incluindocreate: disabledpara edições só de opções estate: detachedem vez de apagar, em vez de uma configuração que só pode ser mudada através doupdate_unsafe. - Vai buscar o MAC ao
proxmox_vm_infonum só sítio, para haver uma forma a analisar em vez de uma condição entre um valor de retorno documentado e um não documentado.
E não recorras ao --check num playbook de construção. O módulo que importa não o consegue respeitar.
Um ensaio a seco que diz sempre que sim é pior do que nenhum ensaio, porque vais acreditar nele.
Referências
- Documentação da coleção community.proxmox — a superfície completa de 47 módulos
- community.proxmox no GitHub — onde vive o código acima;
plugins/modules/proxmox_kvm.pyé o ficheiro a ler quando a documentação é ambígua - Documentação do módulo
proxmox_kvm— a lista de parâmetros, e os avisos deupdate/update_unsafecitados acima - Documentação do módulo
proxmox_vm_info—config: currenteconfig: pending - Referência de opções
qmdo PVE — a verdadeira especificação de cada stringscsi[n],net[n]ebootque passas - proxmoxer — o cliente Python sobre o qual a coleção é construída
- damo2929/ansible-example — os playbooks de onde vêm estes excertos, incluindo o inventário conduzido pelo NetBox, a geração de DHCP e a construção do hipervisor