LLM na NPU Ryzen AI, w kontenerze
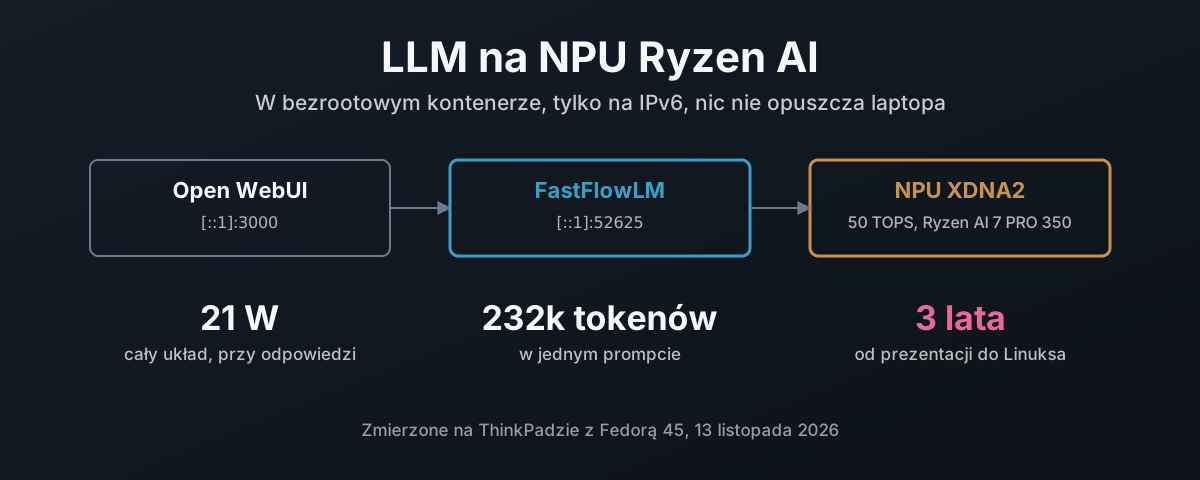
NPU w laptopie z Ryzen AI to 50 TOPS, które na większości instalacji Linuksa stoją bezczynnie. Tu przechodzisz przez zbudowanie sterownika amdxdna od AMD z zostawieniem na hoście tylko modułu jądra, zbudowanie FastFlowLM z runtime’em XRT od AMD w bezrootowym kontenerze podmana dopasowanym do tego sterownika, przypięcie wszystkiego do pętli zwrotnej IPv6 i uruchamianie przy starcie przez Quadlet. Potem to, co to robi: dziewięć modeli w benchmarku, test kontekstu na 232 000 tokenów, rozpoznawanie mowy Whisperem dziesięć razy szybciej niż w czasie rzeczywistym, Open WebUI i 7000 ukrytych tokenów, które doklejało do każdej wiadomości, oraz szybkość i zużycie energii NPU zmierzone w porównaniu z llama.cpp na zintegrowanym Radeonie 860M. Na koniec oś czasu: trzy lata od ogłoszenia Ryzen AI przez AMD do modelu językowego na jego NPU pod Linuksem, dostarczonego przez projekt, którego AMD nie zaczęło, podczas gdy wysiłek szedł w Copilot+ na Fisher-Price OS (Windows), a nie w centrum danych i linuksowe narzędzia, których naprawdę używają zawodowcy od AI.