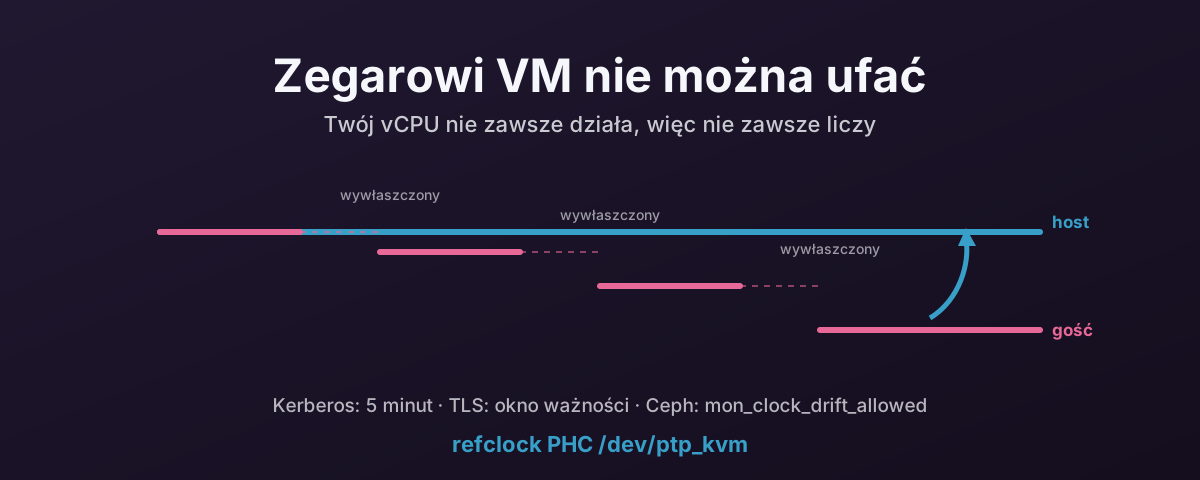
Założenie, które robi każdy zegar
Zegar komputera działa tak, że liczy coś regularnego i ufa, że to liczenie trwa. Kryształ oscyluje, licznik się zwiększa, a oprogramowanie przelicza, ile czasu minęło.
Wirtualizacja łamie część z zaufaniem.
Dokumentacja jądra o mierzeniu czasu w KVM ujmuje problem w jednym zdaniu: „the virtual operating system does not run with 100% usage of the CPU, despite the fact that it may very well make that assumption.” Wszystko poniżej z tego wynika.
Twój vCPU nie zawsze działa
vCPU to wątek na hoście. Działa wtedy, gdy pozwoli mu planista hosta.
Gdy nie działa, gość nie jest po prostu bezczynny: jest nieobecny. Nie może liczyć, nie może obsłużyć przerwania zegarowego i nie ma jak się dowiedzieć, jak długo go nie było. Host śledzi to jako steal time, co jest uczciwą nazwą na „czas, który ci się przydarzył, a nie był dla ciebie”.
Najbardziej boli to przy przerwaniach zegarowych. Gość, który prosi o okresowy tick, prosi hosta o dostarczanie przerwań ze stałą częstotliwością, a host nie zawsze może to zapewnić. Znowu z dokumentacji jądra: „the host virtualization engine may not be able to deliver the proper number of interrupts per second, and so guest time may fall behind.”
Im wyższa częstotliwość ticków, tym gorzej, a przeciążony host pogarsza to jeszcze bardziej. To też powód, dla którego zajęty host psuje mierzenie czasu spokojnym gościom. Wszyscy stoją w kolejce do tych samych fizycznych rdzeni.
Liczniki też nie są twoje
Jeśli okresowe ticki są niewiarygodne, oczywista odpowiedź to czytać licznik. To ma własne problemy.
TSC jest tym szybkim, a dokumentacja jądra mówi o nim bez ogródek: „The TSC is a CPU-local clock in most implementations… the TSCs of different CPUs may start at different times.” Jego tempo może się zmieniać ze stanami zasilania procesora, a na starszych układach staje całkiem, gdy rdzeń jest bezczynny. vCPU, który migruje między fizycznymi rdzeniami, może więc odczytać licznik, który nie zgadza się z tym, który odczytał mikrosekundę temu.
Alternatywy są gorsze w inny sposób. HPET, PIT i zegar ACPI PM to urządzenia emulowane, więc każdy odczyt to pułapka do hiperwizora. Poprawne i na tyle drogie, że gość czytający zegar w gorącej pętli to zauważy.
Dlatego istnieją zegary parawirtualne. Na KVM kvm-clock pozwala hostowi publikować własny pomiar czasu we współdzielonej strukturze, którą gość czyta bezpośrednio: bez pułapki, bez liczenia, bez założenia, że gość był przytomny.
To też powód, by zostawić źródło zegara gościa w spokoju, zamiast wymuszać tsc albo hpet, bo post na forum mówił, że jest szybszy.
Migracja, snapshoty i uśpienie
Migracja na żywo, przywrócenie snapshotu i uśpienie z wybudzeniem robią z zegarem gościa to samo: zatrzymują go, a potem uruchamiają znowu gdzie indziej.
To, co widzi gość, to nie dryf, tylko skok. Zegar miał jedną wartość, a teraz ma inną, a pomiędzy nie ma nic. Migracja na host, którego TSC chodzi z inną częstotliwością, jeszcze to pogarsza.
Skoki mają znaczenie, bo oprogramowanie korygujące zegary zbudowano do korygowania dryfu, a nie teleportacji.
To nie jest problem KVM
Kusi, żeby czytać to wszystko jako słabość KVM. To nie to.
Każdy hiperwizor ma zegar parawirtualny, bo każdy hiperwizor ma ten sam problem konstrukcyjny: KVM ma kvm-clock, Hyper-V ma swoją stronę referencyjnego TSC, VMware ma pseudolicznik wydajności plus synchronizację przez Tools, Xen ma swój pvclock. To cztery niezależne implementacje jednego obejścia.
Wniosek samej dokumentacji jądra jest taki, że nie ma tu idealnego rozwiązania. Są tylko kompromisy między dokładnością, wydajnością i złożonością.
Jeśli wolisz to usłyszeć od producenta, a nie od programistów jądra, granica wsparcia Microsoftu dla czasu wysokiej dokładności jest zaskakująco szczera. Żeby deklarować dokładność 50 ms na zwirtualizowanym systemie Windows, jednym z podanych wymagań jest to, że „the one-day average CPU utilization of the host must not exceed 90%.” Dla 1 ms host musi zostać poniżej 80%.
Przeczytaj to jeszcze raz: dokładność zegara gościa jest udokumentowana jako zależna od tego, jak zajęty jest host. To nie dziwactwo Windowsa, to ta sama fizyka, którą opisuje dokumentacja jądra, zapisana jako granica wsparcia.
Dlaczego NTP w gościu to złe narzędzie
NTP jest dobry w tym, do czego go zaprojektowano: maszyna z prawdziwym oscylatorem, który chodzi trochę za szybko albo za wolno, korygowana przez pomiar czasu w obie strony do zdalnego serwera i łagodne przyspieszanie lub spowalnianie lokalnego zegara.
Każde z tych założeń w VM się chwieje.
Lokalny oscylator nie jest trochę nie tak, tylko co jakiś czas go nie ma. Pomiar w obie strony robi proces, który może zostać wywłaszczony między odczytem zegara a wysłaniem pakietu, co psuje sam pomiar. A korekty potrzebne po migracji to skoki, z którymi algorytm łagodnej korekty radzi sobie źle albo wprost odmawia.
chrony radzi sobie tu dużo lepiej niż ntpd. Szybciej koryguje, toleruje skoki i jest uczciwy co do własnej niepewności. Ale dalej rozwiązuje zły problem: ciągnie czas przez sieć z serwera stratum 2 oddalonego o 20 ms, podczas gdy poprawny czas leży w hiperwizorze po drugiej stronie jednej granicy pamięci.
W praktyce dostajesz gościa, który przeważnie ma rację, czasem myli się o dziesiątki albo setki milisekund i nigdy nie jest w stanie ci powiedzieć, kiedy jest które.
Co naprawdę psuje rozjazd
Nikogo nie obchodzą zegary same w sobie. Obchodzą wtedy, gdy coś przestaje działać.
Kerberos i Active Directory
Kerberos z założenia zależy od czasu, bo ważność biletu wyraża się jako okno czasowe.
Dokumentacja krb5.conf od MIT definiuje clockskew jako „the maximum allowable amount of clockskew in seconds that the library will tolerate before assuming that a Kerberos message is invalid”, a wartość domyślna to 300 sekund, czyli pięć minut.
Przekrocz to, a uwierzytelnianie nie słabnie, tylko pada.
Ponieważ uwierzytelnianie w Active Directory to Kerberos, chodzi o logowania do domeny, net use, połączenia z SQL Serverem, Exchange, udziały plików: o wszystko.
Pięć minut brzmi hojnie, dopóki gość nie cofnie się w czasie po przywróceniu snapshotu.
TLS
Certyfikat ma okno ważności: notBefore i notAfter.
Gość, którego zegar się spóźnia, odrzuci certyfikat wystawiony dziś rano, bo z jego punktu widzenia certyfikat jeszcze nie jest ważny.
Gość, którego zegar się spieszy, odrzuci taki, który wcale nie wygasł.
Ta sama arytmetyka rządzi świeżością OCSP i CRL, polami nbf/exp w JWT i kodami TOTP do uwierzytelniania wieloskładnikowego, które żyją w 30-sekundowych oknach.
Zegar przesunięty o 45 sekund to awaria uwierzytelniania z bardzo mylącym komunikatem błędu.
Ceph
Monitorom Ceph zależy na tym bardziej niż na prawie czymkolwiek innym w stosie, bo od tego zależy ich konsensus.
Kontrola zdrowia MON_CLOCK_SKEW odpala, gdy „the clocks on hosts running Ceph Monitor daemons are not well-synchronized”. Konkretnie, gdy rozjazd przekracza mon_clock_drift_allowed.
Rada z dokumentacji to synchronizacja przez ntpd albo chrony z wieloma źródłami, z zaznaczeniem, że szczególnie liczy się synchronizacja monitor z monitorem.
Możesz podnieść mon_clock_drift_allowed, ale dokumentacja jasno mówi, że musi zostać „significantly below the mon_lease interval”. W związku z tym to mały budżet, a wydawanie go na zaklejanie problemu z mierzeniem czasu w hiperwizorze to kiepska wymiana.
Cała reszta
Logi z różnych hostów przestają się ze sobą zgadzać, co zmienia oś czasu incydentu w zgadywanie. Replikacja baz danych i rozproszony konsensus (etcd, Galera, wszystko, co używa dzierżaw lidera) zaczynają się krzywić. Okna kopii zapasowych i monitoringu rozjeżdżają się z tym, co miały obserwować.
Goście Windows rozjeżdżają się inaczej
Windows zasługuje na osobną uwagę, bo jego usługę czasu zbudowano z innymi celami i to widać.
Microsoft mówi wprost, że wersje przed Windows 10 1607 / Server 2016 „can’t guarantee highly accurate time”. Usługa Windows Time zapewniała w tych wydaniach „the necessary time accuracy to satisfy Kerberos version 5 authentication requirements” oraz „loosely accurate time” dla maszyn we wspólnym lesie AD. Cokolwiek dokładniejszego było „outside of the design specification… and weren’t supported.”
Innymi słowy, starszy Windows stara się zmieścić w pięciominutowym oknie Kerberosa, a nie mieć rację. Co jest w porządku, dopóki coś w twoim środowisku nie potrzebuje więcej. Zwirtualizowany Windows przesunięty o 90 sekund będzie wesoło się uwierzytelniał, pisząc logi, których nie da się z niczym zestawić.
Windows 10 i Server 2016 wzwyż potrafią 1 s, 50 ms, a nawet 1 ms, ale tylko w warunkach zacytowanych wcześniej, łącznie z limitami obciążenia procesora hosta. Microsoft zaznacza też, że „anything that introduces network asymmetry, such as a one-way satellite connection or high CPU load on the target system, will negatively influence accuracy”. Przeciążony vCPU to wysokie obciążenie procesora na systemie docelowym pod inną nazwą.
Dla Windowsa nie ma ptp_kvm. Co masz zamiast tego:
- Usprawnienia zegara Hyper-V. Proxmox już je udostępnia gościom Windows.
PVE::QemuServer::CPUConfigustawiahv_timeobokhv_vapic,hv_spinlocks,hv_relaxedihv_synic.hv_timeto zegar parawirtualny i odpowiednikkvm-clockpo stronie Windowsa. Jest domyślnie włączony dla VM typu Windows; nie ma czego włączać. - Agent gościa QEMU. Z zainstalowanym agentem host może wepchnąć swój czas do gościa po wybudzeniu albo przywróceniu snapshotu, co załatwia przypadek skoku, z którym NTP radzi sobie najgorzej.
- Wybierz jeden autorytet. Klasyczna awaria Windowsa w VM to dwa źródła czasu, które się biją: synchronizacja host-gość i synchronizacja z hierarchii domeny, obie korygujące ten sam zegar w przeciwnych kierunkach. Dla gościa w domenie niech wygra hierarchia domeny, a host przestanie mu wpychać czas. Dla gościa samodzielnego synchronizacja z hosta jest w porządku. Nigdy obie naraz.
Jeśli chcesz wiedzieć dokładnie, co twój hiperwizor mówi danej VM o czasie, zapytaj go, zamiast zgadywać:
# Everything Proxmox actually passes to QEMU for this VM, including -rtc and CPU flags
qm showcmd <vmid> --pretty
Poprawka na QEMU/KVM: ptp_kvm
Dla gości z Linuksem na KVM jest porządna odpowiedź i nie brzmi ona „więcej serwerów NTP”.
ptp_kvm pozwala gościowi zapytać hosta, która jest godzina, bezpośrednio, przez hiperwywołanie: KVM_HC_CLOCK_PAIRING na x86 i równoważne wywołanie firmware na arm64.
Jądro przedstawia to jako urządzenie zegara sprzętowego PTP, więc z przestrzeni użytkownika wygląda jak każde inne precyzyjne źródło zegara, a chrony może go używać jako zegara referencyjnego.
Właściwości, które się liczą:
- Bez sieci. Bez jittera, bez asymetrii, bez stratum, bez pakietów. Ścieżka to granica pamięci.
- Poniżej mikrosekundy. Dokładność ogranicza hiperwywołanie, a nie podróż w obie strony przez centrum danych.
- Omija zepsutą część. Gość niczego nie liczy i nie szacuje podróży w obie strony. Czyta wartość, którą host obliczył zegarem, który chodził przez cały czas.
Wdrożenie
Zastosuj to na każdej VM z Linuksem, która ma sterownik. Hiperwizor hosta potrzebuje własnego działającego NTP albo PTP. ptp_kvm daje gościowi czas hosta, więc dziedziczy błąd hosta.
1. Ładuj moduł jądra przy starcie.
# /etc/modules-load.d/ptp_kvm.conf
ptp_kvm
2. Nadaj mu stałą nazwę i pozwól chrony go czytać.
# /etc/udev/rules.d/90-ptp-kvm.rules
ACTION=="add", SUBSYSTEM=="ptp", ATTR{clock_name}=="kvm", SYMLINK+="ptp_kvm", GROUP="chrony", MODE="0660"
Dowiązanie ma znaczenie, bo numeracja urządzeń PTP nie jest stała. /dev/ptp0 może być przy jednym starcie zegarem karty sieciowej, a przy następnym zegarem KVM. Dopasowanie po clock_name za każdym razem trafia we właściwy.
3. Wskaż go chrony i usuń pule.
Edytuj /etc/chrony/chrony.conf na Debianie i Ubuntu albo /etc/chrony.conf w rodzinie RHEL. Usuń linie pool i użyj:
refclock PHC /dev/ptp_kvm poll 2 stratum 1 delay 0.0004
Usunięcie pul to nie opcjonalne sprzątanie. Zostawienie ich każe chrony godzić lokalne źródło o dokładności poniżej mikrosekundy z serwerami w internecie oddalonymi o dziesiątki milisekund, a źródła internetowe mogą odpowiedź tylko pogorszyć.
4. Zrestartuj i sprawdź.
systemctl restart chronyd # or chrony, on Debian/Ubuntu
Weryfikacja
# The symlink exists and points at the KVM clock
ls -l /dev/ptp_kvm
cat /sys/class/ptp/ptp*/clock_name

# chrony should be using PHC0 as its selected source
chronyc sources -v

# and the offset should be microseconds, not milliseconds
chronyc tracking
W chronyc sources zegar referencyjny PHC pojawia się jako #* PHC0, gdy zostanie wybrany. # oznacza lokalne źródło sprzętowe, a nie sieciowego partnera, a * oznacza, że jest tym używanym.
Jeśli widzisz go na liście, ale niewybranego, chrony go nie przyjął: sprawdź uprawnienia do urządzenia i to, czy grupa chrony w regule udev zgadza się z użytkownikiem, jako który chrony naprawdę działa w twojej dystrybucji.
Zastrzeżenia
- Host musi mieć rację. To sprawia, że gość zgadza się z hostem, co przydaje się tylko wtedy, gdy host zgadza się z rzeczywistością. Daj hiperwizorom prawdziwe NTP albo PTP.
- Każdy gość tego potrzebuje. Flota, w której połowa VM używa
ptp_kvm, a połowa pul internetowych, to flota z dwoma autorytetami czasu. - Migracja na żywo jest w porządku i właśnie o to chodzi. Po migracji gość czyta zegar nowego hosta. O ile hosty zgadzają się między sobą, gość nigdy nie widzi skoku.
- Tylko KVM. To hiperwywołanie KVM. Zagnieżdżone albo obce hiperwizory nie pokażą urządzenia, a reguła udev po prostu nie zadziała. To czysta porażka, a nie cicha zła odpowiedź.
Czego nie robić
- Nie wymuszaj źródła zegara. Zostaw
kvm-clockw spokoju. Wymuszenietscalbohpetw wierszu poleceń jądra gościa wymienia zegar parawirtualny, zaprojektowany na tę sytuację, na licznik, który nigdy nie był twój. - Nie uruchamiaj
ntpdateanihwclockz crona. To skok według harmonogramu, czyli dokładnie to, czego nienawidzą bazy danych i Kerberos. - Nie trzymaj pul „na zapas”. Przy działającym zegarze referencyjnym to nie zapas, tylko druga opinia z gorszego źródła.
- Nie podnoś
mon_clock_drift_allowedi nie nazywaj tego naprawą. Wydałeś część budżetu, który istnieje na realia sieci, żeby tolerować problem ze znanym rozwiązaniem.
To ostatnie warto powiedzieć wprost: poszerzenie progu to nie naprawa zegara. To przesunięcie alarmu, żeby przestał dzwonić.
Źródła
- Linux kernel — KVM timekeeping — dlaczego czas gościa się spóźnia, problem TSC jako zegara lokalnego i wniosek, że istnieją tylko kompromisy
- Linux kernel — PTP_KVM — interfejs hiperwywołań stojący za urządzeniem zegara PTP
- Linux kernel — KVM x86 hypercalls —
KVM_HC_CLOCK_PAIRING, strona x86 - chrony — chrony.conf — dyrektywa
refclocki opcje sterownika PHC - MIT Kerberos — krb5.conf —
clockskewi jego domyślne 300 sekund - Microsoft — support boundary for high accuracy time — cele dokładności i warunki obciążenia procesora hosta dla systemów zwirtualizowanych
- Ceph — health checks —
MON_CLOCK_SKEW,mon_clock_drift_allowedi jego związek zmon_lease