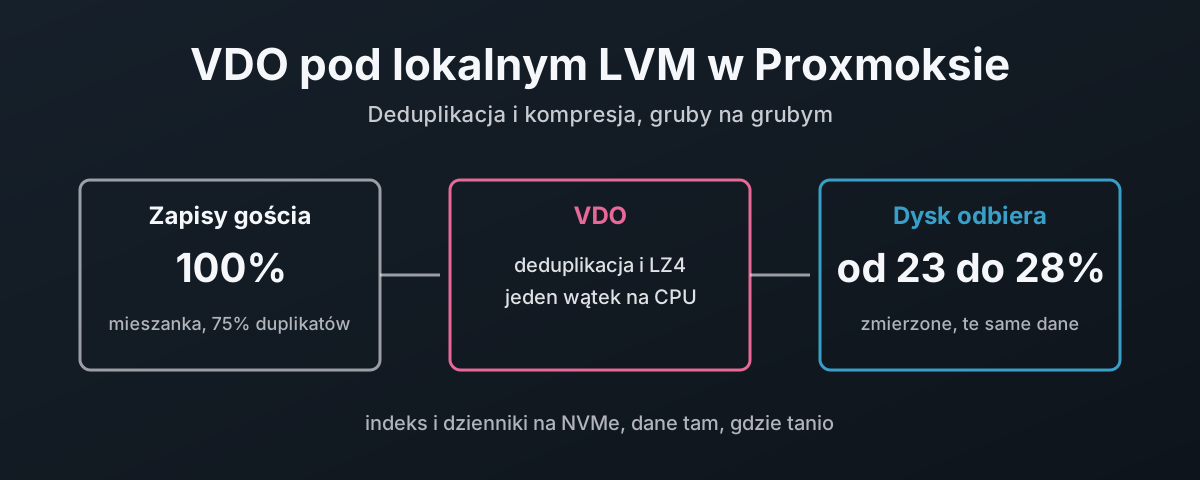
Do dysku trafia mniej bajtów
VDO to warstwa deduplikacji i kompresji w jądrze Linuksa. Siedzi pod grupą woluminów i pracuje na blokach 4 KiB. Każdy blok, który już widział, przechowuje raz.
Dla sprzętu znaczy to coś prostego. Do dysku trafia mniej bajtów. Przez VDO zapisywałem mieszankę w 75% zduplikowaną i w 50% kompresowalną, po 30 sekund naraz, a własne liczniki dysku pokazały, że odebrał od 23 do 28% tego, co zapisał gość. Sześć pełnych klonów dysku szablonu dodało łącznie 8 bloków danych. Trzydzieści dwa kilobajty.
Mniej bajtów to mniejsze zużycie i mniej pracy dla każdego cache na dysku albo w kontrolerze przed nim. Kosztuje to CPU i opóźnienie, a na szybkim dysku ten koszt jest zmierzony niżej wobec tego samego Optane bez VDO. Na wolnych dyskach talerzowych ten sam koszt znika w czasach wyszukiwania, i tu robi się ciekawie.
Dwie zasady kształtują wszystko, co dalej. Stos jest gruby na grubym: nic nad VDO, ani samo VDO, nie może obiecać więcej miejsca, niż ma dysk. A własne metadane VDO, jego indeks i dzienniki, mogą siedzieć na NVMe, podczas gdy dane siedzą gdzieś wolniej.
Każda liczba tutaj pochodzi z jednego hosta Proxmox VE 9.2, Ryzen 7 5700G z 16 CPU, jądro 7.0.14-25-pve, LVM 2.03.31 i narzędzia vdo 8.3.1.1 z Debiana, na dwóch dyskach Intel Optane, które potem wyczyszczono.
Czym jest VDO i gdzie siedzi
Jądro opisuje dm-vdo jako cel device-mappera, który „provides block-level deduplication, compression, and thin provisioning”1. Każdy przychodzący blok 4 KiB jest haszowany. Jeśli identyczny blok jest już zapisany, VDO zapisuje odwołanie zamiast kopii. Bloki, które nie są duplikatami, przechodzą przez LZ4 i są pakowane po kilka w jeden blok fizyczny, a bloki złożone z samych zer w ogóle nie są zapisywane2.
Całością steruje LVM.
lvcreate --type vdo tworzy pulę VDO, która trzyma prawdziwe bloki, i VDO LV na niej, o dowolnym rozmiarze wirtualnym, o jaki poprosisz2.
Na VDO LV idzie gruba grupa woluminów, a Proxmox używa jej jako zwykłego storage lvm.
| Warstwa | Nazwa w labie | Co robi |
|---|---|---|
| Dyski VM | vm-9901-disk-0 i tak dalej | grube LV, tworzone przez Proxmoksa |
| Grupa woluminów | vdovg, 35 GiB | zwykły LVM, to czyta storage lvm Proxmoksa |
| VDO LV | vdolab/vdolv, 35 GiB wirtualnie | deduplikacja, LZ4, bloki zerowe pomijane |
| Pula VDO | vdolab/vdopool, 40 GiB | prawdziwe bloki, metadane i indeks VDO |
| Fizyczny | nvme8n1 | VG vdolab |
Gruby na grubym albo wcale
VDO samo w sobie jest cienkim provisionerem: VDO LV może dostać dowolny rozmiar wirtualny. Ustaw go większy, niż pula może pomieścić, a grupa woluminów na nim jest gruba na obietnicy, czyli cienkie na cienkim przesunięte o warstwę niżej. Dokładnie to zrobiłem przy pierwszej budowie, VDO LV 120 GiB na puli 40 GiB, i Proxmox pokazywał jedną trzecią storage jako wolną, podczas gdy VDO było pełne.
Więc dopasuj rozmiar VDO LV do tego, co pula faktycznie może zaadresować, nie więcej.
lvcreate podaje tę liczbę, „can address 36.00 GB” na tej puli 40 GiB, a mapa bloków VDO dla przestrzeni logicznej też bierze się z tego samego miejsca, więc dałem 35 GiB.
Potem udowodniłem to w trudny sposób. Jeden dysk VM zajmujący każdy extent, jaki dał Proxmox, 34 GiB, zapełniony od końca do końca losowymi danymi, z którymi VDO nic nie zrobi:
# vdostats --human-readable
Device                    Size      Used Available Use% Space saving%
vdolab-vdopool-vpool     40.0G     38.1G      1.9G  95%            0%
Dysk skończył się na swoim własnym końcu, jak powinien gruby dysk. VDO nadal miało 1,9 GiB wolnego, więcej niż 1 GiB, który Proxmoksowi zostało do przydzielenia. Liczba Proxmoksa jest prawdziwym limitem, a VDO nie może skończyć się pierwsze.
Rezygnujesz z nadmiernego przydziału: miejsce, które oszczędza deduplikacja, objawia się jako dysk, który nigdy nie zostaje zapisany, a nie jako dodatkowe dyski dla Proxmoksa. To właściwy kompromis dla tego wpisu, który jest o sprzęcie. I nie stawiaj na tym też puli lvmthin. Dwie cienkie warstwy to dwa zestawy ksiąg3.
Ile kosztuje, zanim zapiszesz bajt
VDO trzyma indeks deduplikacji, indeks UDS, na samej puli.
Pusta pula 40 GiB zgłaszała 4,0 GiB zajęte i 36,0 GiB dostępne.
vdolistmetadata z tego samego pakietu vdo wypisuje każdy blok metadanych na urządzeniu i wyjaśnia niemal całość:
| Obszar | Bloki 4 KiB | Rozmiar |
|---|---|---|
| Indeks UDS | 679 127 | 2,59 GiB |
| Dziennik odzyskiwania | 32 768 | 128 MiB |
| Liczniki odwołań i dzienniki, 18 slabów | 6372 | 25 MiB |
| Miejsce za małe na dziewiętnasty slab | 336 555 | 1,28 GiB |
| Razem | około 4,0 GiB |
Warto znać wiersz z resztą: slaby mają 2 GiB, więc dobieraj rozmiar puli w całych slabach plus narzut, inaczej reszta po prostu leży nieużywana.
Drugi rachunek to RAM. Płacisz go niezależnie od tego, czy pula jest zajęta, czy bezczynna:
| Koszt | Reguła z lvmvdo(7) | Ta pula 40 GiB |
|---|---|---|
| Stały | 38 MiB | 38 MiB |
| Cache mapy bloków | 1,15 MiB na MiB cache, minimum 150 MiB | 150 MiB (domyślnie 128 MiB) |
| Przestrzeń fizyczna | 268 MiB na TiB | 11 MiB |
| Indeks UDS (dense) | minimum 250 MiB, domyślny | 256 MiB |
| Razem | około 455 MiB |
Domyślny indeks dense obejmuje okno deduplikacji około 256 GiB, bo indeks dense z 1 GiB RAM „maintains a 1 TiB deduplication window”2. Cache mapy bloków 128 MiB jest dobrany do „efficient access to 100 GB of logical space at a time”, a dokumentacja jądra wskazuje go jako najważniejszą wartość do zmiany, gdy rośnie zbiór roboczy1.
Budowa stosu
Pozwól LVM zobaczyć PV na LV
Grupa woluminów siedzi na LV, a LVM domyślnie ignoruje LV jako woluminy fizyczne.
devices/scan_lvs to włącza, a dokumentacja LVM podaje ostrzeżenie, które się z tym wiąże: „Caution is required to avoid using PVs that belong to guest images stored on LVs”4.
Inaczej gość, który używa LVM wewnątrz własnego dysku, miałby swoje grupy woluminów widoczne na hoście.
Więc zmienia się też filtr. Ta sama edycja. Domyślny filtr na tym hoście odrzucał tylko zvole ZFS i urządzenia RBD. Dodałem odrzucanie każdego dysku VM Proxmoksa:
# lvmconfig devices/global_filter devices/scan_lvs
global_filter=["r|/dev/zd.*|","r|/dev/rbd.*|","r|/dev/mapper/.*-(vm|base)--[0-9]+--disk--[0-9]+|"]
scan_lvs=1
Ta sama dokumentacja mówi, że scan_lvs „does not enable autoactivation of layered VGs”4.
Proxmox tego nie potrzebuje. Jego wtyczka LVM aktywuje każdy dysk poleceniem lvchange -aey, gdy VM startuje5.
Przetestowałem to tak, jak zostawia rzeczy rozruch, wszystko zdezaktywowane, a potem te same przebiegi udev pvscan: VG pod VDO się podniosła, a qm start sam aktywował dysk VM.
Haczyk jest pod spodem. Gdy VG pod VDO była niekompletna, ten sam qm start kończył się błędem „Volume group «vdovg» not found”.
Pula VDO, gruba, z ustawieniami w linii tworzenia
Formatter jest w debianowym pakiecie vdo6:
# apt install vdo
Potem pula.
-L to prawdziwe miejsce, -V rozmiar wirtualny, trzymany w granicach tego, co pula może zaadresować.
Układ wątków i rozmiar discard idą w tej samej linii, bo żadnego z nich nie da się potem zmienić bez zatrzymania każdej VM na puli:
# pvcreate /dev/nvme8n1
  Physical volume "/dev/nvme8n1" successfully created.
# vgcreate vdolab /dev/nvme8n1
  Volume group "vdolab" successfully created
# lvcreate -y --type vdo -L 40G -V 35G -n vdolv vdolab/vdopool /dev/nvme8n1 --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  Wiping vdo signature on /dev/vdolab/vdopool.
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "vdolv" created.
# dmsetup table vdolab-vdopool-vpool
0 73402368 vdo V4 /dev/dm-7 10485760 4096 32768 16380 deduplication on compression on maxDiscard 4096 ack 1 bio 2 bioRotationInterval 64 cpu 3 hash 2 logical 4 physical 4
Układ wątków to ten zmierzony niżej dla hosta z 16 CPU; max_discard=4096 ma własną sekcję.
Grupa woluminów i storage Proxmoksa
# pvcreate /dev/vdolab/vdolv
  Physical volume "/dev/vdolab/vdolv" successfully created.
# vgcreate vdovg /dev/vdolab/vdolv
  Volume group "vdovg" successfully created
# pvesm add lvm vdo-lvm --vgname vdovg --content images,rootdir --on-volume-remove discard=1
# pvesm status | grep -E "Name|vdo-lvm"
Name             Type     Status     Total (KiB)      Used (KiB) Available (KiB)        %
vdo-lvm           lvm     active        36696064               0        36696064    0.00%
on-volume-remove discard=1 ma znaczenie i jest omówione niżej.
Ile zaoszczędziła deduplikacja
Zapisywałem rzeczy, które host Proxmoksa naprawdę przechowuje, i po każdej odczytywałem liczniki bloków VDO.
logical blocks used to to, co zapisały warstwy powyżej; data blocks used to to, co zapisało VDO. Jedno i drugie w blokach 4 KiB.
| Co zapisano | Dodane bloki logiczne | Dodane bloki danych | Oszczędność |
|---|---|---|---|
| rootfs Rocky Linux 10, ext4 na dysku 4 GiB | 114 505 | 60 537 | 47% |
Sześć jego pełnych klonów (qm clone --full, ok. 4 s każdy) | 6 291 456 | 8 | 99,9999% |
| ISO Proxmox Datacenter Manager 1.1, 1,36 GiB | 356 172 | 351 965 | 1,2% |
Jego przebudowa -auto, prawie te same bajty | 356 399 | 40 | 99,99% |
| 4 GiB zer | 1 048 575 | 0 | 100% |
| 1 GiB losowych danych | 262 143 | 262 144 | 0% |
Każdy klon zapisał całe 4 GiB, zera włącznie, bo pełny klon na grube LV kopiuje każdy blok. VDO zapisało zera jako nic, a resztę jako odwołania.
VDO jest bardzo dobre w danych, które już widziało. I w niczym. Jest bezużyteczne na danych już skompresowanych albo zaszyfrowanych, dlatego pierwsze ISO, w większości squashfs, zaoszczędziło 1,2%.
Z szablonem i sześcioma klonami Proxmox pokazywał storage jako zajęty w 80,01%, 28 GiB grubych dysków z 35. Dysk trzymał 4,3 GiB, a większość z tego to był indeks. Na grubym storage o to właśnie chodzi: Proxmox liczy to, co przydzielono, a dysk nosi to, co faktycznie jest różne.
Co dysk faktycznie odbiera
Oszczędność na dysku to migawka. Sprzęt obchodzi strumień.
Zmierzyłem więc bajty docierające do dysku podczas zapisu: fio przez 30 sekund, licznik zapisów dysku z /sys/block przed i po, ten sam Optane z VDO i bez, po dwa razy.
Licznik jest uczciwy. W całym przebiegu dał w sumie 794 GB, a własne SMART „Data Units Written” dysku też przesunęło się o 794 GB.
| Obciążenie, 30 s | Bez VDO | Z VDO, 16 wątków | Bajty docierające do dysku |
|---|---|---|---|
| 4k losowy zapis, QD32, 4 zadania, 75% dup, 50% kompr. | 582 013 IOPS, p99 244 µs | 460 887 IOPS, p99 1,05 ms | 28% |
| 128k zapis, QD8, 75% dup, 50% kompr. | 2345 MiB/s, p99 490 µs | 2179 MiB/s, p99 1,02 ms | 23% |
| 4k losowy zapis, QD32, 4 zadania, dane losowe | 571 721 IOPS | od 272 366 do 381 005 IOPS | od 59 do 100% |
| 128k zapis, QD8, dane losowe | 2346 MiB/s | od 1051 do 1854 MiB/s | 100% |
Na realistycznej mieszance VDO utrzymało od 79 do 93% przepustowości gołego dysku i wysłało mu jedną czwartą bajtów. Na w pełni losowych danych nic nie oszczędza i dużo kosztuje, a dwa przebiegi różniły się tak bardzo, że podaję tylko zakres.
Opóźnienie ogona to własne przetwarzanie VDO, nie dysk. p99 około milisekundy, wobec ćwierci milisekundy na gołym dysku.
Optane nie ma cache do odciążenia
Te dyski same to mówią: vwc 0 z nvme id-ctrl, write through w /sys/block.
Optane zapisuje w miejscu, bez buforowania w DRAM czy SLC, więc na tym sprzęcie zyskiem są bajty i zużycie, a nie cache dysku, który zapełnia się wolniej.
Dysk SSD NAND z cache SLC albo kontroler RAID z cache write-back to miejsca, gdzie mniej bajtów kupuje też responsywność. O tym jest sekcja o RAID6 niżej.
Dopasowanie wątków VDO do CPU
Od razu po instalacji LVM daje VDO dziesięć wątków: jeden logiczny, jeden fizyczny, jedną strefę haszy, dwa CPU, cztery do wysyłania bio, jeden potwierdzeń. Na hoście z 16 CPU zostawia to większość maszyny bezczynną, podczas gdy praca VDO na mapie bloków stoi w kolejce za jednym wątkiem logicznym.
Dokumentacja jądra objaśnia pokrętła1. Każdy wątek logiczny ma „a disjoint section of the block map”, fizyczny „a disjoint section of the data blocks”, oba „can increase throughput”, a nadmiar wątków „can waste resources and increase contention”. Wątków logicznych może być do 60, fizycznych do 16, a pula potrzebuje co najmniej jednego slabu na wątek fizyczny. Przy 18 slabach ta ma zapas.
| Układ | logical | physical | hash | cpu | bio | ack | Razem |
|---|---|---|---|---|---|---|---|
| Domyślne LVM | 1 | 1 | 1 | 2 | 4 | 1 | 10 |
| Dopasowany do 16 CPU | 4 | 4 | 2 | 3 | 2 | 1 | 16 |
| Dwa razy tyle | 8 | 8 | 4 | 6 | 2 | 2 | 30 |
Każdy układ przeszedł te same zadania fio dwa razy, na przemian, z danymi losowymi, plus odczyt wszystkich siedmiu dysków klonów naraz, tak jak startuje razem siedem VM:
| Test, średnia z dwóch przebiegów | Domyślne | Dopasowany do 16 CPU | Dwa razy tyle |
|---|---|---|---|
| 4k losowy zapis, QD32, 4 zadania | 292 466 IOPS | 365 314 IOPS | 302 461 IOPS |
| 4k losowy zapis p99, 4 zadania | od 2,1 do 3,7 ms | od 1,5 do 1,6 ms | od 2,1 do 2,2 ms |
| 1M zapis sekwencyjny | 1153 MiB/s | 1729 MiB/s | 1507 MiB/s |
| 4k losowy odczyt, QD32, 4 zadania | 507 450 IOPS | 503 827 IOPS | 485 263 IOPS |
| Siedem dysków klonów czytanych naraz | 7,5 s | 3,1 s | 3,4 s |
Dopasowanie do liczby CPU wygrywa prawie wszystko: o ćwierć więcej równoległych zapisów, o połowę więcej przy zapisach sekwencyjnych, siedem dysków czytanych 2,4 razy szybciej i ciaśniejszy ogon. Kolejne podwojenie jest gorsze we wszystkim. To rywalizacja, przed którą ostrzega dokumentacja. Ustawienia domyślne były też najmniej stabilne, a odczyt siedmiu dysków wahał się między przebiegami od 6,1 do 8,8 s.
W związku z tym zasada to jeden wątek VDO na CPU, rozłożony na typy jak wyżej, z wątkami fizycznymi ograniczonymi liczbą slabów.
Ile VDO kosztuje na szybkim sprzęcie
Ten sam Optane bez VDO wobec VDO z dopasowanymi wątkami, dane losowe, średnia z dwóch przebiegów:
| Test | Optane, bez VDO | VDO, 16 wątków |
|---|---|---|
| 4k losowy zapis, QD1 | 42 294 IOPS, 19,4 µs | 55 806 IOPS, 12,1 µs |
| 4k losowy zapis, QD32 | 142 416 IOPS | 144 292 IOPS |
| 4k losowy zapis, QD32, 4 zadania | 572 293 IOPS | 365 314 IOPS |
| 4k losowy odczyt, QD1 | 55 276 IOPS, 14,4 µs | 27 988 IOPS, 31,4 µs |
| 4k losowy odczyt, QD32, 4 zadania | 586 463 IOPS | 503 827 IOPS |
| 1M zapis sekwencyjny, QD8 | 2348 MiB/s | 1729 MiB/s |
| Siedem dysków szablonu czytanych naraz | 11,1 s | 3,1 s |
Przeczytaj to wprost. Pojedynczy losowy odczyt przez VDO trwa ponad dwa razy dłużej. Równoległe losowe zapisy tracą ponad jedną trzecią, sekwencyjne jedną czwartą. Na tak szybkim dysku 17 µs dodatkowej pracy VDO przy odczycie to większość tego odczytu.
To, że zapis QD1 jest przez VDO szybszy, nie jest darmowym obiadem. Daleko mu do tego. VDO potwierdza zapis, zanim ten znajdzie się na dysku, a dokumentacja jądra mówi wprost, że „unflushed writes may or may not persist after a crash”1. Ta liczba mierzy potwierdzenie. Gość, który robi flush, a robi go każdy system plików, dostaje trwałość, o którą prosi.
Wiersz z siedmioma dyskami to ten, który VDO wygrywa bezdyskusyjnie, i warto jasno powiedzieć dlaczego. Siedem zwykłych kopii musi przeczytać 28 GiB prawdziwych bajtów, zera włącznie. VDO czyta jeden zestaw współdzielonych bloków i pomija zera.
Na szybkim flashu VDO zamienia więc opóźnienie na bajty. Każda z tych mikrosekund jest jednak kosztem stałym i nie rośnie, gdy dysk pod spodem jest wolniejszy.
Metadane VDO na NVMe
VDO nie ma osobnego urządzenia na metadane. Wszystko żyje na jednym LV puli. Ale źródła dm-vdo pokazują, że układ jest stały, a LV można zbudować z kawałków na różnych dyskach.
Kod formatujący umieszcza korzenie mapy bloków od początku obszaru danych, potem podsumowanie slabów i dziennik odzyskiwania od końca, a środek wypełnia slabami7.
Indeks UDS siedzi przed tym wszystkim, zaraz za blokiem geometrii.
vdolistmetadata potwierdziło to na puli w labie:
| Bloki | Co | Gdzie siedzi |
|---|---|---|
| od 0 do 679 188 | geometria, indeks UDS, superblok, korzenie mapy bloków | pierwsze 2,59 GiB |
| wewnątrz każdego slabu 2 GiB | dane, liście mapy bloków, 130 bloków odwołań i 224-blokowy dziennik slabu | rozrzucone po puli |
| od 10 452 928 do 10 485 695 | dziennik odzyskiwania | prawie ostatnie 128 MiB |
| od 10 485 696 do 10 485 759 | podsumowanie slabów | ostatnie 256 KiB |
Zbuduj więc LV puli z trzech kawałków: głowa na NVMe, środek na wolnym dysku, ogon na NVMe.
Potem przekonwertuj go na pulę VDO, co lvmvdo(7) dokumentuje dla istniejącego LV2.
Tutaj nvme6n1 zastępuje NVMe, a nvme8n1 wolny dysk:
# lvcreate -y -L 3G -n splitpool vdolab /dev/nvme6n1
  Logical volume "splitpool" created.
# lvextend -l +9408 vdolab/splitpool /dev/nvme8n1
  Size of logical volume vdolab/splitpool changed from 3.00 GiB (768 extents) to 39.75 GiB (10176 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvextend -l +64 vdolab/splitpool /dev/nvme6n1
  Size of logical volume vdolab/splitpool changed from 39.75 GiB (10176 extents) to 40.00 GiB (10240 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvconvert -y --type vdo-pool -n splitlv -V 35G vdolab/splitpool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  WARNING: Converting logical volume vdolab/splitpool to VDO pool volume with formatting.
  THIS WILL DESTROY CONTENT OF LOGICAL VOLUME (filesystem etc.)
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "splitlv" created.
  Converted vdolab/splitpool to VDO pool volume and created virtual vdolab/splitlv VDO volume.
Potem sprawdź, czy VDO umieściło metadane tam, gdzie są extenty:
# vdolistmetadata /dev/mapper/vdolab-splitpool_vdata | grep -v "slab [0-9]* \(reference\|journal\)"
0 .. 0: geometry block
1 .. 679127: index
679128 .. 679128: super block
679129 .. 679188: block map tree roots
10452928 .. 10485695: recovery journal
10485696 .. 10485759: slab summary
Extent to 1024 bloki. Głowa na NVMe to extenty od 0 do 767, bloki od 0 do 786 431, co obejmuje indeks i korzenie, z około 420 MiB danych pierwszego slabu przy okazji. Ogon na NVMe to extenty od 10 176 do 10 239, bloki od 10 420 224 wzwyż, co obejmuje dziennik odzyskiwania i podsumowanie slabów.
Ile pracy VDO przenosi się razem z nimi, na 30-sekundowy przebieg, liczone dla każdego urządzenia:
| Obciążenie | Zapisy I/O na NVMe | Zapisy I/O na dysk danych | Udział NVMe |
|---|---|---|---|
| 4k losowy zapis, 75% dup, 50% kompr. | od 388 430 do 538 223 | od 3,42 do 3,63 mln | od 10 do 13% |
| 128k zapis, 75% dup, 50% kompr. | od 458 214 do 634 167 | od 3,30 do 3,53 mln | od 12 do 15% |
| 4k losowy zapis, dane losowe | od 181 457 do 384 507 | od 3,25 do 8,49 mln | od 4 do 5% |
| 4k losowy odczyt | 0 zapisów, 2% odczytów | 0 |
Mniej więcej jedna dziesiąta operacji zapisu: dziennik odzyskiwania, aktualizacje indeksu i ten kawałek slabu 0 na głowie NVMe. To małe, rozproszone zapisy metadanych, z którymi dysk talerzowy radzi sobie najgorzej. Na NVMe to nic.
Dwa ograniczenia.
Metadane każdego slabu, liczniki odwołań, dzienniki slabów i liście mapy bloków, żyją wewnątrz slabów i zostają przy danych.
I nie testowałem powiększania podzielonej puli. Dziennik jest umieszczany od końca, więc po każdym lvextend uruchom znowu vdolistmetadata i zobacz, gdzie trafił, zanim mu zaufasz.
VDO na bcache: jeden NVMe, dwie role
bcache to drugi sposób na postawienie flasha przed wolnymi dyskami. Używam go już pod Ceph na dyskach talerzowych, z każdym ustawieniem objaśnionym w wpisie o bcache. Pytanie brzmi więc, co VDO robi z cache bcache, gdy siedzi na nim.
Jeden NVMe pełni obie role flasha, podzielony na dwie partycje:
| Urządzenie | Rozmiar | Rola |
|---|---|---|
nvme8n1p1 | 32 GiB | cache bcache, writeback |
nvme8n1p2 | 8 GiB | głowa i ogon VDO: indeks, korzenie, dziennik odzyskiwania, podsumowanie slabów |
nvme6n1 | 349 GiB | urządzenie bazowe bcache, gdzie żyją dane |
/dev/bcache0 | 349 GiB | środek puli VDO, slaby |
Oba dyski to znowu Optane, więc nvme6n1 zastępuje dysk talerzowy.
Pamiętaj o tym przy każdej liczbie niżej. Urządzenie bazowe jest tu szybkie, więc to mierzy, co dociera do cache, a nie to, jak długo wrzeciono będzie go opróżniać.
Partycje i cache set, z ustawieniami z tamtego wpisu:
# sgdisk --zap-all /dev/nvme8n1
# sgdisk -n 1:0:+32G -c 1:bcache-cache -n 2:0:+8G -c 2:vdo-meta /dev/nvme8n1
# blockdev --rereadpt /dev/nvme8n1
# apt install bcache-tools
# make-bcache -C /dev/nvme8n1p1 -B /dev/nvme6n1 --writeback
# B=/sys/block/bcache0/bcache
# echo 0 > $B/sequential_cutoff
# echo 40 > $B/writeback_percent
# echo 81920 > $B/writeback_rate
# echo 20480 > $B/writeback_rate_minimum
# CS=/sys/fs/bcache/47bac36f-a1d5-4e8e-8695-2e7ff944172d
# echo 0 > $CS/congested_read_threshold_us
# echo 0 > $CS/congested_write_threshold_us
Te linie echo działają do następnego restartu. Reguła udev z wpisu o bcache sprawia, że zostają.
Potem pula, podzielona tak samo jak wyżej, z nvme8n1p2 na oba końce i bcache0 na środek:
# pvcreate /dev/bcache0 /dev/nvme8n1p2
# vgcreate vdolab /dev/bcache0 /dev/nvme8n1p2
# lvcreate -y -L 3G -n vdopool vdolab /dev/nvme8n1p2
# lvextend -l +9408 vdolab/vdopool /dev/bcache0
# lvextend -l +64 vdolab/vdopool /dev/nvme8n1p2
# lvconvert -y --type vdo-pool -n vdolv -V 35G vdolab/vdopool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
# lvs -a --segments -o lv_name,lv_size,segtype,seg_start_pe,seg_size_pe,devices vdolab
  LV              LSize  Type     Start SSize Devices
  vdolv           35.00g vdo          0  8960 vdopool(0)
  vdopool         40.00g vdo-pool     0 10240 vdopool_vdata(0)
  [vdopool_vdata] 40.00g linear       0   768 /dev/nvme8n1p2(0)
  [vdopool_vdata] 40.00g linear     768  9408 /dev/bcache0(0)
  [vdopool_vdata] 40.00g linear   10176    64 /dev/nvme8n1p2(768)
vdolistmetadata wypisało te same zakresy bloków co przy podzielonej budowie, więc indeks i oba dzienniki siedzą na nvme8n1p2.
vdovg i storage Proxmoksa idą na wierzch dokładnie jak wcześniej.
Co dociera do cache
Porównanie to LV 8 GiB bezpośrednio na bcache0 wobec LV 8 GiB w vdovg, te same zadania fio przez 30 sekund, dwa razy, z cache opróżnionym do czysta przed każdym przebiegiem.
Liczniki urządzeń w /sys/class/block mówią, dokąd poszły bajty.
| 75% dup, 50% kompr., 30 s | tylko bcache | VDO na bcache |
|---|---|---|
| 4k losowy zapis, QD32, 4 zadania | 212 222 i 205 585 IOPS | 390 206 i 304 757 IOPS |
| p99 | 1,89 i 2,04 ms | 1,45 i 2,54 ms |
| Gość zapisał | 24,29 i 23,53 GiB | 44,67 i 34,88 GiB |
| Zapisane do cache bcache | 25,00 i 24,26 GiB | 11,48 i 10,44 GiB |
| Zapisane na partycję metadanych VDO | 1,18 i 0,59 GiB | |
| Zapisy do cache na bajt gościa | 103% | 26 i 30% |
| Brudne w cache na koniec | 6,0 i 6,5 GiB | 5,5 i 5,2 GiB |
| 128k zapis, QD8 | 2001 i 1985 MiB/s | 1878 i 1416 MiB/s |
| Zapisy do cache na bajt gościa, 128k | 101% | 24 i 27% |
Sam bcache doszedł do około 210 000 małych zapisów na sekundę i zapisał do cache każdy bajt plus 3% własnych. Postaw przed nim VDO, a cache przyjął jedną czwartą bajtów. W pierwszym przebiegu ten sam cache obsłużył potem 390 206 zapisów na sekundę, prawie dwa razy więcej, i nadal skończył z mniejszą ilością brudnych danych czekających na wolny dysk. Cache był ograniczeniem. VDO je przesunęło.
Drugi przebieg jest tym uczciwym dla puli, która była w użyciu. fio domyślnie inicjuje swoje generatory tak samo w każdym przebiegu8, więc drugi przebieg zapisał dane, które indeks już widział, wskazujące na bloki, które w międzyczasie zostały zwolnione przez discard. VDO traktuje indeks jako wskazówki i odczytuje każdy kandydujący blok, żeby sprawdzić, czy naprawdę jest duplikatem, zanim go współdzieli9. W teście samych zapisów ten drugi przebieg odczytał z cache 7,11 GiB i 1,20 GiB z dysku danych. Pierwszy odczytał 0,12 GiB. Nieaktualne wskazówki nie są darmowe, a na puli, gdzie maszyny wirtualne przychodzą i odchodzą, zawsze jakieś będą.
Druga strona to dane losowe:
| Dane losowe, 30 s | tylko bcache | VDO na bcache |
|---|---|---|
| 4k losowy zapis, QD32, 4 zadania | 205 984 i 203 066 IOPS | 203 186 i 85 882 IOPS |
| p99 | 2,04 i 2,15 ms | 5,7 i 17,7 ms |
| 128k zapis, QD8 | 2038 i 2017 MiB/s | 878 i 357 MiB/s |
| 4k losowy odczyt, QD1 | 36 609 i 36 639 IOPS, 21,6 µs | 26 345 i 26 202 IOPS, 33,6 i 33,7 µs |
| 4k losowy odczyt, QD32, 4 zadania | 471 585 i 471 730 IOPS | 335 461 i 336 941 IOPS |
Nie ma czego oszczędzać, więc VDO to czysty narzut, a w przebiegu z nieaktualnym indeksem ponad dwukrotnie obniżyło liczbę małych zapisów. Każdy odczyt w obu kolumnach pochodził z cache. 12 µs VDO na wierzchu to ten sam stały koszt, który dodaje na gołym Optane.
Tam, gdzie dane się powtarzają, te dwie warstwy dobrze się składają. Cache dostaje jedną czwartą bajtów, dłużej przetrzymuje szczyt i ma mniej do zapisania z powrotem na wrzeciona. Tam, gdzie się nie powtarzają, bcache lepiej radzi sobie sam.
Na sprzętowym RAID6 z HDD: rozumowanie, nie pomiar
Nie mam hosta z RAID6 na HDD do testów, więc ta sekcja to rozumowanie zbudowane na pomiarach powyżej. Zmierz własną macierz, zanim na tym polegniesz.
| Na RAID6 z HDD | Co zmienia VDO |
|---|---|
| Zapisy docierające do macierzy | około jednej czwartej, przy mieszance takiej jak zmierzona |
| Cache write-back kontrolera | zapełnia się w jednej czwartej tempa, więc przetrzymuje szczyt mniej więcej cztery razy dłużej |
| Koszt CPU VDO | 17 µs na odczyt, gubi się w wyszukiwaniu trwającym od 5 do 10 ms |
| Zapisy dziennika odzyskiwania | mniej więcej jedna dziesiąta zapisów I/O, małe i z flushem: daj je na NVMe |
| Wyszukiwania w indeksie | obserwuj dedupe advice timeouts w vdostats; na wolnym storage VDO może przestać szukać i i tak zapisać duplikat |
| Odczyt jednego klonu od początku do końca | wolniejszy: jego bloki wskazują z powrotem na bloki szablonu, rozrzucone po macierzy |
Pierwsze dwa wiersze to odpowiedź sprzętowa. Dopóki cache kontrolera z baterią albo flashem ma miejsce, gość widzi opóźnienie cache. Gdy się zapełni, gość widzi wrzeciona. Wyślij mu jedną czwartą bajtów, a ten sam cache daje mniej więcej cztery razy więcej zapasu i ma cztery razy mniej do opróżnienia. Sekcja o bcache powyżej to właśnie to, zmierzone z cache programowym w miejscu cache kontrolera.
Trzeci wiersz mówi, dlaczego VDO bardziej pasuje do wolnych dysków niż do szybkich. Na Optane VDO podwoiło opóźnienie odczytu. Na dyskach 7200 obr./min ten sam stały koszt znika w jednym wyszukiwaniu.
Ostatnie trzy to koszty. Burza rozruchowa identycznych klonów przyspiesza, ale jeden klon czytany od początku do końca zwalnia, bo deduplikacja go rozprasza. A własne małe zapisy VDO też lądują na macierzy, i to jest argument za podzielonym układem powyżej: indeks i dziennik na NVMe, slaby na RAID6.
Usuwanie dysku: niech Proxmox zrobi discard
Usunięcie LV zwalnia jego extenty w LVM. Nie mówi VDO, że bloki są nieużywane, więc VDO je trzyma. Dokumentacja jądra mówi, dlaczego to ważne: „If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space”1. Na grubym storage miejsce nie może się skończyć, ale bloki bez discard to nadal miejsce na dysku zajęte na dane, których nikt nie posiada.
Rozwiązaniem jest opcja on-volume-remove discard=1 na storage. Proxmox opisuje ją jako wysyłanie „discard (TRIM) requests before removal”5:
| Usunięcie | Zwolnione bloki VDO |
|---|---|
zwykły storage lvm, dysk z 1 GiB danych | 0 |
z on-volume-remove discard=1, to samo | 262 140, całe 1 GiB |
Na dużym dysku jest to jednak wolne.
Usunięcie dysku 34 GiB z testu zapełniania zajęło Proxmoksowi 262,6 s, a blkdiscard na tym samym rodzaju danych dał radę 15 GiB w 2,25 s.
Więc przy czymkolwiek dużym najpierw zrób blkdiscard na dysku, a potem go usuń.
Liczy się też rozmiar discard. Domyślny max_discard VDO to jeden blok 4 KiB na żądanie1:
| Discard 15 GiB losowych danych | Czas | CPU (sys) |
|---|---|---|
max_discard=1, domyślnie | 8,06 s | 8,06 s |
max_discard=4096, 16 MiB | 2,25 s | 0,00 s |
Wewnątrz gości włącz opcję Discard dysku, żeby ich TRIM docierał do storage10, i uruchamiaj fstrim według harmonogramu.
Gdzie zarabia na swoje miejsce
| Pasuje | Nie pasuje |
|---|---|
| wiele VM z tych samych kilku szablonów | bazy danych i praca zależna od opóźnień przy dużej głębokości kolejki |
| RAID6 na HDD za cache write-back kontrolera | host w całości na NVMe, który potrzebuje każdej mikrosekundy |
| dane na dyskach talerzowych z NVMe na metadane VDO | dane już skompresowane: media, kopie zapasowe, ISO |
| bcache przed danymi na dyskach talerzowych, gdy dane się powtarzają | bcache przed danymi, które się nie powtarzają |
| dyski, w których ograniczeniem jest wytrzymałość na zapis | zaszyfrowane dyski gości, które nigdy się nie deduplikują |
| host z wolnym pół gigabajta RAM na pulę | mała pula, gdzie indeks zjada jedną dziesiątą |
| Ustawienie | Domyślnie | Ustaw na | Zmiana później |
|---|---|---|---|
Rozmiar wirtualny VDO -V | cokolwiek poprosisz | nie więcej, niż pula może zaadresować | tylko powiększanie, nigdy zmniejszanie |
| Wątki VDO | 10, jeden logiczny | jeden na CPU, rozłożone jak wyżej | tylko przy zatrzymanych VM puli |
max_discard | 1, czyli 4 KiB | 4096, czyli 16 MiB | tylko przy zatrzymanych VM puli |
on-volume-remove na storage | nieustawione | discard=1 | tak, pvesm set |
| Discard na każdym dysku wirtualnym | wyłączone | włączone | tak, dla każdego dysku |
scan_lvs i filtr | 0, bez odrzucania dysków VM | 1, dyski VM odrzucane | tak, w lvm.conf |
Nic z tego nie jest trudne. Nic z tego nie jest domyślne.
Najtańszy zapis to ten, którego nigdy nie wysyłasz
Uderza mnie, jak źle sprzedaje się VDO. Pojawia się jako sposób na zmieszczenie na dysku więcej, niż dysk mieści, a to najmniej użyteczna rzecz, jaką robi. Zrobiłem to przypadkiem przy pierwszej budowie i Proxmox pokazywał jedną trzecią storage jako wolną, podczas gdy VDO było pełne. Nadmierny przydział to pożyczka, a dysk ściąga ją z pełną prędkością zapisu.
Prawdziwa wartość jest w wierszu, którego większość ludzi nigdy nie mierzy. Jedna czwarta bajtów docierających do dysku to jedna czwarta zużycia i cache kontrolera, który wytrzymuje cztery razy dłużej. To nie jest pojemność. To sprzęt wykonujący mniej pracy dla tego samego wyniku, a to jedyny rodzaj oszczędności, który nie wraca, żeby cię ugryźć.
Kosztuje CPU, a na szybkim flashu kosztuje opóźnienie, i oba koszty są stałe. Taki jest kompromis, powiedziany wprost: czas procesora wydany po to, żeby wolna, droga część maszyny robiła mniej. Na dyskach talerzowych za kontrolerem RAID albo za bcache, z indeksem i dziennikiem na NVMe, ten rachunek wychodzi dobrze. Na hoście w całości na Optane przeważnie nie.
I samo o siebie nie zadba. Każde ustawienie domyślne, które ma znaczenie, jest złe do tego zadania: dziesięć wątków na szesnaście CPU, rozmiar discard, który pali rdzeń, rozmiar wirtualny, który można ustawić na cokolwiek, i nic w konfiguracji storage, co kazałoby Proxmoksowi oddawać miejsce. Nic z tego nie jest ukryte. Wszystko jest w dokumentacji.
Więc zbuduj to grubo, raz, porządnie, z ustawieniami w linii tworzenia i metadanymi tam, gdzie ich miejsce. Zrób to, a dysk wykona jedną czwartą pracy. Pomiń to, a kupiłeś kolejną warstwę, która obiecuje więcej, niż ma.
Linux kernel documentation — dm-vdo — cel „provides block-level deduplication, compression, and thin provisioning”; „If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space”; „unflushed writes may or may not persist after a crash”; cache mapy bloków 128 MB pozwala na „efficient access to 100 GB of logical space at a time”; parametry wątków, ich limity i wskazówki strojenia; maxDiscard „in 4096-byte blocks”. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
lvmvdo(7) — Support for Virtual Data Optimizer in LVM — pula VDO i VDO LV, konwersja istniejącego LV przez
lvconvert --type vdo-pool, zużycie pamięci, indeks dense i jego okno 1 TiB na GiB RAM oraz „You cannot reduce the size of a VDOPoolLV”. ↩︎ ↩︎ ↩︎ ↩︎Linux kernel source — drivers/md/dm-thin.c —
disable_discard_passdown_if_not_supported()wyłącza przekazywanie discard, gdy urządzenie danych nie przyjmuje całego cienkiego chunku, a tak właśnie robi domyślne VDO pod cienką pulą. ↩︎LVM2 — conf/example.conf.in —
devices/scan_lvs: „Caution is required to avoid using PVs that belong to guest images stored on LVs” oraz „This option does not enable autoactivation of layered VGs”. ↩︎ ↩︎Proxmox pve-storage — LVMPlugin.pm — właściwość
on-volume-remove, „Use ‘discard=1’ to issue discard (TRIM) requests before removal”; woluminy są aktywowane pojedynczo przezlvchange -aey, a nie przezvgchange -aly. ↩︎ ↩︎Debian trixie — package vdo — „Management tools for Virtual Data Optimizer”, wersja 8.3.1.1-1, która dostarcza
vdoformat,vdostatsivdolistmetadata. ↩︎Linux kernel source — drivers/md/dm-vdo/encodings.c —
vdo_initialize_layout()tworzy partycję mapy bloków na początku, partycje podsumowania slabów i dziennika odzyskiwania na końcu, a skład slabów z tego, co zostaje. ↩︎fio documentation — randrepeat — „Seed all random number generators in a predictable way so the pattern is repeatable across runs. Default: true.” ↩︎
Linux kernel documentation — Design of dm-vdo — „vdo treats the locations in the index as hints, and reads each indicated block to verify that it is indeed a duplicate before sharing the existing block with a new one.” ↩︎
Proxmox VE documentation — Qemu/KVM Virtual Machines, Trim/Discard — „For the guest to be able to issue TRIM commands, you must enable the Discard option on the drive.” ↩︎