Przełącznik, którego nie kupujesz
Trzywęzłowy klaster Proxmox z Ceph potrzebuje szybkiej sieci między węzłami. Zwykła odpowiedź to przełącznik 100 Gbit, a zwykły zarzut to jego cena.
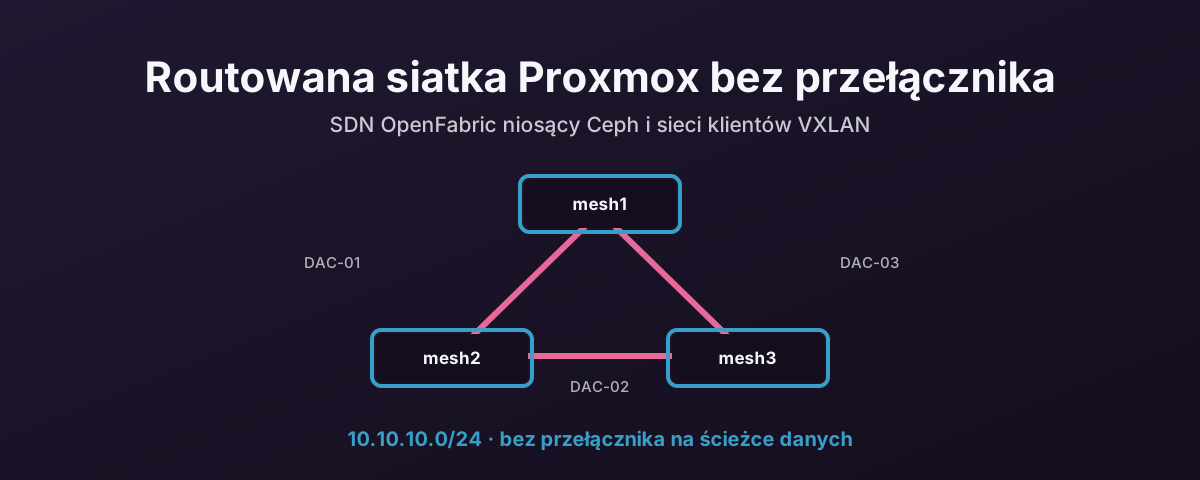
Dla trzech węzłów jest inna odpowiedź: połącz je kablami bezpośrednio ze sobą w trójkąt i routuj po nim. Żadnego przełącznika na ścieżce pamięci masowej.
Najtańszy element każdego projektu to ten, którego nie kupujesz, i to jedyny, który nigdy nie zawodzi.
To daje cztery rzeczy.
Koszt przełącznika znika. Potrzebujesz kart sieciowych i trzech kabli, a nie przełącznika 100 albo 200 Gbit z odpowiednią liczbą portów.
Ścieżka danych nie ma pojedynczego punktu awarii. Przełącznik, który padnie albo się zrestartuje, zabiera ze sobą cały ruch wschód-zachód klastra. Węzłom połączonym bezpośrednio jest obojętne, co dzieje się z przełącznikiem gdzie indziej w budynku.
Ciężki ruch ma własne kable. Migracja na żywo i replikacja Ceph zostają w siatce, zamiast konkurować z ruchem biurowym i zarządzającym.
Rozbudowa to robota przy kablach, a nie przy budżecie portów. Nie ma centralnego pudła, które byłoby sufitem przepustowości albo liczby portów, więc sieć rośnie, dopóki każdy serwer ma wolny slot PCIe. OpenFabric sam zaczyna routować po nowych łączach.
I jedno uczciwe ograniczenie, bo liczy się bardziej niż te cztery korzyści. Pełna siatka potrzebuje kabla między każdą parą węzłów. Trzy węzły to trzy kable. Cztery to sześć. Pięć to dziesięć. Okablowanie rośnie szybciej niż liczba węzłów i ten projekt nie przetrwa poza małym klastrem bez przejścia na coś z przełącznikami, jak leaf-spine.
Trzy węzły to dokładnie ten punkt, w którym pełna siatka ma sens. Dalej, z dwoma portami siatki na węzeł, możesz zbudować jeszcze pierścień, a to wymaga jednej rzeczy, której ta budowa poza tym unika; o tym niżej.
Co powstaje
Trzy hosty Proxmox VE, każdy z dwoma dedykowanymi interfejsami 100 Gbit, połączone w trójkąt, tak że każdy węzeł ma dwóch bezpośrednich sąsiadów.
Routingiem zajmuje się Proxmox SDN. Protokołem jest OpenFabric: wyznacza najlepszą ścieżkę przez siatkę, a gdy ktoś wyciągnie kabel albo padnie łącze, przeroutowuje ruch pozostałą ścieżką. Nikt się nie loguje.
Sieć żyje w 10.10.10.0/24, zarezerwowanej dla siatki i dla niczego innego: nie dla zarządzania, nie dla gości, nie dla adresacji pamięci masowej, nie dla niczego zewnętrznego.
| Węzeł | Adres w siatce | Interfejsy siatki |
|---|---|---|
| mesh1 | 10.10.10.1/32 | nic1, nic2 |
| mesh2 | 10.10.10.2/32 | nic1, nic2 |
| mesh3 | 10.10.10.3/32 | nic1, nic2 |
Każdy węzeł dostaje /32, a nie kawałek podsieci.
Na tym polega siatka routowana, a nie mostkowana. Adres identyfikuje węzeł, OpenFabric go ogłasza, a dwa fizyczne łącza to tylko drogi, by do niego dotrzeć.
Proxmox tworzy do jego przechowania atrapę interfejsu loopback.
Okablowanie
Aktywne światłowodowe kable DAC, w trójkąt, z ramkami jumbo włączonymi na obu interfejsach siatki na każdym węźle.
| Kabel | Od | Do |
|---|---|---|
| DAC-01 | mesh1 nic1 | mesh2 nic1 |
| DAC-02 | mesh2 nic2 | mesh3 nic1 |
| DAC-03 | mesh3 nic2 | mesh1 nic2 |
Aktywny światłowód zamiast miedzianego DAC, z dwóch powodów, które dotyczą szafy, a nie sieci:
- Prowadzenie kabli. Aktywne światłowodowe DAC są cieńsze i znacznie bardziej giętkie niż miedziane, więc układają się czysto i nie piętrzą się za serwerami.
- Przepływ powietrza. Mniej kabli za obudową to mniej zaburzeń przepływu powietrza od przodu do tyłu, co ma znaczenie, gdy kilka szybkich łączy ląduje w tych samych kilku jednostkach szafy.
Dwie sieci, nie jedna
Siatka nie jest jedyną siecią i nie wolno jej się nią stać.
Każdy węzeł ma nic0 na przełączniku 2,5 Gbit, widoczny w Proxmoxie jako most vmbr0.
Przez niego idzie interfejs WWW, dostęp administracyjny i ruch klientów. To też ścieżka, z której korzystasz, budując siatkę, i dlatego musi być od niej niezależna.
nic0 jest celowo pozostawiony poza siatką. Przy tworzeniu węzłów siatki zaznacza się tylko nic1 i nic2.
Siatka niesie trzy rzeczy:
- Ceph. Replikację między węzłami, odzyskiwanie i backfill dla hiperkonwergentnej pamięci masowej.
- Wirtualne sieci klientów. VNety oparte na VXLAN rozciągają sieci gości na wszystkie trzy węzły, używając routowanej siatki jako podkładu.
- Corosync, jako drugą ścieżkę. Ruch członkostwa w klastrze idzie przez sieć zarządzającą i przez siatkę, więc kworum nie zależy od przetrwania żadnej z nich osobno.
Reguła, którą warto wpisać do zgłoszenia zmiany: zarządzanie i dostęp klientów są przez cały czas dostępne przez przełącznik 2,5 Gbit, niezależnie od stanu interfejsów 100 Gbit.
Wszystko przez interfejs WWW
Ta budowa jest zrobiona w całości w interfejsie WWW Proxmoxa. To świadomy wybór, a nie ograniczenie narzędzi.
Celowo nieużywane:
- Ręczna edycja
/etc/network/interfaces. - Ręczna edycja plików konfiguracyjnych FRR.
vtyshjako metoda budowy.
Proxmox generuje leżącą pod spodem konfigurację sieci i routingu z obiektów SDN, które definiujesz. Jeśli czegoś naprawdę nie da się ustawić w interfejsie, warto to nazwać jako warunek wstępny, a nie po cichu poprawiać w wierszu poleceń. Następna osoba, która otworzy interfejs WWW, nie będzie wiedziała, że to zrobiłeś.
Wyjście z wiersza poleceń pojawia się niżej wyłącznie jako dowód, nigdy jako krok budowy.
Budowa
1. Otwórz interfejs WWW Proxmoxa i przejdź do Datacentre → SDN → Fabrics.
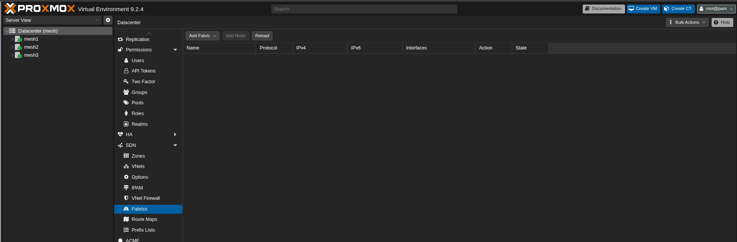
2. Dodaj sieć (fabric). Nadaj jej nazwę, podaj prefiks siatki i ustaw liczniki czasu.
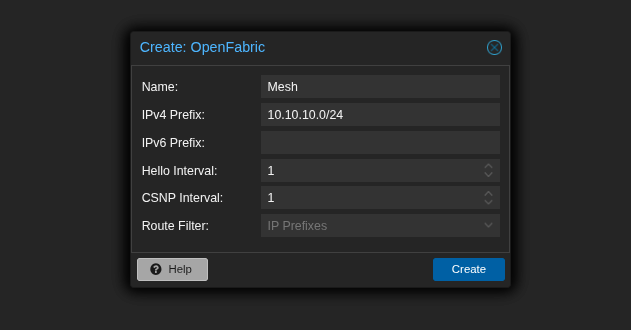
Interwały Hello i CSNP równe 1 aktualizują stan tak szybko, jak się da, gdy coś się zmienia, a tego chcesz w tak małej sieci.
Kosztem jest więcej gadania w płaszczyźnie sterowania. Bez znaczenia przy trzech węzłach z dwoma łączami każdy, warte namysłu, jeśli sieć kiedyś urośnie.
3. Dodaj każdy węzeł przez Add node. Nadaj mu adres z zakresu siatki i zaznacz interfejsy, które biorą udział.
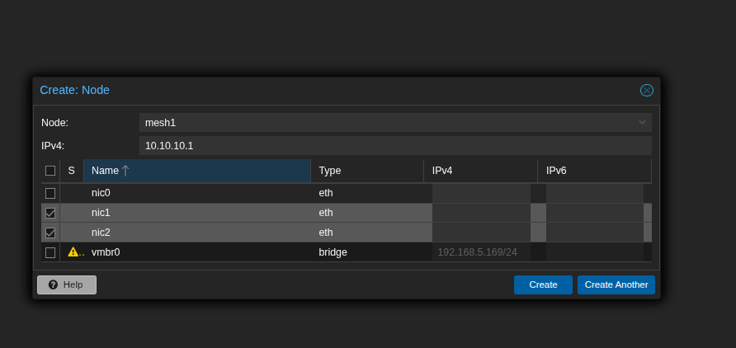
Zwróć uwagę na to, co nie jest zaznaczone: nic0 zostaje poza, a vmbr0 zachowuje adres zarządczy.
Użyj Create another dla pierwszych dwóch węzłów i Create dla ostatniego.
4. Sprawdź wynik, zanim go zastosujesz.
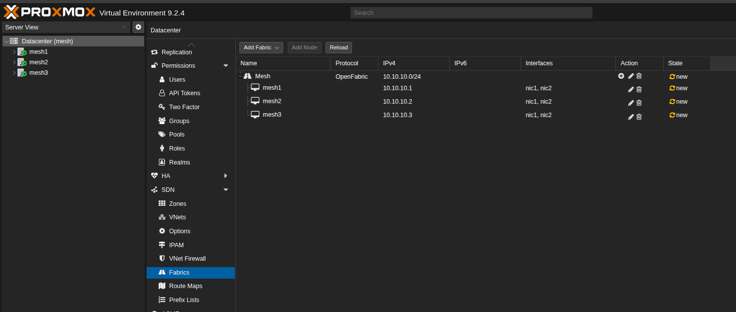
Trzy węzły, trzy adresy, nic1, nic2 na każdym, wszystkie oznaczone new: nic jeszcze nie zostało zapisane.
5. Zastosuj konfigurację SDN.
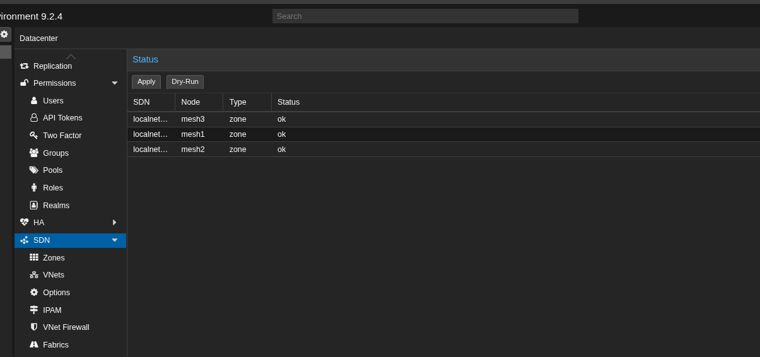
Obok Apply jest Dry-Run, jeśli wolisz najpierw zobaczyć, co zamierza zrobić.
Skąd wiesz, że zadziałało
Widok statusu powinien pokazywać wpisy strefy i sieci jako ok na wszystkich trzech węzłach i żadnych oczekujących zmian do zastosowania.
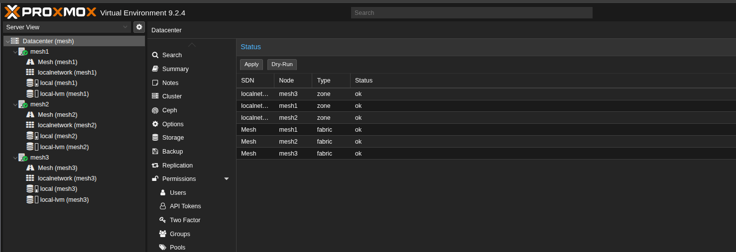
Potem sprawdź sieć z punktu widzenia samego węzła.
Najpierw trasy: każdy węzeł powinien mieć /32 do każdego z pozostałych, a kolumna Via mówi ci, którego sąsiada używa.
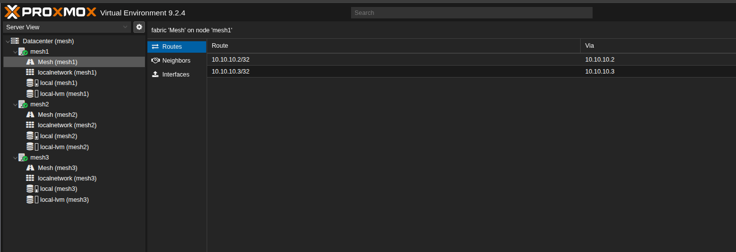
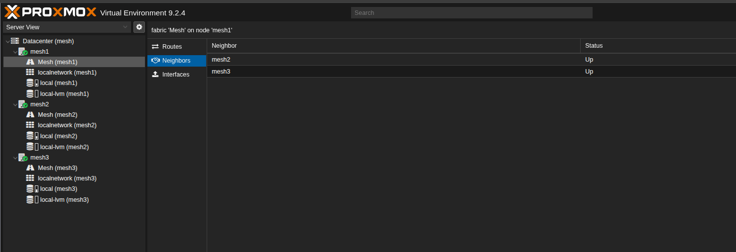
Następnie sąsiedzi. Dwóch, obaj Up, w trzywęzłowym trójkącie.
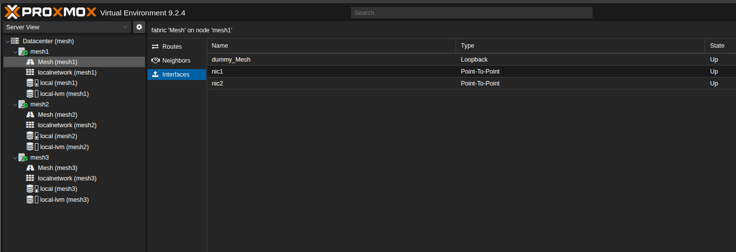
Potem interfejsy, gdzie widać kształt całości: dummy_Mesh jako loopback trzymający adres routera, a nic1 i nic2 jako Point-To-Point, a nie segmenty rozgłoszeniowe.
Na koniec udowodnij to od końca do końca.
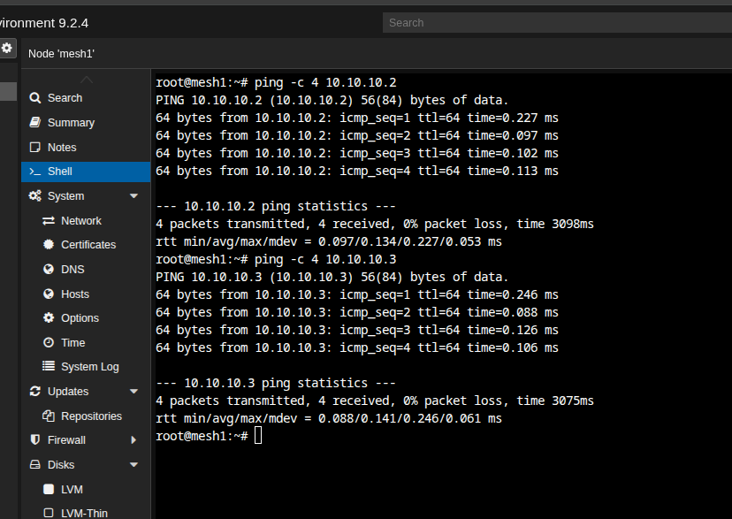
Bez strat i średnie 0,134 ms i 0,141 ms. Obaj sąsiedzi są o jeden bezpośredni skok, i to właśnie daje trójkąt.
Sprawdzian, który warto zrobić, a którego żaden zrzut ekranu nie pokaże: wyciągnij jeden kabel i potwierdź, że wszystko dalej jest osiągalne. To cały powód, by wybrać routowaną siatkę zamiast pary łączy punkt-punkt. W związku z tym to jedyny test, który się liczy.
Ponad trzy węzły: pierścień
Trójkąt to pełna siatka. Każdy węzeł ma bezpośredni kabel do każdego innego, każdy przeskok to jeden przeskok i żaden węzeł nigdy nie niesie ruchu, który nie jest jego.
Tę właściwość dają ci dwa porty siatki na węzeł przy trzech węzłach i dokładnie ją tracisz przy czterech. Nie część. Całą. Pełna siatka czterech węzłów potrzebuje po trzy porty. Z dwoma najwięcej, co możesz okablować, to pierścień.
Pierścień zmienia model ruchu. Sąsiednie węzły dalej mają bezpośredni kabel, ale węzły po przeciwnych stronach pierścienia nie: ich ruch musi przejść przez węzeł pośredni. A ten węzeł musi chcieć przekazywać pakiety między swoimi dwoma interfejsami siatki, czego Linux domyślnie nie robi. Jądro dokumentuje ip_forward jako „Forward Packets between interfaces” z „Default: 0 (disabled)”.
Włącz je dla interfejsów siatki i tylko dla nich:
# /etc/sysctl.d/99-mesh-forwarding.conf
net.ipv4.conf.nic1.forwarding = 1
net.ipv4.conf.nic2.forwarding = 1
sysctl --system
Odczytaj je z powrotem, zamiast zakładać:
sysctl net.ipv4.conf.nic1.forwarding net.ipv4.conf.nic2.forwarding
Ustawienie per interfejs ma tu właściwy zakres i działa samo. Globalne net.ipv4.ip_forward nie jest warunkiem wstępnym. Decyzja jądra o przekazaniu czyta własną wartość interfejsu odbierającego:
#define IN_DEV_FORWARD(in_dev) IN_DEV_CONF_GET((in_dev), FORWARDING)
IN_DEV_CONF_GET zwraca ustawienie tego urządzenia, a nie AND z globalnym. Dzięki temu nic1 i nic2 przekazują ruch tranzytowy sieci, a nic0 i vmbr0 zostają dokładnie tym, czym powinny być: interfejsami hosta, które nie routują. Włączenie globalnego przełącznika zrobiłoby routerem każdy interfejs na maszynie, łącznie z tym od strony sieci biurowej. Ten projekt niczego takiego nie potrzebuje.
Jedna rzecz, którą warto wiedzieć o globalnym przełączniku IPv4, choć go nie ustawiasz: net.ipv4.ip_forward to ustawiacz hurtowy, i dlatego dokumentacja jądra ostrzega, że jego zmiana „resets all configuration parameters to their default state”. Jeśli cokolwiek innego na hoście kiedyś go zapisze, nadpisze te wartości per interfejs. Warto to wiedzieć, zanim spędzisz popołudnie nad tym, czemu tranzyt przestał działać.
IPv6 jest wyjątkiem i to jedyne miejsce, gdzie globalny przełącznik pasuje. Dokumentacja jądra mówi to wprost pod conf/all/forwarding:
Enable global IPv6 forwarding between all interfaces. IPv4 and IPv6 work differently here; the
force_forwardingflag must be used to control which interfaces may forward packets.
Nie ma więc odpowiednika IPv6 dla zgrabnego podejścia per interfejs opisanego wyżej. Jeśli sieć niesie IPv6, włączasz przekazywanie globalnie, a potem zawężasz je przez force_forwarding, udokumentowane jako „Enable forwarding on this interface only — regardless of the setting on conf/all/forwarding”. Zwróć uwagę, że to samo nadpisywanie działa w drugą stronę: ustawienie conf.all.forwarding na 0 resetuje force_forwarding na każdym interfejsie.
Budowa powyżej zostawia prefiks IPv6 sieci pusty, więc nic z tego tu nie obowiązuje: ma to znaczenie tylko wtedy, gdy go dodasz.
Zwróć uwagę, czego przekazywanie nie zmienia: OpenFabric już ogłaszał /32 każdego węzła i już wyznaczał ścieżkę przez pierścień. Przekazywanie to brakujące pozwolenie, a nie brakujący rozum. Tablica routingu była poprawna od początku. Jądro po prostu odmawiało bycia routerem.
Ile kosztuje pierścień w porównaniu z trójkątem:
- Ruch tranzytowy. W pierścieniu czterech węzłów dwie pary po przekątnej przechodzą przez węzeł pośredni, więc ich ruch zużywa przepustowość łączy tego węzła oprócz jego własnej. Ceph zauważa to pierwszy, bo replikacja idzie każdy do każdego, a nie od sąsiada do sąsiada.
- Dodatkowy przeskok opóźnienia na tych ścieżkach, ponad zwykłe dla bezprzełącznikowego projektu wartości poniżej milisekundy.
- Mniejszy zapas na awarie. Jedno zerwane łącze zmienia pierścień w łańcuch: dalej w pełni połączony, ale z dłuższymi ścieżkami i większym tranzytem. Drugie zerwanie dzieli klaster. Trójkąt znosi jedno zerwanie bez żadnego tranzytu.
I robi się gorzej w sposób, który łatwiej narysować niż opisać. Dodaj piąty węzeł, a połowa par węzłów w klastrze zależy od tego, że ktoś inny przekaże ruch:
To jest prawdziwy sufit tego projektu i nie jest nim protokół routingu. OpenFabric radzi sobie dobrze. Chodzi o to, że liczba portów na węzeł jest stała, więc powyżej trzech węzłów każda nowa maszyna zamienia więcej twojego ruchu w czyjś tranzyt.
I uczciwa uwaga, bo ma znaczenie dla budowy, która do tej pory szła wyłącznie przez interfejs WWW: sysctl to nie jest akcja w interfejsie WWW. Zgodnie z regułą postawioną wcześniej to warunek wstępny, który trzeba nazwać, a nie coś do cichego poprawienia w wierszu poleceń. Wpisz to do runbooka, bo następna osoba, która otworzy panel SDN, zobaczy zdrową sieć i ani śladu tego, że pierścień zależy od pliku w /etc/sysctl.d.
Wycofanie
Usunięcie to budowa w odwrotnej kolejności, w tym samym interfejsie: skasuj obiekty SDN utworzone dla siatki, zastosuj konfigurację i potwierdź, że dostęp zarządczy jest nietknięty.
Ten ostatni krok to powód istnienia nic0 i przełącznika 2,5 Gbit. Jeśli wycofanie siatki mogłoby kosztować cię interfejs WWW, projekt był zły, zanim zacząłeś.
Zanim zaczniesz
- Dostęp zarządczy jest naprawdę niezależny od siatki. Sprawdź to, nie zakładaj.
- Wszystkie trzy węzły są zdrowe przed jakąkolwiek zmianą SDN.
- Nazwy węzłów, nazwy interfejsów i okablowanie są zapisane, bo
nic1na jednym hoście będącynic2na innym to kiepskie popołudnie. - Ramki jumbo są ustawione na obu interfejsach siatki, a MTU uwzględnia narzut VXLAN na podkładzie.
- Zakres siatki jest zarezerwowany i nieużywany nigdzie indziej.
Źródła
- Proxmox VE — Software-Defined Network — dokumentacja SDN Fabrics. Sieci „provide automated routing between nodes in a cluster”, OpenFabric jest „based on IS-IS and optimized for the spine-leaf topology common in data centers”, każdy węzeł potrzebuje unikalnego Router-ID, a „a dummy ’loopback’ interface with the router-id is automatically created”
- Proxmox VE — Cluster Manager — sieć Corosync i łącza nadmiarowe, na których opiera się projekt członkostwa po dwóch ścieżkach
- Proxmox VE — Deploy Hyper-Converged Ceph Cluster — oczekiwania sieciowe wobec klastra hiperkonwergentnego
- Linux kernel — IP sysctl documentation —
ip_forwardi jego domyślne 0, sterowanieforwardingper interfejs oraz ostrzeżenie, że zmiana globalnego przełącznika resetuje konfigurację per interfejs