Problem
Wyszło to przy projekcie dla klienta, gdy projektowaliśmy wdrożenie Proxmox VE z passthrough NVMe dla obciążenia wrażliwego na opóźnienia.
Klient zrobił własne benchmarki przed rozmową.
Na hoście fio na dysku NVMe pokazywał 700K IOPS odczytu losowego z opóźnieniem zakończenia poniżej 10µs.
Wewnątrz VM, na tym samym dysku i tym samym teście, dostawał mniej więcej połowę tego.
Oczywiste rzeczy już sprawdził. Dysk się nie zmienił. Firmware się nie zmienił. Slot PCIe się nie przesunął. Zaczynał się zastanawiać, czy passthrough w ogóle jest właściwym podejściem.
Był. To, co widział, to podatek IOMMU. Łapie ludzi, bo nikt ci o nim nie mówi, zanim zobowiążesz się do projektu z passthrough. Dobra wiadomość jest taka, że większość narzutu da się odzyskać, kiedy zrozumiesz, skąd się bierze.
Szczegóły
Problemy, które trzeba było rozwiązać
Danie VM bezpośredniego dostępu do fizycznego urządzenia PCIe brzmi prosto. W praktyce to jeden z trudniejszych problemów wirtualizacji systemów. Kilka rzeczy, które na bare metal działają same, staje się niebezpiecznych, gdy urządzenie jest dzielone między hosta a gościa.
Izolacja DMA
To jest problem podstawowy.
Urządzenia PCIe nie przechodzą przez CPU, żeby czytać i zapisywać pamięć. Używają Direct Memory Access. Piszą prosto pod fizyczne adresy RAM. Na bare metal to nie problem. Urządzenie i system ufają sobie nawzajem.
Pod wirtualizacją gość VM ma własny obraz pamięci fizycznej. Adresy, które sterownik gościa podaje kontrolerowi NVMe, to fizyczne adresy gościa. Nie odpowiadają tym samym miejscom w RAM hosta. Jeśli urządzenie użyje ich bezpośrednio, czyta i pisze nie tę pamięć. To psuje hosta, inne VM albo jedno i drugie.
Gorzej: złośliwy albo wadliwy sterownik gościa mógłby celowo zaprogramować urządzenie tak, by robiło DMA w dowolne miejsce pamięci hosta. To w praktyce root na całej maszynie, bez wykorzystania żadnego błędu w hiperwizorze.
Rozwiązaniem jest IOMMU: sprzętowa jednostka translacji (Intel VT-d, AMD-Vi), która siedzi między każdym urządzeniem PCIe a pamięcią główną. Utrzymuje własne tablice stron, oddzielne od tablic CPU. Każde żądanie DMA z urządzenia przechodzi przez IOMMU, które tłumaczy fizyczne adresy gościa na fizyczne adresy hosta i blokuje każdy dostęp poza obszarami pamięci przydzielonymi gościowi.
Bez IOMMU bezpieczny passthrough jest niemożliwy. Z nim urządzenie jest zamknięte w klatce.
Grupowanie urządzeń
IOMMU nie izoluje pojedynczych urządzeń. Izoluje grupy.
Specyfikacja PCIe definiuje Access Control Services (ACS), które decydują, czy urządzenia na tej samej magistrali mogą rozmawiać ze sobą bezpośrednio, przez DMA peer-to-peer, bez przechodzenia przez root complex, w którym siedzi IOMMU. Jeśli dwa urządzenia dzielą przełącznik PCIe, który nie egzekwuje ACS, jedno może robić DMA w przestrzeń pamięci drugiego, całkowicie omijając IOMMU.
Jądro grupuje urządzenia, które potencjalnie mogą do siebie dotrzeć bez egzekwowania przez IOMMU, w jedną grupę IOMMU. Jeśli twój kontroler NVMe dzieli grupę z innym urządzeniem, przekazanie samego NVMe łamie model izolacji. Drugie urządzenie w grupie nadal mogłoby posłużyć jako boczny kanał obok IOMMU.
Sprzęt serwerowy z porządnym wsparciem ACS na każdym mostku i przełączniku zwykle daje każdemu urządzeniu własną grupę. Płyty konsumenckie i stacji roboczych często wrzucają kilka urządzeń do jednego worka, bo root complex PCIe nie implementuje ACS na każdym porcie.
Proxmox ma łatkę jądra, pcie_acs_override, która każe jądru traktować każde urządzenie jako izolowane, niezależnie od sprzętowego ACS.
W praktyce działa, ale okłamuje jądro co do topologii sprzętu.
Na systemie produkcyjnym czyste grupy oparte na prawdziwym sprzętowym ACS są zawsze lepsze.
Dostarczanie przerwań
Na bare metal, gdy kontroler NVMe kończy operację IO, wysyła przerwanie MSI-X prosto do CPU. CPU obsługuje je w kilkaset nanosekund.
Pod wirtualizacją to przerwanie musi trafić do gościa, nie do hosta. Naiwne podejście to łapać każde przerwanie w hiperwizorze, wywołać VM exit, wstrzyknąć przerwanie do gościa i wznowić. To działa, ale każdy VM exit kosztuje 5–20µs. Przy wysokich IOPS, setkach tysięcy przerwań na sekundę, narzut jest spory.
Rozwiązaniem sprzętowym są posted interrupts. APICv Intela i AVIC AMD pozwalają IOMMU zapisać przerwanie bezpośrednio na stronie wirtualnego APIC gościa, w ogóle bez VM exit. Gość widzi przerwanie tak, jakby przyszło z bare metal. Narzut spada do kilkuset nanosekund.
Nie każda platforma obsługuje posted interrupts. Starsze CPU, niektóre chipsety stacji roboczych i niektóre wersje BIOS-u nie udostępniają tej funkcji. Gdy jej brak, każde przerwanie idzie wolną ścieżką i nie ma na to obejścia programowego.
Reset urządzenia
Gdy VM się wyłącza albo pada, przekazane urządzenie musi wrócić do czystego, znanego stanu. Inaczej nie da się go przypisać innej VM ani odzyskać dla hosta.
Na bare metal system robi uporządkowane zamknięcie sterownika urządzenia. Przy passthrough gość może paść, użytkownik może wymusić zatrzymanie VM, albo hiperwizor może zabić proces. Urządzenie może być w połowie transferu, z operacjami DMA w locie.
PCIe definiuje do tego Function Level Reset (FLR): sposób na zresetowanie pojedynczej funkcji urządzenia bez wpływu na resztę magistrali. Kontrolery NVMe na ogół obsługują FLR i radzą sobie z nim dobrze. GPU są w tym notorycznie kiepskie, ale to temat na inny artykuł.
Jeśli FLR nie jest obsługiwany, rezerwą jest secondary bus reset, który resetuje wszystko za danym mostkiem PCIe. Jeśli na mostku są inne urządzenia, one też dostają reset. W najgorszym przypadku jedynym sposobem na odzyskanie urządzenia jest pełny restart hosta.
Narzut translacji adresów
IOMMU rozwiązuje problem bezpieczeństwa. Jako takie nie jest opcjonalne. Ale wprowadza problem wydajności.
Każda operacja DMA przechodzi teraz przez dodatkowy poziom translacji adresów. IOMMU ma własny TLB, IOTLB, i przy trafieniu narzut jest mały. Przy chybieniu IOMMU musi przejść po swoich tablicach stron, a to dokłada realne opóźnienie do każdej dotkniętej operacji IO.
To jest podatek IOMMU. Reszta artykułu jest o tym, skąd się bierze i jak go zminimalizować.
Mapowanie BAR i przestrzeń adresowa
Każde urządzenie PCIe udostępnia jeden lub więcej Base Address Registers (BAR), które mapują wewnętrzne rejestry i pamięć urządzenia w przestrzeń adresową MMIO hosta. CPU hosta dostaje się do urządzenia przez te mapowania. Żeby passthrough działał, hiperwizor musi poprawnie przedstawić te mapowania gościowi.
Tradycyjnie rozmiary BAR ustalał BIOS przy starcie i mieściły się one w starym 32-bitowym oknie MMIO poniżej 4GB. Działało to, póki BAR-y były małe. Nowoczesne GPU zmieniły obraz. Framebuffer 24GB potrzebuje BAR-u 24GB, który nie mieści się w 32-bitowej przestrzeni adresowej.
Resizable BAR (ReBAR), sprzedawany też jako AMD Smart Access Memory (SAM), to funkcja PCIe pozwalająca renegocjować rozmiar BAR po starcie. Dla GPU to istotna funkcja. Zamiast sięgać do framebuffera przez okno 256MB i stronicować go kawałkami, host mapuje cały VRAM naraz.
Dla NVMe bezpośredni wpływ jest mniejszy. BAR-y kontrolera NVMe mają zwykle od 16KB do 64KB na zestaw rejestrów kontrolera (BAR0). Specyfikacja NVMe definiuje Controller Memory Buffer (CMB), który może udostępnić większy BAR dla kolejek zgłoszeń trzymanych po stronie hosta, ale większość dysków go nie implementuje. ReBAR nie zmienia przepustowości NVMe tak, jak zmienia ją dla GPU.
Ma znaczenie przy passthrough NVMe ze względu na wspólne środowisko PCIe. Jeśli przekazujesz dysk NVMe obok GPU na tym samym hoście, powiększony BAR GPU potrzebuje przestrzeni adresowej powyżej granicy 4GB. BIOS, IOMMU i wirtualna topologia PCIe muszą to wszystko pomieścić. Źle rozdzielona przestrzeń adresowa oznacza, że urządzenia się nie inicjalizują, a passthrough NVMe pada razem z resztą.
Narażenie na utratę zasilania
Na dysku wirtualnym kolejność zapisów i spójność po awarii obsługują hiperwizor i warstwa storage. Przy passthrough gość rozmawia bezpośrednio z flashem. Jeśli host straci zasilanie w trakcie zapisu, to, co firmware kontrolera NVMe zrobi ze swoim cache zapisu albo czego nie zrobi, decyduje o tym, czy stracisz dane.
Dyski NVMe klasy enterprise mają kondensatory power loss protection (PLP), które przy zaniku zasilania bezpiecznie opróżniają cache zapisu. Dyski konsumenckie bez PLP mogą tego nie robić. Przy passthrough między gościem a sprzętem nie ma siatki bezpieczeństwa hiperwizora.
Dla obciążenia produkcyjnego dysk enterprise z PLP nie jest opcją do wyboru.
Kompromisy operacyjne
Passthrough odbiera też możliwości, które dają dyski wirtualne.
Przekazane urządzenie jest fizycznie przykręcone do konkretnego hosta. VM nie da się migrować na żywo, póki urządzenie jest podłączone. W klastrze Proxmox z HA awaria węzła oznacza, że VM pada i startuje od zera na innym węźle. Nie ma płynnego przełączenia.
Dysk jest też niewidoczny dla vzdump i Proxmox Backup Server.
Nie trafi do snapshotów VM ani do zaplanowanych kopii zapasowych.
Zanim obciążenie wejdzie na produkcję, musi być gotowa osobna strategia kopii: na poziomie gościa, systemu plików albo aplikacji.
Jak naprawdę działa passthrough VFIO
Gdy przekazujesz urządzenie PCIe do VM, hiperwizor oddaje gościowi bezpośrednią kontrolę nad rejestrami MMIO urządzenia. Sterownik gościa rozmawia z kontrolerem NVMe tak, jakby działał na bare metal. Ta część jest prawie natywna. Dostęp do rejestrów MMIO idzie przez Extended Page Tables (EPT u Intela, NPT u AMD) i zwykle kończy się bez VM exit.
Koszt pojawia się na ścieżce DMA. Każda operacja DMA przechodzi przez IOMMU do translacji adresów, a jak opisano wyżej, ta translacja ma swoją cenę. Zwłaszcza przy chybieniach IOTLB.
Dlaczego benchmarki wyglądają gorzej niż rzeczywistość
Tu większość ludzi myli się w testach.
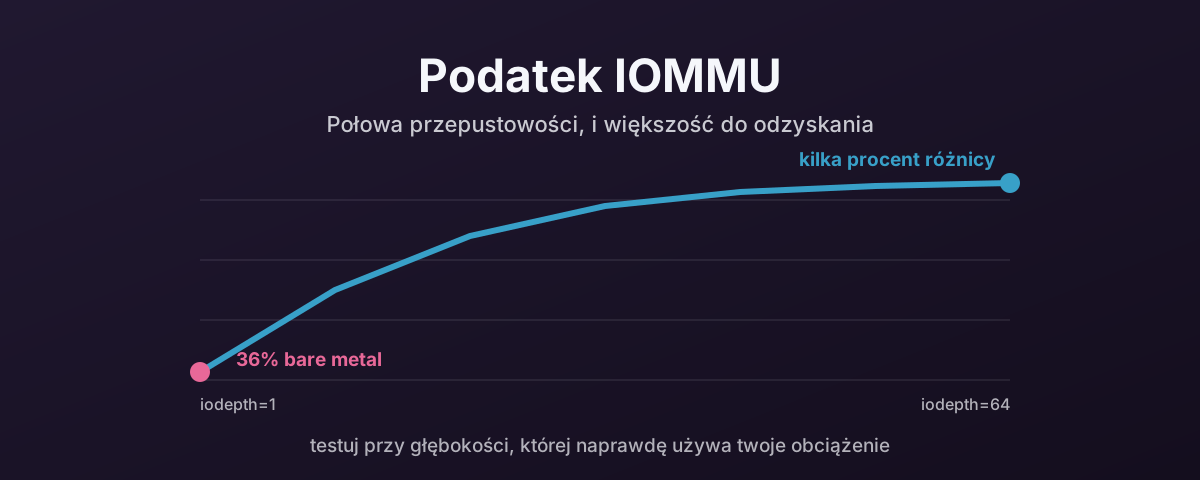
W wątku na forum Proxmox, który dał początek temu artykułowi, użytkownicy uruchamiali fio z iodepth=1.
Przy tej głębokości kolejki fio wysyła jedno IO, czeka na jego zakończenie, potem wysyła następne.
Test mierzy wyłącznie opóźnienie pojedynczego IO.
Każda mikrosekunda narzutu IOMMU widać w całości.
Liczby z tego wątku mówią to wyraźnie.
Opóźnienie zakończenia na bare metal wynosiło średnio około 10µs.
Wewnątrz VM średnio około 28µs.
Te dodatkowe ~18µs na IO to narzut translacji IOMMU.
Przy iodepth=1 wprost obcina przepustowość o połowę, bo przepustowość równa się 1 / latency, gdy w locie jest tylko jedno IO.
Podnieś głębokość kolejki do 32 albo 64, czyli tak, jak dyski NVMe są projektowane do pracy, i obraz się zmienia. Przy wielu IO w locie narzut IOMMU rozkłada się na wszystkie. Kontroler przetwarza zakończenia, podczas gdy trwają nowe translacje. Przepustowość wraca do poziomu kilku procent od bare metal.
Praktyczny wniosek jest taki. Jeśli twoje obciążenie pracuje przy głębokości kolejki powyżej 4, kara przepustowości od IOMMU jest prawdopodobnie pomijalna. To obejmuje większość obciążeń bazodanowych, wirtualizacyjnych i storage. Jeśli twoje obciążenie jest wrażliwe na opóźnienia przy niskiej głębokości kolejki, jak niektóre aplikacje czasu rzeczywistego czy synchroniczne operacje na metadanych, poczujesz to.
Uruchom benchmarki przy realistycznych głębokościach kolejki, zanim uznasz, że passthrough jest za wolny:
# Bare metal baseline — run on the host before binding to vfio-pci
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting

# Same test inside the VM after passthrough
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Porównaj percentyle clat (opóźnienie zakończenia) i wartości IOPS.
Przy iodepth=32 i czterech zadaniach różnica powinna wynosić jednocyfrową liczbę punktów procentowych, nie 50%.
Wyrównanie NUMA
To ma własny artykuł. Zobacz Wyrównanie NUMA w Proxmox VE: dlaczego ma znaczenie i jak zrobić to dobrze.
W skrócie: w systemach wielogniazdowych każde urządzenie PCIe jest podpięte do konkretnego gniazda. Jeśli dysk NVMe jest na węźle NUMA 1, a vCPU maszyny wirtualnej są przypięte do węzła 0, każde zakończenie DMA przechodzi przez łącze między gniazdami. To dodaje 50–100ns na operację. Przy wysokich IOPS różnica przepustowości między wyrównanym a niewyrównanym NUMA wynosi 20–30%.
Sprawdź przez cat /sys/bus/pci/devices/0000:XX:00.0/numa_node, potem przypnij vCPU maszyny do rdzeni na tym samym węźle parametrem affinity w konfiguracji VM.
W systemach jednogniazdowych to cię nie dotyczy.
PCIe Active State Power Management (ASPM)
To ma własny artykuł. Zobacz PCIe ASPM i dlaczego warto go wyłączyć przy passthrough.
W skrócie: ASPM pozwala łączom PCIe wchodzić w stany niskiego poboru mocy, gdy są bezczynne.
Przy passthrough host nadal kontroluje fizyczne łącze, ale urządzenie należy do gościa.
Gdy gość wysyła IO, a łącze śpi, czas wybudzenia dokłada opóźnienie.
Objawem jest duży rozrzut percentyli clat. p99 może być 5–10x wyższe od średniej, podczas gdy średnia wygląda dobrze.
Wyłącz go na hoście przez pcie_aspm=off w linii poleceń jądra.
Dodaj też disable_idle_d3=1 do opcji modułu vfio-pci, jeśli twój kontroler NVMe ma problemy z powrotem ze stanów zasilania. Samsung 990 EVO Plus to znany winowajca.
MaxPayloadSize (MPS)
To ma własny artykuł. Zobacz PCIe MaxPayloadSize: darmowy zysk wydajności przy passthrough.
W skrócie: urządzenia PCIe przesyłają dane w pakietach Transaction Layer Packets.
Wirtualny root complex QEMU domyślnie ma maksymalny payload 128 bajtów.
Większość urządzeń obsługuje 256 albo 512 bajtów.
Dodanie pci=pcie_bus_perf do linii poleceń jądra hosta ustawia MPS na maksimum, na jakie pozwala magistrala nadrzędna każdego urządzenia.
To mały zysk przepustowości, niska jednocyfrowa liczba procent, ale darmowy i bez wad.
Resizable BAR i apertura MMIO
Problem mapowania BAR opisany wcześniej ma praktyczne kroki zarówno po stronie BIOS-u, jak i VM.
Najpierw włącz w BIOS-ie Above 4G Decoding. Pozwala to mapować BAR-y w przestrzeń adresową powyżej granicy 4GB, co jest wymagane dla każdego urządzenia z dużymi BAR-ami. Włącz to nawet przy passthrough samego NVMe. Nie ma wad i oszczędza problemów, jeśli później dodasz GPU albo inne urządzenie z dużym BAR-em.
Jeśli ReBAR jest dostępny w BIOS-ie, włącz go też. Nie wpłynie bezpośrednio na wydajność NVMe, ale pozwala GPU na tym samym hoście używać pełnego mapowania framebuffera.
Po stronie VM wirtualny root complex Q35 w QEMU potrzebuje wystarczająco dużego 64-bitowego okna MMIO, żeby gość widział powiększone BAR-y. Domyślnie OVMF przydziela stosunkowo małe okno. Przy passthrough samego NVMe to wystarcza. BAR-y NVMe mieszczą się z zapasem. Ale jeśli VM ma przekazane i NVMe, i GPU, zwiększ aperturę MMIO:
args: -fw_cfg name=opt/ovmf/X-PciMmio64Mb,string=65536
To każe OVMF przydzielić 64GB 64-bitowej przestrzeni MMIO, wystarczająco na większość framebufferów GPU obok małego BAR-u kontrolera NVMe.
Wsparcie ReBAR w QEMU się poprawia, ale wciąż nie jest bezproblemowe. Niektóre GPU AMD (Vega i nowsze) wywołują błędy sterownika (Code 43 w Windows) z włączonym ReBAR pod QEMU. Jeśli na to trafisz, w pierwszym kroku wyłącz ReBAR w BIOS-ie. Passthrough NVMe nie zostanie dotknięty ani tak, ani tak.
Co Resizable BAR robi po stronie GPU i dlaczego Intel traktuje go jako obowiązkowy na Arc, a NVIDIA włącza go per gra, opisuje PCIe Resizable BAR i nowoczesne GPU.
Obsługa przerwań
Problem dostarczania przerwań opisany wcześniej ma praktyczny krok strojenia. Posted interrupts (APICv u Intela, AVIC u AMD) mogą nie być domyślnie włączone.
Sprawdź, czy są aktywne:
# Intel — look for "Posted-Interrupts" in dmesg
dmesg | grep -i "posted"

# AMD — check AVIC support
dmesg | grep -i "avic"
Na systemach AMD EPYC włącz AVIC w module KVM, jeśli nie jest domyślnie włączony:
# /etc/modprobe.d/kvm.conf
options kvm_amd avic=1
Na systemach Intela APICv z posted interrupts jest zwykle włączany automatycznie, gdy VT-d jest aktywne.
Jeśli twoja platforma nie obsługuje posted interrupts, nie ma obejścia programowego. To funkcja sprzętowa. Ale warto sprawdzić, czy faktycznie jest włączona, zanim założysz, że wolnej ścieżki nie da się uniknąć.
Afinity przerwań i wyrównanie kolejek
Kontrolery NVMe używają wielu par kolejek zgłoszeń i zakończeń. Zwykle jednej na rdzeń CPU. Gdy vCPU maszyny nie pokrywają się z fizycznymi rdzeniami obsługującymi przerwania NVMe, zakończenia muszą przechodzić między rdzeniami przez przerwania międzyprocesorowe. To dokłada opóźnienie.
Wewnątrz gościa sprawdź, ile kolejek IO utworzył sterownik NVMe i jak są zmapowane:
# List NVMe IO queues
cat /proc/interrupts | grep nvme

# Check affinity
for irq in $(grep nvme /proc/interrupts | awk '{print $1}' | tr -d ':'); do
    echo "IRQ $irq: $(cat /proc/irq/$irq/smp_affinity_list)"
done
Najlepiej, gdy przerwanie każdej kolejki IO NVMe ma afinity do vCPU, który wysyła do tej kolejki. Większość nowoczesnych sterowników NVMe robi to automatycznie. Ale warto to sprawdzić, zwłaszcza jeśli ręcznie przypiąłeś vCPU albo zmniejszyłeś liczbę vCPU poniżej liczby kolejek kontrolera.
Zawsze Q35, nie i440fx
To zasługuje na własny artykuł. Zobacz Zawsze Q35, nie i440fx.
W skrócie: i440fx przedstawia płaską, starą magistralę PCI. Q35 przedstawia porządny root complex PCIe. Urządzenia przekazane na i440fx wyglądają jak stare PCI, co psuje wielokolejkowe dostarczanie przerwań MSI-X. Kontrolery NVMe potrzebują MSI-X do swojej architektury kolejki na rdzeń. Bez niego wszystkie zakończenia IO lecą przez jedno przerwanie i masz wąskie gardło przy wysokich IOPS, którego nie naprawi żadne strojenie jądra.
W Proxmox 8.x i nowszych Q35 jest domyślny dla nowych VM. Jeśli robisz passthrough na starszej VM, która wciąż jest na i440fx, przełącz ją. RHEL 10 formalnie oznaczył i440fx jako przestarzały, a szerszy ekosystem KVM idzie w tę samą stronę.
Wszystko razem
Oto podsumowanie kroków strojenia w kolejności wpływu.
Wyrównanie NUMA: upewnij się, że dysk NVMe i vCPU maszyny są na tym samym węźle NUMA. Samo to może dać 20–30% różnicy przepustowości w systemach wielogniazdowych.
ASPM wyłączony: dodaj pcie_aspm=off do linii poleceń jądra hosta.
Usuwa wahania opóźnień od przejść stanów zasilania łącza PCIe.
Realistyczne głębokości kolejki: testuj przy iodepth=32 lub więcej, nie iodepth=1.
Narzut IOMMU, który dominuje przy niskiej głębokości kolejki, rozkłada się przy realistycznych głębokościach.
Posted interrupts: sprawdź, czy APICv (Intel) lub AVIC (AMD) jest aktywny. Zmniejsza narzut na przerwanie z mikrosekund do nanosekund.
Optymalizacja MPS: dodaj pci=pcie_bus_perf do linii poleceń jądra hosta.
Ustawia MaxPayloadSize na maksimum, które obsługuje topologia.
Zarządzanie energią vfio-pci: dodaj disable_idle_d3=1, jeśli twój kontroler NVMe ma problemy ze stanami zasilania przy passthrough.
Łączna linia poleceń jądra hosta dla węzła Proxmox robiącego passthrough NVMe na systemie AMD EPYC wyglądałaby mniej więcej tak:
GRUB_CMDLINE_LINUX_DEFAULT="quiet amd_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Dla Intela:
GRUB_CMDLINE_LINUX_DEFAULT="quiet intel_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Kiedy passthrough się nie opłaca
Zanim pójdziesz tą drogą, warto zapytać, czy w ogóle potrzebujesz passthrough NVMe.
VirtIO-SCSI i VirtIO-BLK z dyskiem wirtualnym na NVMe są już bardzo wydajne. Narzut w porównaniu z passthrough to zwykle 5–10% na opóźnieniu. Różnica przepustowości jest pomijalna dla większości obciążeń.
Passthrough ma sens, gdy system gościa musi zarządzać urządzeniem bezpośrednio. To obejmuje monitoring SMART, aktualizacje firmware, kontrolę TRIM/discard i konkretne funkcje NVMe, jak reservations. Ma też sens dla obciążeń wrażliwych na opóźnienia, gdzie liczy się nawet kilka mikrosekund. Niektóre silniki baz danych i pobieranie danych w czasie rzeczywistym należą do tej kategorii.
Dla całej reszty kompromisy operacyjne omówione wcześniej, czyli utrata migracji na żywo, snapshotów i integracji z kopiami zapasowymi, zwykle przeważają nad małym zyskiem wydajności.
Nie ma nic mądrego w wybieraniu trudniejszej drogi, kiedy łatwiejsza robi robotę.
Weryfikacja zmian
Po zastosowaniu kroków strojenia sprawdź, czy wszystko działa jak trzeba:
# Host side — confirm IOMMU is in passthrough mode
dmesg | grep -i iommu

# Confirm ASPM is disabled
lspci -vv | grep -i "ASPM Disabled"

# Check MPS on the NVMe controller
lspci -vv -s XX:00.0 | grep MaxPayload

# Inside the VM — run the fio comparison
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Porównaj wyniki z VM z wcześniejszą bazą z bare metal.
Przy iodepth=32 przepustowość powinna być w granicach 5% od bare metal.
Średnie opóźnienia zakończenia powinny być w granicach 10–15µs od wartości hosta.
Jeśli różnica nadal jest duża, najpierw sprawdź wyrównanie NUMA.
To najczęściej przeoczany czynnik.
Kosztuje też tylko zmianę konfiguracji, co czyni go najlepszym rodzajem problemu, jaki może ci zostać.
Źródła
- Dokumentacja PCI jądra Linux: opcje strojenia MPS i MRRS — autorytatywne źródło dla
pcie_bus_perf,pcie_bus_safei powiązanych parametrów - Proxmox VE Administration Guide: PCI(e) Passthrough — oficjalna dokumentacja Proxmox o konfiguracji passthrough urządzeń VFIO
- Forum Proxmox: NVMe Passthrough Performance — dyskusja społeczności, od której zaczął się ten artykuł