Czym jest NUMA
NUMA to skrót od Non-Uniform Memory Access. Na systemie z jednym gniazdem każdy rdzeń CPU sięga do całej pamięci RAM przez ten sam kontroler pamięci. Czas dostępu jest taki sam bez względu na to, który rdzeń wysyła żądanie i gdzie dane leżą w pamięci fizycznej.
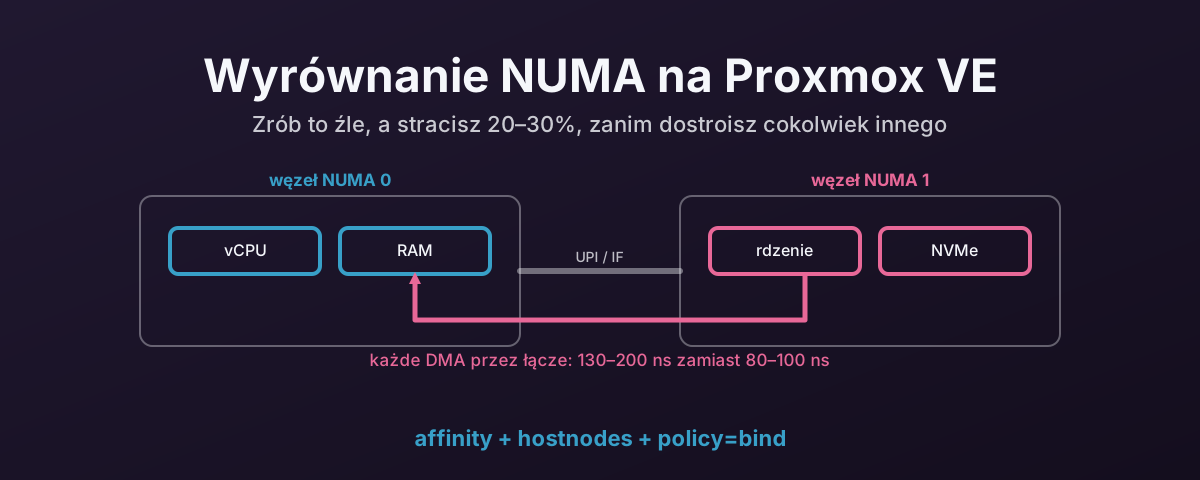
Na systemie wieloprocesorowym każde gniazdo CPU ma własny kontroler pamięci i własny bank RAM. Rdzeń na gnieździe 0 szybko sięga do RAM podłączonej do gniazda 0: to pamięć lokalna. Może też sięgnąć do RAM podłączonej do gniazda 1, ale takie żądanie musi przejść przez łącze między gniazdami (Intel UPI, AMD Infinity Fabric). To pamięć zdalna i jest wolniejsza.
Jądro nazywa każde gniazdo razem z jego lokalną pamięcią węzłem NUMA. Dwuprocesorowy system AMD EPYC ma co najmniej dwa węzły NUMA. Niektóre procesory EPYC wystawiają cztery węzły NUMA na gniazdo (po jednym na CCD), co na płycie dwuprocesorowej daje osiem węzłów.
Różnica w wydajności między dostępem lokalnym a zdalnym nie jest subtelna. Dostęp lokalny to około 80–100 ns. Dostęp zdalny to około 130–200 ns. To kara 50–100% przy każdej operacji na pamięci. Sama w sobie to bardzo mała liczba. Płacona przy każdym dostępie do pamięci przez całe życie VM przestaje być mała.
Dlaczego to ma znaczenie przy wirtualizacji
Kiedy Proxmox tworzy VM, przydziela jej vCPU i RAM. Domyślnie te vCPU mogą być planowane na dowolnym fizycznym rdzeniu na dowolnym gnieździe. RAM maszyny wirtualnej może pochodzić z puli pamięci dowolnego węzła NUMA.
Jeśli planista umieści vCPU na gnieździe 0, a RAM maszyny jest na gnieździe 1, każdy dostęp do pamięci z tego vCPU przechodzi przez łącze między gniazdami. Jeśli vCPU skaczą między gniazdami, a skaczą, gdy nie są przypięte, wzorzec dostępu do pamięci robi się bałaganem. Część dostępów jest lokalna, część zdalna, a wydajność VM faluje w tym samym rytmie.
Przy ogólnych obciążeniach, takich jak serwer WWW, serwer plików czy VM z pulpitem, często da się z tym żyć. Narzut istnieje, ale rozkłada się na wiele operacji i nie dominuje.
Przy obciążeniach intensywnych pod względem IO, czyli bazach danych, serwerach pamięci masowej i wszystkim, co mocno obciąża dysk albo sieć, kara się kumuluje. Każde zakończenie DMA, każde dostarczenie przerwania, każda kopia bufora oznacza dostęp do pamięci. Jeśli te dostępy przechodzą między gniazdami, narzut szybko rośnie.
Dlaczego to ma znaczenie przy passthrough
Urządzenia PCIe są fizycznie podłączone do konkretnego gniazda CPU. Każde gniazdo ma własny kompleks główny PCIe. Dysk NVMe w gnieździe rozszerzeń 3 może siedzieć na liniach PCIe gniazda 0. Karta graficzna w gnieździe 5 może siedzieć na liniach gniazda 1.
Kiedy urządzenie wykonuje DMA, dane trafiają do pamięci tego węzła NUMA, na który mapuje je IOMMU. Jeśli RAM maszyny wirtualnej pochodzi z węzła lokalnego dla urządzenia, zapis DMA idzie prosto do pamięci lokalnej. Jeśli RAM jest na drugim węźle, każda operacja DMA przechodzi przez łącze między gniazdami.
Dla dysku NVMe robiącego setki tysięcy IOPS ta kara 50–100 ns na operację się sumuje.
Przy iodepth=32 i losowych odczytach 4 KB różnica przepustowości między wyrównanym a niewyrównanym NUMA może wynieść 20–30%.
I to zanim spojrzysz na narzut IOMMU, ASPM, MPS czy cokolwiek innego.
To samo dotyczy kart sieciowych, kart graficznych i każdego innego urządzenia przekazanego przez passthrough. Ruch DMA urządzenia powinien trafiać do pamięci lokalnej, a vCPU, które ten ruch przetwarzają, powinny być na tym samym węźle.
Jak sprawdzić swoją topologię
Na którym węźle NUMA jest urządzenie
# Replace 0000:XX:00.0 with your device's PCI address from lspci
cat /sys/bus/pci/devices/0000:XX:00.0/numa_node
To polecenie zwraca numer węzła NUMA.
Jeśli zwraca -1, jądro nie zdołało ustalić węzła. Zdarza się to czasem przy urządzeniach za niektórymi przełącznikami PCIe.
Wtedy prześledź topologię PCIe ręcznie poleceniem lspci -tv i dopasuj port główny do gniazda.
Pełny układ NUMA
numactl --hardware
Pokazuje każdy węzeł NUMA, ile rdzeni CPU na nim jest, ile pamięci jest podłączone i odległość (względny koszt) między węzłami.
Przykładowy wynik z dwuprocesorowego systemu EPYC:
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
node 0 size: 131072 MB
node 1 cpus: 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31
node 1 size: 131072 MB
node distances:
node   0   1
  0:  10  32
  1:  32  10
Tabela odległości mówi ci o względnym koszcie. 10 to dostęp lokalny. 32 to zdalny. Wyższe liczby oznaczają więcej skoków. W konfiguracjach EPYC z czterema węzłami na gniazdo niektóre pary węzłów mają odległość 32, a inne 16, zależnie od tego, na którym CCD leżą.
Przypisz urządzenia do węzłów
# List all PCI devices and their NUMA nodes
for dev in /sys/bus/pci/devices/*; do
    node=$(cat "$dev/numa_node" 2>/dev/null)
    echo "$(basename $dev) node=$node $(lspci -s $(basename $dev) 2>/dev/null | cut -d' ' -f2-)"
done
To daje pełny obraz tego, które urządzenia są na których węzłach. Szukaj swoich kontrolerów NVMe, kart sieciowych i wszystkich kart graficznych, które przekazujesz przez passthrough.
Jak wyrównać VM w Proxmoksie
Przypnij vCPU do właściwego węzła
W pliku konfiguracyjnym VM (/etc/pve/qemu-server/<vmid>.conf):
numa: 1
affinity: 0-15    # Adjust to match cores on the correct NUMA node
Parametr affinity przypina vCPU maszyny wirtualnej do konkretnych fizycznych rdzeni.
Ustaw go na zakres rdzeni na tym samym węźle NUMA co urządzenie przekazane przez passthrough.
Jeśli twój NVMe jest na węźle 1, a węzeł 1 ma rdzenie 16–31, ustaw affinity: 16-31.
Jeśli VM potrzebuje tylko 8 vCPU, przypnij ją do podzbioru: affinity: 16-23.
Przydziel pamięć z właściwego węzła
Włączenie numa: 1 w konfiguracji VM każe Proxmoksowi przedstawić maszynie wirtualnej topologię NUMA.
QEMU spróbuje przydzielić pamięć VM z tego węzła NUMA, do którego przypięto vCPU.
Jeśli chcesz mieć jawną kontrolę, możesz ustawić topologię NUMA w konfiguracji VM:
numa0: cpus=0-7,hostnodes=0,memory=16384,policy=bind
To każe QEMU powiązać pierwszy węzeł NUMA maszyny wirtualnej (węzeł 0 z punktu widzenia gościa) z węzłem NUMA hosta 0, z rdzeniami 0–7 i 16 GB pamięci.
policy=bind gwarantuje, że pamięć jest przydzielana wyłącznie z tego węzła, zamiast przechodzić na inne węzły, gdy lokalna pula jest pod presją.
Sprawdź przypięcie
Po uruchomieniu VM sprawdź, czy vCPU naprawdę działają tam, gdzie się spodziewasz:
# Find the QEMU process
pgrep -a qemu | grep <vmid>

# Check CPU affinity of the process
taskset -cp <pid>

# Or check per-vCPU thread affinity
for tid in $(ls /proc/<pid>/task/); do
    echo "Thread $tid: $(taskset -cp $tid 2>/dev/null)"
done
Typowe błędy
Brak przypięcia w ogóle
Jeśli nie ustawisz affinity, vCPU maszyny wirtualnej mogą być planowane na dowolnym rdzeniu.
Planista jądra będzie je przenosił między węzłami, równoważąc obciążenie.
Za każdym razem, gdy vCPU migruje z jednego węzła na inny, wszystkie dane, na których pracował w pamięci podręcznej starego węzła, stają się zdalne.
Dla zwykłych VM jest to do przyjęcia. Dla VM z passthrough, które robią dużo IO, już nie.
Przypięcie do złego węzła
Sprawdź węzeł NUMA urządzenia, zanim cokolwiek przypniesz.
Nie zakładaj.
Na niektórych płytach głównych fizyczna numeracja gniazd rozszerzeń nie odpowiada w oczywisty sposób przypisaniu do węzłów NUMA.
Zawsze sprawdzaj poleceniem cat /sys/bus/pci/devices/.../numa_node.
Przeciążenie jednego węzła
Jeśli przypniesz za dużo VM do tego samego węzła NUMA, rdzenie tego węzła zostaną przeciążone, a lokalnej puli pamięci zabraknie. Kiedy pamięć przelewa się na węzeł zdalny, dostajesz najgorsze z obu światów: przypięte vCPU ze zdalną pamięcią.
Rozkładaj VM równomiernie między węzły. Jeśli masz dwa węzły NUMA i cztery VM, rozłóż je po równo.
Zapomniany przydział pamięci
Przypięcie vCPU bez kontroli nad przydziałem pamięci daje połowę korzyści.
vCPU są na właściwym węźle, ale pamięć może nie być.
Użyj policy=bind albo przynajmniej włącz numa: 1, żeby przydział pamięci w QEMU szedł za przypięciem CPU.
Systemy z jednym gniazdem
Na systemie z jednym gniazdem wszystko jest na węźle NUMA 0. Jest tylko jeden kontroler pamięci i jeden zestaw linii PCIe. Wyrównanie NUMA nie jest tu problemem.
Nadal możesz ustawić numa: 1 w konfiguracji VM, niczemu to nie zaszkodzi, ale też w niczym nie pomoże.
Jedno gniazdo, jeden kontroler pamięci, nic do wyrównania.
Zachowaj wysiłek na maszynę, która ma dwa.
Dlatego zysk wydajności opisany tutaj dotyczy wyłącznie systemów wieloprocesorowych, w których istnieje łącze między gniazdami.
Źródła
- Proxmox VE Administration Guide — CPU and NUMA Configuration — oficjalna dokumentacja przypinania vCPU i opcji NUMA
- Linux kernel NUMA documentation — opis polityk pamięci w jądrze
- AMD EPYC 7003 Series — BIOS & Workload Tuning Guide (doc 58002) — dokumentacja AMD o NUMA na gniazdo i topologii CCD/CCX