Pytanie, od którego zaczyna się każda ocena Proxmoksa
„Czy Proxmox naprawdę jest klasy enterprise?”
Pada w prawie każdej rozmowie o migracji, a obawa pod spodem prawie nigdy nie dotyczy interfejsu WWW. Nikt na poważnie nie boi się, że panel w przeglądarce zepsuje mu dane. Ludzie pytają o to, czy rzecz stojąca między maszyną wirtualną a sprzętem, komponent, który ma trzymać jednego najemcę z dala od pamięci drugiego, na zawsze i bez jednego błędu, jest poważnym kawałkiem inżynierii, czy projektem społeczności, który zrobił się popularny.
Dokładnie tym warto się denerwować. Tyle że ta nerwowość celuje w złą warstwę, bo Proxmox VE nie zawiera hypervisora.
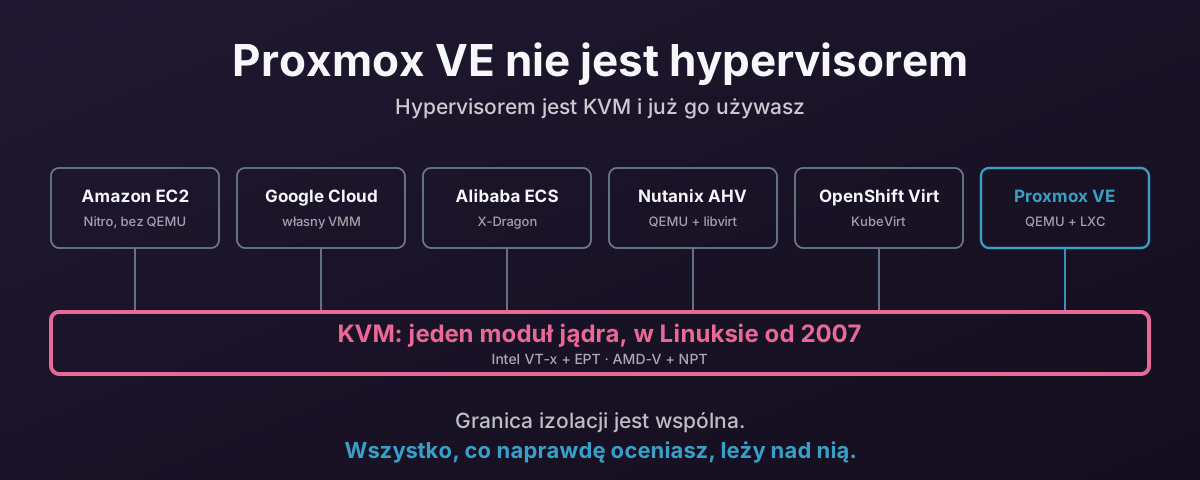
Hypervisorem jest KVM. Jest częścią Linuksa, siedzi w nim od 2007 roku i jeśli twoja organizacja korzysta z EC2, Google Cloud, Oracle Cloud, Alibaba Cloud, DigitalOcean albo Nutanix, to już dziś masz go na produkcji. Po prostu nigdy nie musiałeś o nim myśleć, bo warstwy nad nim należały do kogoś innego.
Ten wpis jest o tym, co ten wspólny fundament naprawdę znaczy. O obu połowach: o części argumentu, która naprawdę się trzyma, i o części, którą slajdy dostawców przeciągają.
Proxmox VE to warstwa zarządzania
Wirtualizacja na Linuksie to cztery osobne warstwy, budowane i utrzymywane przez cztery różne grupy ludzi.
1. Sprzętowe rozszerzenia wirtualizacji. Intel VT-x z EPT albo AMD-V z NPT. Krzem. To one pozwalają gościowi uruchomić własne jądro z natywną prędkością i z własnymi tablicami stron, bez niczego, co emulowałoby instrukcje.
2. KVM, czyli hypervisor.
Moduły jądra: kvm.ko dla rdzenia niezależnego od architektury plus kvm-intel.ko albo kvm-amd.ko dla rozszerzeń producenta. To komponent, do którego należy granica izolacji. Ustawia struktury sterujące maszyny wirtualnej gościa, obsługuje wyjścia z VM, zarządza tablicami stron drugiego poziomu i dostarcza przerwania.
3. VMM, czyli monitor maszyn wirtualnych w przestrzeni użytkownika. W Proxmox VE jest nim QEMU. Buduje wirtualną płytę główną: chipset, topologię PCIe, dyski, karty sieciowe, porty szeregowe, firmware. KVM uruchamia procesor; QEMU decyduje, jaki sprzęt gość myśli, że ma.
4. Warstwa zarządzania.
To jest Proxmox VE: pve-manager i pveproxy dla API i interfejsu, qemu-server, który zamienia plik konfiguracyjny VM na linię poleceń QEMU, pve-container dla LXC, pmxcfs na Corosyncu dla replikowanej konfiguracji klastra, pve-ha-manager do fencingu i restartów, do tego zapora i stos SDN.
Te cztery warstwy istnieją też na platformie, z której migrujesz, i robią tam te same cztery rzeczy. vCenter to warstwa 4, VMkernel to warstwa 2, a do tego porównania wrócę, kiedy wszystkie elementy będą już na stole.
Co Proxmox naprawdę utrzymuje
Proxmox VE w całości posiada warstwę 4. Błędem byłoby jednak powiedzieć, że warstwy 2 i 3 tylko pakuje, a to najczęstsze złe odczytanie tego, czym ta firma się zajmuje.
pve-qemu niesie w chwili pisania 78 łatek na upstreamowe QEMU w swoim pliku series:
debian/patches/series. Większość kolejki to własna inżynieria Proxmoksa, a cała siedzi w warstwie 3. Żadna z tych łatek nie dotyka kvm.ko.Budują też własne jądro i utrzymują pakiety albo łatki dla większości otaczającego stosu: pve-edk2-firmware dla OVMF, do tego lxc, zfsonlinux, openvswitch, libiscsi, corosync-pve, lvm i ceph.
Prawdziwa granica wygląda więc tak: cała warstwa 4, sporo inżynierii wewnątrz warstwy 3 i jądro, które sami kompilują. Czego nie zrobili, to nie napisali hypervisora. Kod KVM w warstwie 2 to upstreamowy Linux.
I nic z tego nie jest krytyką Proxmoksa. Jako takie, właśnie dlatego firmie wielkości Proxmoksa w ogóle można powierzyć tę robotę. Mała firma z Wiednia nie usiadła, żeby od zera napisać hypervisor; zbudowała na takim, za którego utrzymanie Intel, AMD, Red Hat, Google, Amazon i IBM już płaciły inżynierom, a własny wysiłek włożyła w warstwę wyżej i w pracę integracyjną, której ta warstwa potrzebuje. Tam zespół tej wielkości może coś zmienić, a kolejka łatek pokazuje, że zmienia.
Czym KVM naprawdę jest
KVM to skrót od Kernel-based Virtual Machine i nazwa jest dokładna: to funkcja jądra, nie program.
Załaduj moduły, a Linux zyskuje urządzenie znakowe /dev/kvm i mały zestaw wywołań ioctl na nim: KVM_CREATE_VM, KVM_CREATE_VCPU, KVM_SET_USER_MEMORY_REGION, KVM_RUN.
Ten interfejs to całe API hypervisora. Wszystko, co potrafi otworzyć deskryptor pliku i zawołać ioctl, może tworzyć maszyny wirtualne.
Napisał go Avi Kivity w Qumranecie, a wcielono go do Linuksa 2.6.20, wydanego w lutym 2007 roku, czyli dziewiętnaście lat temu. Red Hat kupił Qumranet w 2008 roku i KVM jest w każdym wydaniu jądra od tamtej pory, w zwykłym dla jądra rytmie co dziewięć, dziesięć tygodni. Przeniesiono go daleko poza x86: na arm64, POWER, s390 na IBM Z i RISC-V.
Ważna rzecz architektoniczna to to, dlaczego jest mały.
KVM nie ma planisty, bo Linux go ma. vCPU to zwykły wątek hosta, a completely fair scheduler sadza go na rdzeniu jak każdy inny wątek. Nie ma zarządcy pamięci, bo Linux go ma. RAM gościa to zwykłe mapowanie w przestrzeni użytkownika, więc może być stronicowany, oparty na hugepages albo umieszczony na węźle NUMA tą samą maszynerią co każdy inny proces. Nie ma stosu sterowników, warstwy blokowej, stosu sieciowego ani systemu plików, bo Linux miał już je wszystkie i to właśnie na nich testuje twój dostawca sprzętu.
To jest prawdziwy argument o dojrzałości i jest dużo mocniejszy niż numer wersji. Każde ulepszenie balansowania NUMA, każda zmiana w io_uring, każdy sterownik sieciowy, każde nowe obejście erraty procesora, które trafia do Linuksa, trafia pod twoje maszyny wirtualne, bo nie ma osobnego jądra hypervisora, do którego ktoś musiałby to przenosić.
Argument o typie 1 rysuje linię w złym miejscu
Zarzut, który niezawodnie pada potem, brzmi: KVM to „tylko hypervisor typu 2”. Działa na systemie hosta, w przeciwieństwie do ESXi, który działa na gołym sprzęcie.
Ta taksonomia jest o trzy dekady starsza od sprzętowej wirtualizacji, a to, wokół czego rysowała linię, nie leży już tam, gdzie wszyscy myślą.
Co naprawdę się dzieje, kiedy vCPU pracuje
QEMU woła ioctl(vcpu_fd, KVM_RUN). Sterowanie przechodzi do kvm.ko, który ładuje stan procesora gościa i wykonuje VMLAUNCH. Od tej instrukcji do następnego wyjścia z VM gość wykonuje się bezpośrednio na fizycznym rdzeniu, w trybie gościa, z własnymi tablicami stron aktywnymi przez EPT, z pełną prędkością sprzętu. Nie ma pod nim nic, co by cokolwiek interpretowało. „System hosta” nie leży na tej ścieżce. Na tym rdzeniu nawet nie działa.
Kiedy gość zrobi coś, co wymaga obsługi, procesor wychodzi do hosta i ląduje w kvm.ko, w jądrze, dokładnie na tym poziomie uprawnień, który zajmuje VMkernel w ESXi. Większość wyjść jest rozwiązywana właśnie tam i wraca do gościa, a przestrzeń użytkownika w ogóle się o tym nie dowiaduje.
ESXi ma ten sam podział
Teraz spójrz na platformę, która rzekomo dowodzi tego rozróżnienia.
Własna dokumentacja architektury VMware opisuje VMkernel jako „a POSIX-like operating system”, który zapewnia „process creation and control, signals, file system, and process threads”. To jest system operacyjny, według opisu jego autora. A działająca VM na ESXi nie jest czymś wewnątrz jądra, tylko grupą procesów userworld: VMM na każdy wirtualny procesor, który wirtualizuje instrukcje gościa i zarządza jego pamięcią, oraz proces VMX na każdą VM, który obsługuje wejście-wyjście do urządzeń niekrytycznych wydajnościowo i rozmawia z menedżerem migawek i zdalną konsolą.
Przeczytaj to, myśląc o QEMU. Kontekst wykonania na vCPU w jądrze, proces w przestrzeni użytkownika na VM, który emuluje urządzenia i zarządza. VMware podzieliło to z tego samego powodu co wszyscy inni.
Hyper-V nie jest inny. Dokumentacja Microsoftu mówi wprost, że Virtual Machine Worker Process, vmwp.exe, to „a user mode component of the virtualization stack”, uruchamiany na każdą VM, i że wszystkie emulowane urządzenia są zaimplementowane w nim, działającym w partycji root, czyli w Windows. Nawet Xen, architektura, do której ta taksonomia pasuje najlepiej, potrzebuje do działania Linuksa ogólnego przeznaczenia w dom0, a model urządzeń dla w pełni wirtualizowanych gości bierze z QEMU.
To gdzie jest ta linia?
Kryterium nigdy nie brzmiało „czy używa przestrzeni użytkownika”. Taksonomia Goldberga z początku lat 70. pyta, czy hypervisor jest aplikacją działającą na istniejącym wcześniej systemie operacyjnym, który już posiada sprzęt i zajmuje się planowaniem. To jest hypervisor typu 2, hostowany: VMware Workstation, VirtualBox, Parallels Desktop, gołe QEMU bez akceleracji. Instalujesz system ogólnego przeznaczenia, potem instalujesz na nim program, a ten program prosi system o pamięć i czas procesora jak każdy inny program.
KVM tym nie jest. kvm.ko nie jest programem na Linuksie. Jest częścią Linuksa, wykonuje się na tym samym poziomie uprawnień co kod, do którego należy sprzęt, a kiedy gość wychodzi, ląduje bezpośrednio tam. Pod hypervisorem nie ma żadnego systemu hosta. Jądro jest hypervisorem. Proxmox VE dostarcza to jądro jako system, dokładnie tak, jak ESXi dostarcza VMkernel jako system.
A wersji „potrzebuje przestrzeni użytkownika, więc to typ 2” nie da się uratować, bo stosowana konsekwentnie łapie wszystko. Żadna VM nie ruszy na ESXi bez swojego procesu VMX, żadna na Hyper-V bez vmwp.exe, żadna na Xenie jako gość HVM bez QEMU. Test, który wrzuca każdy dostępny na rynku hypervisor do jednego worka, niczego nie rozróżnia.
| Jądro, które posiada wirtualizację procesora i pamięci | Model urządzeń na VM w przestrzeni użytkownika | Potrzebuje wcześniej istniejącego systemu hosta? | |
|---|---|---|---|
| VMware ESXi | VMkernel | VMX na VM | Nie |
| Microsoft Hyper-V | hypervisor plus partycja root z Windows | vmwp.exe | Nie |
| Xen | hypervisor Xen plus Linux w dom0 | QEMU, w dom0 albo w stub domain | Nie |
| KVM | kvm.ko | QEMU | Nie |
| VirtualBox, VMware Workstation | jądro hosta, przez zainstalowany sterownik | sama aplikacja | Tak |
Cztery produkty, jeden kształt, a potem piąty wiersz, który naprawdę jest inny. Ten ostatni wiersz opisywano słowem „typ 2” i tylko w nim coś innego już wcześniej rządziło sprzętem.
Taksonomia więc nadal rysuje linię. Tylko że nie rysuje jej nigdzie blisko miejsca, które zakłada ten argument: KVM i ESXi stoją po tej samej stronie. Nazwanie KVM typem 2 to pożyczenie słowa z kategorii VirtualBoxa i przyklejenie go do czegoś, co architektonicznie należy do kategorii ESXi.
W ocenie ta etykieta nie robi więc nic pożytecznego, bo oba produkty, między którymi wybierasz, siedzą w tym samym pudełku. Różni je nie numer typu. Różni je to, że jeden dostawca napisał też jądro i nie pozwoli ci go przeczytać: to rozróżnienie licencyjne i dotyczące przejrzystości, przebrane w diagram architektury. Nutanix pokazuje to handlowo: dostarcza ten sam kod KVM co Proxmox i opisuje AHV jako hypervisor typu 1 na gołym sprzęcie. Ten sam kod, odwrotna etykieta, inny dział marketingu.
W tym zarzucie kryje się jednak prawdziwa obawa i zasługuje na lepszą nazwę: jądro ogólnego przeznaczenia robi tysiąc rzeczy, których jądro zbudowane do jednego celu nie robi, a to więcej kodu i większa powierzchnia ataku obok granicy izolacji. To uzasadnione i mierzalne, i wracam do tego pod koniec.
Gdzie praca naprawdę się dzieje
Jedyne miejsce, w którym odruch „przecież to działa na systemie hosta” ma rację bytu, to obsługa wyjść, więc warto jasno powiedzieć, które wyjścia trafiają dokąd.
| Gość robi to | Obsługuje | Koszt |
|---|---|---|
| Dotyka strony jeszcze niezmapowanej w EPT/NPT | kvm.ko, w jądrze | Jedno wyjście, mikrosekundy |
| Pisze do swojego lokalnego APIC | Sam procesor, przez APICv/AVIC | Często żadnego wyjścia |
| Wysyła przerwanie międzyprocesorowe | Posted interrupts w sprzęcie | Często bez wyjścia |
Nadaje na kolejce virtio-net z vhost-net | Wątek jądra, bez skoku do przestrzeni użytkownika | Jeden doorbell |
| Czyta rejestr emulowanego kontrolera e1000 albo IDE | Aż do QEMU | Wyjście plus podróż w obie strony przez przestrzeń użytkownika |
Tylko ostatni wiersz przypomina choć trochę karykaturę typu 2 i to zarazem wiersz, który się wyeliminowuje: używając urządzeń virtio i nie wystawiając emulowanego przestarzałego sprzętu, którego nie potrzebujesz. Za wyborem Q35 zamiast i440fx stoi to samo rozumowanie: mniej przechwytywanych dostępów do rejestrów, mniej przestarzałych urządzeń do obejścia.
System hosta to zaleta, nie balast
Druga połowa tego rachunku nigdy nie trafia do argumentu, więc proszę: węzeł Proxmoksa to maszyna, na której naprawdę da się pracować. To Debian, więc całe archiwum Debiana jest o jedno apt install stąd.
- Monitoring, który już masz: Prometheus node exporter,
smartmontools, twój obecny agent, a nie to, co urządzenie łaskawie wystawi. - Diagnostyka, kiedy coś zwalnia:
fio,iperf3,nvme-cli,perf,bpftrace. - Agenci kopii zapasowych od każdego dostawcy, który wydaje binarkę na Linuksa.
- Zarządzanie konfiguracją, więc hypervisor siedzi w tym samym inwentarzu Ansible co wszystko inne, zamiast być przypadkiem szczególnym.
fwupddo firmware’u, na sprzęcie, którego producent wspiera LVFS.
Nic z tego nie potrzebuje formatu wtyczek, podpisanego pakietu ani błogosławieństwa dostawcy. Porównaj to z modelem ESXi, gdzie powłoka jest celowo ograniczona, kod firm trzecich przychodzi jako VIB, a menedżera pakietów, po który można by sięgnąć, w ogóle nie ma.
Sięga do stosu pamięci masowej
Agenci monitoringu to nudna wersja tej historii. Własna dokumentacja pamięci masowej Proxmoksa wymienia natywne wtyczki: dir, NFS, CIFS, CephFS, ZFS, BTRFS, LVM, LVM-thin, iSCSI, FC/SAS, RBD, ZFS-over-iSCSI, PBS, a potem dodaje zdanie, które warto wziąć dosłownie:
you may use all storage technologies available for Debian Linux
To stwierdzenie o tym, gdzie leży granica, a mechanizm za nim jest ogólny: dostarcz urządzenie blokowe na każdy węzeł, połóż na nim LVM, dodaj je jako pamięć LVM z włączonym shared. Dokładnie tak działają obsługiwane ścieżki Fibre Channel i iSCSI, więc wszystko, co potrafi wyprodukować współdzielone urządzenie blokowe, może pójść tą samą drogą.
NVMe over TCP albo RDMA to przypadek, o którym warto wiedzieć, bo jest szybki, aktualny i nieobecny na tej liście wtyczek. nvme-tcp i nvme-rdma to sterowniki hosta w drzewie Linuksa (NVMe/TCP jest w mainline od 5.0), więc nie ma czego kompilować. nvme-cli to pakiet Debiana (nvme discover, potem nvme connect), a nvmetcli konfiguruje po drugiej stronie target nvmet w jądrze. Podłączona przestrzeń nazw pojawia się jako /dev/nvmeXnY i od tego momentu to zwykłe urządzenie blokowe.
ATA over Ethernet pokazuje to samo z przeciwnego końca skali: prastare, niszowe i równie nieobsługiwane jako wtyczka. Sterownik aoe jest w mainline; aoetools daje ci aoe-discover i aoe-stat; vblade zamienia dowolny plik albo urządzenie blokowe na innej maszynie w target. Ta sama droga, ten sam wynik.
Żadne z nich nie jest API wtyczek, SDK ani programem certyfikacji. Tak to wygląda, kiedy warstwa pamięci masowej hypervisora jest warstwą blokową Linuksa.
Uczciwe zastrzeżenia, bo to brzmi jak sztuczka na imprezę, dopóki nie jest trzecia w nocy. Żaden z tych transportów nie jest przetestowanym typem pamięci Proxmoksa, więc integracja i jej tryby awarii (zachowanie przy ponownym łączeniu, multipath, timeouty pod obciążeniem) są twoje: ty za nie odpowiadasz i ty je testujesz, zanim zamieszka na tym coś ważnego. A AoE to goły protokół warstwy 2, nieroutowalny i bez uwierzytelniania, więc jego miejsce jest w odizolowanym VLAN-ie pamięci masowej i nigdzie indziej. NVMe/TCP ma przynajmniej model wykrywania i da się go routować, i w dużej mierze dlatego to po niego sięga się dziś.
Kto jeszcze używa KVM
Stąd bierze się twierdzenie „już go używasz”. Każda platforma poniżej działa na tym samym module jądra.
| Platforma | Gdzie ją spotykasz | Część KVM | VMM w przestrzeni użytkownika |
|---|---|---|---|
| Amazon EC2 (Nitro) | Chmura publiczna | Rdzeniowy moduł KVM | Własny: QEMU wyrzucone, model urządzeń w kartach Nitro |
| AWS Lambda, Fargate | Serverless | /dev/kvm | Firecracker: minimalny monitor microVM w Ruście |
| Google Compute Engine | Chmura publiczna | KVM od startu | Własny VMM Google’a, celowo nie QEMU |
| Alibaba Cloud ECS | Chmura publiczna | Uproszczone KVM (X-Dragon) | Własny, z siecią i pamięcią zrzuconymi na kartę MoC |
| Oracle Cloud (OCI) | Chmura publiczna | KVM z Oracle Linux, ten sam stos, który Oracle dostarcza on-premises | Rodowód QEMU |
| DigitalOcean, Linode/Akamai, Vultr, Hetzner, OVHcloud, Scaleway, UpCloud | Chmura publiczna | Standardowe KVM | QEMU |
| Nutanix AHV | HCI on-premises | Standardowe KVM | QEMU z libvirt i Open vSwitch |
| OpenStack (Nova) | Chmura prywatna | Standardowe KVM | QEMU przez libvirt: domyślny i najlepiej przetestowany sterownik |
| Apache CloudStack, OpenNebula, oVirt | On-premises | Standardowe KVM | QEMU przez libvirt |
| OpenShift Virtualisation, SUSE Harvester | Kubernetes | Standardowe KVM | QEMU w podzie, przez KubeVirt |
| Proxmox VE | On-premises | Standardowe KVM | QEMU, obok LXC dla kontenerów |
Wszyscy zostawiają połowę w jądrze i przepisują połowę w przestrzeni użytkownika
Hyperscalerzy nie zrobili forka KVM. Zrobili forka roboty QEMU.
AWS przeniósł EC2 z Xena na hypervisor Nitro, zbudowany na rdzeniowym module jądra KVM, z QEMU wyrzuconym w całości. Model urządzeń żyje zamiast tego w dedykowanych kartach Nitro i stąd wydajność nie do odróżnienia od gołego sprzętu. Działa na tym każdy typ instancji EC2 obecnej generacji. Osobno Lambda i Fargate działają na Firecrackerze, VMM w Ruście zbudowanym do tego celu, który rozmawia z tym samym /dev/kvm.
Google uruchamia każdą maszynę Compute Engine na KVM od samego startu Compute Engine i napisał własny VMM w przestrzeni użytkownika zamiast użyć QEMU, wprost po to, żeby uniknąć ogromnej macierzy gości, urządzeń i trybów QEMU. Poszli też w drugą stronę i utwardzili moduł jądra w upstreamie, usuwając emulowane urządzenia, których nikt nie potrzebował, i zawężając zbiór emulowanych instrukcji. Ta praca siedzi w KVM, którego używasz.
Alibaba zrobiła to samo w kształcie X-Dragon: odchudzony hypervisor KVM, z wirtualizacją sieci i pamięci zrzuconą na kartę MoC opartą na FPGA.
Nutanix AHV to KVM plus libvirt plus QEMU plus Open vSwitch plus orkiestracja Nutaniksa. Ze wszystkich produktów komercyjnych na tej liście to najbliższy krewny Proxmox VE. Inna warstwa 4 i zupełnie inna faktura.
Proxmox VE zostawia QEMU celowo
Kusi, żeby czytać tę tabelę jak ranking, z AWS i Google’em na szczycie za to, że zastąpili QEMU. To złe odczytanie, bo ich ograniczenie nie jest twoim.
AWS i Google mają jeden profil sprzętu, w skali, w której jeden błąd w emulacji urządzenia to zdarzenie na całą flotę, i kontrolują każdą granicę obrazu gościa, która ich obchodzi. W takim świecie szerokość QEMU to prawie wyłącznie obciążenie, więc wycięcie go jest oczywiście słuszne.
Ty nie żyjesz w takim świecie.
Masz obraz urządzenia z 2013 roku, który chce e1000. Masz VM z Windows, której typ maszyny musi zostać przypięty do końca jej życia. Masz GPU do przekazania, emulowany kontroler SAS, żeby zadowolić instalator, magazyn zmiennych UEFI do zachowania. QEMU to dokładnie to, co pozwala platformie ogólnego przeznaczenia powiedzieć na to wszystko „tak”.
To, co AWS nazywa powierzchnią ataku, ty nazywasz macierzą zgodności. Oba opisy są trafne; różnica polega na tym, czy możesz wybierać swoje obciążenia.
To wyjaśnia też kształt tamtej kolejki łatek. AWS i Google rozwiązały kopie zapasowe i migawki poza VMM, we własnych usługach pamięci masowej. Proxmox nie miał usługi pamięci, w której mógłby to rozwiązać, więc włożył to do QEMU i dlatego savevm-async i sterownik blokowy PBS istnieją jako łatki, a nie jako produkty.
A warto to wiedzieć z praktycznego powodu: części Proxmox VE, których brakowałoby ci najbardziej, to te, których nie ma w upstreamie. Konfiguracje VM to zwykły tekst, a obrazy dysków są w standardowych formatach, więc maszyna się przeniesie. Ale migawka ze stanem RAM i przyrostowy łańcuch Proxmox Backup Server zależą od forka QEMU Proxmoksa. To dużo lżejsza zależność niż zamknięty hypervisor, bo fork jest publiczny, na AGPL i możesz przeczytać w nim każdą łatkę, ale nie jest zerowa, a hasło „brak uzależnienia na poziomie oprogramowania” powinno nieść ten przypis.
No to czy jest klasy enterprise?
Leniwa wersja tego argumentu nie działa i warto to powiedzieć wprost. „AWS używa KVM, więc Proxmox VE jest klasy enterprise” to non sequitur: bierze twierdzenie o jednej warstwie i po cichu stosuje je do całego produktu.
Oto wersja, która się trzyma.
Wspólna jest ta warstwa, którą najtrudniej zrobić dobrze i najgroźniej zrobić źle. Wirtualizacja procesora i pamięci oraz granica izolacji między najemcami to część, w której błąd oznacza włamanie, a nie przestój. Ten kod przeglądają inżynierowie opłacani przez Amazona, Google’a, Red Hata, Intela, AMD, IBM i Alibabę, a jego błędy znajdują firmy, które mają największe floty na świecie, zwykle zanim jądro do ciebie dotrze. Kiedy już pojawi się podatność pozwalająca uciec z gościa, poprawka przychodzi zwykłą aktualizacją jądra, którą i tak zamierzałeś wgrać. Nie czekasz na cykl wydań jednego dostawcy dla hypervisora, który widzi tylko ten dostawca.
Niewspólne jest wszystko nad tą granicą. A to znaczy, że pytanie zapada się w dwa, na które dużo łatwiej odpowiedzieć:
- Czy warstwa zarządzania jest wystarczająco dobra dla tego, jak pracujesz?
- Czy możesz kupić do niej wsparcie na warunkach, z którymi da się żyć?
Oba da się przetestować w proof of concept i wpisać do umowy. Żadne nie wymaga wiary w hypervisor.
To dużo lepsza pozycja niż ta, którą zakłada pierwotne pytanie: że ktoś każe ci zaufać nowatorskiemu hypervisorowi od małego dostawcy. Nie każe. Kod specyficzny dla Proxmoksa to warstwa zarządzania, głównie w Perlu i coraz częściej w Ruście, plus tamta kolejka łatek na QEMU, a zauważ, gdzie te łatki lądują: w modelu urządzeń i ścieżce kopii zapasowych, nie na granicy izolacji.
Warto też wiedzieć, ile kosztuje cię awaria warstwy specyficznej dla Proxmoksa. Procesy QEMU to zwykłe, niezależne procesy na hoście, więc to, że pveproxy się przewróci, nie zatrzymuje ani jednej maszyny wirtualnej. To zupełnie inny promień rażenia niż utrata komponentu, do którego należy granica izolacji.
Czego „ten sam hypervisor” ci nie kupuje
Tutaj dokumenty dostawców mające budować zaufanie zwykle się kończą, co coś mówi o tym, dla kogo są pisane. To ta bardziej użyteczna połowa.
Nie kupuje ci niezawodności AWS. Dostępność Nitro ma bardzo mało wspólnego z KVM. Bierze się z płaszczyzny sterowania, sieci szkieletowej, usługi pamięci, zarządzania pojemnością i praktyki operacyjnej wokół tego wszystkiego. Niezawodność twojego klastra będzie brała się z projektu kworum Corosynca, konfiguracji fencingu, wyboru pamięci masowej i redundancji sieci. KVM nie ma zdania w żadnej z tych spraw. Wspólny hypervisor z hyperscalerem nie dziedziczy jego operacji.
Nie kupuje ci powierzchni ataku Nitro i tu ląduje uzasadniona połowa zarzutu o typ 2.
Uruchamiasz QEMU na jądrze ogólnego przeznaczenia, a historycznie to w modelu urządzeń QEMU mieszkały pamiętne ucieczki z VM. Kanonicznym przykładem jest VENOM, w emulowanym kontrolerze dyskietek, którego nikt nie używał. Google mógł wtedy zaznaczyć, że Compute Engine nie był podatny właśnie dlatego, że nie uruchamia QEMU. Ty je uruchamiasz, więc środki kompensujące są po twojej stronie: wybieraj virtio zamiast emulowanego sprzętu, nie wystawiaj urządzeń, których nie potrzebujesz, nie ruszaj profili AppArmor i łataj QEMU z tą samą dyscypliną co jądro. Łatki extra/ w Proxmoksie to oni, robiący dokładnie to w twoim imieniu, i rozsądnie jest sprawdzać, czy dalej to robią.
Nie sprawia, że zachowanie VM przenosi się między platformami.
Wybór modelu procesora, wersjonowanie typu maszyny, zgodność migracji na żywo i zachowanie zegara rozstrzygają się w warstwach 3 i 4, a te wszędzie są inne. Klaster z mieszanymi generacjami procesorów nadal cię ukarze za ustawienie typu CPU na host, a zegary gości nadal dryfują, niezależnie od logo na platformie. Ten sam hypervisor to nie to samo zachowanie.
Nie odpowiada na pytanie o wsparcie, a właśnie ono naprawdę obchodzi dział zakupów, i słusznie. Proxmox VE jest na AGPLv3 i można go za darmo uruchomić na produkcji. Subskrypcja kupuje repozytorium testowane pod enterprise i wsparcie dostawcy, od €120 za gniazdo rocznie. Własne wsparcie Proxmoksa działa w austriackich godzinach pracy, więc całodobowa obsługa przychodzi od partnerów, a nie z Wiednia. croit, gdzie pracuję, jest jednym z tych partnerów i obsługuje 24/7, 365 dni w roku. To negocjacja handlowa, a nie ryzyko techniczne, a to, że jest negocjacją handlową, to sens wszystkiego powyżej.
Co naprawdę ocenić zamiast tego
Jeśli hypervisor jest sprawą załatwioną, proof of concept powinien poświęcić czas warstwie, która jest naprawdę specyficzna dla Proxmox VE:
- Fencing i HA. Wyciągnij zasilanie węzłowi z działającymi gośćmi HA i zmierz czas restartu. Potem zrób to dwóm węzłom i sprawdź, czy pozostałe zachowują się tak, jak oczekujesz, kiedy kworum przepada.
- Migracja na żywo między generacjami procesorów. Z modelem CPU, na którym naprawdę zamierzasz się ustandaryzować, nie z
host. - Kopie zapasowe i, co ważniejsze, odtwarzanie. Czasy odtwarzania pod obciążeniem, nie czasy kopii. Nikt nigdy nikomu nie podziękował za szybki backup.
- Model uprawnień. Czy możesz dać zespołowi aplikacyjnemu konsolę i sterowanie zasilaniem ich własnych VM i nic więcej, na tyle szczegółowo, żeby audytor był zadowolony.
- API. Wszystko, co robi interfejs WWW, jest wywołaniem API; jeśli twoja automatyzacja nie umie go sterować, platforma nie pasuje do tego, jak pracujesz.
- Ścieżka aktualizacji. Aktualizacja do nowej wersji głównej na klastrze PoC, zanim postawisz na nim 400 VM.
Żadne z tych pytań nie dotyczy KVM. I właściwie o to chodzi.
Hypervisor to część załatwiona. Wydaj proof of concept na te części, które załatwione nie są.
Źródła
Samo KVM
- KVM API documentation — interfejs ioctl
/dev/kvm, czyli cała umowa hypervisora - Linux 2.6.20 release notes — wydanie, do którego wcielono KVM, luty 2007
- Some KVM developments — LWN, styczeń 2007, o KVM w dniach po trafieniu do mainline
Jak zbudowane są inne hypervisory
- Interpreting virtual machine monitor and executable failures — własny opis Broadcomu działającej VM na ESXi jako “several processes or userworlds”, z jednym VMM na vCPU i jednym VMX na VM
- The Architecture of VMware ESXi (PDF) — whitepaper nazywający VMkernel “a POSIX-like operating system” z procesami, sygnałami, systemem plików i wątkami. Link prowadzi do kopii, bo oryginalny adres VMware nie przetrwał reorganizacji w Broadcomie, co samo w sobie jest małym komentarzem o ciągłości dostawców
- Hyper-V architecture — Microsoft o Virtual Machine Worker Process jako komponencie trybu użytkownika, jednym na VM, w którym żyją wszystkie emulowane urządzenia
- The Nutanix Bible — AHV architecture — AHV opisane jako KVM z libvirt, QEMU i Open vSwitch
Kto używa KVM i jak go zmienił
- 7 ways we harden our KVM hypervisor at Google Cloud — Google o uruchamianiu KVM bez QEMU i o utwardzaniu, które zrobili w upstreamie
- The AWS Nitro System — które typy instancji EC2 działają na hypervisorze Nitro
- AWS EC2 Virtualization 2017: Introducing Nitro — opis przejścia z Xena na KVM autorstwa Brendana Gregga, wciąż najjaśniejszy
- Firecracker — minimalny VMM AWS oparty na KVM, za Lambdą i Fargate
- Alibaba Cloud’s sixth-generation ECS instances — hypervisor X-Dragon i odciążenie na kartę MoC
- KubeVirt — model QEMU/KVM w podzie za OpenShift Virtualisation i Harvesterem
- OpenStack Nova hypervisor support matrix — KVM jako sterownik referencyjny
Co utrzymuje Proxmox
- The Proxmox GitHub organisation — 89 repozytoriów, w tym
pve-qemu,pve-kernel,pve-edk2-firmwarei pakiety dlalxc,zfsonlinux,openvswitch,libiscsi,corosync-pveiceph pve-qemupatch series — 78 łatek policzonych wyżej i najszybszy sposób, żeby zobaczyć dokładnie, co Proxmox dodaje do QEMU- Proxmox VE storage documentation — lista natywnych wtyczek, które typy pamięci są współdzielone, i zdanie o używaniu wszystkich technologii pamięci dostępnych dla Debian Linux
nvme-cliinvmetcli— narzędzia hosta i targetu NVMe-oF;aoetoolsivbladedla odpowiednika ATA over Ethernet. Wszystko w Debianie trixie, na którym zbudowany jest Proxmox VE 9- Proxmox VE pricing and subscription tiers — co obejmuje subskrypcja
Ujawnienie: pracuję dla croit, złotego partnera Proxmoksa. Twierdzenia techniczne powyżej mają źródła i da się je sprawdzić; akapit handlowy to część, w której mam interes, więc traktuj go odpowiednio.