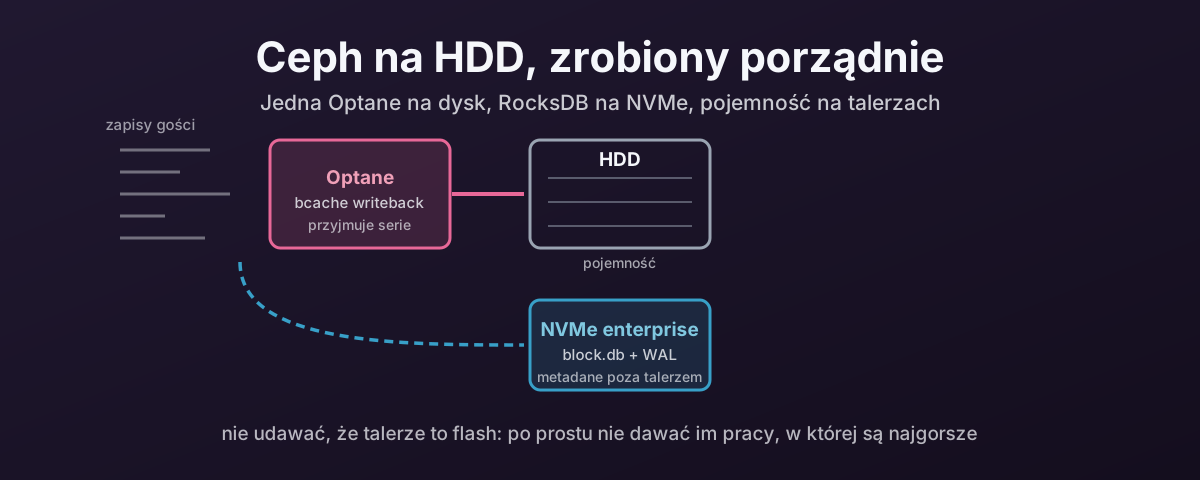
Dlaczego HDD wracają do gry
Przez lata rada była na tyle prosta, że mieściła się na karteczce: wrzuć wszystko na SSD.
Ta rada była słuszna, a przy tym tania. Dziś żadne z tych dwóch nie jest do końca prawdą. Podaż NAND się skurczyła, popyt na AI wypchnął ceny flasha w górę, a pojemne NVMe stało się trudne do uzasadnienia we wdrożeniu Proxmoksa liczonym co do grosza, takim, które ma działać, być niezawodne i kosztować tak mało, jak tylko uczciwie się da.
Dyski HDD klasy enterprise znów są ciekawe z tego samego powodu co zawsze: pojemność na funta, a nic innego nawet się nie zbliża.
Haczyk polega na tym, że każdy, kto uruchamiał maszyny wirtualne na dyskach talerzowych, wie, jak źle to może pójść. To doświadczenie jest prawdziwe i zwykle jest winą architektury, a nie dysków.
Zrzucenie winy na dyski jest łatwiejsze, co prawda. Jest też błędne i drogie, bo namawia ludzi do kupowania flasha, którego nie potrzebowali.
Wszystko poniżej zakłada Proxmoksa z hiperkonwergentnymi OSD Ceph, bo tam decyzje o układzie naprawdę gryzą.
Problemem są opóźnienia, nie przepustowość
Nowoczesny dysk HDD enterprise doskonale radzi sobie z dużymi danymi sekwencyjnymi. To nigdy nie było wąskie gardło.
Dysk enterprise 7,2k RPM daje mniej więcej 80 do 100 IOPS pracy losowej, bo każda losowa operacja czeka na ruch głowicy i obrót talerza. Ta liczba prawie się nie zmieniła od dwudziestu lat. To mechanika, nie elektronika. Podstawowy dysk SSD enterprise jest od niej o trzy albo cztery rzędy wielkości dalej.
Daj temu samemu dyskowi pracę sekwencyjną, a będzie przydatnym urządzeniem. Liczba operacji mniej więcej się podwaja, do około 200 IOPS, ale każda z nich niesie teraz duży blok, bo głowica już jest we właściwym miejscu i może dalej strumieniować. Dostajesz więc prawdziwą przepustowość, 150 do 250 MB/s, w cenie za terabajt, do której nic innego się nie zbliża.
To jest ta ważna asymetria, i nie brzmi ona „HDD są wolne”. Dysk talerzowy jest dobry w pracy sekwencyjnej i beznadziejny w losowej, a obie liczby są blisko siebie tylko dlatego, że ograniczona jest liczba operacji, a nie bajtów.
To ustala całe założenie projektu. Nie próbujesz przyspieszyć dysku. Nie da się. Próbujesz tak to ułożyć, żeby spędzał czas w trybie, w którym już jest kompetentny, i trzymać od niego z daleka drobny losowy ruch. As such, wszystko, co dalej, to ta jedna idea zastosowana dwa razy.
Problem w tym, że maszyny wirtualne nie generują obciążenia, w którym HDD są dobre. Generują aktualizacje metadanych, zapisy dziennika, drobne synchroniczne flushe, logi, porządki w systemie plików i serie losowej aktywności od tuzina gości naraz, które docierają do dysku przemieszane.
Ceph dokłada do tego własną warstwę. Każdy zapis niesie obok danych aktualizacje metadanych RocksDB. Jeśli wszystko to ląduje na gołych talerzach, dyski spędzają czas na szukaniu zamiast na obsłudze i dostajesz objaw, który rozpozna każdy administrator: wysoki I/O wait, ospałe maszyny gości, nierówna responsywność i klaster, który wydaje się dużo wolniejszy, niż sugeruje jego karta pojemności.
Własne wytyczne sprzętowe Ceph mówią bez ogródek, dokąd to prowadzi. Ostrzegają, by „consider carefully the ostensible cost-per-gigabyte advantage of larger HDDs, and the concomitant limitations of IOPS per TB”, i mówią, że dyski powyżej 8 TB „may be best suited for storage of large files / objects that are not at all performance-sensitive.”
Warto to policzyć, bo dyski, dzięki którym to w ogóle się opłaca, są duże. 20 TB i więcej. Dysk 20 TB nadal robi swoje 80 do 100 losowych IOPS, bo pojemność nie kupuje żadnych operacji. Daje więc około 4 do 5 losowych IOPS na terabajt, podczas gdy dysk 8 TB ma ich mniej więcej jedenaście, a dysk 2 TB czterdzieści.
Według miary samego Ceph dysk 20 TB jest więc głęboko na terytorium, na które każe ci nie wkładać obciążeń wrażliwych na wydajność.
To nie jest argument przeciw ich kupowaniu. To powód, dla którego reszta tego wpisu istnieje. Projekt poniżej jest dokładnie tym, co czyni dysk 20 TB sensownym dla pamięci maszyn wirtualnych, bo układa wszystko tak, żeby drobna losowa praca nigdy do niego nie docierała.
Zabierz metadane z talerzy
Najcenniejsza zmiana w klastrze na HDD to przestać kazać dyskowi talerzowemu przechowywać księgowość Ceph.
BlueStore trzyma trzy rzeczy na każde OSD: same dane na block, bazę metadanych RocksDB na block.db i dziennik zapisu z wyprzedzeniem na block.wal. Domyślnie wszystkie trzy żyją na tym samym urządzeniu. Przenieś block.db na NVMe, a duża część drobnego losowego I/O całkiem opuszcza dysk.
Dokumentacja sprzętowa Ceph mówi to wprost: „HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD.”
Użyj tu porządnego NVMe klasy enterprise, a nie konsumenckiego flasha. Powodem nie są liczby z nagłówków benchmarków. Są nim stabilne opóźnienia pod długotrwałym obciążeniem oraz ochrona przed utratą zasilania. Dokumentacja Ceph mówi wprost: „Enterprise-class SSDs are best for Ceph: they feature power loss protection (PLP)”, oraz „bargain client-class or off-brand SSDs are a false economy.”
Dyski klasy Samsung PM9A3 i Micron 7450 Pro to coś, co tu pasuje. Pod presją zapisów Ceph dużo bardziej dba o spójność niż o szczytowe liczby, a to dokładnie odróżnia dysk enterprise od szybkiego konsumenckiego.
Wymiarowanie block.db i ile kosztuje spillover
Pomyl rozmiar, a korzyść po cichu wyparuje, bo kiedy block.db się zapełni, RocksDB nie zawodzi, tylko wylewa się z powrotem na wolne urządzenie, dokładnie tam, gdzie byłby bez NVMe.
To najgorsze z obu światów: kupiłeś flasha, a głowica dalej skacze po talerzu.
Aktualne wytyczne Ceph:
| Obciążenie | block.db jako ułamek block |
|---|---|
| RBD / blokowe, dyski maszyn wirtualnych | 1% do 2% |
| RGW / obiektowe | co najmniej 4% |
| Ogólna rekomendacja przy przenoszeniu WAL+DB | co najmniej 2,5% |
Pamięć maszyn wirtualnych w Proxmoksie to wiersz RBD, więc 1–2% to uczciwa liczba do planowania, a 2,5% to wygodne miejsce, żeby się na nim zatrzymać.
Przyłóż to do dysku 20 TB, a liczby przykuwają uwagę:
block.db dla jednego OSD 20 TB | |
|---|---|
| Przy 1% | 200 GB |
| Przy 2% | 400 GB |
| Przy 2,5% | 500 GB |
Zestaw to z progami poziomów RocksDB poniżej, a 300 GB na OSD to rozsądne miejsce lądowania. Użyteczny próg najbliżej środka zakresu.
To zmienia to, czym właściwie jest współdzielone urządzenie na metadane. Osiem OSD po 20 TB chce razem 2,4 TB NVMe; piętnaście, czyli deklarowane przez Ceph maksimum za jednym NVMe, chce 4,5 TB. Przy dyskach tej wielkości o tym, ile OSD stoi za jednym urządzeniem, decyduje pojemność DB, a nie proporcja. Gigabajty skończą ci się dużo wcześniej niż błogosławieństwo Ceph.
Jest jeszcze jeden szczegół, który warto znać, bo sprawia, że intuicyjne wymiarowanie jest błędne. Struktura poziomów RocksDB oznacza, że partycja DB może w pełni wykorzystać tylko rozmiary odpowiadające sumom jej poziomów, co historycznie daje użyteczne progi około 3 GB, 30 GB i 300 GB, a rozmiary pomiędzy nie dają nic ponad próg poniżej. Zaokrąglenie 18 GB w górę do 30 GB jest w praktyce często za darmo; zaokrąglenie w dół do 20 GB w najgorszym razie nie daje nic ponad 3 GB.
Sprawdzaj spillover, kiedy klaster już trochę popracuje, a nie pierwszego dnia. To problem, który narasta powoli.
Nie potrzebujesz osobnego urządzenia WAL
To oszczędza partycję i mnóstwo dłubania.
Jeśli wskażesz urządzenie DB, a nie wskażesz osobnego urządzenia WAL, Ceph automatycznie umieszcza WAL na szybkim urządzeniu razem z DB. Dokumentacja stwierdza, że „whenever a DB device is specified but an explicit WAL device is not, the WAL will be implicitly colocated with the DB on the faster device.”
„Daj DB i WAL na NVMe” to więc dobry cel, ale to jeden argument, a nie dwa. Osobny block.wal ma sens tylko wtedy, gdy masz trzecią, szybszą warstwę, na której można go umieścić.
Wyłącz cache zapisu w HDD
Drobne, mało efektowne i łatwe do przeoczenia.
Dokumentacja Ceph zauważa, że wydajność OSD „may be dramatically increased … by disabling this write cache” na dyskach HDD. Ulotna pamięć podręczna w dysku przestawia i opóźnia zapisy w sposób, który walczy z semantyką flush w Ceph, a jej wyłączenie zwykle przyspiesza sprawy, a nie spowalnia.
Z zalecenia staje się obowiązkiem, gdy w grę wchodzi bcache, czyli w następnym rozdziale.
Skoro już tam jesteś: nie potrzebujesz HBA z obsługą RAID. Ceph mówi to wprost: „You do not need an RoC (RAID-capable) HBA.” Daj dyski bezpośrednio OSD.
Jedna Optane na dysk
Zabranie metadanych z dysku naprawia stan ustalony. Nie naprawia serii, bo seria drobnych synchronicznych zapisów nadal musi zostać potwierdzona, a dysk talerzowy nadal potwierdza z prędkością talerzy.
Do tego służy bcache, a działa tu dzięki Optane.
Liczy się nie pojemność. Liczy się zachowanie pod obciążeniem zapisem. W porównaniu z NAND Optane daje bardzo niskie opóźnienia, bardzo wysoką trwałość i żadnych urwisk od odśmiecania (garbage collection), które czynią wydajność SSD jako cache zapisu nieprzewidywalną, gdy już trochę popracuje. Przyjmowanie drobnego, porywistego ruchu z przewagą zapisów to rzecz, w której jest najlepsza na świecie.
Układ, który się liczy: jedna Optane na każdy HDD, każda para to osobne urządzenie bcache. Nie jedna Optane dzielona na całą półkę dysków.
Parowanie to świadomy wybór i kupuje dwie rzeczy.
Brak rywalizacji. Każdy dysk dostaje dla siebie opóźnienia i głębokość kolejki całej Optane, zamiast czekać w kolejce za seriami siedmiu innych OSD.
Domena awarii, którą Ceph już umie przetrwać. Wspólny cache zapisu trzyma brudne dane każdego OSD za sobą, więc jego utrata zabiera je wszystkie naraz; przy parowaniu jeden do jednego utrata Optane kosztuje dokładnie jedno OSD. To rozróżnienie jest najważniejszą konsekwencją tego projektu i dostaje osobne omówienie w tym, co oddajesz w zamian.
To musi być Optane. Nie NAND.
Słowo „Optane” nie jest tu kwestią upodobania do marki ani miłym dodatkiem. Podstawienie NVMe na NAND, choćby nie wiem jak drogiego, buduje coś, co się zużywa, a powodem jest trwałość.
Spójrz, gdzie siedzi urządzenie cache. Ponieważ ten projekt wyłącza sekwencyjne obejście bcache, czyli sequential_cutoff=0 w regule poniżej, każdy pojedynczy zapis do tego OSD przez nie przechodzi: nie tylko serie, wszystko. To czyni cache urządzeniem o najwyższym cyklu pracy w węźle, od którego oczekuje się przyjmowania wolumenu zapisów całego dysku talerzowego przez cały czas życia maszyny.
Trwałość podaje się w zapisach całego dysku dziennie (DWPD), a różnica nie jest drobna:
| Urządzenie | Znamionowa trwałość |
|---|---|
| Optane P5800X | 100 DWPD |
| Optane P4800X | 30 DWPD |
| NAND enterprise do intensywnych zapisów, górna półka | około 10 DWPD |
| NAND enterprise do obciążeń mieszanych | 3 DWPD lub mniej |
| Główny nurt NAND enterprise, klasa PM9A3, 7450 Pro | około 1 DWPD |
Optane ma od dziesięciu do stu razy większą trwałość niż NAND, który w innym wypadku wstawiłbyś w to miejsce. Wstaw dysk 1 DWPD w jedyne miejsce, przez które przechodzi każdy zapis w klastrze, a nie zbudowałeś cache, tylko materiał eksploatacyjny.
Jest gorzej, niż sugeruje tabela, bo NAND wewnętrznie cierpi na wzmocnienie zapisu (write amplification), a Optane nie. Znamionowe DWPD dysku NAND to to, co przyjmuje na interfejsie; to, co faktycznie przyjmują jego komórki, jest większe. Liczba Optane nie potrzebuje takiego przypisu.
Odbudowy to miejsce, gdzie to zostaje sprawdzone. Backfill przepycha terabajty zapisów przez ocalałe węzły w skompresowanym oknie czasu, każdy bajt przez ich urządzenia cache: to zdarzenie dla trwałości, nie tylko dla opóźnień, które przychodzi dokładnie wtedy, kiedy najmniej chcesz, żeby padło drugie urządzenie.
Dwie warstwy flash chcą więc różnych dysków, z różnych powodów:
| Warstwa | Wolumen zapisów | Czego potrzebuje urządzenie |
|---|---|---|
| DB/WAL | mały, tylko RocksDB | Szybkiego NVMe enterprise. Niskie opóźnienia, wysokie losowe IOPS, PLP. NAND enterprise to właściwa technologia; PM9A3 albo 7450 Pro to właściwy zakup |
| Cache zapisu | wszystko | PLP i trwałości rzędu dziesiątek DWPD. NAND to zła technologia za każdą cenę |
Kupienie jednego rodzaju dysku do obu zadań to błąd, przed którym ten rozdział ma chronić. Ale nie czytaj pierwszego wiersza jako pozwolenia na oszczędzanie, bo mały wolumen zapisów to nie małe wymagania.
Urządzenie DB/WAL nadal musi być naprawdę szybkim NVMe, z trzech powodów, które nie mają nic wspólnego z tym, ile bajtów przez nie przechodzi.
Obsługuje każde OSD za sobą naraz, więc kolejka, którą widzi, to cztery albo piętnaście zestawów ruchu metadanych, a nie ruch jednego dysku.
Jego opóźnienia lądują bezpośrednio u twoich klientów. Odczyty RocksDB leżą na ścieżce krytycznej przy szukaniu obiektów, przy peeringu i przy scrubie, a to drobne losowe odczyty. Dokładnie to obciążenie, przy którym różnica między szybkim a przeciętnym NVMe jest największa. Każda mikrosekunda mnoży się przez każde OSD, które od niego zależy.
I kompakcja przychodzi seriami. RocksDB co jakiś czas przepisuje swoje poziomy, zamieniając równomierne przewalanie danych w skoncentrowany szczyt odczytów i zapisów. Urządzenie, które radzi sobie ze średnią, a staje na szczycie, zatrzymuje w tej samej chwili każde OSD za sobą.
Proporcje samego Ceph to zdradzają. Pozwala na trzy razy więcej OSD za jednym NVMe niż za SSD SATA, i to mówi interfejs i klasa urządzenia, a nie pojemność. Użyj NVMe.
Zatem: urządzenie cache musi być Optane, urządzenie DB/WAL może być NAND, a żadne z tych miejsc nie jest miejscem na oszczędności.
Która Optane: często wystarczyłaby M10 32 GB
Nic z tego nie znaczy, że największa Optane jest właściwa. Urządzenie, którego potrzebujesz, wyznacza twoje obciążenie zapisami, choć jak się okazuje, rynek wtórny może i tak zdecydować za ciebie. Rachunek nadal się liczy, bo mówi ci, ile kupujesz za dużo albo za mało.
Zacznij od tego, do czego służy cache. Trzyma serię, a nie dysk. Przy writeback_percent=40 urządzenie 32 GB daje około 13 GB brudnego bufora, a to ogromna liczba drobnych synchronicznych zapisów.
Nie zrażaj się więc proporcją. Moduł 32 GB przed dyskiem 20 TB to 0,16% jego pojemności, co brzmi absurdalnie, dopóki nie przypomnisz sobie, że to amortyzator serii, a nie cache zbioru roboczego próbujący trzymać gorące dane. Urządzenie 375 GB przed tym samym dyskiem to 1,9%, czyli po prostu więcej zapasu, niż wykorzystasz.
To wprowadza do gry tani koniec gamy. Oto mały konsumencki moduł przeciw części do centrów danych, bo różnica nie leży tam, gdzie ludzie się jej spodziewają:
| Optane Memory M10 32 GB | Optane DC P4800X 375 GB | |
|---|---|---|
| Losowy odczyt, 4K | 240 000 IOPS | 550 000 IOPS |
| Losowy zapis, 4K | 65 000 IOPS | porównywalny z odczytem |
| Odczyt sekwencyjny | 1200 MB/s | 2400 MB/s |
| Zapis sekwencyjny | 290 MB/s | 2000 MB/s |
| Typowe opóźnienie | b.d. | poniżej 10 µs |
| Trwałość | 365 TBW | 12,3 PBW, 30 DWPD |
| Interfejs | PCIe 3.0 x2, M.2 2280 | PCIe 3.0 x4, U.2 lub AIC |
Najpierw spójrz na wiersz z IOPS zapisu. Mała M10 robi 65 000 losowych zapisów na sekundę; dysk talerzowy za nią robi 80. Nawet najtańsza Optane jest mniej więcej 650 razy szybsza niż dysk, który obsługuje, więc na osi wydajności spór jest rozstrzygnięty, zanim się zaczął. Dodatkowe IOPS części DC nie mają dokąd pójść, gdy dalej stoi jeden dysk 7,2k.
Wiersz, który decyduje o zakupie, to trwałość, gdzie różnica wynosi 34×. Przeliczona na dzienny budżet przez pięć lat życia:
| Urządzenie | Trwałe zapisy dziennie, przez pięć lat |
|---|---|
| M10 32 GB, 365 TBW | około 200 GB/dzień |
| P4800X 375 GB, 12,3 PBW | około 6,7 TB/dzień |
Poniżej 200 GB zapisów dziennie M10 32 GB przeżyje całą instalację. Przy dwa razy tyle dostajesz dwa i pół roku. Przy naprawdę dużych zapisach część DC zarabia na swoją cenę, nie za IOPS, których nie wykorzystasz, ale za ponad trzydzieści razy więcej zapisów, które znosi.
Mierz więc, zamiast zgadywać. nvme smart-log na istniejącym urządzeniu cache daje ci data_units_written; odczytaj to w odstępie tygodnia, podziel i porównaj ze znamionowym TBW tego, co rozważasz. bcache trzyma też własne sumy w /sys/block/bcacheN/bcache/stats_total/, jeśli wolisz czytać je tam.
Dwa zastrzeżenia co do M10. Jej losowe liczby podaje się dla zakresu 8 GB, a nie całego urządzenia, więc przy cache, który zamierzasz trzymać mocno zapełniony, traktuj je jako optymistyczny koniec. I to część konsumencka bez deklaracji PLP klasy enterprise. Nośnik Optane jest zapisywany w miejscu, bez bufora DRAM na ścieżce zapisu, dlatego te moduły zachowują się przy nagłej utracie zasilania dużo lepiej niż konsumencki NAND, ale „w praktyce zachowuje się dobrze” to nie specyfikacja. Jeśli chcesz gwarancji na piśmie, kup część z serii DC.
Dolną granicą jest przepustowość, nie pojemność: odpuść moduły 16 GB
Jest drugie ograniczenie, niezależne od wszystkiego powyżej, i dyskwalifikuje najtańszą część w gamie.
Cache musi być szybszy od dysku sekwencyjnie, bo inaczej jest dławikiem. M10 16 GB nie jest, a to moduł, który najbardziej będzie cię kusił, bo jest prawie za darmo:
| Zapis sekwencyjny | |
|---|---|
| Optane Memory M10 16 GB | 150 MB/s |
| Optane Memory M10 32 GB | 290 MB/s |
| Optane DC P4800X 375 GB | 2000 MB/s |
| Dysk HDD enterprise 7,2k | 150–250 MB/s |
Przeczytaj pierwszy i ostatni wiersz razem. Moduł 16 GB zapisuje sekwencyjnie mniej więcej z tą samą prędkością co dysk talerzowy, który ma przyspieszać, i wolniej niż dobry dysk. W pracy losowej pozostaje nieporównanie szybszy, 35 000 losowych IOPS zapisu wobec 80 dysku, ale na strumieniu sekwencyjnym w najlepszym razie wychodzi na zero, a w najgorszym jest sufitem poniżej tego, co goły dysk osiągał sam.
A ten projekt gwarantuje, że w ten sufit uderzysz, bo wyłączenie sekwencyjnego obejścia przepuszcza wszystko przez cache, przez co własna sekwencyjna przepustowość zapisu cache staje się twardym sufitem dla całego OSD. Najmocniej gryzie to przy odtwarzaniu: backfill OSD 20 TB jest mniej więcej najbardziej sekwencyjną rzeczą w tym obciążeniu, a przycięcie go do 150 MB/s spowalnia i tak już powolną odbudowę.
Linia M10 ma więc dolną granicę na 32 GB i jest to granica przepustowości, a nie pojemności. Rachunek pojemności mówił, że 32 GB to aż nadto; rachunek przepustowości wyklucza 16 GB bez względu na to, jak mało potrzebowałeś przechowywać. Oba testy muszą przejść, a tania część oblewa ten, którego ludzie nie sprawdzają.
Cokolwiek rozważasz, przed zakupem postaw jego sekwencyjną prędkość zapisu obok 250 MB/s.
Kupowanie produktu, którego nikt już nie robi
Optane wycofano. Intel zwinął ten biznes w 2022, odpisując 559 mln $ zapasów i kończąc rozwój. Nie ma nowej produkcji ani uzupełnień; całkowita podaż odtąd tylko maleje.
To rodzi oczywiste pytanie, bo na sprzedaż jest jej zaskakująco dużo. Zrozumienie, skąd pochodzi, mówi ci, co kupujesz.
To likwidowane zapasy części serwisowych OEM. Wielka trójka producentów serwerów trzymała Optane jako części zamienne do obsługi platform, w których ją sprzedawała. Te platformy doszły do końca życia i wypadły ze wsparcia, więc zapasy części dla nich z dnia na dzień stały się martwym towarem: magazyny części do maszyn, których nikt nie jest już umownie zobowiązany naprawiać. To te zapasy płyną na AliExpress i do firm odnawiających sprzęt.
Dwie konsekwencje, i obie są dobrą wiadomością.
Dużo z tego jest nieużywane, a nie wymontowane. Części serwisowe leżały na półce, czekając na awarię, która nigdy nie nadeszła, więc zużycie przy dostawie jest często praktycznie zerowe: nie „kilka lat lekkiej pracy”, tylko nigdy nie zapisane. Sprawdzaj, a nie ufaj: nvme smart-log daje ci percentage_used i data_units_written, a na prawdziwych częściach serwisowych powinny one być zaskakująco niskie. Wszystko, co pokazuje realne zużycie, to część wymontowana sprzedawana jako coś innego, choć nawet wtedy zapas trwałości oznacza, że używana Optane może mieć przed sobą więcej życia niż nowy dysk NAND tej samej pojemności.
To wyjaśnia, jakie pojemności znajdziesz. Części serwisowe OEM gromadzono dla serwerów, czyli części do centrów danych. Oto pełna gama, i zwróć uwagę, od czego zaczyna się flagowiec:
| Część | Pojemności | Format |
|---|---|---|
| Optane Memory M10 | 16, 32, 64 GB | M.2 2280, konsumencka |
| Optane SSD 800P | 58, 118 GB | M.2 2280, konsumencka |
| Optane SSD P1600X | 58, 118 GB | M.2 2280, część do centrów danych na boot i cache |
| Optane SSD DC P4801X | 100, 200, 375 GB | M.2 110 mm lub U.2 |
| Optane SSD DC P4800X | 375 GB najmniejsza, 750 GB, 1,5 TB | U.2 lub karta rozszerzeń |
| Optane SSD P5800X | 400 GB, 800 GB, 1,6 TB | U.2 lub karta rozszerzeń |
W teorii małe części M.2 to eleganckie rozwiązanie: M10, 800P, P1600X i P4801X 100 GB robią swoje, i to tanio. W praktyce rynek ich nie ma, bo nikt nie magazynował modułów przyspieszających do desktopów jako części serwisowych do serwerów. To, co jest wystawione, to 375 GB i więcej, sprzęt klasy P4800X.
Planuj więc zakup większej pojemności, niż wymaga rola, bo to jest na sprzedaż. To nie jest zły wynik. Przesadzenie z urządzeniem cache daje ci 30 DWPD i opóźnienia poniżej 10 µs, kiedy twoje obciążenie wymagało ułamka jednego i drugiego, a dla dysku 20 TB, który chcesz trzymać latami, to właściwa strona, po której się mylić. Oznacza to jednak, że cena wejścia jest wyższa, niż sugeruje rachunek, a wymiarowanie powyżej staje się kontrolą przed kupieniem za mało, a nie listą zakupów.
Trzy rzeczy do zaplanowania, skoro to likwidacja, a nie łańcuch dostaw:
Kup zapasowe razem z instalacją. Wyprzedawana jest skończona pula. Kiedy urządzenie padnie za trzy lata, nie będziesz zamawiać zamiennika, tylko na niego polować, więc wlicz zapasowe teraz, póki towar jest.
Spodziewaj się firmware OEM i sprawdź przestrzeń nazw. Części z programu serwisowego producenta często mają firmware tego producenta i mogą przyjść sformatowane z rozmiarem LBA albo ustawieniami metadanych pasującymi do tego, do czego je gromadzono. Potwierdź przez nvme id-ns, zanim cokolwiek na tym zbudujesz, i bądź gotów zrobić nvme format do zwykłego formatu 4096 bajtów.
Nie ma gwarancji, wsparcia ani kolejnych aktualizacji firmware. Własna informacja Intela dla wsparcia opisuje, co zakończenie oznacza dla urządzeń już w użyciu, a w tej sytuacji jest wszystko, co kupisz. Sprawdzenie, że część, która przyszła, to część z ogłoszenia, należy do ciebie.
bcache nie zastępuje przeniesienia DB/WAL
Warto to powiedzieć wprost, bo to oczywiste miejsce, gdzie można próbować oszczędzić, a to nie działa: nadal potrzebujesz block.db na NVMe. Obie warstwy, a nie jedna albo druga.
Optane to cache zapisu. Tylko tym jest. Skraca ścieżkę potwierdzenia dla zapisów idących na dysk i nie robi niczego innego.
RocksDB nie tylko zapisuje. Ceph czyta jego metadane bez przerwy, żeby znaleźć obiekty, obsłużyć peering i odpowiedzieć na scruby, a cache zapisu nie daje odczytowi dokładnie nic, kiedy dane już z niego spłynęły. Cache nie usuwa też ruchu metadanych; odkłada go i grupuje, więc każda aktualizacja RocksDB i tak w końcu dociera do talerzy, walcząc o te same ruchy głowicy. A kompakcja zamienia umiarkowane przewalanie danych w dużo więcej ruchu na urządzeniu niż zapisy, które go spowodowały.
Te dwie zmiany naprawiają więc różne problemy i żadna nie zastępuje drugiej:
| Co naprawia | Czego nie | |
|---|---|---|
block.db na NVMe | metadane żyją na flashu, odczyty i zapisy, na stałe poza talerzami | nic na serię zapisów gości |
| Optane przez bcache | opóźnienie potwierdzenia serii dla zapisów danych | nic na odczyty metadanych; zapisy metadanych tylko odkłada |
Pomiń przeniesienie DB i zostaw Optane, a RocksDB wraca na talerz, z odczytami obsługiwanymi przy 80 IOPS. Pomiń Optane i zostaw przeniesienie DB, a stan ustalony jest przyzwoity, ale serie dalej stają przy prędkości talerzy.
Reguła udev, linijka po linijce
Parametry bcache żyją w sysfs, a sysfs resetuje je przy każdej rejestracji urządzenia, czyli przy każdym starcie. Należą więc do reguły udev, a nie do skryptu, o którego uruchomieniu ktoś musi pamiętać:
# /etc/udev/rules.d/99-bcache.rules
ACTION=="add|change", SUBSYSTEM=="block", KERNEL=="bcache*", \
  ATTR{bcache/cache_mode}="writeback", \
  ATTR{bcache/sequential_cutoff}="0", \
  ATTR{bcache/congested_read_threshold_us}="0", \
  ATTR{bcache/writeback_rate}="81920", \
  ATTR{bcache/writeback_rate_minimum}="20480", \
  ATTR{bcache/writeback_percent}="40"
KERNEL=="bcache*" pasuje do każdego urządzenia bcache w węźle, więc jedna reguła obejmuje wszystkie pary. ACTION=="add|change" oznacza, że stosuje się ponownie za każdym razem, gdy urządzenie się pojawia albo zostaje ponownie podłączone, a nie tylko przy starcie.
Co robi każde ustawienie i dlaczego:
cache_mode=writeback: cały sens. W domyślnym writethrough zapis nie jest potwierdzany, dopóki nie dotrze do HDD, więc cache nie robi nic dla opóźnień zapisu. W writeback potwierdza Optane, a dysk talerzowy dogania później.
sequential_cutoff=0: domyślnie bcache wykrywa sekwencyjne I/O i kieruje je prosto obok cache, gdy przekroczy 4 MB, przy założeniu, że dysk pod spodem dobrze radzi sobie z sekwencyjnym. Zero wyłącza to obejście, więc wszystko jest cache’owane. W węźle hiperkonwergentnym to właściwa decyzja: to, co wygląda na sekwencyjne dla jednego urządzenia bcache, przestaje być sekwencyjne na talerzu, gdy przeplata się kilka OSD, a ty chcesz, żeby każdy zapis był potwierdzany z prędkością Optane bez względu na wszystko. Niesie to jednak jedno zobowiązanie: bez obejścia własna sekwencyjna przepustowość zapisu urządzenia cache staje się sufitem dla całego OSD, i dlatego moduły 16 GB są zdyskwalifikowane.
congested_read_threshold_us=0: bcache obserwuje opóźnienia własnego urządzenia cache i zaczyna je omijać, gdy uzna je za przeciążone, domyślnie przy 2000 µs dla odczytów. Optane nie przeciąża się tak jak NAND, więc to bcache podważa urządzenie, które źle zmierzył. Zero wyłącza to śledzenie.
writeback_rate=81920 i writeback_rate_minimum=20480: prędkość opróżniania w tle, w sektorach na sekundę, czyli mniej więcej 40 MB/s celu z minimum 10 MB/s. Regulator PD przesuwa faktyczną prędkość między nimi. Cel ustawiono blisko tego, co dysk talerzowy przyjmie sekwencyjnie, a minimum nie pozwala regulatorowi zdławić opróżniania prawie do zera i pozwolić brudnym danym piętrzyć się bez końca. Obie wartości to punkty wyjścia, a nie stałe; jak je zmienić jest niżej.
writeback_percent=40: ile cache bcache pozwoli trzymać w stanie brudnym, zanim mocno zacznie hamować, wobec domyślnych 10. Czterdzieści daje ci dużo głębszy bufor na serie. Oznacza też, że do 40% tej Optane trzyma jedyną kopię danych w systemie, i to jest ten kompromis, i to jest powód, dla którego układ jeden na dysk ma znaczenie. To wartość, do której najbardziej warto wrócić, kiedy obejrzysz prawdziwe obciążenie.
Zmiana wartości zapełnienia i opróżniania później
40% i dwie prędkości powyżej to wartości działające tutaj, a nie uniwersalne stałe. To pierwsza rzecz, którą zechcesz przesunąć, gdy obejrzysz prawdziwe obciążenie, więc warto wiedzieć, że są dwa miejsca, w których je zmienisz, i robią dwie różne rzeczy.
sysfs zmienia to teraz. Reguła udev zmienia to przy następnym starcie. Chcesz obu, i to w tej kolejności.
Zmiana na żywo, na jednym urządzeniu:
echo 30 > /sys/block/bcache0/bcache/writeback_percent
Albo na każdej parze w węźle:
for d in /sys/block/bcache*/bcache; do
  echo 30 > "$d/writeback_percent"
done
Prędkość opróżniania działa tak samo. Obie wartości są w sektorach na sekundę, więc to zmniejsza o połowę cel i minimum:
for d in /sys/block/bcache*/bcache; do
  echo 40960 > "$d/writeback_rate"
  echo 10240 > "$d/writeback_rate_minimum"
done
To działa natychmiast i przetrwa dokładnie do ponownej rejestracji urządzenia. Dokumentacja jądra mówi wprost, że te ustawienia „do not persist across reboot”, i to jest cały powód, dla którego istnieje reguła udev.
Kiedy jesteś zadowolony z wartości, zmień regułę i przeładuj ją bez restartu:
udevadm control --reload
udevadm trigger --subsystem-match=block --action=change
Tu ACTION=="add|change" zarabia na siebie. Trigger wysyła zdarzenie change do urządzeń, które już są, więc reguła stosuje się ponownie do działającego węzła, zamiast czekać na następny start. Gdyby reguła pasowała tylko do add, to polecenie nie zrobiłoby nic.
Potem odczytaj wartości z powrotem, bo literówka w regule udev zawodzi po cichu:
grep . /sys/block/bcache*/bcache/writeback_percent
Skąd wiedzieć, w którą stronę je przesunąć
Nie stroj tego od pierwszych zasad: bcache wystawia to, czego potrzebujesz, w tym samym katalogu sysfs.
dirty_data to ta, którą trzeba obserwować: ile danych siedzi teraz w cache i nigdzie indziej. Dokumentacja opisuje ją jako „continuously updated unlike the cache set’s version, but may be slightly off”, co do tego celu w zupełności wystarcza. Próbkuj ją przez normalny dzień pracy i przez okno backupu.
cache_hits, cache_misses i cache_hit_ratio mówią ci, czy cache jest używany, z zastrzeżeniem, że „a partial hit is counted as a miss”. bypassed liczy IO, które całkiem ominęło cache; przy sequential_cutoff=0 powinno być prawie płaskie, więc rosnąca liczba oznacza, że coś nadal je obchodzi.
Wszystkie przychodzą jako sumy narastające oraz wersje wygasające z ostatniego dnia, godziny i pięciu minut, przez co te z krótkim oknem są dużo przydatniejsze do wyłapania problemu niż liczba z całego życia.
Dalej:
| Objaw | Pokrętło | Kierunek |
|---|---|---|
| Serie stają, zapisy w połowie serii trafiają w opóźnienia talerzy | writeback_percent | w górę, dla głębszego bufora |
| Więcej danych wystawionych na cache, niż ci wygodnie | writeback_percent | w dół |
dirty_data przyklejone do sufitu podczas zwykłej pracy | writeback_rate | w górę, problemem nie jest bufor, tylko odpływ |
| Opróżnianie w tle rywalizuje z odczytami gości na talerzach | writeback_rate | w dół |
dirty_data pełznie w górę przez dni, a nie godziny | writeback_rate_minimum | w górę, żeby regulator nie mógł zdławić do ślimaczego tempa |
Jeśli dirty_data siedzi przyklejone do sufitu, cokolwiek byś robił, żadne pokrętło nie jest odpowiedzią: klaster zapisuje szybciej, niż dyski talerzowe są w stanie przyjąć, a uczciwe rozwiązania to więcej dysków albo mniej zapisów.
Jeden plik zostaw w spokoju: writeback_running. Wyłączenie go całkiem zatrzymuje writeback, a dokumentacja mówi, że jest „only meant for benchmarking”. Na produkcyjnym OSD oznacza to, że brudne dane narastają, aż cache się zapełni, i nigdy nie spływają.
Co oddajesz w zamian
Większość opisów tego projektu kończy się na dobrych wiadomościach. Oto części, które naprawdę cię zabolą, a każdą z nich warto znać przed budową, a nie po niej.
Utrata któregokolwiek urządzenia flash niszczy OSD. Nie zatrzymuje, tylko niszczy. Oba urządzenia trzymają stan, który nie istnieje nigdzie indziej: block.db trzyma RocksDB, dzięki któremu block ma sens, a cache writeback trzyma każdy zapis jeszcze nie opróżniony. Dokumentacja jądra nie owija w bawełnę przy tym drugim: „In writeback mode you’ll lose data if something happens to your SSD.” Tak czy inaczej OSD nie wraca, tylko zostaje odtworzone i wypełnione przez backfill.
To więc ta sama klasa ryzyka i warto mieć jasność co do tego, zamiast traktować cache jako ten straszny. Optane nie jest groźniejszym urządzeniem niż NVMe. Dzielą je dwie rzeczy i żadną z nich nie jest dotkliwość dla pojedynczego OSD.
Pierwszą jest promień rażenia i to jest całe uzasadnienie parowania. Jedna Optane na dysk oznacza, że awaria cache kosztuje jedno OSD: utratę jednego dysku, czyli dokładnie to zdarzenie, które replikowana pula ma przyjąć i które Ceph obsługuje, nie budząc nikogo w nocy. Urządzenie DB/WAL jest wspólne, więc jego utrata kosztuje naraz każde OSD za nim, a to awaria skorelowana, przed którą replikacja cię nie chroni. Ta sama awaria, jedno urządzenie kontra pięć.
Drugą jest to, jak awaria się objawia, i to jest pułapka operacyjna. Kiedy cache umiera w trybie writeback, urządzenie pod spodem się zatrzymuje i zwraca błędy I/O, co jest w porządku: Ceph oznacza OSD jako down i jedzie dalej. Zły przypadek to restart, po którym urządzenie pod spodem wstaje bez podłączonego cache. Wtedy wygląda jak system plików do zamontowania, któremu po prostu brakuje każdego brudnego zapisu, czyli jest uszkodzony, a nie tylko nieaktualny. Brakujący block.db zawodzi głośno i OSD odmawia startu; brakujący cache może zawieść po cichu i pozwolić ci zamontować wrak. Traktuj urządzenie pod bcache jako niemożliwe do zamontowania bez jego cache i nigdy nie pozwól, żeby coś usłużnie zamontowało je za ciebie.
bcache samo z siebie nie gwarantuje writeback odpornego na utratę zasilania. Tu cache zapisu HDD przestaje być optymalizacją i staje się wymogiem: wyłącz go i używaj jądra na tyle nowego, żeby miało obsługę FUA, tak by zapisy synchroniczne były honorowane przez cały stos, a nie potwierdzane przedwcześnie gdzieś w środku. Urządzenie cache bez ochrony przed utratą zasilania pogarsza sprawę, bo może stracić dane, które już zgłosiło jako bezpieczne.
To czyni proporcję DB/WAL liczbą, która się liczy. Ceph dopuszcza 4–5 OSD na HDD na jeden SSD SATA i nie więcej niż 15 na NVMe, i ostrzega przed „balancing the risk of reducing costs by placing too many responsibilities into too few failure domains.” Inaczej niż przy warstwie cache nie ma tu parowania, które by to ograniczyło: współdzielenie jest sensem tego urządzenia.
Przy dyskach 20 TB to jest cała rozmowa, bo odbudowa jest ogromna. Jedno padnięte OSD to 20 TB do backfillu; przy 150–250 MB/s, które dysk talerzowy utrzymuje, z dławieniem, żeby odtwarzanie nie zagłodziło gości, patrzysz na dobrze ponad dobę pracy w stanie zdegradowanym dla jednego dysku. Strać wspólne urządzenie DB z pięcioma takimi, a do przeniesienia jest 100 TB.
Proporcja to więc w gruncie rzeczy nie decyzja kosztowa. To decyzja o tym, jak długo jesteś gotów pracować w stanie zdegradowanym i ile ruchu odbudowy klaster może unieść, nadal obsługując maszyny wirtualne.
Projekt zależy od urządzenia, którego nikt już nie robi. To jedyny punkt bez technicznej odpowiedzi. Optane to właściwa część na pozycję cache i nic obecnego jej nie zastępuje: NAND nie zniesie wolumenu zapisów, a pamięć oparta na CXL, w którą Intel skręcił, nie jest bezpośrednim zamiennikiem cache blokowego. Środek zaradczy jest więc handlowy, a nie sprytny, jest opisany wyżej, a uczciwe podsumowanie brzmi tak, że ta architektura ma datę końca gdzieś w przyszłości.
Nic z tego nie robi z klastra HDD klastra all-flash. Długotrwały losowy ruch zapisów, który wyprzedza prędkość opróżniania, zapełni cache, a gdy jest pełny, zapisujesz z prędkością talerzy z dodatkowymi warstwami po drodze. Ten projekt przyjmuje serie i usuwa narzut metadanych. Nie produkuje IOPS.
Co z tego wychodzi
Trzy warstwy, każda robi jedną rzecz, w której jest najlepsza, i wszystkie trzy są potrzebne:
- Optane przyjmuje serie losowych zapisów, jedno urządzenie na dysk. To musi być Optane, bo przechodzi przez nią każdy zapis, a trwałość NAND nie pasuje do tego miejsca
- Szybkie NVMe enterprise trzyma RocksDB i WAL, wspólne dla kilku OSD, w proporcji, którą wybrałeś świadomie, a nie przyjąłeś
- Dyski HDD dają pojemność, uwolnione i od metadanych, i od serii
Nie chodzi o udawanie, że dyski talerzowe to flash. Chodzi o to, żeby przestać wysyłać im pracę, w której są najgorsze, tak żeby pojemność, za którą naprawdę zapłaciłeś, była użyteczna.
Na tym polega cała sztuczka i nie ma w niej nic mądrego. Daj każdą robotę urządzeniu, które jest w niej dobre, i przestań płacić podwójnie za te, które nie są.
Dla hiperkonwergentnego klastra Proxmox, który potrzebuje wielu terabajtów pojemności bez cen all-flash, to projekt, którego da się bronić. Zbudowany porządnie działa dużo szybciej niż gołe HDD, psuje się w sposób, do którego Ceph jest zbudowany, a pieniądze idą tam, gdzie zmieniają wynik.
Dwie powiązane rzeczy, które warto przeczytać obok tego: praca nad rozmiarem sektora w 4Kn, 512e i 512n ma duże znaczenie dla tego, co dyski talerzowe robią z zapisami, które do nich docierają, a jeśli budujesz to na węzłach z dyskami podłączonymi bezpośrednio, sieć mesh bez przełącznika obejmuje stronę sieciową małego klastra Ceph.
Źródła
- Ceph — Hardware Recommendations — ostrzeżenie o IOPS na TB przy dużych HDD, „HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD”, proporcje 4–5 HDD na SSD SATA i ≤15 na NVMe, ochrona przed utratą zasilania w SSD enterprise, wyłączenie cache zapisu HDD i to, że HBA z RoC nie jest potrzebne
- Ceph — BlueStore Configuration Reference —
block.dbna 1–2%blockdla RBD i co najmniej 4% dla RGW, ogólna rekomendacja 2,5%, spillover z powrotem na urządzenie główne, rozmiary poziomów RocksDB stojące za progami 3/30/300 GB oraz WAL umieszczany niejawnie razem z DB - Linux kernel — bcache admin guide — tryby cache,
sequential_cutoffi jego domyślne 4 MB, domyślne 2000 µs dla przeciążenia odczytów,writeback_ratew sektorach na sekundę, regulator PDwriteback_percent, licznikidirty_data/cache_hit_ratio/bypassedi ich wygasające wersje dzienne, godzinne i pięciominutowe, ostrzeżenie, żewriteback_runningjest „only meant for benchmarking”, stwierdzenie, że te ustawienia „do not persist across reboot”, oraz „in writeback mode you’ll lose data if something happens to your SSD” - Intel — Optane Memory M10 32 GB specifications — 365 TBW, 240 000 IOPS losowego odczytu i 65 000 losowego zapisu przy 4K w zakresie 8 GB, 1200/290 MB/s sekwencyjnie, PCIe 3.0 x2
- Intel — Optane Memory M10 16 GB specifications — 150 MB/s zapisu sekwencyjnego i 35 000 IOPS losowego zapisu, przez które ta część wypada poniżej dysku talerzowego w przepustowości sekwencyjnej
- PC Perspective — Optane SSD DC P4800X performance — 550K IOPS losowego odczytu 4K części 375 GB, 2400/2000 MB/s sekwencyjnie, typowe opóźnienie poniżej 10 µs i 12,3 PBW przy 30 DWPD
- ServeTheHome — Optane DC P4801X 100GB M.2 review — małe części M.2 do centrów danych, do drabinki pojemności
- StorageReview — Intel Optane SSD P5800X — ocena 100 DWPD, 30 DWPD dla P4800X i porównanie z dyskami NAND enterprise, które kończą się na około 10 DWPD dla części do intensywnych zapisów i 3 lub mniej dla mieszanych
- Bcache — ArchWiki — praktyczne tryby awarii, w tym urządzenie pod spodem, które po restarcie wstaje bez swojego cache, oraz wymagania bezpieczeństwa przy utracie zasilania związane z cache zapisu HDD i FUA
- Intel — Optane business update — zakończenie działalności i co oznacza dla gwarancji i wsparcia urządzeń już w użyciu, w tej sytuacji jest wszystko, co kupisz na rynku wtórnym