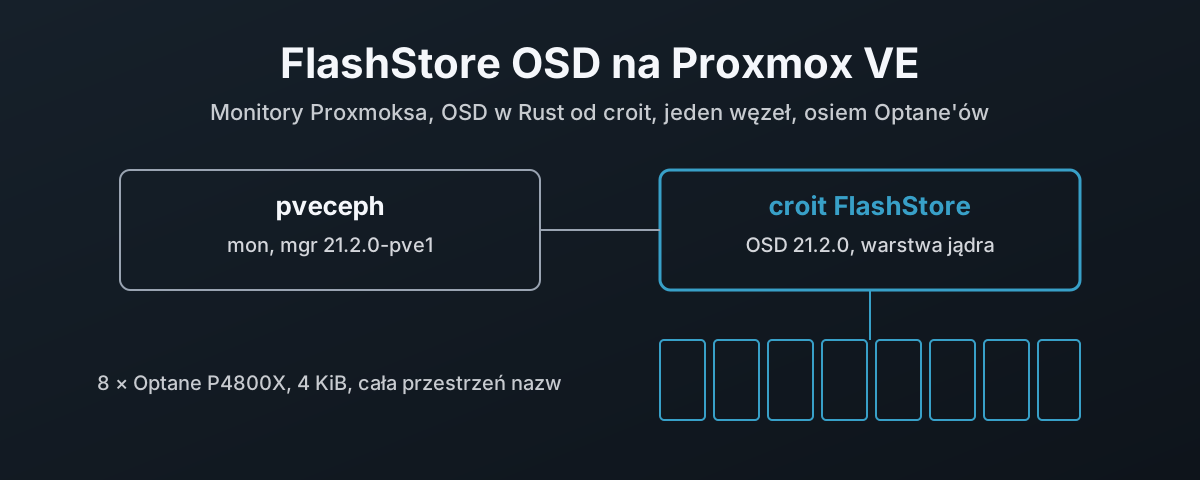
OSD w Rust, w dniu premiery
croit udostępnił FlashStore OSD jako publiczną wersję zapoznawczą 9 listopada 20261.
To OSD Ceph napisany od zera w Rust, z własnym magazynem obiektów zamiast BlueStore, i mówi protokołem sieciowym Ceph.
Obietnica jest taka, że wpinasz go w klaster, który już masz: twoje monitory, twoje managery, twoje CLI ceph i twoi klienci zostają, jak są, a ty wymieniasz po jednym dysku1.
Dla firmy na Proxmoksie ta obietnica znaczy więcej niż dla większości.
Na hiperkonwergentnym węźle Proxmox VE Ceph nie jest czymś, co instalujesz osobno.
Przychodzi z GUI Proxmoksa, z repozytoriów Proxmoksa, zbudowany i załatany przez Proxmoksa, a całością steruje pveceph.
Jeśli OSD od kogoś innego potrafi tam usiąść, nic nie psując, dostajesz nowy silnik storage’u bez rezygnacji z narzędzi.
Jeśli nie potrafi, dowiadujesz się tego w bolesny sposób, na węźle, na którym działają też twoje VM.
Więc spróbowałem.
Pracuję dla croit, który robi FlashStore. Dlatego spróbowałem w ciągu dwóch dni od premiery i z tego samego powodu nic poniżej nie jest łagodzone. To wersja zapoznawcza, README mówi, że jest „not yet recommended for production data”1, a to jest opis tego, czego wymagała na prawdziwym sprzęcie, nie broszura.
Krótka odpowiedź: działa. Gdy to piszę, osiem OSD FlashStore serwuje pulę RBD maszynie wirtualnej na standardowym węźle Proxmox VE 9.2, HEALTH_OK. Dłuższa odpowiedź jest taka, że potrzebne były dwie poprawki, o których dokumentacja nie wspomina, jedna przez to, jak Proxmox przechowuje konfigurację Ceph, a druga przez jądro Proxmoksa, i reszta tego wpisu to te poprawki i to, jak je znaleziono. Jeśli chcesz tylko, żeby działało, pod koniec jest skrypt, który robi to wszystko, i był uruchomiony na tym węźle.
Sprzęt
Laboratorium to pojedynczy węzeł, pve2, w mojej domowej sieci LAN, i jest to marny minikomputer Minisforum B550 z 2021 roku.
Jednowęzłowy Ceph to nie jest sposób na produkcję, a reguła CRUSH niżej jest tego ceną, ale każdy krok jest tu taki sam jak na węźle, który ma sąsiadów.
| Proxmox VE | pve-manager 9.2.26, jądro 7.0.14-28-pve, Debian 13.7 |
| Maszyna | minikomputer Minisforum B550, 2021; płyta zgłasza BESSTAR TECH B550, BIOS 5.17 |
| CPU | AMD Ryzen 7 5700G, 8 rdzeni, 16 wątków, 1 węzeł NUMA |
| Pamięć | 58 GiB |
| Dyski OSD | 8 × Intel Optane P4800X 375 GB (6 z marką Dell, 2 detaliczne Intel) |
| PCIe do Optane’ów | wszystkie osiem za jednym przełącznikiem Broadcom PEX880xx, na jednym łączu PCIe 3.0 x16 z APU |
| Dysk rozruchowy | WD SN750 512 GB, VG pve, trzymany z dala od tego wszystkiego |
| Sieć | jeden port 2,5 GbE, vmbr0 |
| FlashStore | snapshot-2026-11-10, commit upstream c5792750020e2 |
Optane’y są tu dlatego, że FlashStore ma dwa twarde wymagania, których wiele dysków nie spełnia.
Dysk musi mieć ochronę przed utratą zasilania, a przestrzeń nazw musi używać bloków 4096-bajtowych, jako cała przestrzeń nazw, bez partycji i bez systemu plików1.
FlashStore potwierdza zapis, gdy jest on trwały na dysku, więc dysk, który kłamie o trwałości z ulotną pamięcią podręczną, jest odrzucany przy mkfs3.
Każdy P4800X zgłasza w danych Identify brak ulotnej pamięci podręcznej zapisu (vwc 0), czyli sam dysk mówi, że cache nie może zgubić potwierdzonego zapisu.
Tak więc to minikomputer jest czynnikiem ograniczającym w tej analizie, nie FlashStore i nie dyski. Osiem rdzeni to jeden na OSD i nic w zapasie, 58 GiB musi wykarmić i Ceph, i VM, a osiem Optane’ów dzieli jedno łącze PCIe 3.0, bo tyle APU ma do dania. Czytaj każdą liczbę poniżej jako to, na co pozwala ta skrzynka.
Umbrella albo nic
FlashStore jest budowany pod jedno wydanie Ceph naraz.
Decyduje gałąź: main mówi Ceph 21.2.0 Umbrella, a gałąź v20.2.4 mówi 20.2.4 Tentacle4.
Demon sprawdza przy starcie wydanie klastra i odmawia, gdy jest poza jego oknem4.
Pakiety na stronie wydania są budowane z main, i binarka sama to mówi: croit-flashstore-osd 21.2.0 umbrella.
Proxmox VE 9 oferuje trzy repozytoria Ceph i tylko jedno z nich pasuje.
Tentacle jest domyślny w Proxmoksie, więc to bezpieczny wybór?
To ten, który nie zadziała.
Repozytorium Proxmoksa ma Tentacle do 20.2.5-pve1, a gałąź Tentacle FlashStore celuje dokładnie w 20.2.4.
Umbrella w repozytorium Proxmoksa to 21.2.0-pve1, to samo wydanie, w które celuje main.
Proxmox nie ukrywa, czym jest Umbrella.
PVE/Ceph/Releases.pm wymienia go z unsupported => 15, a kreator w GUI mówi to prostymi słowami w chwili, gdy go wybierzesz.
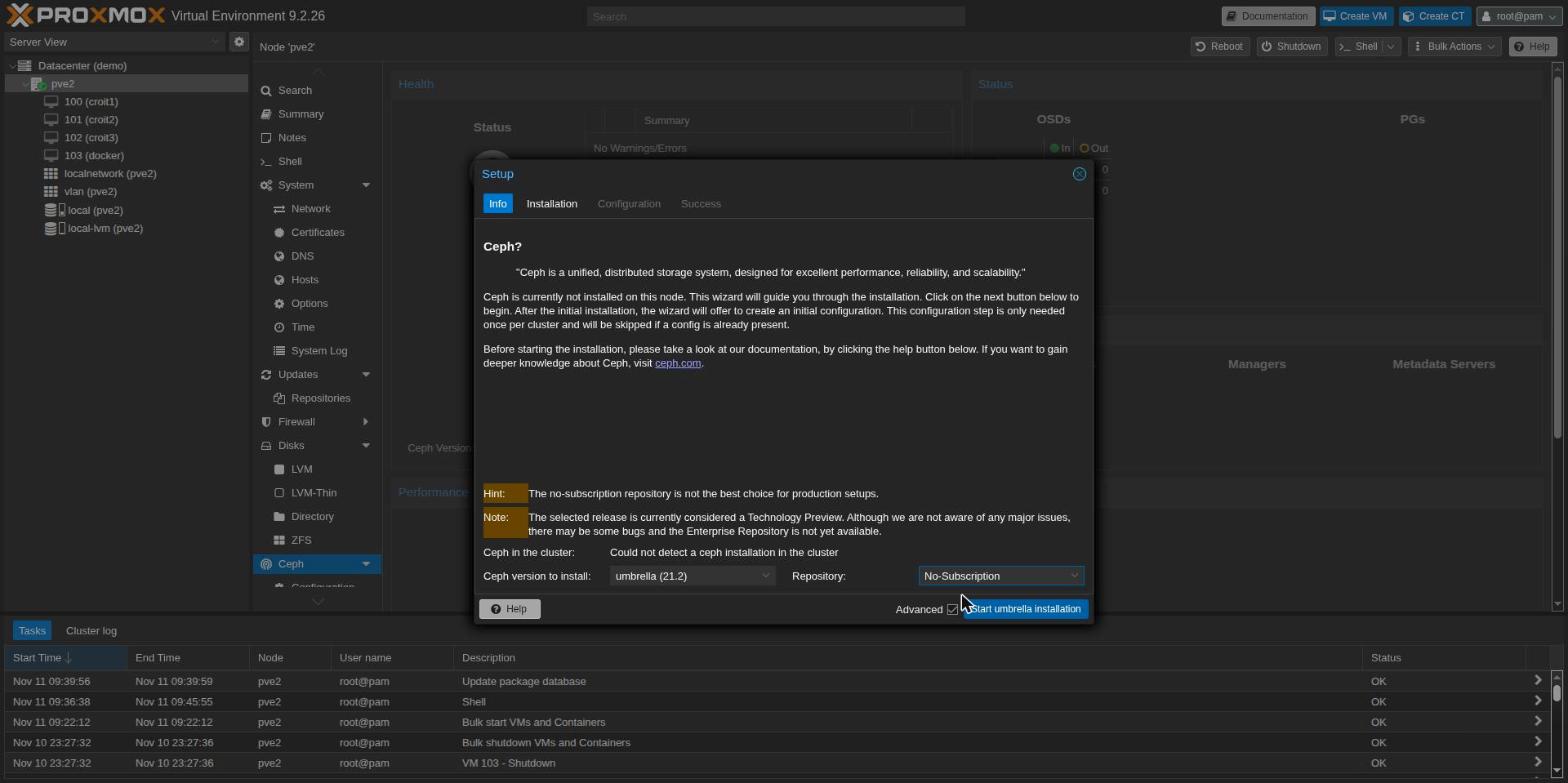
„Technology Preview”, brak repozytorium enterprise, a instalator pyta drugi raz w terminalu, continue (y/N)?, zanim dotknie apt.
To właściwa dawka ostrzeżeń i warto ją czytać jako stwierdzenie o całym stosie: zapoznawczy OSD na zapoznawczym wydaniu Ceph.
Instalacja to standardowy Proxmox. Datacenter → Ceph → Install, wersja Umbrella, repozytorium No-Subscription, potem sieć publiczna i pierwszy monitor.
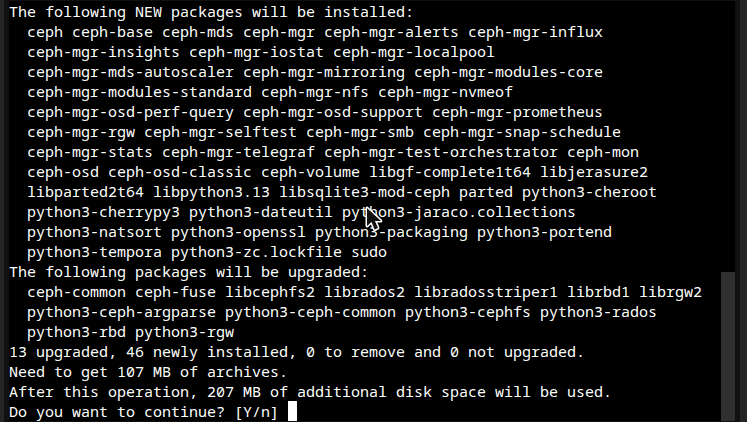
Trzynaście pakietów zaktualizowanych, 46 nowych, 107 MB pobranych.
Jedna rzecz na tej liście jest nowa w Umbrella: ceph-osd-classic obok ceph-osd.
Żaden z nich nie jest tu używany, bo nie powstaje ani jeden klasyczny OSD.
Mniej więcej minutę później działały mon.pve2 i mgr.pve2, ceph versions zgłaszał 21.2.0 … umbrella, a stan był OK, bez niczego do przechowania.
Cztery dyski w 512 bajtach
Cztery z ośmiu Optane’ów były przekazane do laboratoryjnej VM i wciąż miały format 512-bajtowy, ze starymi etykietami ZFS. Dwa kolejne miały właściwy format i te same etykiety. Poprawka dla obu jest prosta: zabrać je z VM, sformatować do 4 KiB, wyczyścić etykiety.
P4800X oferuje 4096 bajtów bez metadanych jako format LBA 3, który nvme id-ns zgłasza jako lbaf 3 : ms:0 lbads:12.
nvme format /dev/nvme0n1 --lbaf=3 --force --timeout=900000
wipefs -a /dev/nvme0n1
sgdisk --zap-all /dev/nvme0n1
Pierwsza próba się nie udała, późniejsza też nie.
Za każdym razem nvme format wracał z Interrupted system call, a dysk wciąż był w 512 bajtach.
Log jądra podaje powód:
nvme nvme0: I/O tag 0 (0000) opcode 0x2 (Admin Cmd) QID 0 timeout, reset controller
nvme nvme1: I/O tag 9 (0009) opcode 0x6 (Admin Cmd) QID 0 timeout, reset controller
Opcode 0x2 to Get Log Page, a 0x6 to Identify.
Żaden z nich nie jest formatowaniem.
P4800X formatuje cały nośnik i trwało to tu od 345 do 351 sekund na dysk.
W tym czasie kontroler nie odpowiada na inne polecenia administracyjne, więc wszystko, co zadaje dyskowi pytanie, czeka.
Po 60-sekundowym limicie czasu poleceń administracyjnych jądro się poddaje i resetuje kontroler, a reset zabija formatowanie.
| Próba | Co dotarło do dysku | Wynik |
|---|---|---|
| nvme0, pierwsza | Get Log Page o 09:53:04, w trakcie instalacji Ceph | przerwana, wciąż 512 B |
| nvme0, w unicie | nic | 4 KiB w 345 s |
| nvme1 | moje własne nvme list, sprawdzające postęp | przerwana, wciąż 512 B |
| nvme2, nvme3 | nic | 4 KiB w 351 s i 350 s |
| nvme1, sam | nic | 4 KiB w 346 s |
Poprawka polega na uruchomieniu każdego formatowania w przejściowym unicie z długim limitem czasu, po jednym dysku, i zostawieniu dysków w spokoju, aż się skończy:
systemd-run --unit=fmt4k /root/fmt4k.sh
journalctl -u fmt4k -f       # read progress from the journal, not from the drive
W ten sposób jedynym sprawdzaniem postępu jest dziennik i nic nie dociera do kontrolera.
Wszystkie osiem pokazywało potem 4 KiB w nvme list.
Pakiet
Strona wydania ma pakiety .deb i .rpm, wśród nich Debian 13 trixie, na którym zbudowany jest Proxmox VE 92.
Jedna kompilacja obsługuje każdą dystrybucję i wymaga glibc 2.34 lub nowszej6.
B=https://github.com/croit/ceph-rust/releases/download/snapshot-2026-11-10-0b6783237291
curl -LO "$B/flashstore_21.2.0+git.20261110063351.c5792750020e_debian-trixie_amd64.deb"
curl -LO "$B/sha256sums.txt"
sha256sum flashstore_*_debian-trixie_amd64.deb
grep debian-trixie/flashstore_ sha256sums.txt
Sprawdź to ręcznie.
sha256sum -c nie sprawdzi tego pobrania, bo plik sum kontrolnych nazywa go debian-trixie/flashstore_…_amd64.deb, a zasób nazywa się flashstore_…_debian-trixie_amd64.deb.
Skróty się zgadzają, ce1fb352…26c8 po obu stronach, więc plik jest w porządku, a tylko lista rozjechała się z zasobami.
apt install ./flashstore_*_debian-trixie_amd64.deb
croit-flashstore-osd --version
croit-flashstore-osd 21.2.0 umbrella (build 0.0.0) git c5792750020e
net tiers: kernel (+rdma upgrade)
Zainstalował się czysto obok własnych ceph-osd i ceph-osd-classic Proxmoksa.
Pakiet instaluje minimalny ceph-osd.target tylko na hostach, które go nie mają6, a Proxmox już go ma, więc unity FlashStore wiszą pod tym samym targetem co klasyczne.
Trzy rzeczy o pakiecie, które warto wiedzieć, zanim zaczniesz pisać pod niego skrypty:
| Co mówi dokumentacja | Czym jest pakiet | |
|---|---|---|
| Nazwa pakietu | apt remove flashstore …6 | croit-flashstore-osd, plik zasobu to flashstore_… |
| Backendy magazynu | produkcyjny zestaw funkcji main to knet,spdk,rdma,mimalloc1 | brak SPDK: --check zgłasza „SPDK NVMe driver: compiled out” |
Wartości flashstore_dev | spdk:<pci> albo file: w kompilacjach deweloperskich7 | warstwa jądra, kernel:/dev/…, to jedyna prawdziwa ścieżka magazynu w tej kompilacji |
Środkowy wiersz jest ważny.
Warstwy SPDK, sterownika NVMe w przestrzeni użytkownika, który wymaga powiązania dysku z vfio-pci, nie ma w opublikowanym pakiecie Debiana.
Jest w nim warstwa jądra: dysk zostaje przy własnym sterowniku nvme jądra, a FlashStore rozmawia z nim przez io_uring.
Źródła pokazują, że jest wkompilowana, bo funkcja knet wciąga kernel-nvme8, mimo że linia podsumowania kontroli hosta nazywa ją „compiled out of this build”.
Ta linia jest błędna.
Czytelnik, który jej zaufa, zatrzyma się w tym miejscu.
Co mówi kontrola hosta
croit-flashstore-osd --check działa tylko do odczytu i uruchamia się, zanim cokolwiek zostanie zapisane.
Sprawdza kompilację, CPU, pamięć, IOMMU, każdy kontroler NVMe, kartę sieciową, jądro i konfigurację, i dla każdego znaleziska drukuje dokładną poprawkę9.
Na tym węźle wykonała 115 sprawdzeń i jest dobra: każde znalezisko przychodzi z poleceniem, które je naprawia, co oszczędziło mnóstwo grzebania.
| Znalezisko | Wynik | Co zrobiłem |
|---|---|---|
| Hugepages: nic nie zarezerwowano | FAIL | zarezerwowałem 16 GiB, o które prosiła, utrwalone w /etc/sysctl.d |
| Dysk rozruchowy SN750: ulotny cache zapisu | FAIL | nic, to nie kandydat na OSD |
vfio-pci niezaładowany | WARN | nic, ta kompilacja nie ma SPDK, który by go użył |
| limit memlock 8 MiB | WARN | nic, mierzy powłokę; unit ustawia LimitMEMLOCK=infinity |
brak isolcpus / nohz_full | WARN | zanotowane, strojenie opóźnień |
IOMMU w trybie translacji, nie iommu=pt | WARN | zanotowane |
init_on_alloc=1 | WARN | zanotowane, według niej kosztuje 15 do 20 % CPU przy dużych odczytach |
| port 2,5 GbE, domyślne bufory kart sieciowych, IRQ na pięciu CPU | WARN | zanotowane |
| 8 × P4800X: bez VWC, aktywne 4096+0, x4 przy 8 GT/s, wolne | OK | |
| io_uring z SEND_ZC i stałymi buforami, jądro 7.0 | OK |
Zaplanuj drugi FAIL.
Kontrola liczy każdy kontroler w skrzynce, a rozruchowy SSD ma cache zapisu, więc oblewa test utraty zasilania, mimo że ta sama kontrola poprawnie oznacza go „in use, not a candidate”.
Tutorial mówi, że kod wyjścia 0 oznacza brak FAIL9.
Na każdym hoście, który startuje z konsumenckiego SSD, a to sporo hostów Proxmoksa, --check nie może zwrócić 0, cokolwiek naprawisz.
Pisz skrypty pod linie poszczególnych sprawdzeń, nie pod kod wyjścia.
Ostrzeżenia dotyczące strojenia zostały. Każde z nich wymaga zmiany wiersza poleceń jądra i restartu, a to jest wdrożenie, nie benchmark. To właściwa lista do przerobienia, zanim ktokolwiek zacytuje liczbę z tej skrzynki.
Rdzenie i hugepages dla ośmiu OSD
FlashStore działa w modelu wątek na rdzeń, a kontrola wyjaśnia, co to znaczy: „one core = one shard/PG owner”, najwyżej 8 rdzeni na OSD, i każdy rdzeń OSD na własnym fizycznym rdzeniu, a nie dzielony z rodzeństwem SMT.
Osiem fizycznych rdzeni i osiem OSD daje po jednym rdzeniu na każdy, flashstore_lcores = 0 do 7, a rodzeństwo SMT zostaje dla Proxmoksa i VM.
Po ponownym uruchomieniu z tym w konfiguracji kontrola oznacza każdy plan rdzeni jako OK.
Spójrz jeszcze raz na hugepages.
Kontrola prosi o 2048 MiB na OSD, czyli domyślne --mem demona, więc osiem OSD potrzebuje 16 GiB zarezerwowanych.
W działaniu każdy OSD użył 512 MiB ze swoich 2048.
To zgadza się z notatką projektową croit dla backendu jądra, która przeznacza ćwierć --mem na alokator ładunku10.
Więc na tej skrzynce, przy wszystkich ośmiu działających, 12 GiB RAM leży zarezerwowane jako hugepages, których nic nie dotyka, na hoście, który ma też VM do wykarmienia.
Węzeł czysto storage’owy wzruszyłby ramionami.
Na węźle Proxmoksa ta pamięć to była jedna VM, i dalej zostaje przycięta do tego, czego OSD faktycznie używają.
Czy mogę zapytać, dlaczego nie potrafi odczytać ceph.conf?
Z sformatowanymi dyskami, zainstalowanym pakietem i czystą kontrolą hosta pierwszy OSD nie chciał wystartować.
croit-flashstore-tool: refused: /etc/ceph/ceph.conf: Permission denied (os error 13)
Na Proxmoksie /etc/ceph/ceph.conf to dowiązanie symboliczne do /etc/pve/ceph.conf, a /etc/pve to pmxcfs, klastrowy system plików, który utrzymuje konfigurację każdego węzła w zgodzie.
Pliki tam mają root:www-data 0640, a pmxcfs nie pozwala zmienić tego dla pojedynczego pliku11.
Własne demony Ceph Proxmoksa radzą sobie, bo startują jako root, czytają konfigurację, a potem schodzą do użytkownika ceph, co robi --setuser ceph --setgroup ceph w każdym unicie ceph-osd@.
Unit FlashStore nie startuje jako root.
Ma User=ceph od pierwszej instrukcji, łącznie z ExecStartPre12, więc nigdy nie dochodzi do odczytania pliku.
Czy mogę zapytać, dlaczego pakiet zbudowany dla Debiana, dla produktu typu drop-in, nie został wypróbowany na najpopularniejszej platformie Ceph opartej na Debianie, jaka istnieje? Nie pytam, kto. pveceph trzyma swoją konfigurację na pmxcfs i każdy OSD FlashStore na węźle zarządzanym przez pveceph trafi na to przy pierwszym starcie.
Demon ma już odpowiedź wbudowaną.
Jego źródła opisują klasyczne zejście przez --setuser/--setgroup: „started as root by a classic unit (--setuser ceph --setgroup ceph), the daemon becomes that user before it opens the store, a socket or a file”13.
Więc drop-in, który uruchamia unit tak, jak Proxmox uruchamia własne OSD, powinien wystarczyć.
Nie do końca wystarczył. Uruchomiony jako zwykły root, następnej odmowy udzielił dysk.
activate: device kernel:/dev/ng0n1 not ready: /dev/nvme0n1: Permission denied (os error 13)
CapabilityBoundingSet unitu pomija CAP_DAC_OVERRIDE12, więc root podlega zwykłym uprawnieniom plików, a węzły przestrzeni nazw należą do ceph:ceph.
Start jako root z grupą ustawioną na ceph załatwia jedno i drugie: root jest właścicielem pliku konfiguracji, grupa ceph otwiera dysk, a demon schodzi do ceph, zanim zrobi cokolwiek innego.
# /etc/systemd/system/croit-flashstore-osd@.service.d/pve-ceph-conf.conf
[Service]
User=root
Group=ceph
ExecStart=
ExecStart=/usr/bin/croit-flashstore-osd run --id %i --cluster ${CLUSTER} -f --setuser ceph --setgroup ceph
Demon potwierdza zejście we własnym logu: set uid:gid to 64045:64045 (ceph).
Jest krótsza poprawka, SupplementaryGroups=www-data, i jej nie użyłem.
Pozwoliłaby OSD czytać każdy plik pod /etc/pve czytelny dla grupy, a nie tylko konfigurację Ceph.
OSD nie ma żadnego interesu w czytaniu reszty konfiguracji klastra, a powyższy drop-in nie daje mu ani trochę więcej, niż Proxmox daje własnym.
Potem węzły urządzeń.
Dokumentacja FlashStore mówi, że węzeł przestrzeni nazw musi być zapisywalny dla ceph, „(udev rule)”14, a pakiet nie dostarcza żadnej.
Ta dopasowuje dyski po modelu, więc nie może złapać dysku rozruchowego, jakkolwiek zmieni się numeracja:
# /etc/udev/rules.d/70-croit-flashstore-optane.rules
SUBSYSTEM=="nvme-generic", KERNEL=="ng*n*", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
SUBSYSTEM=="block", KERNEL=="nvme*n*", ENV{DEVTYPE}=="disk", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
Po udevadm trigger szesnaście węzłów Optane miało ceph:ceph 0660, a SN750 został przy root.
Passthrough, którego to jądro nie zrobi
Warstwa jądra ma dwa tryby, a węzeł, który podasz, wybiera między nimi.
kernel:/dev/ngXnY wysyła polecenia NVMe prosto do dysku przez io_uring, co croit nazywa kernel-cmd.
kernel:/dev/nvmeXnY wykonuje odczyty i zapisy O_DIRECT na urządzeniu blokowym, nazywane kernel albo direct10.
croit zmierzył, że kernel-cmd prowadzi w każdej przetestowanej komórce10, a szybki start w README go używa1, więc to skonfigurowałem.
Gdy uprawnienia były już w porządku, demon zszedł do ceph, odczytał konfigurację i zatrzymał się na pierwszym odczycie:
croit-flashstore-osd: --dev kernel:/dev/ng0n1: /dev/ng0n1: kernel-cmd fixed-buffer probe read: Errno(13)
Ta sama sonda przeszła minutę wcześniej w activate, który wciąż miał uprawnienia roota.
Więc pytanie brzmi, czy to jądro pozwala nieuprzywilejowanemu procesowi wysyłać polecenia I/O przez /dev/ngXnY.
Da się na nie odpowiedzieć bez FlashStore, tym samym odczytem z nvme-cli, jako ceph:
| Jako | Polecenie na /dev/ng0n1 | Wynik |
|---|---|---|
ceph | Identify Namespace | dozwolone |
ceph | Read, LBA 0, 4 KiB | Permission denied |
root | Read, LBA 0, 4 KiB | dozwolone |
Wszystkie osiem Optane’ów dało tę samą odpowiedź, łącznie z dwoma, których nigdy nie formatowałem ani nie resetowałem, z firmware’em Intela zamiast Della. Więc to nie dyski i nie poranne formatowania.
Upstream mówi, że powinno działać.
W Linuksie 7.0 nvme_cmd_allowed() pozwala nieuprzywilejowanemu procesowi wysłać polecenie I/O, gdy log Commands Supported and Effects dysku oznacza je jako obsługiwane, bez nietypowych efektów, i wymaga otwarcia do zapisu tylko dla poleceń, które zapisują lub zmieniają dane15.
Log efektów P4800X oznacza Read jako obsługiwane, 00000001, i nic więcej.
Odczyt jest dozwolony.
Jądro Proxmoksa to nie jądro upstream.
Jego dziennik zmian dla tej kompilacji zawiera przeniesioną poprawkę dokładnie na tej ścieżce, CVE-2026-90227: nvme/ioctl: check SUBMIT_IO with nvme_cmd_allowed(), która na pierwszy rzut oka dotyczy innego ioctl niż ten, który testowałem.
Nie ustaliłem, która zmiana w jądrze 7.0.14-28-pve robi różnicę, i nie będę zgadywał.
Pewne jest zachowanie: na tym jądrze nieuprzywilejowane I/O przez passthrough NVMe jest odrzucane.
FlashStore ma mechanizm zapasowy na odrzucony passthrough i on się nie uruchomił.
Notatka projektowa croit mówi, że gdy Identify zostanie odrzucone, urządzenie kernel-cmd przechodzi na bezpośrednie I/O na swoim węźle blokowym i ogłasza to przy starcie10.
Tutaj Identify jest dozwolone, a Read nie, więc mechanizm zapasowy nigdy się nie włącza i OSD po prostu staje.
Bezpośredniemu I/O jest to obojętne. To jedna linia na OSD:
flashstore_store_backend = kernel
Z tym osd.0 wstał.
croit-flashstore-osd: store mounted (1 shards, replayed 4 txns in 16 ms)
croit-flashstore-osd: set uid:gid to 64045:64045 (ceph)
[    1.398] crush location set (create-or-move updating item name 'osd.0' weight 0.3359 at location {host=pve2,root=default} to crush map)
[    2.406] osd.0 is now active (up_from 10, map 10)
Aktywny w 2,4 sekundy.
Przygotowanie i start OSD
Każdy OSD dostaje sekcję w konfiguracji Ceph, co na Proxmoksie oznacza edycję /etc/pve/ceph.conf, i można to spokojnie robić ręcznie.
[osd.0]
	flashstore_dev = spdk:0000:05:00.0
	flashstore_store_backend = kernel
	flashstore_lcores = 0
Urządzenie jest wskazane adresem PCI, nie przez /dev/nvme0n1, a przedrostek spdk: nie oznacza tu SPDK.
Przy ustawionym backendzie jądra demon przy każdym starcie wyszukuje adres w sysfs i znajduje bieżące węzły kontrolera10.
Tu ma to znaczenie.
Dysk rozruchowy SN750 był nvme7 w październiku, a teraz jest nvme8, a numery podrzędne węzłów generycznych też nie idą za kolejnością dysków: ng1n1 ma numer 0, a ng0n1 numer 2.
Konfiguracja, która mówi /dev/nvme4n1, po restarcie może wskazywać inny dysk.
Konfiguracja, która mówi 0000:0b:00.0, nie może.
Potem jedno polecenie na dysk, które zapisuje magazyn i rejestruje OSD w monitorze:
croit-flashstore-tool prepare --dev spdk:0000:05:00.0 --id 0
kernel-cmd /dev/ng0n1: fixed-buffer NVMe passthrough probe ok (IORING_URING_CMD_FIXED on)
mkfs: device lba 4096 B x 91573146 (375083606016 B), awupf 1 lba, vwc false, max_xfer 32 lba
mkfs: 1 store shards, WAL ring 4096 MiB each
osd.0 prepared in /var/lib/ceph/osd/ceph-0
Dwie sekundy, jako root.
prepare czyta klucz bootstrap z /var/lib/ceph/bootstrap-osd/ceph.keyring16, który pveceph zapisuje dopiero przy pierwszym tworzeniu własnego OSD, więc bez klasycznych OSD trzeba go najpierw pobrać:
ceph auth get client.bootstrap-osd -o /var/lib/ceph/bootstrap-osd/ceph.keyring
Sześć dysków przygotowało się za pierwszym razem. Dwa zostały odrzucone:
croit-flashstore-tool: refused: device is not empty (non-zero data in the first 8192 bytes); --wipe destroys it
croit-flashstore-tool: refused: device is not empty (non-zero data at 65536 bytes); --wipe destroys it
lsblk i blkid zgłaszały oba te dyski jako puste.
Było na nich tekstowe pole metadanych grupy woluminów LVM z wcześniejszego laboratorium, dawno usuniętej, z etykietą na początku już wyzerowaną.
Sonda FlashStore czyta pierwsze 8 KiB oraz obszary na 64 KiB i 256 KiB17, czyli dalej, niż zaglądają zwykłe narzędzia, i miała rację.
Odmowa wobec dysku, na którym jest cokolwiek, chyba że dostanie --wipe, to dokładnie to, co narzędzie do OSD powinno robić.
Wyczyszczenie ich to decyzja właściciela dysków, nie narzędzia.
Gdy decyzja zapadła, --wipe przygotował oba w mniej więcej dwie sekundy, a dołączyły po instalacji opisanej niżej, dlatego zrzut panelu i liczby z instalacji pokazują sześć.
Potem je uruchom:
systemctl enable --now croit-flashstore-osd@0
ID  CLASS  WEIGHT   TYPE NAME      STATUS  REWEIGHT  PRI-AFF
-1         2.01535  root default
-3         2.01535      host pve2
 0   nvme  0.33589          osd.0      up   1.00000  1.00000
 1   nvme  0.33589          osd.1      up   1.00000  1.00000
 2   nvme  0.33589          osd.2      up   1.00000  1.00000
 3   nvme  0.33589          osd.3      up   1.00000  1.00000
 4   nvme  0.33589          osd.4      up   1.00000  1.00000
 5   nvme  0.33589          osd.5      up   1.00000  1.00000
Każdy OSD umieścił się pod host=pve2 z klasą urządzenia nvme.
To, co mówią klastrowi o sobie, warto raz przeczytać:
| Pole | Monitor i manager | OSD FlashStore |
|---|---|---|
ceph versions | 21.2.0 (087cd25db8f1) umbrella (dev - None) | 21.2.0 (b060042deb05) umbrella (dev - croit-flashstore-osd) |
| Zbudowane przez | Proxmox, pakiety -pve1 | croit, z commitu upstream v21.2.0 wskazanego w README1 |
osd_objectstore | bluestore, z wypełnionym każdym polem bluestore_bdev_* | |
| Czym naprawdę jest | FlashStore, bez BlueFS, bez RocksDB |
Odpowiedź BlueStore jest celowa.
flashstore_report_objectstore ma domyślnie bluestore, bo klasyczne monitory włączają niektóre funkcje tylko wtedy, gdy zgłasza to każdy OSD, więc wartość domyślna utrzymuje mieszany klaster w działaniu7.
To nieprawda i warto o tym wiedzieć, zanim przeczytasz metadane klastra i w nie uwierzysz.
Co Proxmox z nich robi
Panel OSD Proxmoksa wymienia wszystkie sześć: up i in, klasa nvme, wersja 21.2.0, po 344 GiB.
Nazywa je też FileStore.
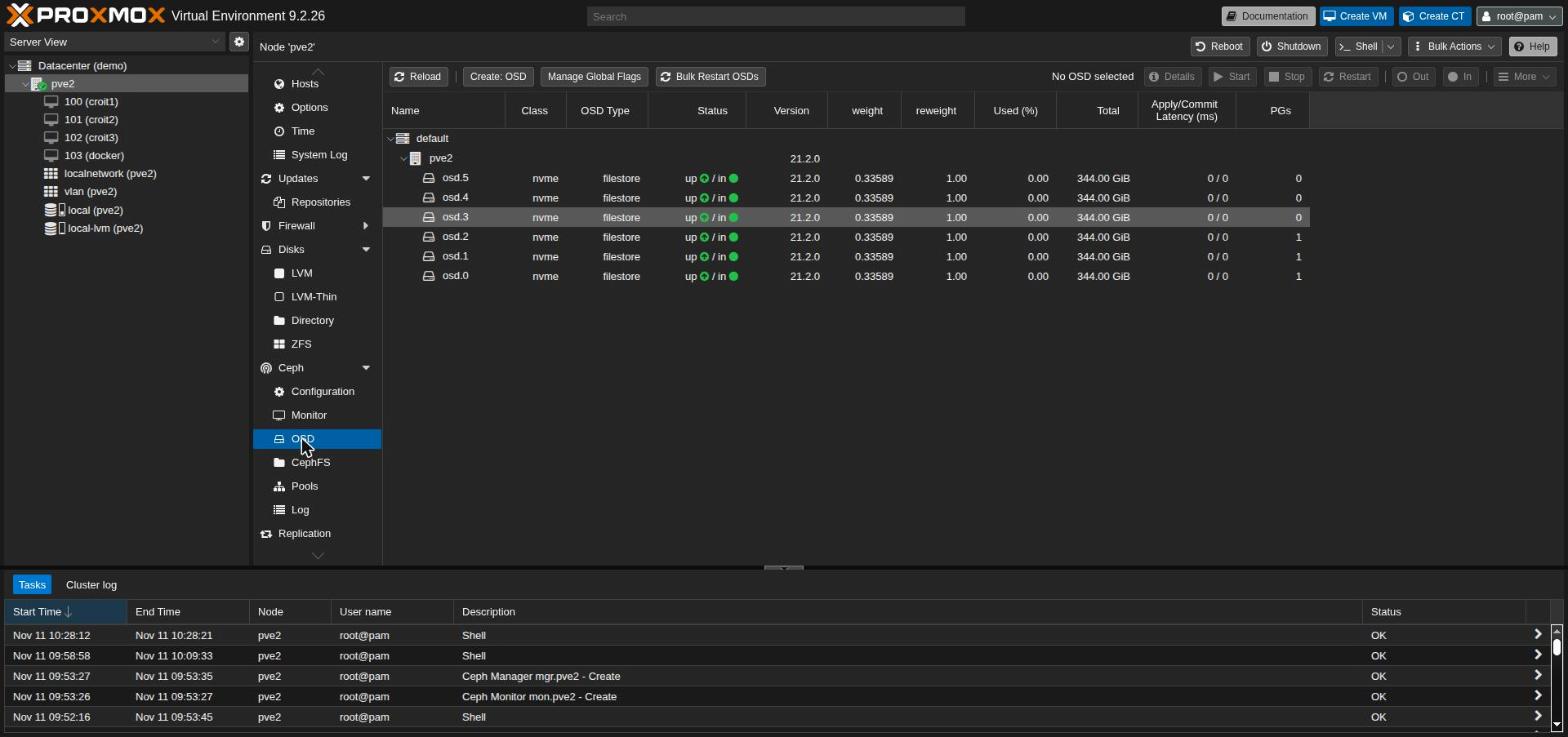
FileStore to magazyn obiektów, który BlueStore zastąpił.
Proxmox ustala etykietę w PVE/API2/Ceph/OSD.pm: jeśli metadane OSD mają klucz bluefs, to BlueStore, a wszystko inne to FileStore18.
FlashStore nie ma BlueFS, bo nie ma pod nim RocksDB, więc w jednym polu zgłasza BlueStore, a z innego dostaje etykietę FileStore.
Żadne nie jest prawdziwe.
A panel to miejsce, w które większość administratorów Proxmoksa patrzy najpierw.
Kolumny opóźnień pokazują 0 / 0 w bezczynności.
Podczas instalacji opisanej niżej ceph osd perf zgłaszał opóźnienia commitu od 0 do 3 ms na całej szóstce.
Start, Stop i Restart w panelu sterują ceph-osd@N, klasycznym unitem, który nie jest tym, co działa19.
Tym samym panel jest widokiem na te OSD, nie sterowaniem nimi.
Do wszystkiego, co dotyka demonów, używaj systemctl … croit-flashstore-osd@N i CLI, a Create: OSD i Destroy zostaw przy nich w świętym spokoju.
Pula, storage i VM z Fisher-Price OS (Windows)
Pierwsza PG w klastrze, z puli .mgr managera, stała w undersized+degraded, gdy tylko OSD wstały.
Winny jest pojedynczy węzeł.
Domyślna replicated_rule umieszcza każdą kopię na innym hoście, a host jest jeden.
ceph osd crush rule create-replicated replicated_osd default osd nvme
ceph osd pool set .mgr crush_rule replicated_osd
Reguła z domeną awarii osd i klasą urządzenia nvme20 umieszcza każdą kopię na innym OSD, a PG przeszła w active+clean w kilka sekund.
Na prawdziwym klastrze z trzema lub więcej hostami zostaw regułę hostów i pomiń to.
Wszystko potem to zwykłe GUI Proxmoksa.
Ceph → Pools → Create: nazwa flashstore, size 3, min size 2, reguła replicated_osd, zaznaczone Add as Storage.
Później zmieniono to na size 2, min size 1, na potrzeby testu obciążenia opisanego dalej.
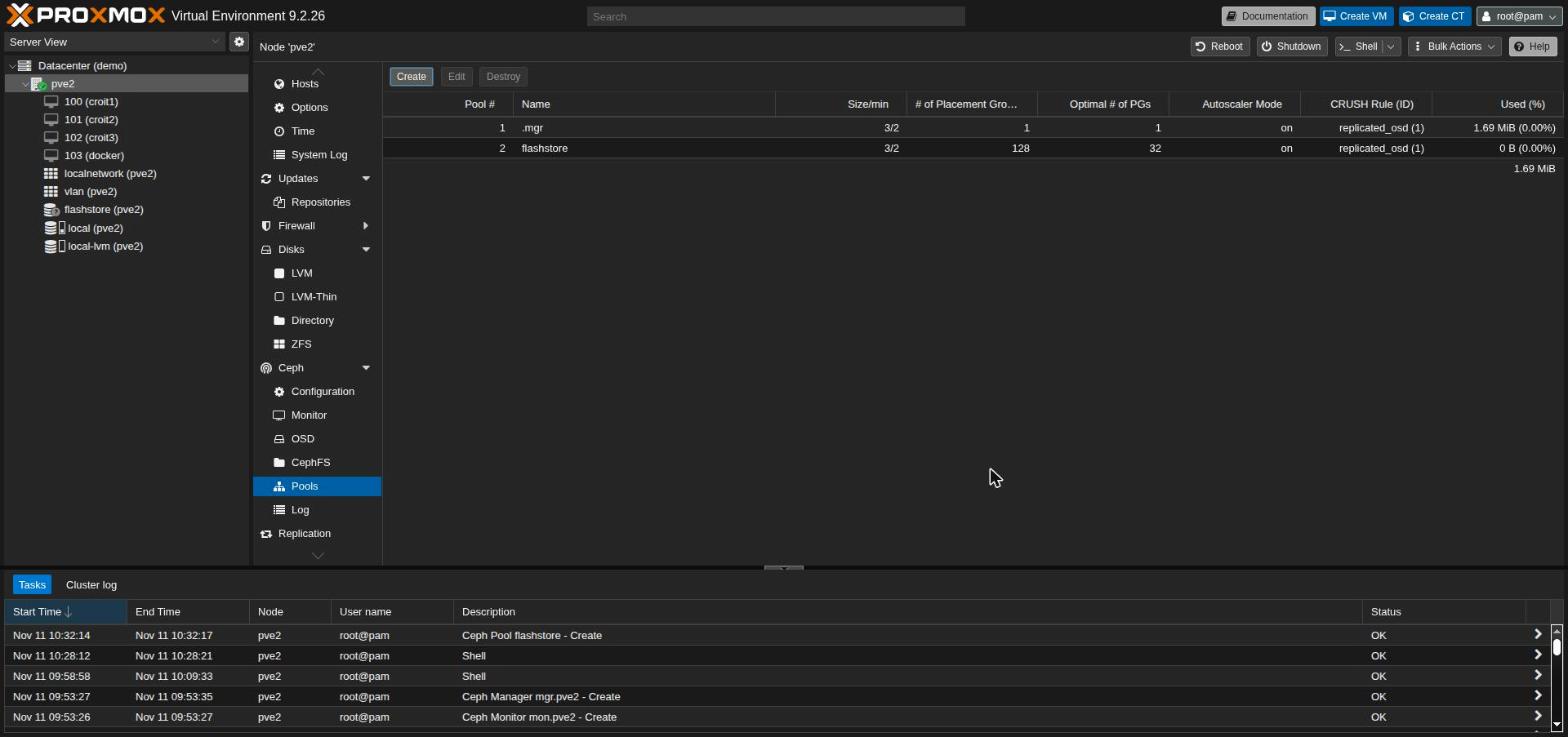
Proxmox utworzył pulę i definicję storage’u RBD za jednym zamachem, a flashstore pojawił się w drzewie z 654 GiB do użycia, czyli 2 TiB surowej pojemności podzielone przez trzy kopie, minus narzut.
129 PG przeszło w active+clean, a autoscaler wkrótce potem zmniejszył nową pulę ze 128 do 32.
Gość testowy to VM z Fisher-Price OS (Windows).
To nie jest preferencja, tylko to, co duża część klientów faktycznie uruchamia na swoich pulach Proxmoksa, więc to jest obciążenie, które się liczy: 16 GiB pamięci, 4 rdzenie, dysk 60 GiB na flashstore z włączonymi discard i iothread.
Jest też gadatliwy wobec dysku i nieefektywny, i o to chodzi: test storage’u chce gościa, który najmocniej opiera się na dysku.
Próbkowanie puli co dziesięć sekund przez pierwsze piętnaście minut instalacji:
| Zapisy do puli | mediana 9,3 MB/s w trakcie aktywności, szczyt 302 MB/s |
| Operacje zapisu | szczyt 2486 na sekundę |
| Odczyty z puli | szczyt 60 MB/s |
| Zajęte miejsce surowe | 35 GiB na sześciu OSD |
| Stan | HEALTH_OK we wszystkich 90 próbkach |
| Restarty OSD | 0 |
| Pamięć rezydentna OSD | od 565 do 871 MiB każdy po wszystkim |
To liczby instalatora, z VM i OSD na tym samym hoście i nietkniętymi ostrzeżeniami strojenia, i nic nie mówią o szybkości FlashStore. Mówią natomiast, że klasyczny klient Proxmoksa przeprowadził instalację systemu operacyjnego na OSD w Rust, 35 GiB surowo, bez usterki, a to jest teza, którą ten wpis miał sprawdzić.
Jak się sprawuje pod obciążeniem
Instalacja dowodzi, że działa. Nie mówi, jak się z tej VM korzysta.
Więc VM dostała CrystalDiskMark 9.0.321, trzy razy: profil Real World Performance [+Mix], Read&Write [+Mix], plik 16 GiB na C: i mieszanka 70/30 odczytów i zapisów, raz z trzema przebiegami i dwa razy z dziewięcioma. Ten profil robi wszystko po jednym żądaniu naraz w jednym wątku, czyli tak, jak faktycznie pracuje komputer biurkowy albo mała baza danych, a nie tak, jak karta katalogowa.
Do tego czasu konfiguracja odeszła już od tej z instalacji. VM miała sześć rdzeni, a pulę zmieniono w GUI na size 2, min size 1 i 256 PG. Size 2 z min size 1 to ustawienie laboratoryjne na jednej skrzynce: gdy zostaje jedna kopia, pula dalej przyjmuje zapisy, które pojedyncza awaria może potem stracić. Gdzie indziej trzymaj 3 i 2.
Dysk był na domyślnym ustawieniu Proxmoksa, bez cache, które jest domyślne od Proxmoksa 222.
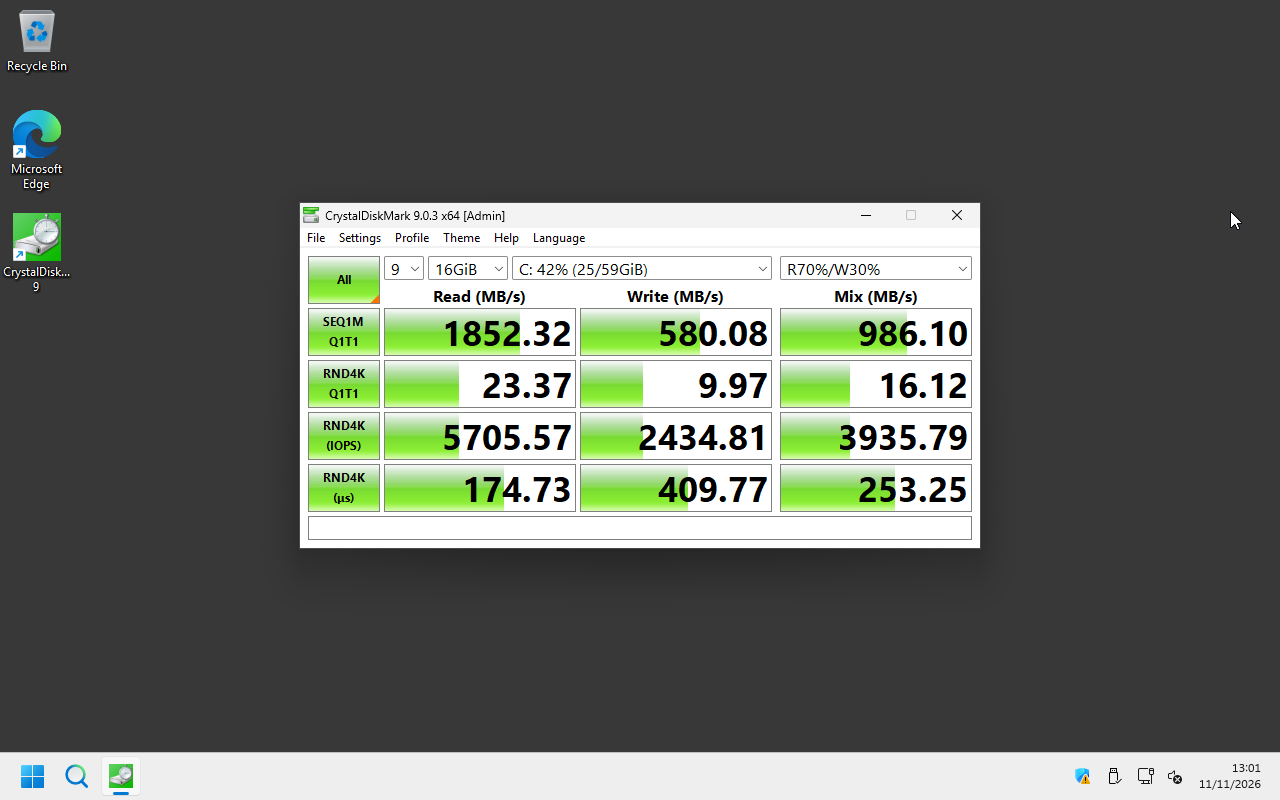
| Real World Performance [+Mix], 16 GiB | 3 przebiegi | 9 przebiegów | znowu 9 przebiegów |
|---|---|---|---|
| SEQ1M Q1T1 odczyt | 1279,71 MB/s | 1675,33 MB/s | 1852,32 MB/s |
| SEQ1M Q1T1 zapis | 563,67 MB/s | 576,65 MB/s | 580,08 MB/s |
| SEQ1M Q1T1 mieszanka | 1043,75 MB/s | 1043,28 MB/s | 986,10 MB/s |
| RND4K Q1T1 odczyt | 5342 IOPS, 186,57 µs | 5659 IOPS, 176,17 µs | 5706 IOPS, 174,73 µs |
| RND4K Q1T1 zapis | 2419 IOPS, 412,51 µs | 2405 IOPS, 414,79 µs | 2435 IOPS, 409,77 µs |
| RND4K Q1T1 mieszanka | 3938 IOPS, 253,13 µs | 3826 IOPS, 260,49 µs | 3936 IOPS, 253,25 µs |
Zapisy i opóźnienie małych bloków trzymają się w granicach około 1% między przebiegami. Odczyt sekwencyjny rośnie o 45% przez te trzy. To pierwszy znak, że kolumna odczytów nie mierzy tego, na co wygląda.
Host był próbkowany co pięć sekund przez wszystkie trzy, z /proc/diskstats dla ośmiu Optane’ów, ceph status dla puli i /proc dla każdego procesu i wątku, a oba widoki nie opowiadają tej samej historii.
Zapisy: dysk to ta mała część
| Jeden losowy zapis 4 KiB naraz, ostatni przebieg | |
|---|---|
| Czas na zapis widziany przez VM | 409,77 µs |
| Czas na zapis na każdym Optane | 17 µs |
| Zapisy docierające do Optane’ów na jeden zapis VM | 4,05: dwie kopie, mniej więcej po dwa zapisy |
| Duże zapisy sekwencyjne | 580 MB/s z VM, 1,14 GB/s na Optane’ach, druga kopia to podwaja |
Dysk to mniej niż 5% małego zapisu. Pozostałe 393 µs to droga: QEMU, librbd, messenger do OSD, sam OSD i czekanie na drugą kopię. Nic z tego nie było tu mierzone osobno, więc nie przypiszę liczby każdemu kawałkowi. Mówi to natomiast, że na tej skrzynce Optane’y nie są ograniczeniem dla I/O po jednym naraz, a szybszy dysk niewiele by te 410 ruszył. Ograniczenie przeszło na klienta, na librbd, które dostarcza Proxmox, i więcej będzie na ten temat, gdy wdrożę tu własny librustyrbd od croit.
Odczyty: cache, nie Optane’y
W ostatnim przebiegu przebieg losowych odczytów 4 KiB robił 5700 odczytów na sekundę na całym pliku 16 GiB, a osiem Optane’ów nie przeczytało zupełnie nic.
Przebieg sekwencyjny osiągnął 2,2 GB/s na puli, podczas gdy własne odczyty dysków spadły z 755 MB/s do zera.
CrystalDiskMark omija cache gościa, a dysk w QEMU żadnego nie ma, więc pamięć, która tu pracuje, jest w OSD.
flashstore_obj_cache jest w tej kompilacji domyślnie włączony, udział każdego OSD w pliku to przy size 2 około 2 GiB, a każdy OSD urósł do około 2,6 GiB.
FlashStore nie raportuje swoich trafień, więc nazwij to niemal pewnym, a nie dowiedzionym.
To też dlatego odczyt sekwencyjny rósł z każdym przebiegiem: coraz więcej pliku już tam było.
Traktuj kolumnę odczytów jako liczbę cache’u, nie magazynu.
CPU: dokąd poszły rdzenie
| Ostatni przebieg, w rdzeniach | Zajętość hosta | OSD | vCPU gościa | librbd i klient Ceph | QEMU |
|---|---|---|---|---|---|
| Bezczynność między przebiegami | 20 do 24% | 3,3 | 0,1 | 0,03 | 0,03 |
| Losowy zapis 4 KiB | 30% | 3,9 | 0,38 | 0,20 | 0,08 |
| Losowy odczyt 4 KiB | 30% | 3,6 | 0,47 | 0,39 | 0,15 |
| Mieszanka sekwencyjna | 41 do 53% | 3,8 | 1,5 do 2,3 | 0,5 | 0,12 |
Trzy kolumny VM pochodzą z jej wątków: QEMU nazywa vCPU gościa, a wątki messengera i workerów librbd działają w tym samym procesie.
Kolumna OSD prawie się nie rusza. Osiem odpytujących OSD kosztuje 3,3 rdzenia, gdy nic nie robią, i 3,9 na pełnych obrotach, więc na skrzynce z 16 wątkami piąta część CPU znika, zanim jakakolwiek VM o cokolwiek poprosi. Nic innego nie zbliżyło się do swojego limitu. Najbardziej zajęty pojedynczy wątek to vCPU gościa przy 47%, a najbardziej zajęty wątek librbd został poniżej 15%. Przy jednym żądaniu naraz ograniczeniem jest czekanie, nie praca, a liczba CPU nie pokaże czekania.
Pamięć: planuj pod szczyt
| We wszystkich trzech przebiegach | |
|---|---|
| Stan | HEALTH_OK w każdej próbce, każda PG active+clean, bez restartów OSD |
| Używane hugepages | 4 GiB od początku do końca |
| Pamięć hosta do rozdania, przy jednej działającej VM 16 GiB | od 3,1 do 4,0 GiB |
Wiersz hugepages to znowu sekcja o budżecie, tym razem pod obciążeniem: 512 MiB na OSD, a pozostałych 12 GiB nigdy nietkniętych.
Zwykła pamięć to liczba, której trzeba pilnować, bo z niej jest zrobiony cache opisany wyżej. Gdy odczyt wciągnął plik, każdy OSD stał na około 2,5 GiB, a tyle Ceph trzymał na hoście z 58,7 GiB:
| Pamięć Ceph w szczycie, domyślny cel 4 GiB | |
|---|---|
| Procesy OSD, wszystkie osiem razem | 19,9 GiB, od 2,4 do 2,6 GiB każdy |
| Hugepages zarezerwowane dla OSD | 16 GiB, z tego 4 GiB używane |
| Monitor i manager | 0,3 GiB |
| Razem | 36,2 GiB, 62% hosta |
| Zostało hostowi do rozdania, przy jednej działającej VM 16 GiB | 3,6 GiB |
Ta pamięć wraca, ale nie według żadnego harmonogramu, który byłbym w stanie dostrzec.
Trzymała się na 19,9 GiB przez 25 minut, łącznie z przerwami bezczynności, potem spadła do 13,9 GiB na koniec ostatniego przebiegu, a host znów miał 10,2 GiB do rozdania.
osd_memory_target stał przez cały ten czas na domyślnych 4 GiB na OSD, więc osiem OSD miało prawo do 32 GiB, zanim policzy się choćby jedną hugepage.
Na węźle, który ma też uruchamiać VM, to szczyt jest budżetem, który trzeba policzyć przed dyskami, i to tam 12 bezczynnych GiB hugepages boli najbardziej.
Trzy VM naraz, przy ciaśniejszym budżecie
Jedna VM zostawia mnóstwo miejsca. Przy trzech budżet musi być dobry. Więc najpierw zmieniły się dwa ustawienia.
ceph config set osd osd_memory_target 1073741824   # 1 GiB per OSD, was 4
sysctl -w vm.nr_hugepages=2048                     # what eight OSDs use, was 8192
Cel nie potrzebuje niczego więcej: każdy OSD zgłosił nową wartość w ciągu kilku sekund, a i tak restartowano je po jednym, ze wszystkimi 257 PG z powrotem w active+clean przed następnym.
Hugepages mają haczyk.
Przed każdym startem OSD croit-flashstore-prep chce mieć wolne całe --mem, 2048 MiB, i powiększa pulę, jeśli brakuje, ale nigdy jej z powrotem nie zmniejsza.
Restart osd.7 po przycięciu wyniósł pulę prosto z powrotem w górę:
croit-flashstore-prep[7]: hugepages 2048kB: free 256 < need 1024, nr_hugepages 2048 -> 2816
Więc dolna granica, która przetrwa restart OSD albo reboot, to tyle, ile OSD używają, plus zapas na jeden start: 2816 stron, 5,5 GiB, wobec 16 GiB, o które prosi kontrola. Skrypt instalacyjny dalej rezerwuje teraz dokładnie tyle. Przycięcie z powrotem do 2048, gdy wszystkie osiem już działa, daje kolejne 1,5 GiB do następnego restartu.
Potem trzy klony VM, po 10 GiB każdy, uruchomiły CrystalDiskMark w tej samej chwili: Real World Performance [+Mix], trzy przebiegi, ale na pliku 1 GiB każdy zamiast 16 GiB. To czyni kolumnę odczytów bardziej niż kiedykolwiek liczbą cache’u, więc czytaj zapisy.
| CrystalDiskMark, trzy VM naraz | VM 104 | VM 105 | VM 106 | Wszystkie trzy | Jedna VM sama |
|---|---|---|---|---|---|
| SEQ1M Q1T1 zapis | 346,99 MB/s | 318,99 MB/s | 446,98 MB/s | 1113 MB/s | 580,08 MB/s |
| SEQ1M Q1T1 odczyt | 796,05 MB/s | 905,03 MB/s | 1160,93 MB/s | 2862 MB/s | 1852,32 MB/s |
| RND4K Q1T1 zapis | 1901 IOPS | 1928 IOPS | 1862 IOPS | 5691 IOPS | 2435 IOPS |
| RND4K Q1T1 opóźnienie zapisu | 524,56 µs | 517,00 µs | 535,42 µs | 409,77 µs | |
| RND4K Q1T1 odczyt | 3773 IOPS | 3916 IOPS | 3909 IOPS | 11 598 IOPS | 5706 IOPS |
| RND4K Q1T1 mieszanka | 2978 IOPS | 3027 IOPS | 3411 IOPS | 9416 IOPS | 3936 IOPS |
Trzy VM dostały 2,3 raza więcej małych zapisów niż jedna, a każda zapłaciła za to około 27% opóźnienia. Optane’y wciąż nie były przyczyną. W szczycie robiły 20 900 zapisów na sekundę po 17 µs każdy, te same 17 µs co przy jednej VM, a najbardziej zajęty z ośmiu był zajęty w 14%.
| Host, co pięć sekund przez cały przebieg | Domyślny cel 4 GiB, jedna VM | Cel 1 GiB, trzy VM |
|---|---|---|
| Największy proces OSD | 2,7 GiB | 1,15 GiB w szczycie, 0,8 po |
| Osiem procesów OSD razem | 19,9 GiB | 8,0 GiB w szczycie, 5,8 po |
| Zarezerwowane hugepages | 16 GiB, 4 używane | 4 GiB, wszystkie używane |
| Pamięć przydzielona VM | 16 GiB | 30 GiB |
| Pamięć hosta do rozdania, w najniższym punkcie | 3,1 GiB | 14,8 GiB |
| Przyrost swapu | brak | brak |
Więc FlashStore rzeczywiście trzyma się osd_memory_target.
Przekroczył go o 15% w szczycie przebiegu odczytu i wrócił poniżej, a cache robił swoje wewnątrz budżetu, a nie poza nim.
Między celem a przycięciem 26 GiB wróciło do VM na tej samej skrzynce.
| CPU w rdzeniach, trzy VM | Zajętość hosta | OSD | Goście | librbd i klient Ceph | QEMU |
|---|---|---|---|---|---|
| Trzy rozruchy Fisher-Price OS (Windows) | 81 do 89% | 3,4 do 3,6 | 6,3 do 7,9 | 0,4 do 0,7 | 0,3 |
| Benchmark | 42 do 73% | 3,7 do 4,5 | 1,2 do 4,0 | 0,4 do 1,6 | 0,2 do 0,4 |
| Bezczynność potem | 20 do 24% | 3,3 | 0,3 | 0 | 0 |
Rozruch trzech gości zmęczył CPU bardziej niż ich benchmark. Storage pod spodem nawet się do tego nie zbliżył, a to minikomputer wyznacza granicę, jak zawsze miało być.
Wszystko w jednym skrypcie
Wszystko, co powyżej, jest w jednym skrypcie. Daj mu adresy PCI dysków, które chcesz mieć jako OSD, a zrobi resztę, w kolejności, w jakiej zrobił to ten wpis, z dwiema poprawkami dla Proxmoksa wbudowanymi.
flashstore-pve-setup.sh: OSD FlashStore na węźle Proxmox VElspci -D -d ::0108 # find the drives
bash flashstore-pve-setup.sh --dry-run 0000:05:00.0 # show the plan, change nothing
bash flashstore-pve-setup.sh 0000:05:00.0 0000:06:00.0
| Sprawdza | Zapisuje | Uruchamia |
|---|---|---|
| Proxmox VE 9 i Ceph 21.2.0 Umbrella | keyring bootstrap-osd | odczyt przez passthrough jako ceph, żeby wybrać kernel-cmd albo kernel |
| każdy dysk: NVMe, bez cache zapisu, niezamontowany, bez partycji, niezajęty | drop-in najpierw root, potem --setuser | prepare i systemctl enable --now dla każdego dysku |
| brak danych w obszarach, które czyta sonda FlashStore | regułę udev dla każdego dysku, dopasowaną po numerze seryjnym | kontrolę hosta, zatrzymując się tylko na tym, czego potrzebują OSD |
| bloki 4 KiB | jedną sekcję [osd.N] na dysk, po jednym fizycznym rdzeniu | pobranie pakietu, sprawdzone z SHA-256 wydania |
Nic nie zostaje zniszczone, jeśli o to nie poprosisz.
--format-4k formatuje dysk, który nie jest w 4 KiB, po jednym, każdy we własnym unicie, żeby nic go nie przerwało, a --wipe pozwala nadpisać dysk, na którym są dane.
--single-node dodaje regułę replicated_osd, a ponowne uruchomienie pomija dyski, które już są OSD.
Był tu przetestowany, nie tylko napisany.
Odrzucił SN750 przez jego cache zapisu, odrzucił dysk osd.7, dopóki był na nim magazyn, a potem, gdy osd.7 został usunięty, a jego węzły oddane z powrotem rootowi, odbudował go od zera w 10,5 sekundy, sam wybierając backend kernel.
Czego nie zrobi, to instalacja Ceph.
Ten krok prosi cię o zaakceptowanie Technology Preview, a to twoja decyzja, nie skryptu.
Co trzeba poprawić
Nic z tego nie zatrzyma zdeterminowanego administratora, a wszystko to zatrzyma zapracowanego. Każdy punkt to stwierdzenie, które croit składa każdemu, kto pobiera pakiet, i na każdy trafiłem przy pierwszej próbie.
| Gdzie | Co się dzieje | Co by to naprawiło |
|---|---|---|
| unit systemd | User=ceph nie może czytać pmxcfs, więc OSD nigdy nie startuje na węźle pveceph | dostarczyć start najpierw jako root, potem --setuser, albo drop-in dla Proxmoksa |
| mechanizm zapasowy kernel-cmd | przełącza się tylko, gdy Identify zostanie odrzucone; na jądrze PVE odrzucany jest Read i OSD staje | przechodzić na bezpośrednie I/O przy każdym odrzuconym I/O przez passthrough |
| udev | dokumentacja wymaga reguły dającej ceph węzły przestrzeni nazw; żadna nie jest dostarczana | dostarczyć taką, opartą o skonfigurowane urządzenia |
podsumowanie --check | mówi, że NVMe w jądrze jest „compiled out”, a to jedyna wkompilowana ścieżka magazynu | poprawić etykietę |
kod wyjścia --check | rozruchowy SSD oblewa test PLP, więc 0 jest nieosiągalne | oceniać tylko urządzenia skonfigurowane lub kandydujące |
| hugepages | 2048 MiB na OSD, a prep chce tyle wolnego przy każdym starcie; backend jądra używa 512 | wymiarować backend jądra według tego, czego używa, i pozwolić prep prosić o to samo |
sha256sums.txt | nazwy plików nie zgadzają się z zasobami wydania | nazywać je tak, jak są opublikowane |
| nazwa pakietu | dokumentacja mówi apt remove flashstore; pakiet to croit-flashstore-osd | jedna nazwa albo ta właściwa w dokumentacji |
opis flashstore_dev | wymienia tylko spdk: i file: | udokumentować kernel: oraz spdk: z backendem jądra |
Nic z tego nie jest nową pracą. Demon ma już zejście z uprawnień, bezpośredni backend i logikę zapasową. Po prostu nie zostały połączone dla platformy, na której większość ludzi spróbuje go najpierw.
Wersja zapoznawcza jest po to, żeby się tego dowiedzieć
Wersja zapoznawcza to właściwe miejsce na każde z tych znalezisk i niewłaściwe miejsce, żeby je zostawić. Po to właśnie jest: ktoś zabiera ją do domu, stawia na sprzęcie, który faktycznie ma, i zapisuje, gdzie się wywraca. Części, które się liczą, wytrzymały. Magazyn wstał w milisekundy, OSD dołączyły do klastra zbudowanego cudzymi narzędziami, a instalacja systemu operacyjnego poszła na nie bez usterki.
Potknęło się wszystko wokół demona. Plik konfiguracji na systemie plików, którego unit nie mógł czytać, jądro, które mówi „nie” wywołaniu dozwolonemu przez upstream, dysk rozruchowy, którego kontrola nie chciała przestać liczyć. Nic z tego nie jest trudne. Wszystko to jest różnicą między oprogramowaniem, które działa, a oprogramowaniem, które działa na twojej skrzynce, a jedyny sposób, żeby ją zamknąć, to testować na skrzynkach, które ludzie mają, a nie na tych, które się do tego zbudowało.
Przy tym wszystkim to obiecujący początek. Na marnym minikomputerze, z klasycznym librbd po stronie klienta i wszystkimi ośmioma dyskami na jednym łączu PCIe 3.0, Optane’y pracują tu ciężej niż pod BlueStore. W miarę rozwoju wrócę do tego i zakopię się głębiej, gdy kolejne części stosu zostaną wymienione, i przyjrzę się też CephFS2.
„Drop-in” to obietnica złożona administratorowi, który nie ma czasu czytać źródeł. Monitory Proxmoksa, GUI Proxmoksa, jądro Proxmoksa i pakiet od kogoś innego to dokładnie sytuacja, dla której ta obietnica istnieje. Teraz prawie jej dotrzymuje. Dziewięć drobnych poprawek i dotrzyma, a ja wolę być tym, kto znalazł je w środę rano, niż klientem, który znajdzie je w piątek wieczorem.
croit/ceph-rust README — publiczna wersja zapoznawcza od 9 listopada 2026, „not yet recommended for production data”, wymagania, szybki start, produkcyjny zestaw funkcji, przetestowany commit Ceph. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
croit/ceph-rust release snapshot-2026-11-10 — użyte tu pakiety, w tym
flashstore_…_debian-trixie_amd64.debisha256sums.txt. ↩︎ ↩︎croit/ceph-rust — hardware requirements — sprawdzenie ulotnego cache zapisu, hugepages, uwagi o wersji jądra. ↩︎
croit/ceph-rust — branches and versions —
mainceluje w v21.2.0,v20.2.4w v20.2.4; „The daemon refuses a cluster release outside its supported window.” ↩︎ ↩︎Proxmox pve-manager, PVE/Ceph/Releases.pm —
umbrellawymieniony zrelease => '21.2'iunsupported => 1. ↩︎croit/ceph-rust — build and install packages — dystrybucje, glibc 2.34, obsługa
ceph-osd.target, liniaapt remove. ↩︎ ↩︎ ↩︎croit/ceph-rust — configuration reference —
flashstore_dev,flashstore_lcores,flashstore_report_objectstorei dlaczego domyślnie tobluestore. ↩︎ ↩︎croit-flashstore-osd Cargo.toml — linia 29,
knet = [… "kernel-nvme"]. ↩︎croit/ceph-rust — first OSD tutorial — kontrola hosta tylko do odczytu; „Exit 0 means no FAIL.” ↩︎ ↩︎
croit/ceph-rust — ADR 0169, kernel NVMe backend — dwa tryby jądra, zmierzone porównanie, budżet alokatora ładunku, rozwiązywanie adresów
spdk:i mechanizm zapasowy tylko dla Identify (poprawka 6). Dodany do repozytorium tego samego wieczoru co wydanie. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎Proxmox VE — Proxmox Cluster File System (pmxcfs) — klastrowy system plików pod
/etc/pvei jego stałe właściciele i uprawnienia. ↩︎croit-flashstore-osd@.service —
User=ceph,ExecStartPre=… activateiCapabilityBoundingSetbezCAP_DAC_OVERRIDE. ↩︎ ↩︎croit-flashstore-osd privdrop.rs — klasyczne zejście z uprawnień przez
--setuser/--setgroup. ↩︎croit/ceph-rust — prepare the host — „the namespace node must be readable and writable by user
ceph(udev rule)”. ↩︎Linux v7.0, drivers/nvme/host/ioctl.c —
nvme_cmd_allowed(), reguła dla nieuprzywilejowanego passthrough NVMe. ↩︎croit/ceph-rust — security — „
preparedefaults--keyringto/var/lib/ceph/bootstrap-osd/<cluster>.keyring”. ↩︎croit/ceph-rust — prepare, activate and list — sonda niepustego urządzenia i
--wipe. ↩︎Proxmox pve-manager, PVE/API2/Ceph/OSD.pm —
osdtypetobluestoretylko wtedy, gdy metadane zawierająbluefs, w przeciwnym raziefilestore. ↩︎Proxmox pve-manager, PVE/Ceph/Services.pm —
ceph_service_cmd()mapujeosd.Nna unit systemdceph-osd@N. ↩︎Ceph documentation — CRUSH maps — reguły replikacji, domeny awarii i klasy urządzeń. ↩︎
CrystalDiskMark — benchmark dysków od Crystal Dew World; „Various measure mode (Peak/Real World/Demo)”. ↩︎
Proxmox VE wiki — Performance Tweaks — tryby cache dysku: „cache=none seems to be the best performance and is the default since Proxmox 2.X”. ↩︎