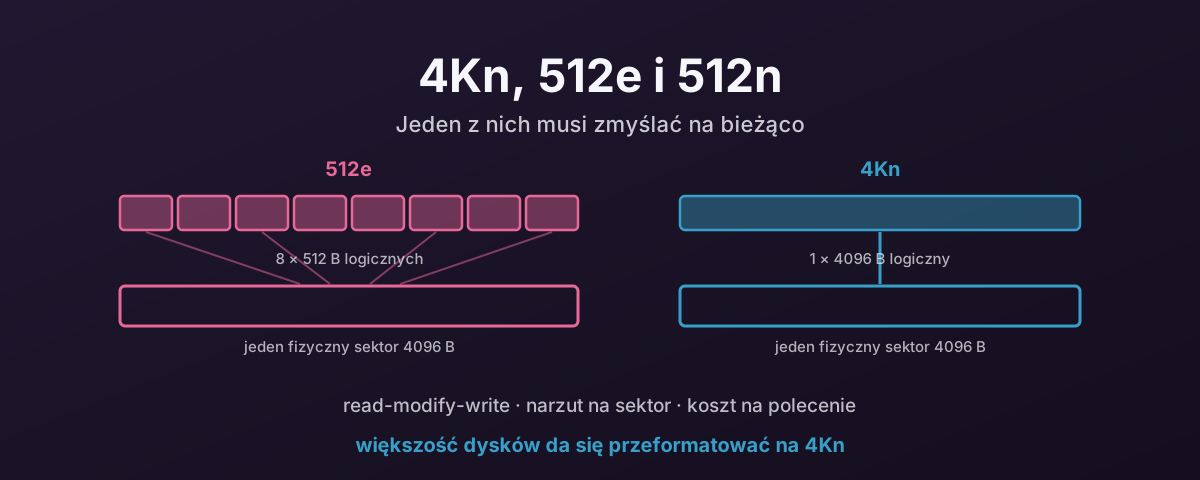
Trzy sposoby, w jakie dysk może się przedstawić
Dysk ma dwa rozmiary bloku, a różnica między nimi to cała historia.
Sektor fizyczny to jednostka, w której naprawdę pracuje nośnik: najmniejsza porcja, którą dysk może odczytać albo zapisać bez dodatkowej roboty. Blok logiczny to jednostka, w której według tego, co dysk mówi hostowi, pracuje: jednostka, którą adresuje host.
W praktyce spotyka się trzy kombinacje.
512n: natywne 512. Oba rozmiary to 512 bajtów. To stary świat: dyski twarde sprzed 2010 roku i nic, co kupiłbyś dziś nowe w jakimkolwiek rozmiarze wartym posiadania.
512e: emulacja 512 bajtów. Sektor fizyczny ma 4096 bajtów, ale dysk zgłasza 512-bajtowe bloki logiczne i tłumaczy w firmware. Istnieje z jednego powodu: zgodności z systemami operacyjnymi, programami rozruchowymi i aplikacjami, które założyły 512 na zawsze. Jako inżynieria dość rozsądne, i źródło niemal wszystkich kłopotów, które następują dalej.
4Kn: natywne 4K. Oba rozmiary to 4096 bajtów. Dysk mówi prawdę, host adresuje go w jednostce, której używa nośnik, i pomiędzy nimi nie siedzi żadna warstwa translacji.
Co robi 512e przy każdym niewyrównanym zapisie
Odczyt jest tani we wszystkich trzech przypadkach. Dysk czyta sektor 4K i oddaje ten 512-bajtowy kawałek, o który prosiłeś.
Fikcja robi się droga przy zapisach.
Jeśli host zapisze pojedynczy 512-bajtowy blok logiczny, dysk nie może zapisać 512 bajtów. Nośnik nie ma takiej jednostki. Robi więc zamiast tego to:
- Odczytuje cały 4096-bajtowy sektor fizyczny.
- Wplata w niego 512 bajtów nowych danych.
- Zapisuje cały 4096-bajtowy sektor z powrotem.
To jest read-modify-write, i zamienia jeden mały zapis w odczyt plus zapis. Na dysku obrotowym oznacza to czekanie, aż talerz znów obróci się na miejsce. Pełny obrót przy 7200 obr./min to coś koło 8 ms, których nie miałeś w budżecie. Na flashu koszt jest innego rodzaju i nie znika, gdy zapis się skończy. Ten ma własną sekcję poniżej.
Brak wyrównania to wersja, która gryzie najmocniej. Jeśli partycja zaczyna się od nieparzystego przesunięcia o 512 bajtów, a klasycznym przykładem jest stara konwencja 63 sektorów, to każdy 4K zapis systemu plików przechodzi przez dwa sektory fizyczne. To nie jest jeden read-modify-write, tylko dwa, przy każdym pojedynczym zapisie, na zawsze, dopóki ktoś nie przepartycjonuje dysku.
Wzmocnienie zapisu na flashu
Na dysku twardym read-modify-write kosztuje cię obrót i na tym koniec. Na flashu kosztuje cię żywotność dysku, a to rachunek, który płacisz raz i płacisz dalej.
Wzmocnienie zapisu (write amplification) to stosunek tego, co naprawdę zostało zapisane do NAND, do tego, o co poprosił host. Stosunek 1,0 oznaczałby, że dysk zapisał dokładnie to, co dostał. Nigdy nie wynosi 1,0, bo flash nie umie nadpisywać w miejscu: dysk programuje świeżą stronę, oznacza starą jako nieaktualną, a odśmiecanie później przenosi ocalałe strony, żeby dało się wymazać cały blok. Te przeniesienia to też zapisy.
512e dokłada do tego warstwę, której dałoby się uniknąć, a powód to szczegół, który warto powiedzieć jasno: warstwa translacji dysku odwzorowuje w jednostkach około 4 KB, niezależnie od tego, jaki rozmiar bloku logicznego ogłasza. Dysk zgłaszający 512-bajtowe bloki wewnętrznie i tak śledzi jednostki 4 KB.
512-bajtowy zapis z hosta staje się więc wewnątrz dysku czymś takim: odczytaj jednostkę odwzorowania 4 KB, wpleć 512 bajtów, zaprogramuj nową jednostkę 4 KB. Do NAND trafia 4096 bajtów, żeby mogło się zmienić 512. Osiem razy więcej zapisu, dla tego jednego zapisu.
Brak wyrównania jest mniej dramatyczny na pojedynczy zapis i gorszy w sumie. Zapis 4 KB, który przechodzi przez dwie jednostki odwzorowania, brudzi obie, więc dla 4 KB danych programowane jest 8 KB. To 2× wzmocnienia przy każdym pojedynczym zapisie, na stałe, dopóki tablica partycji nie zostanie poprawiona.
To skutki uboczne sprawiają, że ma to znaczenie, a nie jest tylko nieporządkiem:
- Więcej zapisów do NAND oznacza, że odśmiecanie uruchamia się częściej, a jego przeniesienia same w sobie są wzmocnieniem.
- Pamięć podręczna zapisu SLC zapełnia się szybciej, więc dysk wcześniej spada do wolniejszego stanu ustalonego, a przepustowość ciągłego zapisu maleje.
- Cykle programowania i kasowania zużywają się proporcjonalnie do tego, co dotarło do NAND, a nie do tego, co wysłał host. Podwój wzmocnienie, a przy tym samym obciążeniu skrócisz żywotność dysku o połowę.
- Parametry wytrzymałości, TBW i DWPD, podaje się względem zapisów hosta. Wzmocnienie po cichu zjada ten margines, a dysk zużywa się przed terminem, który wyszedł ci z rachunku gwarancyjnego przy zakupie.
Bezpośrednie i synchroniczne zapisy to najgorszy przypadek
Przez większość czasu pamięć podręczna stron ukrywa to wszystko. Jądro zbiera małe zapisy, scala je i wysyła do dysku IO o rozmiarze 4 KB lub większym, więc read-modify-write nigdy nie zachodzi.
Dwie flagi usuwają tę ochronę, a aplikacje, którym zależy na trwałości, ustawiają obie.
O_DIRECT omija pamięć podręczną stron.
Między aplikacją a dyskiem nie ma już nic, co mogłoby scalić 512-bajtowy zapis w coś o rozmiarze sektora.
O_SYNC albo O_DSYNC wymaga, żeby zapis był na trwałym nośniku, zanim wywołanie wróci.
To nie pozwala dyskowi wchłonąć zapisu do ulotnego bufora i połączyć go później z sąsiadami.
Połącz je, a każdy 512-bajtowy zapis to pełny cykl read-modify-write, który musi się zakończyć teraz, sam, bez niczego, na co dałoby się rozłożyć jego koszt. Tam właśnie wzmocnienie na dysku 512e zbliża się do teoretycznych 8×, i dokładnie taki wzorzec wytwarza dziennik zatwierdzeń bazy danych, ZIL w ZFS albo WAL w Ceph BlueStore.
Ratunkiem na sprzęcie klasy enterprise jest ochrona przed utratą zasilania. Dysk z PLP może potwierdzić zapis synchroniczny, gdy tylko ten trafi do bufora DRAM podtrzymywanego kondensatorami, który jest trwały, i wciąż scalać wewnętrznie przed zaprogramowaniem NAND. Dysk konsumencki bez PLP musi dotrzeć do flasha, zanim wolno mu odpowiedzieć, więc płaci pełny koszt za każdy zapis. Jeszcze jeden powód, dla którego PLP nie jest opcjonalne przy tego rodzaju obciążeniu.
W Proxmoxie to tryb pamięci podręcznej decyduje, który z tych przypadków dostajesz:
cache=nonetoO_DIRECT: domyślne ustawienie PVE i właściwy wybór dla HA w całości na flashu. Pamięć podręczna stron hosta jest poza ścieżką, więc wzorce zapisu gościa docierają do dysku tak, jak gość je wysłał.cache=directsynctoO_DIRECTplusO_DSYNC: każdy zapis jest synchroniczny. To niszowe ustawienie dla dysków przeznaczonych na dzienniki baz danych i bezużyteczne przy ogólnych obciążeniach.
Na urządzeniu bazowym 512e cache=directsync z gościem zatwierdzającym w 512-bajtowych rekordach to mniej więcej najmniej wydajny dostępny układ: brak scalania w hoście, brak scalania w dysku i read-modify-write przy każdym zatwierdzeniu.
A oto część, która sprawia, że 4Kn jest kwestią struktury, a nie tylko preferencji.
O_DIRECT wymaga, żeby przesunięcie, długość i bufor były wyrównane do logicznego rozmiaru bloku dysku.
Na dysku 512e to 512 bajtów, więc 512-bajtowy zapis bezpośredni jest dozwolony, a dysk po cichu za niego płaci.
Na 4Kn blok logiczny ma 4096, więc najmniejszy zapis bezpośredni, jaki przyjmie jądro, to 4 KB.
Patologiczny wzorzec przestaje być czymś, czego musisz unikać, i staje się czymś, czego stos nie potrafi wyrazić.
Narzut na nośniku
Drugi koszt jest strukturalny i to on jest powodem, dla którego Advanced Format w ogóle istnieje.
Sektor to nie tylko jego dane. Na dysku twardym każdy niesie znacznik synchronizacji, żeby głowica wiedziała, gdzie sektor się zaczyna, przerwę, żeby kolejne sektory na siebie nie wpadały, znacznik adresu i pole ECC do korygowania błędów odczytu.
Przy 512-bajtowych sektorach płacisz za to wszystko osiem razy na każde 4K danych. Przy jednym sektorze 4K płacisz raz.
Ma to dwie konsekwencje, a druga liczy się bardziej niż pierwsza:
- Część talerza, która była narzutem, staje się użyteczną pojemnością. To była deklarowana przez branżę motywacja w czasie przejścia na Advanced Format, rzędu niskich jednocyfrowych procentów.
- Pole ECC może być znacznie większe przy tym samym łącznym narzucie. Jeden silny kod chroniący 4096 bajtów koryguje dużo więcej niż osiem słabych kodów chroniących po 512 bajtów. Gdy gęstość zapisu rosła, przestało to być miłym dodatkiem i stało się jedynym sposobem na utrzymanie akceptowalnego poziomu błędów.
Flash nie ma znaczników synchronizacji ani przerw obrotowych, ale ta sama logika działa poziom wyżej: NAND programuje się stronami, strony są dużo większe niż 512 bajtów, a tablice odwzorowania dysku mają wpis na każdą adresowalną jednostkę. Mniejsze bloki logiczne oznaczają więcej metadanych do śledzenia tej samej pojemności.
Narzut w hoście: polecenia i przerwania
Trzeci koszt to ten, który ludzie przeoczają, bo w ogóle nie leży na dysku.
Logiczny rozmiar bloku wyznacza podłogę dla tego, jak małe może być IO. Na dysku z 512-bajtowym blokiem logicznym system plików albo aplikacja mogą swobodnie wysłać 512-bajtowy zapis, a każdy z nich to pełne IO: polecenie zbudowane i wysłane, zapis do rejestru doorbell, wpis w kolejce zakończeń i przerwanie, które mówi, że się skończyło.
Każde z nich ma stały koszt, którego nie obchodzi, ile danych w tym było. Przenieś 4KB jako osiem 512-bajtowych poleceń, a zapłacisz ten koszt osiem razy. Przenieś to jako jedno polecenie 4K, a zapłacisz raz.
Dwa uczciwe zastrzeżenia, bo w tym miejscu argument zwykle bywa przesadzony.
Przy dużym IO logiczny rozmiar bloku nie zmienia nic w liczbie poleceń. Jedno polecenie może opisać wiele bloków, więc sekwencyjny zapis 1MB to jedno polecenie, niezależnie od tego, czy bloki mają 512 bajtów, czy 4K. Oszczędność jest realna tylko tam, gdzie wysyłane jest małe IO.
Tam jednak, gdzie małe IO jest wysyłane, efekt nie jest subtelny: każde z tych ośmiu żądań to takie, które jądro musi zbudować, zaplanować i zakończyć, każde z własnym przerwaniem MSI-X i przejściem z przestrzeni użytkownika do jądra, a przy dużych głębokościach kolejki tak właśnie dostajesz burzę przerwań. Wewnątrz VM jest jeszcze gorzej, bo każde z tych przerwań to także przełączenie kontekstu gościa.
A współczesne kontrolery NVMe scalają przerwania, więc liczba przerwań nie równa się po prostu liczbie poleceń. Praca na wysłanie i zakończenie każdego polecenia jednak zostaje, a przy kilkuset tysiącach IOPS koszt CPU na polecenie to mierzalny ułamek rdzenia. To ta sama arytmetyka co przy przerwaniach typu posted w serii o passthrough: małe stałe koszty pomnożone przez bardzo dużą liczbę.
4Kn, metadane sektorów i sprzętowy RAID
Przejście na format 4096 + 0 ma konsekwencję, która zaskakuje ludzi, i spada ona prosto na sprzętowy RAID.
Niektóre kontrolery RAID i macierze w ogóle nie używają zwykłych sektorów 512- czy 4096-bajtowych. Formatują dyski do rozszerzonego rozmiaru, 520 albo 528 bajtów, albo odpowiedników 4K jak 4104, 4160 i 4224, bo w tych dodatkowych bajtach na sektor kontroler trzyma własne metadane. To informacje ochronne T10-PI/DIF albo dane integralności producenta, przechowywane razem z danymi, które opisują.
Format 4096 + 0 nie ma ich gdzie położyć. Sektor to dane od początku do końca, i właśnie po to się go wybiera.
Kontroler, który chce metadanych w sektorze, ma więc trzy opcje, i żadna nie jest za darmo:
- Odrzucić dysk.
- Sformatować go z powrotem do formatu rozszerzonego, cofając robotę z 4Kn, którą właśnie wykonałeś.
- Trzymać metadane gdzie indziej na dysku.
Trzecia to ta, za którą karze cię flash. Metadane zapisane osobno od danych, które opisują, to drugi zapis, pod innym przesunięciem, lądujący w innej jednostce odwzorowania. Kolejna strona NAND zaprogramowana na każdą, którą naprawdę chciałeś zapisać. To wzmocnienie z sekcji wyżej, wprowadzone z powrotem celowo, żeby nieść metadane integralności, które dysk mógłby trzymać w sektorze za darmo, gdybyś zostawił go w formacie rozszerzonym.
Nie da się mieć obu. Albo sektor niesie metadane kontrolera, albo tylko twoje dane.
I dlatego flash mocno podkopał sens sprzętowego RAID-u
Reszta to ocena, a nie mechanizm, więc tak to traktuj.
Sprzętowy kontroler RAID to firmware’owy RAID działający na dedykowanym procesorze. „Sprzęt” to CPU, trochę DRAM i bateria. Nie jakiś zasadniczo inny sposób liczenia parzystości. Historycznie kupowałeś dzięki niemu pamięć podręczną zapisu podtrzymywaną baterią i odciążenie z liczenia parzystości, a na flashu oba argumenty mocno osłabły. Enterprise NVMe ma już własną pamięć podręczną chronioną przed utratą zasilania, a kontroler staje się sufitem przepustowości przed urządzeniami, z których każde potrafi nasycić kilka gigabajtów na sekundę.
Kosztuje cię też rzeczy, których teraz aktywnie chcesz:
- Stan urządzenia znika. Szczegóły SMART, wskaźniki zużycia i logi producenta, z których da się policzyć wzmocnienie zapisu, są schowane za nieprzejrzystą abstrakcją.
- Brak sum kontrolnych od końca do końca. Kontroler sprawdza parzystość, która wykrywa brakujący dysk, a nie złą odpowiedź od obecnego. ZFS i Ceph liczą sumy kontrolne samych danych i potrafią powiedzieć, która kopia jest zła; ciche uszkodzenie kontroler przepuszcza prosto dalej. W związku z tym kontroler rozwiązuje niewłaściwy problem.
- Metadane producenta na dyskach wiążą macierz z rodziną kontrolerów, co samo w sobie jest rodzajem zawodności, gdy to kontroler pada.
- RAID z parzystością robi własny read-modify-write przy zapisach częściowych pasów, nakładając się na wszystko z sekcji wyżej.
Dla Ceph to nawet nie jest kwestia preferencji. Własne wytyczne Proxmoxa dla hiperkonwergencji mówią, że dyski muszą być wystawione w trybie HBA lub pass-through, a nie za kontrolerem RAID, a ZFS chce dokładnie tego samego z tych samych powodów.
Układ, który z tego wszystkiego wynika, to: HBA zamiast kontrolera RAID, dyski sformatowane jako 4Kn z zerem metadanych, a redundancja i sumy kontrolne po stronie ZFS albo Ceph, które naprawdę potrafią ci powiedzieć, kiedy dysk skłamał. Jeśli coś w twojej infrastrukturze naprawdę potrzebuje rozszerzonego formatu sektora, to świadomy wybór albo-albo, do rozstrzygnięcia, póki dyski są jeszcze puste. Nie coś do odkrycia po zbudowaniu OSD.
Gdzie 512e naprawdę gryzie
Byłoby nieuczciwie twierdzić, że 512e rujnuje nowoczesny system, bo zwykle tak nie jest.
Obecny stos linuksowy odczytuje fizyczny rozmiar sektora, wyrównuje do niego partycje (parted i sfdisk robią to dziś domyślnie) i używa bloków systemu plików 4K.
W takiej konfiguracji host wysyła wyrównane IO 4K, dysk nigdy nie potrzebuje read-modify-write, a 512e kosztuje cię prawie nic.
Problemy są konkretne:
- Niewyrównane partycje, zwykle odziedziczone po starej instalacji albo sklonowanym obrazie. Dwa read-modify-write przy każdym zapisie.
- ZFS z
ashift=9na dysku 512e, bo ZFS uwierzył w zgłoszone 512. Każdy zapis rekordu staje się read-modify-write, aashiftnie da się zmienić po fakcie: pulę trzeba przebudować. - Aplikacje, które zapisują 512-bajtowe rekordy z O_DIRECT, omijając scalanie w pamięci podręcznej stron. Robią tak niektóre bazy danych i mnóstwo oprogramowania pisanego na zamówienie.
- Wszystko, co ufa, że rozmiar logiczny jest tym prawdziwym. To właściwa szkoda emulacji: rozdaje liczbę, która jest błędna, a rzeczy dalej w łańcuchu podejmują na jej podstawie decyzje.
4Kn usuwa całą tę kategorię. Dysk nie może kłamać o rozmiarze sektora, którego nie ma.
Warto jednak powiedzieć uczciwie, ile jest do wygrania. Własne wytyczne Seagate’a mówią, że 4Kn wyraźnie warto gonić, gdy stos jest w pełni zoptymalizowany pod 4K, a ty liczysz każdy IOPS, na przykład w dostrojonej warstwie w całości na flashu. Poniżej tego, na poprawnie wyrównanym nowoczesnym Linuksie, różnica wydajności dla wyrównanego IO często jest niewielka. Drugi argument to spójność floty: jednolicie 4Kn-owa infrastruktura nie ma w sobie niespodzianek z mieszanymi formatami i nikt nie musi pamiętać, które dyski kłamią.
Większość dysków da się przekonwertować, jeśli pozwala producent
To część, którą się przeocza: 512e to często ustawienie formatu, a nie właściwość sprzętu. Bardzo wiele dysków SAS i SATA klasy enterprise oraz większość enterprise NVMe wychodzi z fabryki, zgłaszając 512 bajtów, i chętnie da się przeformatować na 4Kn.
Wszystko poniżej niszczy każdy bajt na urządzeniu. Nie ma konwersji w miejscu.
NVMe: nvme-cli
Najpierw zobacz, co obsługuje przestrzeń nazw:
# Lists each LBA format and marks which one is in use
nvme id-ns -H /dev/nvme0n1 | grep -i "lbaf\|data size"
Chcesz format z Data Size 4096 i Metadata Size 0, oznaczony jako best i obecnie nieużywany. Potem go zastosuj:
# -l/--lbaf selects the LBA format index from the list above
nvme format /dev/nvme0n1 --lbaf=1 --force
Rozmiar metadanych liczy się tak samo jak rozmiar danych. Niektóre formaty fabryczne rezerwują dodatkowe bajty na sektor, 520 albo 4160, żeby nieść metadane ochronne T10-PI/DIF od końca do końca. Jeśli nic w twoim stosie ich nie konsumuje, to wypełniacz w każdym sektorze, więc wybierz format bez metadanych i pozbądź się go. Wybranie przez przypadek formatu z metadanymi daje ci też dysk, który zachowuje się inaczej niż ten, który chciałeś stworzyć, a połączenie zmiany rozmiaru sektora ze zmianą PI może wymusić powolne pełne formatowanie zamiast szybkiego.
Dla wszystkich dysków w hoście zrób pętlę. Wymaga to shopt -s extglob dla rozszerzonych globów i wybiera tylko formaty 4096/0, które nie są w użyciu:
shopt -s extglob

for dev in /dev/nvme+([0-9])n+([0-9]); do
    # Skip anything that is not actually there
    [ -e "$dev" ] || continue

    # An LBA format with 4096-byte data, 0-byte metadata, marked Best, not in use
    lbaf=$(nvme id-ns -H "$dev" \
        | grep -P '(?=.*Metadata Size: 0)(?=.*Data Size: 4096)(?=.*Best)(?!.*in use)' \
        | awk '{found=$3} END {print (found != "" ? found : -1)}')

    if [ "$lbaf" != "-1" ]; then
        echo "Formatting $dev using LBA Format: $lbaf"
        nvme format --force --lbaf="$lbaf" "$dev"
    else
        echo "Skipping $dev: no matching LBA format found."
    fi
done
Dwie rzeczy robią tam więcej, niż na to wyglądają.
Glob pasuje do przestrzeni nazw, nvme0n1, nvme12n3, i celowo nie pasuje do partycji jak nvme0n1p1, bo wzorzec kończy się po cyfrach następujących po n. To różnica między przeformatowaniem przestrzeni nazw a zrobieniem czegoś nieodwracalnego działającemu systemowi.
A wybór konwertuje wyłącznie dysk, który naprawdę oferuje to, o co prosiłeś. Wszystko inne spada do -1 i jest pomijane, co pokrywa trzy osobne przypadki:
- Dysk oferuje tylko 512. Nie ma formatu 4096-bajtowego, więc nie ma na co konwertować, i pętla zostawia go w spokoju. Nie próbuje i nie wywraca się w połowie.
- Dysk już jest 4Kn. Format 4096/0 to ten w użyciu, a
(?!.*in use)go wyklucza, więc drugi przebieg na tym samym hoście nic nie robi. Żadnego zbędnego przeformatowania każdego dysku. - Jedyne formaty 4096 niosą metadane. Format 4096 + 8 nie spełnia
Metadata Size: 0, więc pętla nie wciśnie ci po cichu dysku z T10-PI, o który nie prosiłeś.
Innymi słowy zawodzi bezpiecznie. Kiedy nie jest pewna, pomija.
Jedna uwaga o przenośności: te asercje wyprzedzające wymagają trybu -P (PCRE) z GNU grep. Na systemie, gdzie grep jest czymś innym, wzorzec nie pasuje do niczego i każdy dysk jest pomijany. Irytujące, ale przynajmniej myli się w bezpieczną stronę.
Mimo wszystko przeczytaj pętlę, zanim ją uruchomisz.
Tam, gdzie pasuje, formatuje bez dalszych pytań. nvme format --force nie pyta dwa razy.
Należy do provisioningu, na maszynie, której dyski nic nie przechowują, nigdy na hoście z działającym OSD, pulą albo dyskiem VM.
Na FreeBSD odpowiednikiem jest nvmecontrol, gdzie -f to indeks formatu:
nvmecontrol format -f 1 nvme0ns1
SAS i SATA: openSeaChest
openSeaChest od Seagate’a jest wieloplatformowy, otwartoźródłowy i działa także na dyskach innych producentów.
# Find the handle
openSeaChest_Format --scan

# Ask the drive which sector sizes it will accept
openSeaChest_Format -d /dev/sg1 --showSupportedFormats

# Convert. The confirmation string is deliberately hard to type by accident.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
Ta fraza potwierdzająca to nie moja dramatyzacja. To dosłowny ciąg, którego wymaga narzędzie, a część o „may render the drive inoperable” jest prawdziwa. Niskopoziomowe formatowanie przerwane przez zanik zasilania może zostawić dysk, który potrzebuje kolejnego formatowania, zanim w ogóle zacznie działać.
Pod spodem operacja różni się zależnie od transportu: SAS i SCSI używają Format Unit, SATA używa Set Sector Configuration Ext, czyli ścieżki szybkiego formatowania, a NVMe używa NVM Format. Na dysku SAS możesz wywołać Format Unit bezpośrednio, a zauważ, że ta opcja przyjmuje krótszy ciąg potwierdzający:
openSeaChest_Format -d /dev/sg1 --formatUnit 4096 --poll \
    --confirm this-will-erase-data
Dwie różne opcje, dwa różne ciągi potwierdzające: pomyl je, a narzędzie odmówi.
Tam, gdzie dysk obsługuje szybkie formatowanie, rozmiar sektora zmienia się w sekundy, a nie w godziny; dysk wykonuje potem swoją pracę integralności i pracę w tle, a zapisanie na nim twoich prawdziwych danych skraca ten czas w tle. Pełne formatowanie zapisuje zera od początku do końca i na dużym dysku obrotowym może trwać wiele godzin, a nawet dni.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 --fastFormat \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
SCSI: sg_format
Dla wszystkiego, co mówi SCSI, tę samą robotę zrobi sg3_utils:
# --size requires --format; expect hours on a large spinning disk
sg_format --format --size=4096 /dev/sdb

# Fast format where the drive supports it — seconds instead of hours
sg_format --format --size=4096 --ffmt=1 /dev/sdb
sg_format daje ci 15-sekundowe odliczanie, zanim się zobowiąże, które --quick pomija.
Jego dokumentacja ostrzega też przed konkretną awarią, o której warto wiedzieć: jeśli zmiana rozmiaru bloku się powiedzie, ale potem formatowanie zawiedzie, dysk może skończyć w stanie „format corrupt” i potrzebować kolejnego formatowania, żeby dojść do siebie.
Zanim cokolwiek przekonwertujesz
- Sprawdź ścieżkę rozruchu. Dysk 4Kn jako urządzenie rozruchowe wymaga UEFI i systemu operacyjnego, który to obsługuje. Nowoczesny Linux jest w porządku. Starsze Windows nie, a niektóre sprzętowe kontrolery RAID wciąż w ogóle odrzucają 4Kn.
- Zrób to, zanim dysk będzie cokolwiek przechowywał. Dorabianie tego później oznacza ewakuację, konwersję i odtworzenie.
- Zrób jeden, potem sprawdź. Przekonwertuj pojedynczy dysk, potwierdź zgłaszane rozmiary, a potem zrób resztę.
- Licz się z godzinami na dysku obrotowym bez szybkiego formatowania. Nie zaczynaj niskopoziomowego formatowania na maszynie, której niedługo będziesz potrzebować z powrotem.
Sprawdzanie, co masz
# LOG-SEC is what the host addresses, PHY-SEC is what the medium uses
lsblk -o NAME,MODEL,SIZE,LOG-SEC,PHY-SEC

# The same, from sysfs
cat /sys/block/sda/queue/logical_block_size
cat /sys/block/sda/queue/physical_block_size

# SMART states both, and this is the clearest 512e signature there is
smartctl -a /dev/sda | grep -i "sector size"
512 bytes logical, 4096 bytes physical to dysk 512e.
Pasujące liczby oznaczają natywny: 512n, jeśli oba to 512, 4Kn, jeśli oba to 4096.
I sprawdź, czy partycje naprawdę są wyrównane:
parted /dev/sda align-check optimal 1
ZFS, Ceph i dyski wirtualne
ZFS: ustaw ashift=12 jawnie przy tworzeniu puli i nie polegaj na rozmiarze zgłaszanym przez dysk, bo na 512e powie ci 9 i będzie w błędzie. Później nie da się tego zmienić.
Ceph: minimalny rozmiar alokacji BlueStore na flashu powinien wynosić 4 KB. Nowoczesny Ceph ma domyślnie 4096, ale starsze kompilacje miały domyślnie więcej, około 16 KB na SSD i 64 KB na HDD, a to źle pasuje do dysków VM na RBD, bo wysyłają one wiele małych losowych zapisów 4 KB, a zapis 4 KB lądujący w jednostce alokacji 16 albo 64 KB i wzmacnia zapis, i marnuje resztę na wypełnienie. Ustala się to przy tworzeniu OSD, więc trzeba to ustawić przed tworzeniem albo przebudową:
ceph config set global bluestore_min_alloc_size_ssd 4096 # new or rebuilt OSDs only
Jest też odpowiadające bluestore_min_alloc_size_hdd. Istniejące OSD zachowują to, z czym je zbudowano, więc zmiana oznacza ich przebudowę.
Dyski wirtualne: gość widzi to, co przedstawia mu hypervisor, a nie dysk pod spodem, więc dysk 4Kn pod VM wciąż daje gościowi 512-bajtowe bloki, chyba że powiesz inaczej. Utrzymanie stosu w 4K od końca do końca oznacza powiedzenie QEMU, żeby przedstawiał 4K, co w Proxmoxie jest surowym wierszem argumentów w /etc/pve/qemu-server/<vmid>.conf:
args: -global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096
To ten wiersz naprawdę zmusza QEMU do 4Kn dla tych dysków: -global stosuje go do każdego urządzenia scsi-hd w VM, więc gość dostaje informację o 4096 zarówno dla logicznego, jak i fizycznego rozmiaru bloku, i odpowiednio partycjonuje i wyrównuje.
Nie ujmuj całego ciągu w cudzysłów. Proxmox parsuje args: przez Text::ParseWords::shellwords, więc to:
args: "-global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096"
zlewa się w jeden argument: cudzysłowy są respektowane i zdejmowane, a QEMU dostaje jedną długą, nieparsowalną opcję zamiast czterech. Bez cudzysłowów ten sam wiersz dzieli się na -global, scsi-hd.physical_block_size=4k, -global, scsi-hd.logical_block_size=4096, czyli to, czego chcesz. Łatwo o ten błąd, bo w wierszu poleceń cudzysłów to właściwy odruch, a objaw, czyli VM, która nie chce wystartować i narzeka na opcję, nie wskazuje z powrotem na cudzysłowy.
Zrób to przed instalacją systemu gościa. Zmiana rozmiaru bloku dysku pod już zainstalowanym systemem może sprawić, że przestanie się uruchamiać, bo układ partycji i program rozruchowy zostały zapisane pod 512-bajtowe sektory. Zauważ też, że args: to furtka dla ekspertów poza zarządzaniem przez GUI, a interakcję z migracją na żywo i snapshotami warto ponownie sprawdzić w aktualnej dokumentacji Proxmoxa.
Gdy gość mówi 512, a host mówi 4K
To przypadek, który warto porządnie zrozumieć, bo właśnie to dostajesz domyślnie po wykonaniu całej pracy powyżej.
QEMU przedstawia gościowi 512-bajtowe bloki logiczne, chyba że powie mu się inaczej, niezależnie od tego, jakie jest urządzenie bazowe. Możesz więc przekonwertować każdy dysk w hoście na 4Kn, a VM na górze wciąż usłyszą 512 i w to uwierzą.
Gość partycjonuje wtedy na granicach 512 bajtów, bo mu wolno, i wysyła 512-bajtowe IO, bo mu wolno. Ale urządzenie hosta ma teraz naprawdę 4096-bajtowy blok logiczny i nie przyjmie 512-bajtowego zapisu. Coś musi te dwie rzeczy pogodzić, a tym czymś jest host: QEMU czyta otaczające 4 KB, wplata w nie 512 bajtów od gościa i zapisuje całość z powrotem.
Nie usunąłeś emulacji. Przeniosłeś ją z firmware’u dysku do swojego hypervisora, gdzie kosztuje CPU hosta i bufor pośredni zamiast cykli dysku.
Przy cache=none to też nie jest łagodna kara. O_DIRECT na urządzeniu 4Kn wymaga przesunięć i długości wyrównanych do 4 KB, więc zapisu gościa mniejszego niż 4K nie da się po prostu przepuścić: wyrównanie musi zostać poprawione w QEMU, zanim IO w ogóle zostanie wysłane.
A przypadek braku wyrównania wraca warstwę wyżej. Gość spartycjonowany z ziarnistością 512 bajtów kładzie swoje zapisy systemu plików 4 KB pod przesunięciami, które przechodzą przez dwa bloki 4 KB hosta, więc każdy staje się dwoma read-modify-write na hoście. Ta sama awaria co niewyrównana partycja na gołym dysku 512e, tyle że teraz dzieje się wewnątrz VM, gdzie nikt jej nie szuka.
Zasada brzmi więc: jeśli host jest 4Kn, przedstaw 4K także gościowi, i zrób to, zanim trafi tam system.
Wyjątkiem jest obsługa po stronie gościa, czyli cały powód istnienia 512e:
- Goście linuksowi radzą sobie z 4Kn bez marudzenia.
- Windows obsługuje 4Kn dla woluminów danych od Windows 8 i Server 2012 wzwyż, a rozruch z 4Kn wymaga UEFI.
- Wszystko starsze, Windows 7 i wcześniejsze, w ogóle nie potrafi 4Kn. Dla nich dysk wirtualny przedstawiający 512 to cena za ich uruchamianie, a godzeniem zajmie się host. Jeśli to ma znaczenie, trzymaj tych gości na pamięci masowej, gdzie kosztuje cię to najmniej, a nie na najszybszej warstwie.
Sprawdź, z czym gość faktycznie skończył, od środka gościa:
lsblk -o NAME,LOG-SEC,PHY-SEC
512 tam na hoście 4Kn oznacza, że opisane wyżej godzenie zachodzi przy każdym niewyrównanym zapisie.
Źródła
- OpenZFS — Workload Tuning —
ashift, dlaczego2^ashiftto najmniejsze możliwe IO na vdev, i spostrzeżenie, że „many devices misreport their sector sizes” nvme-formatman page —--lbaf,--namespace-id,--sesi--forcesg_formatman page —--sizez--format, opcja szybkiego formatowania i ostrzeżenie o stanie format-corrupt- openSeaChest — otwartoźródłowe narzędzia dyskowe Seagate’a, w tym
--setSectorSizei--showSupportedFormats - openSeaChest wiki — Format, Fast Format, And Sector Sizes — który transport używa którego polecenia i kiedy ma zastosowanie szybkie formatowanie
nvmecontrol(8)— odpowiednik na FreeBSD- Linux block layer documentation — jak jądro modeluje logiczne i fizyczne rozmiary bloków