Zatoka, która przyjmie wszystko
Argument sprzedażowy za adapterem tri-mode jest naprawdę dobry i warto go porządnie wyłożyć, zanim się go rozbierze.
Kup obudowę z backplane’em U.3 i kontrolerem tri-mode, a każda zatoka na dysk staje się uniwersalna. Slot 0 może trzymać dysk SAS 24G, slot 1 tani dysk startowy SATA, slot 2 SSD NVMe Gen4, a adapter dogaduje się z tym, co się pojawi. Broadcom nazywa ten krzem Tri-Mode SerDes; standard zatoki to SFF-TA-1001, znany jako U.3, który definiuje wspólne złącze dla SAS x1/x2, SATA i NVMe na x1, x2 albo x4. Stronę zarządzania obsługuje SFF-TA-1005, Universal Backplane Management, dzięki któremu obudowa ustala, z czym naprawdę rozmawia, i steruje właściwymi diodami aktywności.
Dla każdego, kto specyfikuje serwery, to rozwiązuje prawdziwy i irytujący problem. Nie musisz już wybierać protokołu pamięci masowej w chwili składania zamówienia, trzymać dwóch SKU obudowy ani odkrywać, że zatoki obsługujące NVMe to te cztery po lewej, a twoje dyski poszły do pozostałych dwudziestu. Jeden numer części obsługuje całą flotę, a środowisko SAS może przechodzić na NVMe dysk po dysku zamiast obudowa po obudowie.
Nic z tego nie jest marketingiem. To powód, dla którego te adaptery się sprzedają, i głupio byłoby udawać, że jest inaczej.
Ale elastyczność nie jest za darmo, a rachunku nie płaci się w funtach. Płaci się go kolejkami.
Co naprawdę dzieje się z dyskiem
SSD NVMe to punkt końcowy PCIe. W serwerze z dyskami podłączonymi bezpośrednio jego cztery linie biegną do root complexu procesora, przez retimer albo przełącznik PCIe, ale elektrycznie i logicznie to urządzenie na szynie PCIe. Jądro je enumeruje, podpina sterownik nvme i od tej chwili sterownik rozmawia bezpośrednio z rejestrami dysku.
Postaw ten sam dysk za adapterem tri-mode i to przestaje być prawdą.
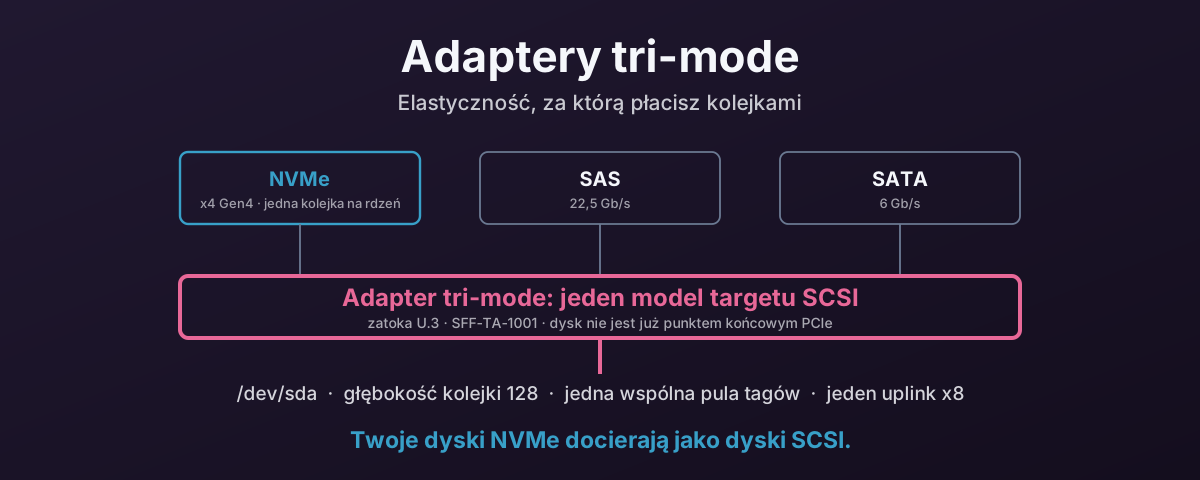
Linie dysku kończą się teraz na kontrolerze. Dokumentacja Broadcomu nazywa odpowiedni blok PCIe device bridge i słowo bridge, czyli most, robi tu dużo roboty: to nie jest przezroczysty przełącznik, który przekazuje transakcje twojego procesora do dysku, który ten procesor nadal widzi. Adapter jest punktem końcowym PCIe, który enumeruje twój host. Dysk jest targetem wiszącym po jego drugiej stronie, a firmware kontrolera od nowa generuje każde I/O.
Adapter nie przepuszcza więc twoich poleceń NVMe. Kończy je i rozmawia z dyskiem w twoim imieniu.
Co rodzi pytanie, jakim protokołem rozmawia z tobą.
System nigdy nie widzi dysku NVMe
Rozmawia SCSI.
Podłącz SSD NVMe do HBA tri-mode Broadcomu, a nie pojawi się jako /dev/nvme0n1. Pojawi się jako /dev/sdb, podpięty do mpt3sas, tego samego sterownika, który od ponad dekady obsługuje kontrolery SAS LSI. nvme list nic nie zwraca. lsblk -o NAME,TRAN raportuje transport jako sas. Dla każdej warstwy stosu pamięci masowej nad sterownikiem kupiłeś dysk SAS.
To nie błąd ani ograniczenie firmware’u czekające na poprawkę. Tak to zaprojektowano. Wystawianie wszystkiego jako targetu SCSI to właśnie sposób, w jaki jeden adapter obsługuje trzy protokoły: kontroler sprowadza SAS, SATA i NVMe do jednego modelu urządzenia, a host dostaje jeden sterownik, jedną ścieżkę enumeracji, jeden zestaw narzędzi. Elastyczność z marketingu i prezentacja SCSI w dmesg to ta sama decyzja architektoniczna oglądana z dwóch końców.
Generacje 9500 i 9600 dodają mechanizm passthrough, żeby narzędzia producenta mogły dosięgnąć poleceń administracyjnych NVMe dysku, a nowsze układy Broadcomu dużo lepiej wystawiają stan dysku niż 9400. Ale to boczny kanał zarządzania. Ścieżka danych, czyli każdy odczyt i zapis, które wydaje twoje obciążenie, nadal biegnie w dół stosu SCSI.
A stos SCSI ma model kolejek starszy od flasha o dwadzieścia lat.
Model kolejek, z którego właśnie zrezygnowałeś
To ta część, która naprawdę kosztuje cię wydajność, i warto być w niej precyzyjnym, bo „NVMe jest szybsze od SAS” nie jest powodem.
Centralna decyzja projektowa NVMe nie dotyczyła szybszego przewodu. Polegała na tym, żeby przestać udawać, że urządzenie pamięci masowej to jedna serializowana rzecz.
Specyfikacja dopuszcza do 65 535 par kolejek I/O i ta liczba pada w każdym objaśnieniu NVMe, jakie istnieje. To zła liczba, po którą się sięga. Żaden dysk nie implementuje niczego bliskiego, więc każdy, kto naprawdę spojrzał na działający system, może machnąć ręką na to porównanie, i miałby rację. Prawdziwa liczba jest mniejsza, nieefektowna i lepiej pokazuje, o co chodzi.
Oto więc prawdziwy dysk. Nie część klasy enterprise: SSD OEM SK Hynix 256 GB, taki, jaki wlutowuje się w laptopa ze średniej półki, w maszynie z 16 rdzeniami.
$ nproc
16
$ cat /sys/class/nvme/nvme0/queue_count
17
$ ls /sys/block/nvme0n1/mq | wc -l
16
$ cat /sys/block/nvme0n1/queue/nr_requests
1023
Siedemnaście kolejek: jedna kolejka administracyjna i szesnaście kolejek I/O dla szesnastu rdzeni. Każda głęboka na 1023 polecenia. Odwzorowanie jest jeden do jednego: każda kolejka sprzętowa jest przypisana do dokładnie jednego procesora:
$ cd /sys/block/nvme0n1/mq && grep -H . */cpu_list
0/cpu_list:1
1/cpu_list:9
2/cpu_list:3
3/cpu_list:11
...
Jeden procesor na kolejkę, do samego końca: kolejka sprzętowa 0 obsługuje rdzeń 1 i nic więcej.
Tak w praktyce wygląda „NVMe ma mnóstwo kolejek”. Nie 65 535, tylko jedna na rdzeń, ile by tych rdzeni nie było. Linux tworzy parę kolejek na każdy procesor, aż do tego, ile przyzna kontroler, a kontrolery przyznają dużo więcej, niż typowy serwer ma rdzeni, więc w praktyce liczba rdzeni jest tą liczbą. Wsadź ten dysk do maszyny z 64 rdzeniami, a dostaniesz 64.
Z tego podziału na rdzenie bierze się wydajność:
- Rdzeń wrzuca polecenia do własnej kolejki. Bez blokady, bo żaden inny rdzeń jej nie dotyka.
- Każda kolejka dostaje własny wektor MSI-X, przypisany do tego rdzenia.
- Przerwanie zakończenia ląduje z powrotem na rdzeniu, który wydał I/O, tam gdzie już są potrzebne linie cache.
- Wszystkie szesnaście rdzeni może mieć operacje w locie naraz, nigdy nie walcząc o wspólną strukturę.
Równoległość rośnie z liczbą rdzeni, a praca żadnego rdzenia nigdy nie czeka w kolejce za pracą innego. Tani dysk konsumencki to robi. To absolutne minimum.
Teraz spójrz, co dysk dostaje za adapterem. Liczby poniżej to nie szacunki, tylko stałe w mainline’owym sterowniku mpt3sas.
Głębokość kolejki na urządzenie ustawiana jest z ioc->max_nvme_qd, którą sterownik bierze z tego, co raportuje firmware kontrolera, a w przeciwnym razie wraca do domyślnej wartości z czasu kompilacji w drivers/scsi/mpt3sas/mpt3sas_base.h:
#define MPT3SAS_SATA_QUEUE_DEPTH	32
#define MPT3SAS_SAS_QUEUE_DEPTH		254
#define MPT3SAS_RAID_QUEUE_DEPTH	128
#define MPT3SAS_NVME_QUEUE_DEPTH	128
128. Urządzenie zdolne do dziesiątek tysięcy oczekujących poleceń dostaje głębokość kolejki 128, a zauważ, że jest ona płytsza niż domyślne 254 dla SAS, dwie linijki wyżej. Możliwości samego dysku w ogóle nie wchodzą w tę decyzję. Liczba pochodzi od kontrolera.
Z liczbą kolejek sprzętowych jest gorzej, a sterownik mówi o tym otwarcie. Z mpt3sas_scsih.c:
shost->nr_hw_queues = 1;

if (shost->host_tagset) {
	shost->nr_hw_queues =
	    ioc->reply_queue_count - ioc->high_iops_queues;
	...
	dev_info(&ioc->pdev->dev,
	    "Max SCSIIO MPT commands: %d shared with nr_hw_queues = %d\n",
	    shost->can_queue, shost->nr_hw_queues);
}
Przeczytaj to uważnie, bo dzieją się tu trzy osobne rzeczy.
Domyślnie jest jedna kolejka sprzętowa. nr_hw_queues = 1. Wielokolejkowość pojawia się tylko na kontrolerach gen35 z włączoną funkcją host_tagset i nawet wtedy to, jak opisuje to historia commitów samego sterownika, symulowane wiele kolejek sprzętowych: sprzęt kontrolera I/O ma jedną kolejkę zgłoszeń z wieloma kolejkami odpowiedzi, a blk-mq jest nakładane na wierzch.
Liczba kolejek pochodzi od kontrolera, nie od liczby rdzeni. To reply_queue_count minus kolejki high-IOPS, czyli przydział wektorów MSI-X adaptera. Nie ma nic wspólnego z tym, ile masz procesorów, i nie rośnie, kiedy dokładasz dyski. To dokładne odwrócenie dysku powyżej, gdzie liczba kolejek była liczbą rdzeni.
A pula tagów jest wspólna. host_tagset znaczy dokładnie to, co mówi: jedna pula tagów dla całego adaptera hosta, a ta linia w logu mówi „shared” na głos. Każdy dysk na karcie bierze z tego samego zestawu slotów na polecenia. Obudowa z dwudziestoma czterema zatokami ma dwadzieścia cztery dyski walczące o tagi jednego kontrolera.
Postaw je obok siebie. Tamten SSD z laptopa miał szesnaście prywatnych kolejek po 1023, jedną na rdzeń, odpowiadających tylko przed sobą. Ten sam dysk za adapterem dostaje udział w kolejkach odpowiedzi karty, 128 oczekujących poleceń i dwudziestu trzech sąsiadów ciągnących z tej samej puli.
Strata nie polega więc na tym, że SCSI jest wolne. Nowoczesne SCSI na blk-mq jest w porządku. Strata jest strukturalna:
- Kolejki należą do adaptera, nie do dysku. Dokładanie dysków dzieli stały zasób, zamiast go powiększać.
- Pula tagów jest wspólna dla całego hosta. Jeden mocno obciążony dysk może zagłodzić pozostałe w sposób, który po prostu nie może się zdarzyć, kiedy każdy dysk ma własne kolejki.
- Głębokość na urządzenie jest ograniczona do 128, niezależnie od tego, co dysk jest w stanie utrzymać.
- Lokalność przerwań jest osłabiona. Zakończenia przychodzą na tę kolejkę odpowiedzi, której użył kontroler, niekoniecznie na rdzeń, który zgłosił I/O.
Przy głębokości kolejki 1 albo 2, czyli jednowątkowym procesie robiącym od czasu do czasu odczyty, nic z tego nie jest odczuwalne. Zmierzysz to samo opóźnienie w obu przypadkach, w granicach szumu. Kara pojawia się dokładnie tam, gdzie kupiłeś NVMe, żeby pomogło: wiele rdzeni wydających wiele współbieżnych I/O. Im głębsze obciążenie, tym więcej dysku, za który zapłaciłeś, pozostaje poza twoim zasięgiem.
Uplink to jeden slot x8
Model kolejek to subtelny problem. Sufit przepustowości to ten oczywisty i można go odczytać z własnych kart produktowych Broadcomu bez żadnego benchmarku.
HBA serii 9500 to karta x8 PCIe Gen 4.0. Opublikowane przez Broadcom wartości to 13 700 MB/s przy sekwencyjnym odczycie 256K i 3M IOPS przy losowym odczycie 4K. Ta sama karta mówi, że obsługuje do 32 urządzeń NVMe.
Postaw te dwie liczby obok siebie, a pytanie odpowiada samo: ilu dysków trzeba, żeby skończył się adapter?
Niewielu i z roku na rok coraz mniej. SSD Gen4 x4 robi mniej więcej 7 GB/s. SSD Gen5 x4 robi mniej więcej 14. Oba to zwyczajne części w 2026 roku: Gen4 to to, czego pełen jest rynek używanych U.2, a Gen5 to to, co dostajesz, kupując nowe.
| Sufit | Dysków Gen4, żeby go osiągnąć | Dysków Gen5, żeby go osiągnąć |
|---|---|---|
| HBA 9500: 13 700 MB/s sekwencyjnie | 2 | 1 |
| HBA 9500: 3M IOPS (4K RR) | 3 | 1–2 |
| eHBA 9600: 6,4M IOPS (4K RR) | ~6 | ~3 |
| MegaRAID 9600: 1,1M IOPS w RAID 5 (4K RW) | ~1 | ~1 |
Przeczytaj jeszcze raz górny wiersz. Jeden SSD Gen5 osiąga cały sekwencyjny sufit HBA 9500. Jeden dysk, w karcie przewidzianej na trzydzieści dwa. Wszystko potem to pojemność. Nie wydajność.
A dolny wiersz to ten, który powinien zatrzymać zamówienie: na MegaRAID obecnej generacji pełna półka NVMe w RAID 5 daje mniej więcej tyle, ile jeden zwykły dysk sam z siebie.
Dyski nawet nie łączą się na x4
Pod wspólnym uplinkiem jest drugi dławik, łatwy do przeoczenia, bo siedzi w tabeli specyfikacji, a nie w nagłówku.
PERC 12 User’s Guide Della, obejmujący kontrolery tri-mode H965i, mówi:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3) and 16 GT/s (Gen 4) at maximum x2 lane width.
Każdy dysk NVMe dostaje dwie linie, nie cztery. Zanim więc dojdzie do jakiejkolwiek walki o uplink, zanim dojdzie do puli tagów, zanim dojdzie do tłumaczenia na SCSI, dysk Gen4 jest już zredukowany do około 3,5 GB/s, czyli połowy tego, co potrafi. Włóż do tej zatoki dysk Gen5, a zestawi łącze Gen4 x2 i da mniej więcej ćwierć swojej znamionowej przepustowości.
Warto być precyzyjnym co do tego, co to zmienia, a czego nie. Nie znaczy to, że adapter starcza na dłużej. Do zapełnienia uplinku 9500 potrzeba około czterech dysków ograniczonych do x2 zamiast dwóch, ale tylko dlatego, że każdy dysk wnosi połowę. Wąskie gardło przesunęło się z uplinku na łącze dysku. Suma, którą da się wycisnąć, się nie poprawiła.
Podłączone bezpośrednio, te same trzydzieści dwa dyski miałyby każdy własną ścieżkę x4 do root complexu, w takiej generacji, jaką wynegocjują dysk i procesor.
Wiersz RAID 5 w tamtej tabeli zasługuje na osobne spojrzenie, bo to własna liczba Broadcomu, opublikowana bez upiększeń. Z karty serii 9600:
900K to 1.1M RAID 5 IOPS (4K RW)
RAID z parzystością w firmware’ze kontrolera to najdroższa rzecz, o jaką możesz poprosić kartę tri-mode, a to obecna generacja, która to robi. Warto to przeczytać, zanim ktoś wyspecyfikuje RAID 5 na dwudziestu czterech dyskach NVMe i będzie oczekiwał wydajności dwudziestu czterech dysków.
A co z kartą x16?
Oczywisty zarzut wobec wszystkiego powyżej: 9500 to karta x8 Gen4, a sufit jest artefaktem wąskiego łącza do hosta. Daj adapterowi szesnaście linii Gen5, a problem zniknie.
To uczciwy zarzut i należy mu się najmocniejszy przykład, a nie chochoł. Weźmy więc PERC13 H975i Della: obecna generacja i mniej więcej tak dobrze, jak tri-mode w ogóle potrafi. Jego podręcznik użytkownika podaje „Gen 4 and Gen 5 PCIe x16 host interfaces”, a StorageReview zmierzył 52,5 GB/s i 12,5M IOPS na kontroler, przy maksymalnie szesnastu dyskach NVMe.
To poważne liczby i istotnie zmieniają obraz. Wobec 13 700 MB/s i 3M IOPS karty 9500 to mniej więcej cztery razy większa przepustowość i cztery razy więcej IOPS, rozłożone na o połowę mniej dysków. Dell nie tylko poszerzył rurę: zmniejszył też o połowę rozgałęzienie, a współczynnik nadsubskrypcji w efekcie się poprawił. Zwłaszcza w IOPS 12,5M na szesnaście dysków to około 780K na dysk, czyli blisko tego, co zwykły dysk daje sam. W tym punkcie kontroler naprawdę nie jest tym, co cię hamuje.
Oddajmy więc sprawiedliwość: nowoczesna karta tri-mode x16 Gen5 to dużo lepszy kawałek inżynierii niż karta x8 Gen4, a jeśli przepustowość była twoim jedynym zarzutem, x16 w dużej mierze na niego odpowiada.
Trzech rzeczy nie naprawia.
Dyski nadal łączą się na x2. To mnie zaskoczyło. Podręcznik PERC13, opisujący kontroler Gen5 x16, nadal mówi:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3), 16 GT/s (Gen 4), and 32 GT/s (Gen 5) at maximum x2 lane width.
Szersze łącze do hosta nie poszerza łączy do dysków. Każdy dysk NVMe na najnowszym, najszybszym kontrolerze RAID tri-mode, jaki sprzedaje Dell, jest nadal podłączony dwiema liniami zamiast czterech i nadal oddaje połowę przepustowości, zanim cokolwiek innego się wydarzy.
Model kolejek jest zupełnie nietknięty. Nic w sekcji tego wpisu o kolejkach nie zależy od szerokości łącza do hosta. nr_hw_queues pochodzi z przydziału kolejek odpowiedzi MSI-X kontrolera; głębokość 128 na urządzenie to stała sterownika i firmware’u; pula tagów jest wspólna dla całego hosta, bo tak mówi host_tagset. Poszerz łącze do hosta do x16, x32, czego dusza zapragnie: dyski nadal są targetami SCSI dzielącymi kolejki karty, nadal nie ma /dev/nvme0n1 i nadal nie możesz przekazać dysku do VM.
A x16 nie wytwarza przepustowości: rozgałęzia linie, które już miałeś. To argument, który naprawdę rozstrzyga sprawę. Szesnaście linii Gen5 do PERC13 kupuje ci 52,5 GB/s dzielone na szesnaście zatok. Te same szesnaście linii podłączonych bezpośrednio do czterech dysków Gen5 na x4 kupuje ci mniej więcej 56 GB/s na cztery zatoki: tę samą przepustowość z tych samych linii, tyle że każdy dysk dostaje pełne x4, własną parę kolejek na rdzeń i prawdziwy węzeł urządzenia nvme.
Uczciwy opis karty tri-mode x16 to więc nie „szybszy adapter”. To multiplekser linii: zamienia stały budżet linii na więcej zatok na dyski i za tę zamianę każe ci zapłacić modelem kolejek. Czy to dobry interes, zależy od jednej rzeczy. Zatoki czy równoległość.
Co się dzieje, kiedy zapełnisz wszystkie zatoki
Co prowadzi nas do przypadku, który naprawdę ma znaczenie, bo nikt nie kupuje obudowy na 24 dyski, żeby włożyć do niej cztery.
Za punktem nasycenia linia sumaryczna jest płaska. Dokładanie dysków dokłada pojemność i nic więcej, więc wydajność na dysk spada jak 1/N. Ta arytmetyka jest bezlitosna przy realnych obsadach:
| Dyski na HBA 9500 | Sumarycznie | Na dysk | Ułamek dysku Gen4 |
|---|---|---|---|
| 2 | 13,7 GB/s | 6,9 GB/s | 98% |
| 12 | 13,7 GB/s | 1,14 GB/s | 16% |
| 24 | 13,7 GB/s | 0,57 GB/s | 8% |
Spójrz na dolny wiersz. Dwadzieścia cztery dyski NVMe za HBA 9500 dają około 570 MB/s każdy. SSD SATA robi około 550. Kupiłeś dwadzieścia cztery dyski NVMe, zapłaciłeś za kontroler tri-mode, żeby je podłączyć, i doszedłeś do przepustowości na dysk klasy SATA.
Arytmetyka IOPS ma ten sam kształt: 3M rozłożone na dwadzieścia cztery dyski to 125K na każdy, wobec 1M, które zwykły dysk Gen4 osiąga sam, czyli mniej więcej jedna ósma tego, co posiadasz.
Karta x16 wyraźnie to poprawia, ale od tego nie ucieka. PERC13 z pełnymi szesnastoma dyskami to 52,5 GB/s ÷ 16 = 3,3 GB/s na dysk, czyli mniej więcej 23% dysku Gen5, a to jeszcze zanim łącze x2 znowu to przepołowi.
Przy dużej liczbie dysków dwa efekty są gorsze, niż sugeruje dzielenie:
- Głodzenie tagów przechodzi między urządzeniami. Wspólna pula tagów hosta oznacza, że jeden mocno obciążony dysk może zużyć sloty potrzebne innym. Dwadzieścia cztery urządzenia, każde z nominalnym prawem do 128 oczekujących poleceń, chcą razem 3072, branych z
can_queuejednego kontrolera. Blokowanie czoła kolejki między osobnymi dyskami to tryb awarii, który po prostu nie istnieje, kiedy każdy dysk ma własne kolejki. - Odbudowy uderzają we wszystko. Odbudowa parzystości na zapełnionej półce nasyca jedyny wspólny uplink, więc I/O na pierwszym planie do każdego innego dysku na karcie degraduje się w tym samym czasie. Z dyskami na niezależnych liniach i programowym RAID odbudowa walczy o procesor, a nie o jedną rurę.
Kiedy nic z tego nie ma znaczenia
Jest ważna przeciwwaga i to ona jest powodem, dla którego mnóstwo serwerów tri-mode na 24 dyski działa całkiem szczęśliwie.
Sufit adaptera gryzie tylko wtedy, gdy coś dalej w łańcuchu jest w stanie skonsumować więcej, niż on dostarcza. Serwer z 2 × 25GbE ma 6,2 GB/s sieci: nie zapełni nawet HBA 9500. Jeśli te dwadzieścia cztery dyski to warstwa pojemnościowa serwująca pliki przez to łącze, adapter nie jest nawet blisko wąskiego gardła, a arytmetyka na dysk powyżej nie ma znaczenia.
Zaczyna mieć znaczenie w chwili, gdy konsument staje się szybszy niż karta: 100GbE (12,5 GB/s) samo w sobie stawia cię na równi z całym sekwencyjnym sufitem 9500, a obciążenia lokalne, czyli bazy danych, kompilacja, analityka, hosty wirtualizacji z zajętymi gośćmi, w ogóle nie mają sieci na ścieżce.
Pytanie, które należy zadać o zapełnioną półkę, to więc nie „czy adapter jest wolny”, tylko „co będzie to konsumować i czy może skonsumować więcej, niż karta jest w stanie dostarczyć?” Jeśli odpowiedź to łącze 25GbE, przestań się martwić. Jeśli odpowiedź to 100GbE, NVMe-oF albo lokalna baza danych, karta jest twoim wąskim gardłem, a liczba dysków tylko to pogarsza.
Czego jeszcze brakuje
Poza przepustowością wystawianie dysku NVMe jako dysku SCSI oznacza, że części twojego zestawu narzędzi specyficzne dla NVMe przestają działać:
| Podłączony bezpośrednio | Za adapterem tri-mode | |
|---|---|---|
| Węzeł urządzenia | /dev/nvme0n1 | /dev/sdb |
| Sterownik | nvme | mpt3sas / mpi3mr |
nvme-cli | Działa | Nie ma z czym rozmawiać |
| Dane o stanie | Strony logu NVMe SMART | Przetłumaczone strony logu SCSI |
| Zarządzanie przestrzeniami nazw | Tak | Nie |
| Aktualizacje firmware’u | nvme fw-download | Narzędzie producenta przez kontroler |
| Format / sanitize | NVMe Format NVM | Odpowiedniki SCSI, jeśli zaimplementowane |
| Kolejki sprzętowe | Jedna para na rdzeń (16 na maszynie powyżej) | Kolejki odpowiedzi karty, wspólne dla każdego dysku |
| Głębokość kolejki | 1023 na kolejkę | 128 na urządzenie |
Jedna konsekwencja łapie ludzi na tyle często, że warto ją wymienić osobno: nie da się przekazać pojedynczego dysku do maszyny wirtualnej. Passthrough PCIe wymaga, żeby dysk był punktem końcowym PCIe z własną grupą IOMMU, a za adapterem tri-mode nim nie jest: jedynym obecnym urządzeniem PCIe jest kontroler. Możesz przekazać cały adapter, z każdym podłączonym do niego dyskiem, albo nic. Jeśli twój plan zakładał oddanie konkretnych dysków NVMe konkretnym gościom, decyzja o backplanie już rozstrzygnęła to za ciebie.
To kto właściwie tego chce w 2026 roku?
Tu argument sprzedażowy z początku tego wpisu musi zmierzyć się z trudniejszym pytaniem, bo świat, dla którego go zaprojektowano, w większości odszedł.
Tri-mode wymyślono, kiedy NVMe było drogą warstwą, którą dokładało się do środowiska SAS. W 2026 roku jest odwrotnie: NVMe to domyślny wybór, dyski enterprise U.2 są na rynku wtórnym w obfitości i tanie, a „SAS, SATA i NVMe wymieszane w jednej obudowie” opisuje coraz mniej prawdziwych wdrożeń. To kto to właściwie kupuje?
Prawie nikt, celowo. Uczciwa odpowiedź jest taka, że większości kontrolerów tri-mode nikt nie wybrał. Przyszły, bo producent serwera taki dostarcza, a producent dostarcza go dlatego, że jedno SKU backplane’u U.3 pozwala jemu sprzedawać konfiguracje SAS, SATA i NVMe z tej samej obudowy. To wygrana w łańcuchu dostaw dla OEM-a. Dla twojej wydajności nie robi nic i jako takie nigdy nie było sprzedawane jako coś, co robi.
Trzy klasyczne uzasadnienia już się dobrze nie trzymają:
„Potrzebuję mieszanych typów dysków.” Rzadko w tej samej obudowie, a nawet wtedy tri-mode nie jest jedyną drogą. Zwykły HBA SAS dla dysków talerzowych plus NVMe podłączone do root complexu daje ci jedno i drugie, bez kary dla żadnego. Mieszane środowisko nie oznacza mieszanego kontrolera.
„Nie mam dość linii PCIe.” To był prawdziwy argument w 2019 roku, na platformach z 40 liniami i 24 zatokami. Jednogniazdowy Epyc Genoa albo Turin ma 128 linii. Dwadzieścia cztery dyski na x4 to 96. Niedobór, który uzasadniał zbieranie dysków za jednym kontrolerem, prawie zniknął, a tam, gdzie nie zniknął, przełącznik PCIe robi tę robotę bez kończenia protokołu.
„Zatoki muszą być uniwersalne.” To trzeba starannie rozdzielić, bo to argument najczęściej używany do uzasadniania niewłaściwego komponentu. U.3 to standard backplane’u, a nie wymaganie wobec kontrolera. Backplane U.3 można okablować prosto do linii PCIe procesora zamiast przez kontroler tri-mode, a producenci dokumentują obie topologie. Możesz zachować uniwersalne zatoki i skasować podatek. Jeśli odziedziczyłeś serwer tri-mode, najcenniejsza pojedyncza rzecz, jaką możesz sprawdzić, to czy backplane da się przepiąć bezpośrednio.
Co faktycznie zostaje:
- Sprzętowy RAID przy dużej gęstości, tam gdzie wymaga go polityka albo platforma: wymóg audytu, macierz wsparcia, wdrożenie Windows albo ESXi bez warstwy programowej, która zrobiłaby tę robotę. To jest prawdziwy pozostały rynek, to jedyny przypadek, w którym kupujesz silnik RAID, a nie łączność, i na obecnym krzemie to porządny produkt: szesnaście dysków NVMe w sprzętowym RAID 5 z cache chronionym superkondensatorem, z szesnastu linii, to coś, czego podłączenie bezpośrednie w ogóle nie oferuje.
- Masowa pojemność na dyskach SAS HDD, gdzie £/TB nadal zdecydowanie należy do talerzy. Ale to robota zwykłego HBA SAS i tańszego.
- Bardzo duże liczby zatok i obudowy zewnętrzne, gdzie ekspandery SAS sięgają dalej i szerzej niż PCIe.
- Obciążenia, które nigdy nie schodzą głęboko. Jeśli twoje głębokości kolejek są jednocyfrowe, nic z tego nie jest odczuwalne. Mnóstwo prawdziwych systemów żyje tu całkiem szczęśliwie.
Jest też prosty argument operacyjny: jeden typ obudowy, jeden sterownik, jedna część zapasowa na półce, a dla hosta wirtualizacji ogólnego przeznaczenia to jest coś warte. Tylko wyceń to uczciwie wobec faktu, że według tabeli powyżej jeden dysk Gen5 może osiągnąć cały sekwencyjny sufit karty.
Kiedy to złe narzędzie
Ta wymiana robi się zła proporcjonalnie do tego, ile współbieżności ma twoje obciążenie.
Ceph to najczystszy przypadek. Węzeł pamięci masowej uruchamia jedno OSD na dysk, każde z własnymi pulami wątków, wszystkie wydające I/O naraz, a potem klienci całego klastra obciążają je współbieżnie. To najgorszy przypadek wspólnej puli tagów: dwadzieścia cztery demony walczące o sloty poleceń jednego kontrolera, każdy dysk ograniczony do 128 oczekujących, wszystko przeciśnięte przez jeden uplink x8. Podłącz te dyski prosto do root complexu, a każde OSD dostanie własne kolejki, własne tagi i własne linie. Węzeł Cepha na samym NVMe nie powinien mieć adaptera tri-mode na ścieżce danych.
Ta sama logika dotyczy targetów NVMe-oF, gdzie ponownie eksportujesz dyski i każda warstwa serializacji się kumuluje; baz danych z głębokim asynchronicznym I/O; i wszystkiego, co zbudowano na io_uring albo SPDK, które istnieją właśnie po to, żeby wykorzystać kolejki na rdzeń, które adapter ci właśnie zabrał.
Ogólna zasada: im więcej równoległości twoje oprogramowanie miało wykorzystywać, tym więcej adapter tri-mode ci za nią policzy.
Jak sprawdzić, co masz
Jeśli odziedziczyłeś serwer i chcesz wiedzieć, po której stronie tej historii jesteś:
# What is the transport? "nvme" is direct, "sas" means it went through a controller
lsblk -o NAME,TRAN,MODEL,SIZE

# Is there a tri-mode controller in the machine at all?
lspci -nn | grep -Ei 'sas|megaraid|serial attached'

# Which driver claimed the disk?
ls -l /sys/block/sdb/device/driver

# Per-device queue depth — 128 is the mpt3sas NVMe default
cat /sys/block/sdb/device/queue_depth

# How many hardware queues does this device actually get?
ls /sys/block/sdb/mq/ | wc -l
ls /sys/block/nvme0n1/mq/ | wc -l    # compare against a direct-attached drive

# On a direct-attached drive, what did the controller actually grant?
# One admin queue plus one I/O queue per core, so expect nproc + 1
cat /sys/class/nvme/nvme0/queue_count
nproc

# The driver says it out loud at load time
dmesg | grep -i 'nr_hw_queues'
Ostatnie polecenie wypisuje cytowaną wcześniej linię Max SCSIIO MPT commands: N shared with nr_hw_queues = M. Jeśli nvme list jest puste na maszynie, o której mówiono ci, że jest w całości na flashu NVMe, przyczyną jest adapter.
W skrócie
Adapter tri-mode zamienia twoje dyski NVMe w dyski SCSI. Ta zamiana nie jest efektem ubocznym. Tak jedna karta obsługuje trzy protokoły i to właśnie kupujesz.
To, z czego rezygnujesz, jest konkretne i mierzalne: pary kolejek na rdzeń zastąpione wspólnymi kolejkami odpowiedzi kontrolera, głębokość 128 na urządzenie, pula tagów dzielona między każdy dysk na karcie, łącze x2 tam, gdzie dysk chciał x4, i jeden wspólny uplink tam, gdzie każdy dysk miał wcześniej własną ścieżkę do root complexu. Adapter przestaje być połączeniem i staje się wąskim gardłem, a na obecnym sprzęcie staje się nim szybko: dwa dyski Gen4 osiągają HBA 9500, cztery dyski Gen5 osiągają nawet PERC13.
Szersze łącze do hosta pomaga, bo karta x16 Gen5 ma mniej więcej cztery razy większą przepustowość i IOPS niż karta x8 Gen4, ale nie zmienia kształtu. Kupuje zatoki, nie równoległość: te same szesnaście linii podłączonych prosto do czterech dysków daje tę samą przepustowość bez żadnego podatku od kolejek. I nie ratuje pełnej półki. Dwadzieścia cztery dyski za 9500 dostają około 570 MB/s każdy, czyli tyle, ile robi SSD SATA.
W 2019 roku, kiedy NVMe było warstwą dokładaną do środowiska SAS, a platformom brakowało linii, to była rozsądna wymiana. W 2026 roku zwykle nie jest. NVMe to wybór domyślny, używane dyski U.2 są tanie, jednogniazdowy Epyc ma linii w nadmiarze, a jedyna korzyść, która nadal stoi, czyli uniwersalne zatoki na dyski, należy do backplane’u U.3, a nie do kontrolera. Bardzo często możesz zachować zatoki i skasować podatek, kablując backplane prosto do procesora.
Kupuj więc adapter tri-mode, jeśli kupujesz jego silnik RAID i go potrzebujesz. Nie kupuj go dla elastyczności, a jeśli odziedziczyłeś taki w obudowie pełnej NVMe, idź i sprawdź, jak ten backplane jest okablowany.
Nie ma sensu płacić dwa razy za dyski, których potem nie możesz porządnie używać.