50 TOPS, które nic nie robią
Każdy laptop z Ryzen AI sprzedany w ostatnich dwóch latach ma w sobie Neural Processing Unit (NPU), blok krzemu zbudowany wyłącznie do matematyki stojącej za modelami AI. W moim, ThinkPadzie z Ryzen AI 7 PRO 350, AMD podaje do 50 TOPS, bilionów operacji na sekundę1. Zapłaciłeś za to. Na standardowej instalacji Linuksa nie robi nic.
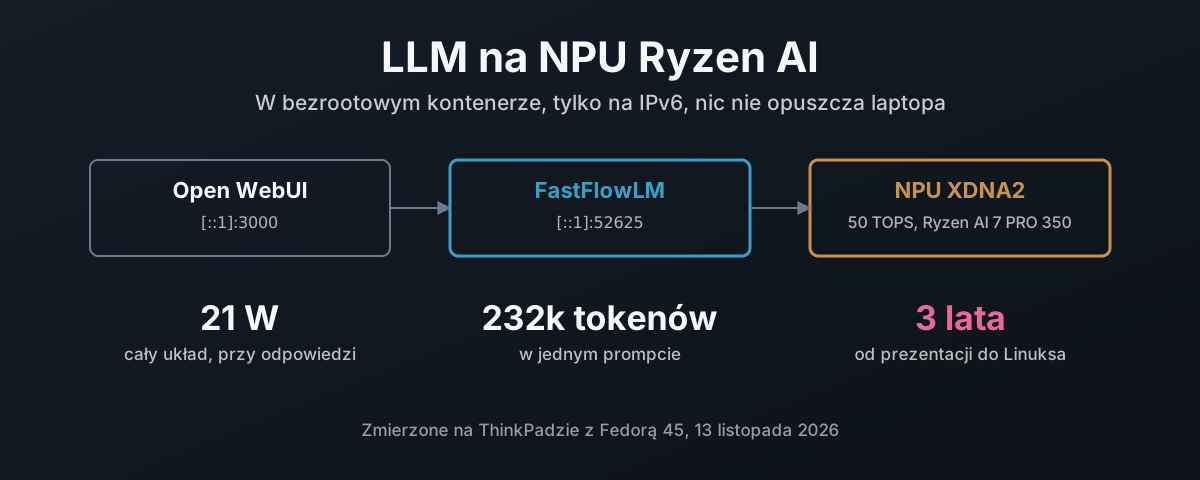
W tym roku to się zmieniło. Po skonfigurowaniu NPU uruchamia model językowy o 4 miliardach parametrów za oknem czatu, do tego rozpoznawanie mowy, wszystko na laptopie, bez konta, bez abonamentu i bez niczego, co opuszcza maszynę, a przy wszystkim, czego wolałbyś nie wpisywać na cudzą stronę, właśnie o to chodzi. Cały układ pobiera około 21 W, kiedy odpowiada, a w spoczynku poniżej 9 W.
| Co działa | Gdzie | Adres |
|---|---|---|
| Qwen 3.5 4B, kontekst 256k tokenów | NPU, w kontenerze | http://[::1]:52625/v1 |
Mowa na tekst: Whisper od OpenAI, whisper-v3:turbo | NPU, ten sam kontener | ten sam, /audio/transcriptions |
| Open WebUI, strona czatu | CPU, w kontenerze | http://[::1]:3000 |
| Sterownik jądra amdxdna, firmware | host | /dev/accel/accel0 |
Dwie zasady ukształtowały tę budowę. Na hoście lądują tylko sterownik jądra i jego firmware; każdy framework do modeli działa w bezrootowym kontenerze podmana. A każda usługa nasłuchuje wyłącznie na pętli zwrotnej IPv6, bez niczego na IPv4. Obie okazały się mniej roboty niż robienie tego na bałagan, i obie wyłapały problemy, które inaczej bym wypuścił.
Czego to wymaga na Linuksie
NPU w tym układzie to druga generacja projektu AMD, XDNA2. To ma znaczenie, bo oprogramowanie, które uruchamia na nim modele językowe, obsługuje części XDNA2 (serie Ryzen AI 300 i 400, Strix Halo), a nie pierwszą generację w Ryzenach 7040 i 80402. Sprawdź swój, zanim zaczniesz:
$ lspci -nn | grep -i 'neural\|signal processing'
c5:00.1 Signal processing controller [1180]: Advanced Micro Devices, Inc. [AMD] Strix/Krackan/Krackan2/Strix Halo Neural Processing Unit [1022:17f0] (rev 20)
Między tym urządzeniem a odpowiedzią w czacie leżą cztery warstwy, a podział między hostem a kontenerem to cały projekt:
| Warstwa | Co to jest | Gdzie mieszka |
|---|---|---|
amdxdna | sterownik jądra, tworzy /dev/accel/accel03 | host, przez DKMS |
| Firmware NPU | npu_7.sbin, 1.1.2.64 na tym układzie | host, z linux-firmware |
XRT + wtyczka amdxdna | biblioteka runtime AMD i jej backend dla NPU | kontener |
| FastFlowLM | runtime LLM, z kernelami NPU w zestawie | kontener |
Jądro 7.x dostarcza amdxdna w drzewie, ale AMD rozwija go najpierw we własnym repozytorium, a
wtyczka w przestrzeni użytkownika musi pasować do modułu jądra, z którym rozmawia4.
Różnica między nimi nie jest mała. Na tym laptopie:
| W drzewie, 7.2.15 i 7.3.3 z Fedory | Spoza drzewa, amd/xdna-driver na 24dfd686 | |
|---|---|---|
| Interfejs sterownika | 0.105 | 0.19 |
| Wersja modułu | brak | 2.27.0_20261113 |
| Identyfikatory PCI NPU, które obsługuje | 6 | 8 |
| Pliki firmware’u, o które prosi | 7 | 59 |
| Firmware, który ładuje ten układ | 17f0_10/npu_7.sbin, 1.1.2.64 | ten sam plik |
Dziewięć wersji interfejsu różnicy, a Linux 7.3, najnowsze wydanie, wciąż ma 0.10. Jedyne, co do
czego się zgadzają, to firmware, a ten pochodzi z linux-firmware Fedory, nie z któregokolwiek
sterownika. Buduję więc obie połowy z jednego commita amd/xdna-driver, moduł kładę na hoście, a
pasującą przestrzeń użytkownika wypiekam w obrazie.
Sterownik: zbuduj wszystko, zostaw tylko kawałek jądra
amd/xdna-driver zawiera XRT jako submoduł gita, a jego budowanie daje RPM-y dla XRT i
pakietu wtyczki. Pakiet wtyczki niesie też źródła sterownika, które rejestruje w DKMS (Dynamic
Kernel Module Support, to, co przebudowuje moduł dla każdego nowego jądra).
Nic z tego nie jest trudne:
git clone --recursive https://github.com/amd/xdna-driver.git && cd xdna-driver
sudo ./tools/amdxdna_deps.sh
(cd xrt/build && ./build.sh -npu -opt)    # XRT RPMs in xrt/build/Release/
(cd build && ./build.sh -release)         # plugin RPM, driver source inside
Na Fedorze 45 skrypt zależności kończy się błędem. Zignoruj go:
| O co prosi | Co się dzieje | Ma znaczenie? |
|---|---|---|
protobuf-devel | konfliktuje z zainstalowanym protobuf3-compiler | nie, XRT bez niego tylko pomija narzędzie do śledzenia |
redhat-lsb | nie ma takiego pakietu, Fedora go porzuciła | nie |
| wszystko inne | już zainstalowane |
Ostatnie otagowane wydanie jest tam z lutego, więc kanałem wydań jest main. Przeszedłem z
kompilacji z maja na listopadową: 550 commitów, XRT z 2.23 na 2.27.
Aktualizacja usuwa sterownik, który właśnie zainstalowała
Moje pierwsze podejście do aktualizacji całkowicie zabrało moduł. RPM uruchamia skrypt
instalacyjny nowego pakietu, który buduje i rejestruje nowy sterownik w DKMS, a potem uruchamia
skrypt usuwający starego pakietu. Ten skrypt odczytuje wersję sterownika z pliku, który nowy pakiet
już nadpisał, więc wyrejestrowuje wersję, która właśnie została zainstalowana. Wyjście dnf
mówi to w dwóch wierszach, jeden po drugim:
>>> Successfully installed and enabled DKMS for xrt-amdxdna/2.27.0
>>> Removing driver source: xrt-amdxdna/2.27.0...
Nic nie zawiodło, nic nie zrobiło się czerwone, a następny start po cichu załadowałby to, co
dostarczyło jądro. Czy mogę zapytać, dlaczego skrypt usuwający uruchamia się przy aktualizacji bez
sprawdzenia, czy to aktualizacja? RPM podaje każdemu skryptletowi tę odpowiedź jako pierwszy
argument. To jedno if.
To także powód, dla którego host w ogóle nie dostaje teraz RPM-ów. Źródła sterownika to archiwum tar wewnątrz pakietu wtyczki, więc je wyciągam i daję prosto DKMS:
T=$(mktemp -d) && rpm2cpio xrt_plugin*.rpm | (cd $T && cpio -idm --quiet)
D=$T/opt/xilinx/xrt/share/amdxdna
sudo mkdir -p /usr/src/xrt-amdxdna-2.27.0
sudo tar -xf $D/amdxdna.tar.gz -C /usr/src/xrt-amdxdna-2.27.0
sudo cp $D/dkms.conf $D/configure_kernel.sh /usr/src/xrt-amdxdna-2.27.0/
sudo dkms install xrt-amdxdna/2.27.0
sudo modprobe -r amdxdna; sudo modprobe amdxdna
Bez restartu. To Linux, a w tym momencie nic nie trzyma otwartego urządzenia, więc moduł
podmienia się na żywo. DKMS potem
przebudowuje go dla każdego jądra, które instaluje dnf; kiedy przyszło 7.3.3, był zbudowany,
zanim zdążyłem się do niego zrestartować.
Sprawdź, czy załadowała się kompilacja z DKMS, a nie ta z drzewa, i czy firmware jest dość nowy. FastFlowLM chce 1.1.0.0 lub nowszego2:
$ modinfo -F filename amdxdna
/lib/modules/7.2.15-300.fc45.x86_64/extra/amdxdna.ko.xz
$ cat /sys/bus/pci/drivers/amdxdna/*/fw_version
1.1.2.64
$ journalctl -k | grep 'Initialized amdxdna'
[drm] Initialized amdxdna_accel_driver 0.19.0 for 0000:c5:00.1 on minor 0
DKMS odsuwa własny moduł jądra na bok zamiast go usuwać, do
/var/lib/dkms/xrt-amdxdna/original_module/, więc wyjęcie kompilacji z DKMS przywraca go na miejsce.
Jeszcze jedno, czego nie ruszaj: amd_iommu=off w wierszu poleceń jądra wyłącza NPU2.
FastFlowLM w kontenerze
FastFlowLM to runtime, który sprawia, że NPU przydaje się do modeli językowych. To wiersz poleceń w stylu Ollamy i serwer zgodny z OpenAI, napisany dla XDNA2, a w tym roku przeszedł pod organizację ROCm od AMD6. Runtime ma licencję MIT. Kernele NPU, które dostarcza, to zamknięte binaria, wolne do używania i redystrybucji bez modyfikacji7. Wolałbym, żeby były otwarte, i to mówię, ale są w repozytorium i nie trzeba niczego ściągać z żadnego innego miejsca.
Obraz to trzy etapy na Fedorze 45: XRT z kompilacji sterownika, FastFlowLM skompilowany na nim, potem runtime tylko z tym, czego potrzebuje. Część, która ma znaczenie:
FROM registry.fedoraproject.org/fedora:45 AS xrt
ARG XDNA_COMMIT
COPY dist/xdna-${XDNA_COMMIT}/ /rpms/
RUN dnf -y install /rpms/xrt_2*-base.rpm /rpms/xrt_2*-npu.rpm \
 && rpm -i --noscripts --nodeps --nosignature \
        --excludepath=/usr/lib/firmware --excludepath=/opt/xilinx/xrt/share/amdxdna \
        /rpms/xrt_plugin*.rpm \
 && echo /opt/xilinx/xrt/lib64 > /etc/ld.so.conf.d/xrt.conf && ldconfig
Każda z tych flag jest tam, bo bez niej coś się psuło:
| Problem | Poprawka |
|---|---|
| Skrypty wtyczki budują moduł jądra, który należy do hosta | --noscripts, a źródła sterownika i firmware wyłączone |
| RPM 6 w Fedorze 45 domyślnie wymusza sprawdzanie podpisów8, a samodzielnie zbudowany RPM jest niepodpisany | --nosignature: zbudowałem go sam, wiem, skąd pochodzi |
Biblioteki XRT są w lib64, czego nie ma na ścieżce linkera | /etc/ld.so.conf.d/xrt.conf wewnątrz obrazu |
FastFlowLM znajduje XRT przez pkg-config, a setup.sh od XRT nie ustawia ścieżki | PKG_CONFIG_PATH=/opt/xilinx/xrt/lib64/pkgconfig w etapie budowania |
Gotowy obraz ma 609 MB, a jego tag niesie commit sterownika,
fastflowlm:v1.0.12-xdna24dfd686. Kontrola stanu porównuje go z commitem, który zgłasza załadowany
moduł, i zawodzi, jeśli się różnią. Obraz zbudowany pod zły sterownik to jedyna usterka
tutaj, którą naprawdę trudno zdiagnozować, więc jest wyłapywana, zanim do tego dojdzie.
Kontener dostaje jedno urządzenie, NPU, i limit blokowania pamięci, którego FastFlowLM potrzebuje do przypięcia swoich buforów:
podman run --rm --device /dev/accel/accel0 --ulimit memlock=-1:-1 \
  localhost/fastflowlm:v1.0.12-xdna24dfd686 validate
[Linux]  NPU: /dev/accel/accel0 with 8 columns
[Linux]  NPU FW Version: 1.1.2.64
[Linux]  Memlock Limit: infinity
Własny autotest AMD, xrt-smi validate, dał NPU 51 TOPS na mnożeniu macierzy. To jest
50 z pudełka, dostarczone.
Start przy uruchomieniu, tylko na IPv6
Quadlet zamienia krótki plik .container w usługę systemd9. Jako jednostka użytkownika
działa bez roota, jako ja, a z włączonym lingeringiem startuje przy uruchomieniu, bez nikogo zalogowanego10:
[Unit]
Description=FastFlowLM NPU server
ConditionPathExists=/dev/accel/accel0

[Container]
Image=localhost/fastflowlm:v1.0.12-xdna24dfd686
AddDevice=/dev/accel/accel0
Ulimit=memlock=-1:-1
Network=host
Volume=%h/.config/flm:/models:Z
Exec=serve qwen3.5:4b --host ::1 --port 52625 -c 262144 -a whisper-v3:turbo
StopSignal=SIGINT

[Install]
WantedBy=default.target
loginctl enable-linger $USER
cp fastflowlm.container ~/.config/containers/systemd/
systemctl --user daemon-reload && systemctl --user start fastflowlm
-c 262144 ustawia okno kontekstu, a test kontekstu poniżej wyjaśnia,
dlaczego jest takie duże. -a whisper-v3:turbo ładuje drugi model obok modelu czatu, taki, który
zamienia mowę w tekst; ma własną sekcję.
Trzy wiersze w tym pliku przyszły z bólem:
| Wiersz | Bez niego |
|---|---|
StopSignal=SIGINT | FastFlowLM ignoruje SIGTERM, sygnał zatrzymania podmana, i zostaje zabity dziesięć sekund później |
--host ::1 | nasłuchuje na 127.0.0.1, IPv4 |
::1, nie [::1] | forma w nawiasach nie daje się sparsować; nawiasy należą do URL-a |
Udowodnij adres, zamiast mu ufać:
$ ss -ltn 'sport = :52625'
LISTEN 0  4096  [::1]:52625  [::]:*
$ curl -s http://127.0.0.1:52625/v1/models || echo refused
refused
localhost wciąż działa dla wszystkiego, co rozwiązuje go najpierw na ::1, a robią tak i
/etc/hosts Fedory, i Chrome.
Co to robi, zmierzone
Dziewięć modeli przez benchmark samego FastFlowLM, przy czym dekodowanie to szybkość, z jaką spływa odpowiedź:
| Model | Dekodowanie, kontekst 1k | Dekodowanie, kontekst 8k | Czytanie promptu, 8k |
|---|---|---|---|
llama3.2:1b | 77 tok/s | 56 tok/s | 2009 tok/s |
qwen3.5:2b | 32 | 29 | 1533 |
llama3.2:3b | 30 | 20 | 857 |
phi4-mini-it:4b | 25 | 17 | 744 |
qwen3:4b | 23 | 15 | 613 |
qwen3.5:4b | 17 | 15 | 657 |
gemma4-it:e4b | 14 | 12 | 642 |
qwen3:8b | 13 | 10 | 418 |
qwen3.5:9b | 11 | 10 | 451 |
Tempo czytania to pięć do ośmiu tokenów na sekundę, więc każdy z nich jest przed tobą. Dekodowanie
spada mniej więcej o połowę za każdym podwojeniem modelu, czego się spodziewasz, gdy ograniczeniem
jest przepustowość pamięci, a nie moc obliczeniowa. Używam qwen3.5:4b. Phi-4 mini jest szybszy, ale Qwen 3.5 trzyma tempo, gdy rozmowa rośnie,
obsługuje obrazy i wywołania narzędzi, i trzyma pamięć podręczną promptu, która oszczędza czytania
całej historii od nowa przy każdej turze. To przesądza.
256 000 tokenów kontekstu
Qwen 3.5 jest zbudowany na okno 262 144 tokenów11, a FastFlowLM domyślnie ustawia 32 768. Po
przekroczeniu tego limitu robi coś, o czym warto wiedzieć: loguje Max length reached, stopping prefilling
i zamyka połączenie bez odpowiedzi i bez błędu, więc okno czatu stoi z pustą
odpowiedzią, a ty możesz zgadywać, czy wywrócił się model, serwer czy przeglądarka.
Podniosłem go więc przez -c 262144 i porządnie przetestowałem. Kod ukryty w pierwszym wierszu
promptu o długości 232 250 tokenów, mniej więcej 175 000 słów, o który zapytano na końcu:
| Kontekst 8k | Kontekst 232k | |
|---|---|---|
| Odpowiedź | poprawna | poprawna, AMBER-FALCON-7731 |
| Czytanie promptu | 657 tok/s | 210 tok/s |
| Czekanie na pierwsze słowo | 12 sekund | 18,4 minuty |
| Dekodowanie | 15 tok/s | 2,4 tok/s |
| Zarezerwowana pamięć | ~5 GB | ~12,7 GB |
Działa. Jest wolne. A pamięć jest zarezerwowana niezależnie od tego, czy używasz okna. Mając 90 GB w maszynie, zapłacę tę cenę, żeby długie wklejenie dostało odpowiedź, a nie zostało po cichu odrzucone.
Czy GPU może pomóc?
Ten sam układ ma Radeona 860M, więc oczywiste pytanie brzmi, czy może przejąć część obciążenia. Rozdzielenie jednego modelu między NPU a GPU, czytanie promptu na jednym i pisanie odpowiedzi na drugim, to coś, czego dziś nie robi żaden linuksowy runtime. Uruchomienie drugiego runtime’u na GPU już tak, więc to zmierzyłem.
„Wydajny” oznacza tu szybkość i energię razem. Sterownik amdgpu zgłasza moc całego pakietu
bez roota, a sterownik amdxdna zgłasza samo NPU, więc każdy przebieg
poniżej był próbkowany cztery razy na sekundę. Wszędzie ten sam model w 4 bitach.
Z runtime’ów GPU, które sprawdziłem, zadziałał jeden:
| Runtime | Wynik na 860M |
|---|---|
| llama.cpp, backend Vulkan12 | działa; obraz 881 MB |
| llama.cpp, backend ROCm | widzi GPU, potem segfault przy pierwszym zadaniu, z nadpisaniem wersji GPU lub bez; obraz 23 GB |
| MLC-LLM, Vulkan13 | jego kompilator robi segfault przy budowaniu architektury Qwen 3.5 |
| vLLM, SGLang | niepróbowane: zbudowane dla GPU z centrów danych i wielu użytkowników, nie dla 8-jednostkowego iGPU |
I NPU w porównaniu z tym, który zadziałał:
| Qwen 3.5 4B | NPU, FastFlowLM | GPU, llama.cpp Vulkan |
|---|---|---|
| Spoczynek, model załadowany | 8,6 W | 16,0 W, wobec 9,7 W przy zatrzymanym |
| Czytanie promptu, ~6k tokenów | 557 tok/s przy 23,8 W | 411 tok/s przy 46,1 W |
| Energia na token promptu | 0,043 J | 0,112 J |
| Dekodowanie | 18,2 tok/s przy 21,0 W | 23,5 tok/s przy 40,7 W |
| Energia na wygenerowany token | 1,16 J | 1,73 J |
GPU pisze odpowiedzi o mniej więcej 29% szybciej. Spala przy tym dwa razy więcej mocy. NPU czyta prompty szybciej i za mniej niż połowę energii. Większa liczba to ta w spoczynku: serwer GPU załadowany i bezczynny kosztuje 6,3 W ponad tę samą maszynę z zatrzymanym serwerem, przez cały dzień. Uruchomienie obu naraz zbiło NPU z 18,2 do 14,2 tokena na sekundę, a GPU z 23,5 do 13,9, bo dzielą tę samą pamięć. W związku z tym kontener GPU istnieje, ale uruchamiam go, kiedy chcę drugiego modelu, i nie jest włączony przy starcie.
Samo NPU pobierało poniżej 2 W w każdym przebiegu. Większość z 21 W to CPU i pamięć, które je karmią. To jest sufit, któremu warto się przyglądać w przyszłych wydaniach FastFlowLM.
Mowa na tekst też na NPU
Whisper to model rozpoznawania mowy od OpenAI: dźwięk na wejściu, tekst na wyjściu, w 99 językach, wydany na licencji MIT, więc działa wszędzie, bez pytania kogokolwiek o zgodę14. Large-v3 to obecna pełnowymiarowa wersja. Turbo to ten sam model z dekoderem, czyli połową, która wypisuje tekst, przyciętym z 32 warstw do 4. Karta modelu przedstawia ten kompromis wprost: „way faster, at the expense of a minor quality degradation”. Przy 809 milionach parametrów ma jedną piątą rozmiaru modelu czatu.
FastFlowLM dostarcza go już przekonwertowanego dla NPU jako whisper-v3:turbo, do pobrania 623 MB, i
ładuje go obok modelu czatu przez -a whisper-v3:turbo. Samego Whispera serwować nie będzie;
musi być załadowany także model czatu. Dźwięk idzie do standardowego endpointu transkrypcji OpenAI,
a tekst wraca.
| 19,6 sekundy mowy | |
|---|---|
| Pierwsze żądanie, ładowanie Whispera | 6,2 s |
| Potem | 2,0 s, mniej więcej dziesięć razy szybciej niż w czasie rzeczywistym |
| Moc całego układu | ~24,7 W |
| Dokładność | każde słowo poprawnie |
Tyle że pisownią amerykańskiej udawanej angielszczyzny: „color” i „program”. API Whispera przyjmuje prompt, a
prompt napisany prawdziwą brytyjską pisownią, angielszczyzną Anglii, skąd ten język
pochodzi, wystarcza, żeby to naprawić:
curl -s 'http://[::1]:52625/v1/audio/transcriptions' -F file=@speech.wav \
  -F model=whisper-v3:turbo -F language=en \
  -F 'prompt=British English spelling: colour, programme, organise, centre.'
W ogóle nie powinniśmy musieć poprawiać tych modeli. Whisper był trenowany na 99 językach, a mimo to pisze po angielsku na amerykańską modłę, dopóki mu się nie powie inaczej, bo ludzie, którzy go zbudowali, traktują swoją pisownię jako domyślną, a wszystkich innych jako opcję, o którą trzeba poprosić. To ten irytujący amerykański domyślizm, którego nienawidzi reszta świata, i jest wpieczony jako uprzedzenie. Prompt systemowy dla modelu czatu niesie to samo polecenie, w sekcji poniżej, z tego samego powodu.
Okno czatu i 7000 tokenów, których nigdy nie wpisałeś
Open WebUI to przeglądarkowy front-end15, we własnym kontenerze, przypięty do [::1]:3000 w ten sam
sposób i skierowany na NPU. Jego przycisk mikrofonu idzie do Whispera na NPU zamiast do własnego
domyślnego, który ściągnąłby model i uruchomił go na CPU.
Pierwsza wiadomość, którą do niego wysłałem, miała dwadzieścia słów. Dotarła do NPU jako prompt na 7223 tokeny, bo Open WebUI 0.13 dokleja definicje wszystkich swoich wbudowanych narzędzi (pamięć, notatki, kalendarz, automatyzacje, wyszukiwanie w sieci) do każdej wiadomości, a administrator dostaje każde z nich.
| To samo pytanie na dwadzieścia słów | Prompt wysłany do NPU | Czekanie na pierwsze słowo |
|---|---|---|
| Wbudowane narzędzia włączone, domyślnie | 7223 tokeny | ~12 s |
| Wbudowane narzędzia wyłączone dla modelu | 127 tokenów | poniżej 1 s |
Dla modelu lokalnego to ustawienie domyślne powinno być wyłączone. Dwanaście sekund, przy każdej odpowiedzi.
Powiedział mi też z pełnym przekonaniem, że jest „trained by Google” i działa „on Google’s advanced infrastructure”. To model Qwen, zrobiony przez Alibabę, działający na laptopie. To kompletna bzdura i nie powinno się zdarzać.
To nie konfiguracja. Model widzi tylko tekst, który mu się wysyła, a nazwa na liście rozwijanej to etykieta dla serwera, nigdy nie przekazywana modelowi. Ta odpowiedź przyszła więc z samego modelu, a pomylił się w jedynym fakcie o sobie, który nigdy nie powinien budzić wątpliwości. To wada projektowa i spoczywa na tym, kto ten model wypuścił.
Alibaba wiedziała, jak temu zapobiec. Szablon czatu Qwen 2.5 otwierał każdą rozmowę od „You are Qwen, created by Alibaba Cloud”, chyba że podałeś coś innego16. Qwen 3 porzucił ten wiersz17, a Qwen 3.5 też jest dostarczany bez niego18. Nic go nie zastąpiło, a sądząc po tej odpowiedzi, model nigdy nie został nauczony tego na tyle dobrze, żeby poradzić sobie sam. Zapytaj model 4B „czym jesteś?” bez promptu, a sięgnie po najczęstszą odpowiedź w swoich danych treningowych, która należy do kogoś innego.
Czy to drobiazg? Nie. Model, który z pełnym przekonaniem powie ci, kto go zbudował i w czyim centrum danych działa, i pomyli się w obu sprawach, zrobi to samo z wszystkim innym, czego nie może sprawdzić. Tu znasz właściwą odpowiedź. Przez większość czasu nie będziesz jej znać.
Trzeba mu więc to powiedzieć, w prompcie systemowym:
| Pytanie „czym jesteś i na czym działasz?” | Odpowiedź |
|---|---|
| Bez promptu systemowego | „a large language model trained by Google… Google’s advanced infrastructure” |
| Z promptem | „Qwen 3.5, a large language model created by Alibaba… running locally on your Lenovo ThinkPad using the AMD Ryzen AI 7 PRO 350’s NPU via FastFlowLM” |
Ten sam prompt każe mu pisać brytyjską angielszczyzną, znów z powodu amerykańskiego domyślizmu, który ma też Whisper. Kiedy mu się powie, tak robi. Nadal nie umie ci powiedzieć, jaki jest dzień. Model bez kalendarza i bez internetu zgaduje daty i niedawne wydarzenia i nie zawsze to przyznaje, cokolwiek każe prompt.
Trzy lata, żeby uruchomić AI na Linuksie
AMD wypuściło Ryzen AI na scenę w styczniu 2023 jako „the first dedicated artificial intelligence hardware in an x86 processor”19. Licz od tej prezentacji:
| Kiedy | Co się stało na Linuksie | Po prezentacji |
|---|---|---|
| 4 stycznia 2023 | ogłoszenie Ryzen AI, w Ryzenie 7040 | |
| 25 stycznia 2024 | amd/xdna-driver opublikowany na GitHubie4 | 1 rok |
| 24 marca 2025 | amdxdna w głównej linii Linuksa, 6.1420 | 2 lata i 2 miesiące |
| 27 marca 2025 | premiera tego układu, Ryzen AI 7 PRO 3501 | 2 lata i 2 miesiące |
| 11 marca 2026 | FastFlowLM 0.9.35, pierwsze natywne wydanie na Linuksa21 | 3 lata i 2 miesiące |
| 11 sierpnia 2026 | FastFlowLM 1.0.0, już pod ROCm od AMD6 | 3 lata i 7 miesięcy |
| dziś | wciąż brak runtime’u LLM dla 7040 i 80402 | 3 lata i 10 miesięcy |
Trzy lata i dwa miesiące, żeby w ogóle uruchomić model językowy na NPU pod Linuksem, i nie zrobiło tego własne oprogramowanie AMD. Zrobił to FastFlowLM, projekt, który zaczął się poza firmą i został w tym roku przyjęty pod ROCm. Jego linuksowe informacje o wydaniu zaczynają się od „The wait is finally over”, a potem mówią, że używa „the exact same recipe you already know and love on Windows”21. Fisher-Price OS (Windows) dostał to pierwszy, i sami to powiedzieli. Własne Ryzen AI Software od AMD wciąż mówi w obecnych informacjach o wydaniu: „Model generation is not supported on Linux in this release”22.
Ktokolwiek kupił pierwszą generację, ma gorzej. Laptop z Ryzenem 7040 z 2023 roku ma NPU, którego nie tknie żaden runtime modeli językowych na Linuksie, a nic, co opublikowano, nie mówi, że jakiś się pojawi. Ta sama plakietka.
Czy mogę zapytać dlaczego? Nie kto, tylko dlaczego. Co w procesie AMD pozwoliło sprzedawać układ z AI w nazwie, podczas gdy oprogramowanie do używania tego AI na Linuksie pojawiło się lata później, z zewnątrz? Karta katalogowa mówi „Up to 50 TOPS”1. Plakietka mówi Ryzen AI. Jedno i drugie to deklaracje złożone osobie kupującej laptopa, a przez pierwszy rok tego układu na Linuksie oba były warte tyle co nic.
Celowane w Copilota, nie w centrum danych
Nie chodzi o to, że AMD uważa Linuksa za trudnego. W centrum danych Linux jest pierwszą klasą i AMD o tym wie: El Capitan w Lawrence Livermore to procesory AMD EPYC i akceleratory AMD Instinct, był najszybszym komputerem świata do czerwca tego roku23, a działa na TOSS, własnej kompilacji Red Hat Linux z Livermore24. Wyobrażasz sobie, że AMD sprzedaje akcelerator Instinct i mówi kupującemu, że oprogramowanie na Linuksa kiedyś się pojawi, od kogoś innego? Odpowiedź brzmiałaby: nie. AMD nawet napisało sterownik jądra dla tego NPU i wprowadziło go do głównej linii. Ostatnia warstwa, ta, która sprawia, że sprzęt robi to, do czego go sprzedano, to kawałek, na który kazano czekać.
To w ogóle nie powinno było być projektem laptopowym. Ta sama architektura XDNA trafiła w tym samym roku na kartę do centrum danych, Alveo V70, sprzedawaną jako „the first Alveo production card leveraging AMD XDNA architecture with AI Engines”25. Zbuduj jeden stos oprogramowania dla AI Engine, najpierw na Linuksa, jak resztę centrum danych, a laptop dostanie go za darmo. Serwer też. Mały, oszczędny akcelerator to dokładnie to, co chcesz rozdawać maszynom wirtualnym, każdej po kawałku, dla małych modeli, które nie potrzebują całego GPU. Jądro nauczyło się to robić dopiero w tym roku, dzieląc NPU na funkcje wirtualne w nowych częściach AIE426. Na NPU w tym laptopie nie umie tego zrobić wcale.
Zamiast tego wysiłek poszedł w Fisher-Price OS (Windows) i w Copilota. AMD wprowadziło generację tego układu jako procesory, które „Unlock Transformational AI Experiences for Windows Copilot+ PCs”27. Prawie nikt się nie skusił. Maszyny Copilot+ stanowiły 2,3% komputerów z Fisher-Price OS (Windows) sprzedanych w pierwszym kwartale 2025, a nowsze funkcje Copilota od Microsoftu i tak działają w chmurze: „only one of its new AI capabilities actually requires an NPU”28. Microsoft podaje też, że to, co zarabia na producentach komputerów, spadło o 7% przez „lower PC market demand”, przy „roughly 30% of the installed base still on Windows 10”29. NPU wycelowano więc w system operacyjny, którego ludzie nie aktualizują, żeby uruchamiał asystenta, o którego nie prosili, a który w większości nie używa NPU.
Ani też nie tam buduje się AI. Ludzie, którzy robią to zawodowo, używają Linuksa, bo tam działają ich narzędzia. TensorFlow mówi wprost, że 2.10 „was the last TensorFlow release that supported GPU on native-Windows”30. Serwer modeli vLLM „does not support Windows natively”31. JAX podaje swoją kompilację na Fisher-Price OS (Windows) jako eksperymentalną, a obsługę AMD jako „AMD GPU (Linux)”32. Tam, gdzie Fisher-Price OS (Windows) w ogóle uruchamia te narzędzia, robi to przez WSL 2, który według opisu samego Microsoftu to „an actual Linux kernel inside a managed VM”33. AMD wycelowało swój układ AI w jedyny desktop, którego zawód AI nie używa. Częściowe wsparcie tego to za mało, AMD.
A potem AMD sprzedaje się inwestorom jako firma od AI. 11 listopada 2025 jej przewodnicząca i prezeska powiedziała, że AMD „is uniquely positioned to lead the next generation of high-performance and AI computing”, w komunikacie, który chwali się wzrostem „AI PC portfolio 2.5x since 2024” i kończy się na „full-stack AI solutions”34. Pełny stos. Na komputerze AI z tego wpisu wierzchołek tego stosu przyszedł z projektu, którego AMD nie zaczęło, a na pierwszej generacji nie przyszedł nigdy. Firma od AI, której własny układ AI czekał trzy lata, żeby uruchomić AI na systemie operacyjnym, na którym zbudowany jest jej biznes centrów danych? Śmiechu warte.
Wsparcie pierwszej klasy łatwo opisać. Działa w dniu, w którym kupujesz maszynę, na systemie operacyjnym, którego używasz, od firmy, która sprzedała ci układ. To NPU jeszcze tego nie spełniło. Kupiłem laptopa dla całej reszty, a NPU przyszło w komplecie, i tylko dlatego to jest opis, a nie skarga. Każdy, kto kupił go dla AI z plakietki i używa Linuksa, kupił obietnicę, którą dotrzymano późno, i to ktoś inny.
Bądź właścicielem krzemu, za który zapłaciłeś
NPU przyszło z laptopem. Tak, jak się je sprzedaje, to kawałek, który robi z maszyny sprzęt gotowy na AI, a oferowane AI jest cudze, w cudzym centrum danych, i czyta to, co wpisujesz, żeby dało się na tym zarobić w jakiś inny sposób. Nic w sprzęcie nie wymaga takiego układu. Model 4B na 21 W odpowiada na pytanie, czyta wklejkę na 175 000 słów, jeśli dasz mu czas, i zapisuje to, co mówisz, i nic z tego nie opuszcza biurka.
Gotowe oprogramowanie to nie jest, a każdy szorstki kant opisany wyżej kosztował godzinę szukania i wiersz czy dwa poprawki. Tyle kosztuje open source, kiedy naprawdę go używasz. To nadal lepszy interes niż wynajmowanie tej samej możliwości z powrotem, a za tę godzinę kupujesz wiedzę, jak to działa.
Kontenery trzymają to w uczciwości. Nic na hoście poza modułem jądra i jego firmware, jedno urządzenie przekazane do jednego kontenera, adres, do którego nikt inny nie dosięgnie, i kontrola, która zawodzi w chwili, gdy kawałki przestają do siebie pasować. Zajęło to dzień. Będzie działać, bo wiem, po co jest każdy jego wiersz, a kontrola powie mi tego ranka, kiedy któryś z nich przestanie być prawdą.
AMD — Ryzen AI 7 PRO 350 — 8 rdzeni, 16 wątków, Radeon 860M, „NPU TOPS: Up to 50 TOPS”, data premiery „3/27/2025”. ↩︎ ↩︎ ↩︎
Lemonade — LLMs on Linux with FastFlowLM — tylko XDNA2 (Ryzen AI 300/400, Strix Halo), nie XDNA1; firmware NPU 1.1.0.0 lub nowszy; nie ustawiaj
amd_iommu=off. ↩︎ ↩︎ ↩︎ ↩︎Linux kernel documentation — amdxdna — sterownik akceleratora w drzewie jądra dla NPU od AMD. ↩︎
amd/xdna-driver — sterownik, submoduł XRT i wtyczka; bazowy pakiet XRT buduj z dołączonego submodułu, żeby działał z wtyczką; repozytorium utworzone 25 stycznia 2024. ↩︎ ↩︎
Linux v7.3 — drivers/accel/amdxdna/amdxdna_pci_drv.c —
AMDXDNA_DRIVER_MAJOR 0,AMDXDNA_DRIVER_MINOR 10; tak samo w v7.2. ↩︎ROCm/FastFlowLM — runtime LLM na NPU dla XDNA2, serwer zgodny z OpenAI, część ROCm od v1.0.0; użyte tu wydanie to v1.0.12. ↩︎ ↩︎
FastFlowLM — LICENSE_BINARY.txt — warunki dla dołączonych binariów kerneli NPU. ↩︎
RPM 6.0.0 release notes — „RPM defaults to enforcing signature checking”. ↩︎
podman-systemd.unit(5) — jednostki
.containerQuadleta, w tymAddDevice=,Ulimit=,StopSignal=iExec=. ↩︎loginctl(1) —
enable-lingeruruchamia menedżera użytkownika przy starcie i utrzymuje go po wylogowaniu. ↩︎Qwen/Qwen3.5-4B — „Context Length: 262,144 natively”; hybrydowe warstwy Gated DeltaNet i gated attention. ↩︎
ggml-org/llama.cpp — obraz kontenera
server-vulkanużyty do przebiegów na GPU, kompilacja 12352. ↩︎mlc-ai/mlc-llm — testowane z nocnymi pakietami 0.26. ↩︎
openai/whisper-large-v3-turbo — „a state-of-the-art model for automatic speech recognition (ASR) and speech translation”; przycięty z large-v3, „the number of decoding layers have reduced from 32 to 4”; 809M parametrów; licencja MIT. ↩︎
open-webui/open-webui — użyte tu wydanie v0.13.3. ↩︎
Qwen/Qwen2.5-7B-Instruct — tokenizer_config.json — domyślny komunikat systemowy szablonu czatu: „You are Qwen, created by Alibaba Cloud. You are a helpful assistant.” ↩︎
Qwen/Qwen3-4B — tokenizer_config.json — szablon czatu bez domyślnego komunikatu systemowego. ↩︎
Qwen/Qwen3.5-4B — tokenizer_config.json — szablon czatu bez domyślnego komunikatu systemowego. ↩︎
AMD — AMD Highlights Future of High-Performance and Adaptive Computing During Opening Keynote of CES 2023 — 4 stycznia 2023: „AMD also unveiled Ryzen AI Technology – the first dedicated artificial intelligence hardware in an x86 processor.” ↩︎
Kernel Newbies — Linux 6.14 — wydany w poniedziałek 24 marca 2025; „an amdxdna driver for AMD NPUs”. ↩︎
FastFlowLM v0.9.35 release notes — 11 marca 2026: „The wait is finally over… FastFlowLM is officially available natively on Linux!” ↩︎ ↩︎
AMD — Ryzen AI Software release notes — znane problemy: „Model generation is not supported on Linux in this release.” ↩︎
TOP500 — June 2026 — „LineShine debuts as the new No. 1 system, ending El Capitan’s run atop the list”; El Capitan „is based on AMD 4th generation EPYC processors… and AMD Instinct MI300A accelerators”. ↩︎
LLNL — TOSS: Speeding Up Commodity Cluster Computing — „a fully functional cluster operating system, based on Red Hat Linux”. ↩︎
AMD — Alveo V70 — „the first Alveo production card leveraging AMD XDNA architecture with AI Engines… designed for AI inference efficiency”. ↩︎
Linux — accel/amdxdna: Add basic support for AIE4 devices — „Add initial support for AIE4 devices (PCI device IDs 0x17F2 and 0x1B0B), including… SR-IOV enablement”. Tabela sterownika daje wpisy funkcji wirtualnych tylko tym częściom; NPU tego laptopa to
17f0. ↩︎AMD — AMD Unveils Next-Gen „Zen 5” Ryzen Processors to Power Advanced AI Experiences — Computex, 2 czerwca 2024: „AMD Ryzen AI 300 Series Processors Unlock Transformational AI Experiences for Windows Copilot+ PCs”. ↩︎
Engadget — Microsoft’s Copilot+ AI PC plan fizzled, but it still served a purpose — 5 grudnia 2025: systemy Copilot+ „made up just 2.3 percent of Windows machines sold in the first quarter of 2025”; „only one of its new AI capabilities actually requires an NPU”. ↩︎
Windows Latest — Microsoft admits its end of support was the real Windows 11 sales driver — 31 lipca 2026, cytując konferencję wynikową Microsoftu: „Windows OEM and Devices revenue decreased 7%… driven by lower PC market demand”; „roughly 30% of the installed base still on Windows 10”. ↩︎
TensorFlow — Install TensorFlow with pip — „TensorFlow 2.10 was the last TensorFlow release that supported GPU on native-Windows.” ↩︎
vLLM — GPU installation — „vLLM does not support Windows natively”. ↩︎
JAX — Installation — pakiety CPU dla „Windows, x86_64 (experimental)”; sekcje GPU dla NVIDIA, Google Cloud TPU, Maca i „AMD GPU (Linux)”. ↩︎
Microsoft — Comparing WSL versions — „the use of an actual Linux kernel inside a managed VM”. ↩︎
AMD — AMD Unveils Strategy to Lead the $1 Trillion Compute Market and Accelerate Next Phase of Growth — Financial Analyst Day, 11 listopada 2025: „AMD is uniquely positioned to lead the next generation of high-performance and AI computing”; „AMD has expanded its AI PC portfolio 2.5x since 2024”; „AMD delivers full-stack AI solutions”. ↩︎