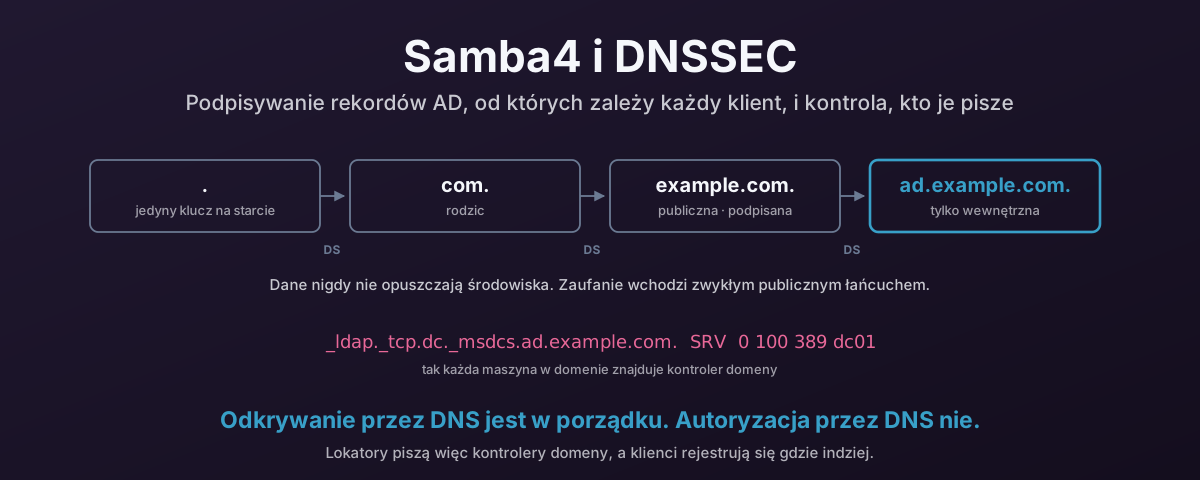
Każda maszyna w domenie Active Directory znajduje swój kontroler domeny, pytając DNS. Nie z skonfigurowanej listy. Pyta o rekord SRV i idzie tam, dokąd odeśle ją odpowiedź. To sprawia, że garstka rekordów pod _msdcs jest najbardziej krytyczną dla bezpieczeństwa rzeczą w strefie, i rodzi dwa pytania warte porządnej odpowiedzi: jak je podpisać i kto ma prawo je zapisywać. Żadnego z nich nie zadaje się często, a na oba domyślnie odpowiada się źle.
Ten wpis odpowiada na oba dla kontrolera domeny Samba4. BIND z dlz_bind9 serwujący katalog, inline signing, ukryty serwer główny (hidden primary), do którego żaden klient nigdy nie dociera, delegacja wewnątrz publicznej strefy, żeby łańcuch zaufania sięgał korzenia, i dynamiczne aktualizacje klientów trzymane z dala od lokatorów.
Ale podpisywanie jest coś warte tylko wtedy, gdy wiesz, co chroni, a to znaczy zacząć poziom niżej: od tego, jak w ogóle rozwiązuje się nazwę. Pierwsza jedna trzecia to więc zejście od korzenia. Jeśli znasz to na pamięć, przeskocz do Dwa backendy DNS w Sambie.
Resolver na starcie nie wie prawie nic
Warto jasno powiedzieć, z jak małą wiedzą rodzi się resolver, bo cała reszta tego wpisu z tego wynika.
Świeżo zainstalowany resolver rekurencyjny wie dwie rzeczy. Zna adresy serwerów głównych: plik podpowiedzi, trzynaście nazw od a.root-servers.net do m.root-servers.net, serwowanych przez anycast z dużo większej liczby instancji niż trzynaście. I, jeśli waliduje, zna jeden klucz publiczny: klucz korzenia.
To cała wbudowana konfiguracja. Każdy inny fakt, jaki kiedykolwiek poda, czyli które serwery są autorytatywne dla uk, gdzie mieszka twoja domena, jaki adres ma twój serwer poczty, zdobywa w czasie działania, pytając, a potem trzyma w pamięci podręcznej, aż wygaśnie TTL.
To dobry projekt. Nikt nie musi dostarczać listy serwerów nazw całego internetu, a żadna centralna strona nie musi zatwierdzać zmiany w twojej strefie. Ale ma konsekwencję, o której jest reszta tego wpisu: resolver wierzy w to, co mu powie serwer, na który wskazała poprzednia odpowiedź. Zabierz podpisy, a cała konstrukcja to łańcuch twierdzeń, z których każde jest uwierzytelnione tylko tym, że przyszło z adresu wskazanego w ostatniej odpowiedzi. To spory ciężar jak na adres zwrotny.
Zejście w dół drzewa
Wyszukanie to nie jedno pytanie. To seria odesłań w dół drzewa nazw, a każdy krok to osobne zapytanie do innego serwera.
Powiedzmy, że klient chce dc01.ad.example.co.uk. Resolver z pustą pamięcią podręczną robi tak:
- Pyta serwer główny. Korzeń nie zna odpowiedzi i nie udaje, że zna. Zwraca odesłanie (referral): pustą sekcję odpowiedzi, a w sekcji authority rekordy
NSdlauk, z adresami tych serwerów nazw jako glue w sekcji additional. - Pyta serwer
uk. Kolejne odesłanie, tym razem do serwerów nazw dlaexample.co.uk. - Pyta serwer
example.co.uk. Jeśliad.example.co.ukjest delegowana, a w projekcie z dalszej części wpisu jest, to jeszcze jedno odesłanie. - Pyta serwer
ad.example.co.uk. Ten jest autorytatywny dla nazwy, więc odpowiada rekordemAi ustawia bit AA (odpowiedź autorytatywna).
Trzy rzeczy w tym zejściu mają znaczenie później.
Odesłanie jest delegacją. Strefa nadrzędna nie przechowuje zawartości strefy podrzędnej. Przechowuje rekordy NS mówiące „zapytaj tam”, a gdy w grę wchodzi podpisywanie, rekord DS mówiący „a oto odcisk klucza, którego masz się spodziewać, kiedy zapytasz”. Delegacja to jedyny mechanizm strukturalny, jaki ma DNS, i to jego użyjesz, żeby strefa wewnętrzna została wewnętrzna.
Prawie wszystko to trafia do pamięci podręcznej. Odesłania z korzenia i TLD mają długie TTL, więc rozgrzany resolver przeskakuje od razu do kroku trzeciego albo czwartego. Dlatego pamięć podręczna resolvera jest warta ataku: zatruj jeden wpis, a przekierujesz wszystko pod nim na tyle, na ile pozwoli wybrany przez ciebie TTL.
Pełna nazwa nie trafia do każdego serwera. Przy minimalizacji QNAME resolver pyta korzeń tylko o uk, nie o dc01.ad.example.co.uk. Warto wiedzieć, jeśli kiedyś będziesz szukać swoich wewnętrznych nazw w logu zapytań gdzieś wyżej. Nie powinno ich tam być.
Stub, rekurencyjny, autorytatywny
Trzy słowa używane zamiennie, które oznaczają zupełnie różne zadania. To rozróżnienie dźwiga połowę tego wpisu poświęconą Active Directory, więc warto je przybić.
| Co robi | Schodzi po drzewie? | Trzyma dane strefy? | |
|---|---|---|---|
| Resolver stub | Biblioteka lub lokalna usługa, którą wołają twoje aplikacje. Pyta jeden skonfigurowany serwer i bierze odpowiedź. | Nie | Nie |
| Forwarder | Przekazuje zapytania do innego resolvera, zapamiętuje odpowiedzi. | Nie | Nie |
| Resolver rekurencyjny | Robi powyższe zejście, zapamiętuje każdy krok, opcjonalnie waliduje podpisy. | Tak | Nie |
| Serwer autorytatywny | Odpowiada za strefy, które dostał, i tylko za nie. O wszystkim innym mówi „nie wiem”. | Nie | Tak |
Ważny jest ostatni wiersz. Serwer autorytatywny nie ma czego szukać w rekursji, a resolver rekurencyjny nie ma czego szukać w byciu autorytatywnym. Połączenie ich daje maszynę, która zarazem przyjmuje dowolne pytania od klientów i trzyma dane, od których ci klienci zależą, czyli dokładnie taką maszynę, jaką twój kontroler domeny nie powinien być.
Na współczesnym linuksowym desktopie jest jeszcze jedna warstwa, o której warto wiedzieć. systemd-resolved uruchamia nasłuch stuba na adresie pętli zwrotnej i zapisuje resolv.conf wskazujący na samego siebie, z options edns0 trust-ad. To trust-ad jest tu ważne: każe stubowi wierzyć bitowi AD (authenticated data) w odpowiedziach od tego serwera. Bit AD sam w sobie niczego nie dowodzi. To twierdzenie resolvera wyżej, że on zwalidował. Ufanie mu ma sens, gdy resolver jest twój, a droga do niego godna zaufania, a poza tym nic nie znaczy.
Jak naprawdę znajduje się usługi
Rekord A odpowiada na jedno pytanie: jaki adres ma ta nazwa. Nie mówi nic o tym, na jakim porcie jest usługa, który z kilku serwerów preferować ani co zrobić, gdy pierwszy leży.
Rekordy SRV odpowiadają na wszystkie trzy. Według RFC 2782 ich kształt to:
_service._proto.name. TTL IN SRV priority weight port target
Każde pole zarabia na swoje miejsce:
- Przedrostki z podkreślnikiem trzymają etykiety usług we własnej przestrzeni nazw.
_tcpnigdy nie zderzy się z hostem, który naprawdę nazywa siętcp, bo nazwa hosta nie może zaczynać się od podkreślnika. - Priorytet to kolejność przełączania awaryjnego: niższy próbuje się pierwszy. Serwery z wyższym numerem priorytetu używane są tylko wtedy, gdy wszystko poniżej jest nieosiągalne.
- Waga dzieli obciążenie w ramach jednego priorytetu. Para z wagą 100 i 300 dostaje mniej więcej jedną czwartą i trzy czwarte klientów. To losowanie proporcjonalne, nie round-robin.
- Port uwalnia usługę od dobrze znanego numeru, i tak klient znajduje serwer LDAP na 3268 bez tego, żeby ktoś go wpisał na sztywno.
- Cel musi być nazwą z rekordami
AlubAAAA. RFC 2782 mówi wprost, że nie może to być CNAME, a pojedynczy cel.oznacza „ta usługa celowo nie jest tu oferowana”, co bywa przydatne do opublikowania z rozmysłem.
To sprawia, że domenę się lokalizuje, a nie konfiguruje. Maszyna dołączona do domeny nie ma listy twoich kontrolerów domeny. Ma nazwę domeny i pyta.
Nazwy, które publikuje Active Directory
Domena AD to z punktu widzenia klienta w większości zestaw rekordów SRV. Ciekawe jest drzewo pod _msdcs, bo tak klienci odróżniają „serwer LDAP” od „kontrolera domeny dla tej domeny” i od „wykazu globalnego dla tego lasu”:
| Nazwa | Kto o nią pyta |
|---|---|
_ldap._tcp.<domain> | Wszystko, co chce LDAP w domenie |
_ldap._tcp.dc._msdcs.<domain> | Lokalizacja kontrolera domeny, ta najważniejsza |
_ldap._tcp.pdc._msdcs.<domain> | Konkretnie emulator PDC |
_ldap._tcp.gc._msdcs.<forest> | Wykaz globalny |
_kerberos._tcp.<domain>, _kerberos._udp.<domain> | Lokalizacja KDC, zanim istnieje jakikolwiek bilet |
_kpasswd._tcp.<domain>, _kpasswd._udp.<domain> | Zmiany haseł |
_ldap._tcp.<site>._sites.dc._msdcs.<domain> | Lokalizacja według lokacji: znajdź DC, który jest blisko |
Popatrz, do czego służy ta lista. Uwierzytelnianie Kerberos nie może się zacząć, dopóki klient nie znajdzie KDC, a KDC znajduje przez DNS. Lokalizacja według lokacji oznacza, że odpowiedź decyduje też, w którym centrum danych klient się uwierzytelnia.
Ta sama idea, unowocześniona
SRV ma następcę, o którym warto wiedzieć. Rekordy SVCB i HTTPS (RFC 9460) uogólniają ten wzorzec: parametry usługi w DNS, w tym ALPN, port i podpowiedzi adresów, w jednym rekordzie. Tak przeglądarka uczy się iść prosto na HTTP/3 bez przekierowania. Rekord HTTPS jest już szeroko wdrożony. Mechanizm jest w duchu taki sam jak SRV: klientowi mówi DNS, jak dotrzeć do usługi. Co znaczy, że argument z następnej sekcji dotyczy go w tym samym stopniu.
Wszystko po wyszukaniu ufa wyszukaniu
Tu jest punkt zwrotny, i to z jego powodu wpis o DNS ma sekcję o bezpieczeństwie, a nie odwrotnie.
Maszyna w domenie startuje i pyta, gdzie jest kontroler domeny. Dostaje nazwę i port. Łączy się tam i dopiero wtedy zaczyna robić wszystko to, co zwykle uważamy za warstwę bezpieczeństwa: Kerberos, podpisywanie LDAP, channel binding, walidację certyfikatów.
Co więc się stanie, jeśli odpowiedź była kłamstwem?
Warto być tu uczciwym, bo odpowiedź to nie „natychmiastowa katastrofa”. Kerberos zaprojektowano z wzajemnym uwierzytelnianiem właśnie po to, żeby klient nie był zdany na łaskę swojego wyszukania nazwy: host, który nie potrafi przedstawić biletu usługi dla nazwy, o którą pytał klient, nie dokończy wymiany. Dostań odpowiedź SRV wskazującą maszynę bez klucza w domenie, a przy ściśle skonfigurowanym kliencie to się nie uda.
Realne szkody są subtelniejsze i siedzą w szczelinach wokół tego:
- Obniżenie (downgrade). Klient, który przy niedziałającym Kerberosie wraca do NTLM, właśnie został oddany temu, kto odpowiedział.
- Relay i wymuszanie (coercion). Atakujący nie musi być kontrolerem domeny. Wystarczy być nazwą, z którą łączy się klient, żeby zacząć przekazywać to uwierzytelnienie tam, gdzie się przyda.
- Odmowa usługi, która wygląda na awarię. Skieruj
_ldap._tcp.dc._msdcsna coś, co nie odpowiada, a domena będzie sporadycznie zepsuta w sposób, którego przez dłuższy czas nikt nie zdiagnozuje jako DNS. - Wszystko, co nie ma w ogóle wzajemnego uwierzytelniania. Synchronizacja czasu, syslog, monitoring, agenci kopii zapasowych, ta wewnętrzna rzecz po HTTP z
verify=False. W wielu środowiskach jest tego więcej, niż ktokolwiek chciałby przyznać.
Ogólna zasada jest tym, co warto stąd wynieść: DNS to mechanizm odkrywania, nie mechanizm autoryzacji. Znajdowanie usługi po nazwie jest całkowicie rozsądne. Przyznawanie czegokolwiek na podstawie nazwy nie jest, a liczba systemów, które po cichu to robią (listy dozwolonych oparte na PTR, ACL po nazwach hostów, „jest w sieci wewnętrznej, więc musi być nasze”), to właściwa powierzchnia ataku.
Co DNSSEC naprawia, a czego nie
DNSSEC istnieje, żeby odpowiedzieć na jedno pytanie: czy ta odpowiedź naprawdę przyszła ze strefy, do której należy nazwa, i to bez zmian?
Działa (RFC 4033 i dwa następne) przez podpisywanie i przez wiązanie podpisów w łańcuch aż do czegoś, czemu już ufasz:
- Każdy RRset w podpisanej strefie ma
RRSIG, czyli podpis nad tym zbiorem. - Klucze publiczne strefy są publikowane jako
DNSKEY. - Strefa nadrzędna publikuje rekord
DS: skrót klucza strefy podrzędnej. - Ten
DSjest sam podpisany przez strefę nadrzędną, której klucz jest zahaszowany wDSjej rodzica, i tak aż do korzenia, a klucz korzenia to jedyna rzecz, z którą twój resolver przyszedł na świat.
Zaprzeczenie też jest podpisane, co łatwo przeoczyć, a znaczy więcej, niż się wydaje. Bez tego „nie ma takiej nazwy” to nieuwierzytelniona odpowiedź, którą atakujący może sfałszować, żeby coś zniknęło. NSEC i NSEC3 dają uwierzytelnione „między tymi dwiema nazwami nic nie istnieje”.
To prawdziwa poprawka prawdziwego problemu. Zatruwanie pamięci podręcznej nie jest teorią: atak Kaminsky’ego tak potanił podszywanie się spoza ścieżki, że wymusił awaryjne łatanie w całym internecie, a środki zaradcze, które przyszły potem (losowanie portu źródłowego, mieszanie wielkości liter 0x20), to wszystko próby utrudnienia zgadywania, a nie uczynienia odpowiedzi weryfikowalnymi. Późniejsze prace nad kanałami bocznymi raz po raz je podgryzały. Podpisy to jedyna rzecz na tej liście, która zmienia zasady gry, a nie tylko podnosi cenę.
Teraz uczciwe granice, bo DNSSEC jest przeceniany w obie strony.
To nie jest poufność. Podpisywanie to uwierzytelnianie kluczem publicznym; każde zapytanie i odpowiedź nadal idą otwartym tekstem po kablu. Prywatność na odcinku klienta to DoT, DoH albo DoQ, a to inny mechanizm rozwiązujący inny problem. Szyfrowanie odcinka do resolvera, który nie waliduje, kupuje ci prywatną rozmowę z czymś, co wciąż można okłamać.
Nie waliduje znaczenia, tylko pochodzenie. DNSSEC dowodzi, że opublikował to właściciel strefy. Jeśli rekord jest błędny, złośliwy albo zapisał go ktoś, komu strefa nierozważnie na to pozwoliła, podpis zostanie nałożony na niego równie wiernie. Podpisanie strefy, którą mogą zapisywać niezaufane maszyny, nie czyni jej zawartości wiarygodną. Uwierzytelnia kłamstwo. Zapamiętaj to zdanie; ostatnia jedna trzecia tego wpisu to w zasadzie jego konsekwencja.
Pomaga tylko wtedy, gdy ktoś waliduje. Jeśli twój resolver nie waliduje, podpisy na strefach, o które pytasz, to dekoracja. A jeśli walidacja dzieje się na resolverze po drugiej stronie sieci od klienta, klient ufa bitowi AD i drodze; patrz trust-ad wyżej.
I trzeba go utrzymywać. Wygasły podpis to nie pogorszona odpowiedź, to SERVFAIL: nazwa gaśnie. DS u rodzica, który już nie pasuje do klucza dziecka, robi to samo. To uczciwy koszt, i jako taki automatyzacja z następnych sekcji znaczy więcej niż samo pierwsze podpisanie.
Dlaczego wymyślonej wewnętrznej TLD nie da się podpisać
Tu decyzje o nazwach sprzed lat wracają z rachunkiem, i warto to rozpisać, bo to z tego powodu projekt w tym wpisie używa prawdziwej, posiadanej domeny dla nazw wewnętrznych.
Spójrz jeszcze raz, jak buduje się łańcuch: za klucz strefy ręczy rekord DS u jej rodzica. Walidujący resolver może więc uwierzytelnić strefę wewnętrzną tylko wtedy, gdy ta strefa ma rodzica, który chce i może opublikować dla niej DS.
ad.corp.local nie ma takiego rodzica. Nie ma go też .lan, .home ani nic innego wymyślonego w dniu, w którym zakładano domenę:
.localjest zarezerwowane dla mDNS. Używanie go do unicastowego DNS to nie tylko brak podpisu, to udokumentowana kolizja z tym, jak ma prawo zachowywać się każdy system operacyjny w budynku. Dostaje poniżej własną sekcję, bo to zupełnie inna liga niż pozostałe trzy..lan,.corp,.hometo niezarejestrowane ciągi znaków. Nie ma rodzica, który mógłby trzymaćDS, a wersje, o które wnioskowano, wstrzymano od delegacji z powodu bałaganu z kolizjami nazw w prywatnych środowiskach.home.arpajest porządnie zarezerwowane dla sieci domowych, co brzmi idealnie, ale jego delegacja jest celowo niezabezpieczona. Nie ma do niego podpisanej ścieżki, z założenia..internalICANN odłożył właśnie do tego zastosowania, i to rozwiązuje problem kolizji. Nie rozwiązuje tego: brak delegacji to brakDS, czyli brak łańcucha.
Twoje opcje przy wewnętrznej strefie bez łańcucha to zostawić ją niepodpisaną albo skonfigurować lokalną kotwicę zaufania na każdym walidującym resolverze w środowisku i zostać korzeniem własnej prywatnej wyspy: klucz, który musisz teraz rozprowadzać, monitorować i wymieniać ręcznie, na każdym resolverze, na zawsze, z SERVFAIL w całej domenie jako trybem awarii.
Jest dużo łatwiejsza odpowiedź, i to darmowa: zrób ze strefy wewnętrznej delegację wewnątrz publicznej strefy, którą już masz i już podpisujesz. ad.example.com, delegowana z example.com. DS idzie do publicznego rodzica. Każdy walidujący resolver w środowisku uwierzytelnia wtedy nazwy wewnętrzne kotwicą zaufania, którą już ma, a ty nic nie rozprowadzasz.
Zawartość zostaje w środku. Tylko zaufanie przychodzi z zewnątrz. To rozróżnienie jest projektem z reszty tego wpisu.
.local to nie kwestia gustu
Jedna z tych czterech zasługuje na własną sekcję, bo to tej ludzie bronią, a obrona jest zawsze ta sama: działa, używamy tego od lat, w czym problem.
Problem w tym, że .local to nie niezarejestrowany ciąg, który ktoś kiedyś może sprzedać. To przestrzeń nazw, która już ma właściciela i zdefiniowane zachowanie, a to zachowanie to nie „zapytaj serwer DNS”. RFC 6762 §3 nie owija w bawełnę:
Any DNS query for a name ending with “.local.” MUST be sent to the mDNS IPv4 link-local multicast address 224.0.0.251 (or its IPv6 equivalent FF02::FB).
Przeczytaj, czym naprawdę rządzi to MUST. To nie twierdzenie o tym, kto jest właścicielem ciągu. To instrukcja, dokąd idzie zapytanie, a odpowiedzią jest grupa multicastowa na lokalnym łączu, nie twój kontroler domeny. Ta sama sekcja mówi, że nazwy pod .local są „meaningful only on the link where they originate”, czyli to DNS-owy odpowiednik adresu 169.254.
Klient, który poprawnie trzyma się specyfikacji, nigdy nie zapyta twojego serwera DNS o nazwę .local. Krzyczy na kablu i bierze to, co odpowie.
Daje to zestaw awarii o bardzo szczególnym smaku:
- Rozwiązywanie zależy od klienta, nie od twojego DNS. macOS rozwiązuje
.localprzez Bonjour, i zawsze tak robił;systemd-resolveddomyślnie kieruje domenęlocaldo mDNS; Windows robi mDNS od Windows 10. Trzy stosy, trzy zestawy reguł, a twojego pliku strefy nie pyta żaden z nich. - Kończy się na pierwszym routerze. mDNS jest z założenia ograniczony do łącza. Nazwa, która rozwiązuje się przy biurku w tym samym VLAN-ie, nie rozwiązuje się z innego piętra, innej lokacji ani przez VPN, i to jest zgłoszenie „działa w biurze, nie działa w domu”, zamykane cztery razy jako „problem z siecią”, zanim ktoś przeczyta specyfikację.
- Zachowanie zmienia się pod tobą. To, czy dana maszyna próbuje najpierw multicastu, najpierw unicastu czy obu równolegle, zależy od stosu resolvera i jego wersji. Środowiska, które jechały na
.local„bez problemu od lat”, to zwykle te, w których aktualizacja dystrybucji jeszcze nie zmieniła kolejności. - Dowodów nie ma tam, gdzie ich szukasz. Log zapytań DC nic nie pokazuje, bo nic nie dotarło. Ludzie spędzają dni na serwerze, a zapytanie nigdy nie opuściło klienta.
- I nie da się tego podpisać, o co w tej sekcji chodzi. Brak rodzica, brak
DS, brak łańcucha, brak sposobu, by go opublikować.
Teraz połóż to pod domeną Active Directory. Realm wywodzi się z nazwy domeny. Principale usług wywodzą się z realmu. Lokatory _msdcs, czyli rekordy, o których jest cały ten wpis, siedzą pod sufiksem, który zgodny ze specyfikacją klient musi rozwiązywać, krzycząc na lokalnym segmencie. Budujesz Kerberosa na przestrzeni nazw, którą połowa twojego środowiska rozwiązuje protokołem zaprojektowanym do szukania drukarek.
A wyjście jest drogie, i to dlatego warto podejść do pierwotnej decyzji bez sentymentów. W Sambie nie ma zmiany nazwy w miejscu. Udokumentowana ścieżka to samba-tool domain backup rename, a potem odtworzenie: robisz kopię bazy pod nową nazwą, zasiewasz z niej nowy DC i dodajesz od zera każdy inny DC, bez żadnego nakładania się DC ze starą i nową nazwą. To nie windowsowy rendom, który przynajmniej przechodzi przez DC po kolei. To przebudowa z ładniejszą nazwą.
Uczciwe podsumowanie jest więc takie. .local dla domeny unicastowej to nie preferencja, konwencja ani nieszkodliwa pozostałość. To udokumentowany konflikt z protokołem, który jest domyślnie włączony w każdym systemie operacyjnym w budynku, a rachunek przychodzi po latach jako sporadyczne, nie do odtworzenia awarie rozwiązywania nazw, a kiedy w końcu chcesz podpisać strefę, jako przebudowa domeny.
Ten sam błąd w innym kapeluszu
Skoro już tu jesteśmy: port 5353.
mDNS nasłuchuje na UDP 5353, i to nie jest zapasowy port, który akurat jest wolny. Postawienie na nim zwykłej unicastowej usługi DNS albo kierowanie resolverów na :5353, bo 53 był zajęty albo wymagał roota, robi tę samą szkodę od drugiej strony: każda maszyna świadoma mDNS w tym segmencie rozmawia teraz z twoją usługą nazw, a twoja usługa nazw obsługuje multicastowe odkrywanie usług, na które nigdy nie miała odpowiadać. Nazwa i port to dwie połowy jednej przestrzeni nazw, i obie już do kogoś należą.
.local na 53 albo unicastowy DNS na 5353. To samo nieporozumienie, ta sama klasa sporadycznych awarii, te same tygodnie cudzego czasu.
I bądź uczciwy co do tego, co to mówi
Microsoft zalecał .local w czasach Small Business Server, dlatego tyle środowisk wciąż je nosi, i przestał to zalecać dawno temu. Odziedziczenie domeny .local to pech. Większość czytających to osób, które ją mają, nie wybrała jej, a sekcja wyżej to plan migracji, nie oskarżenie.
Wdrożenie takiej domeny to zupełnie inna sprawa, i będę o tym mówił bez ogródek, bo łagodzenie tego nikomu nie pomogło.
Każdy, kto wdraża .local dla Active Directory albo dla zwykłego unicastowego DNS, albo stawia usługę DNS na porcie 5353, nie jest profesjonalistą IT. Może mieć taki tytuł na stanowisku. Nie wykonuje tej pracy. RFC 6762 jest opublikowane od 2013 roku, czyta się je w dwadzieścia minut, a zdanie, które rozstrzyga całą sprawę, jest w sekcji 3. Zbudowanie firmowej usługi nazw na przestrzeni, którą specyfikacja rezerwuje dla multicastu ograniczonego do łącza, to nie jest decyzja inżynierska, której da się bronić. To zgadywanie w tej jednej części stosu, gdzie zgadywanie daje awarie, których nikt nie umie odtworzyć, a wszyscy zwalają na sieć.
Taka osoba powinna zostać usunięta z twojego działu IT. Nie przesunięta w bok, nie posadzona przy DNS pod nadzorem. Usunięta z tej funkcji. Ta rola istnieje po to, żeby wiedzieć, który pakiet idzie dokąd i z czyjego upoważnienia. Ktoś, kto nie przeczytał dokumentu rządzącego przestrzenią nazw wybraną przez siebie dla każdej maszyny w budynku, tej roli nie pełni, a zostawienie go w niej znaczy, że następna decyzja tej wagi zapadnie w ten sam sposób.
I każdy system, którego dotknęła, trzeba przeaudytować. Tę część ludzie pomijają, a ona liczy się najbardziej. Taka decyzja nigdy nie jest odosobniona. Ktoś, kto przed nazwaniem domeny nie sprawdził RFC 6762, nie sprawdził też niczego innego, więc idź i zobacz, co jeszcze zbudował. Spodziewaj się znaleźć:
- Serwery DNS otwarte na świat, forwardery odpowiadające każdemu, kto zapyta, i żadnych ACL nigdzie.
- Dynamiczne aktualizacje szeroko otwarte i kontenery stref z uprawnieniami, których nikt nie przeglądał od założenia domeny.
- Certyfikaty i Kerberosa zbudowane na nazwach, które nigdy nie miały rozwiązywać się spójnie, z awariami zaklejonymi plikami hosts.
- Pliki hosts. Wszędzie. Całe środowiska trzymały się na nich właśnie dlatego, że
.localnigdy porządnie nie działało, a ktoś znalazł obejście zamiast przyczyny. - Reguły zapory i konta usług utworzone, żeby zniknęły objawy, wciąż na miejscu, wciąż dające więcej, niż ktokolwiek dziś pamięta.
To nie mściwość. Do tego właśnie służy sygnał kompetencji. Kiedy znajdziesz jedną decyzję podjętą bez przeczytania specyfikacji, właściwa reakcja to założyć, że pozostałe zapadły tak samo, i iść sprawdzić, bo ta sama osoba konfigurowała twoje uwierzytelnianie, twoje certyfikaty i twoją kontrolę dostępu, a ty masz teraz bezpośredni dowód, jak podchodzi do problemu, którego w pełni nie rozumie.
Odziedziczenie tego bałaganu kosztuje cię migrację. Zatrudnianie osoby, która wciąż go tworzy, kosztuje cię znacznie więcej.
Dwa backendy DNS w Sambie
Kontroler domeny Samba AD trzyma swoje dane DNS w samym katalogu, i są dwa sposoby, żeby je serwować.
SAMBA_INTERNAL to własny serwer DNS Samby, wbudowany w AD DC. Obsługuje strefy AD i dynamiczne aktualizacje uwierzytelnione Kerberosem, a wszystko inne oddaje do forwardera. Samba opisuje go jako obsługujący „the basic feature required in an AD” i zaleca go „for simple DNS setups”, co jest uczciwe i warte potraktowania dosłownie. Dostaje poniżej własną sekcję, bo lista tego, czego nie robi, jest dłuższa i ciekawsza niż lista tego, co robi.
BIND9_DLZ uruchamia BIND jako serwer DNS, z załadowanym do niego modułem Samby dlz_bind9. DLZ, czyli Dynamically Loadable Zones, to interfejs BIND do oparcia strefy na czymś innym niż plik strefy. Moduł odpowiada na zapytania BIND prosto z sam.ldb, więc nie ma kopii, kroku eksportu ani synchronizacji, która mogłaby się rozjechać: BIND czyta katalog w trakcie serwowania.
Wewnętrzny serwer DNS nie robi rekursji, bo nie potrafi
Zacznij od rzeczy, którą niemal zawsze opisuje się źle, także ludzie, którzy go używają.
„DC jest naszym serwerem DNS, robi rekursję dla klientów” to nie to, co się dzieje, bo wewnętrzny serwer DNS w ogóle nie potrafi robić rekursji. Własna lista funkcji Samby mówi to wprost. Wewnętrzny DNS nie obsługuje:
- działania jako resolver z pamięcią podręczną
- zapytań rekurencyjnych (ale może przekazywać do innego rekurencyjnego serwera nazw)
- podpisów transakcji ze wspólnym kluczem (TSIG)
- stref stub
- transferów stref
- równoważenia obciążenia Round Robin między DC
a scavenging i warunkowe forwardery są wymienione jako również niezaimplementowane.
Przeczytaj dwie pierwsze pozycje razem, bo to cała historia. Nie potrafi rozwiązywać i nie potrafi zapamiętywać. To, co naprawdę kupuje ci dns forwarder, to przekaźnik: klient pyta DC o windowsupdate.com, DC pyta prawdziwy resolver, odpowiedź wraca przez DC, a potem DC całkowicie o niej zapomina. Następny klient zadaje to samo pytanie i wszystko dzieje się od nowa.
Wróć do tabeli z początku wpisu i zobacz, co to jest: forwarder bez pamięci podręcznej forwardera. Ma koszty tej roli (dodatkowy skok, zależność, kolejna rzecz, która może leżeć) i żadnej z jej korzyści.
DC z SAMBA_INTERNAL, który obsługuje środowisko, nie jest więc serwerem DNS w tym sensie, jaki ludzie mają na myśli. To proxy bez pamięci podręcznej przed prawdziwym resolverem, a ty postawiłeś je na maszynie, która trzyma twój katalog.
Dlaczego to ryzyko, a nie tylko nieefektywność
Nieefektywność łatwo zobaczyć: każde zewnętrzne wyszukanie w budynku staje się na stałe podróżą w obie strony przez AD DC, bez pamięci podręcznej, która by to złagodziła. W cichej domenie nikt tego nie zauważa. Właśnie dlatego to przetrwa.
Argument bezpieczeństwa jest tym, który warto postawić, i ma trzy części.
Nasłuch jest w złym procesie. Wewnętrzny DNS to zadanie usługowe samego AD DC, działające z uprawnieniami katalogu, a nie osobny demon na własnym koncie, jak named. Rzecz, która parsuje nieuwierzytelniony UDP od wszystkiego, co dosięgnie portu 53, działa więc w procesie, który serwuje LDAP i Kerberosa i jest właścicielem sam.ldb. BIND ma za sobą trzydzieści lat wrogiej uwagi, dedykowanego użytkownika i zwyczaj uruchamiania w więzieniu (jail), właśnie dlatego, że nasłuch DNS to podła okolica. Wewnętrzny serwer Samby to funkcja dla wygody, która akurat mieszka w klejnotach koronnych.
Obsługiwanie klientów oznacza bycie osiągalnym dla klientów. Żeby być serwerem DNS środowiska, musi przyjmować zapytania od każdej stacji roboczej, każdej drukarki, każdego laptopa podwykonawcy w gościnnym VLAN-ie, który ktoś przypadkiem zmostkował. To duża, stale otwarta, nieuwierzytelniona powierzchnia ataku na najcenniejszym hoście, jaki masz, a utrzymujesz ją, żeby zaoszczędzić na resolverze, który uciągnęłoby Raspberry Pi.
A forwarder otwarty na świat to cudza broń. DC przekazujący zapytania od każdego, kto pyta, to otwarty forwarder. Gdy tylko da się do niego dotrzeć spoza twojej sieci, staje się uczestnikiem odbić i wzmacniania, co znaczy, że ruch i zgłoszenia nadużyć trafiają do twojego kontrolera domeny. Nie ma ograniczania częstotliwości, po które można by sięgnąć, bo wewnętrzny serwer go nie ma.
Nic z tego nie wymaga podatności w Sambie, żeby było złym pomysłem. To zły pomysł już z samego kształtu: wkłada nieuwierzytelnioną, przypadkiem wystawioną do internetu, ciężką od parsowania usługę do tego samego procesu co twój katalog, żeby robiła pracę, o której dokumentacja mówi, że nie potrafi jej zrobić porządnie.
Padnie szybciej i pociągnie za sobą więcej
Warto jasno powiedzieć, czym ten argument nie jest. To nie twierdzenie, że kod DNS Samby ma więcej błędów niż BIND. BIND ma długą listę CVE, głównie dlatego, że to najdokładniej badana implementacja DNS na świecie, a liczenie biuletynów byłoby kiepskim sposobem wybierania między nimi.
Porównanie, które się liczy, jest strukturalne, i sprowadza się do trzech pytań z trzema niewygodnymi odpowiedziami.
Kto może wysłać mu zniekształcony pakiet? Gdy SAMBA_INTERNAL obsługuje środowisko: każda stacja robocza, każdy telefon w sieci bezprzewodowej, wszystko, co ma trasę do portu 53 na tej maszynie. W projekcie z tego wpisu: podpisujący. Jeden host, jeden klucz TSIG, allow-query ograniczone do niego. To nie mała różnica stopnia. To różnica między wystawioną usługą a taką, do której praktycznie nie da się dotrzeć, i przyćmiewa każdą różnicę w jakości kodu między obiema implementacjami.
Co pada, kiedy on padnie? To pytanie przesądza o wadze. named to osobny demon na własnym koncie; kiedy umiera, DNS staje, a kontroler domeny dalej uwierzytelnia. Wewnętrzny DNS Samby to zadanie usługowe wewnątrz AD DC, więc wszystko, co go zawiesza, wyczerpuje albo wywraca, dzieje się w procesie, który serwuje LDAP i Kerberosa. Problem z DNS staje się awarią katalogu. A systemctl restart named kosztuje sekundę, podczas gdy restart DC to zupełnie inny poranek.
Co możesz z tym zrobić, kiedy to się dzieje? BIND ma ograniczanie częstotliwości odpowiedzi (RRL), allow-query, allow-recursion, blackhole, politykę per widok i opcję nieodpowiadania klientom w ogóle. Wewnętrzny serwer ma dns forwarder i plik logu. Kiedy coś zaczyna go młotkować, nie ma pokrętła, którym można by kręcić.
Do tego dodaj brak pamięci podręcznej. Każde zapytanie klienta to świeża podróż na zewnątrz, więc zalew zapytań kosztuje DC jedno wyszukanie wyżej na pakiet zamiast trafienia w pamięć podręczną, i kosztuje go to w tym samym procesie, który próbuje wydawać bilety Kerberosa. Nie potrzebujesz do tego exploita; wystarczy pracowity poranek, źle zachowująca się aplikacja albo ktoś, kto skieruje skaner na zły VLAN. Gdy to trwa, wygląda jak powolne uwierzytelnianie, a nikt nie wpada na to, żeby spojrzeć na DNS.
Więc tak: nawet z DLZ w obrazku BIND jest tu bezpieczniejszym miejscem. Moduł DLZ rzeczywiście daje named dostęp do danych Samby, i to prawdziwa kwestia, na którą ten wpis już zwrócił uwagę. Ale awaria named to awaria DNS, a nie katalogu, a w tym projekcie ten named w ogóle nie przyjmuje zapytań od środowiska. Błędy są faktem w każdym kodzie. Zasięg rażenia i osiągalność to rzeczy, które wybierasz.
I nie zbuduje projektu z tego wpisu
Jest prostszy, ostateczny powód, dla którego to nie jest tutejszy backend.
Brak transferów stref. Potok z następnej sekcji (ukryty serwer główny, podpisujący, samodzielne serwery autorytatywne) zaczyna się od AXFR z DC. SAMBA_INTERNAL nie ma czym transferować. Brak TSIG też, więc nie ma nawet uwierzytelnienia, którego taki transfer by potrzebował. I brak podpisywania, i brak walidacji czegokolwiek, co przekazuje dalej.
Uczciwe podsumowanie SAMBA_INTERNAL brzmi więc tak: to backend, który pozwala postawić domenę AD w labie w niedzielne popołudnie bez konfigurowania BIND, i robi to bardzo dobrze. Samba mówi „simple DNS setups” i ma to na myśli. To nie resolver, nigdy nie był budowany na usługę DNS dla całego środowiska, a w chwili, gdy chcesz podpisywania, transferów, widoków, ACL, pamięci podręcznej albo ograniczania częstotliwości, odpowiedzią nie jest jego strojenie. On nie ma tych pokręteł. Odpowiedzią jest BIND.
Jeśli dziś go używasz, a każdy klient wskazuje na DC, poprawka nie jest pilna, ale nie jest też opcjonalna: daj klientom prawdziwy walidujący resolver i ustaw dns forwarder na DC tak, żeby wskazywał na niego, wtedy DC odpowiada za własne strefy i za nic więcej.
I tę część chcę postawić jasno, bo „nie używaj DLZ” powtarza się, jakby to była reguła utwardzania: to nie DLZ jest ekspozycją. To mechanizm wydobycia. Liczy się nie to, który moduł jest załadowany do BIND, tylko kto może rozmawiać z tym BIND i co dzieje się dalej ze strefą. BIND z backendem DLZ, który odpowiada wyłącznie na żądanie transferu od twojego podpisującego, nie jest powierzchnią ataku w żadnym ciekawym sensie. DC z SAMBA_INTERNAL, który obsługuje każde wyszukanie nazwy z czterystu laptopów, jak najbardziej nią jest. Tylko jedno z tych dwóch trafia na listy kontrolne utwardzania, i to nie to, które ma znaczenie.
Dwie rzeczy o DLZ są prawdziwe i warto je zaplanować, zamiast się ich bać:
- Moduł jest powiązany z wersją BIND. Samba dostarcza osobny
.sodla każdej wersji BIND, anamed.confwskazuje konkretny. Duża aktualizacja BIND oznacza, że pasujący moduł musi być na miejscu, inaczejnamednie wystartuje. To zależność pakietowa do przetestowania z wyprzedzeniem, a nie cecha bezpieczeństwa. namedpotrzebuje dostępu do danych Samby, dlatego Samba trzyma osobny katalog na te elementy, których potrzebuje BIND, zamiast dawać mu cały katalog prywatny. To uprawnienie ma być wąskie; warto sprawdzić, czy na twoich DC wciąż takie jest, bo to jedyne miejsce, w którym DLZ faktycznie poszerza to, do czego sięgnąłby przejętynamed.
Powodem, dla którego DLZ jest tu właściwym wyborem, jest to, co umożliwia: interfejs DLZ w BIND obsługuje wyliczenie całej strefy, i to sprawia, że transfer strefy z opartej na DLZ strefy jest w ogóle możliwy. Ten transfer to pierwszy skok potoku, i robi go BIND, co znaczy, że reszta potoku to zwykła konfiguracja BIND, a nie nic egzotycznego.
Jest jedno ograniczenie, które kształtuje wszystko dalej, i warto je powiedzieć wprost, bo łatwo założyć inaczej. Strefy DLZ nie da się samej podpisać. ISC mówi to jasno w BIND ARM: DLZ „is unable to handle DNSSEC-signed data due to its limited API”. Nie zawiesisz dnssec-policy na instrukcji dlz i po sprawie.
Co możesz zrobić, i co ISC sugeruje dla DLZ jednym tchem, to uruchomić ją jako ukryty serwer główny, a podpisywanie zostawić zwykłej strefie BIND, która przyjmuje dane transferem. To jest następna sekcja, a to ograniczenie jest powodem, dla którego ma taki kształt.
Warto wiedzieć, że to ograniczenie Samby, a nie prawo Active Directory. Serwer DNS Microsoftu robi podpisywanie online dynamicznych stref zintegrowanych z AD od Windows Server 2012. Strefa jest podpisywana w miejscu, klucze prywatne replikują się do Key Masterów przez samą replikację AD, a dynamiczne aktualizacje dalej działają. Na Windows „podpisz partycje AD” to realna opcja, a odpowiedź na zarzut o częstych zmianach jest wbudowana. (Na Server 2008 R2 tak nie było: dało się podpisać strefę zintegrowaną z AD, ale nie taką, która przyjmuje dynamiczne aktualizacje, a każda zmiana oznaczała ręczne ponowne podpisanie, i stąd bierze się folklor o niepodpisywalnych strefach AD).
Samba nie ma odpowiednika. Żaden backend nie podpisuje: wewnętrzny serwer nie ma DNSSEC w ogóle, a DLZ nie umie nieść podpisanych danych. W Sambie potok transfer i podpis to więc nie jeden projekt z kilku. To jedyna droga.
Potok publikacji
Teraz jego kształt. Cztery role, a DC stoi z tyłu, gdzie nic do niego nie dosięgnie.
named na DC, czy osobny host. Samodzielne serwery autorytatywne to jedyne, co klienci kiedykolwiek widzą, i są serwerami wtórnymi podpisanej strefy.1. Kontroler domeny: ukryty serwer główny. BIND z dlz_bind9, autorytatywny dla stref AD prosto z katalogu. Rekursja wyłączona. Żadnej usługi dla klientów. allow-transfer ograniczone wyłącznie do podpisującego, z TSIG. Z punktu widzenia sieci DC w ogóle nie serwuje DNS, a jedyne, co go kiedykolwiek pyta, to następna maszyna w kolejce.
2. Instancja podpisująca: zwykła strefa BIND, która przyjmuje dane transferem. Tu mieszkają inline-signing i dnssec-policy, na strefie o tej samej nazwie, która trzyma przetransferowaną kopię. BIND trzyma otrzymaną niepodpisaną kopię i publikowaną podpisaną kopię jako osobne rzeczy i podpisuje ponownie, gdy przychodzą nowe transfery. Ponieważ to transfer, a nie wspólny plik, ta instancja może siedzieć na samym DC (drugi named na własnym adresie) albo na osobnym hoście, a konfiguracja jest w obu przypadkach niemal identyczna.
Wymiana jest taka, na jaką wygląda: na DC to o jedną maszynę mniej do utrzymania, a osobny host trzyma klucze prywatne z dala od maszyny z katalogiem. Obu da się bronić, a wybór nie zmienia niczego innego w potoku. Liczy się to, że podpisywanie dzieje się raz, w określonym miejscu, pod polityką kluczy: to różnica między DNSSEC, który utrzymujesz, a DNSSEC, który wygasa o trzeciej w nocy.
3. Serwery autorytatywne: jedyne, co widzą klienci. Zwykłe serwery wtórne podpisanej strefy. Nie trzymają kluczy, nie podpisują i nie mają drogi do katalogu. Jeśli któryś zostanie przejęty, atakujący ma kopię strefy i żadnej możliwości sfałszowania nowego rekordu, który przejdzie walidację.
4. Resolvery. Walidujące resolvery rekurencyjne dla środowiska, które warunkowo przekazują strefy wewnętrzne do tych serwerów autorytatywnych, a po wszystko inne schodzą publicznym drzewem. To na nie wskazuje resolv.conf klientów.
Z tego układu wynikają dwie właściwości, które warto powiedzieć osobno, bo o nie w tym wszystkim chodzi:
- Maszyna trzymająca katalog jest nieosiągalna dla maszyn, które go używają. Kontroler domeny to najcenniejszy host w środowisku. Danie mu usługi sieciowej dla klientów, takiej, która odpowiada na nieuwierzytelniony UDP z każdej stacji roboczej, to kiepska wymiana za usługę, którą mogą wykonywać inne maszyny.
- Podpisywanie dzieje się raz, w określonym miejscu. Zwykły zarzut wobec podpisywania strefy AD to częste zmiany: że zawartość zmienia się zbyt często, by podpisy nadążały. Ten zarzut to tak naprawdę zarzut wobec domyślnego układu, a nie wobec podpisywania. Gdy rejestracja klientów zostanie wyprowadzona, a następna sekcja dowodzi, że musi, strefa AD zmienia się przy promocji lub degradacji kontrolera domeny i poza tym praktycznie nigdy. Strefa zapisywana tylko przez DC to stabilna strefa, a stabilną strefę podpisuje się bez historii. Trzymanie klientów z daleka to nie tylko kontrola bezpieczeństwa; to właśnie robi strefę na tyle cichą, by dało się ją czysto podpisać.
Jak naprawdę jest podłączone podpisywanie
Kształt powyżej jest najważniejszy, ale „zwykła strefa BIND, która przyjmuje dane transferem” zasługuje na pokazanie, a nie opisanie, bo pierwsza próba zwykle rozbija się o podpisywanie DLZ bezpośrednio.
Na DC strona DLZ zostaje celowo nudna. Serwuje katalog, oddaje strefę dokładnie jednemu partnerowi i nie robi nic innego:
key "transfer-to-signer" {
    algorithm hmac-sha256;
    secret "...";
};

options {
    recursion no;
    allow-query { key transfer-to-signer; localhost; };
    allow-transfer { key transfer-to-signer; };
    notify no;
};

dlz "AD DNS Zone" {
    database "dlopen /usr/lib64/samba/bind9/dlz_bind9_18.so";
};
Zauważ, że .so nosi w nazwie główną wersję BIND. To powiązanie z wersją z poprzedniej sekcji w konkretnej postaci: aktualizacja BIND potrzebuje pasującego modułu Samby na miejscu, zanim named wystartuje.
Po stronie podpisującej strefa to zwykły serwer wtórny z dołączonymi opcjami podpisywania. To ta część, która nie może mieszkać na DLZ:
dnssec-policy "ad-internal" {
    keys {
        ksk lifetime P365D algorithm ecdsa256;
        zsk lifetime P90D  algorithm ecdsa256;
    };
};

zone "ad.example.com" {
    type secondary;
    primaries { 192.0.2.10 key transfer-to-signer; };
    file "ad.example.com.axfr";
    inline-signing yes;
    dnssec-policy "ad-internal";
    allow-transfer { key transfer-to-public; };
    also-notify { 192.0.2.20; 192.0.2.21; };
};
To, że działa to na serwerze wtórnym, jest tu szczegółem nośnym, a ARM mówi to wprost:
If
yes, BIND 9 maintains a separate signed version of the zone. An unsigned zone is transferred in or loaded from disk and the signed version of the zone is served with, possibly, a different serial number.
BIND trzyma więc dwie kopie: niepodpisaną, którą otrzymał, zapisaną do file, i podpisaną, którą serwuje, zapisaną obok z rozszerzeniem .signed. Przychodzi transfer, podpisana wersja jest generowana od nowa, a serwery niżej dostają notify, bo w tym miejscu to całkowicie zwyczajna strefa. inline-signing yes jest zresztą domyślne, gdy dołączona jest dnssec-policy; jest wypisane powyżej, bo konfiguracja, która mówi, co robi, jest warta tej linijki.
Wymiana kluczy przychodzi razem z polityką, a nie z zadaniem cron. Wymiany ZSK nie potrzebują żadnego udziału; wymiany KSK potrzebują, żeby nowy DS dotarł do rodzica, i to jest automatyzacja CDS/CDNSKEY z dalszej części wpisu. rndc dnssec -status ad.example.com mówi ci, gdzie w swoim cyklu życia jest każdy klucz.
To, czy ten blok działa na DC, czy na własnym hoście, zależy od tego, na jaki adres wskazuje primaries. Na DC to druga instancja named na drugim adresie, przyjmująca transfer z pierwszej przez pętlę zwrotną albo interfejs zarządzania. To właśnie znaczy w praktyce „BIND z DLZ może być podpisującym”: to samo oprogramowanie, ta sama maszyna, jeśli chcesz, ale podpisywanie dzieje się na przetransferowanej kopii, a nie na strefie DLZ.
Jedyny haczyk operacyjny to notify, i jest po stronie DLZ. Podręcznik ISC mówi o tym bez ogródek: DLZ „has no built-in support for DNS notify”, więc serwery wtórne nie są automatycznie informowane o zmianach w strefach z bazy danych. Samba może zmienić rekord w katalogu, a instancja DLZ nie ma pojęcia, że powinna komuś o tym powiedzieć.
Pierwszy skok to więc odpytywanie, a nie wypychanie. Podpisujący odświeża według timera SOA strefy, którą transferuje, co znaczy, że:
- Propagacja od zmiany na DC do podpisanego, opublikowanego rekordu jest ograniczona tym interwałem odświeżania, a nie sekundami. Wypromuj DC, a jego nowe rekordy
_msdcspojawią się niżej najpóźniej po jednym odświeżeniu. - Ten interwał to pokrętło, jeśli opóźnienie ma znaczenie. To wymiana za to, jak często chcesz odpytywać DLZ, co przywołuje drugą rzecz, którą ISC mówi o DLZ: robi wyszukania w bazie w czasie rzeczywistym bez pamięci podręcznej i jest „not recommended for use on high-volume servers”.
- Obie te rzeczy to argumenty za tą topologią, a nie przeciw niej. Jedynym klientem instancji DLZ jest podpisujący, pytający raz na odświeżenie. Faktyczne obciążenie zapytaniami ze środowiska ląduje na samodzielnych serwerach autorytatywnych, które serwują zwykły podpisany plik strefy z pełną prędkością.
Wszystko za podpisującym jest konwencjonalne: serwery autorytatywne to serwery wtórne podpisanej strefy, dostają porządne notify i nigdy nie dotykają katalogu ani klucza.
Klienci nie mogą zapisywać strefy, która trzyma lokatory
To jest ta ważna, i to reguła projektowa, a nie ustawienie.
Active Directory rejestruje rekordy dynamicznie. Maszyna dołącza i rejestruje samą siebie; DC startuje i rejestruje rekordy SRV ogłaszające jego usługi. „Bezpieczna” aktualizacja dynamiczna oznacza, że te aktualizacje są uwierzytelnione: maszyna dowodzi własnymi poświadczeniami, że jest tym, za kogo się podaje, a ACL na poziomie rekordu sprawia, że maszyna co do zasady może modyfikować tylko rekord, który sama utworzyła.
Przeczytaj to uważnie, bo gwarancja jest węższa, niż się na pierwszy rzut oka wydaje. Bezpieczna aktualizacja dynamiczna uwierzytelnia, kto pisze. Nie ocenia, co rekord znaczy. A zbiór kont uprawnionych do pisania jest znacznie szerszy, niż ludzie zakładają: w domyślnej strefie zintegrowanej z AD grupa Authenticated Users ma Create All Child Objects na kontenerze strefy w katalogu, bo ADIDNS przechowuje każdy rekord jako obiekt AD pod CN=MicrosoftDNS,DC=DomainDnsZones. Nie tylko konta maszyn: każde uwierzytelnione konto w domenie, w tym to należące do osoby, która dziś rano otworzyła załącznik z fakturą.
To daje dwa tryby awarii w strefie, która trzyma zarówno rekordy klientów, jak i lokatory usług:
Nazwy, które jeszcze nie istnieją, nie należą do nikogo. ACL na poziomie rekordu chroni rekord, który już ma właściciela. Nazwa, której nigdy nie zarejestrowano, nie ma obiektu, na którym można by egzekwować ACL, więc dostaje ją pierwsze konto, które ją utworzy. To mechanizm stojący za całą rodziną ataków na ADIDNS, z których najostrzejszy to wildcard: utwórz *, a każda nazwa w strefie, której nikt jawnie nie zajął (literówki, wycofane hosty, wpad), rozwiązuje się na atakującego. Istniejące rekordy zostają nietknięte, i właśnie dlatego nikt tego nie zauważa.
Zasięg rażenia obejmuje lokatory. Rekordy pod _msdcs to sposób, w jaki każdy klient w domenie znajduje kontroler domeny i KDC. To najbardziej krytyczne dla bezpieczeństwa rekordy, jakie masz, a w domyślnym wdrożeniu siedzą w tej samej strefie, do której czterysta laptopów pisze za każdym razem, gdy dostaje dzierżawę DHCP.
Reguła brzmi więc tak: strefę, która trzyma lokatory, piszą kontrolery domeny i nic poza nimi. Dynamiczna rejestracja klientów idzie gdzie indziej.
Gdzie indziej może oznaczać jedną z dwóch rzeczy, i obie są w porządku:
- Delegowana podstrefa serwowana gdzie indziej. Strefa AD trzyma delegację
NSdla, powiedzmy,dyn.ad.example.com, a rekordy lądują na osobnym serwerze, który przyjmuje aktualizacje. Partycje Samby nigdy nie przyjmują zapisu od klienta. - Osobna strefa w Sambie z własnym ACL aktualizacji. Wciąż w katalogu, ale to jej własna strefa, więc zapis klienta nie ma drogi do
_msdcsani do własnych rekordów DC.
Pierwsza daje twardsze rozdzielenie; druga to mniej do utrzymania. Regułę łamie co innego. To ustawienie domyślne, w którym obie żyją razem. Tak wciąż działa większość domen, bo nikt tego nie wybrał i nikt nie wrócił, żeby popatrzeć.
Jest też druga dywidenda, ta, która wiąże to z powrotem z potokiem. Strefa, którą piszą tylko kontrolery domeny, to strefa, która prawie się nie zmienia: promocja DC, degradacja DC, a poza tym cisza. Cała zmienność w domyślnej strefie AD to rejestracja klientów. Wyjmij ją, a zarzut wobec podpisywania partycji AD odchodzi razem z nią: nie ma strumienia aktualizacji, za którym podpisy musiałyby gonić, więc podpisywanie jest rutyną, a nie walką. Dyscyplina zapisu i podpisywanie to ta sama decyzja widziana dwa razy.
Obok każdej z tych opcji jest uprawnienie, któremu warto się przyjrzeć, a na DC Microsoftu to bezpośrednia poprawka. Ponieważ rekordy ADIDNS to obiekty katalogu, uprawnienie pochodzi z ACL w AD, a nie z czegokolwiek w protokole DNS: Authenticated Users z Create All Child Objects na kontenerze strefy. Zaostrzenie tego to najczystsze złagodzenie problemu niezajętych nazw i wildcardów, a w wielu środowiskach można to uprawnienie usunąć zupełnie, gdy już wiesz, co naprawdę musi się samo rejestrować. AD DNS w Sambie przechowuje rekordy w katalogu w ten sam sposób, więc to samo pytanie dotyczy i jej: idź zobacz, co twój kontener strefy faktycznie przyznaje.
Ale chwila: czy klienci w 2026 roku w ogóle powinni się rejestrować?
Wszystko powyżej zakłada, że dynamiczna aktualizacja klientów to coś, czego potrzebujesz i co próbujesz uczynić bezpiecznym. Zanim to przyjmiesz, warto zadać pytanie, którego nikt nie zadaje, bo odpowiedź zmieniła się od czasu, gdy to zachowanie projektowano.
Dynamiczną rejestrację DNS zbudowano dla desktopa. Skrzynka pod biurkiem, jeden kabel sieciowy, jeden adres trzymany latami. W takim świecie maszyna rejestrująca własną nazwę była porządkiem i w zasadzie prawdą.
Teraz zobacz, czym jest klient w 2026 roku. Budzi się w domowym wifi. Przychodzi do biura i dołącza do firmowej sieci bezprzewodowej. Trafia do stacji dokującej i łapie jeszcze adres przewodowy. Ktoś odpala VPN i pojawia się adapter tunelu z trzecim adresem. Idzie do kawiarni, podłącza się przez telefon, a VPN wraca na czwartym. To jedna maszyna, jedna nazwa i pół tuzina adresów w ciągu dnia pracy, a domyślnie spróbuje zarejestrować sporą ich część.
Strefa zapełnia się więc twierdzeniami, które kiedyś były prawdziwe.
- Windows rejestruje każdy adapter, jaki ma, chyba że ktoś przeszedł i odznaczył Register this connection’s addresses in DNS na każdym interfejsie. Zadokowany laptop na VPN to maszyna z trzema aktywnymi adapterami i zdaniem o każdym z nich.
- Wiele rekordów A dla jednej nazwy to nie stan błędu, to normalny wynik. Wyszukanie zwraca je wszystkie, klienci próbują ich w dowolnej kolejności, a połączenia z tą nazwą zawodzą proporcjonalnie do tego, ile adresów jest martwych. To mechanizm stojący za „zdalne wsparcie widzi maszynę w jednej minucie, a w następnej nie”.
- Adresy VPN są z nich najgorsze, bo adres tunelu jest ważny przez godzinę, a rekord go przeżywa. Tunel pada, adres z puli idzie do kogoś innego, a nazwa wskazuje teraz na kolegę.
- Stacje dokujące mącą samą tożsamość. Jeśli nie skonfigurowano przekazywania adresu MAC, dzierżawa należy do stacji, a nie do laptopa, więc w środowisku z hot-deskami nazwy, dzierżawy i maszyny rozjeżdżają się codziennie.
- A własność czyni to trwałym. Rekord może zaktualizować tylko konto, które go utworzyło. Gdy rekord utworzył DHCP pod jednym poświadczeniem, a maszyna później próbuje go zaktualizować pod własnym, aktualizacja po cichu się nie udaje, a nieaktualny adres zostaje dokładnie tam, gdzie był.
Historia ze sprzątaniem też nie jest ratunkiem, na jaki brzmi. Samba ma scavenging od 4.9, ale jest domyślnie wyłączony (dns zone scavenging = yes, z samba-tool dns zoneoptions --aging=1), a sama Samba mówi, że „should only be enabled on new zones or new installations”, bo starsze wersje oznaczały rekordy dynamiczne jako statyczne, a statyczne jako dynamiczne. W środowiskach najbardziej zawalonych śmieciami, czyli tych, które działają od lat, narzędzie do sprzątania to to, którego radzą ci nie włączać. Miało też własne CVE.
Postaw więc pytanie wprost: co właściwie korzysta z rekordu A laptopa?
W większości firm bardzo niewiele. Użytkownicy łączą się z serwerami; serwery nie łączą się z laptopami. Prawdziwi konsumenci to narzędzia zdalnego wsparcia, RDP do stacji roboczej po nazwie oraz inwentaryzacja lub monitoring, a niemal całe to oprogramowanie prowadzi własną inwentaryzację i działa na agencie, który się zgłasza, bo przy klientach mobilnych nigdy nie mogło polegać na DNS.
Co podsuwa odwrócenie ustawienia domyślnego:
- Serwery i infrastruktura dostają rekordy z provisioningu. Z NetBoxem i Ansible już w obrazku rekord tworzy ta sama rzecz, która stworzyła maszynę, jest poprawny z konstrukcji i znika, gdy znika maszyna.
- Stabilne środowisko przewodowe może brać rekordy z DHCP, jeśli coś ich naprawdę potrzebuje, z jednym poświadczeniem jako właścicielem, żeby aktualizacje nie zawodziły.
- Klienci mobilni nie rejestrują niczego. Są konsumentami DNS, nie jego wydawcami. Jeśli coś musi dotrzeć do laptopa, potrzebuje agenta, a nie rekordu A.
Lądujesz w tym samym miejscu, w które postawił cię argument bezpieczeństwa, tylko z zupełnie innej strony. Mniej piszących to mniejsza powierzchnia ADIDNS, strefa niezapchana wygasłymi twierdzeniami i, wracając do potoku, strefa na tyle cicha, by podpisywać ją bez zastanowienia.
Argument bezpieczeństwa mówi, że klienci nie mogą pisać strefy z lokatorami. Argument operacyjny pyta, po co w ogóle piszą do DNS. W 2026 roku, dla floty, która zmienia adres pięć razy dziennie, „nie piszą” to całkiem dobra odpowiedź, i znacznie mniej roboty niż czynienie ich bałaganu bezpiecznym.
Podzielone widoki i skąd bierze się zaufanie
Ostatni element spina obie połowy wpisu.
Są dwa widoki przestrzeni nazw. Strefa publiczna, opublikowana w internecie, z garstką nazw, których potrzebuje świat. I widok wewnętrzny: treść wywiedziona z AD, każdy host w domenie, każdy lokator usługi, topologia lokacji, czyli coś, czego świat nie ma prawa oglądać. Ta treść to mapa środowiska i powinna być z zewnątrz nieosiągalna i nie do przetransferowania.
Ale zaufanie dla widoku wewnętrznego przychodzi ze strony publicznej, i to czyni ten projekt lepszym od zwykłej wewnętrznej wyspy DNS:
example.comjest publiczna i podpisana, ze swoimDSu rodzica i łańcuchem do korzenia.ad.example.comjest z niej delegowana. Publiczny rodzic publikuje delegację iDSdla klucza strefy wewnętrznej.- Wewnętrzne serwery autorytatywne serwują podpisaną
ad.example.com. Wewnętrzne resolvery ją walidują (korzeń →com→example.com→ad.example.com), nie używając niczego poza kotwicą zaufania korzenia, którą już miały.
Żadnej lokalnej kotwicy zaufania. Żadnej wyspy. Żadnego klucza rozdawanego ręcznie. Dane nigdy nie opuszczają budynku, a ścieżka walidacji jest zwykłą publiczną ścieżką. Gdy dodajesz resolver, waliduje nazwy wewnętrzne poprawnie bez żadnej konfiguracji DNSSEC.
Bądźmy uczciwi co do wymiany, bo jakaś jest. Opublikowanie delegacji i DS w strefie publicznej oznacza, że istnienie ad.example.com i nazwy jej serwerów nazw są publiczne. Zawartość nie jest i nigdy nie będzie, ale powiedziałeś światu, że strefa istnieje. W zamian każdy twój resolver waliduje nazwy wewnętrzne względem prawdziwego korzenia. Dla większości środowisk to dobra wymiana, i powinna być świadoma, a nie niespodzianką.
Dwie rzeczy, które trzeba przy tym zrobić dobrze:
- Trzymaj widok wewnętrzny niewyliczalny i nie do przetransferowania.
allow-transferna wewnętrznych serwerach autorytatywnych jest dla podpisującego i twoich własnych serwerów wtórnych, dla nikogo innego. I pamiętaj, że uwierzytelnione zaprzeczenieNSECpozwala każdemu, kto może pytać strefę, przejść ją od końca do końca;NSEC3podnosi ten koszt, ale prawdziwa kontrola polega na tym, że obcy w ogóle nie dosięgną serwerów. - Zautomatyzuj
DS.DSu rodzica, który przestaje pasować do klucza dziecka, wrzuca całą wewnętrzną domenę wSERVFAIL.CDS/CDNSKEYistnieją po to, żeby dziecko mogło zasygnalizować zmianę klucza, a rodzic ją podjąć bez człowieka edytującego rekord w trakcie wymiany. Jeśli strefa nadrzędna jest u rejestratora lub dostawcy, który to obsługuje, używaj tego; jeśli nie, procedurę wymiany trzeba spisać przed pierwszą wymianą, a nie w jej trakcie.
Jak zmusić Windows i Linuksa do faktycznej walidacji
Wszystko do tej pory dotyczyło publikowania strefy, którą da się zweryfikować. Nic z tego nie działa, dopóki coś po stronie klienta nie nalega na weryfikację. Idealnie podpisana strefa i klient, który nigdy nie sprawdza podpisu, dają dokładnie to samo doświadczenie co strefa niepodpisana, aż do dnia, w którym przestają.
Są tylko dwa miejsca, gdzie walidacja może się odbyć, a różnica między nimi to różnica między kontrolą bezpieczeństwa a uprzejmą sugestią.
Waliduj na resolverze i ufaj bitowi AD. Klient pyta resolver, resolver robi kryptografię i zgłasza wynik, ustawiając jeden bit w odpowiedzi: AD, authenticated data. Klient wierzy bitowi. To model, którego używa Windows, i jest tylko tak mocny jak droga między klientem a resolverem, bo wszystko, co potrafi odpowiedzieć jako resolver, potrafi ustawić ten bit.
Waliduj na samym kliencie. Maszyna uruchamia własny walidujący resolver, więc „droga do resolvera” to gniazdo pętli zwrotnej wewnątrz maszyny i nie zostaje nic do podrobienia. To mocniejsze, a na Linuksie całkowicie wykonalne.
Domyślnie nic
Zanim cokolwiek skonfigurujesz, warto zobaczyć, co robi typowa linuksowa stacja robocza prosto z pudełka. To maszyna z Fedorą 44, systemd 259, nietknięta:
$ resolvectl status | head -3
Global
         Protocols: LLMNR=resolve -mDNS -DNSOverTLS DNSSEC=no/unsupported
  resolv.conf mode: stub

$ grep options /etc/resolv.conf
options edns0 trust-ad

$ dig +dnssec cloudflare.com A | grep flags
;; flags: qr rd ra; QUERY: 1, ANSWER: 3, AUTHORITY: 0, ADDITIONAL: 1
Przeczytaj te trzy razem, bo opowiadają małą historię.
Stub jest skonfigurowany z trust-ad: kazano mu wierzyć bitowi AD. systemd-resolved zgłasza DNSSEC=no/unsupported, więc sam niczego nie waliduje. A odpowiedź dla podpisanej strefy wraca z flagami qr rd ra i bez ad: nic na całej tej drodze nie twierdziło, że zwalidowało.
To nie błędna konfiguracja. To ustawienie domyślne. Klientowi można kazać ufać twierdzeniu, którego nic w łańcuchu nie wygłasza. Nikt tego nie sprawdza. Warto posiedzieć nad tym minutę, zanim skonfigurujesz cokolwiek innego.
Linux
Trzy opcje, w kolejności rosnącej tego, jak mało musisz ufać sieci.
1. systemd-resolved, walidujący lokalnie. Plik drop-in zamiast edytowania dostarczonego pliku:
# /etc/systemd/resolved.conf.d/dnssec.conf
[Resolve]
DNSSEC=yes
DNSOverTLS=opportunistic
Potem systemctl restart systemd-resolved i potwierdź przez resolvectl status, że linia brzmi teraz DNSSEC=yes.
Ostrożnie trzeba podejść do środkowego ustawienia. DNSSEC=allow-downgrade wygląda na rozsądny kompromis i nie jest kontrolą bezpieczeństwa; resolved.conf(5) sam to mówi:
Note that this mode makes DNSSEC validation vulnerable to “downgrade” attacks, where an attacker might be able to trigger a downgrade to non-DNSSEC mode by synthesizing a DNS response that suggests DNSSEC was not supported.
Atakujący, który potrafi fałszować odpowiedzi, to dokładnie ten atakujący, przed którym DNSSEC ma chronić, więc tryb, który może wyłączyć, fałszując odpowiedź, nic ci przeciw niemu nie daje. Albo yes, albo dekoracja.
2. Prawdziwy walidujący resolver na hoście. Walidator systemd-resolved jest wygodny, a nie gruntowny. Tam, gdzie to ma znaczenie, uruchom Unbound albo BIND na pętli zwrotnej i skieruj na niego stub:
# unbound: validate against the root anchor, refuse to be stripped
server:
    module-config: "validator iterator"
    auto-trust-anchor-file: "/var/lib/unbound/root.key"
    harden-dnssec-stripped: yes
    val-permissive-mode: no

# the internal zone is reached like any other name — no local anchor needed
forward-zone:
    name: "ad.example.com."
    forward-addr: 192.0.2.53
Odpowiednik w BIND to jedna linia, dnssec-validation auto;, która używa wbudowanej kopii kotwicy korzenia i sama zarządza jej wymianą.
3. W całym środowisku, na resolverach, które już masz. To czwarty etap potoku z wcześniejszej części wpisu. Walidacja dzieje się tam, klienci ufają bitowi AD, a odcinek między nimi to rzecz, którą musisz chronić: przez DoT albo przez sieć, co do której gotów jesteś przyjąć takie założenie.
I zauważ, czego nie ma w żadnej z tych konfiguracji: kotwicy zaufania dla strefy wewnętrznej. Ponieważ ad.example.com to delegacja wewnątrz publicznie podpisanej strefy, każda z nich waliduje nazwy wewnętrzne przez zwykły łańcuch od korzenia. To projekt z poprzedniej sekcji, który się spłaca. Alternatywą jest wypychanie lokalnej kotwicy do każdego klienta i resolvera w środowisku i wypychanie jej ponownie przy każdej wymianie.
Windows
Najpierw rzecz najważniejsza, bo regularnie się ją źle rozumie: klient DNS w Windows nie waliduje DNSSEC. Nie robi żadnej kryptografii, nie sprawdza żadnego podpisu i nie trzyma żadnej kotwicy zaufania. To resolver stub, i zawsze nim był.
To, co możesz zrobić, to zmusić go do odrzucania odpowiedzi, których nie zwalidował w jego imieniu serwer. To Name Resolution Policy Table, i działa per przestrzeń nazw, a nie globalnie:
# Require validated answers for the internal zone
Add-DnsClientNrptRule -Namespace ".ad.example.com" `
    -DnsSecEnable -DnsSecValidationRequired

# What is actually in force on this machine, including from Group Policy
Get-DnsClientNrptPolicy -Effective
Get-DnsClientNrptRule
Dla całego środowiska to samo mieszka w Group Policy pod Computer Configuration → Policies → Windows Settings → Name Resolution Policy: utwórz regułę dla przestrzeni nazw, zaznacz opcję DNSSEC i zaznacz wymóg, by klient sprawdzał, że dane zwalidował serwer DNS.
Wynikają z tego dwie rzeczy, i obie mają znaczenie.
Coś wyżej wciąż musi walidować. Reguła NRPT sprawia, że klient żąda bitu AD; nie tworzy go. Resolver, na który wskazują ci klienci, musi być walidujący, inaczej każda nazwa w tej przestrzeni zawiedzie.
I dlatego reguła NRPT ma obok opcje IPsec. Microsoft umieścił je tam z powodu opisanego na początku tej sekcji: wymaganie bitu, który może ustawić każdy atakujący na ścieżce, to żadne wymaganie. Jeśli polegasz na modelu, w którym waliduje resolver, w niezaufanej sieci, ostatni odcinek trzeba chronić: IPsec między klientem a resolverem albo DoT tam, gdzie resolver go obsługuje.
Zawodzi w trybie zamkniętym, więc wdrażaj w tej kolejności
Wymuszenie walidacji zamienia klasę cichych kompromitacji w klasę głośnych awarii. To właściwa wymiana, a i tak to awaria: wygasły RRSIG, DS u rodzica, który po wymianie już nie pasuje, albo resolver, który nie dosięga strefy nadrzędnej, dają SERVFAIL, a SERVFAIL dla _ldap._tcp.dc._msdcs oznacza, że domena leży, a nie działa gorzej.
Rób to więc w tej kolejności:
- Najpierw włącz walidację na resolverach, a klientów zostaw w spokoju. Obserwuj
SERVFAILw logach resolverów przez kilka tygodni: tu znajdziesz strefę, która od roku jest po cichu zepsuta. - Zautomatyzuj
DS, zanim cokolwiek wymusisz, zgodnie z poprzednią sekcją. Większość awarii DNSSEC zadanych sobie samemu to wymiana, przy której nigdy nie zaktualizowano rodzica. - Potem wymuś to na klientach, jedna przestrzeń nazw naraz, zaczynając od własnej stacji roboczej i testowej OU, a nie od całego środowiska.
Awaria, przed którą się zabezpieczasz, to klient, któremu podsunięto sfałszowany kontroler domeny. Awaria, którą ryzykujesz, to klient, któremu nie podsunięto niczego. Ta druga jest do odratowania i oczywista; pierwsza nie jest ani jednym, ani drugim. O awarii usłyszysz w ciągu minuty. O tamtej drugiej nie usłyszałbyś nigdy.
Szyfrowanie ostatniego odcinka: DoT i DoH na wewnętrznych resolverach
Sekcja o walidacji zostawiła jedną rzecz w zawieszeniu. W modelu, w którym waliduje resolver, czyli tym, który daje ci Windows, klient ufa jednemu bitowi ustawionemu przez resolver, a ten bit jest wart tyle, co droga, którą przebył. Coś musi tę drogę chronić.
BIND obsługuje oba szyfrowane transporty natywnie, więc to robota konfiguracyjna, a nie zakupowa:
- DNS over TLS: blok
tlswskazany zlisten-on, zwyczajowo na porcie 853. - DNS over HTTPS: ten sam blok
tlsplus blokhttp, na 443. - Wychodzące DoT, bo
forwardersprzyjmuje transport TLS dla każdego adresu albo dla całej listy. - Transfery stref po TLS, bo instrukcja
primariesstrefytype secondaryteż go przyjmuje, co jest bezpośrednio przydatne dla potoku z wcześniejszej części wpisu.
Najpierw jasno, co to kupuje, bo DoT i DNSSEC myli się nieustannie, a to nie są alternatywy. DNSSEC uwierzytelnia dane, aż do strefy, która je opublikowała. DoT chroni rozmowę z resolverem. Jedno przetrwa wrogi resolver i wrogą sieć między resolverami; drugie powstrzymuje maszynę w twoim wifi przed czytaniem i przepisywaniem tego, o co pytał twój laptop. Chcesz obu, i żadne nie zastępuje drugiego. Szyfrowanie odcinka do resolvera, który nie waliduje, to prywatna rozmowa z czymś, co wciąż można okłamać.
Serwowanie
tls internal-resolver {
    key-file "/etc/pki/dns/resolver.key";
    cert-file "/etc/pki/dns/resolver.pem";
    protocols { TLSv1.3; };
};

http internal-doh {
    endpoints { "/dns-query"; };
};

options {
    dnssec-validation auto;

    listen-on          port  53                          { 192.0.2.53; };
    listen-on          port 853 tls internal-resolver    { 192.0.2.53; };
    listen-on          port 443 tls internal-resolver
                                 http internal-doh       { 192.0.2.53; };
    listen-on-v6       port 853 tls internal-resolver    { 2001:db8::53; };
};
Certyfikat to właściwa robota, i to ta część, którą się pomija. Klient, który weryfikuje, a o to w całości chodzi, potrzebuje certyfikatu ważnego dla nazwy, z którą go skonfigurowano, wystawionego przez coś, czemu już ufa. To oznacza twoje wewnętrzne CA i twoją istniejącą automatyzację certyfikatów, a nie słowo kluczowe ephemeral. ephemeral generuje jednorazowy certyfikat z podpisem własnym; jest po to, żebyś mógł udowodnić, że nasłuch działa, i jest bezwartościowy dla każdego klienta, który naprawdę sprawdza.
Przekazywanie przez niego
Jeśli te resolvery przekazują gdzieś zapytania, zamiast same schodzić po drzewie, odcinek w górę też można zaszyfrować, a jest tu rozróżnienie, które warto mieć dobrze:
tls upstream {
    ca-file "/etc/pki/tls/certs/ca-bundle.crt";
    remote-hostname "dns.example.net";
};

options {
    forwarders port 853 tls upstream { 192.0.2.1; };
};
Bez remote-hostname dostajesz szyfrowanie bez uwierzytelnienia: ruch jest nieczytelny dla pasywnego obserwatora, a aktywny atakujący, który potrafi przechwycić połączenie, po prostu przedstawia własny certyfikat. Z remote-hostname i ca-file BIND sprawdza, z kim rozmawia. Pierwsze jest coś warte. Tylko drugie warto nazwać kontrolą.
Połowa po stronie klienta nie jest symetryczna
Tu mieszane środowisko robi się niezręczne, i to jest powód, żeby skonfigurować oba transporty, zamiast wybierać jeden.
Linux robi DoT porządnie. systemd-resolved przyjmuje DNSOverTLS=yes dla trybu ścisłego, a serwerowi można podać nazwę, względem której ma być weryfikowany:
[Resolve]
DNS=192.0.2.53#resolver.ad.example.com
DNSOverTLS=yes
DNSSEC=yes
Tak jak przy DNSSEC=, pułapką jest środkowe ustawienie: DNSOverTLS=opportunistic wraca do otwartego tekstu, gdy TLS jest niedostępny, a atakujący, który może ingerować w połączenie, potrafi to zaaranżować.
Windows robi DoH, a nie DoT. Obsługa DoH po stronie klienta pojawiła się w Windows 11 i Server 2022, konfigurowana per serwer z szablonem:
$doh = "https://resolver.ad.example.com/dns-query"
netsh dnsclient add encryption server=192.0.2.53 dohtemplate=$doh
DoT w chwili pisania pojawił się tylko w kompilacjach Insider. W wydanych wersjach Windows szyfrowaną opcją jest więc DoH albo nic, i właśnie dlatego sekcja o NRPT sięgnęła wcześniej po IPsec.
Stąd serwowanie obu z tej samej instancji BIND. DoT dla floty linuksowej i wszystkiego innego, co go mówi, DoH dla Windows, jeden resolver, jeden certyfikat.
Który i gdzie
Dla wewnętrznego resolvera DoT jest lepszym transportem, a DoH odpowiedzią na zgodność.
DoT siedzi na własnym porcie. Możesz go zobaczyć, dopuścić, zablokować i alarmować o wszystkim, co robi DNS, a nie robi tego przez niego. Przewaga DoH, czyli nieodróżnialność od zwykłego ruchu WWW na 443, to prawdziwa korzyść we wrogiej sieci i utrapienie we własnej, gdzie możliwość odróżnienia, co jest DNS-em, to funkcja, za którą zapłaciłeś. W środowisku, które kontrolujesz, wybieraj transport, który możesz obserwować, a DoH uruchamiaj, bo Windows nie zostawia ci wyboru, a nie dlatego, że jest lepszy.
Skoro już tam jesteś: szyfruj transfery
Potok z wcześniejszej części wpisu przenosi strefę AD przez AXFR, a sekcja o podzielonych widokach podkreśliła, że jej zawartość to mapa środowiska. TSIG uwierzytelnia te transfery; nie ukrywa ich. Skoro instrukcja primaries serwera wtórnego przyjmuje konfigurację TLS, transfer też może iść po TLS, RFC 9103, jeśli chcesz standardu:
zone "ad.example.com" {
    type secondary;
    primaries { 192.0.2.10 port 853 tls xfr-tls key transfer-to-signer; };
    ...
};
Uwierzytelnione kluczem, zaszyfrowane transportem. Jeśli którykolwiek odcinek tego potoku przechodzi przez łącze między lokacjami, hiperwizor, który z kimś dzielisz, albo cokolwiek, na co nie postawiłbyś chętnie huba, jest wart tych dwudziestu minut.
Czego to nie naprawia
- To nie jest walidacja. Omówione wyżej, i warto powtórzyć, bo dostawcy sprzedają „bezpieczny DNS”, mając na myśli samo szyfrowanie.
- Niczego nie ukrywa przed resolverem. Resolver widzi każde zapytanie w całości. Szyfrowanie chroni drogę, a nie prywatność wyszukania przed operatorem, co jest w porządku, gdy operatorem jesteś ty.
- Nie robi nic dla klienta, który nie weryfikuje certyfikatu, a tryby oportunistyczne da się obniżyć właśnie przez tego atakującego, którego się obawiasz.
- I nie jest powodem, żeby stawiać nasłuch na kontrolerze domeny. Szyfrowany DNS na DC pięknie rozwiązywałby zły problem. DC dalej nie odpowiada nikomu.
Jak sprawdzić, co masz
Polecenia do uruchomienia na własnym środowisku. Ciekawe są wyniki, a kilka z nich za pierwszym razem czyta się zwykle niewygodnie.
# Walk the tree yourself, one delegation at a time
dig +trace dc01.ad.example.com

# Validate, and show the chain being built
delv +rtrace +vtrace ad.example.com SOA

# Is the resolver you are pointed at actually validating?
# A deliberately broken test name must come back SERVFAIL, not an address
dig @<resolver> dnssec-failed.org A

# What does the estate advertise as a domain controller?
dig SRV _ldap._tcp.dc._msdcs.<domain>
dig SRV _kerberos._udp.<domain>

# Is a DC answering for names it has no business answering?
# Ask it for something it is not authoritative for. "recursion requested
# but not available" is the answer you want. An actual address means it is
# serving the estate — recursing if it is BIND, relaying to the forwarder
# if it is SAMBA_INTERNAL. Either way it should not be doing that.
dig @<dc> www.example.org A

# Is the DC configured as the estate's DNS relay?
grep -E 'dns forwarder|server services' /etc/samba/smb.conf

# Will a DC hand its zone to anybody who asks?
dig @<dc> AXFR ad.example.com

# Which backend is this DC running, and does named have the module?
grep -r dlz /etc/named.conf /var/lib/samba/bind-dns/ 2>/dev/null
samba-tool dns query <dc> <domain> @ ALL

# Is the internal zone chained to the public parent?
dig DS ad.example.com @<public-authoritative-for-example.com>

# What does the local stub actually do with the AD bit, and is the
# hop to the resolver encrypted?
resolvectl status                    # DNSSEC= and DNSOverTLS= per link
grep options /etc/resolv.conf        # trust-ad, trusting whom exactly?

# Did anything in the path claim to have validated? Look for "ad" in the flags
dig +dnssec ad.example.com SOA | grep flags

# Validate independently of whatever the local resolver believes
delv ad.example.com SOA              # "fully validated" is the line you want

# Is the resolver actually listening for DoT, and does its certificate
# match the name clients are configured with?
kdig +tls @192.0.2.53 ad.example.com SOA
openssl s_client -connect 192.0.2.53:853 \
    -servername resolver.ad.example.com </dev/null 2>/dev/null \
    | openssl x509 -noout -subject -dates
A na kliencie Windows, żeby zobaczyć, czy w ogóle czegoś żąda:
Get-DnsClientNrptPolicy -Effective    # the rules actually in force
Resolve-DnsName ad.example.com -DnssecOk
Get-DnsClientDohServerAddress         # is the hop to the resolver encrypted?
Dwa, które najczęściej przynoszą niespodziankę, to sprawdzenie rekursji i próba AXFR. Jeśli DC odpowie na którekolwiek z nich dowolnemu klientowi, potoku z tego wpisu nie ma, cokolwiek mówi diagram na wiki.
Trzecie to resolvectl status na maszynie, której nikt nie ruszał. DNSSEC=no/unsupported obok trust-ad w resolv.conf to normalny stan linuksowego desktopu, i oznacza, że opisaną wyżej pracę nad podpisywaniem obecnie nikt nie sprawdza.
Krótka wersja
Resolver rodzi się, znając serwery główne i jeden klucz, a wszystkiego innego uczy się z tego, co mu powiedzą. Nazwy znajduje się, schodząc po delegacjach, a usługi, pytając o rekord SRV, więc zanim klient zacznie robić Kerberosa z kontrolerem domeny, tożsamość tego kontrolera przyszła z odpowiedzi DNS. Odkrywanie przez DNS jest poprawne i w porządku. Autoryzacja przez DNS nie jest, a zaskakująco dużo infrastruktury i tak po cichu ją stosuje.
DNSSEC sprawia, że te odpowiedzi da się zweryfikować: podpisy na każdym zbiorze, DS u każdego rodzica, łańcuch do jednej kotwicy zaufania w korzeniu i uwierzytelnione zaprzeczenie, żeby nazwy nie dało się sprawić, by zniknęła. Kupuje uwierzytelnienie pochodzenia i integralność, nie prywatność i nie poprawność. Podpisuje to, co mówi strefa, i dlatego nie uratuje strefy, którą mogą pisać niezaufane maszyny. I potrzebuje rodzica: wymyślona wewnętrzna TLD nie ma gdzie umieścić DS, więc .local, .lan, .internal i home.arpa zostawiają cię albo bez podpisu, albo z prywatną wyspą ręcznie rozdawanych kluczy.
Dla domeny Active Directory daje to projekt, a nie listę ustawień. Użyj delegacji wewnątrz publicznej strefy, którą masz, żeby zaufanie schodziło zwykłym łańcuchem od korzenia, a dane nigdy nie wychodziły. Serwuj partycje AD przez BIND i dlz_bind9 (DLZ to nie ryzyko, to sposób na wydobycie strefy z katalogu) i niech DC będzie ukrytym serwerem głównym, który oddaje transferem i nikomu innemu nie odpowiada. Strefy DLZ nie da się samej podpisać, więc podpisywanie to zwykła strefa wtórna z przetransferowaną kopią, z inline-signing i dnssec-policy: drugi named na DC, jeśli chcesz mniej maszyn, osobny host, jeśli chcesz kluczy prywatnych z dala od katalogu. Tak czy inaczej podpisuje się raz, w określonym miejscu, pod polityką kluczy, a pierwszy skok to odpytywanie, a nie wypychanie, bo DLZ nie umie wysłać notify. Publikuj z samodzielnych serwerów autorytatywnych, które nie trzymają kluczy i nie mają trasy do katalogu.
I trzymaj klientów z dala od strefy, która się liczy. Bezpieczna aktualizacja dynamiczna uwierzytelnia piszącego, a nie znaczenie, a w domyślnej strefie zintegrowanej z AD piszącymi są Authenticated Users, czyli każde konto, nie tylko każda maszyna, więc strefa trzymająca zarówno rekordy laptopów, jak i lokatory _msdcs jest o jednego zphishowanego użytkownika od klienta, któremu z całkowicie poprawnym podpisem powiedziano, że kontroler domeny jest gdzie indziej. Rejestracje klientów należą do podstrefy, delegowanej na zewnątrz albo osobnej w Sambie, gdzie najgorsze, co może zrobić przejęte konto, to skłamać o samym sobie.
Choć lepsze pytanie brzmi, czy klienci w ogóle powinni się rejestrować. Laptop z 2026 roku ma adres w domowym wifi, drugi w biurowej sieci bezprzewodowej, trzeci przez stację dokującą i czwarty na VPN, i ochoczo opublikuje większość z nich. Z rekordu A laptopa nie korzysta prawie nic: narzędzia, które muszą dotrzeć do stacji roboczej, prowadzą własną inwentaryzację, bo DNS i tak nigdy nie był wiarygodny dla klientów mobilnych. Rekordy serwerów powinny pochodzić z provisioningu, a flota nie powinna rejestrować niczego.
Potem niech coś sprawdza podpisy, bo nic z powyższego nie jest nic warte, dopóki klient nie odrzuci odpowiedzi. Na Linuksie to DNSSEC=yes w systemd-resolved albo prawdziwy walidujący resolver na pętli zwrotnej, nigdy allow-downgrade, który atakujący zdolny do fałszowania odpowiedzi może po prostu wyłączyć, fałszując odpowiedź. Na Windows to przyjęcie do wiadomości, że klient DNS sam niczego nigdy nie waliduje, i użycie reguły NRPT, żeby wymagał odpowiedzi zwalidowanej przez resolver, z chronionym ostatnim odcinkiem, bo to wymaganie to jeden bit. Włącz to najpierw na resolverach i obserwuj SERVFAIL, zautomatyzuj DS, potem wymuś na klientach. Zawodzi w trybie zamkniętym, co jest właściwą stroną, a i tak oznacza awarię.
Nic z tego nie jest egzotyczne. To delegacja, transfer i podpisywanie, trzy rzeczy, które DNS robił zawsze, ułożone tak, żeby maszyna trzymająca twój katalog nie była maszyną przyjmującą pytania z parkingu, i żeby klient zauważył, kiedy coś go jednak okłamie.