Ujawniam na wstępie: pracuję dla croit, firmy, która to napisała. Wszystko poniżej jest wyczytane z opublikowanego kodu i dokumentacji obu projektów, podlinkowanych na dole strony, a tam, gdzie dokumentacja croit nie zgadza się z kodem croit, mówię o tym.
OSD Cepha przepisany od zera
croit opublikował ceph-rust, OSD Cepha napisany od zera w Rust, z własnym magazynem obiektów o nazwie FlashStore w miejsce BlueStore1.
Wszedł w publiczną wersję zapoznawczą 9 listopada 2026, a ogólna dostępność planowana jest na pierwszy kwartał 20271.
To nie jest fork.
Zasada projektu jest taka, że kod C++ Cepha czyta się jako punkt odniesienia, opisuje jako specyfikację własnymi słowami croit, a potem implementuje ze specyfikacji2.
Deklaracja, która liczy się dla każdego, kto prowadzi Cepha, to ta o drop-in.
Twoje monitory, twoje managery, CLI ceph i twoi klienci zostają, jak są.
OSD FlashStore dołącza do tych samych pul i tych samych placement groups co klasyczne OSD, które już tam są, a dyski wymieniasz po jednym1.
Pytanie dla operatora jest więc praktyczne. Jeśli zamienisz OSD z BlueStore na OSD z FlashStore, co jest pod spodem inaczej? Nie w abstrakcji i nie względem jakiegoś BlueStore z prezentacji konferencyjnej sprzed lat. Względem BlueStore, który naprawdę dziś prowadzisz, jeśli jesteś na Umbrelli, Ceph 21.2.0, czyli wydaniu, na którym FlashStore jest budowany i testowany1.
To jest więc porównanie tutaj, i tylko to. BlueStore z Umbrelli tak, jak opisują go jego kod i dokumentacja, kontra FlashStore tak, jak opisują go jego kod i zapisy decyzji.
Dotyczy każdego, kto ma klastry Cepha na NVMe, i każdego, kto przyjrzał się, ile kosztuje go OSD w rdzeniach. Klastrów HDD nie dotyczy wcale, a powód wyjdzie niżej.
Co jest w repozytorium
Repozytorium to migawka tylko do odczytu prywatnego drzewa rozwojowego croit. Bez systemu zgłoszeń, bez pull requestów; aktualizacje przychodzą jako nowe commity z migawką1. To etap wersji zapoznawczej, który służy zebraniu opinii społeczności, podczas gdy croit wewnętrznie przeprowadza swoje produkcyjne przypadki testowe, zanim uzna go za bezpieczny w użyciu. Otwarty rozwój przyjdzie po pierwszym wydaniu produkcyjnym, jak w większości projektów open source sponsorowanych przez firmy. Ta migawka ma datę 10 listopada 2026 i zawiera około 700 000 linii Rusta i ponad 450 zapisów decyzji architektonicznych, ADR, czyli krótkich dokumentów zapisujących, dlaczego podjęto każdą decyzję projektową.
ADR to najprzydatniejsza część do takiego porównania. Są bezpośrednie, zawierają pomiary i zapisują, co wypróbowano i wyrzucono, a nie tylko to, co zostało.
| Komponent | Co zastępuje | Wersja zapoznawcza | GA (planowane) |
|---|---|---|---|
| FlashStore OSD | ceph-osd + BlueStore | lis 2026 | I kw. 2027 |
| librustyrados | librados | lis 2026 | I kw. 2027 |
| librustyrbd | librbd | lis 2026 | I kw. 2027 |
| Transport RDMA (RoCEv2) | nic w Umbrelli | lis 2026 | I kw. 2027 |
| CephFS2, RGW w Rust | MDS, RGW | I kw. 2027 | II kw. 2027 |
| ceph-mon, ceph-mgr | niezastępowane | nd. | nd. |
Licencje warto znać, zanim cokolwiek na tym zbudujesz. Demon i narzędzia są na LGPL-3.0-only, biblioteki klienckie na MPL-2.0, a dokumentacja na CC-BY-SA-4.03. Biblioteki klienckie poszły na MPL, żeby program w Rust mógł linkować je statycznie bez obowiązku ponownego linkowania, który niesie LGPL, i to wybór przemyślany i jako taki zapisany3.
Wersja zapoznawcza znaczy to, co mówi. Własne README croit mówi, że służy do testów i oceny i jest „not yet recommended for production data”1. Ja też nie wkładałbym na nią jeszcze danych klientów i nic w dalszej części tego artykułu tego nie zmienia.
Dwa magazyny obok siebie
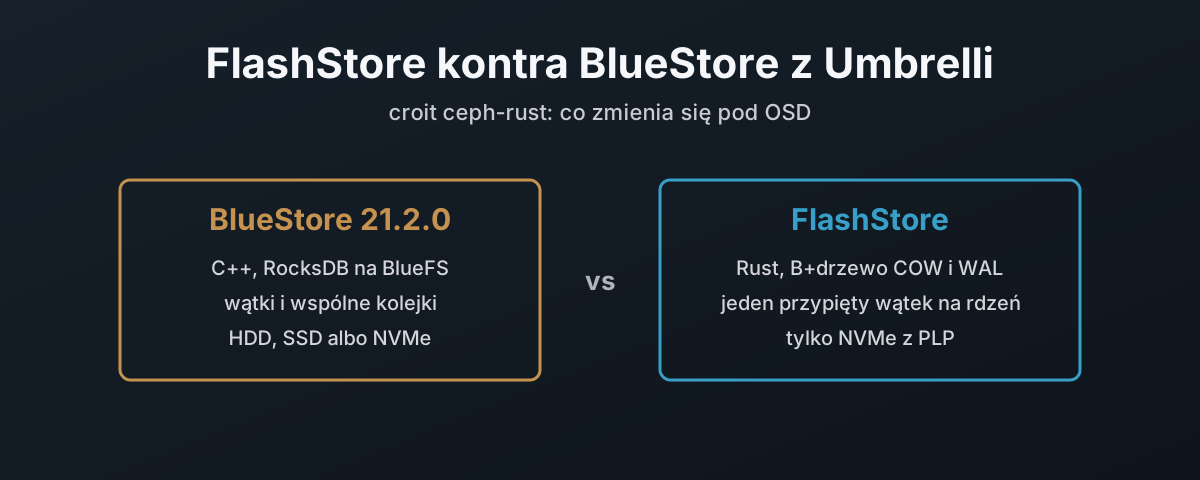
OSD ma dwie połowy. Górna mówi protokołem Cepha, jest właścicielem placement groups, prowadzi peering, odtwarzanie i scrubbing. Dolna, magazyn obiektów, zamienia „zapisz te bajty do tego obiektu” na bloki na dysku i obiecuje, że przetrwają zanik zasilania.
BlueStore to dolna połowa Umbrelli. Jego dokumentacja mówi, że „reads and writes to the devices directly in a ‘raw’ fashion”4 i że używa „raw block devices or partitions”5. Dane obiektów idą prosto na urządzenie blokowe. Wszystko inne, metadane obiektów, OMAP i jego własna księgowość, trafia do wbudowanej bazy klucz/wartość RocksDB, a RocksDB stoi na BlueFS, małym systemie plików, który BlueStore nosi specjalnie dla niej56.
FlashStore wyrzuca to wszystko. Jedno B+drzewo copy-on-write na shard magazynu trzyma całość: kolekcje, metadane obiektów, rozszerzone atrybuty, mapy ekstentów, OMAP, log PG, liczniki referencji, a nawet własną bitmapę alokatora7. Obok leżą pierścień dziennika redo write-ahead i obszar danych. Nie ma RocksDB, nie ma BlueFS i nie ma drugiej bazy danych do strojenia.
Drugi duży podział to sam dysk. BlueStore idzie przez warstwę blokową jądra do tego, co mu dasz. FlashStore rozmawia z NVMe albo przez SPDK, sterownik w przestrzeni użytkownika, który zabiera urządzenie jądru przez vfio, albo przez jądro z io_uring89. SPDK to domyślny backend. Warstwa io_uring działa tam, gdzie vfio nie działa, i dlatego na niej skończyłem w buildzie na Proxmoxie.
Gdzie żyją metadane
Zacznij tutaj. Większość reszty z tego wynika.
| BlueStore z Umbrelli | FlashStore | |
|---|---|---|
| Metadane obiektów | klucze RocksDB | B+drzewo COW na shard |
| OMAP | klucze RocksDB | domyślnie to samo B+drzewo; LSM albo RocksDB opcjonalnie przy przygotowaniu |
| Log PG | klucze RocksDB | to samo B+drzewo |
| Stan alokatora | alokator hybrid, freelist w RocksDB | bitmapa na shard, w drzewie |
| Urządzenie na metadane | opcjonalne block.db i block.wal | brak, to samo NVMe |
| Sumy kontrolne danych | domyślnie crc32c na 4 KiB | crc32c na 4 KiB, w mapie ekstentów |
| Liczba magazynów na OSD | jeden | jeden na rdzeń |
Ustawienia domyślne po stronie BlueStore pochodzą wprost z pliku opcji Umbrelli: RocksDB jako backend klucz/wartość, alokator hybrid, sumy crc32c61011. Sumowanie kontrolne metadanych w BlueStore „is handled by RocksDB and uses the crc32c algorithm”, a dane kosztują go „a checksum value (usually 4 bytes) for every 4 KB block of data”4. W sumach kontrolnych oba magazyny się zgadzają. FlashStore trzyma crc32c na każdy blok 4 KiB w mapie ekstentów i sprawdza ją przy odczycie7.
Rozchodzą się w strukturze. RocksDB w BlueStore to drzewo LSM, czyli zapisuje, a potem kompaktuje w tle, przepisując dane, które już raz zapisało. Drzewo FlashStore aktualizowane jest metodą copy-on-write i zrzucane na dysk w checkpointach: co pięć sekund, póki coś jest nieutrwalone, albo gdy pierścień WAL zapełni się do połowy7.
Kolejna konsekwencja: FlashStore nie ma szybkiego urządzenia na metadane, bo go nie potrzebuje.
Na Umbrelli możesz położyć block.db na szybszym dysku, a BlueStore umieści „as much metadata as it can on the DB device”4.
FlashStore zakłada, że każdy dysk to już szybkie NVMe, i trzyma metadane obok danych.
To uczciwe założenie dla sprzętu, w który celuje. To też dokładnie powód, dla którego nie ma tu żadnej historii z HDD.
OMAP to jedyne miejsce, gdzie FlashStore się asekuruje. Domyślne jest drzewo, ale magazyn można przygotować z własnym silnikiem LSM croit albo z RocksDB, za tym samym interfejsem12. Silnik OMAP wybiera się przy tworzeniu magazynu. Nie przełączasz go na działającym OSD.
Jeden zapis 4 KiB, na dwa sposoby
Oto różnica, którą byś poczuł, jeśli w ogóle jakąś poczujesz.
Weź zapis 4 KiB do obiektu na Umbrelli z ustawieniami domyślnymi na flashu.
bluestore_min_alloc_size_ssd to 4 KiB, a bluestore_prefer_deferred_size_ssd to 0, więc cały zapis 4 KiB idzie do nowo przydzielonych 4 KiB1314.
BlueStore wysyła ten zapis danych, a transakcja czeka w STATE_AIO_WAIT, aż dysk powie, że skończył15.
Dopiero wtedy metadane trafiają do kolejki RocksDB, a wątek synchronizacji RocksDB opróżnia urządzenie blokowe, zanim zatwierdzi16.
Potem klient dostaje potwierdzenie.
Dwie podróże do urządzenia, jedna po drugiej.
FlashStore wysyła obie naraz. Dane idą do świeżego ekstentu 4 KiB, a jednostka WAL do pierścienia logu, równolegle. Rekord WAL niesie crc32c każdego nowego bloku danych, więc odtwarzanie po awarii potrafi stwierdzić, czy dane dotarły7. Potwierdzenie wychodzi, w kolejności logu, gdy dane, jednostka WAL i każda wcześniejsza transakcja są trwałe7. Własne uzasadnienie tego projektu w ADR brzmi „parallel commit gives one device latency per ack”7.
Dwie rzeczy trzymają to w uczciwych granicach. Na zajętym OSD oba magazyny grupują zatwierdzenia, więc różnica pod obciążeniem jest mniejsza niż jedno opóźnienie urządzenia na zapis. A pojedyncza podróż do NVMe to kilkadziesiąt mikrosekund. Czy to zauważysz, zależy od tego, czy twoi klienci czekają na opóźnienie przy małej głębokości kolejki, jak często bazy danych na RBD, czy pchają przepustowość, gdzie to się rozmywa.
croit próbował pójść dalej, do jednego zapisu na urządzenie na transakcję, w stylu ZFS. Zbudowali to, zmierzyli i wyrzucili: zysk pojawiał się tylko przy głębokości kolejki 1, a złożoność nie była tego warta17. Cenię to bardziej niż jakikolwiek wykres benchmarków. To zapis decyzji, który publicznie mówi „zbudowaliśmy to i nie było warto”.
Zapis poniżej 4 KiB
Mniejszy zapis to miejsce, gdzie oba naprawdę się rozchodzą.
Powiedzmy, że klient nadpisuje 512 bajtów w środku bloku, który już zawiera dane.
Umbrella domyślnie wciąż używa swojej pierwotnej ścieżki zapisu; bluestore_write_v2, przeróbka, jest dostarczany wyłączony18.
Na tej ścieżce zapis mniejszy niż min_alloc_size do bloku, który jest już przydzielony, staje się zapisem odroczonym19.
Dane jadą w transakcji RocksDB jako klucz z prefiksem L i trafiają na swoje właściwe miejsce dopiero wtedy, gdy klient usłyszał już, że są bezpieczne2021.
Dane trafiają więc na dysk dwa razy. Dokumentacja Umbrelli tego nie ukrywa: „writes smaller than min_alloc_size must first pass through the BlueStore WAL”4.
FlashStore nigdy nie nadpisuje żywych danych w miejscu, i kropka7. Obiekty do 2 KiB idą dalej i żyją w całości w drzewie, więc jeden zapis WAL to całe zatwierdzenie7.
To oznacza też, że FlashStore nie ma kolejki zapisów odroczonych do opróżniania, odtwarzania odroczonych zapisów przy montowaniu ani kluczy L do sprzątania.
Płaci za to gdzie indziej: zwolnione bloki są wstrzymywane do następnego checkpointu, więc zwalnianie miejsca opóźnia się o maksymalnie jeden interwał checkpointu7.
Wątki kontra rdzenie
Górna połowa OSD różni się tak samo mocno.
ceph-osd z Umbrelli to klasyczny serwer wielowątkowy, a każda liczba w lewej połowie diagramu poniżej to jedno z jego ustawień domyślnych na flashu22.
Operacja po drodze przechodzi przez kilka tych pul. Dzielą one stan za blokadami.
FlashStore trzyma całą podróż na jednym przypiętym, odpytującym rdzeniu, od karty sieciowej do dysku i z powrotem23. Każda placement group należy do dokładnie jednego rdzenia, tak samo jak wszystko, czego PG dotyka: „no locks, no atomics, no shared mutable state”24. Ruch między rdzeniami idzie przez pierścienie z jednym producentem, a wraz z nim przechodzi własność wiadomości.
Magazyn idzie za tym samym podziałem.
flashstore_store_shards domyślnie daje jeden shard na rdzeń, każdy z własnym pierścieniem WAL, drzewem i alokatorem, a PG żyje w dokładnie jednym shardzie257.
BlueStore to jeden magazyn na OSD z jedną RocksDB.
Jest cena i ADR ją podaje: „idle cores burn CPU (accepted; optional adaptive sleep later)”23.
Późniejsze prace dodały adaptacyjną bezczynność i oczekiwanie taktowane urządzeniem, żeby rdzeń nie kręcił się przez całe opóźnienie urządzenia przy małej głębokości kolejki8, ale zasada zostaje, a flashstore_cores domyślnie wynosi 8, gdy nie przypniesz zakresu25.
FlashStore dajesz całe rdzenie.
Na dedykowanym węźle storage to w porządku. Na maszynie hiperkonwergentnej, gdzie te same rdzenie uruchamiają też VM, to pierwszy rachunek do zrobienia.
Dysk musi dotrzymać obietnicy
BlueStore jest napisany tak, by radzić sobie z dyskiem, który kłamie, kiedy dane są bezpieczne. FlashStore w ogóle odmawia pracy z takim dyskiem.
| BlueStore z Umbrelli | FlashStore | |
|---|---|---|
| Co czyni zapis trwałym | opróżnienie urządzenia blokowego przed zatwierdzeniem RocksDB | zakończenie zapisu na dysku z PLP |
| Opróżnianie na gorącej ścieżce | tak | nie |
| Dysk z ulotną pamięcią podręczną zapisu | używany i opróżniany | mkfs go odrzuca; kontrola hosta FAIL |
| Obejście | niepotrzebne | tylko do labu: bit FUA na każdym trwałym zapisie |
Strona BlueStore to cytowany już wątek synchronizacji kv16. Strona FlashStore to ADR o trwałości i kontrola hosta: PLP oznacza, że dysk zgłasza brak ulotnej pamięci podręcznej zapisu, więc zakończenie oznacza, że dane są na stabilnym nośniku2426.
To właściwa decyzja dla tego celu, ale miej jasność, co wyklucza, bo prawie każde konsumenckie NVMe ma ulotną pamięć podręczną i nie ma PLP, podobnie jak spora część sprzętu „do centrów danych” sprzedawanego na cenę. Bez PLP nie ma FlashStore. Cokolwiek innego o nim sądzisz.
Na czym FlashStore nie ruszy
Postaw wymagania obok siebie, a rynek docelowy staje się oczywisty.
| BlueStore z Umbrelli | FlashStore | |
|---|---|---|
| Nośniki | HDD, SSD, NVMe | tylko NVMe |
| Ochrona przed utratą zasilania | niewymagana | wymagana, mkfs bez niej odmawia |
| Format sektora | 512 B albo 4 KiB | oczekiwane 4 KiB, w przeciwnym razie ostrzeżenie |
| Układ | partycje, LVM przez ceph-volume | całe przestrzenie nazw, bez partycji |
| Osobne urządzenie DB/WAL | obsługiwane | nie istnieje |
| Szyfrowanie danych w spoczynku | --dmcrypt przez ceph-volume | poza zakresem |
| Klienci msgr1 | domyślnie nasłuchuje | odrzuceni, tylko msgr2 |
| Cache tiering | przestarzały, wciąż obecny | odrzucony, pula przechodzi w tryb pasywny |
| Wymagania co do jądra | dowolne obsługiwane | io_uring: Linux 5.19+, albo 5.14 z RHEL 9 z backportami; hugepages dla SPDK |
Kolumna BlueStore pochodzi od samej Umbrelli: ceph-volume szyfruje woluminy logiczne „using dmcrypt by specifying the --dmcrypt flag”27, a ms_bind_msgr1 domyślnie wciąż ma wartość true28.
Kolumna FlashStore pochodzi z jego opisu sprzętu i decyzji o zakresie2629.
Dwie z nich zasługują na więcej niż wiersz w tabeli.
Szyfrowanie w spoczynku wypada, z podanym powodem: SPDK omija dm-crypt, a szyfrowania wewnątrz magazynu nie planuje się. Odpowiedź ADR to samoszyfrujące dyski NVMe albo szyfrowanie powyżej magazynu, u klienta albo w RGW29. Jeśli masz wymóg zgodności, który wymienia dm-crypt na OSD, dziś to przeszkoda nie do przejścia.
msgr1 wypada jako zaakceptowane ryzyko. Klienci jądra starsi niż 5.11 i librados sprzed Nautilusa w ogóle nie dogadają się z OSD FlashStore29. Większość środowisk ma to dawno za sobą. Niektóre nie, i dowiaduje się o tym stara, zapomniana skrzynka w kącie.
Mówi monitorowi, że jest BlueStore
To jest to, na czym ludzie się złapią.
Domyślnie OSD FlashStore startuje i mówi monitorom osd_objectstore=bluestore30.
Nie ukrywa się. Dodaje obok własne klucze flashstore_version i flashstore_build30.
Powodem jest zgodność: monitor Umbrelli pozwala na funkcje takie jak nadpisywanie w EC na puli tylko wtedy, gdy każdy OSD w niej zgłasza BlueStore, a moduły managera, jak Prometheus i telemetria, rozgałęziają się na tej samej wartości30.
ADR mówi jasno, że bluestore jest tu „a compat value for mon/mgr feature gates, not a product name”30.
Jest przełącznik, flashstore_report_objectstore=flashstore, który zmienia nazwę wszędzie: w metadanych, kluczach bluestore_bdev_*, loggerze wydajności, poleceniach tell i kodach zdrowia BLUESTORE_*. Wymaga załatanych monitorów, a domyślnie zostaje bluestore2530.
Własne buildy Cepha od croit mają te łatki, więc na nich FlashStore zgłasza się jako flashstore i nic z tego, co dalej, nie ma zastosowania.
Nazwa bluestore jest tam dla standardowych monitorów i managerów, które ludzie dziś prowadzą na produkcji.
Rozumiem dlaczego.
Bramka w monitorze oparta na napisie to projekt Cepha, nie croit, a odmowa powiedzenia bluestore wyłączyłaby funkcje na niezałatanym klastrze.
To jest pułapka na standardowym klastrze.
Każdy dashboard, każdy skrypt inwentaryzacyjny i każde ceph osd count-metadata osd_objectstore, które uruchomisz, policzy OSD FlashStore jako BlueStore.
W trakcie migracji, kiedy najbardziej potrzebujesz wiedzieć, który OSD jest który, oczywiste pole nie powie ci nic.
Sprawdzaj więc flashstore_version w ceph osd metadata, a nie osd_objectstore.
Wpisz to do runbooka, zanim wejdzie pierwszy OSD FlashStore.
Te same pokrętła, inne zachowanie
FlashStore czyta wiele istniejących opcji Cepha i to w większości dobra wiadomość. Nie każda opcja znaczy to, co znaczyła na Umbrelli, a te, które nie znaczą, to miejsca, gdzie dostrojony klaster dostaje niespodziankę.
| Opcja | BlueStore z Umbrelli | FlashStore |
|---|---|---|
compression_mode, na pulę | none, passive, aggressive, force | te same cztery, to samo znaczenie |
compression_algorithm | domyślnie snappy | snappy, zlib, zstd, lz4; poziom zstd ustalony na 1 |
bluestore_compression_max_blob_size_ssd | 64 KiB | kawałki 64 KiB |
osd_memory_target | 4 GiB, cache autostrojone na żywo | czytane raz przy starcie, wymiaruje cache magazynu, bez autostrojenia |
osd_op_queue | mclock_scheduler | przyjmowane i ignorowane |
osd_mclock_* | aktywne | przyjmowane i ignorowane |
csum_type | domyślnie crc32c, dostępne warianty xxhash | stałe crc32c; każda inna wartość zapisuje ostrzeżenie31 |
Kompresja się zgadza.
Domyślny tryb BlueStore to none, a domyślny algorytm to snappy3233; FlashStore implementuje te same cztery tryby, te same opcje pul i ten sam podział na kawałki 64 KiB, a ADR zauważa, że kawałek 64 KiB ściśliwy w 50% zajmuje na obu tyle samo miejsca34.
Nie zawsze miała tu być. Plik ADR nadal nazywa się no-store-compression, od pierwotnej decyzji, odwróconej, gdy croit ustalił wymóg pełnej zgodności funkcjonalnej z klasycznym Cephem34.
Pamięć zgodna nie jest.
Umbrella w trakcie pracy autostroi cache BlueStore względem osd_memory_target3536.
FlashStore czyta tę wartość raz przy starcie, dzieli ją między shardy, a zmiana zrobiona przez ceph config set działa od następnego restartu37.
Nie trzyma też procesu w tych granicach: hugepages, bufory sieciowe i stan PG leżą poza nimi37.
osd_memory_target wymiaruje więc cache FlashStore. Nie ogranicza pamięci OSD tak, jak możesz być przyzwyczajony.
A mClock jest ignorowany całkowicie37.
Nie przytłumiony. Zignorowany.
Nie ma harmonogramu operacji do skonfigurowania, bo każdy rdzeń jest właścicielem swoich PG.
Odtwarzanie i backfill hamują zamiast tego osd_max_backfills, osd_recovery_max_active i opcje uśpienia37.
Jeśli na Umbrelli stroiłeś profile mClock pod przebudowę, te ustawienia nic nie robią na OSD FlashStore i nic cię nie ostrzeże.
Nie ma konwersji, w żadną stronę
Nie da się przekonwertować OSD z BlueStore na OSD z FlashStore. Przewodnik migracji croit mówi to wprost: „There is no in-place conversion of a BlueStore device”38. Proponuje zamiast tego dwie kolejności, i obie to backfill38:
| Dodaj, potem usuń | Zwolnij, potem dodaj | |
|---|---|---|
| Potrzebuje | wolnego gniazda NVMe | niczego zapasowego |
| Krok 1 | przygotuj FlashStore na nowym dysku | ceph osd out, poczekaj na stan clean |
| Krok 2 | poczekaj na active+clean | zatrzymaj i usuń (purge) klasyczny OSD |
| Krok 3 | usuń klasyczny OSD | przygotuj FlashStore na zwolnionym dysku |
| Ryzyko w trakcie | nic ponad zwykły backfill | o jedną kopię mniej do końca backfillu |
Później też nie będzie łatwiej. Format dyskowy FlashStore ma bity funkcji, a montowanie odrzuca nieznany bit: „Every format change means mkfs; unknown bits refuse mount (no downgrade)”7. Zmiana formatu w późniejszym wydaniu FlashStore to więc to samo opróżnianie i ponowne zapełnianie co przy pierwszej migracji.
Jedno dokumentacja podaje źle.
Lista kontrolna w przewodniku migracji każe upewnić się, że „the pools do not use erasure coding on croit-flashstore-osd OSDs”38.
Przewodnik po erasure coding w tej samej migawce mówi, że FlashStore domyślnie obsługuje dawne pule EC, a własna wartość domyślna kodu dla zoptymalizowanego EC to all3940.
Jedno z nich jest nieaktualne, i sądząc po kodzie, jest to przewodnik migracji.
Mimo to przeczytałbym przewodnik po EC w całości, zanim wymieszam pule EC między oboma rodzajami OSD, bo awaria, którą opisuje, to PG, który przechodzi w stan zdegradowany, i backfill, który staje39.
Magazyn zbudowany dla dysków, które naprawdę kupujemy
BlueStore zbudowano, żeby działał na wszystkim. Dyski talerzowe, tanie SSD, NVMe, partycje, LVM, zaszyfrowane woluminy, szybkie urządzenie DB przed wolnym urządzeniem danych. Ta szerokość to powód, dla którego stał się domyślny, i powód, dla którego niesie odroczoną ścieżkę zapisu, opróżnianie przed każdym zatwierdzeniem, bazę klucz/wartość na własnym systemie plików i pulę wątków, żeby to wszystko kręciło się dalej. Każda z tych rzeczy istnieje, bo jakiś dysk gdzieś jej potrzebował.
FlashStore zaczyna od przeciwnego końca. Zakłada, że dysk to NVMe, że ma ochronę przed utratą zasilania i że jest na tyle szybki, że wąskim gardłem jest teraz oprogramowanie. Potem wyrzuca wszystko, co istniało tylko dla innych dysków.
Czy to dobry zakład? Dla nowych klastrów all-flash, zbudowanych na porządnym, korporacyjnym NVMe, tak. W tę stronę idą klastry Cepha, a OSD, który wydaje swoje rdzenie na blokady, przekazania i bazę danych kompaktującą się za jego plecami, płaci, w każdej sekundzie każdego dnia, za elastyczność, której taki klaster nigdy nie użyje.
Ale zakład ma swój koszt i wolę, żebyś go zobaczył, zanim w niego wejdziesz. Rezygnujesz z HDD, dm-crypt, msgr1, strojenia pamięci na żywo i mClock. Na standardowym klastrze dostajesz OSD, który mówi twoim monitorom, że jest BlueStore, bo dzisiejsze monitory i managery nie zostawiają mu innej drogi; własne buildy croit tego nie będą potrzebować. Dostajesz format, do którego nie da się przekonwertować, ani przekonwertować między jego wersjami. I dostajesz to w wersji zapoznawczej, od jednego dostawcy, który akurat mnie zatrudnia.
Traktuj więc kod jako dowód, a nie ten artykuł i nie raport benchmarków croit. Zapisy decyzji są publiczne i mówią, co zmierzono i co wyrzucono. Przeczytaj je, zbuduj testowy klaster na sprzęcie, który naprawdę byś wdrożył, i zmierz własne obciążenie. Jeśli na twoich dyskach robi to, co mówią ADR, będziesz wiedział. Jeśli nie, też będziesz wiedział, i dowiesz się tego na klastrze testowym.
croit ceph-rust, README w migawce 48f9014 — komponenty, status i mapa drogowa, „not yet recommended for production data”, zgodność protokołu z v21.2.0 i v20.2.4. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
ADR 0003, green-field, bez forka Crimsona — „No fork, no linking of Ceph code”; kod Cepha czytany jako punkt odniesienia, specyfikacje własnymi słowami. ↩︎
ADR 0164, licencje — demon i narzędzia LGPL-3.0-only, biblioteki klienckie MPL-2.0, dokumentacja CC-BY-SA-4.0 i powód wyboru MPL. ↩︎ ↩︎
Ceph Umbrella, BlueStore configuration reference — bezpośredni dostęp do urządzenia, urządzenie DB, „writes smaller than min_alloc_size must first pass through the BlueStore WAL”, sumy kontrolne. ↩︎ ↩︎ ↩︎ ↩︎
Ceph Umbrella, storage devices — BlueStore „consumes raw block devices or partitions”; RocksDB wbudowana na wewnętrzne metadane. ↩︎ ↩︎
Ceph v21.2.0,
bluestore_kvbackend— domyślnierocksdb. ↩︎ ↩︎ADR 0021, silnik magazynu — B+drzewo COW na shard, pierścień WAL, równoległe zatwierdzanie, checkpointy, dane inline, wstrzymane zwolnienia, „Every format change means mkfs”. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
ADR 0004, I/O magazynu — SPDK przez vfio, poprawione do dwóch warstw z io_uring, bezczynność taktowana przez urządzenie. ↩︎ ↩︎
ceph-rust docs, prepare and activate —
spdkto domyślny backend,kernelikernel-cmdzostawiają NVMe na sterowniku jądra. ↩︎Ceph v21.2.0,
bluestore_allocator— domyślniehybrid. ↩︎Ceph v21.2.0,
bluestore_csum_type— domyślniecrc32c. ↩︎ceph-rust, użycie croit-flashstore-tool — „fresh prepare/mkfs –omap-engine btree|lsm|rocksdb”. ↩︎
Ceph v21.2.0,
bluestore_min_alloc_size_ssd— domyślnie 4 KiB. ↩︎Ceph v21.2.0,
bluestore_prefer_deferred_size_ssd— domyślnie 0. ↩︎Ceph v21.2.0,
BlueStore.cc, maszyna stanów transakcji — oczekujące aio przenoszą transakcję doSTATE_AIO_WAIT, zanim trafi do kolejki zatwierdzania klucz/wartość. ↩︎Ceph v21.2.0,
BlueStore.cc, wątek synchronizacji kv — „flush/barrier on block device” przed wysłaniem do RocksDB. ↩︎ ↩︎ADR 0027, atomowe zatwierdzanie jednym I/O, odrzucone — „gain only at QD1”, zbudowane i usunięte. ↩︎
Ceph v21.2.0,
bluestore_write_v2— „Use faster write path”, domyślnie false. ↩︎Ceph v21.2.0,
BlueStore.cc,_do_write_small— odczyt początku i końca, potem „chunk-aligned deferred overwrite”. ↩︎Ceph v21.2.0,
BlueStore.cc, “journal deferred items” — odroczona transakcja jest ustawiana jako klucz w tej samej transakcji RocksDB. ↩︎Ceph v21.2.0,
BlueStore.cc, prefiksy kluczy —PREFIX_DEFERRED = "L". ↩︎Domyślne ustawienia wątków w Ceph v21.2.0 —
osd_op_num_shards_ssd8;osd_op_num_threads_per_shard_ssd2;osd_op_queuemclock_scheduler;ms_async_op_threads3; tworzenie wątków wBlueStore.cc,bstore_kv_syncibstore_kv_final. ↩︎ADR 0006, runtime z wątkiem na rdzeń — jeden przypięty, aktywnie odpytujący wątek na rdzeń, PG należące do jednego rdzenia, „idle cores burn CPU (accepted …)”. ↩︎ ↩︎
ADR 0008, współbieżność i trwałość — „no locks, no atomics, no shared mutable state”; PLP wymagane,
mkfsodrzuca dyski bez PLP, obejście FUA do labu. ↩︎ ↩︎ceph-rust docs, opis konfiguracji —
flashstore_coresdomyślnie 8,flashstore_store_shardsauto,flashstore_report_objectstore. ↩︎ ↩︎ ↩︎ceph-rust docs, wymagania sprzętowe i hosta — ulotna pamięć podręczna zapisu daje FAIL, LBA 4 KiB, bez partycji, wymagania co do jądra i io_uring. ↩︎ ↩︎
Ceph Umbrella, ceph-volume encryption — „Logical volumes can be encrypted using dmcrypt by specifying the
--dmcryptflag”. ↩︎Ceph v21.2.0,
ms_bind_msgr1— domyślnie true. ↩︎ADR 0168, szyfrowanie w spoczynku, msgr1 i cache tiering poza zakresem — „SPDK bypasses dm-crypt”; klienci tylko z v1 „cannot reach croit-flashstore-osd”. ↩︎ ↩︎ ↩︎
ADR 0019, zgłaszanie
osd_objectstore=bluestore— bramki funkcji w monitorze, dodatkowe kluczeflashstore_*i opcja zgłaszaniaflashstore. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ceph-rust,
pgs.rs— „csum_type {v} unsupported; using fixed crc32c per 4096-byte block”. ↩︎Ceph v21.2.0,
bluestore_compression_mode— domyślnienone. ↩︎Ceph v21.2.0,
bluestore_compression_algorithm— domyślniesnappy. ↩︎ADR 0059, kompresja magazynu na pulę — te same tryby i opcje co BlueStore, stały poziom zstd 1, miejsce przy ściśliwości 50% „identical to BlueStore”. ↩︎ ↩︎
Ceph v21.2.0,
osd_memory_target— domyślnie 4 GiB. ↩︎Ceph v21.2.0,
bluestore_cache_autotune— domyślnie true. ↩︎ADR 0062, cel pamięci i mClock — cel czytany raz, bez autostrojenia, RSS nieegzekwowane; opcje mClock „ACCEPTED and IGNORED”. ↩︎ ↩︎ ↩︎ ↩︎
ceph-rust docs, migracja z klasycznego — „There is no in-place conversion of a BlueStore device”; dwie kolejności; linia o EC na liście kontrolnej. ↩︎ ↩︎ ↩︎
ceph-rust docs, pule z erasure coding —
ec_enable_poolsdomyślnieall,ec_enable_optimizeddomyślniealli jak wygląda odrzucona pula. ↩︎ ↩︎ceph-rust, domyślne ustawienia OSD —
("ec_enable_optimized", "all"). ↩︎