Tym razem host istnieje. Tylko na złym hiperwizorze
Ostatnio problem polegał na tym, że maszyna nazwana w inwentarzu jeszcze nie istniała: ani IP, ani SSH, ani Pythona, nic, z czym można się połączyć. Każde zadanie trzeba było delegować gdzie indziej.
Migracja z VMware odwraca to i nie zmienia niczego. Maszyna istnieje, działa, ludzie z niej korzystają. A ty i tak nigdy się z nią nie łączysz. To nazwa i worek zmiennych opisujących coś, co trzeba odbudować gdzie indziej. Każde zadanie nadal działa na węźle sterującym, tyle że po drugiej stronie są teraz dwa API zamiast jednego.
Słowo o tym, czym to jest. Ten wpis to projekt i playbook, a nie opowieść z frontu. Nie puściłem go jeszcze od początku do końca na produkcyjnym środowisku. Wszystko, co niżej mówię o zachowaniu modułów, wyczytałem z dostarczanego kodu i sprawdziłem, a tam, gdzie twierdzenie pochodzi ze źródeł, a nie z uruchomienia, mówię to wprost. Kiedy zrobię nim prawdziwą migrację, liczby i niespodzianki dostaną własny wpis.
Wersje, na których to sprawdzałem:
$ ansible --version | head -1
ansible [core 2.20.7]

$ ansible-galaxy collection list | grep -E 'vmware|proxmox'
community.proxmox 1.6.0
community.vmware  6.2.1
vmware.vmware     2.9.0
Poniższe fragmenty są wycięte z jednego playbooka: migrate.yml, dynamicznego inwentarza vSphere w inventory/vmware.vms.yml i jednego group_vars/all.yml. Nazwy centrum danych, węzłów i magazynów uogólniłem dla czytelności.
Kształt roboty
Pięć kroków, a kosztuje tylko ostatni.
Kolejność to cały projekt. Rozpoznanie niczego nie zmienia. Budowa sieci zmienia tylko Proxmox. Budowa skorup zmienia tylko Proxmox, a skorupę bez dysku tanio usunąć. Przenoszenie dysków jest wolne, ale odbywa się na żywo. Dopiero ostatni play cokolwiek wyłącza.
Odejdź w połowie, a każdy gość nadal działa na VMware, nietknięty.
Dwie kolekcje, a jedna z nich idzie na emeryturę
Potrzebujesz obu, i to nie z powodu, który byś zgadł.
collections:
  - name: community.vmware
    version: ">=6.2.1"
  - name: vmware.vmware
    version: ">=2.5.0"
  - name: community.proxmox
    version: ">=1.6.0"
community.vmware to stara, szeroka kolekcja i właśnie jest rozbierana. Jej MANIFEST.json deklaruje {"vmware.vmware": ">=2.5.0"} jako twardą zależność, więc instalacja pierwszej ściąga drugą, czy o to prosiłeś, czy nie. Moduły przechodzą po jednym, a te, po które sięgasz przy migracji, są na różnych etapach tej przeprowadzki:
vmware_dvs_portgroup_info: nadal tylko wcommunity.vmware, a to on czyta twoje VLAN-y.vmware_vmotion: nadal tylko wcommunity.vmware.vmware_guest_powerstate: przestarzały, usunięty wcommunity.vmware7.0.0. Użyjvmware.vmware.vm_powerstate.vmware_vm_inventory: przestarzały, usunięty w 7.0.0. Użyjvmware.vmware.vms.
Ansible mówi ci o przestarzałych modułach przy pierwszym uruchomieniu, co jest z jego strony przyzwoite:
[DEPRECATION WARNING]: community.vmware.vmware_guest_powerstate has been deprecated.
Use vmware.vmware.vm_powerstate instead. This feature will be removed from
collection 'community.vmware' version 7.0.0.
Nie ostrzega cię jednak o wtyczce inwentarza, bo wtyczki inwentarza są parsowane, zanim ta maszyneria w ogóle ruszy. Musisz sam pójść i przeczytać wtyczkę.
W tym podziale jest trzecia pułapka. vmware.vmware.vm_portgroup_info wygląda dokładnie na to, czego chce migracja sieci: per VM, per karta, daje portgroup i VLAN. Ale jest zbudowany na ModuleRestBase i importuje com.vmware.vapi, co znaczy, że na węźle sterującym potrzebuje vSphere Automation SDK, a nie samego pyVmomi. Jego udokumentowany zwrot jest też nieaktualny: blok RETURN obiecuje name i vlan_id, a kod w rzeczywistości buduje portgroup_name i słownik vlan_info dla przypadku rozproszonego. Poszedłem inną drogą, opisaną niżej, i nie potrzebowałem żadnego z nich.
Inwentarz jest rozpoznaniem
W tym playbooku nie ma playa „idź i znajdź VM-y”, bo zanim ruszy pierwsze zadanie, inwentarz już to zrobił, i to jednym zapytaniem property collectora, a nie pętlą po każdej VM.
# inventory/vmware.vms.yml
plugin: vmware.vmware.vms

hostname: "{{ lookup('ansible.builtin.env', 'VMWARE_HOST') }}"
username: "{{ lookup('ansible.builtin.env', 'VMWARE_USER') }}"
password: "{{ lookup('ansible.builtin.env', 'VMWARE_PASSWORD') }}"
validate_certs: false

search_paths:
  - /Datacenter-1

properties:
  - name
  - config.name
  - config.uuid
  - config.guestId
  - config.firmware
  - config.template
  - config.hardware.numCPU
  - config.hardware.numCoresPerSocket
  - config.hardware.memoryMB
  - config.hardware.device
  - summary.runtime.powerState

gather_compute_objects: true
hostnames: ['name']
filter_expressions:
  - 'config.template'
Nazwa pliku ma znaczenie. verify_file wtyczki przyjmuje tylko pliki kończące się na vms.yml, vms.yaml, vmware_vms.yml lub vmware_vms.yaml. Nazwij go vcenter.yml, a po cichu przestaje być twoim inwentarzem.
search_paths filtruje przed zapytaniem, a nie po nim. W dużym środowisku to różnica między sekundami a minutami. Inaczej niż filter_expressions, o którym dokumentacja mówi jasno: działa po zebraniu danych i „does not affect the speed of the inventory plugin”.
filter_expressions odrzuca hosta, gdy wyrażenie jest prawdziwe. config.template usuwa więc szablony, co za pierwszym razem czyta się na odwrót.
A ważna linia to config.hardware.device, której nie ma na żadnej domyślnej liście właściwości. To cały inwentarz sprzętowy VM i niesie trzy rzeczy, bez których ta migracja nie ruszy: MAC każdej karty sieciowej, klucz dvportgroup, do którego każda karta jest podpięta, i ścieżkę datastore każdego dysku. Bez tego wracasz do pętli vmware_guest_info, jedna wymiana z serwerem na każdą VM.
Urządzenia wracają jako JSON z zachowanym typem vSphere w _vimtype. Warto to wiedzieć, bo tak odróżniasz kartę sieciową od dysku. Sprawdziłem enkoder, zamiast zgadywać:
{
  "_vimtype": "vim.vm.device.VirtualVmxnet3",
  "macAddress": "00:50:56:87:a5:9a",
  "backing": {
    "_vimtype": "...DistributedVirtualPortBackingInfo",
    "port": {
      "_vimtype": "vim.dvs.PortConnection",
      "portgroupKey": "dvportgroup-1014"
    }
  }
}
Blok compose może więc wyciągnąć niewygodne ścieżki do płaskich hostvars:
compose:
  vm_moid: moid
  vm_firmware: config.firmware
  vm_memory_mb: config.hardware.memoryMB
  vm_num_cpu: config.hardware.numCPU

  # A virtual NIC is any device with a MAC. Filtering on _vimtype does not
  # work cleanly here, because VMXNET3, E1000 and SR-IOV cards are all
  # different types with no shared substring.
  vm_nics: >-
    config.hardware.device
    | selectattr('macAddress', 'defined')
    | selectattr('macAddress', 'ne', None) | list

  # Disks are one exact type, so this one can match on it.
  vm_disks: >-
    config.hardware.device
    | selectattr('_vimtype', 'eq', 'vim.vm.device.VirtualDisk') | list
Ta asymetria jest prawdziwa i łapie ludzi. Nie ma typu VirtualEthernetCard, do którego można dopasować. To abstrakcyjna klasa bazowa, a vCenter faktycznie podaje ci VirtualVmxnet3, VirtualE1000, VirtualE1000e, VirtualPCNet32 albo VirtualSriovEthernetCard. Nie mają wspólnego podciągu. Za to MAC ma tylko karta sieciowa.
Każdy moduł info ukrywa pole, którego potrzebujesz
To nić przewodnia całej roboty, a kiedy zobaczysz to trzy razy, zaczynasz sprawdzać każdą wartość domyślną, zanim napiszesz zadanie.
vmware_dvs_portgroup_info ma sześć opcji show_*. Pięć ma domyślnie true. Szósta to show_vlan_info i domyślnie ma false.
show_mac_learning=dict(type='bool', default=True),
show_network_policy=dict(type='bool', default=True),
show_teaming_policy=dict(type='bool', default=True),
show_uplinks=dict(type='bool', default=True),
show_port_policy=dict(type='bool', default=True),
show_vlan_info=dict(type='bool', default=False),
Zostaw to w spokoju, a dostaniesz politykę uczenia MAC, politykę teamingu, kolejność uplinków i politykę portów dla każdej portgroupy w środowisku. Wszystko poza tagiem VLAN, który jest jedynym polem, o które migracja sieci naprawdę pyta. Zadanie jest więc na lewą stronę wobec tego, co napisałbyś odruchowo: włącz tę jedną rzecz, wyłącz pozostałe pięć.
- name: Read the distributed portgroups
  community.vmware.vmware_dvs_portgroup_info:
    datacenter: "{{ vcenter_datacenter }}"
    show_vlan_info: true
    show_network_policy: false
    show_teaming_policy: false
    show_port_policy: false
    show_mac_learning: false
    show_uplinks: false
  register: dvs_pgs
To nie jest jednorazowy wybryk. vmware.vmware.vms ma gather_compute_objects, które wypełnia cluster i esxi_host: domyślnie false. community.vmware.vmware_vm_info ma show_allocated, blok z CPU i pamięcią: domyślnie false. We wszystkich trzech przypadkach pole drogie do zebrania jest tym, którego migracja potrzebuje, a wartość domyślna chroni zastosowanie raportowe tylko do odczytu, a nie to, w którym jesteś.
vlan_id ma trzy różne typy
Potem dostajesz tagi VLAN i okazuje się, że nie mają jednego kształtu. Prosto z get_vlan_info:
if isinstance(vlan_obj, vim...TrunkVlanSpec):
    ...
    return dict(trunk=True, pvlan=False, vlan_id=vlan_id_list)
elif isinstance(vlan_obj, vim...PvlanSpec):
    return dict(trunk=False, pvlan=True, vlan_id=str(vlan_obj.pvlanId))
else:
    return dict(trunk=False, pvlan=False, vlan_id=str(vlan_obj.vlanId))
Portgroup dostępowa daje ci napis "100". PVLAN daje napis. Trunk daje listę napisów, każdy w postaci "20" albo "20-30". A każdy przełącznik rozproszony ma na sobie co najmniej jeden trunk, czy go zrobiłeś, czy nie, bo portgroup uplinków jest trunkiem niosącym "0-4094".
| int jest więc dla ciebie niedostępne, dopóki nie wyrzucisz dwóch pozostałych kształtów:
access_pgs: >-
  {{ dvs_pgs.dvs_portgroup_info | dict2items | map(attribute='value') | flatten
     | rejectattr('vlan_info.trunk') | rejectattr('vlan_info.pvlan')
     | rejectattr('vlan_info.vlan_id', 'in', ['0', 0])
     | list }}
Trzy odrzucenia, w tej kolejności. Wylatują trunki, wylatują PVLAN-y, a potem portgroupy nietagowane, co załatwia też grupy uplinków i wszystko na VLAN 0.
Nie tłumaczę trunków ani PVLAN-ów automatycznie i postawiłbym się każdemu, kto by to robił. Trunk VMware lądujący na Proxmox potrzebuje albo strefy Q-in-Q, albo VNetu świadomego VLAN-ów, a który jest właściwy, zależy od tego, co gość spodziewa się widzieć. To decyzja, a nie mapowanie. Playbook je wypisuje i idzie dalej:
TASK [Report what was found]
ok: [localhost] => {
    "msg": "3 access portgroups -> [100, 200]. Not translated:
            ['dvs_001-uplink'] (trunks), ['isolated'] (PVLANs)."
}
Odwzorowanie VLAN-ów w SDN
Jedna strefa VLAN przypięta do mostu, potem jeden VNet na każdy VLAN, z tagiem.
- name: Create the VLAN zone
  community.proxmox.proxmox_zone:
    zone: "{{ sdn_zone }}"
    type: vlan
    bridge: "{{ sdn_bridge }}"
    mtu: "{{ sdn_mtu }}"
    state: present

- name: Create one VNet per VMware VLAN
  community.proxmox.proxmox_vnet:
    vnet: "{{ sdn_vnet_prefix }}{{ item.vlan_info.vlan_id | int }}"
    zone: "{{ sdn_zone }}"
    tag: "{{ item.vlan_info.vlan_id | int }}"
    alias: "{{ item.portgroup_name }}"
    state: present
  loop: "{{ access_pgs | unique(attribute='vlan_info.vlan_id') }}"
  throttle: 1
Nazwy VNetów są krótkie i ograniczone, a nazwy portgroup VMware nie. Production-Web-Tier-VLAN100 to zupełnie zwyczajna nazwa portgroupy i niemożliwa nazwa VNetu. Nazwa jest więc generowana, v100 z tagu, a czytelny oryginał trafia do alias, gdzie pozostaje widoczny w interfejsie i w wyjściu pvesh. Wyprowadzanie nazwy z VLAN-u, a nie z portgroupy, oznacza też, że mapowanie da się odwrócić na oko pół roku później.
Dwie portgroupy na tym samym VLAN-ie zlewają się w jeden VNet. To poprawne, bo w VMware też były tą samą domeną rozgłoszeniową, ale powinieneś zobaczyć, że tak się dzieje, i to właśnie robi unique(attribute='vlan_info.vlan_id'). Dwie portgroupy o nazwach prod-web i prod-web-b, obie na VLAN 100, dają jeden v100.
throttle: 1 to nie ostrożność, tylko moduł. Każdy zapis SDN w community.proxmox bierze globalną blokadę klastra, stosuje oczekującą konfigurację i zwalnia blokadę: get_global_sdn_lock(), potem apply_sdn_changes_and_release_lock(). Puść je równolegle, a i tak ustawią się w kolejce na blokadzie; throttle po prostu przestaje udawać, że jest inaczej. Warto też wiedzieć, że wycofanie zmian przy błędzie zależy od wersji: moduł sprawdza is_lock_and_rollback_supported i na starszym PVE mówi ci, że nie mógł wycofać, zamiast to zrobić.
Jedna kosmetyczna rzecz, przez którą zwątpisz w siebie. W 1.6.0 proxmox_vnet wypluwa cały swój słownik parametrów jako ostrzeżenie Ansible przy każdym jednym tworzeniu:
self.module.warn(f"{vnet_params}")
self.proxmox_api.cluster().sdn().vnets().post(**vnet_params)
To linia debugowa, którą ktoś zostawił. To szum, a nie usterka.
Zbuduj skorupy, bez dysków
Teraz maszyny wirtualne i tu projekt na siebie zarabia. Każda VM powstaje w Proxmox z właściwą liczbą CPU, właściwą pamięcią, właściwym firmware i właściwymi kartami sieciowymi na właściwych VLAN-ach. Bez żadnych dysków.
Skorupa bez dysku powstaje szybko, usuwa się ją za darmo, a jak ktoś ją przypadkiem uruchomi, staje na monicie PXE. Możesz zbudować ich czterysta w jedno popołudnie, obejrzeć wynik, uznać, że jest zły, usunąć wszystko i zrobić od nowa. Nic nie zostało skopiowane, nic nie zostało wyłączone i nikt niczego nie zauważył.
Wartości pochodne są deklaracjami, a nie zadaniami. Ansible wylicza je leniwie względem hosta, który akurat jest w zasięgu, więc każda VM dostaje własne bez jednego set_fact:
# group_vars/all.yml
pve_vmid: "{{ vmid_base | int + (vm_moid | regex_replace('^vm-', '') | int) }}"
pve_bios: "{{ 'ovmf' if vm_firmware == 'efi' else 'seabios' }}"
pve_cores: "{{ vm_cores_per_socket | int }}"
pve_sockets: "{{ ((vm_num_cpu | int) / (vm_cores_per_socket | int)) | round(0, 'ceil') | int }}"
VMID pochodzi z MoID vCenter. vm-42 staje się 20042. To ważniejsze, niż wygląda: play przełączenia musi znaleźć VM, którą stworzył play budowy, a ponowne uruchomienie musi trafić w tę samą, zamiast po cichu budować drugą. Pozwolenie API na przydzielenie następnego wolnego ID, co dzieje się, gdy pominiesz vmid, i o czym pisałem ostatnio, czyni to niemożliwym.
Pamięć nie wymaga przeliczania. VMware raportuje config.hardware.memoryMB, a Proxmox chce MB. Gniazda wymagają: VMware daje łączną liczbę vCPU i rdzeni na gniazdo, Proxmox chce gniazd i rdzeni.
- name: Create the VM shell
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    name: "{{ inventory_hostname }}"
    cores: "{{ pve_cores }}"
    sockets: "{{ pve_sockets }}"
    memory: "{{ vm_memory_mb }}"
    ostype: "{{ pve_ostype }}"
    bios: "{{ pve_bios }}"
    scsihw: "{{ default_scsihw }}"
    efidisk0: "{{ {'storage': pve_target_storage, 'efitype': '4m',
                   'pre_enrolled_keys': false}
                  if pve_bios == 'ovmf' else omit }}"
    agent: "enabled=1"
    onboot: false
    state: present
onboot: false celowo. W środku migracji nic nie powinno startować samo, a już najmniej maszyna, na której dyski wciąż pisze inny hiperwizor.
Firmware musi być dobrze, nie ma wyboru. Gość UEFI zaimportowany na VM z SeaBIOS zaimportuje się idealnie, a potem odmówi startu, i stracisz na tym godzinę. config.firmware to efi albo bios i mapuje się wprost na ovmf i seabios. Gość UEFI potrzebuje też dysku zmiennych EFI, który trzeba utworzyć razem z VM; dlaczego, piszę niżej.
proxmox_kvm nie naprawi karty sieciowej i ci o tym nie powie
Ostatnio pisałem, że proxmox_kvm odmawia zbieżności, zamiast aktualizować. Oto ostrzejsza wersja tego samego, która ugryzła mnie przy pisaniu tego wpisu i w której warto być dokładnym.
update ma domyślnie false, więc ponowne uruchomienie na VM, która już istnieje, nic nie robi. W porządku i udokumentowane. Ale ustaw update: true, a moduł i tak odmówi ruszenia niektórych parametrów:
# If update, don't update disk (virtio, efidisk0, tpmstate0, ide, sata, scsi)
# and network interface, unless update_unsafe=True
if update_unsafe is False:
    ...
    if "efidisk0" in kwargs:
        del kwargs["efidisk0"]
Usuwa je z żądania i jedzie dalej. Poprawiasz więc kartę sieciową w mapowaniu inwentarza, uruchamiasz ponownie z update: true, patrzysz, jak Ansible raportuje changed, a karta jest dokładnie tak samo zła jak była. changed jest prawdą, bo coś innego w ładunku zostało zaktualizowane, ale nie to, co naprawiałeś.
update_unsafe: true znosi ograniczenie, a nazwa jest uczciwa. Ta sama osłona obejmuje dyski, więc na VM, która ma dyski, niebezpieczna aktualizacja to dobry sposób, żeby dorobić się drugiej kopii jednego z nich. Po ten przełącznik nie sięga się w trakcie migracji.
Wyjście jest takie, żeby w ogóle nie używać net. Karty sieciowe zakłada się przez proxmox_nic, moduł, którego całą robotą jest jeden interfejs i który zbiega się porządnie:
- name: Attach each NIC to its VNet
  delegate_to: localhost
  community.proxmox.proxmox_nic:
    vmid: "{{ pve_vmid }}"
    interface: "net{{ idx }}"
    bridge: "{{ sdn_vnet_prefix }}{{ pg_vlan[item.backing.port.portgroupKey] }}"
    mac: "{{ item.macAddress }}"
    model: "{{ default_net_model }}"
    state: present
  loop: "{{ vm_nics }}"
  loop_control:
    index_var: idx
To ten sam podział, do którego doszedłem ostatnio: proxmox_kvm do zdefiniowania maszyny, proxmox_disk i proxmox_nic do rzeczy, które zmieniają się potem. Parametr nazywa się mac, nie mac_addr.
efidisk0 nie da się wynieść w ten sam sposób, bo proxmox_disk nie ma efitype ani pre_enrolled_keys, więc musi trafić na VM przy tworzeniu i być dobrze za pierwszym razem.
Przenieś MAC. VMware rozdaje MAC-i z 00:50:56:..., a Proxmox przyjmie je bez narzekania. Zachowanie ich oznacza, że rezerwacje DHCP nadal pasują, licencje przypięte do MAC nadal się weryfikują, a każda reguła zapory napisana pod MAC nadal działa. Zmiana oznacza dzień drobnych zagadek. proxmox_nic przyjmuje też model: vmxnet3, jeśli gość ma widzieć tę samą kartę co wcześniej, ale na KVM virtio jest lepszą kartą, a gość Windows i tak będzie chciał nowych sterowników.
Odmów, zamiast zgadywać
Karta sieciowa na standardowej portgroupie w ogóle nie ma backing.port. Jej backing to NetworkBackingInfo z deviceName. Nie będzie jej w mapie, a właściwe, co można zrobić, to się zatrzymać:
- name: Every NIC must sit on a distributed portgroup with a VNet
  ansible.builtin.assert:
    that:
      - vm_nics | rejectattr('backing.port.portgroupKey', 'defined') | list | length == 0
      - vm_nics | map(attribute='backing.port.portgroupKey')
          | reject('in', pg_vlan.keys() | list) | list | length == 0
    fail_msg: >-
      {{ inventory_hostname }} has NICs that do not map to a Proxmox VNet.
      Attaching it to the wrong network is worse than not building it.
Dwa warunki zamiast jednego, bo pierwszy musi zadziałać przed drugim: map(attribute=...) po karcie bez port wybuchłoby na niezdefiniowanym odwołaniu. Najpierw odrzuć te bez kształtu, potem sprawdź resztę względem mapy.
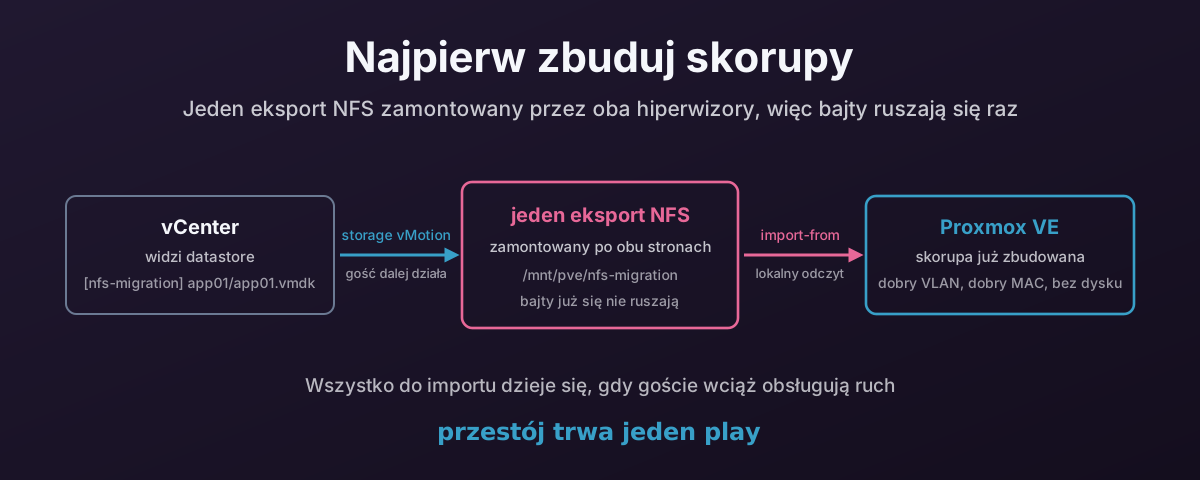
Jeden eksport, zamontowany dwa razy
Oto część, dzięki której całość jest tania.
Postaw eksport NFS tam, gdzie oba hiperwizory mogą go zamontować. vCenter widzi datastore o nazwie nfs-migration; węzły Proxmox montują ten sam eksport i widzą /mnt/pve/nfs-migration. Teraz przenieś VMDK-i na niego przez storage vMotion.
Storage vMotion działa na żywo. Gość obsługuje ruch przez cały czas. Nic nie jest przełączane, okno nie jest potrzebne, a całość można porzucić w połowie bez skutków poza zmarnowanym I/O. To zdecydowanie najwolniejszy etap i nic nie kosztuje.
- name: Relocate to the NFS datastore
  delegate_to: localhost
  throttle: 2
  community.vmware.vmware_vmotion:
    moid: "{{ vm_moid }}"
    destination_datastore: "{{ nfs_datastore_vmware }}"
    timeout: "{{ vmotion_timeout }}"
timeout ma domyślnie 3600, czyli godzinę. VMDK o rozmiarze 2 TB nie zdąży, a tryb awarii jest paskudny w cichy sposób: zadanie Ansible zawodzi, a vMotion w vCenter jedzie dalej. Masz teraz playbook, który mówi, że się nie udało, i środowisko, które wciąż jest zajęte. Ustaw coś, co odpowiada twojemu prawdziwemu magazynowi.
throttle: 2, bo wąskim gardłem nie jest węzeł sterujący. Storage vMotion ogranicza macierz i sieć. Sześć naraz nie daje sześć razy większej przepustowości; daje sześć wolnych migracji i wściekły zespół od storage’u.
Moduł jest idempotentny tak, jak chcesz: ustawia storage_vmotion_needed = False, jeśli VM już jest na docelowym datastore, więc ponowne uruchomienie, żeby zebrać maruderów, jest bezpieczne.
Gdy to się skończy, bajty leżą na magazynie, który Proxmox już montuje. W związku z tym nic innego nie musi ich kopiować. Nigdy.
Przełączenie
To jedyny play, który kosztuje przestój, a kolejność w nim nie podlega negocjacjom.
Najpierw problem, który łatwo przeoczyć: inwentarz jest teraz nieaktualny. Zebrano go przed vMotion, więc vm_disks nadal trzyma stare ścieżki datastore. Importuj z nich, a wskażesz Proxmoxowi ścieżkę, której nie widzi.
- name: Re-read the inventory now the disks have moved
  ansible.builtin.meta: refresh_inventory
Dlatego też cache jest wyłączony w konfiguracji inwentarza. Ciepły cache oddałby refresh_inventory dokładnie te nieaktualne dane, które miało zastąpić. To prawdziwy kompromis, bo vCenter nie jest szybki, ale zła ścieżka tutaj to nieudane przełączenie w oknie serwisowym, a dodatkowe zapytanie jest przy tym tanie.
Potem wyłączenie. Import VMDK, który host ESXi wciąż ma otwarty, daje w najlepszym razie kopię spójną jak po awarii:
- name: Shut the guest down in VMware
  delegate_to: localhost
  vmware.vmware.vm_powerstate:
    moid: "{{ vm_moid }}"
    state: "{{ 'shutdown-guest' if vm_power_state == 'poweredOn' else 'powered-off' }}"
    timeout: 600
    force: true
shutdown-guest to łagodne wyłączenie przez VMware Tools; force: true twardo zatrzymuje wszystko, co nie zejdzie w limicie czasu. W nowym module parametr nazywa się timeout, a nie state_change_timeout, jak w przestarzałym.
Potem import, który jest osią całości:
- name: Import each VMDK onto its VM
  delegate_to: localhost
  throttle: 2
  community.proxmox.proxmox_disk:
    vmid: "{{ pve_vmid }}"
    disk: "scsi{{ idx }}"
    storage: "{{ pve_target_storage }}"
    import_from: >-
      {{ item.backing.fileName
         | regex_replace('^\[[^\]]+\]\s*', '/mnt/pve/' ~ nfs_storage_pve ~ '/') }}
    format: "{{ pve_target_format }}"
    timeout: "{{ import_timeout }}"
    create: regular
    state: present
  loop: "{{ vm_disks }}"
  loop_control:
    index_var: idx
regex_replace tłumaczy między dwoma światami. vCenter nazywa dysk [nfs-migration] app01/app01.vmdk; Proxmox dociera do tego samego pliku pod /mnt/pve/nfs-migration/app01/app01.vmdk. Ten sam eksport, te same bajty, bez drugiej kopii. Bierzesz deskryptor .vmdk i ignorujesz -flat.vmdk obok niego: qemu-img czyta deskryptor i idzie za nim do extentu.
Trzy rzeczy o import_from, wszystkie w module i wszystkie warte poznania przed otwarciem okna.
Działa tylko przy tworzeniu. W gałęzi aktualizacji:
# 'import_from' fails on disk updates
playbook_config = self.get_create_attributes()
playbook_config.pop("import_from", None)
Jeśli scsi0 już istnieje na tej VM, parametr jest porzucany i dostajesz zwykłą aktualizację. Ponowne uruchomienie po złym imporcie nie importuje więc ponownie. Po cichu nie robi zupełnie nic i raportuje sukces. Jeśli import pójdzie źle, usuń dysk, zanim spróbujesz jeszcze raz.
timeout ma domyślnie 600 sekund. Dziesięć minut na import i konwersję dysku maszyny wirtualnej. Własna dokumentacja modułu mówi, żeby to podnieść; posłuchaj rady.
A ścieżka bezwzględna wymaga roota. Dokumentacja mówi to bez ogródek:
<STORAGE>:<VMID>/<FULL_NAME>or<ABSOLUTE_PATH>/<FULL_NAME>.<STORAGE>:import/<FULL_NAME>for PVE 9.x and later, to use storage’s import directory. Attention! Only root can use absolute paths.
Co ląduje niezręcznie obok rady, którą dałem ostatnio i której nadal się trzymam: używaj tokenu API o ograniczonym zakresie, a nie roota. Ta rada obowiązuje na każdym innym etapie: rozpoznanie, SDN, budowa skorup, ustawianie kolejności rozruchu, wszystko działa dobrze z tokenem. To jedno zadanie nie działa i żadna ilość uprawnień w roli tego nie zmieni, bo ograniczenie dotyczy tego, czy użytkownik jest rootem, a nie uprawnienia.
Są trzy uczciwe wyjścia i nie ma sprytnego czwartego:
- PVE 9.x: użyj
<storage>:import/<file>i zostań przy tokenie. - PVE 8.x: zrób to jedno zadanie jako
root@pam, i tylko to jedno. - PVE 8.x, bez roota przez API: uruchom zamiast tego
qm importdiskprzez SSH.
Playbook obsługuje dwa pierwsze przez flagę, bo udawanie, że jest inaczej, przerzuciłoby tylko problem na tego, kto go uruchamia.
Na koniec kolejność rozruchu, która jest zwykłą aktualizacją i dlatego ograniczenie update_unsafe jej nie dotyczy:
- name: Boot from the first imported disk
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    boot: "order=scsi0"
    update: true
Nic nie uruchamia gościa. To celowe. Uruchom go ręcznie, popatrz, jak wstaje, i dopiero wtedy myśl o usuwaniu czegokolwiek w VMware.
Uruchamianie
Całość to jeden playbook, otagowany etapami, bo to nie są kroki, które chcesz puszczać razem:
ansible-playbook migrate.yml --tags discover   # look, change nothing
ansible-playbook migrate.yml --tags sdn        # build the VLANs
ansible-playbook migrate.yml --tags build      # build the diskless shells
ansible-playbook migrate.yml --tags relocate   # storage vMotion, live
ansible-playbook migrate.yml --tags cutover    # power off and import
--limit jest twoim przyjacielem przez cały czas. Zrób najpierw jedną VM. Zrób jeden klaster. Playbook nie ma zdania o tym, ile odgryzasz naraz, a inwentarz daje ci grupy za darmo: power_poweredOn, cluster_<name>, a do tego vmware_windows i vmware_linux z bloku groups.
Sprawdź, w co celujesz, zanim wycelujesz:
ansible-inventory --graph
ansible-inventory --host some-vm
Na co jeszcze bym uważał
Rzeczy, które spodziewam się znaleźć, gdy to spotka prawdziwe środowisko, zapisane teraz, żebym nie mógł potem twierdzić, że je przewidziałem:
- Goście Windows nie wystartują czysto z kontrolera VirtIO SCSI, jeśli sterownik nie będzie obecny wcześniej.
virtio-scsi-singleto właściwy kontroler i zły kontroler do podania VM z Windows, która nigdy go nie widziała. To osobny, cały problem i nic powyżej go nie rozwiązuje. - VMware Tools powinny zejść przed przeprowadzką, a nie po niej.
- Migawki. VM z łańcuchem migawek ma więcej niż jeden
.vmdkna dysk, a import bazowego daje ci stan sprzed migawki. Najpierw skonsoliduj. - Kolejność w
config.hardware.devicedecyduje, który dysk zostajescsi0. Wszędzie, gdzie patrzyłem, pokrywała się z kolejnością samego gościa, ale sprawdziłbym ją na wielodyskowym serwerze bazodanowym, zanim zaufałbym jej w oknie. - Dyski niezależne i RDM nie przejdą storage vMotion jak zwykłe.
Nic z tego nie zmienia kształtu. Zbuduj najpierw skorupy, przenieś dyski, póki wszystko jeszcze działa, i ogranicz przestój do jednego playa, który go potrzebuje.