Een LLM op de Ryzen AI NPU, in een container
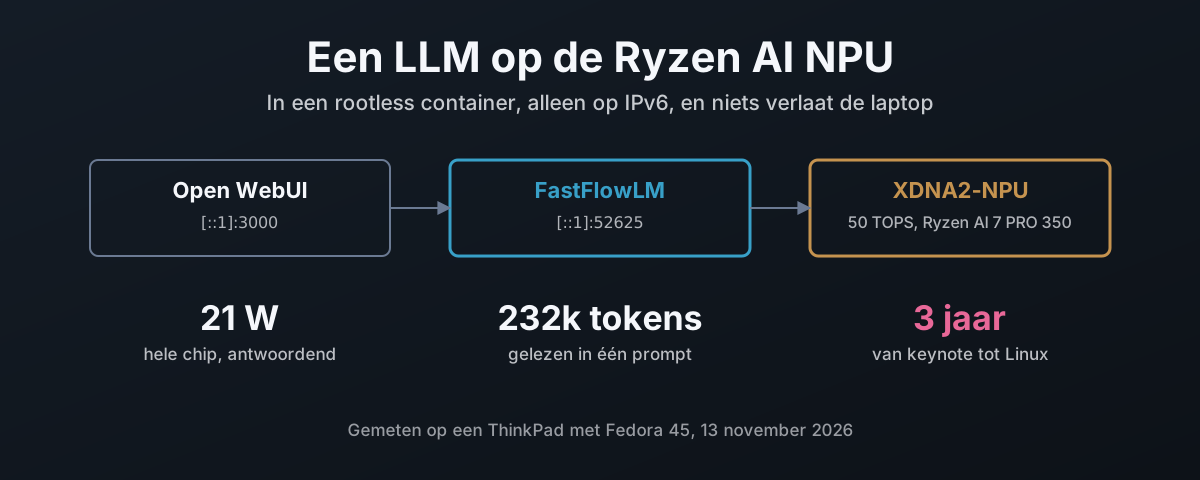
De NPU in een Ryzen AI-laptop is 50 TOPS die op de meeste Linux-installaties stil ligt. Dit loopt door het bouwen van AMD’s amdxdna-driver waarbij alleen de kernelmodule op de host blijft, het bouwen van FastFlowLM met AMD’s XRT-runtime in een rootless podman-container die bij die driver past, alles binden aan IPv6-loopback en het bij het booten starten met Quadlet. Dan wat het doet: negen modellen gebenchmarkt, een contexttest van 232.000 tokens, Whisper spraak-naar-tekst op tien keer realtime, Open WebUI en de 7.000 verborgen tokens die het aan elk bericht toevoegde, en de snelheid en het energieverbruik van de NPU gemeten tegen llama.cpp op de Radeon 860M iGPU. Tot slot de tijdlijn: drie jaar van AMD’s aankondiging van Ryzen AI tot een taalmodel op de NPU onder Linux, geleverd door een project dat AMD niet begon, terwijl de moeite naar Copilot+ op Fisher-Price OS (Windows) ging in plaats van naar het datacenter en de Linux-tooling die AI-professionals werkelijk gebruiken.