Skip to content
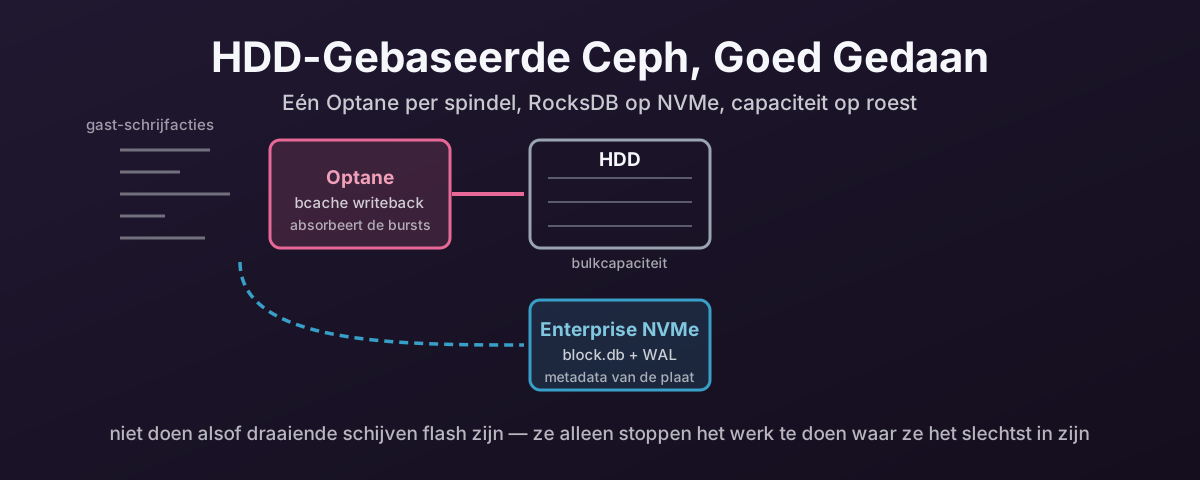
Drie storage-tiers: Optane die schrijfacties absorbeert, NVMe die Ceph-metadata houdt, en HDD's die bulkcapaciteit leveren

HDD-Gebaseerde Proxmox-Ceph-Clusters Snel Maken — NVMe-Metadata, Eén Optane Per Spindel, en Wat Het Je Kost

Flash-prijzen hebben all-NVMe moeilijk te rechtvaardigen gemaakt, en enterprise-HDD’s zijn een tweede blik waard. Acceptabele latency eruit halen op hyper-converged Proxmox-Ceph betekent RocksDB van de spindel verplaatsen, elke schijf koppelen aan zijn eigen Optane via bcache — specifiek Optane, want NAND-endurance is verkeerd voor die klus — en eerlijk zijn over de faalmodi die het je koopt.
7 augustus 2026 Â· 34 min Â· 7207 woorden Â· Damien Dye
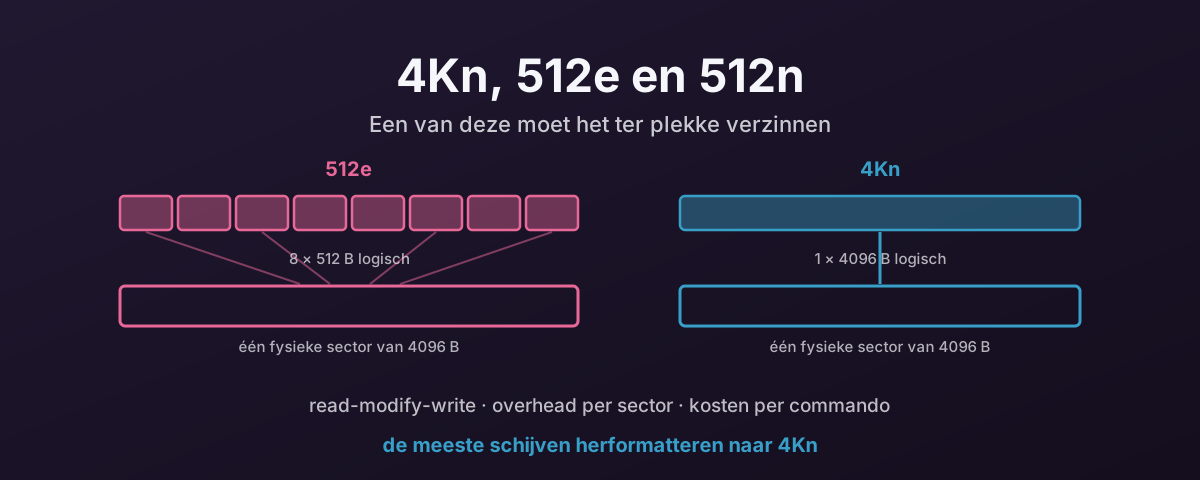
Acht logische blokken van 512 byte gemapt op één fysieke sector van 4K, naast een één-op-één 4K-mapping

4Kn, 512e en 512n — Waarom Native 4K Wint, en Wat De Emulatie Kost

512e-schijven presenteren 512-byte-sectoren die ze niet hebben, en de firmware maakt het verschil goed bij elke niet-uitgelijnde schrijfactie. Wat dat kost op het medium, in de host en in write amplification — waarom directe synchrone schrijfacties het slechtste geval zijn — en hoe je een vloot naar 4Kn omzet.

7 augustus 2026 Â· 26 min Â· 5443 woorden Â· Damien Dye
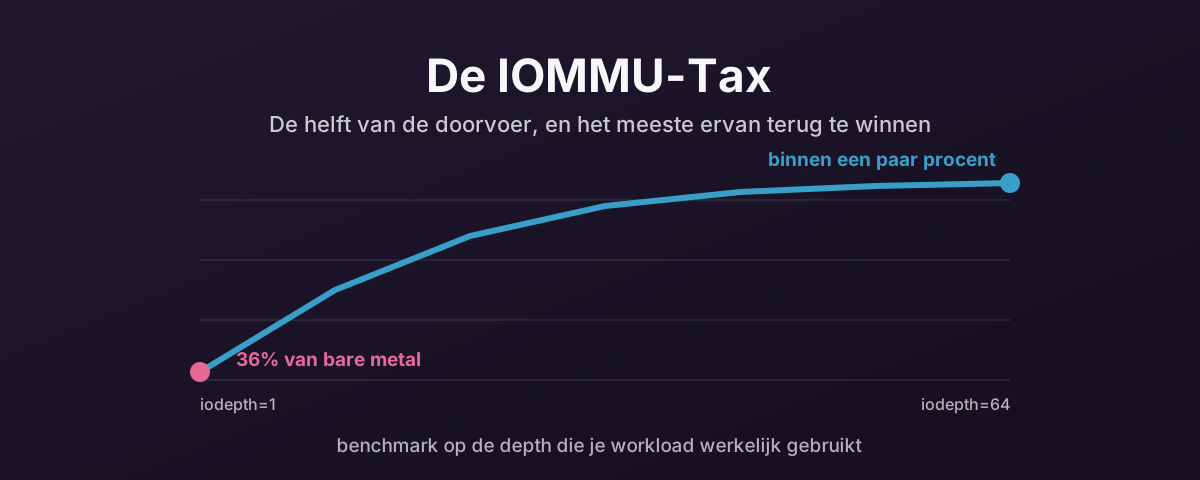
Een curve die stijgt van 36 procent van bare metal bij queue depth 1 tot binnen een paar procent bij queue depth 32

PCIe-Passthrough-Prestaties op Proxmox VE — De IOMMU-Tax en Hoe Je Die Minimaliseert

Waarom PCIe-apparaten doorvoer verliezen wanneer ze via VFIO aan een VM worden doorgegeven, en de praktische afstelstappen die het meeste ervan terugwinnen.

7 augustus 2026 Â· 19 min Â· 3922 woorden Â· Damien Dye
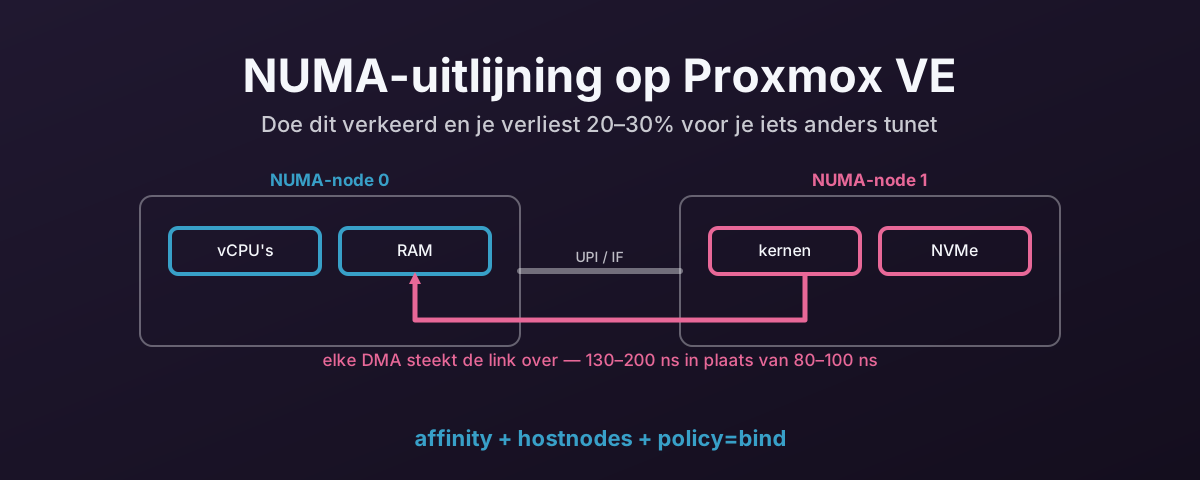
Twee CPU-sockets met een DMA-pad dat de link tussen de sockets oversteekt

NUMA-uitlijning op Proxmox VE — waarom het uitmaakt en hoe je het goed doet

Op systemen met meerdere sockets verliest een VM met zijn vCPU’s op de ene NUMA-node en zijn doorgegeven apparaat op de andere 20–30% doorvoer, nog voordat je naar iets anders hebt gekeken.

7 augustus 2026 Â· 9 min Â· 1831 woorden Â· Damien Dye
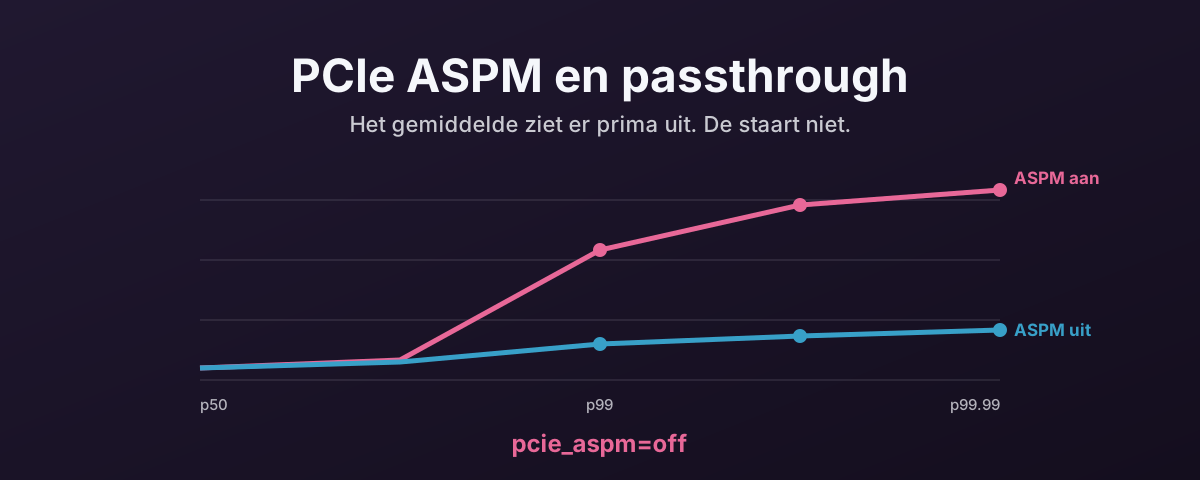
Een latencypercentielcurve die vlak blijft tot p90 en dan steil oploopt, naast een die vlak blijft

PCIe ASPM en waarom je het uit moet zetten voor passthrough

Active State Power Management bespaart een paar watt op inactieve PCIe-links. Onder VFIO-passthrough voegt het latencyjitter toe die moeilijk te diagnosticeren en makkelijk te verhelpen is.

7 augustus 2026 Â· 8 min Â· 1697 woorden Â· Damien Dye
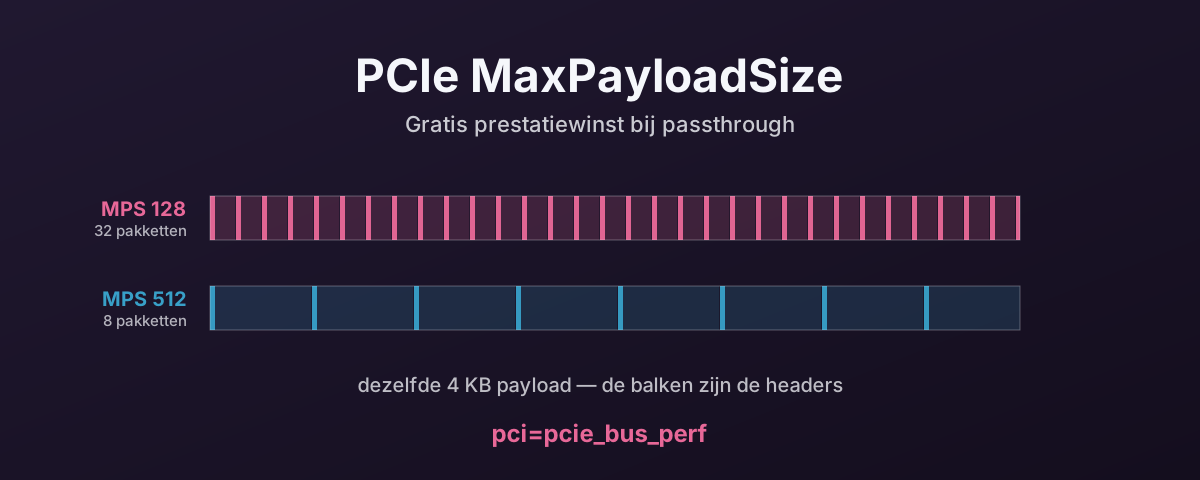
Dezelfde payload van 4 KB getekend als 32 pakketten bij MPS 128 en 8 pakketten bij MPS 512

PCIe MaxPayloadSize — gratis prestatiewinst bij passthrough

Het virtuele root complex van QEMU gebruikt standaard TLP-payloads van 128 byte. De meeste apparaten kunnen 256 of 512. Eén kernelparameter lost het op.

7 augustus 2026 Â· 7 min Â· 1448 woorden Â· Damien Dye