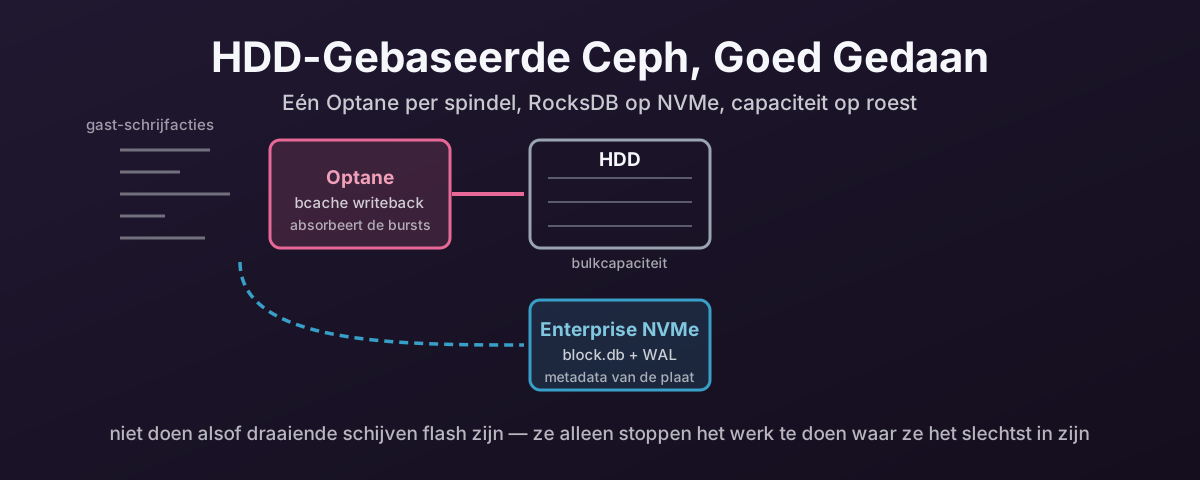
HDD-Gebaseerde Proxmox-Ceph-Clusters Snel Maken — NVMe-Metadata, Eén Optane Per Spindel, en Wat Het Je Kost
Flash-prijzen hebben all-NVMe moeilijk te rechtvaardigen gemaakt, en enterprise-HDD’s zijn een tweede blik waard. Acceptabele latency eruit halen op hyper-converged Proxmox-Ceph betekent RocksDB van de spindel verplaatsen, elke schijf koppelen aan zijn eigen Optane via bcache — specifiek Optane, want NAND-endurance is verkeerd voor die klus — en eerlijk zijn over de faalmodi die het je koopt.