De aanname die elke klok doet
De klok van een computer werkt door iets regelmatigs te tellen en erop te vertrouwen dat het blijft doortellen. Een kristal trilt, een teller loopt op, en software rekent uit hoeveel tijd er is verstreken.
Virtualisatie maakt het vertrouwende deel stuk.
De eigen documentatie over tijdmeting in KVM van de kernel zet het probleem in één zin: “the virtual operating system does not run with 100% usage of the CPU, despite the fact that it may very well make that assumption.” Al het onderstaande volgt daaruit.
Je vCPU draait niet altijd
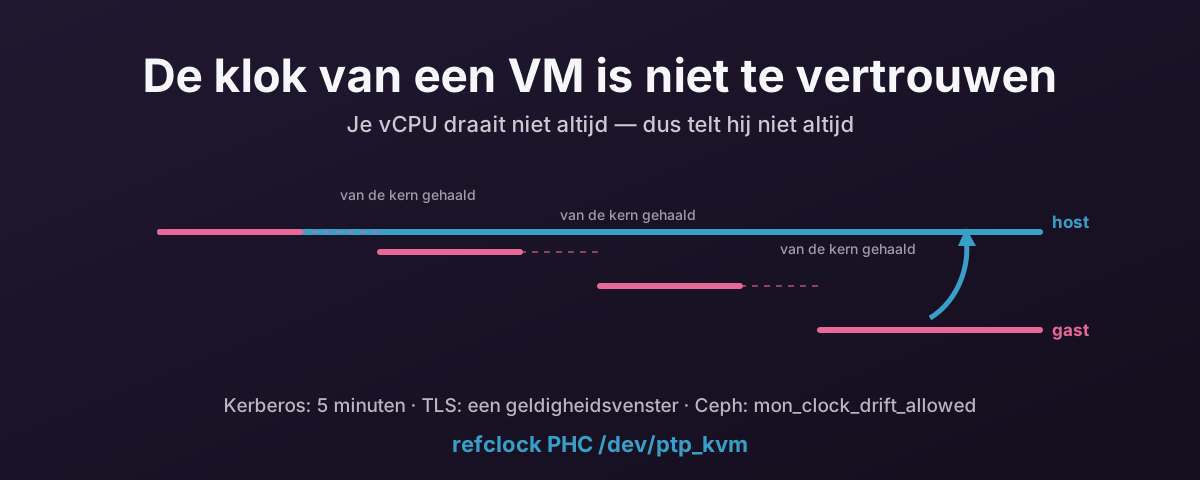
Een vCPU is een thread op de host. Hij draait wanneer de planner van de host dat zegt.
Draait hij niet, dan is de gast niet slechts inactief — hij is afwezig. Hij kan niet tellen, hij kan geen timerinterrupt afhandelen, en hij heeft geen enkele manier om te weten hoe lang hij weg was. De host houdt dat bij als steal time, de eerlijke naam voor “tijd die jou is overkomen in plaats van voor jou is gebeurd”.
Timerinterrupts zijn waar dit het hardst aankomt. Een gast die om een periodieke tik vraagt, vraagt de host interrupts op een vast tempo te bezorgen, en dat kan de host niet altijd waarmaken. Weer uit de documentatie van de kernel: “the host virtualization engine may not be able to deliver the proper number of interrupts per second, and so guest time may fall behind.”
Hoe hoger het tiktempo, hoe erger het wordt, en een overboekte host maakt het nog erger. Dit is ook waarom een drukke host de tijdmeting van stille gasten verslechtert. Ze staan allemaal in de rij voor dezelfde fysieke kernen.
De tellers zijn ook niet van jou
Zijn periodieke tikken onbetrouwbaar, dan is het voor de hand liggende antwoord om in plaats daarvan een teller te lezen. Dat heeft zijn eigen problemen.
De TSC is de snelle, en de documentatie van de kernel is er bot over: “The TSC is a CPU-local clock in most implementations… the TSCs of different CPUs may start at different times.” Zijn tempo kan meebewegen met de energietoestanden van de processor, en op oudere onderdelen stopt hij helemaal als de kern niets doet. Een vCPU die tussen fysieke kernen verhuist kan dus een teller lezen die niet overeenkomt met degene die hij een microseconde eerder las.
De alternatieven zijn op een andere manier slechter. De HPET, de PIT en de ACPI PM-timer zijn allemaal nagebootste apparaten, dus elke leesactie is een val naar de hypervisor. Correct, en duur genoeg dat een gast die de klok in een hete lus leest het merkt.
Daarom bestaan paravirtuele klokken. Op KVM laat kvm-clock de host zijn eigen tijdmeting publiceren in een gedeelde structuur die de gast direct leest: geen val, geen tellen, geen aanname dat de gast wakker was.
Daarom moet je ook de clocksource van de gast met rust laten in plaats van tsc of hpet af te dwingen omdat een forumbericht zei dat het sneller was.
Migratie, snapshots en pauzeren
Live migratie, een snapshot terugzetten en pauzeren/hervatten doen alle drie hetzelfde met de klok van een gast: ze zetten hem stil, en starten hem dan ergens anders weer.
Wat de gast ziet is geen wegdrijven, het is een stap. De klok was de ene waarde, en nu is hij een andere, met niets ertussen. Migreren naar een host waarvan de TSC op een andere frequentie loopt, maakt het erger.
Stapveranderingen doen ertoe omdat de software die klokken bijstelt is gebouwd om wegdrijven bij te stellen, niet teleportatie.
Dit is geen KVM-probleem
Het is verleidelijk al het bovenstaande te lezen als een tekortkoming van KVM. Dat is het niet.
Elke hypervisor levert een paravirtuele klok, want elke hypervisor heeft hetzelfde structurele probleem: KVM heeft kvm-clock, Hyper-V heeft zijn reference TSC page, VMware heeft een pseudo-prestatieteller plus synchronisatie via Tools, Xen heeft zijn pvclock. Dat zijn vier onafhankelijke uitvoeringen van één omweg.
De eigen conclusie van de kerneldocumentatie is dat er hier geen perfecte oplossing bestaat. Alleen afwegingen tussen nauwkeurigheid, prestaties en complexiteit.
Wil je het van een leverancier in plaats van van kernelontwikkelaars, dan is de ondersteuningsgrens van Microsoft voor hoge tijdnauwkeurigheid opmerkelijk openhartig. Om 50 ms nauwkeurigheid op een gevirtualiseerd Windows-systeem te claimen, is een van de gestelde eisen dat “the one-day average CPU utilization of the host must not exceed 90%.” Voor 1 ms moet de host onder 80% blijven.
Lees dat nog eens: de nauwkeurigheid van de klok van de gast is gedocumenteerd als voorwaardelijk aan hoe druk de host is. Dat is geen eigenaardigheid van Windows, het is dezelfde natuurkunde die de kerneldocumentatie beschrijft, opgeschreven als ondersteuningsgrens.
Waarom NTP binnen de gast het verkeerde gereedschap is
NTP is goed in waarvoor het is ontworpen: een machine met een echte oscillator die iets te snel of te langzaam loopt, bijgesteld door het rondje naar een server op afstand te meten en de lokale klok zachtjes te laten meelopen.
Elk van die aannames is wankel in een VM.
De lokale oscillator is niet een beetje verkeerd, hij is met tussenpozen afwezig. De meting van het rondje wordt gedaan door een proces dat tussen het lezen van de klok en het versturen van het pakket van de kern kan worden gehaald, en dat verpest de meting zelf. En de bijstellingen die na een migratie nodig zijn, zijn stappen, en daar gaat een meeloopalgoritme slecht mee om of het weigert ze pardoes.
chrony gaat hier veel beter mee om dan ntpd. Hij loopt sneller mee, verdraagt stappen, en is eerlijk over zijn eigen onzekerheid. Maar hij lost nog steeds het verkeerde probleem op: tijd over een netwerk trekken van een stratum 2-server op 20 ms afstand, terwijl de juiste tijd in de hypervisor zit, aan de andere kant van één geheugengrens.
Wat je in de praktijk krijgt is een gast die meestal goed zit, af en toe tientallen of honderden milliseconden ernaast, en nooit helemaal in staat je te zeggen welke van de twee.
Wat afwijking echt sloopt
Niemand geeft om klokken op zichzelf. Ze geven erom als er iets stopt met werken.
Kerberos en Active Directory
Kerberos is van opzet tijdsafhankelijk, want de geldigheid van een ticket is uitgedrukt als een tijdvenster.
De documentatie van MIT bij krb5.conf definieert clockskew als “the maximum allowable amount of clockskew in seconds that the library will tolerate before assuming that a Kerberos message is invalid”, en de standaard is 300 seconden — vijf minuten.
Ga daarover en authenticatie wordt niet slechter, ze mislukt.
En omdat authenticatie in Active Directory Kerberos is, betekent dat domeinaanmeldingen, net use, verbindingen naar SQL Server, Exchange, bestandsshares — de hele mikmak.
Vijf minuten klinkt ruim tot een gast na het terugzetten van een snapshot achteruit stapt.
TLS
Een certificaat draagt een geldigheidsvenster: notBefore en notAfter.
Een gast met een klok die achterloopt zal een certificaat weigeren dat vanmorgen is uitgegeven, want voor zover hij weet is het certificaat nog niet geldig.
Een gast met een klok die voorloopt zal er een weigeren dat niet echt is verlopen.
Dezelfde rekenkunde regeert OCSP- en CRL-versheid, de nbf/exp-claims van JWT’s, en TOTP-codes voor meervoudige authenticatie, die in vensters van 30 seconden leven.
Een klok die 45 seconden verkeerd staat is een authenticatiestoring met een bijzonder verwarrende foutmelding.
Ceph
Ceph-monitors geven hier meer om dan bijna alles in de stack, want hun consensus hangt eraan.
De gezondheidscontrole MON_CLOCK_SKEW gaat af als “the clocks on hosts running Ceph Monitor daemons are not well-synchronized”. Specifiek: als de afwijking mon_clock_drift_allowed overschrijdt.
Het advies van de documentatie is te synchroniseren met ntpd of chrony tegen meerdere bronnen, en het merkt op dat synchronisatie tussen monitors onderling er in het bijzonder toe doet.
Je kunt mon_clock_drift_allowed verhogen, maar de documentatie is duidelijk dat het “significantly below the mon_lease interval” moet blijven. Het is dan ook een klein budget, en dat besteden om een tijdmeetprobleem van de hypervisor weg te werken is geen goede ruil.
Al het andere
Logs over hosts heen houden op te correleren, en dat maakt een incidenttijdlijn tot gokwerk. Databasereplicatie en gedistribueerde consensus — etcd, Galera, alles met leases voor een leider — worden ongelukkig. Vensters voor back-up en monitoring drijven weg van het ding dat ze hadden moeten bekijken.
Windows-gasten wijken anders af
Windows verdient een eigen aantekening, want zijn tijdsdienst is met andere doelen gebouwd en dat zie je.
Microsoft zegt onomwonden dat versies vóór Windows 10 1607 / Server 2016 “can’t guarantee highly accurate time”. Wat de Windows Time-dienst op die versies leverde was “the necessary time accuracy to satisfy Kerberos version 5 authentication requirements” en “loosely accurate time” voor machines in een gemeenschappelijk AD-forest. Strakker dan dat was “outside of the design specification… and weren’t supported.”
Met andere woorden: ouder Windows mikt erop binnen het Kerberos-venster van vijf minuten te blijven, niet erop juist te zijn. En dat is prima tot iets in je omgeving beter nodig heeft. Een gevirtualiseerde Windows-bak die 90 seconden verkeerd staat, authenticeert vrolijk terwijl hij logs schrijft die met niets te correleren zijn.
Windows 10 en Server 2016 en later kunnen 1 s, 50 ms of zelfs 1 ms — maar alleen onder de eerder aangehaalde voorwaarden, inclusief de grenzen aan het CPU-gebruik van de host. Microsoft merkt ook op dat “anything that introduces network asymmetry, such as a one-way satellite connection or high CPU load on the target system, will negatively influence accuracy”. Een vCPU die om rekentijd moet vechten is hoge CPU-last op het doelsysteem, met andere woorden.
Er is geen ptp_kvm voor Windows. Wat je in plaats daarvan hebt:
- Hyper-V-klokverlichtingen. Proxmox biedt die al aan Windows-gasten aan.
PVE::QemuServer::CPUConfigzethv_timenaasthv_vapic,hv_spinlocks,hv_relaxedenhv_synic.hv_timeis de paravirtuele klok, en het is het Windows-equivalent vankvm-clock. Dit staat standaard aan voor VM’s van het type Windows; er is niets aan te zetten. - De QEMU-gastagent. Met de agent geïnstalleerd kan de host zijn tijd na een hervatting of het terugzetten van een snapshot naar de gast duwen, en dat vangt juist het geval van de stapverandering waar NTP het slechtst mee omgaat.
- Kies één gezag. De klassieke storing van Windows-in-een-VM is twee tijdbronnen die vechten: synchronisatie van host naar gast én synchronisatie via de domeinhiërarchie, die dezelfde klok in tegengestelde richtingen bijstellen. Laat voor een gast in het domein de domeinhiërarchie winnen en laat de host er geen tijd naartoe duwen. Voor een losstaande gast is synchronisatie met de host prima. Nooit beide.
Wil je precies weten wat je hypervisor een bepaalde VM over de tijd vertelt, vraag het hem dan in plaats van te gokken:
# Everything Proxmox actually passes to QEMU for this VM, including -rtc and CPU flags
qm showcmd <vmid> --pretty
De oplossing op QEMU/KVM: ptp_kvm
Voor Linux-gasten op KVM is er een net antwoord, en dat is niet “meer NTP-servers”.
ptp_kvm laat de gast de host direct vragen hoe laat het is, via een hypercall — KVM_HC_CLOCK_PAIRING op x86, en een gelijkwaardige firmware-aanroep op arm64.
De kernel biedt dat aan als een PTP-hardwareklokapparaat, dus vanuit userspace ziet het uit als elke andere precisieklokbron, en chrony kan het als referentieklok gebruiken.
De eigenschappen die ertoe doen:
- Geen netwerk. Geen jitter, geen asymmetrie, geen stratum, geen pakketten. Het pad is een geheugengrens.
- Onder de microseconde. De nauwkeurigheid wordt begrensd door de hypercall, niet door een rondje over een datacenter.
- Het gaat om het stukke deel heen. De gast telt niets en schat geen rondje. Hij leest een waarde die de host heeft berekend met een klok die de hele tijd wel liep.
Uitvoering
Doe dit op elke Linux-VM die de driver heeft. De hypervisor op de host heeft zijn eigen werkende NTP of PTP nodig. ptp_kvm geeft de gast de tijd van de host, dus hij erft de fout van de host.
1. Laad de kernelmodule bij het opstarten.
# /etc/modules-load.d/ptp_kvm.conf
ptp_kvm
2. Geef hem een vaste naam en laat chrony hem lezen.
# /etc/udev/rules.d/90-ptp-kvm.rules
ACTION=="add", SUBSYSTEM=="ptp", ATTR{clock_name}=="kvm", SYMLINK+="ptp_kvm", GROUP="chrony", MODE="0660"
De symlink doet ertoe omdat de nummering van PTP-apparaten niet vast is. /dev/ptp0 kan de ene keer de klok van een NIC zijn en de volgende de KVM-klok. Op clock_name matchen pakt elke keer de juiste.
3. Wijs chrony ernaartoe, en haal de pools weg.
Bewerk /etc/chrony/chrony.conf op Debian en Ubuntu, of /etc/chrony.conf op de RHEL-familie. Verwijder de pool-regels en gebruik:
refclock PHC /dev/ptp_kvm poll 2 stratum 1 delay 0.0004
De pools weghalen is geen optionele netheid. Ze laten staan vraagt chrony een lokale referentie onder de microseconde te verzoenen met internetservers op tientallen milliseconden afstand, en de internetbronnen kunnen het antwoord alleen slechter maken.
4. Herstart en kijk het na.
systemctl restart chronyd # or chrony, on Debian/Ubuntu
Nakijken
# The symlink exists and points at the KVM clock
ls -l /dev/ptp_kvm
cat /sys/class/ptp/ptp*/clock_name

# chrony should be using PHC0 as its selected source
chronyc sources -v

# and the offset should be microseconds, not milliseconds
chronyc tracking
In chronyc sources komt de PHC-referentieklok naar boven als #* PHC0 zodra hij is gekozen. De # markeert een lokale hardwarereferentie in plaats van een netwerkpeer, en de * markeert hem als degene die in gebruik is.
Zie je hem in de lijst maar niet gekozen, dan heeft chrony hem niet aanvaard: kijk de rechten op het apparaat na, en of de groep chrony in de udev-regel overeenkomt met de gebruiker waaronder chrony op jouw distributie echt draait.
Kanttekeningen
- De host moet goed zitten. Dit laat de gast met de host overeenstemmen, en dat is alleen nuttig als de host met de werkelijkheid overeenstemt. Geef de hypervisors echte NTP of PTP.
- Elke gast heeft het nodig. Een vloot waar de helft van de VM’s
ptp_kvmgebruikt en de helft internetpools, is een vloot met twee tijdgezagen. - Live migratie is prima, en is het punt. Na een migratie leest de gast de klok van zijn nieuwe host. Stemmen de hosts met elkaar overeen, dan ziet de gast nooit een stap.
- Alleen KVM. Het is een KVM-hypercall. Geneste of vreemde hypervisors bieden het apparaat niet aan, en de udev-regel gaat simpelweg niet af. Dat is netjes falen in plaats van een stil verkeerd antwoord.
Wat je niet moet doen
- Dwing de clocksource niet af. Laat
kvm-clockmet rust.tscofhpetop de kernelregel van de gast afdwingen ruilt een paravirtuele klok die voor deze situatie is ontworpen in voor een teller die nooit van jou was. - Draai geen
ntpdateofhwclockuit cron. Dat is een stapverandering volgens schema, en dat is precies wat databases en Kerberos verafschuwen. - Houd de pools niet “als terugval”. Met een werkende referentieklok zijn ze geen terugval, ze zijn een tweede mening van een slechtere bron.
- Verhoog
mon_clock_drift_allowedniet en noem het opgelost. Je hebt een deel van een budget opgemaakt dat voor de werkelijkheid van het netwerk bestaat, om een probleem met een bekende oplossing te verdragen.
Die laatste is het waard onomwonden te zeggen: de drempel verbreden is niet de klok oplossen. Het is het alarm verzetten zodat het niet meer afgaat.
Bronnen
- Linux kernel — KVM timekeeping — waarom gasttijd achterloopt, het probleem van de TSC als lokale klok, en de conclusie dat er alleen afwegingen bestaan
- Linux kernel — PTP_KVM — de hypercall-interface achter het PTP-klokapparaat
- Linux kernel — KVM x86 hypercalls —
KVM_HC_CLOCK_PAIRING, de x86-kant ervan - chrony — chrony.conf — de
refclock-richtlijn en de opties van de PHC-driver - MIT Kerberos — krb5.conf —
clockskewen de standaard van 300 seconden - Microsoft — support boundary for high accuracy time — de nauwkeurigheidsdoelen, en de voorwaarden aan het CPU-gebruik van de host voor gevirtualiseerde systemen
- Ceph — health checks —
MON_CLOCK_SKEW,mon_clock_drift_alloweden hun verhouding totmon_lease