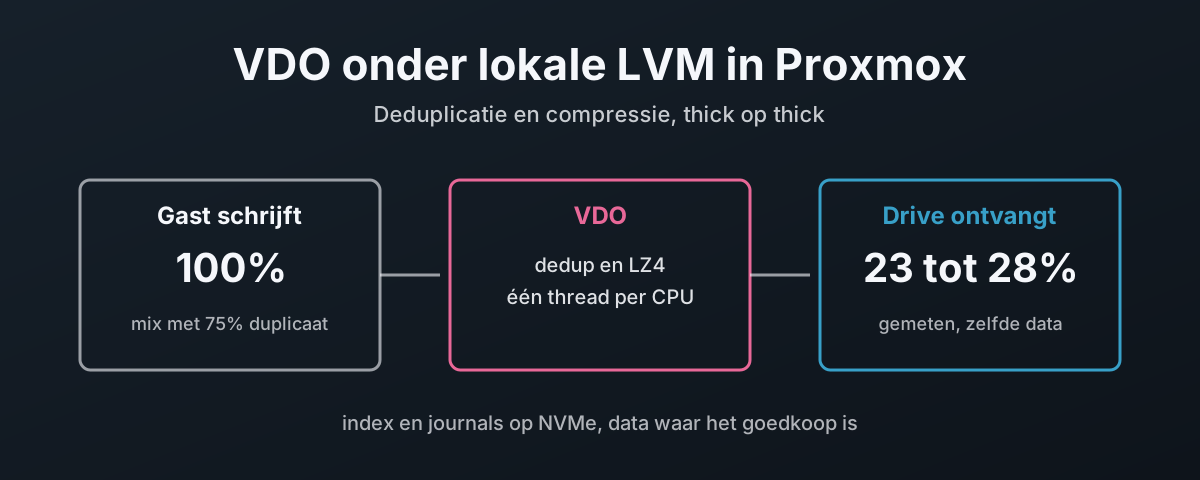
Er komen minder bytes op de drive
VDO is de deduplicatie- en compressielaag van de Linux-kernel. Het zit onder een volumegroep en werkt in blokken van 4 KiB. Elk blok dat het al eerder heeft gezien, slaat het één keer op.
Wat dat voor de hardware betekent, is simpel. Er komen minder bytes op de drive. Ik schreef een mix die voor 75% uit duplicaten bestond en voor 50% comprimeerbaar was, telkens 30 seconden door VDO, en volgens de eigen tellers van de drive ontving die 23 tot 28% van wat de gast schreef. Zes volledige klonen van een templateschijf voegden samen 8 datablokken toe. Tweeëndertig kilobyte.
Minder bytes is minder slijtage, en minder werk voor elke cache op de drive of in de controller ervoor. Het kost CPU en latency om daar te komen, en op een snelle drive wordt die prijs hieronder gemeten tegen dezelfde Optane zonder VDO. Op trage draaiende schijven verdwijnt diezelfde prijs in de seektijden, en daar wordt het interessant.
Twee regels bepalen alles wat volgt. De stack is thick op thick: niets boven VDO, en VDO zelf ook niet, kan meer ruimte beloven dan de drive heeft. En de eigen metadata van VDO, de index en de journals, kan op NVMe staan terwijl de data ergens trager staat.
Elk getal hier komt van één Proxmox VE 9.2-host, een Ryzen 7 5700G met 16 CPU’s, kernel 7.0.14-25-pve, LVM 2.03.31 en de Debian-tools vdo 8.3.1.1, op twee Intel Optane-drives die daarna zijn gewist.
Wat VDO is en waar het zit
De kernel beschrijft dm-vdo als een device-mapper-target dat “provides block-level deduplication, compression, and thin provisioning”1. Elk binnenkomend blok van 4 KiB wordt gehasht. Staat er al een identiek blok, dan legt VDO een verwijzing vast in plaats van een kopie. Blokken die geen duplicaat zijn, gaan door LZ4 en worden met een paar tegelijk in een fysiek blok gepakt, en blokken die helemaal uit nullen bestaan, worden helemaal niet opgeslagen2.
LVM bestuurt het geheel.
lvcreate --type vdo maakt een VDO-pool, die de echte blokken bevat, en daarbovenop een VDO-LV met elke virtuele grootte die je vraagt2.
Een thick volumegroep komt op de VDO-LV, en Proxmox gebruikt die als gewone lvm-storage.
| Laag | Naam in het lab | Wat het doet |
|---|---|---|
| VM-schijven | vm-9901-disk-0 enzovoort | thick LV’s, aangemaakt door Proxmox |
| Volumegroep | vdovg, 35 GiB | gewone LVM, wat de lvm-storage van Proxmox leest |
| VDO-LV | vdolab/vdolv, 35 GiB virtueel | dedup, LZ4, nulblokken weggelaten |
| VDO-pool | vdolab/vdopool, 40 GiB | de echte blokken, de metadata en index van VDO |
| Fysiek | nvme8n1 | VG vdolab |
Thick op thick, of helemaal niet
VDO is zelf ook een thin provisioner: de VDO-LV kan elke virtuele grootte krijgen. Maak hem groter dan de pool kan bevatten en de volumegroep erboven is thick op een belofte, en dat is thin op thin, een laag lager. Precies dat deed ik bij de eerste opbouw, een VDO-LV van 120 GiB op een pool van 40 GiB, en Proxmox toonde een derde van de storage als vrij terwijl VDO vol was.
Dimensioneer de VDO-LV dus op wat de pool echt kan adresseren, niet meer.
lvcreate print dat getal, “can address 36.00 GB” op deze pool van 40 GiB, en de block map van VDO voor de logische ruimte komt uit dezelfde ruimte, dus ik gaf hem 35 GiB.
Daarna bewees ik het op de harde manier. Eén VM-schijf die elke extent nam die Proxmox wilde geven, 34 GiB, van begin tot eind gevuld met random data waar VDO niets mee kan:
# vdostats --human-readable
Device                    Size      Used Available Use% Space saving%
vdolab-vdopool-vpool     40.0G     38.1G      1.9G  95%            0%
De schijf liep vol aan zijn eigen einde, zoals een thick schijf hoort te doen. VDO had nog 1,9 GiB vrij, meer dan de 1 GiB die Proxmox nog kon toewijzen. Het getal van Proxmox is de echte grens, en VDO kan niet als eerste vollopen.
Wat je inlevert is de overcommit: de ruimte die deduplicatie bespaart, zie je terug als drive die nooit beschreven wordt, niet als extra schijven voor Proxmox. Dat is de juiste ruil voor dit stuk, dat over de hardware gaat. En zet er ook geen lvmthin-pool op. Twee thin-lagen zijn twee boekhoudingen3.
Wat het kost voordat je één byte opslaat
VDO houdt een deduplicatie-index bij, de UDS-index, op de pool zelf.
Een lege pool van 40 GiB meldde 4,0 GiB in gebruik en 36,0 GiB beschikbaar.
vdolistmetadata, uit hetzelfde pakket vdo, somt elk metadatablok op het apparaat op, en verklaart vrijwel alles:
| Gebied | Blokken van 4 KiB | Grootte |
|---|---|---|
| UDS-index | 679.127 | 2,59 GiB |
| Recovery journal | 32.768 | 128 MiB |
| Referentietellingen en journals, 18 slabs | 6.372 | 25 MiB |
| Ruimte te klein voor een negentiende slab | 336.555 | 1,28 GiB |
| Totaal | ongeveer 4,0 GiB |
Die restregel is goed om te weten: slabs zijn 2 GiB, dus dimensioneer de pool in hele slabs plus de overhead, anders blijft het restant gewoon ongebruikt.
RAM is de andere rekening. Die betaal je of de pool nu bezig is of niet:
| Kosten | Regel uit lvmvdo(7) | Deze pool van 40 GiB |
|---|---|---|
| Vast | 38 MiB | 38 MiB |
| Block-map-cache | 1,15 MiB per MiB cache, minimaal 150 MiB | 150 MiB (standaard 128 MiB) |
| Fysieke ruimte | 268 MiB per TiB | 11 MiB |
| UDS-index (dense) | minimaal 250 MiB, de standaard | 256 MiB |
| Totaal | ongeveer 455 MiB |
De standaard dense index dekt een deduplicatievenster van grofweg 256 GiB, want een dense index met 1 GiB RAM “maintains a 1 TiB deduplication window”2. De block-map-cache van 128 MiB is bemeten op “efficient access to 100 GB of logical space at a time”, en de kerneldocumentatie noemt hem de belangrijkste waarde om bij te stellen als de working set groeit1.
De stack bouwen
Laat LVM een PV op een LV zien
De volumegroep zit op een LV, en LVM negeert LV’s standaard als physical volume.
devices/scan_lvs zet dat aan, en de referentie van LVM geeft de waarschuwing die erbij hoort: “Caution is required to avoid using PVs that belong to guest images stored on LVs”4.
Een gast die binnen zijn eigen schijf LVM gebruikt, zou anders zijn volumegroepen op de host zien opduiken.
Dus het filter verandert ook. Zelfde wijziging. Het standaardfilter op deze host wees alleen ZFS-zvols en RBD-apparaten af. Ik voegde een afwijzing toe voor elke VM-schijf van Proxmox:
# lvmconfig devices/global_filter devices/scan_lvs
global_filter=["r|/dev/zd.*|","r|/dev/rbd.*|","r|/dev/mapper/.*-(vm|base)--[0-9]+--disk--[0-9]+|"]
scan_lvs=1
Dezelfde referentie zegt dat scan_lvs “does not enable autoactivation of layered VGs”4.
Proxmox heeft dat ook niet nodig. Zijn LVM-plugin activeert elke schijf met lvchange -aey wanneer de VM start5.
Ik testte het zoals een boot de boel achterlaat, alles gedeactiveerd en dan dezelfde pvscan-runs van udev: de VG onder VDO kwam op, en qm start activeerde de schijf van de VM zelf.
De valkuil zit eronder. Met de VG onder VDO onvolledig mislukte dezelfde qm start met “Volume group “vdovg” not found”.
De VDO-pool, thick, met zijn instellingen op de aanmaakregel
De formatter zit in het Debian-pakket vdo6:
# apt install vdo
Dan de pool.
-L is de echte ruimte, -V de virtuele grootte, binnen wat de pool kan adresseren.
De threadindeling en de discardgrootte gaan op dezelfde regel, omdat geen van beide later te veranderen is zonder elke VM op de pool te stoppen:
# pvcreate /dev/nvme8n1
  Physical volume "/dev/nvme8n1" successfully created.
# vgcreate vdolab /dev/nvme8n1
  Volume group "vdolab" successfully created
# lvcreate -y --type vdo -L 40G -V 35G -n vdolv vdolab/vdopool /dev/nvme8n1 --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  Wiping vdo signature on /dev/vdolab/vdopool.
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "vdolv" created.
# dmsetup table vdolab-vdopool-vpool
0 73402368 vdo V4 /dev/dm-7 10485760 4096 32768 16380 deduplication on compression on maxDiscard 4096 ack 1 bio 2 bioRotationInterval 64 cpu 3 hash 2 logical 4 physical 4
De threadindeling is de indeling die verderop voor een host met 16 CPU’s is gemeten; max_discard=4096 heeft een eigen sectie.
De volumegroep en de Proxmox-storage
# pvcreate /dev/vdolab/vdolv
  Physical volume "/dev/vdolab/vdolv" successfully created.
# vgcreate vdovg /dev/vdolab/vdolv
  Volume group "vdovg" successfully created
# pvesm add lvm vdo-lvm --vgname vdovg --content images,rootdir --on-volume-remove discard=1
# pvesm status | grep -E "Name|vdo-lvm"
Name             Type     Status     Total (KiB)      Used (KiB) Available (KiB)        %
vdo-lvm           lvm     active        36696064               0        36696064    0.00%
on-volume-remove discard=1 doet ertoe, en dat komt hieronder aan bod.
Wat deduplicatie bespaarde
Ik schreef dingen die een Proxmox-host echt opslaat en las na elk ervan de bloktellers van VDO.
logical blocks used is wat de lagen erboven schreven; data blocks used is wat VDO opsloeg. Beide in blokken van 4 KiB.
| Wat er geschreven werd | Logische blokken erbij | Datablokken erbij | Bespaard |
|---|---|---|---|
| Rocky Linux 10-rootfs, ext4 op een schijf van 4 GiB | 114.505 | 60.537 | 47% |
Zes volledige klonen ervan (qm clone --full, ongeveer 4 s per stuk) | 6.291.456 | 8 | 99,9999% |
| ISO van Proxmox Datacenter Manager 1.1, 1,36 GiB | 356.172 | 351.965 | 1,2% |
De -auto-rebuild ervan, vrijwel dezelfde bytes | 356.399 | 40 | 99,99% |
| 4 GiB nullen | 1.048.575 | 0 | 100% |
| 1 GiB random data | 262.143 | 262.144 | 0% |
Elke kloon schreef alle 4 GiB, nullen inbegrepen, omdat een volledige kloon op een thick LV elk blok kopieert. VDO sloeg de nullen op als niks en de rest als verwijzingen.
VDO is erg goed in data die het al eens gezien heeft. En in niks. Het is nutteloos op data die al gecomprimeerd of versleuteld is, en daarom bespaarde de eerste ISO, grotendeels squashfs, 1,2%.
Met de template en zijn zes klonen erop toonde Proxmox de storage als 80,01% gebruikt, 28 GiB aan thick schijven van de 35. De drive bevatte 4,3 GiB, en het meeste daarvan was de index. Op thick storage is dat precies de bedoeling: Proxmox telt wat is toegewezen, en de drive draagt wat echt verschilt.
Wat de drive echt ontvangt
Besparing op schijf is een momentopname. De hardware geeft om de stroom.
Dus ik mat de bytes die de drive bereikten tijdens het schrijven: fio gedurende 30 seconden, de schrijfteller van de drive uit /sys/block ervoor en erna, dezelfde Optane met en zonder VDO, elk twee keer.
De teller is eerlijk. Over de hele run telde hij op tot 794 GB, en de eigen SMART-waarde “Data Units Written” van de drive bewoog ook 794 GB.
| Workload, 30 s | Zonder VDO | Met VDO, 16 threads | Bytes die de drive bereiken |
|---|---|---|---|
| 4k random write, QD32, 4 jobs, 75% dup, 50% compressie | 582.013 IOPS, p99 244 µs | 460.887 IOPS, p99 1,05 ms | 28% |
| 128k-write, QD8, 75% dup, 50% compressie | 2.345 MiB/s, p99 490 µs | 2.179 MiB/s, p99 1,02 ms | 23% |
| 4k random write, QD32, 4 jobs, random data | 571.721 IOPS | 272.366 tot 381.005 IOPS | 59 tot 100% |
| 128k-write, QD8, random data | 2.346 MiB/s | 1.051 tot 1.854 MiB/s | 100% |
Op een realistische mix hield VDO 79 tot 93% van de doorvoer van de kale drive over en stuurde het er een kwart van de bytes naartoe. Op volledig random data bespaart het niets en kost het veel, en de twee runs liepen zo ver uiteen dat ik alleen het bereik geef.
De tail latency is de eigen verwerking van VDO, niet de drive. Een p99 van ongeveer een milliseconde, tegen een kwart daarvan kaal.
De Optane heeft geen cache om te ontlasten
Deze drives zeggen het zelf: vwc 0 uit nvme id-ctrl, write through in /sys/block.
Een Optane schrijft ter plekke, zonder DRAM- of SLC-buffer, dus op deze hardware zit de winst in de bytes en de slijtage, niet in een drivecache die langzamer volloopt.
Een NAND-SSD met een SLC-cache, of een RAID-controller met een write-back-cache, is waar minder bytes ook responsiviteit oplevert. Dat is de RAID6-sectie hieronder.
De threads van VDO afstemmen op de CPU’s
Standaard geeft LVM VDO tien threads: één logical, één physical, één hash zone, twee CPU, vier voor bio-submission, één voor acknowledgement. Op een host met 16 CPU’s laat dat het grootste deel van de machine stilstaan, terwijl het block-map-werk van VDO in de rij staat achter één enkele logical thread.
De kerneldocumentatie legt de knoppen uit1. Logical threads bezitten elk “a disjoint section of the block map”, physical threads “a disjoint section of the data blocks”, en beide “can increase throughput”, terwijl te veel threads “can waste resources and increase contention”. Logical threads gaan tot 60, physical tot 16, en de pool heeft minstens één slab per physical thread nodig. Met 18 slabs heeft deze ruimte genoeg.
| Indeling | logical | physical | hash | cpu | bio | ack | Totaal |
|---|---|---|---|---|---|---|---|
| Standaard van LVM | 1 | 1 | 1 | 2 | 4 | 1 | 10 |
| Afgestemd op 16 CPU’s | 4 | 4 | 2 | 3 | 2 | 1 | 16 |
| Twee keer zoveel | 8 | 8 | 4 | 6 | 2 | 2 | 30 |
Elke indeling draaide dezelfde fio-jobs twee keer, door elkaar, met random data, plus alle zeven kloonschijven tegelijk gelezen, zoals zeven VM’s samen opstarten:
| Test, gemiddelde van twee runs | Standaard | Afgestemd op 16 CPU’s | Twee keer zoveel |
|---|---|---|---|
| 4k random write, QD32, 4 jobs | 292.466 IOPS | 365.314 IOPS | 302.461 IOPS |
| 4k random write p99, 4 jobs | 2,1 tot 3,7 ms | 1,5 tot 1,6 ms | 2,1 tot 2,2 ms |
| 1M sequentiële write | 1.153 MiB/s | 1.729 MiB/s | 1.507 MiB/s |
| 4k random read, QD32, 4 jobs | 507.450 IOPS | 503.827 IOPS | 485.263 IOPS |
| Zeven kloonschijven tegelijk gelezen | 7,5 s | 3,1 s | 3,4 s |
Afgestemd op het aantal CPU’s wint bijna alles: een kwart meer parallelle writes, de helft meer op sequentiële writes, zeven schijven 2,4 keer sneller gelezen, en een strakkere tail. Nog eens verdubbelen is over de hele linie slechter. Dat is de contention waar de documentatie voor waarschuwt. De standaardinstelling was ook de minst stabiele, met de leesactie van zeven schijven die tussen runs schommelde van 6,1 tot 8,8 s.
Dus de regel is één VDO-thread per CPU, verdeeld over de typen zoals hierboven, met de physical threads begrensd door het aantal slabs.
Wat VDO kost op snelle hardware
Dezelfde Optane zonder VDO, tegen VDO met afgestemde threads, random data, gemiddelde van twee runs:
| Test | Optane, geen VDO | VDO, 16 threads |
|---|---|---|
| 4k random write, QD1 | 42.294 IOPS, 19,4 µs | 55.806 IOPS, 12,1 µs |
| 4k random write, QD32 | 142.416 IOPS | 144.292 IOPS |
| 4k random write, QD32, 4 jobs | 572.293 IOPS | 365.314 IOPS |
| 4k random read, QD1 | 55.276 IOPS, 14,4 µs | 27.988 IOPS, 31,4 µs |
| 4k random read, QD32, 4 jobs | 586.463 IOPS | 503.827 IOPS |
| 1M sequentiële write, QD8 | 2.348 MiB/s | 1.729 MiB/s |
| Zeven templateschijven tegelijk gelezen | 11,1 s | 3,1 s |
Lees het zoals het er staat. Eén random read duurt door VDO meer dan twee keer zo lang. Parallelle random writes verliezen meer dan een derde, sequentiële writes een kwart. Op een drive die zo snel is, is de 17 µs extra werk die VDO per read doet het grootste deel van de read.
Dat de QD1-write door VDO sneller is, is geen gratis lunch. Verre van. VDO bevestigt een write voordat die op de drive staat, en de kerneldocumentatie zegt het ronduit: “unflushed writes may or may not persist after a crash”1. Dat getal meet een bevestiging. Een gast die flusht, en dat doet elk bestandssysteem, krijgt de duurzaamheid waar hij om vraagt.
De regel met de zeven schijven is de enige die VDO ronduit wint, en het is goed om helder te zijn over waarom. Zeven gewone kopieën moeten 28 GiB aan echte bytes lezen, nullen inbegrepen. VDO leest één set gedeelde blokken en slaat de nullen over.
Op snelle flash ruilt VDO dus latency in voor bytes. Elk van die microseconden is wel een vaste prijs, en die groeit niet als de drive eronder trager wordt.
De metadata van VDO op NVMe zetten
VDO heeft geen apart metadata-apparaat. Alles staat op die ene pool-LV. Maar de broncode van dm-vdo laat zien dat de indeling vastligt, en een LV kan worden opgebouwd uit stukken op verschillende drives.
De formatteercode plaatst de wortels van de block map vanaf het begin van het datagebied, daarna de slab summary en het recovery journal vanaf het einde, en vult het midden met slabs7.
De UDS-index zit vóór dat alles, direct na het geometrieblok.
vdolistmetadata bevestigde het op de labpool:
| Blokken | Wat | Waar het zit |
|---|---|---|
| 0 tot 679.188 | geometrie, UDS-index, superblok, wortels van de block map | de eerste 2,59 GiB |
| binnen elke slab van 2 GiB | data, bladeren van de block map, 130 referentieblokken en een slabjournal van 224 blokken | verspreid door de pool |
| 10.452.928 tot 10.485.695 | recovery journal | de laatste 128 MiB, bijna |
| 10.485.696 tot 10.485.759 | slab summary | de allerlaatste 256 KiB |
Bouw de pool-LV dus in drie stukken: de kop op NVMe, het midden op de trage drive, de staart op NVMe.
Converteer hem daarna naar een VDO-pool, wat lvmvdo(7) documenteert voor een bestaande LV2.
Hier staat nvme6n1 voor de NVMe en nvme8n1 voor de trage drive:
# lvcreate -y -L 3G -n splitpool vdolab /dev/nvme6n1
  Logical volume "splitpool" created.
# lvextend -l +9408 vdolab/splitpool /dev/nvme8n1
  Size of logical volume vdolab/splitpool changed from 3.00 GiB (768 extents) to 39.75 GiB (10176 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvextend -l +64 vdolab/splitpool /dev/nvme6n1
  Size of logical volume vdolab/splitpool changed from 39.75 GiB (10176 extents) to 40.00 GiB (10240 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvconvert -y --type vdo-pool -n splitlv -V 35G vdolab/splitpool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  WARNING: Converting logical volume vdolab/splitpool to VDO pool volume with formatting.
  THIS WILL DESTROY CONTENT OF LOGICAL VOLUME (filesystem etc.)
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "splitlv" created.
  Converted vdolab/splitpool to VDO pool volume and created virtual vdolab/splitlv VDO volume.
Controleer dan of VDO zijn metadata heeft gezet waar de extents liggen:
# vdolistmetadata /dev/mapper/vdolab-splitpool_vdata | grep -v "slab [0-9]* \(reference\|journal\)"
0 .. 0: geometry block
1 .. 679127: index
679128 .. 679128: super block
679129 .. 679188: block map tree roots
10452928 .. 10485695: recovery journal
10485696 .. 10485759: slab summary
Een extent is 1.024 blokken. De NVMe-kop is extents 0 tot 767, blokken 0 tot 786.431, en dekt de index en de wortels, met ongeveer 420 MiB van de data van de eerste slab als bijvangst. De NVMe-staart is extents 10.176 tot 10.239, blokken 10.420.224 en verder, en dekt het recovery journal en de slab summary.
Hoeveel van het werk van VDO meeverhuist, per run van 30 seconden, geteld per apparaat:
| Workload | Write-I/O’s NVMe | Write-I/O’s datadrive | Aandeel NVMe |
|---|---|---|---|
| 4k random write, 75% dup, 50% compressie | 388.430 tot 538.223 | 3,42 tot 3,63 miljoen | 10 tot 13% |
| 128k-write, 75% dup, 50% compressie | 458.214 tot 634.167 | 3,30 tot 3,53 miljoen | 12 tot 15% |
| 4k random write, random data | 181.457 tot 384.507 | 3,25 tot 8,49 miljoen | 4 tot 5% |
| 4k random read | 0 writes, 2% van de reads | 0 |
Een tiende of zo van de write-operaties: het recovery journal, index-updates, en dat stukje van slab 0 op de NVMe-kop. Het zijn kleine, verspreide metadatawrites, het soort waar een draaiende schijf het slechtst mee omgaat. Op NVMe zijn ze niks.
Twee grenzen.
De metadata per slab, referentietellingen, slabjournals en bladeren van de block map, staat in de slabs en blijft bij de data.
En ik heb het laten groeien van een gesplitste pool niet getest. Het journal wordt vanaf het einde geplaatst, dus draai na elke lvextend opnieuw vdolistmetadata en kijk waar het terechtkwam voordat je erop vertrouwt.
VDO op bcache: één NVMe, twee taken
bcache is de andere manier om flash voor trage schijven te zetten. Het is wat ik al onder Ceph op draaiende drives gebruik, met elke instelling uitgelegd in de bcache-post. De vraag is dus wat VDO met een bcache-cache doet als het erbovenop zit.
Eén NVMe doet beide flashtaken, verdeeld over twee partities:
| Apparaat | Grootte | Taak |
|---|---|---|
nvme8n1p1 | 32 GiB | bcache-cache, writeback |
nvme8n1p2 | 8 GiB | kop en staart van VDO: index, wortels, recovery journal, slab summary |
nvme6n1 | 349 GiB | bcache-backing-device, waar de data staat |
/dev/bcache0 | 349 GiB | het midden van de VDO-pool, de slabs |
Beide drives zijn weer Optanes, dus nvme6n1 staat in voor een draaiende schijf.
Houd dat in gedachten bij elk getal hieronder. Het backing device is hier snel, dus dit meet wat de cache bereikt, niet hoe lang een spindel erover doet om hem leeg te schrijven.
De partities en de cache set, met de instellingen uit die post:
# sgdisk --zap-all /dev/nvme8n1
# sgdisk -n 1:0:+32G -c 1:bcache-cache -n 2:0:+8G -c 2:vdo-meta /dev/nvme8n1
# blockdev --rereadpt /dev/nvme8n1
# apt install bcache-tools
# make-bcache -C /dev/nvme8n1p1 -B /dev/nvme6n1 --writeback
# B=/sys/block/bcache0/bcache
# echo 0 > $B/sequential_cutoff
# echo 40 > $B/writeback_percent
# echo 81920 > $B/writeback_rate
# echo 20480 > $B/writeback_rate_minimum
# CS=/sys/fs/bcache/47bac36f-a1d5-4e8e-8695-2e7ff944172d
# echo 0 > $CS/congested_read_threshold_us
# echo 0 > $CS/congested_write_threshold_us
Die echo-regels gelden tot de volgende reboot. De udev-regel in de bcache-post zorgt dat ze blijven.
Dan de pool, op dezelfde manier gesplitst als hierboven, met nvme8n1p2 voor de twee uiteinden en bcache0 voor het midden:
# pvcreate /dev/bcache0 /dev/nvme8n1p2
# vgcreate vdolab /dev/bcache0 /dev/nvme8n1p2
# lvcreate -y -L 3G -n vdopool vdolab /dev/nvme8n1p2
# lvextend -l +9408 vdolab/vdopool /dev/bcache0
# lvextend -l +64 vdolab/vdopool /dev/nvme8n1p2
# lvconvert -y --type vdo-pool -n vdolv -V 35G vdolab/vdopool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
# lvs -a --segments -o lv_name,lv_size,segtype,seg_start_pe,seg_size_pe,devices vdolab
  LV              LSize  Type     Start SSize Devices
  vdolv           35.00g vdo          0  8960 vdopool(0)
  vdopool         40.00g vdo-pool     0 10240 vdopool_vdata(0)
  [vdopool_vdata] 40.00g linear       0   768 /dev/nvme8n1p2(0)
  [vdopool_vdata] 40.00g linear     768  9408 /dev/bcache0(0)
  [vdopool_vdata] 40.00g linear   10176    64 /dev/nvme8n1p2(768)
vdolistmetadata printte dezelfde blokbereiken als bij de gesplitste opbouw, dus de index en beide journals staan op nvme8n1p2.
vdovg en de Proxmox-storage komen er precies zo bovenop als eerder.
Wat de cache bereikt
De vergelijking is een LV van 8 GiB direct op bcache0 tegen een LV van 8 GiB in vdovg, dezelfde fio-jobs gedurende 30 seconden, twee keer, met de cache tussen elke run schoon geflusht.
De apparaattellers in /sys/class/block zeggen waar de bytes heen gingen.
| 75% dup, 50% compressie, 30 s | alleen bcache | VDO op bcache |
|---|---|---|
| 4k random write, QD32, 4 jobs | 212.222 en 205.585 IOPS | 390.206 en 304.757 IOPS |
| p99 | 1,89 en 2,04 ms | 1,45 en 2,54 ms |
| Gast schreef | 24,29 en 23,53 GiB | 44,67 en 34,88 GiB |
| Geschreven in de bcache-cache | 25,00 en 24,26 GiB | 11,48 en 10,44 GiB |
| Geschreven naar de metadatapartitie van VDO | 1,18 en 0,59 GiB | |
| Cachewrites per gastbyte | 103% | 26 en 30% |
| Aan het eind dirty in de cache | 6,0 en 6,5 GiB | 5,5 en 5,2 GiB |
| 128k-write, QD8 | 2.001 en 1.985 MiB/s | 1.878 en 1.416 MiB/s |
| Cachewrites per gastbyte, 128k | 101% | 24 en 27% |
bcache alleen liep vast op ongeveer 210.000 kleine writes per seconde, en het schreef elke byte in de cache plus 3% van zichzelf. Zet VDO ervoor en de cache kreeg een kwart van de bytes. In de eerste run droeg dezelfde cache vervolgens 390.206 writes per seconde, bijna twee keer zoveel, en eindigde hij nog steeds met minder dirty data die op de trage drive wachtte. De cache was de grens. VDO verschoof hem.
De tweede run is de eerlijke voor een pool die al in gebruik is. fio seedt zijn generators standaard elke run op dezelfde manier8, dus run twee schreef data die de index al had gezien, wijzend naar blokken die inmiddels waren gediscard. VDO behandelt de index als hints en leest elk kandidaatblok om te controleren dat het echt een duplicaat is voordat het dat deelt9. Tijdens een test die alleen schreef, las die tweede run 7,11 GiB terug uit de cache en 1,20 GiB van de datadrive. De eerste las 0,12 GiB. Verouderd advies is niet gratis, en op een pool waar VM’s komen en gaan, is er altijd wat van.
Random data is de andere kant ervan:
| Random data, 30 s | alleen bcache | VDO op bcache |
|---|---|---|
| 4k random write, QD32, 4 jobs | 205.984 en 203.066 IOPS | 203.186 en 85.882 IOPS |
| p99 | 2,04 en 2,15 ms | 5,7 en 17,7 ms |
| 128k-write, QD8 | 2.038 en 2.017 MiB/s | 878 en 357 MiB/s |
| 4k random read, QD1 | 36.609 en 36.639 IOPS, 21,6 µs | 26.345 en 26.202 IOPS, 33,6 en 33,7 µs |
| 4k random read, QD32, 4 jobs | 471.585 en 471.730 IOPS | 335.461 en 336.941 IOPS |
Niets te besparen, dus VDO is pure overhead, en in de run met de verouderde index halveerde het de kleine writes ruimschoots. Elke read in beide kolommen kwam uit de cache. De 12 µs die VDO erbovenop legt, is dezelfde vaste prijs die het op een kale Optane toevoegt.
Waar de data zich herhaalt, stapelen de twee dus goed. De cache krijgt een kwart van de bytes, vangt een burst langer op, en heeft minder terug te schrijven naar de spindels. Waar de data zich niet herhaalt, is bcache alleen beter af.
Op HDD’s in hardware-RAID6: beredeneerd, niet gemeten
Ik heb geen HDD-RAID6-host om op te testen, dus deze sectie is redenering op basis van de metingen hierboven. Meet je eigen array voordat je erop vertrouwt.
| Op HDD-RAID6 | Wat VDO verandert |
|---|---|
| Writes die de array bereiken | ongeveer een kwart, bij een mix zoals de gemeten |
| Write-back-cache van de controller | loopt vol op een kwart van de snelheid, dus vangt een burst ongeveer vier keer zo lang op |
| CPU-kosten van VDO | 17 µs per read, verloren in een seek van 5 tot 10 ms |
| Writes naar het recovery journal | een tiende of zo van de write-I/O’s, klein en geflusht: zet ze op NVMe |
| Opzoekingen in de index | let op dedupe advice timeouts in vdostats; op trage storage kan VDO het zoeken opgeven en het duplicaat toch schrijven |
| Eén kloon van begin tot eind lezen | trager: de blokken wijzen terug naar die van de template, verspreid over de array |
De eerste twee regels zijn het hardwareantwoord. Zolang de cache van de controller, met batterij of flash als back-up, ruimte heeft, ziet de gast cachelatency. Als hij volloopt, ziet de gast de spindels. Stuur hem een kwart van de bytes en dezelfde cache geeft ongeveer vier keer zoveel ruimte, en heeft een kwart zoveel leeg te schrijven. De bcache-sectie hierboven is precies dat, gemeten met een softwarecache in plaats van die van de controller.
De derde is waarom VDO meer op trage schijven thuishoort dan op snelle. Op de Optane verdubbelde VDO de leeslatency. Op drives van 7.200 rpm verdwijnt dezelfde vaste prijs in één seek.
De laatste drie zijn de kosten. Een bootstorm van identieke klonen wordt sneller, maar één kloon van begin tot eind lezen wordt trager, omdat deduplicatie hem verspreidt. En de eigen kleine writes van VDO komen ook op de array terecht, en dat is het argument voor de gesplitste indeling hierboven: index en journal op NVMe, slabs op de RAID6.
Een schijf verwijderen: laat Proxmox hem discarden
Een LV verwijderen geeft de extents ervan vrij in LVM. Het vertelt VDO niet dat de blokken ongebruikt zijn, dus VDO houdt ze vast. De kerneldocumentatie zegt waarom dat ertoe doet: “If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space”1. Op thick storage kan het niet vollopen, maar niet-gediscarde blokken zijn nog steeds driveruimte die vastgehouden wordt voor data van niemand.
De optie on-volume-remove discard=1 op de storage is de oplossing. Proxmox beschrijft die als het versturen van “discard (TRIM) requests before removal”5:
| Verwijderen | VDO-blokken vrijgegeven |
|---|---|
gewone lvm-storage, een schijf met 1 GiB erop | 0 |
met on-volume-remove discard=1, hetzelfde | 262.140, de hele 1 GiB |
Op een grote schijf is het wel traag.
Het verwijderen van de schijf van 34 GiB uit de vultest kostte Proxmox 262,6 s, terwijl blkdiscard op hetzelfde soort data 15 GiB in 2,25 s haalde.
Dus voor alles wat groot is: eerst de schijf blkdiscarden en dan verwijderen.
De discardgrootte doet er ook toe. De standaard max_discard van VDO is één blok van 4 KiB per request1:
| Discard van 15 GiB random data | Verstreken | CPU (sys) |
|---|---|---|
max_discard=1, de standaard | 8,06 s | 8,06 s |
max_discard=4096, 16 MiB | 2,25 s | 0,00 s |
Zet binnen de gasten de optie Discard van de drive aan, zodat hun TRIM de storage bereikt10, en draai fstrim volgens een schema.
Waar het zijn plek verdient
| Past | Past niet |
|---|---|
| veel VM’s uit dezelfde paar templates | databases en latencygebonden werk op diepte |
| HDD-RAID6 achter een write-back-cache van de controller | een all-NVMe-host die elke microseconde nodig heeft |
| draaiende data met een NVMe voor de metadata van VDO | al gecomprimeerde data: media, back-ups, ISO’s |
| bcache voor draaiende data, waar de data zich herhaalt | bcache voor data die zich niet herhaalt |
| drives waar de schrijfduurzaamheid de grens is | versleutelde gastschijven, die nooit dedupliceren |
| een host met een halve gigabyte RAM per pool over | een kleine pool, waar de index een tiende opeet |
| Instelling | Standaard | Zet het op | Later veranderen |
|---|---|---|---|
Virtuele VDO-grootte -V | wat je maar vraagt | niet meer dan de pool kan adresseren | alleen groeien, nooit krimpen |
| VDO-threads | 10, één logical | één per CPU, verdeeld zoals hierboven | alleen met de VM’s van de pool gestopt |
max_discard | 1, dat is 4 KiB | 4096, dat is 16 MiB | alleen met de VM’s van de pool gestopt |
on-volume-remove op de storage | niet gezet | discard=1 | ja, pvesm set |
| Discard op elke virtuele schijf | uit | aan | ja, per schijf |
scan_lvs en het filter | 0, geen afwijzing van VM-schijven | 1, VM-schijven afgewezen | ja, in lvm.conf |
Niets daarvan is moeilijk. Niets daarvan is de standaard.
De goedkoopste write is de write die je nooit verstuurt
Wat me aan VDO opvalt, is hoe slecht het verkocht wordt. Het duikt op als manier om meer op een schijf te zetten dan de schijf kan bevatten, en dat is het minst nuttige wat het doet. Ik deed het per ongeluk bij de eerste opbouw, en Proxmox toonde een derde van de storage als vrij terwijl VDO vol was. Overcommit is een lening, en de drive eist hem op volle schrijfsnelheid terug.
De echte waarde zit in de regel die de meeste mensen nooit meten. Een kwart van de bytes op de drive is een kwart van de slijtage en een controllercache die vier keer zo lang meegaat. Dat is geen capaciteit. Het is de hardware die minder werk doet voor hetzelfde resultaat, en dat is de enige soort besparing die je later niet opbreekt.
Het kost CPU, en op snelle flash kost het latency, en beide zijn vast. Dat is de ruil, eerlijk gezegd: processortijd besteed zodat het trage, dure deel van de doos minder doet. Op draaiende schijven achter een RAID-controller of een bcache, met de index en het journal op een NVMe, valt die som goed uit. Op een all-Optane-host meestal niet.
En het past niet vanzelf op zichzelf. Elke standaard die ertoe doet, is fout voor deze taak: tien threads op zestien CPU’s, een discardgrootte die een core opbrandt, een virtuele grootte die je op alles kunt zetten, en niets in de storageconfiguratie dat Proxmox vertelt ruimte terug te geven. Niets daarvan is verborgen. Het staat allemaal in de documentatie.
Dus bouw het thick, één keer, fatsoenlijk, met de instellingen op de aanmaakregel en de metadata waar die hoort. Doe dat en de drive doet een kwart van het werk. Sla het over en je hebt weer een laag gekocht die meer belooft dan hij heeft.
Linux kernel documentation — dm-vdo — het target “provides block-level deduplication, compression, and thin provisioning”; “If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space”; “unflushed writes may or may not persist after a crash”; de block-map-cache van 128 MB ondersteunt “efficient access to 100 GB of logical space at a time”; de threadparameters, hun grenzen en de afstemrichtlijnen; maxDiscard “in 4096-byte blocks”. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
lvmvdo(7) — Support for Virtual Data Optimizer in LVM — VDO-pool en VDO-LV, een bestaande LV converteren met
lvconvert --type vdo-pool, geheugengebruik, de dense index en zijn venster van 1 TiB per GiB RAM, en “You cannot reduce the size of a VDOPoolLV”. ↩︎ ↩︎ ↩︎ ↩︎Linux kernel source — drivers/md/dm-thin.c —
disable_discard_passdown_if_not_supported()zet discard-passdown uit als het data-apparaat geen hele thin-chunk aankan, en dat is wat de standaardinstelling van VDO onder een thin pool doet. ↩︎LVM2 — conf/example.conf.in —
devices/scan_lvs: “Caution is required to avoid using PVs that belong to guest images stored on LVs” en “This option does not enable autoactivation of layered VGs”. ↩︎ ↩︎Proxmox pve-storage — LVMPlugin.pm — de eigenschap
on-volume-remove, “Use ‘discard=1’ to issue discard (TRIM) requests before removal”; volumes worden afzonderlijk geactiveerd metlvchange -aeyin plaats van metvgchange -aly. ↩︎ ↩︎Debian trixie — package vdo — “Management tools for Virtual Data Optimizer”, versie 8.3.1.1-1, die
vdoformat,vdostatsenvdolistmetadatalevert. ↩︎Linux kernel source — drivers/md/dm-vdo/encodings.c —
vdo_initialize_layout()maakt de block-map-partitie aan het begin, de partities voor slab summary en recovery journal aan het einde, en het slab depot uit wat overblijft. ↩︎fio documentation — randrepeat — “Seed all random number generators in a predictable way so the pattern is repeatable across runs. Default: true.” ↩︎
Linux kernel documentation — Design of dm-vdo — “vdo treats the locations in the index as hints, and reads each indicated block to verify that it is indeed a duplicate before sharing the existing block with a new one.” ↩︎
Proxmox VE documentation — Qemu/KVM Virtual Machines, Trim/Discard — “For the guest to be able to issue TRIM commands, you must enable the Discard option on the drive.” ↩︎