Het Probleem
Dit kwam op tijdens een klantopdracht waar we een Proxmox VE-deployment ontwierpen met NVMe-passthrough voor een latency-gevoelige workload.
De klant had voor het gesprek zijn eigen benchmarking gedaan.
Op de host rapporteerde fio tegen de NVMe-schijf 700K random read-IOPS met een voltooiingslatency onder de 10µs.
Binnen de VM, met dezelfde schijf en dezelfde test, kregen ze ongeveer de helft daarvan.
Ze hadden de voor de hand liggende dingen al gecontroleerd. De schijf was niet veranderd. De firmware was niet veranderd. Het PCIe-slot was niet verplaatst. Ze begonnen zich af te vragen of passthrough helemaal de verkeerde aanpak was.
Dat was het niet. Wat ze zagen is de IOMMU-tax. Het verrast mensen omdat niemand je erover vertelt voordat je je aan het passthrough-ontwerp hebt vastgelegd. Het goede nieuws is dat het meeste van de overhead terug te winnen is zodra je begrijpt waar het vandaan komt.
Diepe Duik
De Problemen Die Opgelost Moesten Worden
Een VM directe toegang geven tot een fysiek PCIe-apparaat klinkt eenvoudig. In de praktijk is het een van de moeilijkere problemen in systeemvirtualisatie. Een paar dingen die op bare metal automatisch werken, worden gevaarlijk wanneer een apparaat gedeeld wordt tussen een host en een gast.
DMA-Isolatie
Dit is het fundamentele probleem.
PCIe-apparaten gaan niet via de CPU om geheugen te lezen en schrijven. Ze gebruiken Direct Memory Access. Ze schrijven rechtstreeks naar fysieke RAM-adressen. Op bare metal is dat prima. Het apparaat en het OS vertrouwen elkaar.
Onder virtualisatie heeft de gast-VM zijn eigen kijk op fysiek geheugen. De adressen die de gastdriver aan de NVMe-controller geeft, zijn guest physical addresses. Ze mappen niet naar dezelfde locaties in host-RAM. Als het apparaat ze rechtstreeks gebruikt, leest en schrijft het het verkeerde geheugen. Dat beschadigt de host, andere VM’s, of beide.
Erger nog, een kwaadaardige of buggy gastdriver zou het apparaat opzettelijk kunnen programmeren om DMA uit te voeren naar elk deel van het host-geheugen. Dat is in feite root-toegang tot de hele machine zonder ooit een hypervisor-bug te misbruiken.
De oplossing is de IOMMU — een hardware-vertaaleenheid (Intel VT-d, AMD-Vi) die tussen elk PCIe-apparaat en het hoofdgeheugen zit. Die onderhoudt zijn eigen page tables, apart van die van de CPU. Elke DMA-aanvraag van het apparaat gaat door de IOMMU, die guest physical addresses vertaalt naar host physical addresses en elke toegang buiten de toegewezen geheugenregio’s van de gast blokkeert.
Zonder de IOMMU is veilige passthrough onmogelijk. Ermee is het apparaat ingeperkt.
Apparaatgroepering
De IOMMU isoleert geen individuele apparaten. Het isoleert groepen.
De PCIe-specificatie definieert Access Control Services (ACS) die bepalen of apparaten op dezelfde bus rechtstreeks met elkaar kunnen praten — peer-to-peer DMA — zonder door het root complex te gaan waar de IOMMU zit. Als twee apparaten een PCIe-switch delen die ACS niet afdwingt, kan het ene apparaat DMA uitvoeren naar de geheugenruimte van het andere, waarbij het de IOMMU volledig omzeilt.
De kernel groepeert apparaten die elkaar mogelijk kunnen bereiken zonder IOMMU-handhaving in één IOMMU-groep. Als je NVMe-controller een groep deelt met een ander apparaat, breekt het doorgeven van alleen de NVMe het isolatiemodel. Het andere apparaat in de groep zou nog steeds als zijkanaal om de IOMMU heen gebruikt kunnen worden.
Server-grade hardware met goede ACS-ondersteuning op elke bridge en switch geeft doorgaans elk apparaat zijn eigen groep. Consumenten- en werkstationborden gooien vaak meerdere apparaten samen omdat het PCIe-root-complex ACS niet op elke poort implementeert.
Proxmox draagt een kernelpatch — pcie_acs_override — die de kernel vertelt elk apparaat als geïsoleerd te behandelen ongeacht hardware-ACS-ondersteuning.
Het werkt in de praktijk, maar het liegt tegen de kernel over de hardwaretopologie.
Op een productiesysteem zijn schone groepen die gedekt worden door echte hardware-ACS altijd te prefereren.
Interruptaflevering
Op bare metal, wanneer een NVMe-controller een IO-operatie voltooit, vuurt hij een MSI-X-interrupt rechtstreeks naar de CPU. De CPU handelt die in een paar honderd nanoseconden af.
Onder virtualisatie moet die interrupt de gast bereiken, niet de host. De naïeve aanpak is elke interrupt in de hypervisor te trappen, een VM exit te triggeren, de interrupt in de gast te injecteren en te hervatten. Dat werkt, maar elke VM exit kost 5–20µs. Bij hoge IOPS — honderdduizenden interrupts per seconde — is de overhead substantieel.
De hardware-oplossing is posted interrupts. Intels APICv en AMD’s AVIC laten de IOMMU de interrupt rechtstreeks in de virtuele APIC-pagina van de gast schrijven zonder überhaupt een VM exit te veroorzaken. De gast ziet de interrupt alsof die van bare-metal-hardware kwam. De overhead daalt tot een paar honderd nanoseconden.
Niet alle platforms ondersteunen posted interrupts. Oudere CPU’s, sommige werkstationchipsets, en sommige BIOS-versies leggen de capability niet bloot. Wanneer ze ontbreken, gaat elke interrupt door het trage pad, en er is geen software-workaround.
Apparaat-Reset
Wanneer een VM afsluit of crasht, moet het doorgegeven apparaat terugkeren naar een schone, bekende toestand. Anders kan het niet opnieuw worden toegewezen aan een andere VM of teruggenomen door de host.
Op bare metal doet het OS een ordelijke afsluiting van de apparaatdriver. Onder passthrough kan de gast crashen, kan de gebruiker de VM geforceerd stoppen, of kan de hypervisor het proces killen. Het apparaat kan midden in een overdracht zitten met DMA-operaties in de lucht.
PCIe definieert hiervoor Function Level Reset (FLR) — een manier om één apparaatfunctie te resetten zonder de rest van de bus te beïnvloeden. NVMe-controllers ondersteunen FLR over het algemeen en handelen het goed af. GPU’s zijn er notoir slecht in, maar dat is een ander artikel.
Als FLR niet ondersteund wordt, is de terugval een secondary bus reset, die alles achter die PCIe-bridge reset. Als de bridge er andere apparaten op heeft, worden die ook allemaal gereset. In het ergste geval is een volledige host-reboot de enige manier om het apparaat terug te nemen.
Adresvertaling-Overhead
De IOMMU lost het veiligheidsprobleem op. Het is dan ook niet optioneel. Maar het introduceert een prestatieprobleem.
Elke DMA-operatie gaat nu door een extra niveau van adresvertaling. De IOMMU heeft zijn eigen TLB — de IOTLB — en wanneer die raak is, is de overhead klein. Wanneer die mist, moet de IOMMU zijn page tables doorlopen, en dat voegt echte latency toe aan elke betrokken IO-operatie.
Dit is de IOMMU-tax. De rest van dit artikel gaat over begrijpen waar het vandaan komt en hoe je het minimaliseert.
BAR-Mapping en Adresruimte
Elk PCIe-apparaat legt een of meer Base Address Registers (BAR’s) bloot die de interne registers en het geheugen van het apparaat in de MMIO-adresruimte van de host mappen. De host-CPU benadert het apparaat via deze mappings. Om passthrough te laten werken, moet de hypervisor deze mappings correct aan de gast presenteren.
Traditioneel lagen BAR-groottes bij het opstarten vast door de BIOS en pasten ze binnen het legacy 32-bits MMIO-venster onder 4GB. Dat werkte toen BAR’s klein waren. Moderne GPU’s hebben het beeld veranderd. Een framebuffer van 24GB heeft een BAR van 24GB nodig, die niet in een 32-bits adresruimte past.
Resizable BAR (ReBAR) — ook op de markt gebracht als AMD Smart Access Memory (SAM) — is een PCIe-capability die het toestaat de BAR-grootte na het opstarten opnieuw te onderhandelen. Voor GPU’s is dit een belangrijke feature. In plaats van de framebuffer via een venster van 256MB te benaderen en er in stukken doorheen te pagineren, mapt de host het hele VRAM in één keer.
Voor NVMe is de directe impact kleiner. NVMe-controller-BAR’s zijn doorgaans 16KB tot 64KB voor de controller-registerset (BAR0). De NVMe-specificatie definieert een Controller Memory Buffer (CMB) die een grotere BAR kan blootleggen voor host-resident submission queues, maar de meeste schijven implementeren dat niet. ReBAR verandert de NVMe-doorvoer niet op de manier die het voor GPU’s doet.
De reden dat het uitmaakt in een NVMe-passthrough-context is de gedeelde PCIe-omgeving. Als je een NVMe-schijf doorgeeft naast een GPU op dezelfde host, heeft de resized BAR van de GPU adresruimte boven de 4GB-grens nodig. De BIOS, de IOMMU en de virtuele PCIe-topologie moeten dat allemaal accommoderen. De adresruimtetoewijzing verkeerd krijgen betekent dat apparaten niet initialiseren, en de NVMe-passthrough faalt samen met al het andere.
Blootstelling Aan Stroomverlies
Op een virtuele schijf handelen de hypervisor en de storagelaag de schrijfvolgorde en crash-consistentie af. Met passthrough praat de gast rechtstreeks met flash. Als de host midden in een schrijfactie stroom verliest, bepaalt wat de firmware van de NVMe-controller met zijn write cache doet — of niet doet — of je data verliest.
Enterprise-NVMe-schijven dragen power loss protection (PLP) condensatoren die de write cache veilig wegschrijven tijdens een stroomstoring. Consumentenschijven zonder PLP mogelijk niet. Met passthrough is er geen hypervisor-vangnet tussen de gast en de hardware.
Voor een productieworkload is een enterprise-schijf met PLP niet optioneel.
Operationele Afwegingen
Passthrough verwijdert ook capabilities die virtuele schijven bieden.
Een doorgegeven apparaat is fysiek vastgeschroefd aan een specifieke host. De VM kan niet live-gemigreerd worden zolang het apparaat aangesloten is. In een Proxmox-cluster met HA betekent een node-uitval dat de VM omvalt en koud opstart op een andere node. Er is geen naadloze failover.
De schijf is ook onzichtbaar voor vzdump en Proxmox Backup Server.
Hij wordt niet meegenomen in VM-snapshots of geplande backups.
Een aparte backupstrategie — op gastniveau, filesystem-niveau of applicatieniveau — moet aanwezig zijn voordat de workload live gaat.
Hoe VFIO-Passthrough Werkelijk Werkt
Wanneer je een PCIe-apparaat aan een VM doorgeeft, geeft de hypervisor de gast directe controle over de MMIO-registers van het apparaat. De gastdriver praat met de NVMe-controller alsof die op bare metal draaide. Dat deel is bijna native. MMIO-registertoegang gaat door Extended Page Tables (EPT op Intel, NPT op AMD) en voltooit doorgaans zonder een VM exit.
Het DMA-pad is waar de kostenpost verschijnt. Elke DMA-operatie gaat door de IOMMU voor adresvertaling, en zoals hierboven beschreven heeft die vertaling een prijs. Vooral bij IOTLB-missers.
Waarom De Benchmarks Er Slechter Uitzien Dan De Werkelijkheid
Hier gaan de meeste mensen de mist in met hun tests.
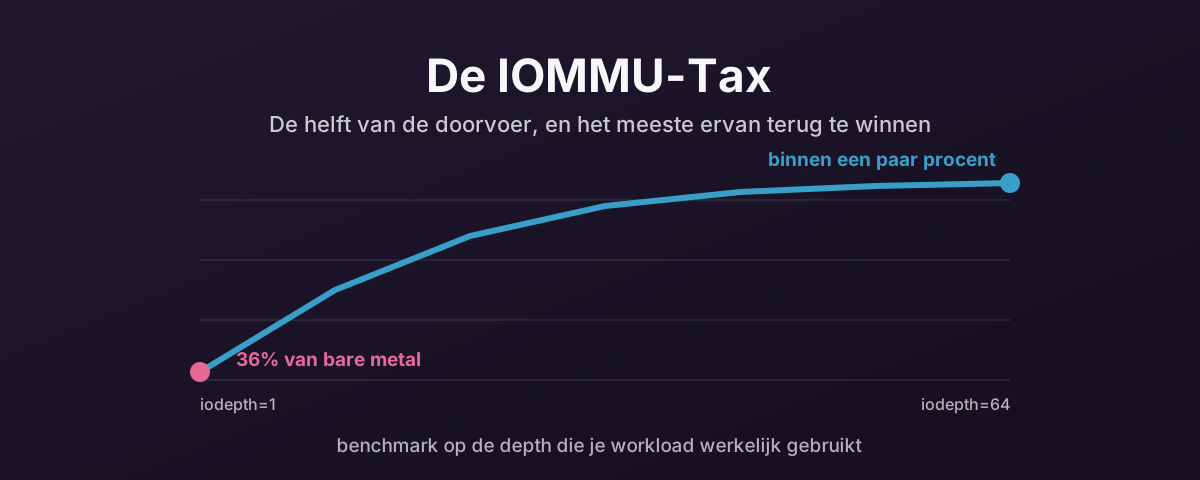
Een Proxmox-forumthread die dit artikel aanzette, had gebruikers die fio draaiden met iodepth=1.
Bij die queue depth dient fio één IO in, wacht tot die voltooit, en dient dan de volgende in.
De test meet gewoon de latency per IO.
Elke microseconde IOMMU-overhead komt volledig naar voren.
De cijfers uit die thread vertellen het verhaal helder.
De voltooiingslatency op bare metal was gemiddeld rond de 10µs.
Binnen de VM was die gemiddeld rond de 28µs.
Die extra ~18µs per IO is de IOMMU-vertaling-overhead.
Bij iodepth=1 halveert het de doorvoer rechtstreeks, omdat doorvoer gelijk is aan 1 / latency wanneer er maar één IO in de lucht is.
Verhoog de queue depth naar 32 of 64 — de manier waarop NVMe-schijven zijn ontworpen te werken — en het beeld verandert. Met meerdere IO’s in de lucht wordt de IOMMU-overhead over allemaal geamortiseerd. De controller verwerkt voltooiingen terwijl er nieuwe vertalingen plaatsvinden. De doorvoer herstelt tot binnen een paar procent van bare metal.
De praktische conclusie is deze. Als je workload op queue depths boven de 4 draait, is de IOMMU-doorvoerstraf waarschijnlijk verwaarloosbaar. Dat dekt de meeste database-, virtualisatie- en storageworkloads. Als je workload latency-gevoelig is op lage queue depths — bepaalde realtime-applicaties, synchrone metadata-operaties — zul je het voelen.
Draai je benchmarks op realistische queue depths voordat je concludeert dat passthrough te traag is:
# Bare metal baseline — run on the host before binding to vfio-pci
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting

# Same test inside the VM after passthrough
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Vergelijk de clat-percentielen (completion latency) en de IOPS-cijfers.
Bij iodepth=32 met vier jobs zou het gat enkele procentpunten moeten zijn, geen 50%.
NUMA-Uitlijning
Dit heeft zijn eigen artikel. Zie NUMA-Uitlijning op Proxmox VE — Waarom Het Uitmaakt en Hoe Je Het Goed Doet.
De korte versie: op multi-socket-systemen is elk PCIe-apparaat bedraad aan een specifieke socket. Als de NVMe-schijf op NUMA-node 1 zit en de vCPU’s van de VM zijn gepind aan node 0, kruist elke DMA-voltooiing de inter-socket-link. Dat voegt 50–100ns per operatie toe. Bij hoge IOPS is het doorvoerverschil tussen uitgelijnde en niet-uitgelijnde NUMA 20–30%.
Controleer met cat /sys/bus/pci/devices/0000:XX:00.0/numa_node, en pin dan de vCPU’s van de VM aan cores op dezelfde node met de affinity-parameter in de VM-config.
Op single-socket-systemen is dit geen zorg.
PCIe Active State Power Management (ASPM)
Dit heeft zijn eigen artikel. Zie PCIe ASPM en Waarom Je Het Zou Moeten Uitschakelen voor Passthrough.
De korte versie: ASPM laat PCIe-links laag-vermogenstoestanden ingaan wanneer ze inactief zijn.
Onder passthrough beheert de host nog steeds de fysieke link maar bezit de gast het apparaat.
Wanneer de gast IO indient en de link slaapt, voegt de wektijd latency toe.
Het symptoom is een brede spreiding in je clat-percentielen. De p99 kan 5–10x hoger zijn dan het gemiddelde terwijl het gemiddelde er prima uitziet.
Schakel het uit op de host met pcie_aspm=off op de kernel-commandoregel.
Voeg ook disable_idle_d3=1 toe aan de vfio-pci-moduleopties als je NVMe-controller herstelproblemen met stroomtoestanden heeft. De Samsung 990 EVO Plus is een bekende boosdoener.
MaxPayloadSize (MPS)
Dit heeft zijn eigen artikel. Zie PCIe MaxPayloadSize — Een Gratis Prestatiewinst voor Passthrough.
De korte versie: PCIe-apparaten dragen data over in Transaction Layer Packets.
Het virtuele root-complex van QEMU staat standaard op een maximale payload van 128 bytes.
De meeste apparaten ondersteunen 256 of 512 bytes.
Het toevoegen van pci=pcie_bus_perf aan de host-kernel-commandoregel zet MPS op het maximum dat de parent bus van elk apparaat toestaat.
Het is een kleine doorvoerverbetering — laag enkelcijferig percentage — maar het is gratis zonder nadeel.
Resizable BAR en MMIO-Venster
Het BAR-mapping-probleem dat eerder beschreven werd, heeft praktische stappen aan zowel de BIOS- als de VM-kant.
Schakel eerst Above 4G Decoding in in de BIOS. Dit staat toe dat BAR’s in adresruimte boven de 4GB-grens gemapt worden, wat vereist is voor elk apparaat met grote BAR’s. Schakel het in zelfs voor NVMe-only-passthrough. Het heeft geen nadeel en voorkomt problemen als je later een GPU of ander large-BAR-apparaat toevoegt.
Als ReBAR beschikbaar is in de BIOS, schakel dat dan ook in. Het beïnvloedt de NVMe-prestaties niet rechtstreeks, maar het staat GPU’s op dezelfde host toe hun volledige framebuffer-mapping te gebruiken.
Aan de VM-kant heeft het virtuele Q35-root-complex van QEMU een groot genoeg 64-bits MMIO-venster nodig zodat de gast resized BAR’s kan zien. Standaard wijst OVMF een relatief klein venster toe. Voor NVMe-only-passthrough is dit prima. NVMe-BAR’s passen comfortabel. Maar als de VM zowel een NVMe als een GPU doorgegeven heeft, vergroot dan het MMIO-venster:
args: -fw_cfg name=opt/ovmf/X-PciMmio64Mb,string=65536
Dit vertelt OVMF 64GB aan 64-bits MMIO-ruimte toe te wijzen, genoeg voor de meeste GPU-framebuffers naast de kleine BAR van de NVMe-controller.
QEMU’s ReBAR-ondersteuning is verbeterd maar is nog steeds niet naadloos. Sommige AMD-GPU’s (Vega en nieuwer) triggeren driverfouten (Code 43 in Windows) met ReBAR ingeschakeld onder QEMU. Als je dat tegenkomt, schakel ReBAR dan als eerste stap uit in de BIOS. NVMe-passthrough wordt hoe dan ook niet beïnvloed.
Voor wat Resizable BAR aan de GPU-kant van het hek doet, en waarom Intel het als verplicht behandelt op Arc terwijl NVIDIA het per game inschakelt, zie PCIe Resizable BAR en Moderne GPU’s.
Interruptafhandeling
Het interruptaflevering-probleem dat eerder beschreven werd, heeft een praktische afstelstap. Posted interrupts (APICv op Intel, AVIC op AMD) zijn mogelijk niet standaard ingeschakeld.
Controleer of ze actief zijn:
# Intel — look for "Posted-Interrupts" in dmesg
dmesg | grep -i "posted"

# AMD — check AVIC support
dmesg | grep -i "avic"
Schakel op AMD EPYC-systemen AVIC in de KVM-module in als die niet standaard aanstaat:
# /etc/modprobe.d/kvm.conf
options kvm_amd avic=1
Op Intel-systemen wordt APICv met posted interrupts doorgaans automatisch ingeschakeld wanneer VT-d actief is.
Als je platform geen posted interrupts ondersteunt, is er geen software-workaround. Het is een hardware-capability. Maar het is de moeite waard te verifiëren dat het werkelijk aanstaat voordat je aanneemt dat het trage pad onvermijdelijk is.
Interrupt-Affiniteit en Queue-Uitlijning
NVMe-controllers gebruiken meerdere submission- en completion-queue-paren. Doorgaans één per CPU-core. Wanneer de vCPU’s van de VM niet uitlijnen met de fysieke cores die de NVMe-interrupts afhandelen, moeten voltooiingen cores kruisen via inter-processor interrupts. Dat voegt latency toe.
Controleer binnen de gast hoeveel IO-queues de NVMe-driver heeft aangemaakt en hoe ze gemapt zijn:
# List NVMe IO queues
cat /proc/interrupts | grep nvme

# Check affinity
for irq in $(grep nvme /proc/interrupts | awk '{print $1}' | tr -d ':'); do
    echo "IRQ $irq: $(cat /proc/irq/$irq/smp_affinity_list)"
done
Idealiter zou de interrupt van elke NVMe-IO-queue geaffiniteerd moeten zijn aan de vCPU die aan die queue indient. De meeste moderne NVMe-drivers handelen dit automatisch af. Maar het is de moeite waard te verifiëren, vooral als je handmatig vCPU’s hebt gepind of het vCPU-aantal onder het queue-aantal van de controller hebt verlaagd.
Gebruik Altijd Q35, Niet i440fx
Dit verdient zijn eigen artikel. Zie Gebruik Altijd Q35, Niet i440fx.
De korte versie: i440fx presenteert een vlakke legacy-PCI-bus. Q35 presenteert een echt PCIe-root-complex. Passthrough-apparaten op i440fx verschijnen als legacy-PCI, wat MSI-X multi-queue-interruptaflevering breekt. NVMe-controllers hebben MSI-X nodig voor hun queue-per-core-architectuur. Zonder dat trechteren alle IO-voltooiingen door één interrupt en krijg je een bottleneck bij hoge IOPS die geen enkele hoeveelheid kernelafstelling zal oplossen.
In Proxmox 8.x en nieuwer is Q35 de standaard voor nieuwe VM’s. Als je passthrough doet op een oudere VM die nog i440fx is, schakel over. RHEL 10 heeft i440fx formeel afgeschaft, en het bredere KVM-ecosysteem volgt.
Alles Bij Elkaar Brengen
Hier is een samenvatting van de afstelstappen op volgorde van impact.
NUMA-uitlijning — zorg dat de NVMe-schijf en de vCPU’s van de VM op dezelfde NUMA-node zitten. Dit alleen al kan op multi-socket-systemen een doorvoerverschil van 20–30% verklaren.
ASPM uit — voeg pcie_aspm=off toe aan de host-kernel-commandoregel.
Elimineert latency-jitter van PCIe-link-stroomtoestandsovergangen.
Realistische queue depths — test op iodepth=32 of hoger, niet iodepth=1.
De IOMMU-overhead die op lage queue depths domineert, wordt op realistische depths geamortiseerd.
Posted interrupts — verifieer dat APICv (Intel) of AVIC (AMD) actief is. Verlaagt de overhead per interrupt van microseconden naar nanoseconden.
MPS-optimalisatie — voeg pci=pcie_bus_perf toe aan de host-kernel-commandoregel.
Zet MaxPayloadSize op het maximum dat de topologie ondersteunt.
vfio-pci-energiebeheer — voeg disable_idle_d3=1 toe als je NVMe-controller stroomtoestandsproblemen heeft onder passthrough.
Een gecombineerde host-kernel-commandoregel voor een Proxmox-node die NVMe-passthrough doet op een AMD EPYC-systeem zou er ongeveer zo uitzien:
GRUB_CMDLINE_LINUX_DEFAULT="quiet amd_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Voor Intel:
GRUB_CMDLINE_LINUX_DEFAULT="quiet intel_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Wanneer Passthrough Het Niet Waard Is
Voordat je dit pad inslaat, is het de moeite waard je af te vragen of je NVMe-passthrough eigenlijk wel nodig hebt.
VirtIO-SCSI en VirtIO-BLK met een NVMe-ondersteunde virtuele schijf zijn al zeer efficiënt. De overhead vergeleken met passthrough is doorgaans 5–10% op latency. Het doorvoerverschil is voor de meeste workloads verwaarloosbaar.
Passthrough is zinvol wanneer je nodig hebt dat het gast-OS het apparaat rechtstreeks beheert. Dat omvat SMART-monitoring, firmware-updates, TRIM/discard-controle, en specifieke NVMe-features zoals reservations. Het is ook zinvol voor latency-gevoelige workloads waar zelfs een paar microseconden ertoe doen. Bepaalde database-engines en realtime-data-inname vallen in die categorie.
Voor al het andere wegen de operationele afwegingen die eerder behandeld werden — verlies van live migratie, verlies van snapshots en backupintegratie — doorgaans zwaarder dan de kleine prestatiewinst.
Er is niks slims aan het kiezen van het moeilijkere pad wanneer het makkelijkere de klus klaart.
Je Wijzigingen Verifiëren
Nadat je de afstelstappen hebt toegepast, verifieer je dat alles werkt zoals verwacht:
# Host side — confirm IOMMU is in passthrough mode
dmesg | grep -i iommu

# Confirm ASPM is disabled
lspci -vv | grep -i "ASPM Disabled"

# Check MPS on the NVMe controller
lspci -vv -s XX:00.0 | grep MaxPayload

# Inside the VM — run the fio comparison
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Vergelijk de VM-resultaten met je eerdere bare-metal-baseline.
Bij iodepth=32 zou je doorvoer moeten zien binnen 5% van bare metal.
De gemiddelde voltooiingslatency zou binnen 10–15µs van de host-cijfers moeten liggen.
Als het gat nog steeds groot is, controleer dan eerst de NUMA-uitlijning.
Het is de meest over het hoofd geziene factor.
Het kost ook niets behalve een configwijziging, wat het het beste soort probleem maakt om mee achter te blijven.
Referenties
- Linux-kernel PCI-documentatie — MPS- en MRRS-afstelopties — de gezaghebbende bron voor
pcie_bus_perf,pcie_bus_safeen verwante parameters - Proxmox VE Administration Guide — PCI(e) Passthrough — officiële Proxmox-documentatie over VFIO-apparaatpassthrough-configuratie
- Proxmox Forum — NVMe Passthrough Performance — de communitydiscussie die dit artikel aanzette