Wat MPS is
PCIe-apparaten verplaatsen data in pakketten die Transaction Layer Packets (TLP’s) heten. Elke TLP heeft een header en een payload. De maximale grootte van die payload is de MaxPayloadSize (MPS).
MPS wordt tijdens link training onderhandeld tussen een apparaat en de bridge erboven. De onderhandelde waarde is de kleinste van wat het apparaat kan en wat de bridge toestaat. Elke bridge en switch in het pad tussen het apparaat en het root complex heeft zijn eigen MPS-capaciteit. De uiteindelijke MPS voor een apparaat wordt bepaald door het smalste punt in de keten.
Gangbare MPS-waarden zijn 128, 256 en 512 byte. Sommige apparaten kunnen 1024 of zelfs 4096 byte, maar in de praktijk is 256 of 512 typisch voor NVMe-controllers en netwerkkaarten. GPU’s kunnen vaak 256 byte.
Waarom het uitmaakt
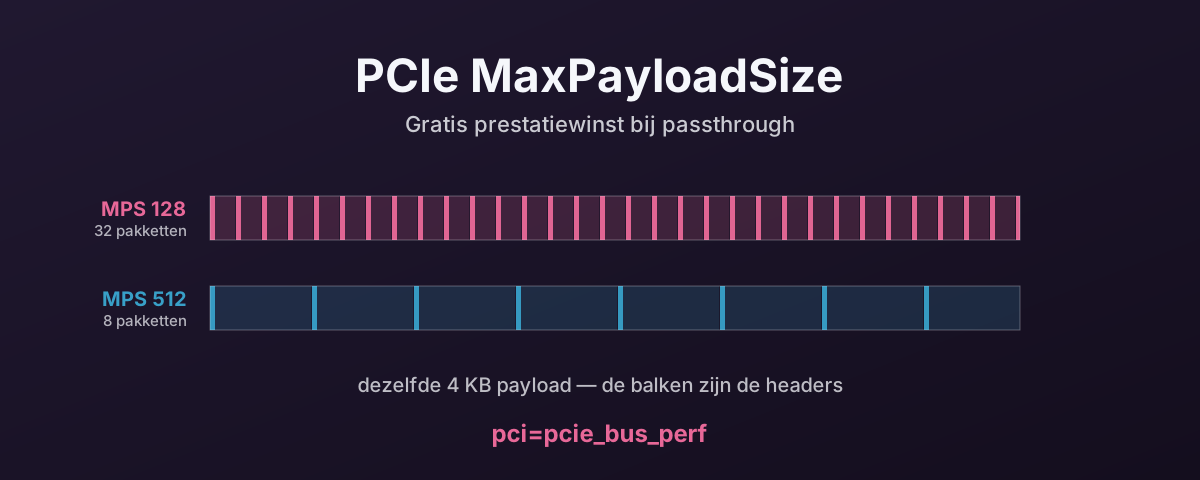
Een grotere MPS betekent minder pakketten voor dezelfde hoeveelheid data. Een IO van 4 KB heeft bij MPS 128 32 TLP’s nodig. Dezelfde overdracht heeft bij MPS 512 8 TLP’s nodig.
Elke TLP draagt protocoloverhead met zich mee — de header, CRC, framing. Minder TLP’s betekent minder protocoloverhead per verplaatste byte. Bij hoge doorvoer is dat verschil meetbaar. Niet dramatisch. Maar echt. En het is dezelfde overhead, betaald op elk pakket.
MPS bepaalt ook hoe goed de PCIe-link wordt benut. Kleinere payloads betekenen dat de link meer tijd aan headers besteedt in verhouding tot data. Grotere payloads schuiven die verhouding op naar nuttige data.
Het effect op latency is kleiner dan op doorvoer. Eén read van 4 KB bij MPS 128 tegenover 512 laat geen latencyverschil zien dat het meten waard is, want de TLP’s zijn gepijplijnd. Maar duw hoge IOPS met veel overdrachten onderweg en de kleinere overhead van een grotere MPS telt op.
Het probleem bij passthrough
Op bare metal zet de BIOS de MPS tijdens de POST, op basis van de PCIe-topologie. Een moderne serverbios zet MPS doorgaans op het maximum dat de topologie ondersteunt, meestal 256 of 512 byte.
Onder QEMU heeft het root complex van de virtuele Q35-chipset zijn eigen MPS-capaciteit.
Standaard presenteert het een lage MPS.
Het standaard-MPS-beleid van de Linux-kernel (pcie_bus_default) zet de MPS van elk apparaat gelijk aan die van de bridge erboven, en in een virtuele topologie is dat de standaard van het QEMU-root complex. Vaak 128 byte.
Zo draait een apparaat dat payloads van 512 byte kan doen op 128, omdat het virtuele root complex het plafond heeft gezet.
Hoe je het oplost — hostkant
Zeg de kernel dat hij de MPS op het maximum moet zetten dat de bus boven elk apparaat ondersteunt:
# Add to GRUB_CMDLINE_LINUX_DEFAULT in /etc/default/grub
pci=pcie_bus_perf
Dit zet de MPS van elk apparaat op de grootste waarde die de bus erboven toestaat. Het zet ook de MRRS (Max Read Request Size) daarop af. De kernelbron zegt dat het ervoor zorgt dat de MPS van een apparaat niet groter is dan die van zijn ouder. Dat houdt de keten consistent en levert toch de beste overdrachtsgroottes.
Controleer na een herstart de nieuwe MPS:
# Check MPS on a specific device
lspci -vv -s XX:00.0 | grep -i "MaxPayload"
Je zou MaxPayload 256 bytes of MaxPayload 512 bytes moeten zien in plaats van de standaard 128.
De andere kernelopties
De kernel biedt vier MPS-beleidsopties, elk via de bootparameter pci=:
pcie_bus_tune_off — raak de MPS helemaal niet aan.
Gebruik wat de BIOS heeft gezet.
Op bare metal met een goede BIOS is dat vaak prima.
Onder QEMU is de BIOS OVMF of SeaBIOS, en die optimaliseren de MPS misschien niet.
pcie_bus_default — de standaard van de kernel.
Zet de MPS van elk apparaat gelijk aan de bridge erboven.
Voorzichtig en veilig, maar haalt niet het maximum uit de prestaties.
pcie_bus_safe — zet de MPS op de grootste waarde die alle apparaten in het systeem ondersteunen.
Nuttig voor gesloten systemen waar je alle apparaten kent en er niets hotplugged wordt.
Iets agressiever dan de standaard.
pcie_bus_perf — zet de MPS per apparaat op de grootste waarde die de bus erboven toestaat.
Elk apparaat krijgt de beste MPS die zijn eigen topologie ondersteunt.
Dit is de juiste keuze voor passthrough, omdat het elk pad los van de rest optimaliseert.
pcie_bus_peer2peer — zet de MPS op alles op 128 byte.
Elk apparaat praat op de laagste gemene grootte.
Wordt gebruikt als apparaten direct naar elkaar moeten DMA’en (GPU naar GPU, GPU naar NIC via RDMA).
Niet nuttig voor gewone passthrough.
pcie_bus_perf is de juiste voor passthrough.
Hoe je het oplost — gastkant
Je kunt pci=pcie_bus_perf ook in de bootconfiguratie van de gastkernel zetten.
Of dat praktisch effect heeft, hangt af van hoe QEMU de virtuele PCIe-topologie presenteert.
Het virtuele root complex begrenst wat de gast kan onderhandelen.
In tests is de fix aan de hostkant degene die blijft plakken. De host bezit het fysieke apparaat, en zijn MPS-instelling bepaalt de werkelijke TLP-grootte op de draad. De instelling van de gast raakt alleen de virtuele topologie binnen de VM, en of dat echt gedrag verandert, hangt af van hoe QEMU het PCIe-pad voor dat apparaat presenteert.
Zet het op de host. Het er ook in de gast bij zetten kan geen kwaad, maar vertrouw er niet alleen op.
Wat MRRS is
Max Read Request Size (MRRS) hoort erbij, maar is iets anders. MPS begrenst hoeveel data een apparaat in één TLP kan versturen. MRRS begrenst hoeveel data een apparaat in één read request kan opvragen.
Een apparaat met MRRS 4096 kan één read request van 4 KB uitgeven. Het antwoord komt terug in meerdere TLP’s, elk tot de MPS in grootte. Een hogere MRRS betekent dat het apparaat per transactie meer data kan opvragen, wat het aantal read-request-TLP’s op de bus terugbrengt.
pci=pcie_bus_perf zet zowel MPS als MRRS op hun optimale waarden.
Je hoeft ze niet apart te tunen.
Effect tegenover andere tuning
Het MPS-verschil tussen 128 en 512 byte heeft minder invloed op de prestaties dan NUMA-uitlijning of ASPM. Het is doorgaans een verbetering van een paar procent op de doorvoer. Je ziet het niet in latencybenchmarks bij lage queue depths.
Maar het is een gratis optimalisatie. Eén kernelparameter, geen nadeel, geen compatibiliteitsrisico. Er is geen reden om het niet te zetten op elk systeem dat passthrough doet.
Het kost niets, en de hardware heb je al betaald. Dan kun je net zo goed hebben waarvoor je hebt betaald.
Bronnen
- Linux kernel PCI Kconfig — MPS and MRRS tuning options — gezaghebbende bron voor alle vier de MPS-beleidsopties
- Linux Plumbers Conference 2017 — MPS vs MRRS (PDF) — de presentatie van Sinan Kaya over hoe de kernel MPS/MRRS behandelt