Wat NUMA is
NUMA staat voor Non-Uniform Memory Access. Op een systeem met één socket bereikt elke CPU-kern al het RAM van het systeem via dezelfde geheugencontroller. De toegangstijd is gelijk, welke kern het verzoek ook doet en waar de data ook in het fysieke geheugen staat.
Op een systeem met meerdere sockets heeft elke CPU-socket zijn eigen geheugencontroller en zijn eigen bank RAM. Een kern op socket 0 kan het RAM aan socket 0 snel bereiken — dat is lokaal geheugen. Hij kan ook het RAM aan socket 1 bereiken, maar dat verzoek moet over de link tussen de sockets (Intel UPI, AMD Infinity Fabric). Dat is extern geheugen, en dat is langzamer.
De kernel noemt elke socket-met-zijn-lokale-geheugen een NUMA-node. Een systeem met twee AMD EPYC-sockets heeft ten minste twee NUMA-nodes. Sommige EPYC-processors laten vier NUMA-nodes per socket zien (één per CCD), wat op een bord met twee sockets acht nodes geeft.
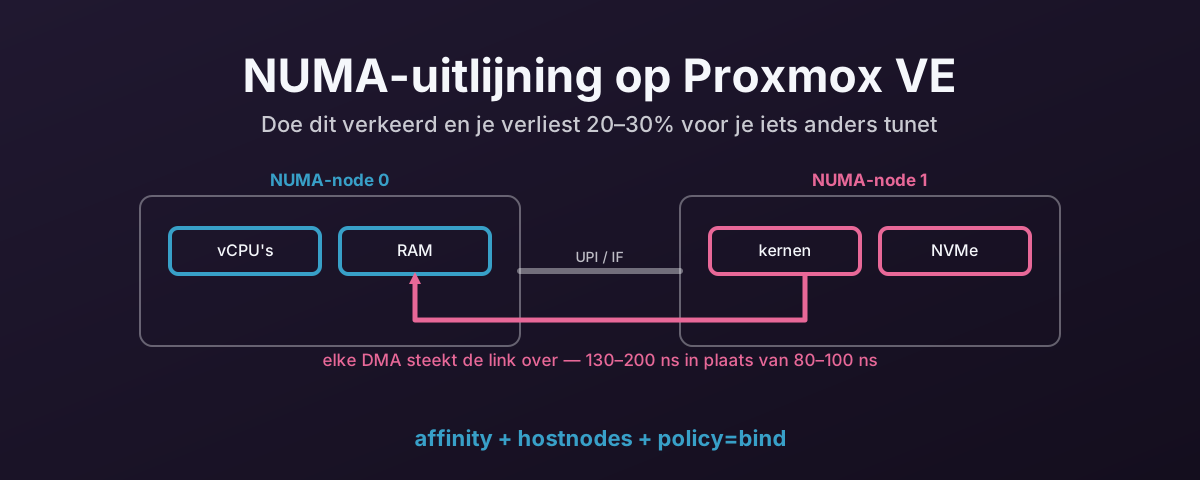
Het prestatieverschil tussen lokale en externe geheugentoegang is niet subtiel. Lokale toegang is rond de 80–100 ns. Externe toegang is rond de 130–200 ns. Dat is 50–100% straf per geheugenbewerking. Op zichzelf is dat een heel klein getal. Betaald op elke geheugentoegang zolang de VM leeft, is het niet klein meer.
Waarom het uitmaakt voor virtualisatie
Als Proxmox een VM aanmaakt, wijst het vCPU’s en RAM toe. Standaard kunnen die vCPU’s op elke fysieke kern op elke socket worden ingeplant. Het RAM van de VM kan uit de geheugenpool van elke NUMA-node komen.
Zet de planner een vCPU op socket 0 terwijl het RAM van de VM op socket 1 staat, dan steekt elke geheugentoegang van die vCPU de link tussen de sockets over. Stuiteren de vCPU’s tussen sockets — en dat doen ze als je ze niet vastzet — dan wordt het patroon van geheugentoegang een rommeltje. Sommige toegangen zijn lokaal, sommige extern, en de prestaties van de VM schokken mee.
Voor algemene workloads — een webserver, een fileserver, een desktop-VM — is dat vaak te leven. De overhead zit er wel, maar is over veel bewerkingen verspreid en overheerst niet.
Voor IO-intensieve workloads — databases, opslagservers, alles met zware schijf- of netwerk-IO — telt de straf op. Elke DMA-afronding, elke interruptbezorging, elke buffercopy raakt het geheugen. Steken die toegangen sockets over, dan loopt de overhead snel op.
Waarom het uitmaakt voor passthrough
PCIe-apparaten zitten fysiek aan een bepaalde CPU-socket gedraad. Elke socket heeft zijn eigen PCIe-root complex. De NVMe-schijf in slot 3 zit misschien op de PCIe-lanes van socket 0. De GPU in slot 5 misschien op die van socket 1.
Doet een apparaat DMA, dan gaat de data naar het geheugen dat hangt aan de NUMA-node waar de IOMMU hem naartoe wijst. Komt het RAM van de VM uit de node die lokaal is voor het apparaat, dan gaat de DMA-write direct naar lokaal geheugen. Staat het RAM op de andere node, dan steekt elke DMA-bewerking de link tussen de sockets over.
Voor een NVMe-schijf die honderdduizenden IOPS doet, telt die straf van 50–100 ns per bewerking op.
Bij iodepth=32 met random reads van 4 KB kan het doorvoerverschil tussen uitgelijnde en niet-uitgelijnde NUMA 20–30% zijn.
En dat is nog voordat je naar IOMMU-overhead, ASPM, MPS of iets anders hebt gekeken.
Hetzelfde geldt voor netwerkkaarten, GPU’s en elk ander doorgegeven apparaat. Het DMA-verkeer van het apparaat hoort in lokaal geheugen te landen, en de vCPU’s die dat verkeer verwerken horen op dezelfde node te zitten.
Hoe je je topologie controleert
Zoek op welke NUMA-node een apparaat zit
# Replace 0000:XX:00.0 with your device's PCI address from lspci
cat /sys/bus/pci/devices/0000:XX:00.0/numa_node
Dit geeft het nummer van de NUMA-node terug.
Geeft het -1 terug, dan kon de kernel de node niet vaststellen. Dat gebeurt soms bij apparaten achter bepaalde PCIe-switches.
Trek in dat geval de PCIe-topologie met de hand na via lspci -tv en koppel de root port aan de socket.
Bekijk je volledige NUMA-indeling
numactl --hardware
Dit laat je elke NUMA-node zien, hoeveel CPU-kernen erop zitten, hoeveel geheugen eraan hangt, en de afstand (relatieve kosten) tussen nodes.
Voorbeelduitvoer van een systeem met twee EPYC-sockets:
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
node 0 size: 131072 MB
node 1 cpus: 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31
node 1 size: 131072 MB
node distances:
node   0   1
  0:  10  32
  1:  32  10
De afstandstabel vertelt je de relatieve kosten. 10 is lokaal. 32 is extern. Hogere getallen betekenen meer hops. Op EPYC-opstellingen met vier nodes per socket hebben sommige nodeparen een afstand van 32 en andere 16, afhankelijk van op welke CCD ze zitten.
Apparaten aan nodes koppelen
# List all PCI devices and their NUMA nodes
for dev in /sys/bus/pci/devices/*; do
    node=$(cat "$dev/numa_node" 2>/dev/null)
    echo "$(basename $dev) node=$node $(lspci -s $(basename $dev) 2>/dev/null | cut -d' ' -f2-)"
done
Dit geeft je een volledig beeld van welke apparaten op welke nodes zitten. Zoek je NVMe-controllers, netwerkkaarten en eventuele GPU’s op die je doorgeeft.
Hoe je een VM uitlijnt in Proxmox
vCPU’s aan de juiste node vastzetten
In het configuratiebestand van de VM (/etc/pve/qemu-server/<vmid>.conf):
numa: 1
affinity: 0-15    # Adjust to match cores on the correct NUMA node
De parameter affinity zet de vCPU’s van de VM vast op bepaalde fysieke kernen.
Zet hem op het bereik van kernen op dezelfde NUMA-node als je doorgegeven apparaat.
Zit je NVMe op node 1 en heeft node 1 de kernen 16–31, zet dan affinity: 16-31.
Heeft de VM maar 8 vCPU’s nodig, zet hem dan vast op een deel daarvan: affinity: 16-23.
Geheugen van de juiste node toewijzen
numa: 1 aanzetten in de VM-config zegt Proxmox dat het de VM een NUMA-topologie moet voorschotelen.
QEMU zal dan proberen het geheugen van de VM toe te wijzen uit de NUMA-node waar de vCPU’s zijn vastgezet.
Voor uitdrukkelijke controle kun je de NUMA-topologie in de VM-config zetten:
numa0: cpus=0-7,hostnodes=0,memory=16384,policy=bind
Dit zegt QEMU dat het de eerste NUMA-node van de VM (node 0 vanuit de gast bekeken) moet binden aan NUMA-node 0 van de host, met de kernen 0–7 en 16 GB geheugen.
policy=bind zorgt ervoor dat het geheugen strikt uit die node komt, in plaats van terug te vallen op andere nodes als de lokale pool onder druk staat.
Controleer het vastzetten
Kijk na het starten van de VM of de vCPU’s ook echt draaien waar je ze verwacht:
# Find the QEMU process
pgrep -a qemu | grep <vmid>

# Check CPU affinity of the process
taskset -cp <pid>

# Or check per-vCPU thread affinity
for tid in $(ls /proc/<pid>/task/); do
    echo "Thread $tid: $(taskset -cp $tid 2>/dev/null)"
done
Veelgemaakte fouten
Helemaal niet vastzetten
Zet je affinity niet, dan kunnen de vCPU’s van de VM op elke kern worden ingeplant.
De planner van de kernel schuift ze tussen nodes heen en weer om de last te verdelen.
Elke keer dat een vCPU van de ene node naar de andere verhuist, wordt alles waarmee hij bezig was in de cache van de oude node extern.
Voor algemene VM’s is dat acceptabel. Voor passthrough-VM’s met zware IO niet.
Aan de verkeerde node vastzetten
Kijk de NUMA-node van het apparaat na voordat je vastzet.
Ga er niet van uit.
Op sommige moederborden loopt de fysieke slotnummering niet op een voor de hand liggende manier gelijk met de indeling in NUMA-nodes.
Controleer het altijd met cat /sys/bus/pci/devices/.../numa_node.
Een node overboeken
Zet je te veel VM’s vast op dezelfde NUMA-node, dan raken de kernen op die node overboekt en loopt de lokale geheugenpool leeg. Loopt het geheugen over naar de externe node, dan heb je het slechtste van twee werelden: vastgezette vCPU’s met extern geheugen.
Verdeel je VM’s over de nodes. Heb je twee NUMA-nodes en vier VM’s, spreid ze dan gelijk.
Geheugentoewijzing vergeten
vCPU’s vastzetten zonder ook de geheugentoewijzing te regelen geeft je de helft van de winst.
De vCPU’s staan op de juiste node, maar het geheugen misschien niet.
Gebruik policy=bind, of zet op zijn minst numa: 1 aan zodat de toewijzing van QEMU het vastzetten van de CPU’s volgt.
Systemen met één socket
Op een systeem met één socket staat alles op NUMA-node 0. Er is maar één geheugencontroller en één set PCIe-lanes. NUMA-uitlijning is dan geen zorg.
Je kunt numa: 1 nog steeds in de VM-config zetten — het doet geen kwaad — maar het helpt ook niet.
Eén socket, één geheugencontroller, niets uit te lijnen.
Bewaar de moeite voor een bak met twee.
De winst die hier wordt beschreven geldt dan ook alleen voor systemen met meerdere sockets, waar de link tussen de sockets bestaat.
Bronnen
- Proxmox VE Administration Guide — CPU and NUMA Configuration — officiële documentatie over vCPU’s vastzetten en de NUMA-opties
- Linux kernel NUMA documentation — naslag voor het geheugenbeleid van de kernel
- AMD EPYC 7003 Series — BIOS & Workload Tuning Guide (doc 58002) — de documentatie van AMD over NUMA-per-socket en de CCD/CCX-topologie